Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Important
Cette fonctionnalité est en version bêta.
Les sessions d’agent offrent à vos agents un stockage durable et indépendant du framework pour l’état de session : l’état qu’un agent ou un framework conserve pour une interaction. Le plus souvent, il s’agit de l’historique de la conversation, la transcription ordonnée des messages, des appels d’outils et des résultats qu’un agent lit au début d’un tour et auquel il ajoute des éléments au fur et à mesure de son exécution. Il peut aussi s’agir de tout autre état qu’un framework conserve dans le cadre de l’interaction, comme un graphe LangGraph. Azure Databricks le stocke dans Lakebase et gère le stockage pour vous, donc vous ne construisez pas ou n'exploitez pas la base de données.
Note
Lors de la prévisualisation, vous êtes facturé pour l’instance Lakebase sous-jacente qui stocke vos sessions. Aucun frais supplémentaire ne s’appliquent pour les sessions d’agent elles-mêmes. Les tarifs peuvent évoluer au fur et à mesure de l’avancement de la prévisualisation.
Utilisez les sessions d’agent lorsque vous souhaitez :
- Conservez l’historique des conversations d’un agent pour qu’il survive aux redémarrages et puisse être repris plus tard.
- Reconstruisez le contexte complet (y compris les appels d’outils et le raisonnement) sur un message de suivi.
- Listez, reprenez et ramifiez les conversations au-delà de votre propre interface.
Les sessions d’agent conservent l’état d’une seule interaction (état à court terme, état de session). Pour une mémoire à long terme qui persiste à travers les conversations, utilisez mémoire d’agent.
Exigences
- Installez Python 3.10 ou version supérieure pour utiliser le SDK AgentKit. Le SDK AgentKit est le client Python de Databricks pour les API d’agents, utilisé dans les exemples ci-dessous. Vous pouvez aussi appeler l’API REST directement depuis n’importe quel langage, sans besoin de Python.
Comment fonctionnent les sessions d’agent
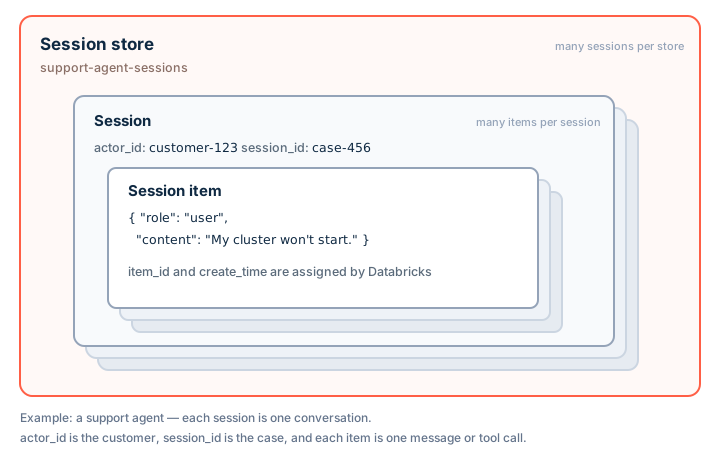
Les sessions d’agents comportent trois niveaux :
- Un magasin de sessions est le conteneur associé à un espace de travail pour les sessions d’un agent. La création d’un espace de stockage provisionne automatiquement le stockage Lakebase sous-jacent. Vous choisissez un espace de travail unique
session_store_name. - Une session est une interaction durable (généralement un fil de conversation) au sein d’un magasin. Une session est identifiée par :
-
actor_id(requis) : à qui appartient la session, comme un utilisateur final ou un autre agent. Il regroupe toutes les séances d’un seul sujet pour pouvoir les lister et les filtrer ensemble. Lorsque vous développez une application par utilisateur, définissezactor_idl’identifiant de l’utilisateur (par exemple, l’identité utilisateur finale vérifiée via l’authentification de votre application) afin que les sessions de chaque utilisateur restent regroupées. Configurez-le à partir d’un contexte d’application fiable, jamais une valeur fournie par le modèle ou l’utilisateur. -
session_id(optionnel) : un identifiant choisi par l’appelant pour l’interaction. Le service en génère un lorsque vous l’omettez. -
parent_session_id(optionnel) : relie une session à celle dont elle est issue par bifurcation, pour représenter des conversations ramifiées.
-
- Un élément de session est une entrée dans l’historique ordonné d’une session. Chaque élément contient une valeur opaque, compatible
dataJSON, telle qu’un message, un appel d’outil, un résultat d’outil ou un bloc de raisonnement. Azure Databricks attribue à chaque élément unitem_idet uncreate_timeet ne vérifie pas son contenu. Les éléments sont immuables après leur ajout.
Le service maintient un ordre déterministe pour les éléments d’une session et autorise chaque opération auprès du magasin de session.
Get started
Ces exemples permettent de configurer des sessions d’agent pour un agent support : ils créent un magasin de sessions, lancent une session pour une conversation, ajoutent les tours de la conversation, puis relisent l’historique lors d’une demande ultérieure. Choisissez le client qui correspond à votre projet.
AgentKit SDK
Le SDK AgentKit est le client Python Databricks pour les API d’agents, distribué dans le databricks-agentbricks paquet. Il s’authentifie à l’aide du SDK Databricks WorkspaceClient.
Installez le SDK AgentKit :
pip install databricks-agentbricksCréez un magasin de sessions, puis lancez une session pour une conversation.
actor_idest à qui appartient la conversation ; l’optionsession_ididentifie de manière unique cette conversation :from databricks.sdk import WorkspaceClient from databricks_agentkit import AgentKitClient client = AgentKitClient(WorkspaceClient()) session_store = client.session_stores.create("support-agent-sessions") session = session_store.add(actor_id="customer-123", session_id="case-456")Ajoutez les tours de conversation au fur et à mesure que l’agent court. Chaque élément est une valeur compatible JSON :
session.append_items(
    [
        {"type": "message", "role": "user", "content": "I need help with my cluster."},
        {"type": "message", "role": "assistant", "content": "Let's take a look."},
    ]
)
Sur une demande de suivi, rechargez la session et lisez son historique complet pour reconstituer le contexte :
session = session_store.get("case-456")
# Request chronological order; list_items defaults to newest-first and auto-pages.
history = [item.data for item in session.list_items(order_by="create_time asc")]
REST API
Les clients appellent l’API REST sous /api/2.0/agents/session-stores. Appelez-la directement pour d’autres langages que Python.
Générez un jeton OAuth avec l’interface de ligne de commande Databricks :
databricks auth login --host ${DATABRICKS_HOST}
export DATABRICKS_TOKEN=$(databricks auth token | jq -r .access_token)
Créez un magasin de sessions pour votre agent :
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/session-stores?session_store_name=support-agent-sessions" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"description": "Support agent conversation history"}'
Commence une séance pour une conversation.
actor_idest à qui elle appartient ;session_ididentifie de manière unique cette conversation :curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/session-stores/support-agent-sessions/sessions?session_id=case-456" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \ -d '{"actor_id": "customer-123"}'Ajoutez un tour de conversation pendant que l’agent court :
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/session-stores/support-agent-sessions/sessions/case-456/items:append" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"items": [{"data": {"type": "message", "role": "user", "content": "I need help with my cluster."}}]}'
Relisez l’histoire dans l’ordre chronologique pour reconstruire le contexte :
curl -G "https://${DATABRICKS_HOST}/api/2.0/agents/session-stores/support-agent-sessions/sessions/case-456/items" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" --data-urlencode "order_by=create_time asc"
Les clients prennent également en charge la suppression de l’élément le plus récent, l’effacement de tous les éléments d’une session et la duplication d’une conversation en une copie indépendante (éventuellement jusqu’à un élément donné). La suppression d’une session qui comporte des sessions enfants nécessite l’option force pour répercuter la suppression en cascade sur celles-ci (par exemple, session.delete(force=True)).
Associer la session d’un framework d’agent à des sessions d’agent
Des frameworks d’agents tels que le SDK OpenAI Agents et le Claude Agent SDK lisent l’historique des conversations au début d’une exécution et ajoutent de nouveaux éléments à la fin. Le stockage de session correspond directement à ce modèle :
| Fonctionnement du cadre | Appel au stockage de session |
|---|---|
| Lire l’histoire |
list_items dans l’ordre chronologique (order_by="create_time asc") |
| Ajouter des éléments de rotation |
append Les nouveaux éléments |
| Annuler le dernier élément |
pop l’élément le plus récent |
| Effacez le fil |
clear Les éléments de la session |
Portée et accès
Les sessions d’agent stockent les éléments d’une session sous forme de valeurs opaques, compatibles JSON : le service persiste et renvoie tout ce que votre agent ou framework ajoute, sans l’interpréter. Il n’ajoute pas de ressources de contrôle d’exécution telles que les exécutions, points de contrôle ou approbations comme concepts de première classe, bien qu’un cadre sérialisant un tel état puisse les faire persister en tant qu’items.
Les stocks de session sont limités à l’espace de travail, et l’accès est autorisé au niveau du stock. Les actor_id champs et metadata ne supportent que le regroupement et le filtrage ; ils n’accordent ni ne restreignent l’accès. Définissez le actor_id à partir du contexte d’une application de confiance plutôt qu’à partir d’une valeur fournie par le modèle ou l’utilisateur.
Pour permettre à un autre principal, comme le principal de service de votre agent, d’utiliser un magasin, accordez-lui l’accès via l’opération de concession d’autorisation du magasin (session_store.grant_permission(principal_id) dans le SDK AgentKit).
Les sessions d’agent et la mémoire d’agent sont indépendantes. La suppression d'une session ou d'un stockage de session n'entraîne pas la suppression de la mémoire conservée dans un stockage de mémoire. Pour construire une mémoire à long terme à partir des sessions dans un espace de stockage, créez un pipeline mémoire.