Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Important
Cette fonctionnalité est en version bêta.
La mémoire des agents donne à vos agents une mémoire à long terme qui persiste à travers les conversations. Azure Databricks stocke la mémoire dans Lakebase et gère le stockage, l’indexation et la recherche sémantique pour vous, afin que vos agents puissent se souvenir des préférences utilisateur, des décisions passées et du contexte accumulé sans que vous ayez à utiliser une base de données.
Note
Lors de la prévisualisation, vous êtes facturé pour l’instance Lakebase sous-jacente qui stocke vos entrées mémoire. Aucun frais supplémentaire ne s’applique à la mémoire d’agent elle-même. Les tarifs peuvent évoluer au fur et à mesure de l’avancement de la prévisualisation.
Utilisez la mémoire des agents lorsque vous souhaitez que vos agents :
- Gardez à l’esprit les préférences des utilisateurs, les faits et les décisions issues des conversations séparées.
- Personnalisez les réponses en fonction de ce qu’un agent a appris lors des sessions précédentes.
- Partagez les connaissances accumulées entre agents et projets.
- Améliorez la précision et l’efficacité au fil du temps.
La mémoire des agents fonctionne avec des agents construits sur n’importe quel framework. Pour un historique de conversation à court terme au sein d’une seule interaction, utilisez des sessions d’agent.
Requirements
- Installez Python 3.10 ou version supérieure pour utiliser le SDK AgentKit. Le SDK AgentKit est le client Python de Databricks pour les API d’agents, utilisé dans les exemples ci-dessous. Vous pouvez aussi appeler l’API REST directement depuis n’importe quel langage, sans besoin de Python.
Comment fonctionne la mémoire des agents
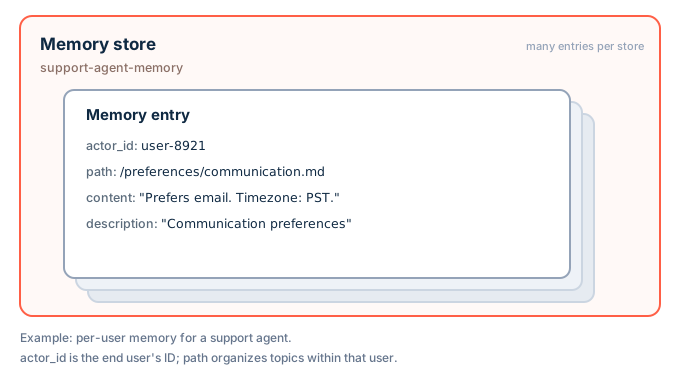
La mémoire de l’agent comporte deux niveaux :
- Un magasin de mémoire est le conteneur propre à l’espace de travail pour les mémoires d’un agent. La création d’un espace de stockage provisionne automatiquement le stockage Lakebase sous-jacent. Vous adressez un magasin par son
display_name. - Une entrée mémoire est un contenu individuel dans un magasin. Chaque entrée contient un texte
contentlibre, un courtdescriptiontexte utilisé pour la récupération, et un ensemble de champs qui l’organisent et la partitionnent :-
actor_id(requis) : à qui appartient la mémoire, comme un utilisateur final ou un autre agent. -
session_id(optionnel) : indique de quelle session la mémoire a été capturée, à des fins de traçabilité et de provenance. Laissez-le non défini pour la mémoire qui n’est pas liée à une session spécifique. -
path(requis) : un chemin de type système de fichiers qui organise les entrées dans un acteur, comme/preferences/response-style.md.
-
Une entrée est identifiée de manière unique par la combinaison de actor_id, session_id, et path.
Les entrées arrivent dans un stockage de deux manières : votre agent ou application les écrit directement, ou un pipeline mémoire les distille à partir des conversations dans un stockage de session.
Recherche
Récupérer la mémoire de deux façons :
-
Listez les entrées d’un acteur, filtrées éventuellement par
session_idou par unpathpréfixe. Utilisez-le pour parcourir ou afficher un index de ce que sait un agent. - Recherchez les entrées d’un acteur à l’aide d’une requête en langage naturel. La recherche renvoie les entrées les plus pertinentes classées par un score de pertinence en texte intégral (BM25).
Get started
Ces exemples configurent la mémoire d’agent pour un agent d’assistance : ils créent un stockage de mémoire, enregistrent la préférence de l’utilisateur, puis la rappellent lors d’une conversation ultérieure. Choisissez le client qui correspond à votre projet. Le nom d’un magasin de mémoire display_name doit comporter entre 3 et 56 caractères, commencer par une lettre minuscule, se terminer par une lettre ou un chiffre, et ne contenir que des lettres minuscules, des chiffres et des traits d’union.
AgentKit SDK
Le SDK AgentKit est le client Python Databricks pour les API d’agents, distribué dans le databricks-agentbricks paquet. Il s’authentifie à l’aide du SDK Databricks WorkspaceClient.
Installez le SDK AgentKit :
pip install databricks-agentbricksCréez un stockage de mémoire pour votre agent.
AgentKitClients’authentifie avec vos identifiantsWorkspaceClient:from databricks.sdk import WorkspaceClient from databricks_agentkit import AgentKitClient client = AgentKitClient(WorkspaceClient()) memory_store = client.memory_stores.create("support-agent-memory")Sauvegardez un souvenir après que l’agent ait appris quelque chose de durable sur un utilisateur.
actor_idest dont appartient cette mémoire,pathl’organise au sein de cet acteur, etdescriptionaméliore la récupération :memory_store.add( actor_id="user-123", path="/preferences/communication.md", content="Prefers email over phone. Timezone: PST. Enterprise subscription.", description="User 123 communication preferences", )Rappelez-vous les souvenirs de l’utilisateur lors d’une conversation ultérieure avec une recherche en langue naturelle :
results = memory_store.search(actor_id="user-123", query="communication preferences", limit=10)
REST API
Les clients appellent l’API REST sous /api/2.0/agents/memory-stores. Appelez-la directement pour d’autres langages que Python.
Générez un jeton OAuth avec l’interface de ligne de commande Databricks :
databricks auth login --host ${DATABRICKS_HOST}
export DATABRICKS_TOKEN=$(databricks auth token | jq -r .access_token)
Créez une base de mémoire pour votre agent :
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"display_name": "support-agent-memory", "description": "Support agent memory"}'
Sauvegardez une entrée mémoire pour un utilisateur.
actor_idest dont cette mémoire appartient,pathl’organise etdescriptionaméliore la récupération :curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \ -d '{"actor_id": "user-123", "path": "/preferences/communication.md", "content": "Prefers email over phone.", "description": "Communication preferences"}'Rappelez les souvenirs de l’utilisateur avec une recherche en langue naturelle :
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries:search" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"actor_id": "user-123", "query": "communication preferences"}'
Donnez à votre agent des outils de mémoire
Pour permettre à un agent de décider quand enregistrer et récupérer des informations en mémoire, encapsulez les opérations du client sous forme d’outils et indiquez à l’agent quand les utiliser dans son prompt système. Définissez le actor_id dans le code d’application approuvé à partir de l’identité vérifiée de l’utilisateur final. Ne laissez jamais le modèle choisir quelle mémoire lire ou écrire.
L’exemple suivant encapsule le SDK AgentKit memory_store issu de Get started sous forme d’outils pour le SDK Agents d’OpenAI.
from agents import Agent, function_tool

def make_memory_tools(memory_store, actor_id: str):
    @function_tool
    def search_memory(query: str) -> str:
        """Search long-term memory for relevant facts about the user."""
        results = memory_store.search(actor_id=actor_id, query=query, limit=10)
        return "\n\n".join(f"{r.memory.path}: {r.memory.content}" for r in results) or "No memory found."

    @function_tool
    def save_memory(path: str, content: str, description: str = "") -> str:
        """Save a durable, long-term memory about the user."""
        memory_store.add(actor_id=actor_id, path=path, content=content, description=description)
        return f"Saved memory at {path}"

    return [search_memory, save_memory]

agent = Agent(
    name="Support agent",
    instructions="Save durable user preferences and recall them when relevant.",
    tools=make_memory_tools(memory_store, actor_id="user-123"),
)
Le même schéma fonctionne avec le Claude Agent SDK et d’autres frameworks : encapsuler les opérations de recherche et d’ajout du magasin comme type d’outil du framework.
Si vous exécutez également un pipeline mémoire sur le même magasin de mémoire, le pipeline peut réécrire, fusionner, diviser ou supprimer les entrées que votre agent sauvegarde pour n’importe quel acteur qu’il traite.
Partition et mémoire sécurisée
Dans un magasin, actor_id est ainsi qu’on distingue à qui appartiennent les souvenirs. Chaque liste et recherche se limite à un seul actor_id, alors choisissez la stratégie qui correspond à ce que votre agent doit retenir :
-
Mémoire privée pour chaque utilisateur : Définir
actor_idsur l’identité de l’utilisateur final vérifié. Chaque utilisateur reçoit sa propre partition, et l’agent ne se souvient que des entrées de cet utilisateur.- Exemple : Un agent support se souvient des préférences de communication d’un utilisateur et des tickets passés.
-
Mémoire partagée pour un groupe : Définissez
actor_idà une clé fixe que vous choisissez, comme un identifiant d’équipe, de projet ou d’organisation. Tout le monde lit et écrit les mêmes souvenirs.- Exemple : Un agent d’équipe se souvient d’un glossaire partagé des termes de l’entreprise et des conventions internes.
-
Mémoire répartie selon d’autres critères : Créez
actor_idà partir de vos propres valeurs, comme un ID de locataire ou unuser:projectcomposite.-
Exemple : Une application mutualisée définit
actor_idsur{tenant}:{user}afin que les utilisateurs de chaque client restent isolés les uns des autres.
-
Exemple : Une application mutualisée définit
Définissez actor_id dans votre code d’application depuis le contexte de l’appelant de confiance : l’identité vérifiée de l’utilisateur final pour la mémoire par utilisateur, ou une clé d’équipe ou de projet de confiance pour la mémoire partagée. Ne laissez jamais le modèle le choisir. Si votre stratégie dépend d’une identité utilisateur final, rejetez les requêtes qui n’en portent pas plutôt que de revenir à une identité partagée actor_id.
Warning
actor_id sépare les espaces mémoire, mais ce n’est pas un contrôle d’accès. Les magasins de mémoire sont limités à l’espace de travail, donc tout principal pouvant atteindre un magasin de mémoire peut lire et écrire chaque entrée pour tous les acteurs. Le magasin, pas l’acteur, est la frontière de sécurité. Pour une isolation stricte entre locataires ou utilisateurs, créez un stockage mémoire séparé par frontière.
Pour permettre à un autre principal, comme le principal de service de votre agent, d’utiliser un magasin, accordez-lui l’accès via l’opération de concession d’autorisation du magasin (memory_store.grant_permission(principal_id) dans le SDK AgentKit).
Limitations
- La mémoire des agents ne fournit que la mémoire à long terme. Pour l’historique des conversations à court terme, voir les sessions d’agent.
- La recherche est une opération de texte intégral classée par pertinence (BM25) qui renvoie un ensemble de résultats en top N pouvant atteindre 100 entrées. Il ne supporte pas la pagination ni la recherche de similarité vectorielle.
- Le contrôle d’accès est appliqué au niveau du magasin. Le contrôle d’accès par entrée et par acteur n’est pas disponible.
- Le magasin
display_nameest immuable après sa création. Seuldescriptionpeut être mis à jour.