Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Important
Cette fonctionnalité est disponible en préversion publique. Les administrateurs d’espace de travail peuvent contrôler l’accès à cette fonctionnalité à partir de la page Aperçus . Consultez Gérer les préversions d’Azure Databricks.
Contrôle d’accès
Les fonctionnalités sont des objets catalogue Unity pouvant être régis. L’accès à une fonctionnalité est contrôlé par les CREATE FEATUREprivilèges de catalogue , READ FEATUREet MANAGE Unity. Pour obtenir des descriptions complètes, consultez informations de référence sur les privilèges du catalogue Unity.
-
CREATE FEATURE: Nécessaire pour créer une fonctionnalité dans un schéma.create_featureetregister_featureexigerCREATE FEATUREsur le schéma parent. En suivant le principe du privilège minimum, accordez-leCREATE FEATUREau niveau du schéma ; vous pouvez également l’accorder sur un catalogue pour permettre la création de fonctionnalités dans n’importe quel schéma de ce catalogue. -
READ FEATURE: Obligatoire pour lire les métadonnées des fonctionnalités.get_feature,create_training_set, etlist_materialized_featuresnécessitentREAD FEATUREsur la fonctionnalité. Ce privilège n’accorde pas l’accès aux données de fonctionnalités dans les tables sources ou de sortie matérialisée. Pour lire ces données pour la formation ou le service, vous devez également êtreSELECTinscrites dans les tables concernées.READ FEATUREaccordé sur un schéma ou un catalogue s’applique à toutes les fonctionnalités actuelles et futures qu’il contient. -
MANAGE: Nécessaire pour gérer le cycle de vie et les subventions d’une fonctionnalité. Supprimer une caractéristique avecdelete_feature, et matérialiser une caractéristique avecmaterialize_features, nécessiteMANAGEsur la fonctionnalité. La suppression d’une caractéristique matérialisée avecdelete_materialized_featuren’est pas régie parMANAGE: seul le créateur de la caractéristique matérialisée peut la supprimer.
Toutes les opérations de fonctionnalité nécessitent USE CATALOG également sur le catalogue parent et USE SCHEMA sur le schéma parent. Pour savoir comment MANAGE et READ FEATURE s’appliquer à la matérialisation, consultez Autorisations.
API d’affichage des fonctionnalités
Feature constructeur et register_feature()
L’approche recommandée consiste à construire un Feature objet localement et à l’utiliser register_feature pour le conserver dans le catalogue Unity. Ce flux de travail en deux étapes vous permet d’expérimenter des fonctionnalités (y compris create_training_set) avant de les inscrire.
Feature(
    source: DataSource,                                    # Required: DeltaTableSource, StreamSource, RequestSource, or FeatureViewSource
    function: Union[AggregationFunction, ColumnSelection, CustomUDF], # Required for all features
    entity: Optional[List[str]] = None,                    # Required for DeltaTableSource and StreamSource
    timeseries_column: Optional[str] = None,               # Required for DeltaTableSource and StreamSource
    name: Optional[str] = None,                            # Optional: Feature name (auto-generated if omitted)
    description: Optional[str] = None,                     # Optional: Feature description
)
FeatureEngineeringClient.register_feature() inscrit une construction Feature locale dans le catalogue Unity.
FeatureEngineeringClient.register_feature(
    feature: Feature,       # Required: A Feature instance (not already registered)
    catalog_name: str,      # Required: UC catalog name
    schema_name: str,       # Required: UC schema name
) -> Feature
from databricks.feature_engineering.entities import Feature, DeltaTableSource, AggregationFunction, Sum, RollingWindow
from datetime import timedelta

# Step 1: Construct the feature locally
feature = Feature(
    source=DeltaTableSource(catalog_name="main", schema_name="store", table_name="transactions"),
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)

# Step 2: Register in Unity Catalog
fe = FeatureEngineeringClient()
registered_feature = fe.register_feature(
    feature=feature,
    catalog_name="main",
    schema_name="store",
)
create_feature()
FeatureEngineeringClient.create_feature() valide, construit et inscrit immédiatement une fonctionnalité dans le catalogue Unity en une seule étape. Utilisez cette option lorsque vous n’avez pas besoin d’expérimenter la fonctionnalité localement.
FeatureEngineeringClient.create_feature(
    source: DataSource,                                    # Required: DeltaTableSource, StreamSource, RequestSource, or FeatureViewSource
    function: Union[AggregationFunction, ColumnSelection, CustomUDF], # Required for all features
    catalog_name: str,                                     # Required: The catalog name for the feature
    schema_name: str,                                      # Required: The schema name for the feature
    entity: Optional[List[str]] = None,                    # Required for DeltaTableSource and StreamSource
    timeseries_column: Optional[str] = None,               # Required for DeltaTableSource and StreamSource
    name: Optional[str] = None,                            # Optional: Feature name (auto-generated if omitted)
    description: Optional[str] = None,                     # Optional: Feature description
) -> Feature
Paramètres :
-
source: La source de données utilisée dans le calcul des caractéristiques (DeltaTableSource,StreamSource,RequestSource, ouFeatureViewSource). -
function: EtAggregationFunctionqui regroupe un opérateur et une fenêtre temporelle,ColumnSelection("column_name")pour les caractéristiques de passage, ouCustomUDFpour les transformations rangée par rangée. Voir Fonctions prises en charge pour les types de sources compatibles. -
catalog_name: nom du catalogue Du catalogue Unity pour la fonctionnalité. -
schema_name: nom du schéma du catalogue Unity pour la fonctionnalité. -
entity: liste des noms de colonnes qui définissent les clés d’agrégation ou de recherche (clés primaires). Requise pourDeltaTableSourceetStreamSource. Par exemple,["user_id"]les agrégats ou les recherches par utilisateur. Omettre pourRequestSourceetFeatureViewSource. -
timeseries_column: colonne timestamp utilisée pour l’agrégation de fenêtre de temps ou la sélection de la dernière valeur. Requise pourDeltaTableSourceetStreamSource. Omettre pourRequestSourceetFeatureViewSource. -
name: nom de fonctionnalité facultatif. S’il est omis, généré automatiquement à partir de la colonne d’entrée, de la fonction et de la fenêtre (par exemple,amount_avg_rolling_7d). -
description: description facultative de la fonctionnalité.
Retourne : Une instance de fonction validée
Soulève: ValueError si une validation échoue
delete_feature()
Supprime une fonctionnalité du catalogue Unity par son nom complet.
FeatureEngineeringClient.delete_feature(
    full_name: str,  # Required: '<catalog>.<schema>.<feature_name>'
) -> None
fe.delete_feature(full_name="main.store.amount_sum_rolling_7d")
Avant de supprimer une fonctionnalité, supprimez ou mettez à jour des modèles ou des spécifications de fonctionnalités qui le référencent. Une fonctionnalité ne peut pas être supprimée tant qu’elle a encore des fonctionnalités matérialisées. Supprimez d’abord les fonctionnalités matérialisées, puis supprimez la fonctionnalité. Découvrez comment supprimer une fonctionnalité matérialisée.
Noms générés automatiquement
Lorsqu’il name est omis, un nom est généré automatiquement. Les noms générés suivent le modèle : {column}_{function}_{window}. Par exemple:
-
price_avg_rolling_1h(prix moyen de 1 heure) -
transaction_count_rolling_30d_1d(Nombre de transactions de 30 jours avec un délai de 1d à partir de l’horodatage de l’événement)
Fonctions prises en charge
Fonctions d’agrégation
Note
Les fonctions d’agrégation sont encapsulées dans une AggregationFunction fenêtre de temps, comme décrit dans les fenêtres de temps. Chaque fonction prend un input paramètre spécifiant la colonne source à agréger.
| Function | Description | Exemple de cas d’usage |
|---|---|---|
Sum(input="column") |
Total des valeurs | Utilisation quotidienne de l’application par utilisateur en minutes |
Avg(input="column") |
Moyenne des valeurs | Montant moyen de la transaction |
Count(input="column") |
Nombre d’enregistrements | Nombre de connexions par utilisateur |
Min(input="column") |
Valeur minimale | Fréquence cardiaque la plus faible enregistrée par un appareil portable |
Max(input="column") |
Valeur maximale | Montant de transaction le plus élevé par session |
StddevPop(input="column") |
Écart type de population | Variabilité quotidienne des transactions entre tous les clients |
StddevSamp(input="column") |
Exemple d’écart type | Variabilité des taux de clics de campagne publicitaire |
VarPop(input="column") |
Variance de la population | Propagation des lectures de capteurs pour les appareils IoT dans une usine |
VarSamp(input="column") |
Variance d'échantillon | Répartition des évaluations de films sur un groupe échantillonné |
ApproxCountDistinct(input="column", relativeSD=0.05) |
Nombre unique approximatif | Nombre distinct d’articles achetés |
ApproxPercentile(input="column", percentile=0.95, accuracy=100) |
Percentile approximatif | Latence de réponse p95 |
First(input="column") |
Première valeur | Horodatage de première connexion |
Last(input="column") |
Dernière valeur | Montant d’achat le plus récent |
FirstN(input="column", n=3) |
Premières n valeurs sous forme de tableau |
Les trois premiers produits vus lors d’une session |
LastN(input="column", n=3) |
Dernières n valeurs en tant que tableau |
Trois états les plus récents dans les cas de soutien |
FirstDistinct(input="column", n=3) |
Premièrement n , des valeurs distinctes en tant que tableau |
Trois premières catégories de produits distinctes examinées |
LastDistinct(input="column", n=3) |
Dernières n valeurs distinctes en tant que tableau |
Trois catégories de marchands distinctes les plus récentes |
Note
First, Last, FirstN, LastN, FirstDistinct, , et LastDistinct incluent par défaut des valeurs nulles. Pour ignorer les valeurs Null, ajoutez un filter_condition élément qui exclut explicitement les colonnes d’entrée qui sont null.
FirstN, LastN, , et LastDistinct utiliser les timeseries_column caractéristiques pour ordonner les lignes d’entrée et retourner un tableau contenant jusqu’à nFirstDistinctdes valeurs. Le n paramètre doit être un entier positif.
FirstN et FirstDistinct sélectionner des valeurs de la plus ancienne à la plus récente.
LastN et LastDistinct sélectionner les valeurs de la plus récente à la plus ancienne, puis retourner les valeurs sélectionnées dans l’ordre temporel.
FirstDistinct et LastDistinct supprimez les valeurs en double lors de la sélection des valeurs dans cette direction.
Par exemple, si les lignes sources d’une entité sont ordonnées par event_time , ["A", "A", "B", "C", "B", "B"]les fonctions suivantes retournent :
| Function | Résultat |
|---|---|
FirstN(input="event_type", n=3) |
["A", "A", "B"] |
LastN(input="event_type", n=3) |
["C", "B", "B"] |
FirstDistinct(input="event_type", n=3) |
["A", "B", "C"] |
LastDistinct(input="event_type", n=3) |
["A", "C", "B"] |
FirstN, LastN, FirstDistinct, et LastDistinct nécessitent databricks-feature-engineering la version 0.17.0 ou ultérieure.
CustomUDF
CustomUDFapplique une fonction Python (UDF) enregistrée dans le catalogue Unity à chaque ligne. Utilisez-le pour transformer les entrées de requêtes ou combiner les valeurs des caractéristiques. Il n’agrége pas les lignes ni ne définit de fenêtre temporelle.
CustomUDF(
    function_name="main.ecommerce.log_amount_udf",
    input_bindings={"amount": "transaction_amount"},
)
input_bindings associe chaque nom de paramètre UDF à une entrée. Pour RequestSource, l’entrée est un nom de colonne source. Pour FeatureViewSource, c’est une référence de fonctionnalité en amont. Assignez chaque paramètre UDF, y compris les paramètres par défaut. Les types d’entrée doivent correspondre exactement aux types de paramètres UDF, sans distribution numérique implicite. Utilisez des types d’entrée et de retour scalaires.
| Source | Behavior |
|---|---|
RequestSource |
Transforme les colonnes à partir du DataFrame d’entraînement ou de la requête d’inférence. |
FeatureViewSource |
Combine les valeurs des caractéristiques en amont. Voir FeatureViewSource. |
Les fonctionnalités soutenues CustomUDF par Delta ne peuvent pas être matérialisées ni diffusées en ligne. Pour transformer les valeurs de caractéristiques soutenues par table pour l’entraînement et le service, définissez une agrégation ou une caractéristique de sélection de colonnes soutenue par Delta et référencez-la via FeatureViewSource.
CustomUDF n’est pas supporté par StreamSource. Pour transformer la sortie d’une fonctionnalité de streaming, référencez-la via FeatureViewSource.
CustomUDF avec RequestSource nécessite databricks-feature-engineering la version 0.17.0 ou ultérieure.
Pour utiliser un CustomUDF, il faut le EXECUTE privilège sur la UDF, le USE CATALOG privilège sur son catalogue parent, et le USE SCHEMA privilège sur son schéma parent.
L’exemple suivant utilise NumPy pour calculer log(1 + amount), réduisant l’échelle des montants importants de transactions. Exécutez-le sur un calcul serverless avec des dépendances UDF personnalisées activées. Le main.ecommerce schéma doit exister.
spark.sql("""
CREATE OR REPLACE FUNCTION main.ecommerce.log_amount_udf(amount DOUBLE)
RETURNS DOUBLE
LANGUAGE PYTHON
ENVIRONMENT (
  dependencies = '["numpy==1.26.4"]',
  environment_version = '5'
)
AS $$
import numpy as np

if amount is None or not np.isfinite(amount) or amount < 0:
    return None
return float(np.log1p(amount))
$$
""")
Enregistrer une fonctionnalité qui lie la colonne transaction_amount de requête au paramètre amountUDF :
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import (
    CustomUDF, FieldDefinition, RequestSource, ScalarDataType,
)

fe = FeatureEngineeringClient()

log_transaction_amount = fe.create_feature(
    source=RequestSource(
        schema=[
            FieldDefinition(name="transaction_amount", data_type=ScalarDataType.DOUBLE),
        ]
    ),
    function=CustomUDF(
        function_name="main.ecommerce.log_amount_udf",
        input_bindings={"amount": "transaction_amount"},
    ),
    catalog_name="main",
    schema_name="ecommerce",
    name="log_transaction_amount",
)
Les UDF ENVIRONMENT configurent les dépendances pour le calcul hors ligne. Pour la livraison en ligne, déclarez également les colis dans create_feature_spec(extra_pip_requirements=...) ou log_model(extra_pip_requirements=...). Elles ne sont pas copiées automatiquement depuis l’UDF.
Voir Dépendances de service de fonctionnalités et dépendances de modèles.
CustomUDF les fonctionnalités ne peuvent pas être matérialisées. Les UDF à commande et à fonctionnalités fonctionnent à la demande pendant la formation et le service. Chaque UD dans une chaîne de dépendances ajoute du calcul, donc gardez les fonctions et chaînes petites. Les UDF doivent gérer les entrées manquantes, qui peuvent être None hors ligne ou NaN en ligne.
Pour des conseils sur la gestion des valeurs manquantes, voir Comment gérer les valeurs manquantes des caractéristiques.
ColumnSelection (passage)
ColumnSelection sélectionne une seule colonne à partir d’une source sans appliquer d’agrégation. Il est encapsulé directement dans le paramètre (pas à l’intérieur functionAggregationFunction). Le type de retour est déduit du schéma source.
| Function | Description | Exemple de cas d’usage |
|---|---|---|
ColumnSelection("col") |
Dernière valeur d’une colonne (aucune agrégation) | Catégorie de fournisseur la plus récente, pass-through d’un champ de demande |
ColumnSelection Prend en charge les sources de données suivantes :
-
DeltaTableSource: retourne la valeur la plus récente par clé d’entité via une jointure à un point dans le temps (aucune agrégation de fenêtre de recherche). -
StreamSource: Retourne la dernière valeur par clé d’entité du Stream (sans agrégation de fenêtre de rétrospection). -
RequestSource: passe par la valeur fournie au moment de l’inférence (ou extraite du DataFrame étiqueté au moment de l’entraînement).
from databricks.feature_engineering.entities import (
    ColumnSelection, DeltaTableSource, Feature, FieldDefinition,
    RequestSource, ScalarDataType,
)

delta_source = DeltaTableSource(
    catalog_name="main", schema_name="feature_store", table_name="transactions",
)

request_source = RequestSource(
    schema=[
        FieldDefinition(name="session_duration", data_type=ScalarDataType.DOUBLE),
    ]
)

# ColumnSelection from a Delta table
latest_amount = Feature(
    source=delta_source,
    function=ColumnSelection("amount"),
    entity=["user_id"],
    timeseries_column="transaction_time",
    name="latest_transaction_amount",
)

# ColumnSelection from a RequestSource
session_feature = Feature(
    source=request_source,
    function=ColumnSelection("session_duration"),
    name="session_duration",
)
Exemple : fonctionnalités d’agrégation et de sélection de colonnes
L’exemple suivant montre les fonctionnalités définies sur la même source de données.
from databricks.feature_engineering.entities import (
    AggregationFunction, Feature, Sum, Avg, ApproxCountDistinct,
    ColumnSelection, RollingWindow,
)
from datetime import timedelta

window = RollingWindow(window_duration=timedelta(days=7))

sum_feature = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(Sum(input="amount"), window),
)

avg_feature = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(Avg(input="amount"), window),
)

distinct_count = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(ApproxCountDistinct(input="product_id", relativeSD=0.01), window),
)

# Column selection (no aggregation, no time window)
latest_amount = Feature(
    source=source,
    function=ColumnSelection("amount"),
    entity=["user_id"],
    timeseries_column="event_time",
    name="latest_amount",
)
Fonctionnalités avec des conditions de filtre
Le filter_condition paramètre vous permet de filtrer les lignes de la table source avant l’informatique des agrégations. Cela fonctionne comme une clause SQL WHERE appliquée avant le regroupement et l’agrégation des données.
Note
filter_condition filtre les lignes avant l’agrégation, comme une clause SQL WHERE appliquée avant GROUP BY. Elle ne modifie pas la granularité, qui est toujours définie par entity la définition de fonctionnalité.
Les filtres sont utiles lors de l’utilisation de tables sources volumineuses qui incluent un super-ensemble de données nécessaire pour le calcul des fonctionnalités et réduisent le besoin de créer des vues distinctes sur ces tables.
from databricks.feature_engineering.entities import AggregationFunction, Sum, Count, RollingWindow, DeltaTableSource
from datetime import timedelta

# Source with filter applied at the source level
high_value_transactions = DeltaTableSource(
    catalog_name="main",
    schema_name="ecommerce",
    table_name="transactions",
    filter_condition="amount > 100",  # Only transactions over $100
)

high_value_sales = Feature(
    source=high_value_transactions,
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=30))),
)

# Multiple conditions
completed_orders_source = DeltaTableSource(
    catalog_name="main",
    schema_name="ecommerce",
    table_name="orders",
    filter_condition="status = 'completed' AND payment_method = 'credit_card'",
)

completed_orders = Feature(
    source=completed_orders_source,
    entity=["user_id"],
    timeseries_column="order_time",
    function=AggregationFunction(Count(input="order_id"), RollingWindow(window_duration=timedelta(days=7))),
)

# Filter on a StreamSource
from databricks.feature_engineering.entities import StreamSource

purchase_stream = StreamSource(
    full_name="main.ecommerce.transactions_stream",
    filter_condition="value.event_type = 'purchase'",
)

purchase_total = Feature(
    source=purchase_stream,
    entity=["value.user_id"],
    timeseries_column="value.event_time",
    function=AggregationFunction(Sum(input="value.amount"), RollingWindow(window_duration=timedelta(hours=1))),
)
Sources de données
DeltaTableSource
DeltaTableSource est un objet Python éphémère utilisé pour définir la façon dont les fonctionnalités sont calculées à partir d’une table source. Elle ne crée pas de table. Il spécifie la configuration pour lire les données et agréger les fonctionnalités.
DeltaTableSource(
    catalog_name: str,                              # Required: Catalog name
    schema_name: str,                               # Required: Schema name
    table_name: str,                                # Required: Table name
    filter_condition: Optional[str] = None,         # Optional: SQL WHERE clause to filter source data
    transformation_sql: Optional[str] = None,       # Optional: SQL SELECT expression for column transformations
    dataframe_schema: Optional[str] = None,         # Required if transformation_sql is set: schema of the resulting DataFrame
    lateness: Optional[SourceLateness] = None,       # Optional: Expected source settling time
)
Paramètres :
-
catalog_name, ,schema_name:table_nameidentifier la table Delta source dans le catalogue Unity. -
filter_condition: clause SQLWHEREappliquée avant l’agrégation. Exemple :"status = 'completed'". -
transformation_sql: expression SQLSELECTappliquée à la table source. Utilisez-la pour renommer des colonnes, des types de cast ou des colonnes dérivées de calcul avant l’agrégation. En cas d’omission, toutes les colonnes sont sélectionnées (*). Exemple :"user_id, CAST(amount AS DOUBLE) AS amount, event_time". -
dataframe_schema: schéma du DataFrame résultant après les transformations, au format JSON Spark StructType (à partir dedf.schema.json()). Obligatoire sitransformation_sqlest fourni. Cela indique au système les noms et les types de colonnes résultant de votre transformation. -
lateness: UnSourceLatenessobjet qui décrit le temps que la source met normalement à devenir complète en temps d’événement. Si elle est omise, la source est considérée comme complète immédiatement.
Lorsque les deux filter_condition et transformation_sql sont définis, la requête résultante est la suivante : SELECT {transformation_sql} FROM {table} WHERE {filter_condition}.
SourceLateness.settling_delay est la méthode recommandée pour simuler pendant l’entraînement un délai ETL constant qui affecte la matérialisation en ligne. Azure Databricks recule le temps d’évaluation d’entraînement éligible de cette durée afin qu’un exemple d’entraînement n’utilise pas de données qui auraient encore été en transit en ligne. Lors de la matérialisation, Azure Databricks attend la même durée avant de publier une fenêtre complétée et sert la dernière fenêtre complétée pendant la période intermédiaire.
Par exemple, supposons qu’un travail ETL quotidien se termine 8 heures après minuit dans un fuseau horaire local où minuit correspond à 07h00 UTC. Utilisez un délai de déposement de 8 heures et un décalage de fenêtre de 7 heures :
from datetime import timedelta
from databricks.feature_engineering.entities import (
    DeltaTableSource,
    SourceLateness,
    TumblingWindow,
)

source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    lateness=SourceLateness(settling_delay=timedelta(hours=8)),
)

window = TumblingWindow(
    window_duration=timedelta(days=1),
    offset=timedelta(hours=7),
)
Note
Le timeseries_column doit être de type TimestampType ou TimestampNTZType.
DateType n’est pas supporté pour les séries temporelles ; caster la colonne en TimestampType premier (par exemple, avec transformation_sql).
Exemple : Utilisation transformation_sql pour les transformations de colonne
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="raw_events",
    transformation_sql="user_id, CAST(price_cents AS DOUBLE) / 100 AS price, event_time",
    filter_condition="event_type = 'purchase'",
    dataframe_schema=spark.sql(
        "SELECT user_id, CAST(price_cents AS DOUBLE) / 100 AS price, event_time FROM main.analytics.raw_events LIMIT 0"
    ).schema.json(),
)
Exemple : dérivation transformation_sql et dataframe_schema utilisation d’un DataFrame PySpark
Vous pouvez écrire votre transformation en tant que requête PySpark, puis extraire le schéma du DataFrame résultant :
df = spark.sql(f"""
  SELECT user_id, CAST(amount AS DOUBLE) / 100 AS amount_dollars, event_time
  FROM main.analytics.events
  WHERE event_date >= date_sub(current_date(), 7)
  LIMIT 0
""")

# Use df.schema.json() as the dataframe_schema
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    transformation_sql="user_id, CAST(amount AS DOUBLE) / 100 AS amount_dollars, event_time",
    filter_condition="event_date >= date_sub(current_date(), 7)",
    dataframe_schema=df.schema.json(),
)
Expressions prises en charge transformation_sql
Les mêmes règles s’appliquent à transformation_sql sur DeltaTableSource et StreamSource.
transformation_sql prend en charge toutes les expressions ligne par ligne ; les opérations évaluées indépendamment pour chaque ligne. Ils ne modifient pas le nombre de lignes ni la correspondance un pour un avec la source. Les expressions ligne par ligne incluent les renommages de colonnes, les casts, les opérations arithmétiques, et plus encore.
Les opérations qui modifient la forme ou le nombre de lignes ne sont pas prises en charge, comme les agrégations telles que SUM() ou COUNT(). Utilisez AggregationFunction plutôt la définition de fonctionnalité.
DeltaTableSource.from_sql()
En guise de commodité, vous pouvez créer une DeltaTableSource requête SQL. La méthode analyse la requête pour extraire automatiquement le nom de la table, transformation_sqlet filter_condition.
DeltaTableSource.from_sql(
    sql: str,                           # Required: SQL SELECT query
    spark: SparkSession,                # Required: active SparkSession (for schema inference)
) -> DeltaTableSource
Seules les requêtes simples SELECT ... FROM ... [WHERE ...] sont prises en charge. Le code SQL complexe (JOIN, sous-requêtes, CTEs, UNION) est rejeté. Pour les requêtes complexes, créez DeltaTableSource directement avec transformation_sql et filter_condition.
from databricks.feature_engineering.entities import (
    AggregationFunction,
    DeltaTableSource,
    Feature,
    Sum,
    TumblingWindow,
)

source = DeltaTableSource.from_sql(
    spark=spark,
    sql=f"SELECT customer_id, event_ts, amount * 2 AS doubled_amount, amount FROM {CATALOG}.{SCHEMA}.{TABLE}",
)

feature = Feature(
    source=source,
    function=AggregationFunction(Sum(input="doubled_amount"), time_window=TumblingWindow(window_duration=timedelta(days=7))),
    entity=["customer_id"], timeseries_column="event_ts",
)
Itérer avec to_dataframe()
Permet source.to_dataframe() d’afficher un aperçu des données qui seront utilisées pour le calcul des fonctionnalités. Cela est utile pour itérer filter_condition et transformation_sql jusqu’à ce qu’ils produisent les résultats attendus.
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    filter_condition="event_type = 'purchase'",
)

# Preview the filtered source data
source.to_dataframe().display()
Présentation des entités
Les colonnes d’entité définissent le niveau d’agrégation de vos fonctionnalités. Elles sont spécifiées sur la Feature définition, et non sur DeltaTableSource. Les entités déterminent :
-
Comment les données sont regroupées : les fonctionnalités sont agrégées par combinaison unique de valeurs d’entité (comme
GROUP BYdans SQL) - Structure de clé primaire : chaque combinaison d’entités unique entraîne une ligne de fonctionnalités calculées
Exemple : fonctionnalités au niveau du client
Le code suivant agrège les fonctionnalités au niveau du client (une ligne par client) :
from databricks.feature_engineering.entities import DeltaTableSource

source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="user_events",
)

Feature(
    source=source,
    entity=["user_id"],                # Features aggregated per user
    timeseries_column="event_time",    # Timestamp for time windows
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)
Exemple : fonctionnalités au niveau du Customer-Store
Pour agréger des fonctionnalités à un niveau plus détaillé (une ligne par combinaison de magasin de clients), utilisez plusieurs colonnes d’entité :
source = DeltaTableSource(
    catalog_name="main",
    schema_name="retail",
    table_name="transactions",
)

Feature(
    source=source,
    entity=["user_id", "store_id"],  # Features aggregated per user-store pair
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)
Lorsque vous avez besoin de fonctionnalités à différents niveaux d’agrégation (par exemple, au niveau du client et au niveau du magasin client), utilisez différentes entity valeurs dans vos définitions de fonctionnalités. La même DeltaTableSource chose peut être partagée entre les fonctionnalités avec différentes configurations d’entité.
StreamSource
StreamSource fait référence à un flux. Le flux contient la configuration de connexion, d’authentification, de schéma et d’ingestion pour la source de diffusion en continu. Pour Kafka, les références de colonne dans les définitions de fonctionnalités doivent être préfixées value. ou key. indiquer la partie du message à lire.
StreamSource(
    full_name: str,                       # Required: Three-part Stream name (catalog.schema.stream)
    filter_condition: Optional[str] = None,      # Optional: SQL WHERE clause applied before aggregation
    transformation_sql: Optional[str] = None,    # Optional: SQL SELECT expression for column transformations
    dataframe_schema: Optional[str] = None,      # Required if transformation_sql is set: schema of the resulting DataFrame
    lateness: Optional[SourceLateness] = None,    # Optional: Expected source settling time
)
Paramètres :
-
full_name: nom complet en trois parties d’un flux (par exemple,"my_catalog.my_schema.my_stream"). -
filter_condition(facultatif) : clause SQLWHEREappliquée au flux de données avant l’agrégation, à l’aide de références de colonnes avec préfixe point (par exemple)."value.event_type = 'purchase'" -
transformation_sql(optionnel) : Une expression SQLSELECTappliquée avant l’agrégation ou la sélection de colonnes, en utilisant des références préfixées à lakeystructure et.valuePrend en charge les mêmes expressions rangées queDeltaTableSource. Si elle est omise, la source utilise toutes les colonnes (*). -
dataframe_schema: Le schéma JSON SparkStructTypede la sortie projetée. Obligatoire si vous définisseztransformation_sql. -
lateness: UnSourceLatenessobjet qui décrit la durée normale de la fin du flux en temps d’événement. VoirSourceLateness.settling_delay.
from databricks.feature_engineering.entities import StreamSource

stream_source = StreamSource(
    full_name="my_catalog.my_schema.my_stream",
    filter_condition="value.event_type = 'purchase'",
)
On dérive dataframe_schema en faisant tourner la projection contre la table d’ingestion du Stream, qui expose les key structures et value .
transformation_sql = (
    "value.amount * value.conversion_rate AS converted_amount, "
    "struct(value.user_id AS user_id, value.event_time AS time) AS event"
)

ingestion_table = "my_catalog.my_schema.events_ingestion"
dataframe_schema = spark.sql(
    f"SELECT {transformation_sql} FROM {ingestion_table} LIMIT 0"
).schema.json()

stream_source = StreamSource(
    full_name="my_catalog.my_schema.my_stream",
    transformation_sql=transformation_sql,
    dataframe_schema=dataframe_schema,
)
RequestSource
RequestSource définit un schéma pour les données fournies au moment de l’inférence dans la charge utile de la requête plutôt qu’à partir d’une table pré-matérialisée. Pendant l’entraînement, ces colonnes sont extraites du DataFrame étiqueté passé à create_training_set. Pendant le service de modèle, l’appelant doit les inclure dans la charge utile de requête HTTP.
RequestSource peut être utilisé avec les fonctions CustomUDF ou Column Selection Feature View. Il ne prend pas en charge les fonctions d’agrégation ou les fenêtres de temps.
Définition du schéma
Définissez le schéma comme une liste d’objets, chacun spécifiant un nom de FieldDefinition colonne et un ScalarDataType:
from databricks.feature_engineering.entities import (
    FieldDefinition, RequestSource, ScalarDataType,
)

request_source = RequestSource(
    schema=[
        FieldDefinition(name="transaction_amount", data_type=ScalarDataType.DOUBLE),
        FieldDefinition(name="vendor_id", data_type=ScalarDataType.STRING),
        FieldDefinition(name="transaction_id", data_type=ScalarDataType.STRING),
        FieldDefinition(name="transaction_time", data_type=ScalarDataType.DATE),
    ]
)
Types de données prises en charge
RequestSourceprend en charge les types scalaires définis dans ScalarDataType: INTEGER, , FLOATBOOLEANSTRING, DOUBLE, LONG, TIMESTAMP, , DATE. SHORT Les types complexes tels que les tableaux, les cartes et les structs ne sont pas pris en charge.
Comment les données de requête sont hydratées
| Context | Behavior |
|---|---|
Formation (create_training_set) |
Les colonnes sont extraites du DataFrame étiqueté. Les types sont validés par rapport au schéma déclaré. Les incompatibilités déclenchent une erreur (aucune conversion implicite). |
| Service (point de terminaison de modèle) | Les colonnes sont extraites ou dataframe_recordsdataframe_split dans la requête HTTP. Les valeurs JSON sont converties en types déclarés (par exemple, le nombre JSON → DOUBLE). |
Signature de modèle
Lorsqu’un modèle est enregistré à l’aide log_model d’un jeu d’entraînement qui inclut des RequestSource fonctionnalités, les RequestSource colonnes sont ajoutées à la signature du modèle MLflow en fonction des entrées requises. Cela signifie que le schéma d’API du point de terminaison de service reflète les champs que les appelants doivent fournir au moment de l’inférence.
FeatureViewSource
FeatureViewSource utilise les sorties d’autres Feature Views comme entrées pour un CustomUDFfichier . L’enchaînement des fonctionnalités crée un graphe acyclique orienté (DAG). Par exemple, une caractéristique de marge peut combiner les agrégats de revenus et de coûts, et une autre fonctionnalité peut transformer la marge.
Utilisez databricks-feature-engineering la version 0.18.0 ou ultérieure pour FeatureViewSource.
Passez une liste d’objets Feature à features, pas des chaînes de noms de caractéristiques. Récupérer les caractéristiques enregistrées avec get_feature. Dans input_bindings, utilise la full_namefonction de chaque élément enregistré . Pour une fonctionnalité locale non enregistrée, utilisez sa name à la place.
L’exemple suivant suppose deux caractéristiques enregistrées, revenue_sum_7d et cost_sum_7d, qui retournent DOUBLE des valeurs par customer_id et utilisent event_time pour le calcul à un moment donné :
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import CustomUDF, FeatureViewSource

fe = FeatureEngineeringClient()
revenue = fe.get_feature(full_name="main.ecommerce.revenue_sum_7d")
cost = fe.get_feature(full_name="main.ecommerce.cost_sum_7d")

spark.sql("""
CREATE OR REPLACE FUNCTION main.ecommerce.margin_udf(revenue DOUBLE, cost DOUBLE)
RETURNS DOUBLE
LANGUAGE PYTHON
AS $$
import math

if revenue is None or cost is None:
    return None
if not math.isfinite(revenue) or not math.isfinite(cost) or revenue <= 0:
    return None
return (revenue - cost) / revenue
$$
""")

margin = fe.create_feature(
    source=FeatureViewSource(features=[revenue, cost]),
    function=CustomUDF(
        function_name="main.ecommerce.margin_udf",
        input_bindings={"revenue": revenue.full_name, "cost": cost.full_name},
    ),
    catalog_name="main",
    schema_name="ecommerce",
    name="margin",
)
Les restrictions suivantes s’appliquent :
- Seule
CustomUDFest prise en charge comme fonction. Les fonctionnalités en amont peuvent être des agrégations, des sélections de colonnes ou d’autresCustomUDFfonctionnalités. - Omets
entityettimeseries_columnsur la caractéristique deriva. Chaque fonctionnalité en amont conserve sa propre entité, son horodatage et sa définition de fenêtre. - Une fonctionnalité a une seule source. Pour combiner une valeur de requête avec une caractéristique à support de table, on définit une
RequestSourcecaractéristique et on référence les deux viaFeatureViewSource. - Chaque caractéristique en amont déclarée doit être utilisée dans
input_bindings. Les cycles ne sont pas autorisés. - Enregistrez les caractéristiques en amont avant d’enregistrer la caractéristique dérivée. Des graphes locaux non enregistrés peuvent être utilisés avec
create_training_setpour l’expérimentation. - Pour la formation ou le service, vous avez besoin du
READ FEATUREprivilège ouMANAGEsur la caractéristique dérivée et ses caractéristiques transitives en amont. Utilisez des noms de caractéristiques distincts sur le graphique pour l’enregistrement et le service, même entre catalogues ou schémas. - Une fonctionnalité peut faire référence à jusqu’à 20 fonctionnalités directes en amont. Les graphes enregistrés prennent en charge une profondeur maximale de cinq caractéristiques le long d’un chemin de dépendance, y compris la caractéristique de base.
-
FeatureViewSourceLes caractéristiques ne peuvent pas être matérialisées ou évaluées aveccompute_features. Utilisez-lescreate_training_setpour les évaluer hors ligne. Pour le service en ligne, matérialisez plutôt les fonctionnalités en amont supportées par la table.
Pour l’évaluation des dépendances et la sélection des sorties, voir Entraîner avec les fonctionnalités FeatureViewSource. Pour le déploiement, voir Fonctionnalités dérivées de Serve.
API d’apprentissage et d’inférence
create_training_set et score_batch calculer des valeurs de fonctionnalité correctes à la demande à partir des données sources. Pour les fonctionnalités qui prennent en charge la matérialisation hors connexion, telles que les agrégations de fenêtre glissantes sur les sources de table delta, la matérialisation des fonctionnalités d’abord dans un magasin hors connexion améliore les performances des deux opérations. Lorsque des fonctionnalités hors connexion matérialisées sont disponibles, les opérations lisent les données hors connexion précomputées au lieu de recomputer des valeurs de fonctionnalités à partir de la source. Consultez Matérialiser les vues des fonctionnalités pour matérialiser les fonctionnalités dans un magasin hors connexion.
create_training_set()
Crée un jeu de données d’entraînement avec un calcul de fonctionnalité correct dans le temps. Pour plus d’informations, consultez Entraîner des modèles avec des vues de fonctionnalités.
FeatureEngineeringClient.create_training_set(
    df: DataFrame,                                # DataFrame with training data
    features: Optional[List[Feature]],            # List of Feature objects
    label: Union[str, List[str], None],           # Label column name(s)
    exclude_columns: Optional[List[str]] = None,  # Optional: columns to exclude
) -> TrainingSet
log_model()
Consigne un modèle avec des métadonnées de fonctionnalité pour le suivi de la traçabilité et la recherche automatique des fonctionnalités pendant l’inférence. Pour plus d’informations, consultez Entraîner des modèles avec des vues de fonctionnalités.
FeatureEngineeringClient.log_model(
    model,                                    # Trained model object
    artifact_path: str,                       # Path to store model artifact
    flavor: ModuleType,                       # MLflow flavor module (e.g., mlflow.sklearn)
    training_set: TrainingSet,                # TrainingSet used for training
    registered_model_name: Optional[str],     # Optional: register model in Unity Catalog
)
score_batch()
Effectue l’inférence de lots hors connexion avec la recherche automatique des fonctionnalités. Utilise les métadonnées de fonctionnalité stockées avec le modèle pour calculer des fonctionnalités correctes dans le temps, garantissant ainsi la cohérence avec l’entraînement.
FeatureEngineeringClient.score_batch(
    model_uri: str,                           # URI of logged model (e.g., "models:/catalog.schema.model/1")
    df: DataFrame,                            # DataFrame with entity keys and timestamps
) -> DataFrame
Le DataFrame d’entrée doit contenir les colonnes d’entité et de série chronologique utilisées pendant l’entraînement. Les fonctionnalités sont automatiquement calculées à partir des données sources.
fe = FeatureEngineeringClient()

# Batch scoring with automatic feature lookup
predictions = fe.score_batch(
    model_uri="models:/main.ecommerce.fraud_model/1",
    df=inference_df,
)
predictions.display()
Fenêtres Délai
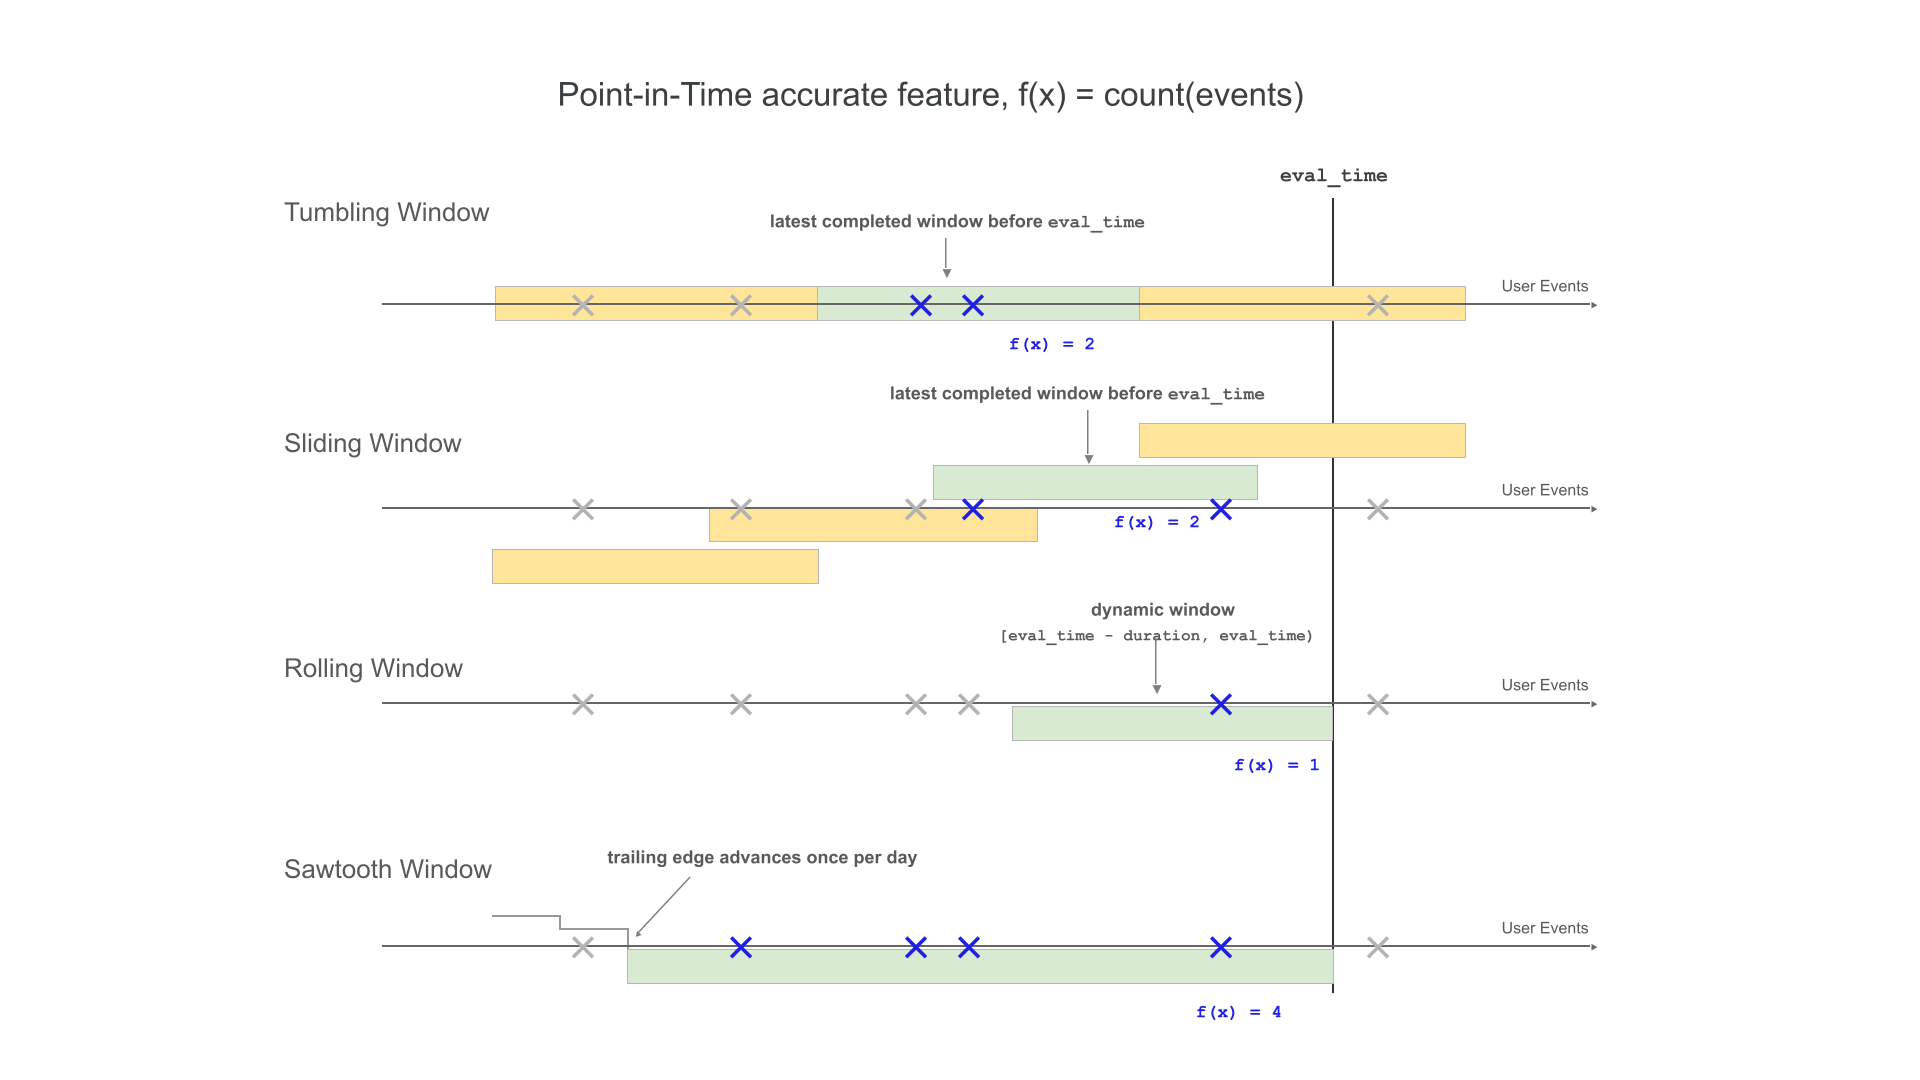
Les Feature Views prennent en charge quatre types de fenêtres pour contrôler le comportement de rétrospection lors des agrégations basées sur des fenêtres temporelles. Les types de fenêtres disponibles dépendent de la source de la fonctionnalité : les fonctionnalités source en streaming peuvent utiliser des fenêtres roulantes et en dents de scie, et les fonctionnalités de la source batch peuvent utiliser des fenêtres roulantes, roulantes et coulissantes.
- La restauration des fenêtres revient à partir de l’heure de l’événement. La durée et le délai sont définis explicitement.
- Les fenêtres tumbling sont fixes et ne se chevauchent pas. Chaque point de données appartient exactement à une fenêtre.
- Les fenêtres glissantes sont des fenêtres temporelles mobiles qui se chevauchent, avec un intervalle de glissement configurable.
- Les fenêtres en dents de scie gardent une longue fenêtre de rétrospection fraîche au-dessus d’une source en streaming grâce à un chemin hybride batch et streaming. Voir la fenêtre Sawtooth.
L’illustration suivante montre les fenêtres à roulement, glissement, roulement et fenêtres dentées de scie.
Chronométrage de la fenêtre temporelle
À utiliser delay pour évaluer une fenêtre à un moment analytique antérieur. Par exemple, une fenêtre de 30 jours avec un délai de 7 jours calcule une valeur de 30 jours à partir d’une semaine avant la date d’évaluation.
delay est indépendant du temps d’arrivée de la source. Pour modéliser le temps que met la source à arriver, SourceLateness.settling_delay configurez à la place.
Lorsque les deux décors sont présents, ils composent. Azure Databricks considère la fenêtre comme complète après le délai de règlement source et l’évalue en utilisant le délai analytique.
À utiliser offset pour modifier l’alignement des limites fixes des fenêtres. Par défaut, les fenêtres à roulement et les fenêtres coulissantes sont alignées sur minuit UTC. Par exemple, un décalage de 22 heures aligne une frontière quotidienne à 22h00 UTC. Pour approximer les frontières dans un fuseau horaire local, configurez un décalage statique par rapport à l’UTC. Le décalage ne s’ajuste pas à l’heure avancée, ne décale pas l’heure d’évaluation, ni ne modélise les données arrivant en retard.
Le tableau suivant résume le support de ces champs :
| Champ | Fenêtres prises en charge | Contrainte |
|---|---|---|
delay |
Rouler, rouler et glisser | Doit être non négatif datetime.timedelta |
offset |
Roulades et glissades | Doit être non négatif et plus court que la période* |
SourceLateness.settling_delay |
Caractéristiques de roulement, de roulement et de glissade | Doit être non négatif datetime.timedelta |
start_time |
Rouler, rouler et glisser | Ça doit être un datetime.datetime |
*Période : Pour une fenêtre à bascule, le décalage doit être plus court que window_duration. Pour une fenêtre coulissante, elle doit être plus courte que slide_duration.
Heure de début
Utilisez start_time pour définir la première limite d’événement en temps UTC à laquelle une fonctionnalité peut émettre une sortie. La frontière est inclusive.
start_time Sorties de gates. Il ne restreint pas les lignes sources historiques qu’une fenêtre peut lire, et ne modifie pas l’alignement des fenêtres. Si start_time elle se situe entre deux frontières alignées, la première sortie éligible à fenêtre fixe est la frontière suivante.
Avec start_time, des fenêtres à durée fixe peuvent émettre avant qu’une durée complète de fenêtre ne soit écoulée dans la source. Ces premières sorties utilisent l’historique des sources disponibles. Par exemple, considérons une fenêtre glissante avec un an window_duration et un slide_durationjour , sur une source dont les données commencent le 1er janvier 2024 :
- Sans
start_time, la fonctionnalité est émise pour la première fois le 1er janvier 2025, une fois qu’une fenêtre complète d’un an peut être formée. - Prévue
start_timeau 21 août 2024, la rubrique sera diffusée pour la première fois le 21 août 2024. Cette production ne couvre que l’historique des sources disponible jusqu’à présent, à partir du 1er janvier 2024. La fenêtre atteint sa période complète d’un an le 1er janvier 2025, et produit dès lors des résultats complets.
Parce que start_time cela ne modifie pas l’alignement des fenêtres, une valeur entre deux frontières alignées ne crée pas une nouvelle frontière. Pour une fenêtre de chute avec des limites quotidiennes à minuit UTC, a start_time de 06h00 UTC émet d’abord à la frontière suivante de minuit. Un start_time qui atterrit exactement sur une frontière émet à cette frontière, car la frontière est inclusive.
Si start_time est déplacé, les fenêtres à roulement et les fenêtres coulissantes à durée fixe s’émettent d’abord à une limite alignée après la formation d’une fenêtre complète. Les fenêtres coulissantes et roulantes à vie sont émises dès que des données sources éligibles existent.
Note
start_time est prise en charge pour les fonctionnalités batch utilisées DeltaTableSource avec des fenêtres roulantes, à rouler ou coulissantes. Il n’est pas supporté par StreamSource ou SawtoothWindow.
Par exemple:
from datetime import datetime, timedelta
from databricks.feature_engineering.entities import SlidingWindow

window = SlidingWindow(
    window_duration=timedelta(days=365),
    slide_duration=timedelta(days=1),
    start_time=datetime(2024, 8, 21),
)
Fenêtre roulante
Note
RollingWindow a été précédemment nommé ContinuousWindow. Si vous migrez à partir d’une version antérieure du SDK, mettez à jour vos importations en conséquence.
Les fenêtres propagées sont up-to-date et agrégats en temps réel, généralement utilisés sur les données de streaming. Dans les pipelines de diffusion en continu, la fenêtre propagée émet une nouvelle ligne uniquement lorsque le contenu de la fenêtre de longueur fixe change, par exemple lorsqu’un événement entre ou quitte. Lorsqu’une fonctionnalité de fenêtre propagée est utilisée dans les pipelines d’apprentissage, un calcul précis de fonctionnalité à un point dans le temps est effectué sur les données sources à l’aide de la durée de la fenêtre de longueur fixe qui précède immédiatement l’horodatage d’un événement spécifique. Cela permet d’empêcher le déséquilibre en ligne-hors ligne ou les fuites de données. Les fonctionnalités au moment T agrègent les événements à partir de [T − la durée, T).
class RollingWindow(TimeWindow):
    window_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    start_time: Optional[datetime.datetime] = None
Le tableau suivant répertorie les paramètres d’une fenêtre propagée. Les heures de début et de fin de la fenêtre sont basées sur ces paramètres comme suit :
- Heure de début :
evaluation_time - window_duration - delay(inclusive) - Heure de fin :
evaluation_time - delay(exclusif)
| Paramètre | Contraintes |
|---|---|
delay (facultatif) |
Ça doit être ≥ 0. Ça recule la fenêtre analytique par rapport au timestamp d’évaluation. Utilisez SourceLateness.settling_delay pour modéliser une base de référence cohérente pour le délai d’arrivée de la source dans votre flux. |
window_duration |
Doit être > 0 |
start_time (facultatif) |
Première frontière d’événement-temps à laquelle la caractéristique peut émettre une sortie. |
from databricks.feature_engineering.entities import RollingWindow
from datetime import timedelta

# Look back 7 days from evaluation time
window = RollingWindow(window_duration=timedelta(days=7))
Définissez une fenêtre propagée avec un délai à l’aide du code ci-dessous.
# Compute a 7-day value as of one day before the evaluation time
window = RollingWindow(
    window_duration=timedelta(days=7),
    delay=timedelta(days=1)
)
Exemples de fenêtres propagées
window_duration=timedelta(days=7): cela crée une fenêtre de rétrospection de 7 jours se terminant au moment d'évaluation actuel. Pour un événement à 2h00 le jour 7, cela inclut tous les événements de 2h00 le jour 0 jusqu’à (mais pas compris) 2h00 le jour 7.window_duration=timedelta(hours=1), delay=timedelta(minutes=30): Cela crée une fenêtre de consultation de 1 heure se terminant 30 minutes avant l’heure d’évaluation. Pour un événement à 13h00, cela inclut tous les événements de 13h30 jusqu’à (mais pas inclus) 2h30.
À utiliser Last pour limiter la fraîcheur d’une valeur récente
Combinez Last avec RollingWindow le fait qu’une dernière valeur n’est valable que pour une durée limitée. À un moment d’évaluation, la caractéristique renvoie la valeur de la ligne avec le dernier horodatage dans cet intervalle :
[evaluation_time - delay - window_duration, evaluation_time - delay)
Si la dernière ligne de l’intervalle contient une valeur nulle, la caractéristique retourne nulle. Si vous souhaitez exclure les valeurs d’entrée nulles, mettez a filter_condition sur la source.
Cette combinaison diffère de ColumnSelection.
ColumnSelection Retourne la dernière valeur non nulle observée sans la faire expirer selon l’âge.
Pour les fonctionnalités batch, cette combinaison propose un mode spécial de matérialisation uniquement en ligne. Il ne supporte que DeltaTableSource, Last, RollingWindow, et TableTrigger. Voir Materialize les dernières valeurs bornées par la fraîcheur.
Fenêtre glissante fixe
Pour les fonctionnalités définies à l'aide de fenêtres à bascule, les agrégations sont calculées sur une fenêtre de longueur fixe prédéfinie qui avance par un intervalle de glissement, produisant des fenêtres non-chevauchantes qui partitionnent entièrement le temps. Par conséquent, chaque événement de la source contribue exactement à une fenêtre. Les caractéristiques au moment t agréger les données des fenêtres terminant à ou avant t (exclusif). Windows commence à l’époque Unix.
class TumblingWindow(TimeWindow):
    window_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    offset: Optional[datetime.timedelta] = None
    start_time: Optional[datetime.datetime] = None
Le tableau suivant répertorie les paramètres d'une fenêtre de basculement.
| Paramètre | Contraintes |
|---|---|
window_duration |
Doit être > 0 |
delay (facultatif) |
Ça doit être ≥ 0. Ça recule la fenêtre analytique par rapport au timestamp d’évaluation. |
offset (facultatif) |
Doit être ≥ 0 et plus court que window_duration. Décale les limites des fenêtres à partir de minuit UTC. |
start_time (facultatif) |
Première frontière d’événement-temps à laquelle la caractéristique peut émettre une sortie. |
from databricks.feature_engineering.entities import TumblingWindow
from datetime import timedelta

window = TumblingWindow(
    window_duration=timedelta(days=1),
    delay=timedelta(hours=2),
    offset=timedelta(hours=22),
)
Exemple de fenêtre bascule
-
window_duration=timedelta(days=5): cela crée des fenêtres de longueur fixe prédéfinies de 5 jours chacune. Exemple : La fenêtre #1 s’étend sur le jour 0 à jour 4, la fenêtre #2 s’étend sur le jour 5 à le jour 9, la fenêtre #3 s’étend sur le jour 10 à la journée 14, et ainsi de suite. Plus précisément, la fenêtre n°1 inclut tous les événements avec horodatages commençant au00:00:00.00jour 0 jusqu’à (mais pas inclus) les événements avec horodatage00:00:00.00le jour 5. Chaque événement appartient exactement à une fenêtre.
Fenêtre glissante
Pour les caractéristiques définies à l’aide de fenêtres coulissantes, les agrégations sont calculées sur une fenêtre qui avance d’un intervalle de glissade. Une fenêtre coulissante peut avoir une durée fixe ou une durée de vie. Les fenêtres de durée fixe se chevauchent, donc chaque événement source peut contribuer à l’agrégation de fonctionnalités pour plusieurs fenêtres. Une fenêtre à vie inclut tous les événements sources avant la fin de la fenêtre. Les caractéristiques au moment t agréger les données des fenêtres terminant à ou avant t (exclusif). Windows sont alignés sur l’époque Unix.
class SlidingWindow(TimeWindow):
    window_duration: Optional[datetime.timedelta]
    slide_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    offset: Optional[datetime.timedelta] = None
    start_time: Optional[datetime.datetime] = None
Le tableau suivant répertorie les paramètres d’une fenêtre glissante.
| Paramètre | Contraintes |
|---|---|
window_duration |
Doit être positif pour une fenêtre de durée fixe. Réglé sur None une fenêtre à vie. |
slide_duration |
Doit être positif. Pour une fenêtre de durée fixe, elle doit aussi être plus courte que window_duration. |
delay (facultatif) |
Ça doit être ≥ 0. Ça recule la fenêtre analytique par rapport au timestamp d’évaluation. |
offset (facultatif) |
Doit être ≥ 0 et plus court que slide_duration. Décale les limites des fenêtres à partir de minuit UTC. |
start_time (facultatif) |
Première frontière d’événement-temps à laquelle la caractéristique peut émettre une sortie. |
from databricks.feature_engineering.entities import SlidingWindow
from datetime import timedelta

window = SlidingWindow(
    window_duration=timedelta(days=7),
    slide_duration=timedelta(days=1),
    delay=timedelta(hours=2),
    offset=timedelta(hours=22),
)
Exemple de fenêtre glissante
-
window_duration=timedelta(days=5), slide_duration=timedelta(days=1): cela crée des fenêtres superposées de 5 jours qui avancent de 1 jour chaque fois. Exemple : La fenêtre n°1 s’étend sur le jour 0 à jour 4, la fenêtre #2 s’étend sur le jour 1 à jour 5, la fenêtre #3 s’étend sur le jour 2 à la journée 6, et ainsi de suite. Chaque fenêtre inclut les événements du00:00:00.00jour de début jusqu’à (mais pas compris)00:00:00.00le jour de fin. Étant donné que les fenêtres se chevauchent, un événement unique peut appartenir à plusieurs fenêtres (dans cet exemple, chaque événement appartient à jusqu’à 5 fenêtres différentes).
Fenêtre à vie
Réglez window_duration=None pour créer une fenêtre à vie. À chaque limite de glisement, la caractéristique agrège tous les événements sources de l’entité avec des horodatages antérieurs à cette frontière. Par exemple, une diapositive d’un jour produit une valeur cumulative une fois par jour.
Les fenêtres à vie sont prises en charge uniquement par SlidingWindow.
RollingWindow et TumblingWindow nécessitent un fini window_duration.
Note
Les fenêtres à vie nécessitent une databricks-feature-engineering version client qui supporte window_duration=None l’activation de l’espace de travail. Les versions clientes antérieures ne prennent pas en charge cette syntaxe.
from datetime import timedelta
from databricks.feature_engineering.entities import (
    AggregationFunction,
    DeltaTableSource,
    Feature,
    SlidingWindow,
    Sum,
)

lifetime_spend = Feature(
    source=DeltaTableSource(
        catalog_name="main",
        schema_name="store",
        table_name="transactions",
    ),
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(
        Sum(input="amount"),
        SlidingWindow(
            window_duration=None,
            slide_duration=timedelta(days=1),
        ),
    ),
    name="lifetime_spend",
)
Fenêtre dentée de scie
Important
SawtoothWindow est en version Bêta.
Une fenêtre en dents de scie est une agrégation qui permet des mises à jour très récentes pour les événements récents, ainsi que la compactation quotidienne des données historiques. Son bord de fuite (ancien) avance en pas fixes quotidiens tandis que le bord avant (récent) reste à jour avec les derniers événements, donc la longueur effective de la fenêtre « scie » au cours de chaque journée. La majeure partie de la fenêtre est servie à partir des données dans la table d’ingestion du Stream, et seuls les deux jours les plus récents proviennent du live stream. C’est un compromis qui calcule efficacement les fenêtres de longue durée (en passant à l’échelle des années) tout en restant réactif aux mises à jour fraîches.
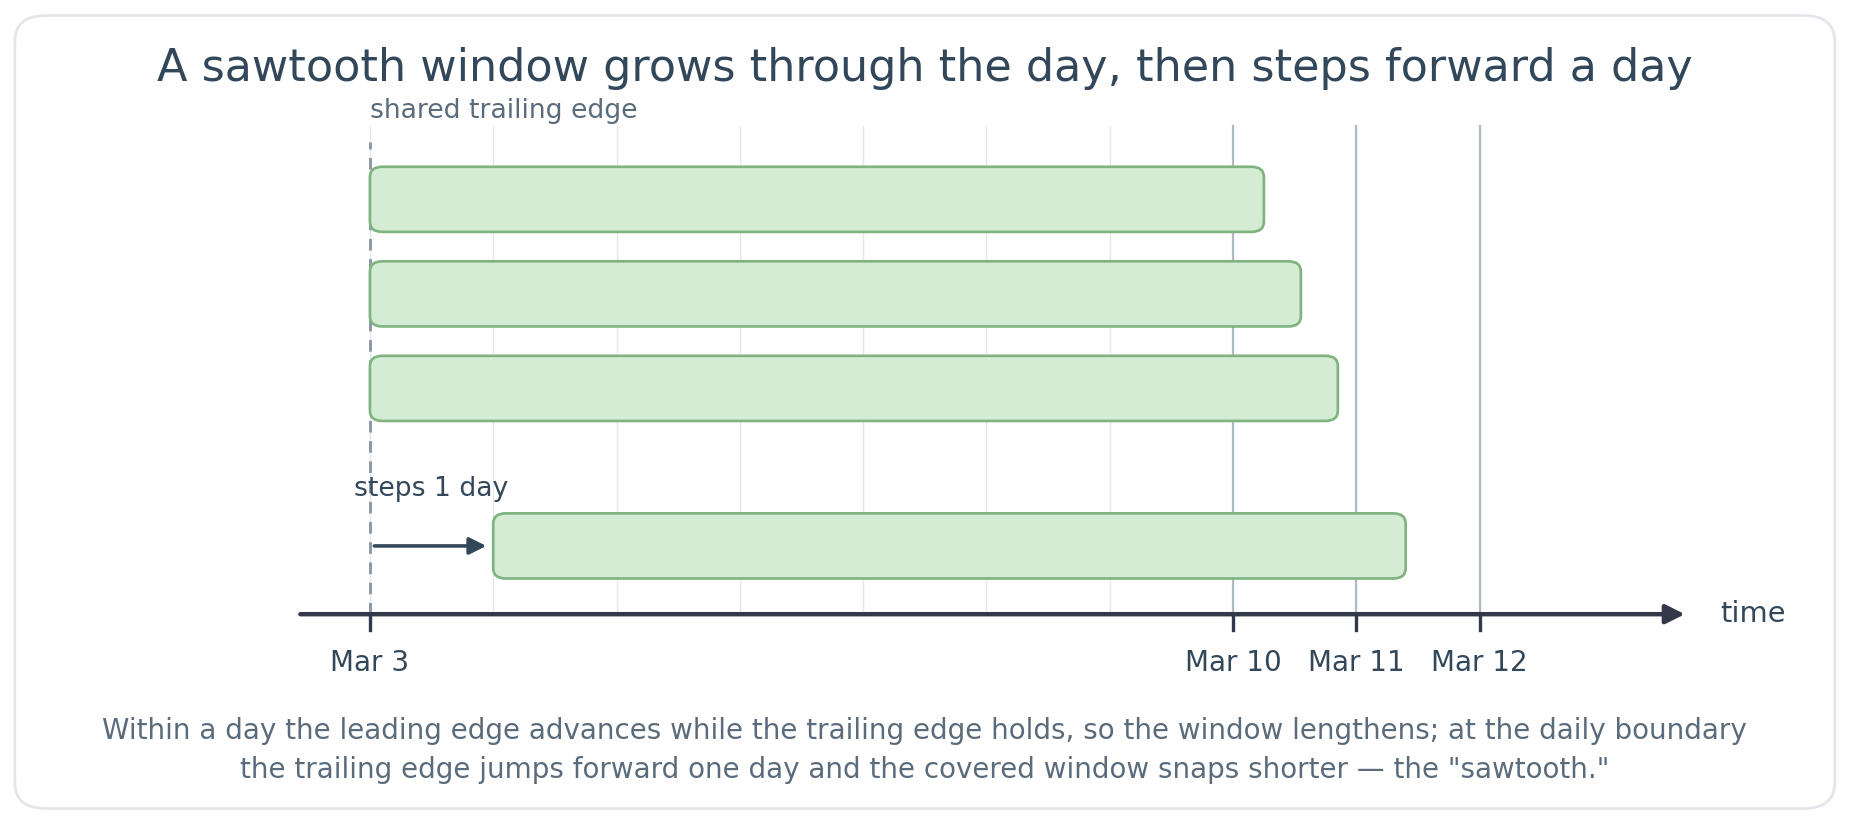
Les fenêtres en dents de scie sont matérialisées sur un chemin hybride par lots et en flux. Un pipeline batch maintient la majeure partie de la fenêtre, tandis qu’un pipeline de streaming maintient les données les plus récentes fraîches en temps réel. Les deux sont fusionnés en lecture, donc pour le modèle ou le consommateur au service, c’est une seule fonctionnalité.
Parce que la partie historique de la fenêtre est calculée par la conduite par lots, une structure en dents de scie est prête à servir peu après le début de la matérialisation, même lorsque la fenêtre s’étend sur des mois ou des années. Une fenêtre roulante n’est complète qu’après la durée complète de sa fenêtre. Le minimum window_duration doit être supérieur à deux jours (la limite inférieure appliquée). Databricks recommande une fenêtre en dents de scie pour des durées supérieures à 7 jours. Pour les fenêtres de plus de deux jours et jusqu’à sept jours, choisissez entre la précision de longueur fixe d’une fenêtre roulante et la préparation plus rapide à la production d’une fenêtre en dents de scie.
Note
Une caractéristique dentée de scie s’appuie sur une histoire déjà présente. La table d’ingestion du Stream doit contenir des données couvrant au moins la durée totale de la fenêtre, sinon la fenêtre calculée est incomplète. Avant que deux jours complets ne se soient écoulés, la fonctionnalité ne reflète que les données matérialisées jusqu’à présent. Il n’est pas recommandé de diffuser le long métrage en production avant que deux jours complets ne se soient écoulés. Une agrégation sur une fenêtre vide renvoie 0 pour Sum et , et nulle pour Avg, Min, Max, LastFirst, VarPop, VarSamp, , StddevPop, , et StddevSamp.Count
Pour savoir si une fonctionnalité Dents de scie est prête, ouvrez la Vue Fonctionnalité dans l’Explorateur de catalogue. Dans la section Caractéristiques matérialisées, le remblai par lots est terminé une fois que le dernier temps de matérialisation de la fonctionnalité est avancé et que son statut montre un succès. La portion en flux est matérialisée par un pipeline déclaratif Lakeflow. Après la validation de la Feature View, la fonctionnalité matérialisée se connecte à ce pipeline, où vous pouvez surveiller son état d’exécution.
Les fenêtres en dents de scie nécessitent un StreamSource et sont matérialisées avec StreamingMode.
class SawtoothWindow(TimeWindow):
    window_duration: datetime.timedelta
Les bords d’une fenêtre en dents de scie bougent différemment de ceux d’une fenêtre roulante : le bord d’attaque suit le dernier événement, tandis que le bord d’arrivée avance une fois par jour plutôt qu’en continu. Chaque jour, à une limite fixe à 18h00 UTC, le bord de fuite avance jusqu’à la limite UTC-minuit de la journée. En conséquence, la fenêtre effective est légèrement plus longue et window_duration s’étend au fil de la journée avant de revenir un jour au seuil suivant. La formation et le service utilisent la même limite à 18h00 UTC, donc la formation hors ligne et le service en ligne restent constants.
| Paramètre | Contraintes |
|---|---|
window_duration |
Ça doit être plus de deux jours. Une durée qui n’est pas un nombre entier de jours (par exemple, timedelta(days=3, minutes=15)) est autorisée, mais la fenêtre est tout de même mise à jour à la précision quotidienne. |
Les fenêtres en dents de scie prennent en charge les Sumfonctions , Avg, Count, Min, LastFirstMax, VarPopVarSamp, , StddevPop, , etStddevSamp agrégation.
Exemple de fenêtre en dents de scie
L’exemple suivant montre un compte de 7 jours des transactions d’un utilisateur. Le bord d’attaque suit l’événement en cours tandis que le bord d’arrivée avance jour après jour. Pour les événements du 10 mars, la fenêtre remonte à environ le 3 mars. Au fil du 10 mars, le bord d’attaque continue d’avancer tandis que le bord de fuite tient, donc la portée couverte s’agrandit. Puis, au début du 11 mars, le bord de fuite s’étend vers le 4 mars. La fenêtre effective est toujours un peu plus longue que sept jours. Les deux jours les plus récents sont servis à partir du flux en direct, et les jours précédents sont servis à partir de la table d’ingestion du Stream.
from databricks.feature_engineering.entities import SawtoothWindow
from datetime import timedelta

# 7-day window kept continuously fresh with streaming data
window = SawtoothWindow(window_duration=timedelta(days=7))
Limitations des fenêtres en dent de scie
- Le
delayparamètre n’est pas pris en charge. - La fonction
SourceLateness.settling_delayn'est pas prise en charge. - Les fonctions d’agrégation autres que
Sum,Avg,Count,Min,FirstMax,Last,VarPop,StddevPopVarSamp, etStddevSampne sont pas prises en charge (par exemple,ApproxCountDistinct,ApproxPercentile,FirstN,LastN,FirstDistinct, , etLastDistinct). - Les fenêtres en dents de scie nécessitent un
StreamSource. ADeltaTableSourcen’est pas pris en charge.
Déclencheurs de matérialisation
Déclenche le contrôle lorsqu’un pipeline de matérialisation s’exécute. Le type de déclencheur dépend du type de fonctionnalité.
CronSchedule
À utiliser CronSchedule pour les fonctionnalités d’agrégation par lots. Par défaut, Azure Databricks découle un planning à partir de la fenêtre d’agrégation. Un planning dérivé prend en compte la période de la fenêtre, la fenêtre delay et offset, et la source settling_delay afin qu’une exécution ne publie pas une fenêtre avant que ses données sources ne soient attendues complètes. Les plannings dérivés supportent les fenêtres de roulement et de glissade.
Pour demander un planning dérivé, omettez l’expression cron.
CronSchedule() et la forme explicite CronSchedule(mode=CronScheduleMode.DERIVED) sont équivalentes :
from databricks.feature_engineering.entities import (
    CronSchedule,
    CronScheduleMode,
)

trigger = CronSchedule(mode=CronScheduleMode.DERIVED)
Ne pas définir quartz_cron_expression avec CronScheduleMode.DERIVED. Lorsque vous récupérez la fonctionnalité matérialisée, le planning retourné peut contenir l’expression cron que Azure Databricks a calculée.
Pour contrôler directement l’ordonnance, fournissez une expression cron Quartz.
CronScheduleMode.MANUAL est déduit lorsque vous fournissez une expression :
from databricks.feature_engineering.entities import CronSchedule

trigger = CronSchedule(
    quartz_cron_expression="0 0 * * * ?",  # Hourly
    timezone_id="UTC",
)
TableTrigger
Utiliser TableTrigger pour ColumnSelection les fonctionnalités ou les fonctionnalités d’agrégation (AggregationFunction) soutenues par un DeltaTableSourcefichier . Le pipeline s’exécute chaque fois que la table Delta en amont reçoit une nouvelle validation.
Pour les fonctionnalités d’agrégation, le pipeline est limité pour ne pas s’exécuter à chaque commit. Le pipeline s’exécute au maximum une fois par moitié de la durée de la fenêtre de la fonctionnalité, mais jamais plus souvent que toutes les 5 minutes. Par exemple, une fonctionnalité avec une fenêtre de chute d’une heure s’exécute au maximum toutes les 30 minutes, ou une fonctionnalité avec une fenêtre de 8 heures s’exécute au maximum toutes les 4 heures. Le plancher de 5 minutes s’applique quand la moitié de la fenêtre est plus petite, donc les fenêtres de 10 minutes ou moins fonctionnent au maximum toutes les 5 minutes. Les fonctionnalités d’agrégation dont la fenêtre est inférieure à 5 minutes ne peuvent pas utiliser TableTrigger, utilisent un déclencheur de streaming à la place.
from databricks.feature_engineering.entities import TableTrigger

trigger = TableTrigger()
StreamingMode
Utiliser StreamingMode pour les fonctionnalités sauvegardées par un StreamSource. Le pipeline s’exécute en tant que pipeline de streaming continu.
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import (
    StreamSource, Feature, AggregationFunction, Sum,
    RollingWindow, OnlineStoreConfig, StreamingMode,
)
from datetime import timedelta

fe = FeatureEngineeringClient()

stream_source = StreamSource(full_name="my_catalog.my_schema.my_stream")

streaming_feature = fe.create_feature(
    source=stream_source,
    entity=["value.user_id"],
    timeseries_column="value.event_time",
    function=AggregationFunction(
        operator=Sum(input="value.amount"),
        time_window=RollingWindow(window_duration=timedelta(hours=1)),
    ),
    catalog_name="my_catalog",
    schema_name="my_schema",
    name="user_purchase_sum",
)

fe.materialize_features(
    features=[streaming_feature],
    online_config=OnlineStoreConfig(
        catalog_name="my_catalog",
        schema_name="my_schema",
        table_name_prefix="streaming_features_serving",
        online_store_name="feature_store_online",
    ),
    trigger=StreamingMode(),
)
Choix d’un déclencheur
Chaque fonctionnalité utilise un déclencheur ; Les options par type de fonctionnalité sont :
| Type de fonctionnalité | Trigger | Quand il s’exécute |
|---|---|---|
Agrégation (AggregationFunction) à partir de DeltaTableSource |
CronSchedule |
Sur un calendrier dérivé ou manuel |
Agrégation (AggregationFunction) à partir de DeltaTableSource |
TableTrigger |
Sur chaque validation de table source |
ColumnSelection (de DeltaTableSource) |
TableTrigger |
Sur chaque validation de table source |
Fonctionnalités de StreamSource |
StreamingMode |
Streaming continu |
Vous ne pouvez pas matérialiser les fonctionnalités qui nécessitent différents types de déclencheurs dans un seul materialize_features appel. Émettre des appels distincts à la place.