Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Le traitement flexible (aperçu) propose l’inférence avec une réduction de 50 % par rapport au traitement Standard pour les charges de travail pouvant tolérer des temps de réponse plus lents et une indisponibilité occasionnelle des ressources. Sélectionnez le traitement Flex pour une requête individuelle de l’API Responses ou de l’API Chat Completions en définissant service_tier sur flex.
Utilisez le traitement Flex pour les travaux non interactifs et de priorité inférieure, tels que les évaluations de modèle, l’enrichissement des données, l’analyse des documents et les flux de travail d’application asynchrones. Pour les charges de travail sensibles à la latence ou sensibles à la capacité, utilisez plutôt le traitement standard, le traitement prioritaire ou le débit provisionné.
Important
Avec l’introduction du traitement Flex, les requêtes qui définissent service_tier sur flex sont traitées uniquement lorsque le modèle sélectionné prend en charge le traitement Flex. Un modèle non pris en charge retourne un HTTP 400 invalid_request_error et ne revient pas au traitement Standard. Le traitement flexible n’a pas de contrat SLA de latence ou de contrat SLA de service.
Prerequisites
Un abonnement Azure. Créez-en un gratuitement.
Une ressource OpenAI Azure avec un modèle pris en charge déployé à l’aide du type de déploiement Global Standard.
Le point de terminaison de la ressource et une clé API ou des informations d’identification Microsoft Entra ID. Les exemples de cet article utilisent une clé API stockée dans la variable d’environnement
AZURE_OPENAI_API_KEY.Une charge de travail qui peut tolérer une latence variable et des réponses indiquant une indisponibilité temporaire des ressources.
Python 3.10 ou version ultérieure et le package openAI Python pour les exemples de Python :
pip install --upgrade openai
Envoyer une demande Flex
Définissez flex sur service_tier dans chaque requête qui doit utiliser le traitement Flex. La model valeur est le nom de votre déploiement de modèle Azure.
Python
L’exemple suivant envoie une requête Flex à l’aide de l’API Réponses :
import os

from openai import OpenAI

AZURE_OPENAI_ENDPOINT = "https://YOUR-RESOURCE-NAME.openai.azure.com"

# Create a client with a longer timeout for Flex requests.
openai = OpenAI(
    base_url=f"{AZURE_OPENAI_ENDPOINT}/openai/v1/",
    api_key=os.environ["AZURE_OPENAI_API_KEY"],
    timeout=900.0,
)

# Send a request for Flex processing.
response = openai.responses.create(
    model="YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    input="Analyze these records and summarize the recurring themes.",
    service_tier="flex",
)

print(response.output_text)
print(f"Processed by service tier: {response.service_tier}")
<generated-analysis>
Processed by service tier: flex
La réponse contient l’analyse générée et le niveau de service qui traite la requête.
Référence :API Réponses
REST
L’exemple suivant envoie la même requête directement à l’API Réponses :
curl -X POST https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/responses \
  -H "Content-Type: application/json" \
  -H "api-key: $AZURE_OPENAI_API_KEY" \
  -d '{
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
    "service_tier": "flex"
  }'
{
    "service_tier": "flex",
    "status": "completed",
    "output": [<response-output>]
}
Pour vérifier le niveau qui traite la requête, vérifiez le service_tier champ dans une réponse réussie.
Référence :Référence de l’API REST Responses
Choisir une option de traitement
Le traitement Flex, Standard et Priorité est un choix de niveau de service pour les demandes d’API en ligne. Le débit par lots et le débit provisionné sont des options de déploiement et d’achat distinctes.
| Option | Comment le sélectionner | Latence et disponibilité | Modèle de coût | Idéal pour |
|---|---|---|---|---|
| Traitement flexible | Définissez le niveau service_tier de la requête sur flex. |
Latence variable. Les requêtes peuvent retourner HTTP 429 lorsque la capacité Flex n’est pas disponible. | 50% remise par rapport aux taux de jeton standard. Les remises sur les tokens mis en cache s’appliquent également. | Évaluations, enrichissement, analyse hors ligne et tâches en arrière-plan pouvant tolérer des délais. |
| Traitement standard | Définissez le niveau service_tierdefaultde requête sur , ou utilisez le niveau Standard configuré pour le déploiement. |
Traitement en ligne au mieux pour les charges de travail d’ordre général. | Taux de paiement par jeton standard. | Charges de travail de développement, de test et de production avec un trafic variable. |
| Traitement de priorité | Configurez la priorité sur le déploiement ou définissez le niveau service_tier de requête sur priority. |
Latence plus faible et plus cohérente, avec une cible définie pour les modèles pris en charge. | Taux de paiement par jeton prioritaire. | Applications en ligne sensibles à la latence sans engagement de capacité réservée. |
| Batch | Soumettez une tâche de traitement par lots asynchrone à un déploiement Batch. | Les résultats sont généralement disponibles sous 24 heures. Aucune cible de latence en temps réel. | Tarif réduit par lot. | Travaux hors connexion volumineux qui ne nécessitent pas de réponse immédiate. |
| Capacité de traitement provisionnée | Créez un déploiement provisionné et achetez ou réservez des unités de débit approvisionnées (PTU). | Capacité réservée avec débit et latence prévisibles. | Facturation par PTU horaire ou réservation de Azure. | Charges de travail de production à volume élevé et stratégique. |
Choisissez le traitement Flex lorsque toutes les conditions suivantes s’appliquent :
- Votre charge de travail peut tolérer des temps de traitement plus longs et variables.
- Vous préférez réduire les coûts par rapport à la latence prévisible.
- Votre application peut réessayer des échecs temporaires ou acheminer une demande ayant échoué vers le traitement Standard.
- Le modèle sélectionné et le contexte de requête sont pris en charge.
N’utilisez pas le traitement Flex quand l’une des conditions suivantes s’applique :
- Un utilisateur attend une réponse interactive.
- La requête doit se terminer dans une cible de latence stricte.
- Votre application ne peut pas tolérer ou réessayer les réponses HTTP 429 temporaires.
- Vous avez besoin d’une capacité de traitement réservée ou d’un débit prévisible.
Le traitement flexible présente les caractéristiques suivantes :
-
Sélection au niveau de la requête : Définissez
flexsurservice_tierpour chaque requête devant utiliser le traitement Flex. - Aucun déploiement distinct : Envoyez des requêtes Standard et Flex au même déploiement Global Standard, puis sélectionnez le niveau par requête.
- API prises en charge : Utilisez l’API Responses ou l’API Chat Completions.
- Réponse synchrone : L’appel d’API reste synchrone, même si la charge de travail peut prendre plus de temps. Le traitement flexible n’est pas identique à l’API Batch.
- Disponibilité dépendante de la capacité : Une requête peut retourner HTTP 429 lorsque la capacité Flex n’est pas disponible.
-
Pas de repli automatique vers le mode Standard : Votre application doit réessayer explicitement avec
service_tierdéfini surdefaultsi le traitement Standard est acceptable. - Quota partagé : Les demandes Flex et Standard utilisent le quota affecté au déploiement Global Standard.
- Même qualité de sortie de modèle : Flex utilise le même modèle sous-jacent que Standard. Le niveau de traitement change la latence, la disponibilité et le prix, et non la qualité du modèle.
Note
Les jetons d’entrée et de sortie Flex reçoivent une remise de 50% par rapport aux taux de jeton standard correspondants. Les tokens d’entrée mis en cache éligibles bénéficient également de la remise applicable aux tokens mis en cache. Pour connaître les tarifs actuels, consultez Azure tarification OpenAI.
Passer en revue les modèles pris en charge
Le traitement flexible offre une disponibilité limitée des modèles au lancement.
gpt-5.6-sol est le premier modèle pris en charge. Le tableau suivant répertorie les modèles pris en charge. Microsoft ajoute d’autres modèles à mesure que la prise en charge devient disponible.
| Model | Version | Type de déploiement | Disponibilité de la région |
|---|---|---|---|
gpt-6.1-sol |
2026-09-29 |
Standard global | Toutes les régions Azure où Global Standard est disponible |
gpt-6-sol |
2026-09-22 |
Standard global | Toutes les régions Azure où Global Standard est disponible |
gpt-6-luna |
2026-09-22 |
Standard global | Toutes les régions Azure où Global Standard est disponible |
gpt-6-astra |
2026-09-03 |
Standard global | Toutes les régions Azure où Global Standard est disponible |
gpt-5.6-sol |
2026-07-09 |
Standard global | Toutes les régions Azure où Global Standard est disponible |
gpt-5.6-luna |
2026-07-09 |
Standard global | Toutes les régions Azure où Global Standard est disponible |
gpt-5.6-terra |
2026-07-09 |
Standard global | Toutes les régions Azure où Global Standard est disponible |
Vérifiez ce tableau avant d’envoyer une demande Flex. Ne supposez pas qu’un modèle ou une nouvelle version de modèle prend en charge le traitement Flex, car il prend en charge le traitement Standard ou Prioritaire. Un modèle non pris en charge retourne HTTP 400. Pour éviter de perturber votre application, mettez en place un mécanisme de basculement au niveau de l’application vers le traitement Standard lorsque la tarification et les performances du niveau Standard sont acceptables.
Revenir au traitement standard
Le traitement Flex ne redirige pas automatiquement une requête vers Standard lorsque la capacité Flex n’est pas disponible. Si l’exécution de la requête est plus importante que le maintien de la tarification Flex, réessayez la requête avec service_tier défini sur default.
L’exemple suivant utilise une stratégie d’achèvement d’abord. Il tente d’abord de traiter Flex et de réessayer une fois avec le traitement Standard après toute réponse HTTP 429 :
import os

from openai import OpenAI, RateLimitError

AZURE_OPENAI_ENDPOINT = "https://YOUR-RESOURCE-NAME.openai.azure.com"

# Create a client with a longer timeout for Flex requests.
openai = OpenAI(
    base_url=f"{AZURE_OPENAI_ENDPOINT}/openai/v1/",
    api_key=os.environ["AZURE_OPENAI_API_KEY"],
    timeout=900.0,
)

request = {
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
}

# Try Flex processing, and fall back to Standard after an HTTP 429 response.
try:
    response = openai.responses.create(**request, service_tier="flex")
except RateLimitError:
    response = openai.responses.create(**request, service_tier="default")

print(response.output_text)
print(f"Processed by service tier: {response.service_tier}")
<generated-analysis>
Processed by service tier: <flex-or-default>
Le retour au mode Standard modifie les caractéristiques de tarification et de performance de la requête. Utilisez ce modèle uniquement lorsque la charge de travail peut accepter la tarification Standard.
Une réponse HTTP 429 peut indiquer une capacité Flex indisponible ou une limite de quota. Étant donné que les traitements Flex et Standard partagent le même quota, la requête Standard peut également échouer lorsque la réponse d’origine était due à un dépassement de quota. Définissez des limites de nouvelles tentatives et gérez un deuxième RateLimitError dans votre application. Lorsque le service retourne l’identificateur d’erreur spécifique à Flex, utilisez-le pour limiter les réponses liées à la capacité.
Pour les charges de travail qui privilégient le coût le plus bas, réessayez le traitement Flex avec une temporisation exponentielle avant de recourir à une solution de repli. Pour les charges de travail qui privilégient le temps d’exécution, basculez sur Standard après la première erreur de capacité sur Flex.
Référence :RateLimitError
Gérer les erreurs Flex
Distinguez les erreurs de requête permanentes des erreurs de capacité temporaires.
| État HTTP | Error | Cause | Gestion recommandée |
|---|---|---|---|
| 400 | invalid_request_error |
Le modèle sélectionné, la version du modèle, la longueur du contexte, l’API ou la configuration de la demande ne prend pas en charge le traitement Flex. | N’effectuez pas de nouvelle tentative de même requête inchangée. Sélectionnez un modèle ou une longueur de contexte pris en charge, ou réessayez explicitement avec service_tier défini sur default. |
| 408 | Délai d’expiration de la requête | La demande ne se termine pas dans le délai d’expiration du client ou du service configuré. Les requêtes Flex peuvent prendre plus de temps que les requêtes Standard. | Utilisez un délai d’expiration client plus long. Réessayez avec un délai d’attente exponentiel plafonné. Si le temps d’achèvement est plus important que la tarification Flex, réessayez avec Standard. |
| 429 | Ressource indisponible ou limite de débit atteinte | La capacité flex n’est pas disponible temporairement, ou la demande a dépassé une limite de débit applicable. La capacité flex est préemptible, de sorte que l’indisponibilité temporaire est plus probable pendant les heures de pointe. | Si la demande a dépassé une limite de débit, augmentez la limite de débit du déploiement Global Standard en affectant davantage de quota. Flex et Standard partagent ce quota. Si l’abonnement n’a pas suffisamment de quota pour une charge de travail à débit élevé, demandez une augmentation du quota. Si la capacité Flex est temporairement indisponible, réessayez avec un délai d’attente exponentiel et une gigue, répartissez les tâches pouvant tolérer un délai sur des périodes creuses, comme les nuits de semaine ou les week-ends, ou réessayez avec service_tier défini sur default. Respectez Retry-After lorsqu’il est présent. |
| 500, 502, 503 ou 504 | Erreur de service temporaire | Un problème temporaire de service ou de passerelle a empêché l’achèvement. | Réessayez avec un délai d’attente exponentiel plafonné. N’envoyez pas un nombre illimité de nouvelles tentatives. |
| 401 ou 403 | Erreur d’authentification ou d’autorisation | Les informations d’identification sont manquantes, non valides, expirées ou n’ont pas accès à la ressource. | Corrigez les informations d’identification ou l’attribution de rôle. Ne réessayez pas tant que la configuration n’a pas changé. |
| 404 | Déploiement introuvable | Le nom de déploiement ou le point de terminaison est incorrect. | Vérifiez que model correspond au nom du déploiement et que l’URL de base pointe vers la ressource Azure OpenAI appropriée. |
Note
Une demande Flex rejetée parce qu’aucune capacité de traitement n’est disponible n’est pas facturée. Toutefois, vous remarquerez peut-être une capacité de limite de débit moins disponible, car les demandes Flex et Standard partagent le quota affecté au déploiement Global Standard.
Utilisez une temporisation exponentielle avec un jitter aléatoire pour les réponses HTTP 408, 429 et les réponses 5xx transitoires. Définissez un nombre maximal de nouvelles tentatives et un délai maximal afin qu’une demande ayant échoué ne reste pas dans une boucle de nouvelle tentative sans limite.
- Respectez
Retry-Afterlorsque la réponse l’inclut. - Sinon, attendez un délai exponentiellement croissant avec une gigue aléatoire.
- Réessayez Flex uniquement pendant que le délai reste acceptable pour la charge de travail.
- Revenez à Standard si le budget de nouvelle tentative est épuisé et que l’application autorise le coût Standard plus élevé.
- Renvoyez un échec explicite si ni le traitement Flex différé ni le mécanisme de secours Standard ne satisfait aux exigences de l’application.
Ne réessayez pas à plusieurs reprises la même requête Flex non prise en charge. Une nouvelle tentative réussit uniquement après avoir modifié le modèle, la longueur du contexte, la configuration de l’API ou le niveau de service.
Surveiller l’utilisation et les coûts
Utilisez Azure Monitor métriques pour comparer le trafic Flex et Standard sur le même déploiement. Surveillez le volume de demandes, la consommation de jetons, la latence, les défaillances et le taux auquel les requêtes Flex reviennent à Standard dans votre application.
Connectez-vous au portail Azure.
Accédez à votre ressource OpenAI Azure, puis sélectionnez Métriques.
Ajoutez la métrique Requêtes Azure OpenAI. Vous pouvez également ajouter Azure latence OpenAI, Azure Utilisation d’OpenAI et les métriques d’erreur.
Ajoutez un filtre où ServiceTierRequest est
flexégal.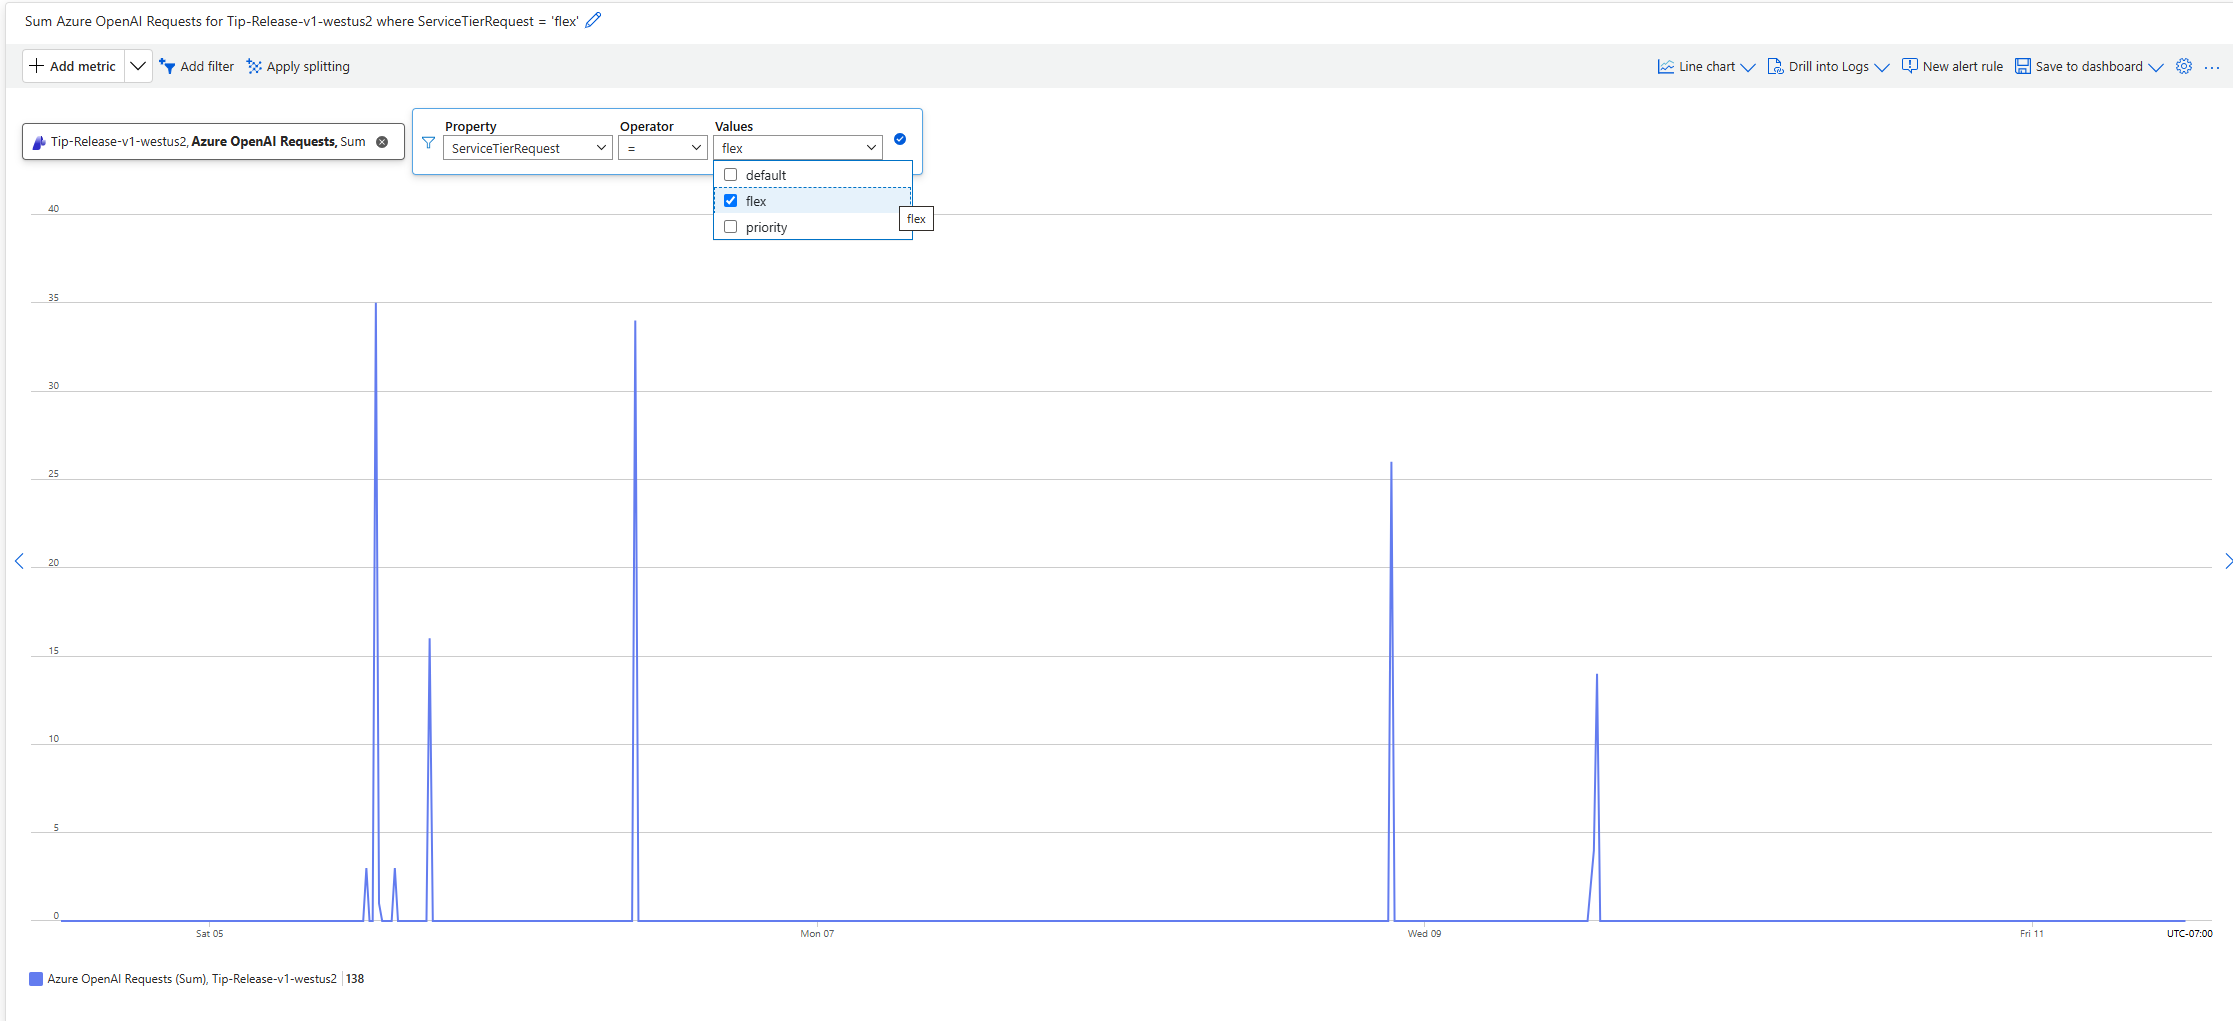
Créez des alertes pour les réponses HTTP 429 persistantes, une augmentation des taux d’erreur et une latence dépassant le budget de nouvelles tentatives de votre charge de travail.
Suivez les signaux suivants pour chaque charge de travail :
| Signal | Pourquoi cela se produit-il |
|---|---|
| Nombre de requêtes Flex | Affiche l’adoption et le trafic redirigé vers un traitement moins coûteux. |
| Taux de réussite des requêtes Flex | Indique la fréquence à laquelle la capacité Flex accepte et termine les demandes. |
| Taux HTTP 429 | Affiche les périodes où la capacité Flex ou le quota de déploiement est limité. |
| Nombre et taux de repli par défaut | Montre le gain de fiabilité et le surcoût du mécanisme de repli contrôlé par l’application. |
| Tokens d’entrée, tokens d’entrée mis en cache et tokens de sortie | Prend en charge l’attribution des coûts et vérifie l’effet de la mise en cache des prompts. |
| Latence de bout en bout | Permet de déterminer si une charge de travail reste adaptée à Flex. |
Nombre de HTTP 400 invalid_request_error |
Identifie les modèles, versions de modèle, longueurs de contexte ou configurations de requête non pris en charge. |
Pour plus d’informations sur la surveillance des déploiements de modèles, consultez Monitor Azure OpenAI.
L’utilisation flex est facturée sur les compteurs Flex dédiés afin de pouvoir la distinguer de l’utilisation standard. Utilisez Cost Analysis pour passer en revue les coûts des jetons Flex par ressource et par déploiement.
- Dans le portail Azure, ouvrez Cost Management + Billing>.
- Filtrez par abonnement, groupe de ressources ou ressource Azure OpenAI contenant le déploiement.
- Regroupez ou filtrez par Compteur pour séparer l’usage Flex de l’usage standard.
- Ajoutez un filtre de facturation par tag, sélectionnez deployment et choisissez le nom du déploiement.
- Comparez les économies de coûts Flex avec les coûts de secours Standard et les exigences d’achèvement de la charge de travail.
Les jetons d’entrée et de sortie Flex sont facturés à 50% des tarifs Standard correspondants. La mise en cache des prompts peut réduire davantage le coût des tokens d’entrée éligibles déjà mis en cache. Une demande Flex rejetée parce qu’aucune capacité de traitement n’est disponible n’est pas facturée.
Appliquer les meilleures pratiques de production
- Définissez un délai d’expiration plus long. Les requêtes Flex peuvent prendre plus de temps que les requêtes Standard. Commencez par définir un délai d’expiration côté client adapté à votre charge de travail, par exemple 15 minutes, puis testez avec des requêtes représentatives.
- Utilisez des nouvelles tentatives limitées. Limitez les tentatives de nouvelle tentative et le temps écoulé total.
- Ajouter une gigue. Délai d’interruption aléatoire pour éviter les pics de nouvelles tentatives synchronisés.
- Rendre explicite la solution de secours. Défini
service_tiersurdefaultplutôt que de s’appuyer sur un comportement implicite. - Suivez le palier traité. Enregistrez la valeur de réponse
service_tieravec la latence, l’état, l’utilisation des jetons et les données de coût. - Séparez le trafic interactif et en arrière-plan. Conservez les requêtes destinées aux utilisateurs en mode Standard, Priorité ou à débit provisionné, sauf si la latence variable de Flex est acceptable.
- Évitez le travail en double. Assurez-vous que l’application ne soumette pas plusieurs fois la même tâche logique après des expirations de délai côté client.
- Tester les scénarios d’échec. Validez la gestion des réponses HTTP 400, 408, 429 et 5xx temporaires avant d’utiliser le traitement Flex dans les flux de travail de production.
- Passez en revue la prise en charge du modèle avant les mises à niveau. Un modèle de remplacement ou une version de modèle n’hérite pas automatiquement de la prise en charge de Flex.
Redéfinir le niveau de service à l’aide d’un en-tête de requête
Utilisez l’en-tête x-ms-service-tier de requête lorsqu’une passerelle, un proxy ou une couche de routage centralisée doit sélectionner le niveau de service sans inspecter ou modifier le corps de la requête. L’en-tête peut également réduire les modifications de migration pour les applications qui sélectionnent déjà un niveau de service OpenAI via un en-tête de requête.
L’en-tête accepte les valeurs suivantes :
| Valeur de l’en-tête | Niveau de traitement demandé |
|---|---|
flex |
Flex |
priority |
Priority |
default |
Standard |
auto |
Priority |
Lorsque l’en-tête est présent et valide, il prévaut sur la valeur service_tier dans le corps de la requête.
| Entrée d’en-tête | Entrée du corps de la requête | Comportement et sortie |
|---|---|---|
| En-tête omis | Valeur valide service_tier |
Le corps de la requête sélectionne le niveau. Une réponse réussie identifie le niveau traité dans service_tier. |
| Valeur d’en-tête valide | Toute valeur ou omise | L’en-tête sélectionne le niveau demandé. Une réponse réussie identifie le niveau traité dans service_tier. |
| Valeur d’en-tête non prise en charge | Toute valeur ou omise | La requête retourne HTTP 400. Le service ne revient pas à la valeur du corps de la requête. |
Cet exemple sollicite le traitement Flex via l’en-tête. L’en-tête remplace la valeur default dans le corps de la requête :
curl -X POST https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/responses \
  -H "Content-Type: application/json" \
  -H "api-key: $AZURE_OPENAI_API_KEY" \
  -H "x-ms-service-tier: flex" \
  -d '{
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
    "service_tier": "default"
  }'
{
    "service_tier": "flex",
    "status": "completed",
    "output": [<response-output>]
}
L’en-tête de remplacement ne fournit pas de restauration automatique. Une valeur d’en-tête non valide ou un niveau que le déploiement sélectionné ne prend pas en charge retourne HTTP 400.