Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Azure Batch exécute des travaux par lots parallèles à grande échelle et de calcul haute performance (HPC) dans Azure. Batch crée et gère des pools de nœuds de calcul, installe les applications que vous souhaitez exécuter et planifie les travaux à exécuter sur les nœuds.
Lorsque vous utilisez Azure, la fiabilité est une responsabilité partagée. Microsoft offre une gamme de fonctionnalités permettant de prendre en charge la résilience et la récupération. Vous êtes responsable de comprendre le fonctionnement de ces fonctionnalités dans tous les services que vous utilisez et de sélectionner les fonctionnalités dont vous avez besoin pour atteindre vos objectifs métier et vos objectifs de temps d’activité.
Cet article explique comment rendre Azure Batch résilient aux erreurs temporaires, aux défaillances de nœud de calcul, aux défaillances de zone de disponibilité, aux défaillances à l’échelle de la région et à la maintenance du service. Il décrit également les recommandations de déploiement de production, l’architecture de fiabilité Batch, la sauvegarde et la restauration, ainsi que les informations clés sur le contrat de niveau de service (SLA) Azure Batch.
Recommandations concernant le déploiement de production
Pour les charges de travail de production, suivez les meilleures pratiques pour Azure Batch, y compris les recommandations de fiabilité suivantes :
Concevoir des tâches pour tolérer l’interruption et la réexécution. Effectuez des tâches idempotentes, créez des points de contrôle pour les tâches de longue durée et enregistrez les données de sortie et de diagnostic requises dans un stockage durable. Pour plus d’informations, consultez Résilience aux erreurs temporaires et résilience aux défaillances de nœud de calcul.
Utilisez plusieurs nœuds de calcul lorsque votre charge de travail doit continuer après une défaillance de nœud. Les nœuds de calcul individuels ne sont pas garantis pour rester disponibles. Provisionnez suffisamment de nœuds afin que les nœuds utilisables restants puissent exécuter des tâches replanifiées.
Utilisez le placement de zone de disponibilité lorsqu’il est pris en charge. Configurez l’emplacement des zones de disponibilité lorsque la région, la référence SKU de machine virtuelle et la configuration de la charge de travail la prennent en charge. Les nœuds dans des zones saines peuvent continuer à exécuter des tâches lors d’une panne de zone, mais prévoyez une capacité réduite, car la capacité de remplacement dépend du quota et de la disponibilité des machines virtuelles dans les zones saines. Pour plus d’informations, consultez Résilience aux échecs de zone de disponibilité.
Concevoir des travaux pour cibler des pools dynamiquement plutôt qu’un ID de pool fixe. Cette conception vous permet de recibler un travail vers un pool sain si le pool d’origine devient indisponible ou ne parvient pas à atteindre la capacité souhaitée. Elle améliore la continuité de l’activité pendant la maintenance ou la défaillance du pool.
Conservez les configurations de pool à jour. Surveillez les dates de fin de vie (EOL) de la prise en charge Batch pour les images et références SKU de machine virtuelle, et migrez les pools avant la fin de vie. Suivez les instructions de maintenance du service pour maintenir l’agent de nœud Batch à jour.
Vue d’ensemble de l’architecture de fiabilité
Cette section décrit certains des aspects importants du fonctionnement du service qui sont les plus pertinents du point de vue de la fiabilité. La section présente l’architecture logique, qui inclut certaines des ressources et fonctionnalités que vous déployez et utilisez. Il traite également de l’architecture physique, qui fournit des détails sur le fonctionnement du service sous les couvertures.
Architecture logique
Azure Batch utilise plusieurs types de ressources pour exécuter des charges de travail par lots. La configuration de ces ressources détermine la façon dont votre charge de travail répond aux défaillances.
L’ensemble du traitement Batch et toutes les ressources sont associés à un compte Batch . Une solution Batch utilise les composants logiques suivants :
Compte Batch : Ressource régionale avec laquelle les pools, les travaux, les tâches et d’autres ressources Batch sont associés. Vous créez le compte et sélectionnez sa région, son mode d’allocation de pool et ses paramètres d’authentification.
Pool : Collection de nœuds de calcul sur lesquels les tâches s’exécutent. La configuration d’un pool définit son image et sa taille de machine virtuelle, son nombre de nœuds cibles, son comportement de mise à l’échelle, sa configuration réseau et son emplacement de zone. Vous configurez chaque pool pour fournir la capacité, le placement et l’environnement d’exploitation requis par votre charge de travail. Le nombre de nœuds cibles est la capacité demandée, mais le nombre de nœuds alloués peut être inférieur en raison des limites de quota, des contraintes de capacité ou des échecs d’allocation.
Travaux et tâches : un travail gère une collection de tâches et est associé à un pool. Une tâche exécute une application ou un script sur un nœud de calcul. Vous définissez des jobs, des tâches, des contraintes, des dépendances, un comportement de nouvelle tentative et le pool sur lequel chaque job s’exécute.
Compte de stockage associé : Un compte stockage Azure que vous pouvez éventuellement lier à un compte Batch. La plupart des solutions Batch utilisent un compte de stockage associé pour les fichiers d’application, les fichiers de ressources de tâche, les données d’entrée et les données de sortie.
Une fois que vous avez lié un compte de stockage à un compte Batch, Batch y fait référence sous le nom de compte de stockage automatique. Un compte Autostorage est requis pour les packages d’application et peut également stocker des fichiers de ressources de tâche.
La fiabilité d’une solution Batch dépend de ses ressources de stockage. Vous êtes responsable de la sélection d’une configuration de redondance de stockage qui répond à vos exigences de récupération lorsque vous créez le compte de stockage. Déplacez la sortie des tâches et d’autres données durables hors des nœuds de calcul vers le stockage. Pour plus d’informations sur les options de fiabilité stockage Azure, consultez Fiabilité dans Stockage Blob Azure.
Pour plus d’informations, consultez flux de travail et ressources de service Batch et comptes Batch et comptes stockage Azure.
Architecture physique
Azure Batch dispose d’un plan de contrôle régional qui traite les opérations de gestion sur des comptes Batch et d’autres ressources Batch, telles que des pools, des travaux et des tâches. Il est distinct des nœuds de calcul qui exécutent des tâches.
Les pools de calcul Azure Batch utilisent Machines virtuelles Azure et Virtual Machine Scale Sets. Un nœud de calcul est une machine virtuelle qui traite une partie d’une charge de travail Batch. Chaque nœud appartient à un pool et exécute des tâches que le service Batch lui attribue. L’agent de nœud Batch s’exécute sur chaque nœud et fournit l’interface de commande et de contrôle entre le nœud et le service Batch. Les nœuds de calcul et leur stockage local sont éphémères. Lorsqu’un nœud quitte un pool, les modifications apportées à son système d’exploitation et à ses fichiers sont perdues.
Le mode d’allocation de pool du compte Batch détermine où Batch crée les ressources liées au calcul et aux machines virtuelles :
- Mode d’allocation du pool de services Batch : Batch alloue les ressources dans les abonnements Azure gérés par le service Batch.
- Mode d’allocation du pool d’abonnements utilisateur : Batch crée les ressources directement dans l’abonnement qui contient le compte Batch.
Les responsabilités pour l’architecture physique sont divisées comme suit :
Microsoft : Microsoft exploite le plan de contrôle régional Batch et l’infrastructure de service. Batch provisionne des nœuds de calcul en fonction de la configuration du pool et de la capacité disponible, planifie les tâches, surveille l’intégrité des nœuds et tente de récupérer des nœuds après les défaillances de l’infrastructure. Batch peut requeuler des tâches interrompues pour l’exécution sur un autre nœud disponible.
Vous : Vous sélectionnez l’image et la taille de la machine virtuelle, les types de nœuds, le nombre de nœuds cibles, la configuration de mise à l’échelle, la mise en réseau et l’emplacement de la zone de disponibilité.
Vous êtes également responsable de maintenir une capacité suffisante pour tolérer les défaillances de nœud, surveiller les états des nœuds et des tâches, maintenir le système d’exploitation invité et l’agent de nœud à jour, concevoir des tâches pour tolérer la réexécution et déplacer des données durables hors des nœuds de calcul.
La récupération de nœud Batch ne garantit pas qu’une charge de travail continue sans interruption. Pour plus d’informations, consultez Résilience aux défaillances de nœud de calcul.
Résilience aux erreurs temporaires
Les erreurs temporaires sont des défaillances courtes et intermittentes dans les composants. Elles se produisent fréquemment dans un environnement distribué comme le cloud, et font partie intégrante des opérations ordinaires. Les erreurs temporaires se corrigent après une courte période de temps. Il est important que vos applications puissent gérer les erreurs temporaires, généralement en réessayant les requêtes affectées.
Toutes les applications hébergées dans le cloud doivent suivre les instructions de gestion des erreurs temporaires Azure lorsqu’elles communiquent avec toutes les API, bases de données et autres composants hébergés dans le cloud. Pour plus d’informations, voir Recommandations concernant le traitement des pannes transitoires.
Dans une solution Batch, les erreurs temporaires peuvent affecter les applications et les scripts qui s’exécutent en tant que tâches et toutes les applications qui appellent des API Batch pour gérer les ressources Batch. Batch fournit des mécanismes de nouvelle tentative au niveau de la tâche. Vous êtes responsable de la configuration des contraintes de tâche, de rendre les tâches idempotentes (sans risque de s’exécuter plusieurs fois) et de la configuration du comportement de nouvelle tentative pour les appels au service Batch et à d’autres dépendances.
Réessais des tâches et limites de temps
Configurez maxTaskRetryCount pour contrôler combien de fois Batch retente une tâche après la fin de son processus avec un code de sortie différent de zéro :
- La valeur par défaut,
0, signifie que Batch ne réessaie pas la tâche après un code de sortie différent de zéro. - Un entier positif définit un nombre maximal de nouvelles tentatives après la tentative initiale.
- Une valeur de
-1autorise un nombre illimité de nouvelles tentatives. Cette valeur n’est pas recommandée, car une défaillance persistante peut entraîner l’exécution indéfinie de la tâche.
Concevez chaque tâche pour qu’elle soit idempotente afin que les nouvelles tentatives ne provoquent pas d’altération des données ou de sortie en double. Pour les tâches de longue durée, utilisez les points de contrôle afin qu’une nouvelle tentative puisse continuer à partir de la progression enregistrée. Pour plus d’informations, consultez Conception pour les nouvelles tentatives et la réexécution.
Définissez la contrainte maxWallClockTime pour une tâche ou un travail afin de mettre fin à l’exécution qui ne progresse pas dans un délai acceptable. Une limite de temps limite également l’effet des défaillances répétées. Sélectionnez les nombres de nouvelles tentatives et les limites de temps qui s’alignent sur les objectifs de récupération de la charge de travail.
Erreurs temporaires dans les dépendances de tâche
Les applications et les scripts qui s’exécutent en tant que tâches Batch appellent souvent d’autres composants, tels que stockage Azure, les bases de données ou les API. Batch ne gère pas les requêtes individuelles que le code de tâche envoie à ces dépendances. Implémentez la gestion des erreurs temporaires dans le code de tâche ou utilisez des fonctionnalités de nouvelle tentative fournies par le Kit de développement logiciel (SDK) de la dépendance. Suivez les instructions de chaque dépendance pour identifier les erreurs pouvant faire l’objet d’une nouvelle tentative, sélectionnez les paramètres de temporisation et de délai d’attente appropriés, et respectez les instructions de nouvelle tentative telles que l’en-tête Retry-After. Réessayez uniquement les opérations pouvant être répétées sans risque.
Si un échec de dépendance entraîne la sortie du processus de tâche avec un code de sortie différent de zéro, Batch peut réessayer toute la tâche en fonction de maxTaskRetryCount. Toutefois, Batch n’effectue pas de nouvelle tentative d’une requête de dépendance individuelle au sein d’une tâche en cours d’exécution.
Nouvelles tentatives de demande d’API Batch
Vos applications s’exécutant en dehors du service peuvent appeler des API Batch pour créer et gérer des pools, des travaux, des tâches, des nœuds de calcul et d’autres ressources Batch. Configurez ces clients avec des stratégies de nouvelle tentative qui s’étendent sur au moins cinq minutes pour gérer les défaillances temporaires du service Batch ou du réseau.
Utilisez la prise en charge intégrée des nouvelles tentatives du Kit de développement logiciel (SDK) lorsqu’il est disponible. Par exemple, la bibliothèque cliente Azure.Compute.Batch pour .NET expose le comportement de nouvelle tentative via les options Azure.Core de nouvelle tentative.
Si vous interagissez directement avec les API du service Batch à partir de votre code, attendez plusieurs secondes avant de réessayer, utilisez une temporisation exponentielle avec randomisation (gigue) pour éviter les demandes de nouvelle tentative synchronisées et respectez l’en-tête Retry-After retourné avec des réponses de limitation telles que 429 Too Many Requests et 503 Service Unavailable.
Un délai d’expiration de requête ne signifie pas nécessairement que Batch n’a pas réussi à traiter la requête. Après un délai d’expiration, réessayez l’opération lorsqu’il est sûr de le faire ou récupérez l’état de la ressource pour déterminer si l’opération d’origine a réussi. Pour plus d’informations, consultez Gestion et détection des erreurs dans Azure Batch.
Résilience aux défaillances des nœuds de calcul
Un nœud de calcul peut devenir indisponible en raison d’une défaillance de l’infrastructure, d’un problème de système d’exploitation ou d’un problème de configuration. Batch tente de récupérer les nœuds affectés par les défaillances d’infrastructure, mais il ne peut pas récupérer automatiquement chaque échec lié à la configuration. Par exemple, si un package d’application ou un conteneur ne parvient pas à s’installer, vous devez corriger le problème sous-jacent et vous devrez peut-être supprimer et remplacer le nœud concerné.
Si un échec de nœud interrompt une tâche, Batch peut réessayer la tâche sur le même nœud, le cas échéant, jusqu’à une limite interne. Si la tâche ne peut pas continuer sur ce nœud, Batch peut la remettre en file d’attente pour l’exécution sur un autre nœud disponible. Ces nouvelles tentatives de récupération pilotées par le service sont indépendantes de maxTaskRetryCount et peuvent se produire même quand sa valeur est 0.
processus de récupération de nœud géré par Microsoft
Microsoft gère la récupération des nœuds pilotés par le service et la mise en file d’attente des tâches. Si le service Batch cesse de recevoir des signaux de pulsation d’un nœud suffisamment longtemps pour déclencher la récupération, Batch peut effectuer les actions suivantes :
-
Isolez le nœud : Batch traite le nœud comme non sain, définit son état sur
unusableet arrête la planification de nouvelles tâches sur celui-ci. - Identifier les tâches affectées : Batch identifie les tâches qui s’exécutaient sur le nœud en tant que candidats à la nouvelle planification.
-
Remettre en file d’attente les tâches éligibles : Si une tâche affectée est toujours conservée dans l’état
running, Batch peut la réinitialiser àactiveafin que le planificateur puisse l’affecter à un autre nœud. Batch ne réinitialise pas et ne réexécute pas une tâche déjà enregistrée dans l’étatcompleted. - Récupérez le nœud : Batch tente de restaurer le nœud dans un état sain ou de remplacer la machine virtuelle sous-jacente.
La récupération n’est pas instantanée. Une tâche peut rester dans l’état running pendant que Batch détecte l’échec du nœud et tente de replanifier la tâche. Si aucun autre nœud de calcul n’est disponible, la tâche peut rester dans cet état jusqu’à ce que Batch puisse la replanifier. Pour plus d’informations, consultez Limitations connues pour les tâches Batch.
Si le nœud d’origine reprend des signaux de pulsation sains avant le début du remplacement, Batch peut le rétablir dans un état stable. Si le remplacement a déjà commencé, Batch peut à la place supprimer la machine virtuelle d’origine et approvisionner un remplacement.
Vos responsabilités
La récupération pilotée par le service ne garantit pas l’exécution ininterrompue des tâches ou une capacité restante suffisante. Vous êtes responsable des actions suivantes :
Maintenir une capacité suffisante : Si votre charge de travail doit continuer pendant qu’un nœud n’est pas disponible, provisionnez suffisamment de nœuds pour que les nœuds restants exécutent des tâches replanifiées. Sans un autre nœud utilisable, les tâches interrompues doivent attendre.
Surveiller la capacité utilisable : Suivez le nombre total de nœuds et leurs états afin de pouvoir détecter quand un pool n’a plus suffisamment de nœuds utilisables pour votre charge de travail. États tels que
unusable,unknown,startTaskFailedetpreemptedindiquent une capacité réduite. Pour plus d’informations, consultez Surveiller les solutions Batch en comptant les tâches et les nœuds par état.Examiner les nœuds de problème : Si les tâches échouent à plusieurs reprises, sont requeuées ou restent dans l’état
runningaprès que leur nœud affecté devient inutilisable ou quitte le pool, utilisez les métadonnées de tâche pour déterminer si les problèmes sont associés à un nœud spécifique.Avant de supprimer un nœud problématique, chargez ses journaux d’activité de l’agent de nœud Batch et conservez les journaux des tâches pertinents, car la suppression du nœud supprime ses fichiers locaux. Les journaux d’activité de l’agent de nœud peuvent aider Support Microsoft à diagnostiquer les problèmes de service ou de nœud Batch, tandis que les journaux des tâches tels que stdout et stderr peuvent vous aider à identifier les problèmes d’application et de configuration. Pour plus d’informations, consultez les fichiers journaux de l’agent Node.
Protégez la progression des tâches et les données : Concevez des tâches pour tolérer l’interruption et la réexécution. Déplacer des points de contrôle, des sorties et d’autres données durables hors des nœuds de calcul, car leur stockage local est éphémère.
Pour plus d’informations, consultez Pools Azure Batch et erreurs de nœud et Gestion et détection des erreurs dans Azure Batch.
Résilience aux échecs de zone de disponibilité
Les zones de disponibilité sont des groupes physiquement distincts de centres de données au sein d’une région Azure. Lorsqu'une zone tombe en panne, les services peuvent basculer vers l'une des zones restantes.
Batch prend en charge les zones de disponibilité de deux manières principales :
Plan de contrôle : le plan de contrôle Batch est résilient aux zones dans de nombreuses régions. Dans ces régions, les opérations de gestion sur les comptes Batch et d’autres ressources Batch peuvent continuer pendant une défaillance de zone. Microsoft ne publie pas les régions qui offrent cette résilience du plan de contrôle.
Pools : Vous pouvez configurer un pool Batch pour utiliser le placement dans une zone de disponibilité. Si une zone devient indisponible, les nœuds de calcul dans des zones saines restent disponibles pour la planification des tâches.
Pour le placement des nœuds de calcul, ce modèle de prise en charge est similaire à la redondance de zone dans d’autres services Azure, car un pool unique peut contenir des nœuds de calcul dans plusieurs zones de disponibilité. Toutefois, Batch distribue les nœuds entre les zones dans la mesure du possible. Il tente d’utiliser toutes les zones de la région, mais ne garantit pas le placement dans chaque zone ni une répartition uniforme. Vous ne pouvez pas sélectionner des zones spécifiques ni contrôler le nombre de nœuds placés dans chaque zone.
Le diagramme suivant montre un exemple de compte Batch. Le compte dispose d’un pool unique avec ses nœuds répartis entre trois zones de disponibilité :
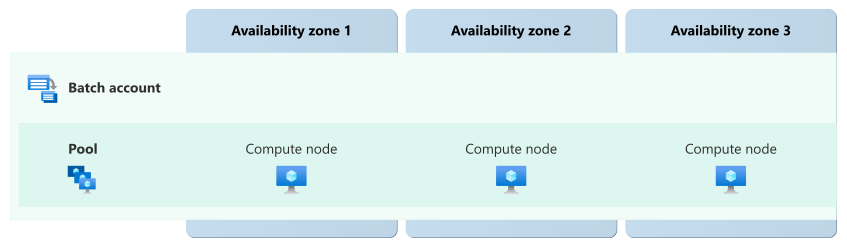
Le diagramme montre un compte Batch qui contient un pool. Le pool a trois nœuds de calcul, avec un nœud affiché dans chacune des zones de disponibilité 1, 2 et 3. Le placement de zone de disponibilité s’applique aux nœuds de calcul et ne détermine pas la résilience aux zones de disponibilité du plan de contrôle Batch. La distribution est un exemple, car Batch utilise l’équilibrage de zone best-effort et ne garantit pas un nœud dans chaque zone.
Vous êtes responsable de rendre d’autres ressources dépendantes, telles que les comptes de stockage, résistantes aux zones. Passez en revue les guides de fiabilité pour chaque service. Pour plus d’informations, consultez les guides de fiabilité des services Azure.
Requirements
Prise en charge de la région : Créez le pool dans une région Azure qui prend en charge les zones de disponibilité.
Disponibilité de la référence SKU de machine virtuelle : La référence SKU de machine virtuelle sélectionnée doit être disponible dans plusieurs zones de la région. Utilisez l’API Références SKU de ressource - Lister pour vérifier le champ
locationInfode la référence SKU de machine virtuelle.Accès aux abonnements : Pour un mode d’allocation de pool d’abonnements utilisateur, l’abonnement ne doit pas avoir de restriction d’offre de zone pour la référence SKU de machine virtuelle sélectionnée. Vérifiez
ResourceSkuRestrictionsdans la réponse de l’API Liste des références SKU de ressource. Si une restriction existe, envoyez une demande de support pour demander sa suppression.Communication entre nœuds : Un pool ne peut pas utiliser de stratégie de placement de zone de disponibilité lorsque la communication entre nœuds est activée avec une SKU de VM compatible InfiniBand.
Distribution d’instances entre zones
Lorsque vous activez le positionnement des zones de disponibilité, Batch tente d’allouer des nœuds de calcul dans toutes les zones de disponibilité de la région sélectionnée. Cette allocation est effectuée dans la mesure du possible. Batch contrôle la distribution et le nombre de nœuds dans chaque zone peut ne pas être égal.
Coûts
Batch n’ajoute pas de frais pour l’activation du placement dans une zone de disponibilité. Vous êtes facturé pour le calcul, le stockage, la mise en réseau et d'autres ressources Azure utilisées par la charge de travail. Si vous provisionnez des nœuds supplémentaires pour tolérer la perte d’une zone, ces nœuds sont facturés au tarif normal. Pour plus d’informations, consultez Azure Batch tarification.
Configurez la prise en charge des zones de disponibilité
Créez un pool avec un emplacement de zone de disponibilité : Pour créer un pool avec placement de zone de disponibilité activé, consultez Créer un pool Batch entre les zones de disponibilité.
Modifiez le placement de zone de disponibilité sur un pool existant : Vous devez sélectionner le placement de zone de disponibilité lorsque vous créez le pool. Vous ne pouvez pas modifier un pool existant pour utiliser des zones de disponibilité.
Vous pouvez créer un pool de remplacement et mettre à jour chacune de vos tâches pour l’utiliser en procédant comme suit :
Désactivez le job : Utilisez l’opération Désactiver le job et sélectionnez la façon dont Batch gère les tâches en cours d’exécution lorsque vous envoyez la demande :
-
Attendez : Batch arrête de démarrer de nouvelles tâches et permet aux tâches en cours de se terminer sur le pool existant. Le travail reste dans l’état
disablingjusqu’à ce que les tâches en cours d’exécution se terminent. - Remettre en file d’attente : Batch interrompt l’exécution des tâches et les retourne à la file d’attente. Les tâches peuvent s’exécuter à nouveau une fois que vous avez activé le job.
- Terminer : Le traitement par lots interrompt les tâches en cours d’exécution et les marque comme terminées avec les informations d’échec qui indiquent qu’elles ont été arrêtées. Les tâches ne s’exécutent pas de nouveau une fois que vous avez activé le job.
Les tâches qui sont déjà dans l’état
active, ce qui signifie qu’elles sont mises en file d’attente mais pas en cours d’exécution, elles restent mises en file d’attente avec chaque option.Attendez que la tâche atteigne l’état
disabledavant de continuer. À ce stade, aucune tâche n’est en cours d’exécution et Batch ne planifie pas de nouvelles tâches.-
Attendez : Batch arrête de démarrer de nouvelles tâches et permet aux tâches en cours de se terminer sur le pool existant. Le travail reste dans l’état
Modifier le pool du travail : utilisez l’opération Mettre à jour un travail pour définir le
poolInfo.poolIddu travail sur le pool de remplacement. Batch autorise uniquement cette propriété à changer pendant que la tâche est dans l’étatdisabled. Vérifiez que le pool de remplacement existe et dispose d’une capacité utilisable avant d’activer la tâche. Si le pool n’existe pas, Batch accepte la mise à jour, mais il ne peut pas planifier les tâches tant que vous n’avez pas créé le pool.Activez le travail : utilisez l’opération Activer le travail. La tâche passe de l’état
enablingà l’étatactive. Batch planifie ensuite les tâches en file d’attente, y compris les tâches retournées à la file d’attente par l’option Requeue , sur le pool de remplacement. Les tâches terminées lorsque Batch a appliqué l’option Attendre et les tâches terminées par l’option Terminer ne s’exécutent pas à nouveau.
Planification de capacité et gestion
Le processus normal de récupération des nœuds de Batch tente de remplacer les nœuds qui deviennent inutilisables lors d’une défaillance de zone et restaure le pool sur son nombre de nœuds cibles configuré. Cela n’augmente pas la cible. Pour conserver suffisamment de capacité pour la charge de travail afin de continuer lorsqu’une zone n’est pas disponible, envisagez de surprovisionner la capacité du pool à l’aide de la mise à l’échelle automatique ou manuellement :
Si vous utilisez la mise à l’échelle automatique : référencez la
$UsableNodeCountvariable définie par le service dans la formule de mise à l’échelle automatique du pool pour détecter quand la capacité utilisable tombe en dessous du niveau de référence requis par votre charge de travail.$UsableNodeCountest une variable de mise à l’échelle automatique Batch pour le pool dont la formule est évaluée, et non une métrique Azure Monitor. Azure Monitor publie des métriques de nombre de nœuds Batch dans l'étendue du compte Batch et ces métriques n'ont pas depoolIddimension.Si vous gérez la capacité manuellement : Utilisez l’opération List Pool Node Counts pour récupérer les nombres de nœuds dédiés et de nœuds Spot dans chaque état pour chaque pool. L’opération ne renvoie pas un nombre unique de nœuds utilisables. Évaluer les états compatibles avec les tâches, tels que
idleetunusable, par rapport aux états non disponibles ou problématiques tels queunknown,offline,startTaskFailedetrunning. Les nombres retournés peuvent ne pas être à jour. Énumérez donc les nœuds de calcul du pool lorsque vous avez besoin d’un nombre exact.
Batch distribue les nœuds entre les zones dans la mesure du possible, il se peut donc que la distribution réelle ne soit pas uniforme. Ne supposez pas que les nœuds sont répartis de façon égale entre les zones lorsque vous planifiez la capacité. Vérifiez que votre workload peut atteindre ses objectifs de reprise avec une capacité de pool réduite.
Comportement lorsque toutes les zones sont saines
Cette section décrit ce qu’il faut attendre lorsqu’un pool Batch utilise le positionnement des zones de disponibilité et que toutes les zones sont opérationnelles.
Opération interzone : Batch planifie les tâches sur les nœuds de calcul disponibles dans l’ensemble du pool, quelle que soit la zone qui contient chaque nœud.
Réplication des données interzones : Les nœuds de calcul Batch sont éphémères et Batch ne réplique pas les fichiers de tâches entre les zones. Vous êtes responsable du déplacement des données d’entrée, de sortie, de points de contrôle et de diagnostic qui doivent survivre à la perte de nœud dans un stockage durable. Configurez la redondance du compte de stockage pour répondre à vos besoins de disponibilité.
Comportement lors d’une défaillance de zone
Cette section décrit ce qu’il faut attendre lorsqu’un pool Batch utilise le placement de zone de disponibilité et qu’une zone de disponibilité n’est pas disponible.
Détection et réponse : Microsoft surveille le service Batch et l’intégrité des nœuds de calcul. Lors d’une défaillance de zone, Batch détecte une perte persistante des signaux de pulsation des nœuds affectés et démarre son processus normal de récupération des nœuds. Les nœuds dans des zones saines restent disponibles et Batch peut continuer à planifier des tâches sur ces nœuds.
Batch tente de ramener le pool au nombre cible de nœuds configuré par le biais de son processus de récupération normal, mais il n’augmente pas cette cible. Il vous incombe de demander une capacité supplémentaire si la cible ne fournit pas une capacité suffisante pour la charge de travail.
- Notification: Microsoft ne vous avertit pas automatiquement lorsqu’une zone est en panne. Toutefois, vous pouvez utiliser Azure Service Health pour comprendre l’intégrité globale du service, y compris les défaillances de zone, et vous pouvez configurer des alertes Service Health pour vous avertir des problèmes.
Tâches actives : Les tâches exécutées sur les nœuds affectés sont interrompues. Batch peut replanifier les tâches sur les nœuds disponibles dans le cadre de son comportement de récupération interne. Concevoir des tâches pour tolérer les nouvelles tentatives et la réexécution, comme décrit dans Résilience aux erreurs temporaires et résilience aux défaillances de nœud de calcul.
Perte de données attendue : Les fichiers sur les nœuds de calcul affectés ne sont pas disponibles pendant la panne et sont perdus si les nœuds sont réimagenés ou supprimés du pool. Batch ne réplique pas ces fichiers entre les zones. Les données conservées dans un stockage durable restent disponibles en fonction de la configuration de redondance de cette ressource de stockage.
Temps d’arrêt attendu : Les tâches sur les nœuds sains continuent. Les tâches interrompues subissent un temps d’arrêt jusqu’à ce que Batch puisse les replanifier sur des nœuds utilisables. Si aucun nœud utilisable n’est disponible, une tâche peut rester dans l’état
runningjusqu’à ce que Batch puisse la replanifier. Le temps de récupération dépend de la capacité de pool disponible et de la charge de travail mise en file d’attente.Les opérations de gestion sur les comptes Batch et d’autres ressources Batch continuent si le compte se trouve dans une région où le plan de contrôle est résilient aux zones. Dans d’autres régions, les opérations de gestion peuvent être indisponibles tant que la zone affectée ne s’est pas rétablie.
Redistribution : Après une perte prolongée des signaux heartbeat, Batch marque les nœuds affectés comme
unusableinutilisables et les envoie pour remplacement par le biais de son processus normal de récupération des nœuds. Batch tente de restaurer le pool sur son nombre de nœuds cible configuré, mais la capacité de remplacement dépend du quota et de la disponibilité des machines virtuelles dans les zones saines.Les tâches restent associées au pool pendant ce processus. Batch continue de planifier des tâches à partir de jobs actifs sur des nœuds utilisables dans des zones saines. Si les nœuds de remplacement sont alloués et deviennent utilisables, Batch peut également planifier des tâches sur ces nœuds.
Ce processus de récupération n’augmente pas le nombre de nœuds cibles configuré. Si votre charge de travail nécessite une capacité au-delà de cette cible, augmentez-la manuellement ou configurez la formule de mise à l’échelle automatique du pool pour ce faire.
Récupération de la zone
Batch gère le processus de récupération lorsqu’une zone récupère après une défaillance. Batch suit le même processus que celui défini dans Résilience aux échecs de nœud de calcul.
Batch ne garantit pas que les nœuds sont rééquilibrés uniformément entre les zones de disponibilité après la reprise. L’emplacement des zones se fait au mieux.
Tester les pannes de zone
Vous ne pouvez pas simuler une panne réelle de zone de disponibilité Azure pour les tests. Utilisez plutôt un pool hors production pour interrompre les tâches représentatives et mettre suffisamment de nœuds de calcul hors service pour estimer la perte de capacité attendue. Envisagez d’utiliser les opérations de nœud prises en charge suivantes :
- Redémarrez les nœuds sélectionnés.
- Désactivez la planification des tâches sur les nœuds sélectionnés.
- Supprimez les nœuds sélectionnés du pool.
Lorsqu’une opération vous permet de choisir comment gérer les tâches en cours d’exécution, sélectionnez l’option Requeue afin que Batch puisse planifier les tâches interrompues sur les nœuds restants.
Pendant le test, vérifiez que Batch replanifie les tâches interrompues et que la réexécution ne produit pas de sortie dupliquée ou incohérente. Vérifiez que les points de contrôle et les données de sortie restent disponibles à partir du stockage durable, que la surveillance détecte la perte de nœuds et la diminution de capacité, et que la charge de travail peut s’exécuter jusqu’au bout avec la capacité restante.
Ces opérations valident l’interruption et la replanification des tâches, l’idempotence, les points de contrôle et la gestion durable des sorties. Toutefois, ils ne reproduisent pas tous les effets d’une défaillance à l’échelle de la zone.
Résilience aux défaillances à l’échelle de la région
Un compte Batch et ses pools sont limités à une région Azure. Si la région subit une défaillance, vos tâches et pools Batch peuvent être affectés.
Batch ne réplique pas les comptes, la configuration du pool, les travaux, les tâches, les packages d’application ou les données de tâche vers une autre région, et ne fournit pas de basculement interrégion intégré. Vous êtes responsable du déploiement et de l’exploitation d’une solution Batch multirégion lorsque votre charge de travail doit tolérer une défaillance touchant toute une région.
Solutions multirégions personnalisées pour la résilience
Pour créer une solution multirégion, déployez au moins un compte Batch dans chaque région que votre conception de récupération utilise. Les comptes Batch fonctionnent indépendamment d’une région à l’autre. Vous êtes responsable de la sélection des régions, du déploiement et de l’exploitation des ressources dans chaque région, et de la coordination de la configuration, de la réplication, du basculement et de la reprise.
Vous pouvez concevoir une approche active-active qui soumet le travail dans plusieurs régions pendant l’opération normale, ou une approche active-passive qui maintient le déploiement secondaire prêt pour le basculement. Les architectures actif-actif peuvent réduire le temps de récupération, car les deux déploiements traitent la charge pendant les opérations normales, tandis que les architectures actif-passif peuvent réduire les coûts de calcul à l’état stable.
La liste suivante fournit des exemples de vos responsabilités lorsque vous concevez la solution :
Déploiement : créez au préalable les comptes Batch, les pools ou les définitions de déploiement de pool, les comptes de stockage, les ressources réseau et d’autres dépendances dans chaque région. Vérifiez que chaque région sélectionnée prend en charge les fonctionnalités Batch, les tailles de machine virtuelle et les services dépendants requis par votre charge de travail. Conservez chaque compte Batch et les ressources de stockage utilisées par ses tâches dans la même région si possible pour éviter une latence inutile. Définissez des comptes, des pools et des ressources de support pour Batch à l’aide de l’infrastructure en tant que code afin que la configuration puisse être reproduite de manière cohérente entre les régions.
Quotas et capacité : Vérifiez le compte Batch, l’abonnement et les quotas de famille de machines virtuelles applicables dans chaque région de récupération et demandez des augmentations avant une panne si nécessaire. Un quota est une limite, pas une garantie de capacité. La disponibilité des machines virtuelles varie selon la région, la famille de machines virtuelles et l’heure. Pour plus d’informations, consultez les quotas de compte Batch et de cœurs.
Réplication des données : Conservez les packages d’application, les images conteneur, les données d’entrée et les données de référence disponibles dans chaque région de récupération. Batch ne duplique pas ces éléments pour vous.
Réplication du stockage : Configurez la redondance du stockage et la réplication des données inter-régions en fonction de votre objectif de point de récupération. Vérifiez que les données répliquées sont accessibles à partir de chaque région de récupération. Pour connaître les options de fiabilité du stockage, consultez Fiabilité dans Stockage Blob Azure.
Ciblage de région : Si vos applications fonctionnent avec votre compte Batch, concevez-les afin qu’elles puissent sélectionner un autre compte Batch et ses ressources de stockage associées sans nécessiter de déploiement de code.
Basculement : Batch ne déplace pas automatiquement votre charge de travail vers une autre région. Vous êtes responsable de détecter une panne, de déterminer comment la panne affecte votre charge de travail, d’arrêter les soumissions au compte Batch concerné, de diriger le nouveau travail vers un compte Batch dans une région saine et de décider s’il faut resoumettre les tâches interrompues. La sortie de travail ou de tâche que vous n’avez pas répliquée en dehors de la région affectée peut être indisponible ou perdue. Votre temps de récupération dépend de votre modèle de déploiement, de la capacité disponible, de la réplication des données et de l’automatisation.
Récupération de région : Une fois la disponibilité du service restaurée dans la région affectée, validez le compte Batch, les pools, les dépendances de stockage et l’état du travail avant de diriger le travail vers cette région. Résolvez les tâches dupliquées ou partiellement terminées avant la nouvelle soumission. Batch ne coordonne pas ce processus et ne réconcilie pas l’état entre les comptes régionaux.
Test : Testez régulièrement le processus de récupération régional complet dans un environnement hors production. Simulez un déploiement régional devenant indisponible, dirigez les soumissions vers un autre compte Batch régional, validez l’accès aux packages d’application et aux données d’entrée, exécutez des travaux représentatifs, collectez la sortie et entraînez-vous à remettre en service le déploiement rétabli. Mesurez les résultats par rapport à votre objectif de délai de récupération et à votre objectif de point de récupération.
Sauvegarde et restauration
Azure Batch n'est pas un stockage durable pour les données d'entrée et de sortie de charge de travail. Microsoft gère le service Batch, mais vous êtes responsable de la préservation de la configuration et des données nécessaires pour recréer votre charge de travail :
Configuration de Batch : définissez des comptes, des pools, des tâches et des ressources de prise en charge Batch à l’aide de l’infrastructure en tant que code, comme Bicep, et de définitions de travaux contrôlées par version. Ces artefacts offrent un moyen reproductible de recréer la configuration dans la même région ou une autre région. Testez régulièrement que les définitions peuvent déployer un pool et exécuter un travail représentatif.
Métadonnées Batch : Batch conserve les enregistrements de travail et de tâche jusqu’à ce que vous supprimiez le travail ou la tâche associé, mais ces enregistrements ne sont pas une sauvegarde. Si vous devez conserver cet historique, conservez les enregistrements requis en dehors de Batch.
Données sur les nœuds de calcul : Les nœuds de calcul sont éphémères et leurs systèmes de fichiers ne sont pas une sauvegarde ou un magasin durable. Les données sur un nœud sont perdues lorsque le nœud est réimagené ou quitte un pool. Batch peut également supprimer des fichiers de tâches après l’expiration de leur période de rétention. Enregistrez durablement la sortie requise et les journaux de diagnostic dans un stockage durable avant la fin d’une tâche. Pour les tâches de longue durée, conservez les points de reprise pendant l’exécution. Pour plus d’informations, consultez Conserver la sortie des travaux et des tâches et Surveiller Azure Batch.
Données dans les comptes Autostorage : Un compte Autostorage associé peut contenir des packages d’application et des fichiers de ressources de tâche. En plus de configurer la redondance qui répond à vos objectifs de récupération, déterminez si vous devez protéger ces données contre la suppression accidentelle ou la corruption. Pour plus d’informations, consultez Sauvegarde et récupération dans Stockage Blob Azure.
Test de restauration et de récupération
Pour effectuer la récupération, déployez Batch et la configuration des ressources associées, restaurez ou reconnectez les données d’entrée requises et les artefacts d’application, puis résoumettez les tâches qui ne se sont pas terminées. Testez régulièrement la reconstruction des ressources et la restauration des données dans un environnement de récupération isolé ou hors production. Utilisez des définitions contrôlées par la version et des données sauvegardées, exécutez un travail représentatif, vérifiez la sortie résultante et l’accès aux dépendances, et mesurez le temps de récupération et le point de récupération atteints par rapport à vos objectifs. Vérifiez que les tâches sont idempotentes afin que la remise à nouveau du travail incertain ne endommage pas les données ni ne crée une sortie dupliquée.
Résilience à la maintenance du service
Microsoft effectue la maintenance de la plateforme et coordonne les mises à jour de l’infrastructure pour Azure Batch et d’autres services. Vous êtes responsable de la configuration du comportement de mise à jour du pool et de concevoir des tâches pour qu’elles tolèrent les interruptions.
Maintenance de l’hôte : Azure utilise des techniques de maintenance telles que la migration dynamique lorsque cela est possible. Si la maintenance nécessite qu’un nœud de calcul redémarre ou soit déplacé, les tâches en cours d’exécution peuvent être interrompues et Batch peut les replanifier. Effectuez des tâches idempotentes et enregistrez les points de contrôle et la sortie dans un stockage durable.
Système d’exploitation invité : Vous êtes responsable de maintenir à jour le système d’exploitation invité et l’agent de nœud Batch. Le comportement de mise à jour du système d’exploitation dépend de la configuration de l’image et de la configuration de mise à jour. Avec la configuration appropriée, les mises à niveau automatiques d’images de système d’exploitation pour les pools Batch peuvent mettre à jour les nœuds du pool sans interrompre l’exécution des tâches. Les mises à niveau automatiques des images de système d’exploitation ne prennent pas en charge chaque image de système d’exploitation Batch.
Mises à jour de l’agent de nœud : Les mises à niveau automatiques d’images du système d’exploitation ne mettent pas automatiquement à jour l’agent de nœud Batch. Les agents de nœud Batch ne sont pas automatiquement mis à niveau tant qu’un pool contient des nœuds de calcul. Pour recevoir un agent de nœud plus récent, redimensionnez le pool sur zéro nœud et effectuez un scale-up à nouveau, ou remplacez le pool. Avant de supprimer des nœuds, conservez toutes les sorties de tâche requises et les journaux de diagnostic. Pour plus d’informations, consultez les mises à jour de l’agent de nœud Batch.
Suivez les recommandations de déploiement de production et les conseils en cas de défaillance des nœuds de calcul pour aider votre charge de travail à continuer ou à récupérer lorsque la maintenance interrompt les tâches ou rend les nœuds de calcul indisponibles.
Contrat de niveau de service
Le contrat de niveau de service (SLA) pour les services Azure décrit la disponibilité attendue de chaque service et les conditions que votre solution doit respecter pour atteindre cette attente de disponibilité. Pour plus d’informations, consultez les SLA pour les services en ligne.
Le contrat SLA de disponibilité Azure Batch s’applique aux opérations que vous effectuez sur l’API Batch. Pour plus d’informations sur les types d’opérations inclus, passez en revue le libellé du contrat SLA. La taille de votre pool, la distribution de zone et les services dépendants affectent la disponibilité de bout en bout de la charge de travail, mais ne modifient pas les termes du contrat SLA Batch.