Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Obtenez des résultats plus rapidement et évitez les délais d’expiration lors de l’exécution de requêtes complexes en optimisant vos requêtes. Pour obtenir des conseils sur l’amélioration des performances des requêtes :
- Conseils d’optimisation généraux - dans cet article
-
Optimiser l’opérateur
joindans cet article -
Optimiser l’opérateur
summarizedans cet article - Scénarios de requête : dans cet article
- Meilleures pratiques relatives aux requêtes Kusto : inclut plusieurs scénarios pour rendre votre requête plus efficace
- Optimiser les requêtes de journal dans Azure Monitor : contient des conseils supplémentaires pour l’optimisation des requêtes
- Optimisation des requêtes KQL (vidéo) : méthodes les plus courantes pour améliorer votre requête
Comprendre les quotas de ressources processeur
En fonction de sa taille, chaque locataire a accès à une quantité définie de ressources processeur allouées pour l’exécution de requêtes de repérage avancées. Pour plus d’informations sur les différents paramètres d’utilisation, consultez quotas de chasse avancés et paramètres d’utilisation.
Après avoir exécuté votre requête, vous pouvez voir le temps d’exécution et son utilisation des ressources (faible, moyen, élevé). Une valeur élevée indique que l’exécution de la requête a pris plus de ressources et qu’elle pourrait être améliorée pour retourner les résultats plus efficacement.
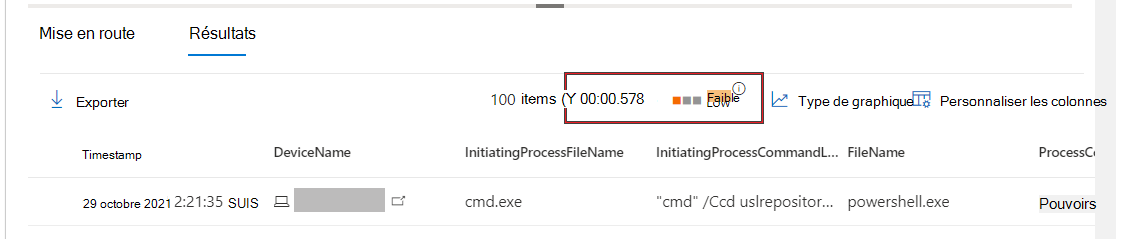
Les clients qui exécutent régulièrement plusieurs requêtes doivent suivre la consommation et appliquer les conseils d’optimisation de cet article pour réduire les interruptions résultant du dépassement des quotas ou des paramètres d’utilisation.
Conseils d’optimisation généraux
Dimensionner les nouvelles requêtes : si vous pensez qu’une requête retourne un jeu de résultats volumineux, évaluez-le d’abord à l’aide de l’opérateur count. Utilisez limit ou son synonyme
takepour éviter les jeux de résultats volumineux.Appliquer les filtres tôt : appliquez des filtres de temps et d’autres filtres pour réduire le jeu de données, en particulier avant d’utiliser des fonctions de transformation et d’analyse, telles que substring(),replace(), trim(), toupper() ou parse_json() . Dans l’exemple ci-dessous, la fonction d’analyse extractjson() est utilisée après que les opérateurs de filtrage ont réduit le nombre d’enregistrements.
DeviceEvents
| where Timestamp > ago(1d)
| where ActionType == "UsbDriveMount"
| where DeviceName == "user-desktop.domain.com"
| extend DriveLetter = extractjson("$.DriveLetter", AdditionalFields)
Has beats contains : pour éviter de rechercher inutilement des sous-chaînes dans des mots, utilisez l’opérateur
hasau lieu decontains. En savoir plus sur les opérateurs de chaîneLimitez la portée de votre recherche — Évitez d’exécuter des requêtes
searchouunionsans portée définie, car elles s’étendent à toutes les tables du schéma et peuvent dépasser les limites de taille des requêtes dans les environnements comportant de nombreuses tables. Utilisezsearch inpour spécifier les tables que vous souhaitez rechercher. Par exemple, au lieu desearch "email", utilisezsearch in (EmailEvents, EmailAttachmentInfo, IdentityInfo) "email".Rechercher dans des colonnes spécifiques : recherchez dans une colonne spécifique plutôt que d’exécuter des recherches en texte intégral. N’utilisez pas
*pour cocher toutes les colonnes.Respect de la casse pour plus de rapidité—Les recherches respectant la casse sont plus spécifiques et généralement plus performantes. Les noms des opérateurs de chaîne de caractères sensibles à la casse, tels que
has_csetcontains_cs, se terminent généralement par_cs. Vous pouvez également utiliser l’opérateur d’égalité sensible à la casse==au lieu de=~.Analyser, ne pas extraire : dans la mesure du possible, utilisez l’opérateur d’analyse ou une fonction d’analyse comme parse_json(). Évitez l’opérateur
matches regexde chaîne ou la fonction extract(), qui utilisent toutes deux une expression régulière. Réservez l’utilisation de l’expression régulière pour des scénarios plus complexes. En savoir plus sur les fonctions d’analyseFiltrer les tables et non les expressions : ne filtrez pas sur une colonne calculée si vous pouvez filtrer sur une colonne de table.
Pas de termes à trois caractères : évitez de comparer ou de filtrer des termes contenant trois caractères ou moins. Ces termes ne sont pas indexés et leur correspondance nécessite plus de ressources.
Projeter de manière sélective : facilitez la compréhension de vos résultats en projetant uniquement les colonnes dont vous avez besoin. La projection de colonnes spécifiques avant l’exécution d’opérations de jointure ou similaires permet également d’améliorer les performances.
Optimiser l’opérateur join
L’opérateur de jointure fusionne les lignes de deux tables en faisant correspondre les valeurs dans les colonnes spécifiées. Appliquez ces conseils pour optimiser les requêtes qui utilisent cet opérateur.
Table plus petite à gauche : l’opérateur
joinétablit une correspondance entre les enregistrements de la table située à gauche de votre instruction de jointure et les enregistrements à droite. En ayant la table plus petite à gauche, moins d’enregistrements devront être mis en correspondance, ce qui accélère la requête.Dans le tableau ci-dessous, nous réduisons le tableau de gauche
DeviceLogonEventspour le limiter à seulement trois appareils spécifiques avant de le joindre àIdentityLogonEventsà l’aide des SID de compte.DeviceLogonEvents | where DeviceName in ("device-1.domain.com", "device-2.domain.com", "device-3.domain.com") | where ActionType == "LogonFailed" | join (IdentityLogonEvents | where ActionType == "LogonFailed" | where Protocol == "Kerberos") on AccountSidUtilisez le type de jointure interne — Le type de jointure par défaut ou innerunique-join déduplique les lignes de la table de gauche selon la clé de jointure avant de retourner une ligne pour chaque correspondance dans la table de droite. Si la table de gauche a plusieurs lignes avec la même valeur pour la
joinclé, ces lignes sont dédupliquées pour laisser une seule ligne aléatoire pour chaque valeur unique.Ce comportement par défaut peut exclure des informations importantes de la table de gauche qui peuvent fournir des informations utiles. Par exemple, la requête ci-dessous n’affiche qu’un seul e-mail contenant une pièce jointe particulière, même si cette même pièce jointe a été envoyée à l’aide de plusieurs messages électroniques :
EmailAttachmentInfo
| where Timestamp > ago(1h)
| where Subject == "Document Attachment" and FileName == "Document.pdf"
| join (DeviceFileEvents | where Timestamp > ago(1h)) on SHA256
Pour remédier à cette limitation, nous appliquons la variante inner-join en spécifiant
kind=innerpour afficher toutes les lignes de la table de gauche ayant des valeurs correspondantes dans la table de droite :EmailAttachmentInfo | where Timestamp > ago(1h) | where Subject == "Document Attachment" and FileName == "Document.pdf" | join kind=inner (DeviceFileEvents | where Timestamp > ago(1h)) on SHA256Joindre des enregistrements à partir d’une fenêtre de temps : lors de l’examen des événements de sécurité, les analystes recherchent les événements connexes qui se produisent autour de la même période. L’application de la même approche lors de l’utilisation de
joinaméliore également les performances en réduisant le nombre d’enregistrements à examiner.La requête ci-dessous recherche les événements de connexion dans les 30 minutes suivant la réception d’un fichier malveillant :
EmailEvents
| where Timestamp > ago(7d)
| where ThreatTypes has "Malware"
| project EmailReceivedTime = Timestamp, Subject, SenderFromAddress, AccountName = tostring(split(RecipientEmailAddress, "@")[0])
| join (
DeviceLogonEvents
| where Timestamp > ago(7d)
| project LogonTime = Timestamp, AccountName, DeviceName
) on AccountName
| where (LogonTime - EmailReceivedTime) between (0min .. 30min)
Appliquer des filtres temporels des deux côtés — Même si vous n’analysez pas une période précise, l’application de filtres temporels sur les tableaux de gauche et de droite peut réduire le nombre d’enregistrements à vérifier et améliorer
joinles performances. La requête ci-dessous s’appliqueTimestamp > ago(1h)aux deux tables afin qu’elle joint uniquement les enregistrements de la dernière heure :EmailAttachmentInfo | where Timestamp > ago(1h) | where Subject == "Document Attachment" and FileName == "Document.pdf" | join kind=inner (DeviceFileEvents | where Timestamp > ago(1h)) on SHA256Utiliser des indicateurs pour les performances : utilisez des indicateurs avec l’opérateur
joinpour indiquer au back-end de répartir la charge lors de l’exécution d’opérations gourmandes en ressources. En savoir plus sur les indicateurs de jointure.Par exemple, l’indication shuffle permet d’améliorer les performances des requêtes pour joindre des tables à l’aide d’une clé à cardinalité élevée — une clé comportant de nombreuses valeurs uniques — comme
AccountObjectIddans la requête ci-dessous :IdentityInfo | where JobTitle == "CONSULTANT" | join hint.shufflekey = AccountObjectId (IdentityDirectoryEvents | where Application == "Active Directory" | where ActionType == "Private data retrieval") on AccountObjectIdL’indicateur de diffusion est utile lorsque la table de gauche est petite (jusqu’à 100 000 enregistrements) et que la table de droite est extrêmement volumineuse. Par exemple, la requête ci-dessous tente de joindre quelques e-mails qui ont des sujets spécifiques avec tous les messages contenant des liens dans le
EmailUrlInfotableau :EmailEvents | where Subject in ("Warning: Update your credentials now", "Action required: Update your credentials now") | join hint.strategy = broadcast EmailUrlInfo on NetworkMessageId
Optimiser l’opérateur summarize
L’opérateur summarize agrège le contenu d’une table. Appliquez ces conseils pour optimiser les requêtes qui utilisent cet opérateur.
Rechercher des valeurs distinctes : en général, utilisez
summarizepour rechercher des valeurs distinctes qui peuvent être répétitives. Il peut être inutile de l’utiliser pour agréger des colonnes qui n’ont pas de valeurs répétitives.Bien qu’un seul e-mail puisse faire partie de plusieurs événements, l’exemple ci-dessous n’est pas une utilisation efficace de , car un ID de
summarizemessage réseau pour un e-mail individuel est toujours fourni avec une adresse d’expéditeur unique.EmailEvents | where Timestamp > ago(1h) | summarize by NetworkMessageId, SenderFromAddressL’opérateur
summarizepeut être facilement remplacé parproject, produisant potentiellement les mêmes résultats tout en consommant moins de ressources :EmailEvents | where Timestamp > ago(1h) | project NetworkMessageId, SenderFromAddressL’exemple suivant est une utilisation plus efficace de ,
summarizecar il peut y avoir plusieurs instances distinctes d’une adresse d’expéditeur envoyant un e-mail à la même adresse de destinataire. Ces combinaisons sont moins distinctes et sont susceptibles d’avoir des doublons.EmailEvents | where Timestamp > ago(1h) | summarize by SenderFromAddress, RecipientEmailAddressMélanger la requête—Bien que
summarizes’utilise de préférence dans des colonnes contenant des valeurs répétées, ces mêmes colonnes peuvent également présenter une cardinalité élevée ou un grand nombre de valeurs uniques. À l’instar de l’opérateurjoin, vous pouvez également appliquer l’indicateur de lecture aléatoire avecsummarizepour répartir la charge de traitement et améliorer potentiellement les performances lors de l’utilisation de colonnes avec une cardinalité élevée.La requête ci-dessous utilise
summarizepour compter les adresses e-mail de destinataires distinctes, dont le nombre peut atteindre plusieurs centaines de milliers dans les grandes organisations. Pour améliorer les performances, il incorporehint.shufflekey:EmailEvents | where Timestamp > ago(1h) | summarize hint.shufflekey = RecipientEmailAddress count() by Subject, RecipientEmailAddress
Scénarios de requête
Identifier des processus uniques avec des ID de processus
Les ID de processus (PID) sont recyclés dans Windows et réutilisés pour les nouveaux processus. Ils ne peuvent pas être utilisés comme identificateurs uniques pour des processus spécifiques.
En règle générale, la seule façon d’identifier un processus de manière unique sur un appareil spécifique était de combiner son ID de processus avec son heure de création de processus, ainsi que l’identificateur de l’appareil (ou DeviceIdDeviceName). Par instance, l’exemple de requête suivant recherche les processus qui accèdent à plus de 10 adresses IP sur le port 445 (SMB), éventuellement en recherchant des partages de fichiers.
DeviceNetworkEvents
| where RemotePort == 445 and Timestamp > ago(12h) and InitiatingProcessId !in (0, 4)
| summarize RemoteIPCount=dcount(RemoteIP) by DeviceName, InitiatingProcessId, InitiatingProcessCreationTime, InitiatingProcessFileName
| where RemoteIPCount > 10
La requête ci-dessus effectue un résumé à la fois par InitiatingProcessId et InitiatingProcessCreationTime afin d’examiner un seul processus, sans mélanger plusieurs processus ayant le même identifiant de processus.
Cette approche est toujours valide, en particulier pour les systèmes non Windows. Toutefois, dans Windows, il existe une méthode plus directe utilisant le ProcessUniqueId champ . Bien que la méthode précédente et celle décrite ci-dessous génèrent des instances de processus uniques, nous vous recommandons d’utiliser ProcessUniqueId le cas échéant, car elle simplifie les requêtes et élimine la nécessité de gérer les scénarios de réutilisation piD.
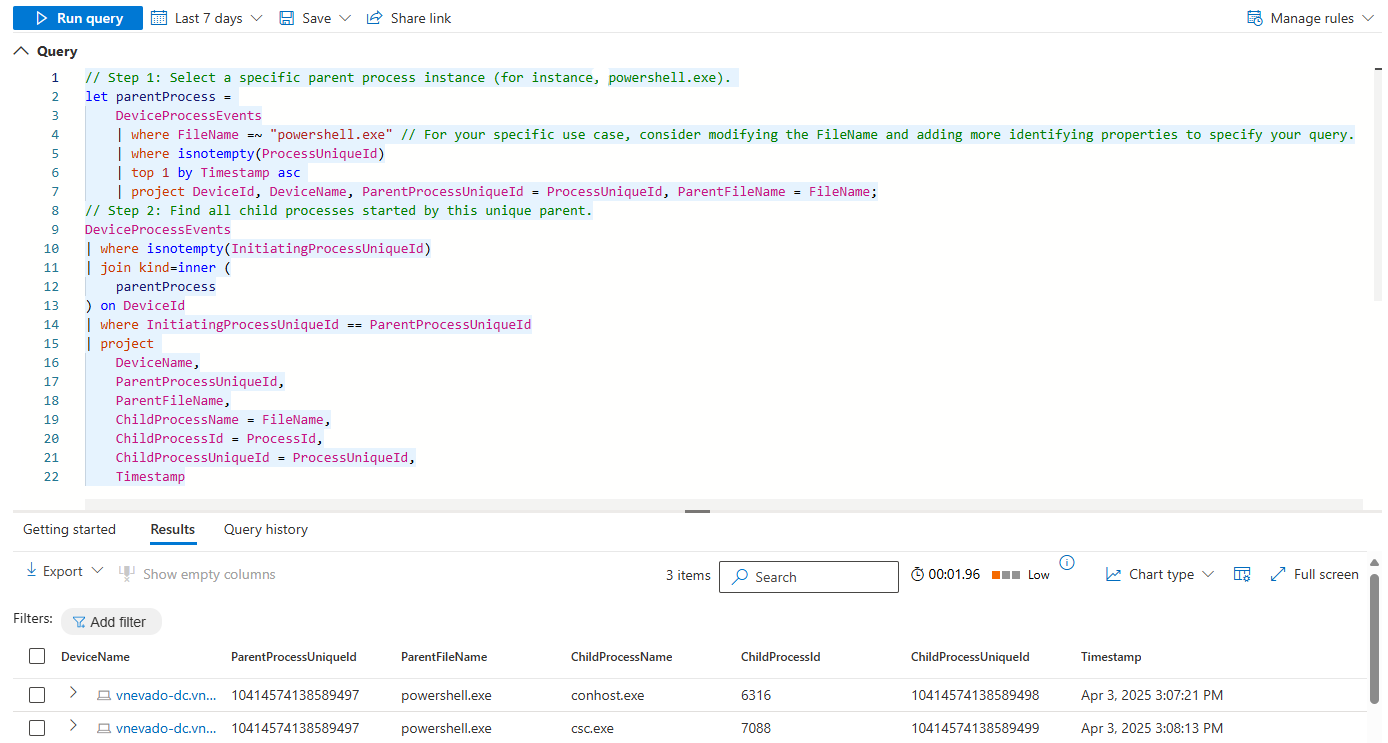
Cette requête montre comment utiliser les ProcessUniqueId champs et InitiatingProcessUniqueId pour lier un processus parent spécifique à ses processus enfants. En faisant correspondre le InitiatingProcessUniqueId de chaque enfant au ProcessUniqueId du parent, il isole uniquement les processus enfants lancés par cette instance précise du parent, même si les identifiants de processus sont réutilisés au fil du temps.
Exemples de requête :
// Step 1: Select a specific parent process instance (for instance, powershell.exe).
let parentProcess =
    DeviceProcessEvents
    | where FileName =~ "powershell.exe" // For your specific use case, consider modifying the FileName and adding more identifying properties to specify your query.
    | where isnotempty(ProcessUniqueId)
    | top 1 by Timestamp asc
    | project DeviceId, DeviceName, ParentProcessUniqueId = ProcessUniqueId, ParentFileName = FileName;
// Step 2: Find all child processes started by this unique parent.
DeviceProcessEvents
| where isnotempty(InitiatingProcessUniqueId)
| join kind=inner (
    parentProcess
) on DeviceId
| where InitiatingProcessUniqueId == ParentProcessUniqueId
| project
    DeviceName,
    ParentProcessUniqueId,
    ParentFileName,
    ChildProcessName = FileName,
    ChildProcessId = ProcessId,
    ChildProcessUniqueId = ProcessUniqueId,
    Timestamp
De même, la requête résume à la fois InitiatingProcessId et InitiatingProcessCreationTime de sorte qu’elle examine un seul processus, sans mélanger plusieurs processus avec le même ID de processus.
Interroger les lignes de commande
Plusieurs méthodes s’offrent à vous pour créer une ligne de commande pour accomplir une tâche. Par exemple, un attaquant peut référencer un fichier image sans chemin d’accès, sans extension de fichier, à l’aide de variables d’environnement ou avec des guillemets. L’attaquant peut également modifier l’ordre des paramètres ou ajouter plusieurs guillemets et espaces.
Pour créer des requêtes plus durables autour des lignes de commande, appliquez les pratiques suivantes :
- Identifiez les processus connus (tels que net.exe ou psexec.exe) en mettant en correspondance les champs de nom de fichier, au lieu de filtrer sur la ligne de commande elle-même.
- Analyser les sections de ligne de commande à l’aide de la fonction parse_command_line()
- Lors de la recherche d’arguments de ligne de commande, ne recherchez pas de correspondance exacte entre plusieurs arguments sans lien entre eux dans un ordre donné. Au lieu de cela, vous devez utiliser des expressions régulières ou utiliser plusieurs opérateurs de contenu séparés..
- Utiliser des correspondances sans distinction de casse. Par exemple, utilisez
=~,in~etcontainsau lieu de==,inetcontains_cs. - Pour atténuer les techniques d’obfuscation de ligne de commande, envisagez de supprimer les guillemets, de remplacer les virgules par des espaces et de remplacer plusieurs espaces consécutifs par un seul espace. Il existe des techniques d’obfuscation plus complexes qui nécessitent d’autres approches, mais ces ajustements peuvent aider à résoudre les problèmes courants.
Les exemples suivants montrent différentes façons de construire une requête qui recherche le fichier net.exe pour arrêter le service de pare-feu « MpsSvc » :
// Non-durable query - do not use
DeviceProcessEvents
| where ProcessCommandLine == "net stop MpsSvc"
| limit 10

// Better query - filters on file name, does case-insensitive matches
DeviceProcessEvents
| where Timestamp > ago(7d) and FileName in~ ("net.exe", "net1.exe") and ProcessCommandLine contains "stop" and ProcessCommandLine contains "MpsSvc"

// Best query also ignores quotes
DeviceProcessEvents
| where Timestamp > ago(7d) and FileName in~ ("net.exe", "net1.exe")
| extend CanonicalCommandLine=replace("\"", "", ProcessCommandLine)
| where CanonicalCommandLine contains "stop" and CanonicalCommandLine contains "MpsSvc"
Ingérer des données à partir de sources externes
Pour incorporer des listes longues ou des tables volumineuses dans votre requête, utilisez l’opérateur externaldata pour ingérer des données à partir d’un URI spécifié. Vous pouvez obtenir des données à partir de fichiers dans TXT, CSV, JSON ou d’autres formats. L’exemple ci-dessous montre comment vous pouvez utiliser la longue liste de hachages SHA-256 de logiciels malveillants fournie par MalwareBazaar (abuse.ch) pour vérifier les pièces jointes des e-mails :
let abuse_sha256 = (externaldata(sha256_hash: string)
[@"https://bazaar.abuse.ch/export/txt/sha256/recent/"]
with (format="txt"))
| where sha256_hash !startswith "#"
| project sha256_hash;
abuse_sha256
| join (EmailAttachmentInfo
| where Timestamp > ago(1d)
) on $left.sha256_hash == $right.SHA256
| project Timestamp,SenderFromAddress,RecipientEmailAddress,FileName,FileType,
SHA256,ThreatTypes,DetectionMethods
Analyser les chaînes
Il existe différentes fonctions que vous pouvez utiliser pour gérer efficacement les chaînes qui nécessitent une analyse ou une conversion.
| Chaîne | Fonction | Exemple d'utilisation |
|---|---|---|
| Lignes de commande | parse_command_line() | Extrayez la commande et tous les arguments. |
| Chemins | parse_path() | Extrayez les sections d’un chemin d’accès de fichier ou de dossier. |
| Numéros de version | parse_version() | Déconstruire un numéro de version avec jusqu’à quatre sections et jusqu’à huit caractères par section. Utilisez les données analysées pour comparer l’ancienneté des versions. |
| Adresses IPv4 | parse_ipv4() | Convertir une adresse IPv4 en entier long. Pour comparer des adresses IPv4 sans les convertir, utilisez ipv4_compare(). |
| Adresses IPv6 | parse_ipv6() | Convertissez une adresse IPv4 ou IPv6 en notation IPv6 canonique. Pour comparer les adresses IPv6, utilisez ipv6_compare(). |
Pour en savoir plus sur toutes les fonctions d’analyse prises en charge, consultez Fonctions de chaîne Kusto.
Remarque
Certaines tables de cet article peuvent ne pas être disponibles dans Microsoft Defender pour point de terminaison. Activez Microsoft Defender pour rechercher les menaces à l’aide de sources de données supplémentaires. Vous pouvez déplacer vos flux de travail de chasse avancés de Microsoft Defender for Endpoint vers Microsoft Defender en suivant les étapes décrites dans Migrer des requêtes de chasse avancées à partir de Microsoft Defender for Endpoint.
Rubriques connexes
- Documentation sur le langage de requête Kusto
- Paramètres d’utilisation et de quotas
- Gérer les erreurs de chasse avancées
- Vue d’ensemble de la chasse avancée
- Apprendre le langage de requête
Conseil
Voulez-vous en savoir plus ? Collaborez avec la communauté Sécurité Microsoft dans notre communauté technique : Communauté technique Microsoft Defender XDR.