Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
Ha készen áll egy egyéni szövegfelolvasási hang létrehozására az alkalmazáshoz, először gyűjtse össze a hangrögzítéseket és a hozzájuk tartozó szkripteket a hangmodell betanításához. A hangminták felvételével kapcsolatos részletekért tekintse meg az oktatóanyagot. A Speech szolgáltatás ezeket az adatokat felhasználva egy egyedi hangszínt hoz létre, amely a felvételek hangjának megfelelően van hangolva. A hang betanítása után megkezdheti a beszéd szintetizálását az alkalmazásokban.
Minden feltöltött adatnak meg kell felelnie a választott adattípus követelményeinek. Fontos, hogy a feltöltés előtt megfelelően formázza az adatokat, ami biztosítja, hogy a Speech szolgáltatás pontosan feldolgozza az adatokat. Az adatok helyes formázásának ellenőrzéséhez tekintse meg a Betanítás adattípusokat.
Megjegyzés
- A standard előfizetés (S0) felhasználói egyszerre öt adatfájlt tölthetnek fel. Ha eléri a korlátot, várjon, amíg legalább az egyik adatfájl importálása befejeződik. Ezután próbálkozzon újra.
- A standard előfizetési (S0) felhasználók által előfizetésenként importálható adatfájlok maximális száma 500 .zip fájl. További részletekért tekintse meg a Speech szolgáltatás kvótáit és korlátait.
Adatok feltöltése
Jótanács
A hozzájárulási nyilatkozat mintáját és a betanítási adatokat a GitHub-adattárban tekinti meg.
Betanítási adatok feltöltéséhez kövesse az alábbi lépéseket:
Ezek a lépések a Modell testreszabása oldalon folytatódnak, amelyet a Professzionális hang beállítása oldalon nyitott meg.
Ha bezárta a lapot, folytassa a vázlat testreszabását a folytatás előtt.
A Foundryben (új) rendszerezze a betanítási adatokat adathalmazokban. A betanítás konfigurálásakor több adathalmazt is létrehozhat, adatokat tölthet fel mindegyikbe, és kiválaszthatja a megfelelő adathalmazokat.
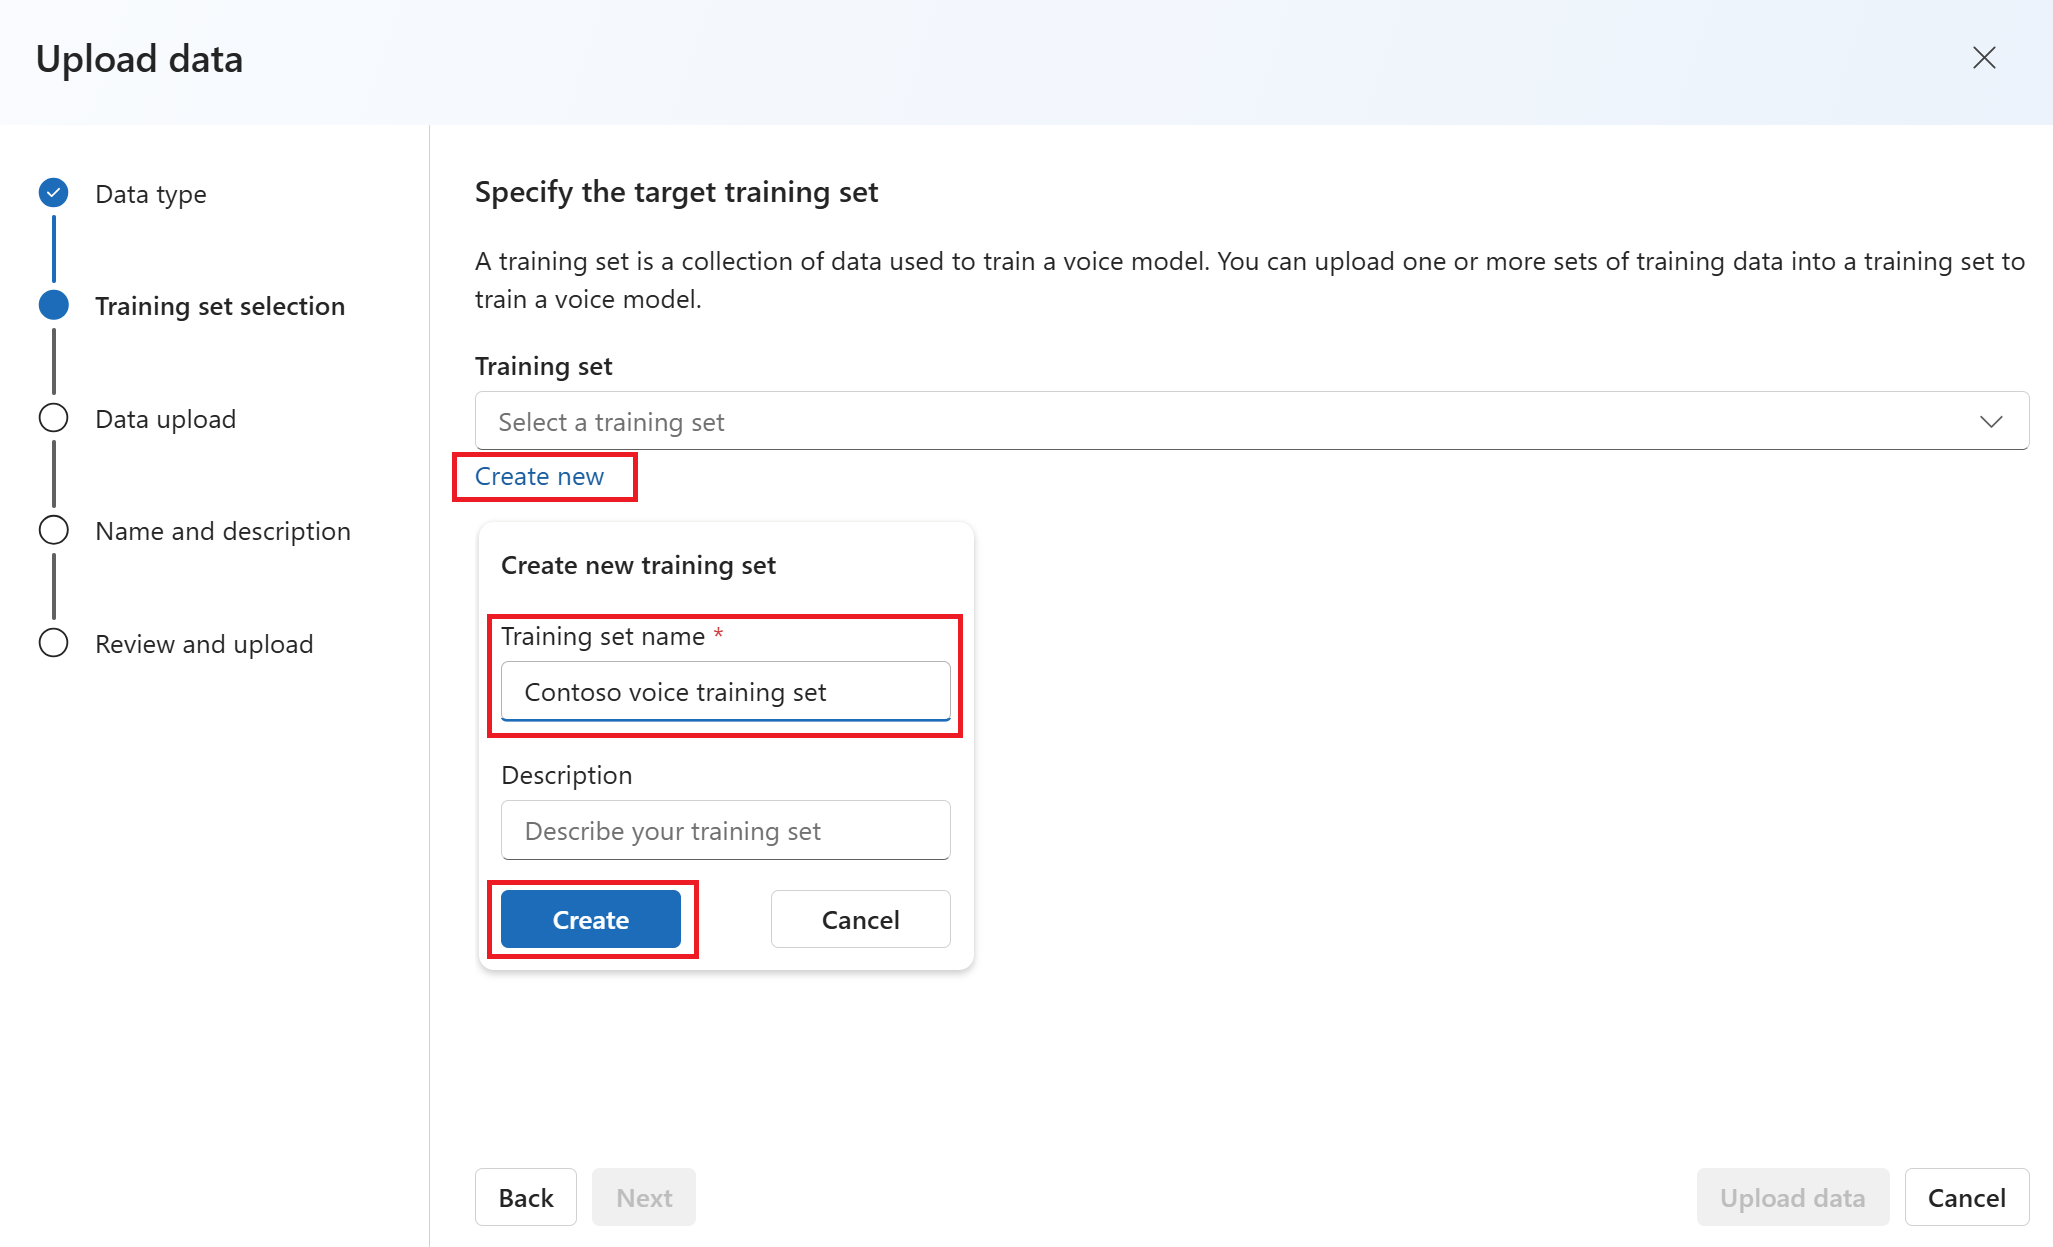
A Betanítási adat lépésben válassza az Új adatkészlet létrehozása lehetőséget.
Az Új adathalmaz létrehozása panelen adjon meg egy adathalmaznevet, majd válassza a Létrehozás lehetőséget.
Válassza ki az új adathalmazt az Adathalmaz kiválasztása legördülő listában, majd válassza az Adatok hozzáadása lehetőséget.
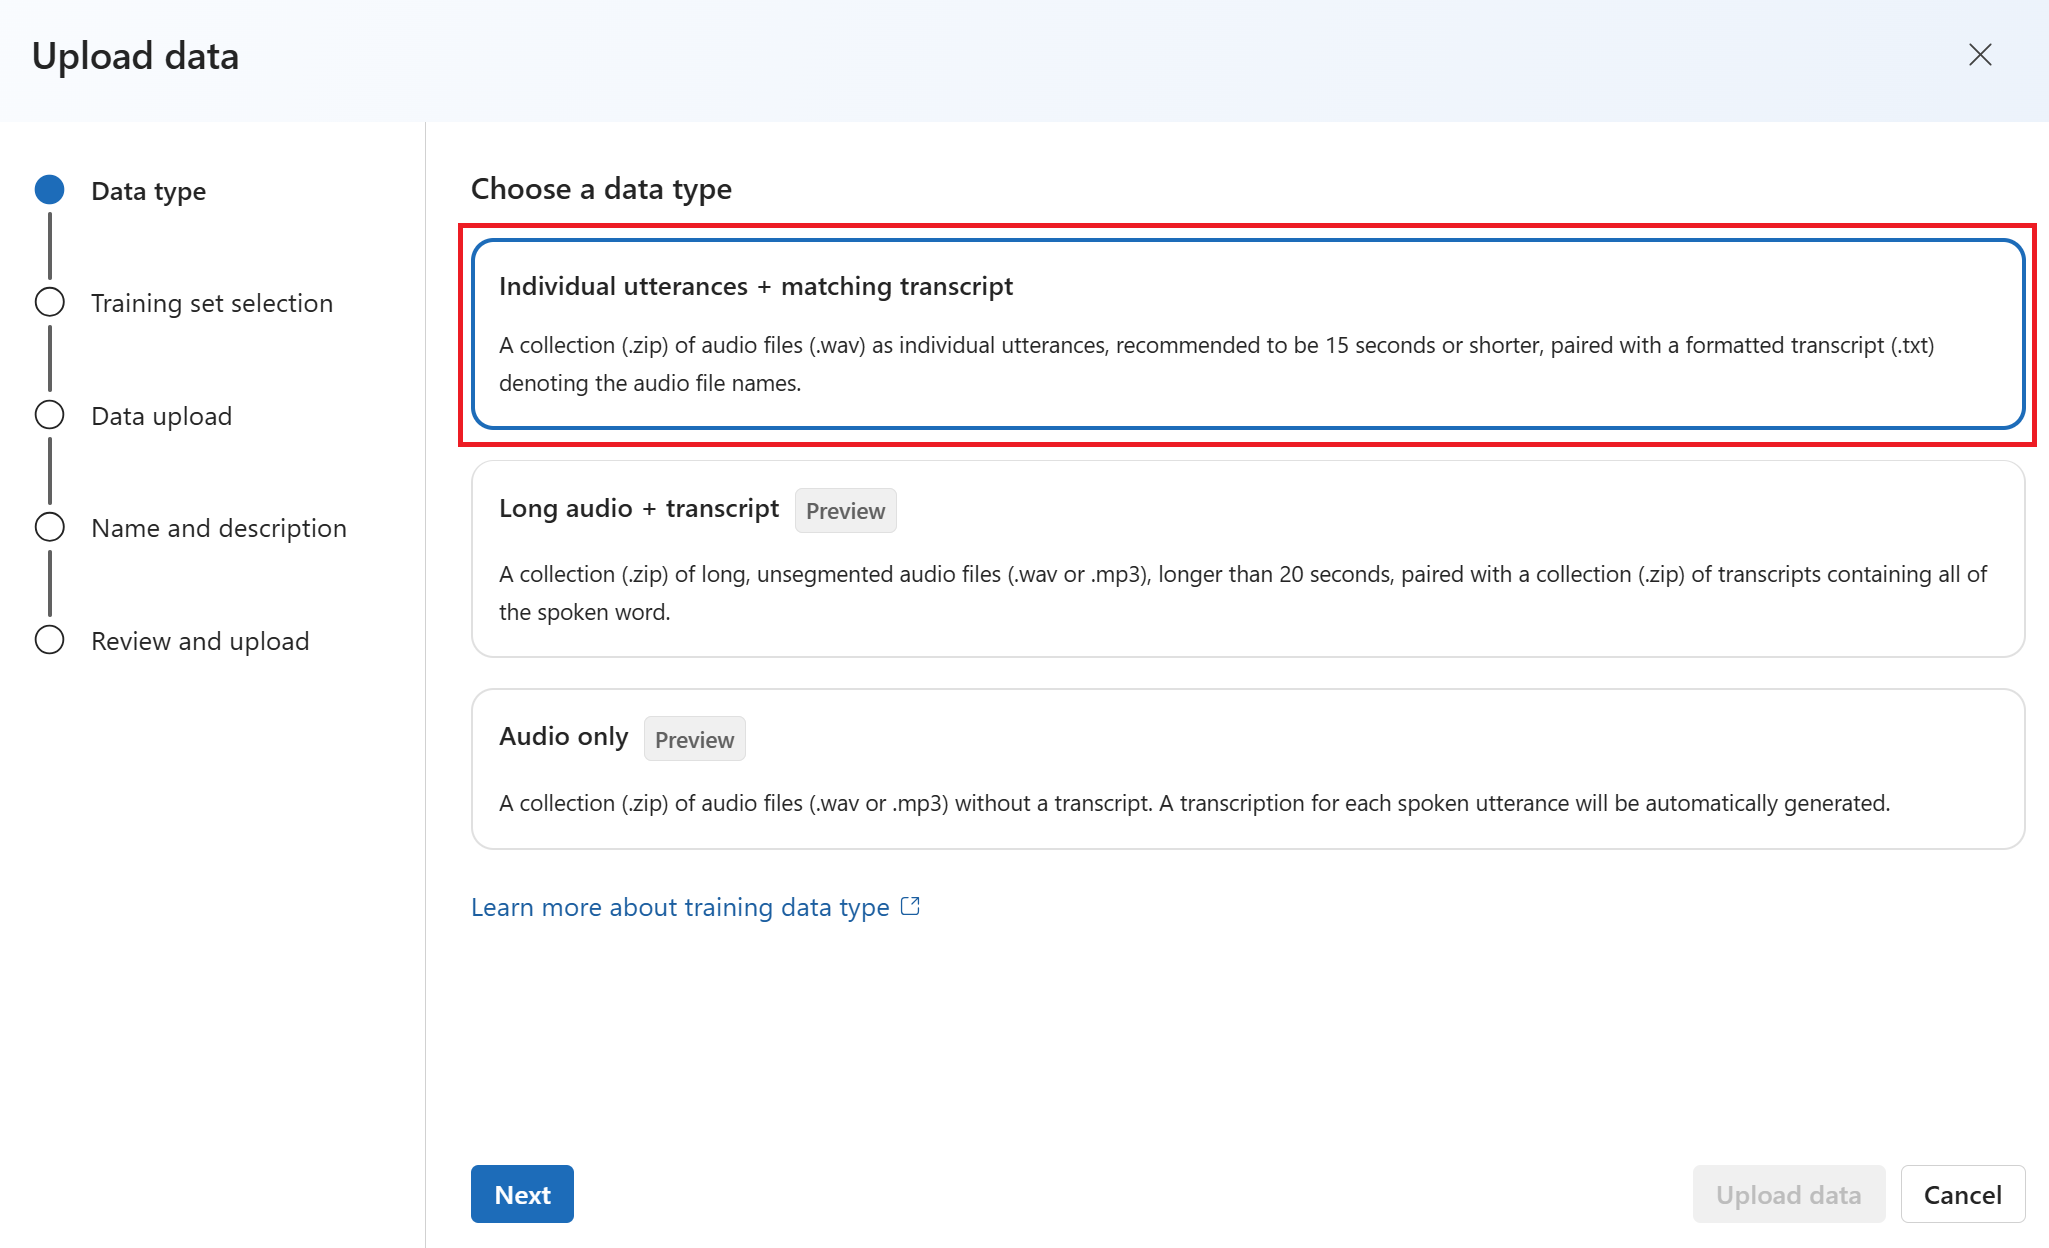
Az Adat hozzáadása panelen válasszon egy adattípust. Ha a mintaadatokat használja, válassza az Egyéni kimondott szövegek + egyező átirat lehetőséget.
A feldolgozottként való feldolgozáshoz válasszon egy, az adattípus által támogatott módot:
- Szegmentált: Ezt a módot használhatja egyéni kimondott szövegekhez és egyező átiratokhoz. Arra is használhatja, hogy a felvételeket megnyilatkozásokra bontsa a hosszú hanganyag + átirat vagy a csak hanganyag esetében.
- Környezetfüggő: Hosszú hang + átirat és hang esetén csak támogatott nyelveken érhető el. Ez a mód megőrzi a környezetfüggő információkat és a természetes intonációt. A kontextuális adatok nem kombinálhatók szegmentált adatokkal.
A támogatott kombinációk és nyelvi korlátozások betanítási adattípusait lásd.
Töltse fel az adatokat az alábbi módszerek egyikével:
- Helyi fájlok: Válassza ki a felvételfájlt a számítógépről. Átirattal rendelkező adattípusok esetén válassza a Szkriptfájlt is.
- Azure Blob: Adja meg a felvételi blob URL-címét. Átirattal rendelkező adattípusok esetén adja meg a Szkript blob URL-címét is.
Csak hang esetén ne adjon meg szkriptet. A szolgáltatás a feldolgozás során létrehozza az átiratot.
Válassza a Feltöltésopciót. Az Adatok előnézete szakasz a feldolgozás befejezése után jeleníti meg az érvényesítési eredményeket.
Ha az adathalmaz nem áll készen a betanításra, tekintse át az adatok előnézetét , és oldja meg az adatproblémákat. A folytatás előtt ellenőrizze a kiválasztott betanítási módszer és verzió jogosultságát.
Meglévő adatkészlet megtekintése vagy törlése
Ha helytelen betanítási adatokat töltött fel, keresse meg az adathalmazt az Adatok lapon a Szolgáltatások területen. Ez a lap külön van a bal oldali navigációban található Data elemtől.
- Nyissa meg az adathalmazt tartalmazó Foundry-projektet.
- Válassza a Build>Services, majd az Adatok lapot.
- Keresse meg a szövegfelolvasás és a Professional hangcímkéket tartalmazó adatkészletet. Válassza ki a nevét a részletek áttekintéséhez, beleértve az elfogadott adatokat és az elutasított adatokat.
Nem kívánt adathalmaz törlése:
Visszatérés a szolgáltatások>adataihoz.
Az adathalmaz sorában nyissa meg a Műveletek menüt (három pont), majd válassza a Törlés lehetőséget.
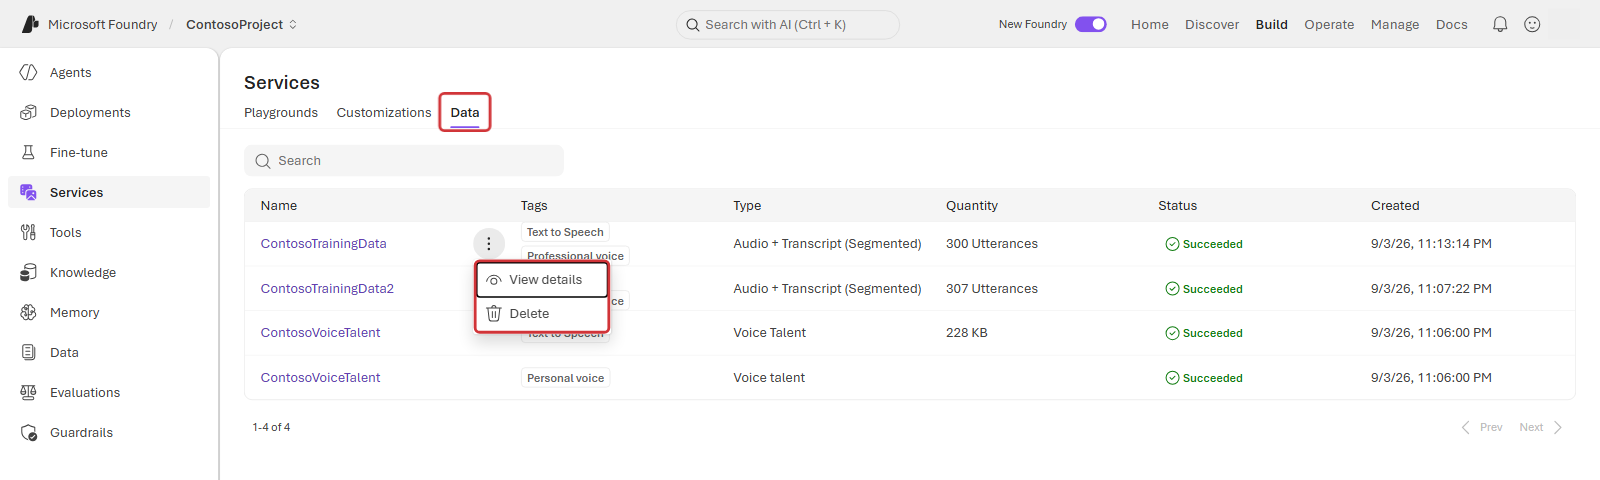
Az AI-szolgáltatás erőforrásának törlése párbeszédpanelen ellenőrizze, hogy a megjelenített név megegyezik-e az eltávolítani kívánt adatkészlettel.
A megerősítéshez válassza a Törlés lehetőséget, vagy az adathalmaz megtartásához a Mégse lehetőséget.
Important
A törlés nem vonható vissza. A törlés előtt győződjön meg arról, hogy kiválasztotta a nem kívánt adathalmazt.
Helyettesítő adatkészlet létrehozásához térjen vissza a betanítási adatokhoz a testreszabás során, és kövesse az Adatok feltöltése lehetőséget.
Megjegyzés
A duplikált azonosítók nem fogadhatók el. Az azonos azonosítójú kimondott szövegek törlődnek.
A rendszer eltávolítja az ismétlődő hangneveket a betanításból. Győződjön meg arról, hogy a kiválasztott adatok nem tartalmazzák ugyanazokat a hangneveket a .zip fájlban vagy több .zip fájlban. Ha a kimondott szövegek azonosítói (hang- vagy szkriptfájlokban) duplikáltak, a rendszer elutasítja őket.
A szolgáltatás automatikusan ellenőrzi a feltöltött adatokat. Az ellenőrzés ellenőrzi a hangfájlokra vonatkozó követelményeket, például a fájlformátumot, a méretet és a mintavételezési arányt. Hibák esetén javítsa ki őket, és töltse fel újra az adatokat.
A modell betanítása előtt tekintse át az érvényesítési eredményeket. Áttekintheti a kiejtési problémákat és az egyes kimondott szövegek zajszintét. A mondatszint kiejtési pontszáma 0 és 100 közötti lehet. A 70 alatti pontszám általában beszédhibát vagy szkripteltérést jelez. A 70-nél alacsonyabb összesített pontszámmal rendelkező kimondott szövegeket a rendszer elutasítja. Az erős akcentus csökkentheti a kiejtési pontszámot, és hatással lehet a generált digitális hangra.
Adatproblémák áttekintése
A hangmodell betanítása előtt tekintse át az érvényesítési eredményeket, és oldja meg az adatproblémák megoldását.
Jellemző adatproblémák
Az alábbi táblázatok a gyakori adatproblémákat ismertetik.
Automatikusan elutasítva
A betanítási folyamat kizárja az ilyen problémákkal kapcsolatos adatokat. Az importálási folyamat figyelmen kívül hagyja őket, ezért nem kell törölnie őket. Oldja meg a forrásfájlok hibáit, majd töltse fel a javított adatokat a betanításhoz.
| Kategória | Név | Leírás |
|---|---|---|
| Szkript | Érvénytelen elválasztó | A kimondott szöveg azonosítóját és a szkript tartalmát tabulátor karakterrel kell elválasztani. |
| Szkript | Érvénytelen szkriptazonosító | A szkriptsor azonosítójának numerikusnak kell lennie. |
| Szkript | Duplikált szkript | A szkript tartalmának minden sorának egyedinek kell lennie. A sor duplikálva van a következővel: {}. |
| Szkript | Túl hosszú szkript | A szkriptnek 1000 karakternél rövidebbnek kell lennie. |
| Szkript | Nincs egyező hang | Az egyes kimondott szövegek (a szkriptfájl minden sora) azonosítójának meg kell egyeznie a hangazonosítóval. |
| Szkript | Nincs érvényes szkript | Ebben az adatkészletben nem található érvényes szkript. Javítsa ki a részletes problémalistában megjelenő szkriptsorokat. |
| Hang | Nincs egyező szkript | Nincs olyan hangfájl, amely megegyezik a szkript azonosítójával. A .wav fájlok nevének meg kell egyeznie a szkriptfájl azonosítóival. |
| Hang | Érvénytelen hangformátum | A .wav fájlok hangformátuma érvénytelen. Ellenőrizze a .wav fájlformátumot egy olyan hangeszközzel, mint a SoX. |
| Hang | Alacsony mintavételezési sebesség | A .wav fájlok mintavételezési sebessége nem lehet alacsonyabb 16 KHz-nél. |
| Hang | Túl hosszú hang | A hang időtartama 30 másodpercnél hosszabb. Ossza fel a hosszú hangot több fájlra. Érdemes 15 másodpercnél rövidebbre tenni a kimondott szövegeket. |
| Hang | Nincs érvényes hang | Ebben az adatkészletben nem található érvényes hang. Ellenőrizze a hangadatokat, és töltse fel újra. |
| Eltérés | Alacsony pontszámú kifejezés | A mondatszintű kiejtési pontszám kisebb, mint 70. Tekintse át a szkriptet és a hangtartalmat, hogy biztosan egyezzenek. |
Automatikusan javítva
A rendszer automatikusan kijavítja a következő problémákat, de ellenőrizze és ellenőrizze, hogy a javítások helyesek-e.
| Kategória | Név | Leírás |
|---|---|---|
| Eltérés | Automatikusan rögzített csend | A rendszer 100 ms-nál rövidebb indítási csendet észlel, és automatikusan 100 ms-ra bővíti. Töltse le a normalizált adathalmazt, és tekintse át. |
| Eltérés | Automatikusan rögzített csend | A rendszer azt észleli, hogy a végcsend 100 ms-nál rövidebb, és automatikusan 100 ms-ra van kiterjesztve. Töltse le a normalizált adathalmazt, és tekintse át. |
| Szkript | Automatikusan normalizált szöveg | A szöveg automatikusan normalizálódik a számjegyek, szimbólumok és rövidítések esetében. Tekintse át a szkriptet és a hangot, és győződjön meg arról, hogy egyeznek. |
Manuális ellenőrzés szükséges
A következő táblázatban felsorolt megoldatlan problémák hatással vannak a betanítás minőségére, de a betanítási folyamat nem zárja ki az ezekkel a problémákkal kapcsolatos adatokat. A jobb minőségű betanításhoz manuálisan oldja meg ezeket a problémákat.
| Kategória | Név | Leírás |
|---|---|---|
| Szkript | Nem normalizált szöveg | Ez a szkript szimbólumokat tartalmaz. Normalizálja a szimbólumokat a hangnak megfelelően. Például normalizálja /perjelet. |
| Szkript | Nincs elég kérdésfelvetés | A teljes kimondott szöveg legalább 10 százalékának kérdőjelnek kell lennie. Ez segít a hangmodellnek megfelelően kifejezni a kérdő hangszínt. |
| Szkript | Nincs elég felkiáltójeles kimondott szöveg | A teljes kimondott szöveg legalább 10%-ának felkiáltójeles mondatnak kell lennie. Ez segít a hangmodellnek megfelelően kifejezni az izgatott hangot. |
| Szkript | Nincs érvényes záró írásjel | A sor végén adja hozzá az alábbi lehetőségek egyikét: pont (fél szélességű "." vagy teljes szélességű "。"), felkiáltójel (fél szélességű '!' vagy teljes szélességű '!'), vagy kérdőjel (fél szélességű '?' vagy teljes szélességű '?'). |
| Hang | Alacsony mintavételezési arány a neurális hanghoz | Neurális hangok létrehozásához ajánlott a .wav fájlok mintavételezési sebessége 24 KHz-es vagy magasabb. Ha alacsonyabb, a rendszer automatikusan 24 KHz-re emeli. |
| Térfogat | Az összes hangerő túl alacsony | A hangerő nem lehet alacsonyabb, mint -18 dB (a maximális hangerő 10 százaléka). A mintarögzítés vagy adatelőkészítés során szabályozza a hangerő átlagos szintjét a megfelelő tartományon belül. |
| Térfogat | Hanglemez túlcsordulás | A rendszer túlcsorduló kötetet észlel az s időpontban {}. Állítsa be a felvevő berendezést, hogy elkerülje a hangerő túllépését a csúcsértéken. |
| Térfogat | Elnémítási probléma indítása | Az első 100 ms csend nem tiszta. Csökkentse a rögzítési zajküszöbszintet, és hagyja az első 100 ms-ot a kezdésnél teljesen csendesnek. |
| Térfogat | A csend megszüntetésére való probléma | Az utolsó 100 ms csend nem tiszta. Csökkentse a rögzítési zajszintet, és hagyja csendben az utolsó 100 ms-t. |
| Eltérés | Alacsony pontszámú szavak | Tekintse át a szkriptet és a hangtartalmat, hogy biztosan egyezzenek, és szabályozza a zajszintet. Csökkentse a hosszabb szüneteket, vagy ha túl hosszú az anyag, ossza fel a hangot több részre. |
| Eltérés | Elnémítási probléma indítása | Az első szó előtt további hang hallható. Tekintse át a szkriptet és a hangtartalmat, hogy biztosan egyezzenek, szabályozhassa a zajszintet, és hogy az első 100 ms csendben legyen. |
| Eltérés | A csend megszüntetésére való probléma | Az utolsó szó után további hang hallható. Tekintse át a szkriptet és a hangtartalmat, hogy biztosan egyezzenek, szabályozhassa a zajszintet, és az utolsó 100 ms csendben legyen. |
| Eltérés | Alacsony jel-zaj arány | A hang SNR szintje alacsonyabb, mint 20 dB. Legalább 35 dB ajánlott. |
| Eltérés | Nincs elérhető pontszám | Nem sikerült felismerni a beszéd tartalmát ebben a hanganyagban. Ellenőrizze a hang és a szkript tartalmát, hogy a hang érvényes-e, és megegyezik-e a szkripttel. |
Következő lépés
Ha készen áll arra, hogy egyéni szöveget hozzon létre a beszédhanghoz az alkalmazás számára, az első lépés a hangfelvételek és a hozzájuk tartozó szkriptek összegyűjtése a hangmodell betanításának megkezdéséhez. A hangminták felvételével kapcsolatos részletekért tekintse meg az oktatóanyagot. A Speech szolgáltatás ezeket az adatokat felhasználva egy egyedi hangszínt hoz létre, amely a felvételek hangjának megfelelően van hangolva. A hang betanítása után megkezdheti a beszéd szintetizálását az alkalmazásokban.
Minden feltöltött adatnak meg kell felelnie a választott adattípus követelményeinek. Fontos, hogy a feltöltés előtt megfelelően formázza az adatokat, ami biztosítja, hogy a Speech szolgáltatás pontosan feldolgozza az adatokat. Az adatok helyes formázásának ellenőrzéséhez tekintse meg a Betanítás adattípusokat.
Megjegyzés
- A standard előfizetés (S0) felhasználói egyszerre öt adatfájlt tölthetnek fel. Ha eléri a korlátot, várjon, amíg legalább az egyik adatfájl importálása befejeződik. Ezután próbálkozzon újra.
- Az előfizetésenként importálható adatfájlok maximális száma 500 .zip fájl a standard előfizetési (S0) felhasználók számára. További részletekért tekintse meg a Speech szolgáltatás kvótáit és korlátait .
Adatok feltöltése
Ha készen áll az adatok feltöltésére, lépjen a Betanítási adatok előkészítése lapra az első betanítási csoport hozzáadásához és az adatok feltöltéséhez. A tanulókészlet hangos megnyilatkozások és a hozzájuk tartozó leképezési szkriptek összessége, amelyet hangmodell tanítására használnak. Egy tanulókészlet használatával rendszerezheti a tanulóadatállományt. A szolgáltatás minden betanítási csoportban ellenőrzi az adatok készültségét. Több adatot is importálhat egy betanítási halmazba.
Betanítási adatok feltöltéséhez kövesse az alábbi lépéseket:
- Jelentkezzen be a Speech Studio-ba.
- Válassza az Egyéni hang> a projekt neve >Készítse elő a tananyagokat>Adatfeltöltés lehetőséget.
- Az Adatok feltöltése varázslóban válasszon egy adattípust, majd válassza a Tovább gombot.
- Válassza ki a helyi fájlokat a számítógépről, vagy adja meg az Azure Blob Storage URL-címét az adatok feltöltéséhez.
- Ha a környezetfüggő támogatási projektekben a Hosszú hang + átirat vagy csak a Hang adattípusokat választotta, megjelenik egy lehetőség a feldolgozási mód kiválasztására:
- Környezetfüggő feldolgozás: Feldolgozza a hanganyagokat, miközben megőrzi a kontextuális információkat a jobb társalgási képesség és természetesebb beszédminták érdekében.
- Szegmentált: A hang- és átiratokat szabványos szegmentálással dolgozza fel egyéni kimondott szövegekké.
- A Cél betanítási csoport megadása csoportban válasszon ki egy meglévő betanítási csoportot, vagy hozzon létre egy újat. Ha létrehozott egy új betanítási csoportot, a folytatás előtt győződjön meg arról, hogy ki van jelölve a legördülő listában.
- Válassza a Tovább lehetőséget.
- Adja meg az adatok nevét és leírását, majd válassza a Tovább gombot.
- Tekintse át a feltöltés részleteit, és válassza a Küldés lehetőséget.
Megjegyzés
A duplikált azonosítók nem fogadhatók el. Az azonos azonosítójú kimondott szövegek el lesznek távolítva.
A rendszer eltávolítja az ismétlődő hangneveket a betanításból. Győződjön meg arról, hogy a kiválasztott adatok nem tartalmazzák ugyanazokat a hangneveket a .zip fájlban vagy több .zip fájlban. Ha a kimondott szövegek azonosítói (hang- vagy szkriptfájlokban) duplikáltak, a rendszer elutasítja őket.
A betanítási csoportok csak ugyanabban a módban feldolgozott adatokat tartalmazhatnak. Ha például a Környezetfüggő feldolgozás móddal tölt fel adatokat egy betanítási csoportba, akkor az ugyanahhoz a betanítási csoporthoz tartozó összes későbbi feltöltésnek szintén a Környezetfüggő feldolgozás módot kell használnia.
Az adatfájlok automatikusan érvényesítve lesznek a Küldés lehetőség kiválasztásakor. Az adatérvényesítés több ellenőrzést is tartalmaz a hangfájlokon a fájlformátum, a méret és a mintavételezési sebesség ellenőrzéséhez. Ha bármilyen hiba merül fel, javítsa ki őket, és küldje el újra.
Az adatok feltöltése után a betanítási csoport részletes nézetében ellenőrizheti a részleteket. A részletes lapon további információt kaphat a kiejtési problémáról és az egyes adatok zajszintjéről. A mondatszint kiejtési pontszáma 0 és 100 közötti lehet. A 70 alatti pontszám általában beszédhibát vagy szkripteltérést jelez. A 70-nél alacsonyabb összesített pontszámú kimondott szövegeket a rendszer elutasítja. Az erős akcentus csökkentheti a kiejtési pontszámot, és hatással lehet a generált digitális hangra.
Online adatproblémák megoldása
A feltöltés után ellenőrizheti a betanítási csoport adatadatait. Mielőtt folytatná a hangmodell betanítását, próbálja meg megoldani az adatproblémákat.
A Speech Studióban kimondott szövegenként azonosíthatja és megoldhatja az adatproblémákat.
Szegmentáltként feldolgozva
A részletek lapon lépjen az Elfogadott adatok vagy az Elutasított adatok lapra. Jelölje ki a módosítani kívánt egyes kimondott szövegeket, majd válassza a Szerkesztés lehetőséget.

A feltételek alapján kiválaszthatja, hogy mely adatproblémák jelenjenek meg.

Ekkor megjelenik a Szerkesztés ablak.

Frissítse az átiratot vagy a felvételfájlt a szerkesztési ablakban található problémaleírásnak megfelelően.
Szerkesztheti az átiratot a szövegmezőben, majd válassza a Kész lehetőséget

Ha frissítenie kell a felvételfájlt, válassza a Felvétel frissítése lehetőséget, majd töltse fel a rögzített felvételfájlt (.wav).

Miután módosította az adatokat, ellenőriznie kell az adatminőséget az Adatok elemzése gombra kattintva, mielőtt betanításra használták volna ezt az adatkészletet.
Az elemzés befejezése előtt nem választhatja ki ezt a betanítási csoportot a betanítási modellhez.

A problémákat tartalmazó kimondott szövegek törléséhez jelölje ki őket, és kattintson a Törlés gombra.
Környezetfüggőként feldolgozva
A szegmentáltként feldolgozotttól eltérően a Környezetfüggőként feldolgozott fájl megőrzi az eredeti hangfájlokat, és létrehozza a megfelelő környezeti információkat.
A részletek lapon kattintson az egyes kimondott szövegekre a "Problémák száma" szöveggel.
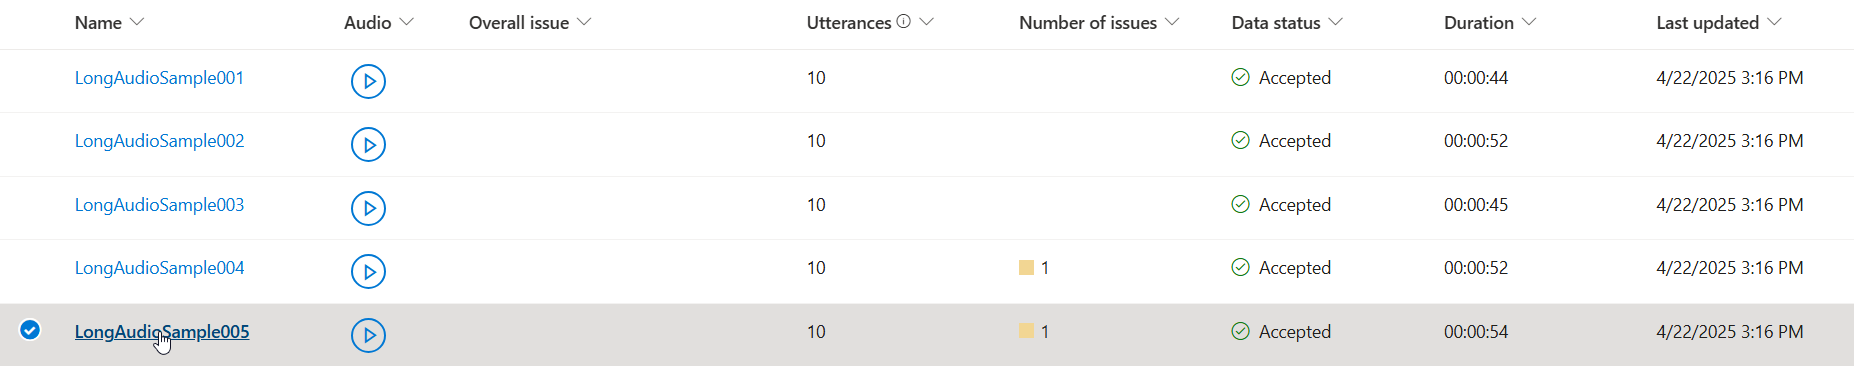
A környezeti információk szegmensekként jelennek meg. Jelölje ki a módosítani kívánt szegmenst, majd kattintson a Szerkesztés gombra.
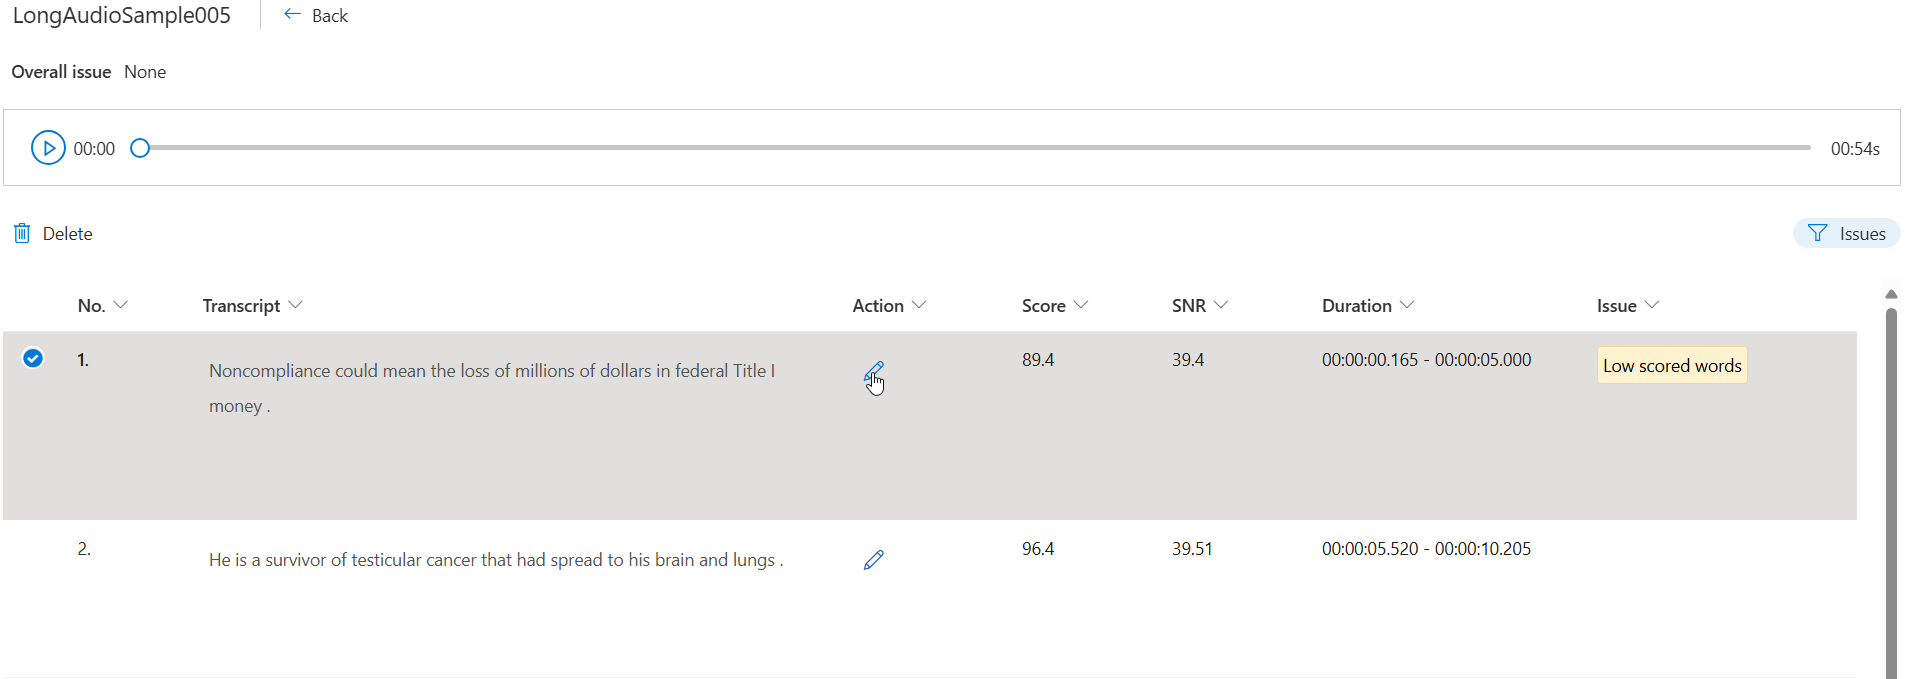
A feltételek alapján kiválaszthatja, hogy mely adatproblémák jelenjenek meg.
Szerkessze a szövegdobozban lévő átiratot a probléma leírása szerint, majd válassza a Kész lehetőséget.
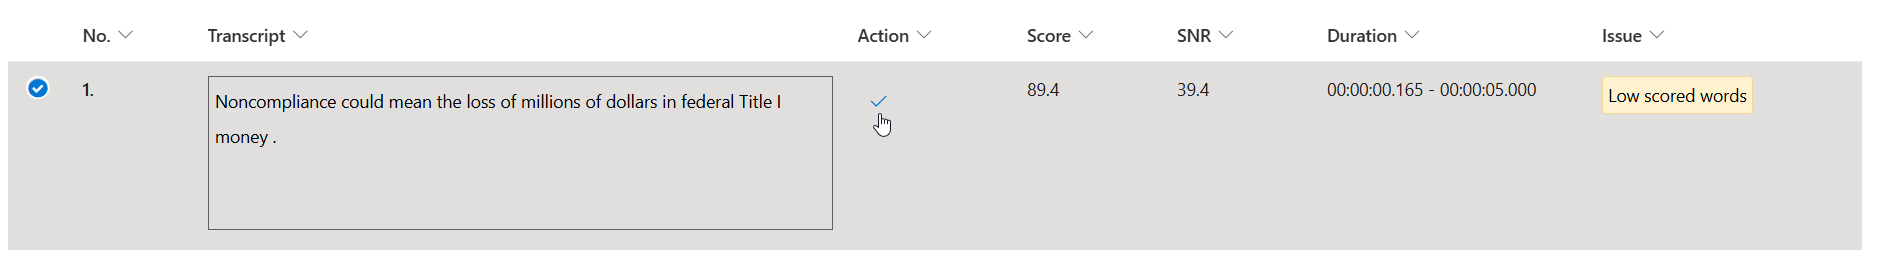
Miután módosította az adatokat, ellenőriznie kell az adatminőséget az Adatok elemzése gombra kattintva, mielőtt betanításra használták volna ezt az adatkészletet.
Az elemzés befejezése előtt nem választhatja ki ezt a betanítási csoportot a betanítási modellhez.
Megjegyzés
A környezeti információk egy részének törlése nem zárja ki azt a tartalmat a képzésből. Csak akkor törölje a szegmenseket, ha az adataik már szerepelnek vagy szerepelni fognak a szomszédos szegmensekben.
Az elutasított szegmensek nem használhatók betanításhoz.
Jellemző adatproblémák
A problémák három típusra vannak osztva. A hibatípusok ellenőrzéséhez tekintse meg az alábbi táblázatokat.
Automatikusan elutasítva
Az ilyen hibákat tartalmazó adatok nem lesznek használatban a betanításhoz. A rendszer figyelmen kívül hagyja a hibákat tartalmazó importált adatokat, ezért nem kell törölnie őket. Ezeket az adathibákat online kijavíthatja, vagy újra feltöltheti a javított adatokat a betanításhoz.
| Kategória | Név | Leírás |
|---|---|---|
| Szkript | Érvénytelen elválasztó | A kimondott szöveg azonosítóját és a szkript tartalmát tabulátor karakterrel kell elválasztani. |
| Szkript | Érvénytelen szkriptazonosító | A szkriptsor azonosítójának numerikusnak kell lennie. |
| Szkript | Duplikált szkript | A szkript tartalmának minden sorának egyedinek kell lennie. A sor duplikálva van a következővel: {}. |
| Szkript | Túl hosszú szkript | A szkriptnek 1000 karakternél rövidebbnek kell lennie. |
| Szkript | Nincs egyező hang | Az egyes kimondott szövegek (a szkriptfájl minden sora) azonosítójának meg kell egyeznie a hangazonosítóval. |
| Szkript | Nincs érvényes szkript | Ebben az adatkészletben nem található érvényes szkript. Javítsa ki a részletes problémalistában megjelenő szkriptsorokat. |
| Hang | Nincs egyező szkript | Nincs olyan hangfájl, amely megegyezik a szkript azonosítójával. A .wav fájlok nevének meg kell egyeznie a szkriptfájl azonosítóival. |
| Hang | Érvénytelen hangformátum | A .wav fájlok hangformátuma érvénytelen. Ellenőrizze a .wav fájlformátumot egy olyan hangeszközzel, mint a SoX. |
| Hang | Alacsony mintavételezési sebesség | A .wav fájlok mintavételezési sebessége nem lehet alacsonyabb 16 KHz-nél. |
| Hang | Túl hosszú hang | A hang időtartama 30 másodpercnél hosszabb. Ossza fel a hosszú hangot több fájlra. Érdemes 15 másodpercnél rövidebbre tenni a kimondott szövegeket. |
| Hang | Nincs érvényes hang | Ebben az adatkészletben nem található érvényes hang. Ellenőrizze a hangadatokat, és töltse fel újra. |
| Eltérés | Alacsony pontszámú kifejezés | A mondatszintű kiejtési pontszám kisebb, mint 70. Tekintse át a szkriptet és a hangtartalmat, hogy biztosan egyezzenek. |
Automatikusan javítva
A következő hibák automatikusan ki lettek javítva, de érdemes áttekinteni és ellenőrizni a javítások helyességét.
| Kategória | Név | Leírás |
|---|---|---|
| Eltérés | Automatikusan rögzített csend | A rendszer 100 ms-nál rövidebb indítási csendet észlel, és automatikusan 100 ms-ra bővítette. Töltse le a normalizált adathalmazt, és tekintse át. |
| Eltérés | Automatikusan rögzített csend | A rendszer azt észleli, hogy a végcsend 100 ms-nál rövidebb, és automatikusan 100 ms-ra lett kiterjesztve. Töltse le a normalizált adathalmazt, és tekintse át. |
| Szkript | Automatikusan normalizált szöveg | A szöveg automatikusan normalizálódik a számjegyek, szimbólumok és rövidítések esetében. Tekintse át a szkriptet és a hangot, és győződjön meg arról, hogy egyeznek. |
Manuális ellenőrzés szükséges
A következő táblázatban felsorolt megoldatlan hibák befolyásolják a betanítás minőségét, de az ilyen hibákat tartalmazó adatok nem lesznek kizárva a betanítás során. A jobb minőségű betanításhoz érdemes manuálisan kijavítani ezeket a hibákat.
| Kategória | Név | Leírás |
|---|---|---|
| Szkript | Nem normalizált szöveg | Ez a szkript szimbólumokat tartalmaz. Normalizálja a szimbólumokat a hangnak megfelelően. Például normalizálja /perjelet. |
| Szkript | Nincs elég kérdésfelvetés | A teljes kimondott szöveg legalább 10 százalékának kérdőjelnek kell lennie. Ez segít a hangmodellnek megfelelően kifejezni a kérdő hangszínt. |
| Szkript | Nincs elég felkiáltójeles kimondott szöveg | A teljes kimondott szöveg legalább 10%-ának felkiáltójeles mondatnak kell lennie. Ez segít a hangmodellnek megfelelően kifejezni az izgatott hangot. |
| Szkript | Nincs érvényes záró írásjel | A sor végén adja hozzá az alábbi lehetőségek egyikét: pont (félszélességű "." vagy teljes szélességű "。"), felkiáltójel (félszélességű '!' vagy teljes szélességű '!'), vagy kérdőjel (félszélességű '?' vagy teljes szélességű '?'). |
| Hang | Alacsony mintavételezési arány a neurális hanghoz | Neurális hangok létrehozásához ajánlott, hogy a .wav fájlok mintavételezési sebessége legalább 24 KHz legyen. Ha alacsonyabb, a rendszer automatikusan 24 KHz-re emeli. |
| Térfogat | Az összes hangerő túl alacsony | A hangerő nem lehet alacsonyabb, mint -18 dB (a maximális hangerő 10 százaléka). A mintarögzítés vagy adatelőkészítés során szabályozza a hangerő átlagos szintjét a megfelelő tartományon belül. |
| Térfogat | Hanglemez túlcsordulás | A rendszer túlcsorduló kötetet észlel az s időpontban {}. Állítsa be a felvevő berendezést, hogy elkerülje a hangerő túllépését a csúcsértéken. |
| Térfogat | Elnémítási probléma indítása | Az első 100 ms csend nem tiszta. Csökkentse a rögzítési zajküszöbszintet, és hagyja az első 100 ms-ot a kezdésnél teljesen csendesnek. |
| Térfogat | Csenddel kapcsolatos probléma megoldása | Az utolsó 100 ms csend nem tiszta. Csökkentse a rögzítési zajszintet, és hagyja csendben az utolsó 100 ms-t. |
| Eltérés | Alacsony pontszámú szavak | Tekintse át a szkriptet és a hangtartalmat, hogy biztosan egyezzenek, és szabályozza a zajszintet. Csökkentse a hosszabb szüneteket, vagy ha túl hosszú az anyag, ossza fel a hangot több részre. |
| Eltérés | Elnémítási probléma indítása | Az első szó előtt további hang hallható. Tekintse át a szkriptet és a hangtartalmat, hogy biztosan egyezzenek, szabályozhassa a zajszintet, és hogy az első 100 ms csendben legyen. |
| Eltérés | Csenddel kapcsolatos probléma megoldása | Az utolsó szó után további hang hallható. Tekintse át a szkriptet és a hangtartalmat, hogy biztosan egyezzenek, szabályozhassa a zajszintet, és az utolsó 100 ms csendben legyen. |
| Eltérés | Alacsony jel-zaj arány | A hang SNR szintje alacsonyabb, mint 20 dB. Legalább 35 dB ajánlott. |
| Eltérés | Nincs elérhető pontszám | Nem sikerült felismerni a beszéd tartalmát ebben a hanganyagban. Ellenőrizze a hang és a szkript tartalmát, hogy a hang érvényes-e, és megegyezik-e a szkripttel. |
Következő lépések
A professzionális hang létrehozásához betanítási adatkészletre van szüksége. A betanítási adatkészlet hang- és szkriptfájlokat is tartalmaz. A hangfájlok a szkriptfájlokat olvasó hangtehetség felvételei. A szkriptfájlok a hangfájlok szövegei.
Ebben a cikkben létrehoz egy tanulókészletet, és lekéri annak erőforrás-azonosítóját. Ezután az erőforrás-azonosító használatával hang- és szkriptfájlokat tölthet fel.
Betanítási csoport létrehozása
Betanítási csoport létrehozásához használja a testreszabott hang API TrainingSets_Create műveletét. A kérelem törzsének összeállítása az alábbi utasítások szerint:
- Állítsa be a szükséges
projectIdtulajdonságot. Lásd: projekt létrehozása. - Állítsa be a szükséges
voiceKindtulajdonságotMalevagyFemale. A típus később nem módosítható. - Állítsa be a szükséges
localetulajdonságot. Ennek kell lennie a betanítási csoport adatainak területi beállításának. A betanítási csoport területi beállításának meg kell egyeznie a hozzájárulási nyilatkozat területi beállításával. A területi beállítás később nem módosítható. A szövegfelolvasási nyelvterület listáját itt találja. - Igény szerint állítsa be a
descriptionbetanítási csoport leírásának tulajdonságát. A betanítási csoport leírása később módosítható.
Hozzon létre egy HTTP PUT-kérést az URI használatával az alábbi TrainingSets_Create példában látható módon.
- Cserélje le a
YourResourceKey-t a beszéd erőforráskulcsával. - Cserélje le a(z)
YourResourceNameelemet a Speech-erőforrás nevére. - Cserélje le
JessicaTrainingSetIda kívánt betanítási csoportazonosítóra. A kis- és nagybetűkre érzékeny azonosító a tanítókészlet URI-jában lesz használva, és később nem módosítható.
curl -v -X PUT -H "Ocp-Apim-Subscription-Key: YourResourceKey" -H "Content-Type: application/json" -d '{
  "description": "300 sentences Jessica data in general style.",
  "projectId": "ProjectId",
  "locale": "en-US",
  "voiceKind": "Female"
} '  "https://YourResourceName.cognitiveservices.azure.com/customvoice/trainingsets/JessicaTrainingSetId?api-version=2026-01-01"
A válasz törzsének a következő formátumban kell érkeznie:
{
  "id": "JessicaTrainingSetId",
  "description": "300 sentences Jessica data in general style.",
  "projectId": "ProjectId",
  "locale": "en-US",
  "voiceKind": "Female",
  "status": "Succeeded",
  "createdDateTime": "2023-04-01T05:30:00.000Z",
  "lastActionDateTime": "2023-04-02T10:15:30.000Z"
}
Betanítási adathalmaz adatainak feltöltése
Hang- és szkriptek betanítási készletének feltöltéséhez használja az egyéni hang API TrainingSets_UploadData műveletét.
Az API meghívása előtt tárolja a rögzítési és szkriptfájlokat az Azure Blobban. Az alábbi példában a rögzítési fájlok https://contoso.blob.core.windows.net/voicecontainer/jessica300/*.wav, a szkriptfájlok pedig https://contoso.blob.core.windows.net/voicecontainer/jessica300/*.txt.
A kérelem törzsének összeállítása az alábbi utasítások szerint:
- Állítsa be a szükséges
kindtulajdonságot a következőreAudioAndScript: ,LongAudiovagyAudioOnly. A típus határozza meg a betanítási csoport típusát. - Igény szerint állítsa be a
processAstulajdonságot a feldolgozási módszer megadására. A támogatott értékek (Segmentedalapértelmezett) ésContextual.Contextualegy továbbfejlesztett mód, amely megtartja a hang egészét, hogy megőrizze a kontextuális információkat a természetesebb intonáció biztosítása érdekében. AContextualmód csak akkor érhető el, hakindbe van állítvaLongAudiovagyAudioOnly. Ha nincs megadva, a rendszer az alapértelmezettSegmentedmódot használja. További információ: betanítási adattípusok. - Állítsa be a szükséges
audiostulajdonságot. A tulajdonságonaudiosbelül állítsa be a következő tulajdonságokat:- Állítsa be a szükséges
containerUrltulajdonságot a hangfájlokat tartalmazó Azure Blob Storage-tároló URL-címére. Használjon közös hozzáférésű jogosultságkódokat (SAS) olvasási és listaengedélyekkel rendelkező tárolókhoz . - Állítsa be a szükséges
extensionstulajdonságot a hangfájlok bővítményére. - Ha szeretné, állítsa be a
prefixtulajdonságot a blobnév előtagjának beállítására.
- Állítsa be a szükséges
- Állítsa be a szükséges
scriptstulajdonságot. A tulajdonságonscriptsbelül állítsa be a következő tulajdonságokat:- Állítsa be a szükséges
containerUrltulajdonságot a szkriptfájlokat tartalmazó Azure Blob Storage-tároló URL-címére. Használjon közös hozzáférésű jogosultságkódokat (SAS) olvasási és listaengedélyekkel rendelkező tárolókhoz . - Állítsa be a szükséges
extensionstulajdonságot a szkriptfájlok bővítményére. - Ha szeretné, állítsa be a
prefixtulajdonságot a blobnév előtagjának beállítására.
- Állítsa be a szükséges
Hozzon létre egy HTTP POST-kérést az URI használatával az alábbi TrainingSets_UploadData példában látható módon.
- Cserélje le a
YourResourceKey-t a beszéd erőforráskulcsával. - Cserélje le a(z)
YourResourceNameelemet a Speech-erőforrás nevére. - Cserélje le
JessicaTrainingSetId, ha az előző lépésben egy másik betanítási csoportazonosítót adott meg.
curl -v -X POST -H "Ocp-Apim-Subscription-Key: YourResourceKey" -H "Content-Type: application/json" -d '{
  "kind": "AudioAndScript",
  "audios": {
    "containerUrl": "https://contoso.blob.core.windows.net/voicecontainer?mySasToken",
    "prefix": "jessica300/",
    "extensions": [
      ".wav"
    ]
  },
  "scripts": {
    "containerUrl": "https://contoso.blob.core.windows.net/voicecontainer?mySasToken",
    "prefix": "jessica300/",
    "extensions": [
      ".txt"
    ]
  }
} '  "https://YourResourceName.cognitiveservices.azure.com/customvoice/trainingsets/JessicaTrainingSetId:upload?api-version=2026-01-01"
Az alábbi példa hosszú hangadatokat tölt fel környezetfüggő feldolgozással:
curl -v -X POST -H "Ocp-Apim-Subscription-Key: YourResourceKey" -H "Content-Type: application/json" -d '{
  "kind": "LongAudio",
  "processAs": "Contextual",
  "audios": {
    "containerUrl": "https://contoso.blob.core.windows.net/voicecontainer?mySasToken",
    "prefix": "jessica-long/",
    "extensions": [
      ".wav"
    ]
  },
  "scripts": {
    "containerUrl": "https://contoso.blob.core.windows.net/voicecontainer?mySasToken",
    "prefix": "jessica-long/",
    "extensions": [
      ".txt"
    ]
  }
} '  "https://YourResourceName.cognitiveservices.azure.com/customvoice/trainingsets/JessicaTrainingSetId:upload?api-version=2026-01-01"
A válaszfejléc tartalmazza a tulajdonságot Operation-Location . Ezzel az URI-val részletes információkat kaphat a TrainingSets_UploadData műveletről. Íme egy példa a válaszfejlécre:
Operation-Location: https://YourResourceName.cognitiveservices.azure.com/customvoice/operations/aaaabbbb-0000-cccc-1111-dddd2222eeee?api-version=2026-01-01
Operation-Id: aaaabbbb-0000-cccc-1111-dddd2222eeee