Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
A gyorsítótárazás egy gyakran alkalmazott módszer, amelynek célja egy rendszer teljesítményének és méretezhetőségének javítása. A gyorsítótárazás ideiglenesen átmásolja a gyakran használt adatokat az alkalmazáshoz közelebbi tárolóba, mint az eredeti forrás. Ez a megközelítés jelentősen javíthatja az ügyfélalkalmazások válaszidejének növelését az adatok gyorsabb kiszolgálásával.
A gyorsítótárazás akkor a leghatékonyabb, ha egy ügyfélpéldány ismételten beolvassa ugyanazokat az adatokat, különösen akkor, ha az alábbi feltételek az eredeti adattárra vonatkoznak:
- Az adattár viszonylag statikus marad.
- A gyorsítótár sebességéhez képest lassú.
- Magas szintű versengésnek van kitéve.
- Elég messze van az ügyfelektől, hogy a hálózati késés jelentős.
Gyorsítótárazás elosztott alkalmazásokban
Az elosztott alkalmazások általában az alábbi stratégiák valamelyikét vagy mindkettőt implementálják az adatok gyorsítótárazásakor:
Használjon privát gyorsítótárat, ahol az adatokat helyileg tárolja az alkalmazást vagy szolgáltatást futtató számítógépen.
Használjon megosztott gyorsítótárat, amely közös forrásként szolgál, amelyet több folyamat és gép is elérhet.
Mindkét esetben végezhet gyorsítótárazást az ügyféloldalon és a kiszolgáló oldalán. Az ügyféloldali gyorsítótárazást az a folyamat kezeli, amely a rendszer felhasználói felületét nyújtja, mint például egy webböngésző vagy egy asztali alkalmazás. A kiszolgálóoldali gyorsítótárazást az üzleti szolgáltatásokat nyújtó folyamat távolról végzi.
Privát gyorsítótárazás
A gyorsítótár legalapvetőbb típusa egy memóriabeli tároló. Egyetlen folyamat címterében van tárolva, és az abban a folyamatban futó kód közvetlenül hozzáfér a gyorsítótárhoz. Ez a gyorsítótártípus gyorsan elérhető. Emellett hatékony eszköz lehet a statikus adatok szerény mennyiségének tárolására is. A gépen rendelkezésre álló memória mennyisége általában korlátozza a gyorsítótár méretét.
Ha a memóriában fizikailag lehetségesnél több információt kell gyorsítótáraznia, a gyorsítótárazott adatokat a helyi fájlrendszerbe is írhatja. Az adatok a fájlrendszerből való elérése hosszabb időt vesz igénybe, mint ha az adatokat a memóriában tárolják, de még mindig gyorsabbnak és megbízhatóbbnak kell lennie, mint a hálózaton keresztüli adatok lekérése.
Ha több olyan alkalmazáspéldánya van, amely egyidejűleg futtatja ezt a modellt, minden alkalmazáspéldány saját független gyorsítótárral rendelkezik, amely az adatok saját másolatát tárolja.
Gondolj a gyorsítótárra úgy, mint az eredeti adatok egy korábbi pillanatképére. Ha ezek az adatok nem statikusak, akkor valószínű, hogy a különböző alkalmazáspéldányok az adatok különböző verzióit használják a gyorsítótáraikban. Ezért az ilyen példányok által végrehajtott lekérdezés különböző eredményeket adhat vissza, ahogyan az alábbi ábrán is látható.
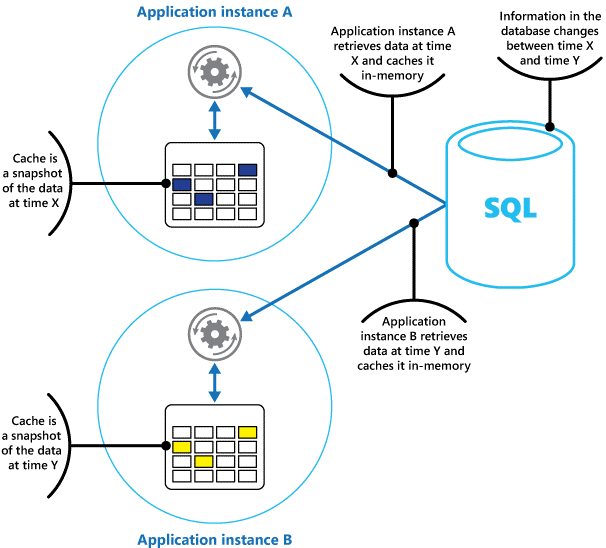
A megosztott SQL-adatbázishoz csatlakoztatott több alkalmazáspéldány gyorsítótár-inkonzisztenciaét bemutató ábra. A jobb oldalon egy SQL-adatbázis látható hengerként. A bal felső sarokban egy nagy, A nevű alkalmazáspéldány látható, a bal alsó részen pedig egy hasonló méretű, B nevű alkalmazáspéldány. Az A alkalmazáspéldányon belül az alkalmazásfolyamatot jelképező fogaskerék ikon látható. A fogaskerék ikon alatt egy memóriabeli gyorsítótárat ábrázoló rácstábla látható. A határon kívül van egy címkefelolvasó gyorsítótár, amely pillanatképet ad az adatokról az X időpontban. A B alkalmazáspéldányon belül egy másik fogaskerék ikon látható. A fogaskerék ikon alatt egy memóriabeli gyorsítótárat ábrázoló rácstábla látható. A határon kívül van egy címkefelolvasó gyorsítótár, amely az Y időpontban lévő adatok pillanatképe. Az SQL-adatbázisból egy sor terjed ki az A alkalmazáspéldány felé, az A címkével ellátott alkalmazáspéldány az X időpontban kéri le az adatokat, és gyorsítótárazza azokat a memóriában. A második sor az SQL-adatbázistól a B alkalmazáspéldányig terjed, a B címkével ellátott alkalmazáspéldány Y időpontban kéri le az adatokat, és gyorsítótárazza azokat a memóriában. A két megjegyzéssor között egy olyan megjegyzés található, amely szerint az adatbázisban található információ X és Y időpont között változik.
Megosztott gyorsítótárazás
Megosztott gyorsítótár használatával gondoskodhat arról, hogy minden alkalmazáspéldány ugyanazt a nézetet lássa a gyorsítótárazott adatokról. A gyorsítótár egy külön helyen található, amely általában egy külön szolgáltatás részeként van üzemeltetve, ahogyan az alábbi ábrán látható.
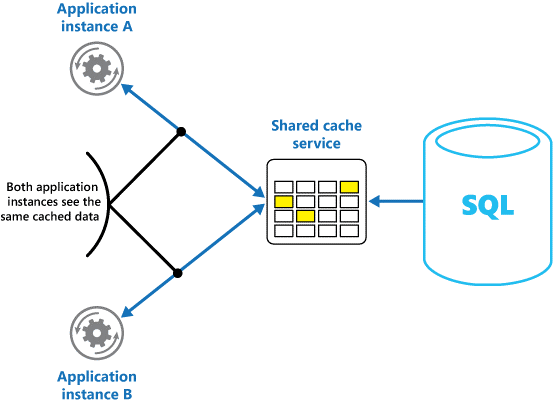
Diagram, amely bemutatja, hogyan oldja fel a megosztott gyorsítótár-szolgáltatás a gyorsítótár-inkonzisztencia feloldását az SQL-adatbázishoz csatlakoztatott több alkalmazáspéldány között. A jobb szélen egy SQL-adatbázis látható hengerként. A központban egy megosztott gyorsítótár-szolgáltatás feliratú mező található, amely a megosztott gyorsítótárat jelképező rácstáblát tartalmaz. A bal szélen egy fogaskerék ikon látható, amely az A alkalmazáspéldányt jelöli. Alatta egy második fogaskerék ikon látható, amely b alkalmazáspéldányt jelöl. Az SQL-adatbázisból a megosztott gyorsítótár szolgáltatásrácsára mutató fekete nyíl jelzi, hogy az adatbázis feltölti a megosztott gyorsítótárat. A megosztott gyorsítótár-szolgáltatásból két kék nyíl indul kifelé; az egyik az A alkalmazáspéldány, a másik a B alkalmazáspéldány felé mutat. A bal oldalon egy ívelt kapcsos zárójel függőlegesen átfogja a két alkalmazáspéldányt, mellette pedig a következő felirat olvasható: „Mindkét alkalmazáspéldány ugyanazokat a gyorsítótárazott adatokat látja.” Ez a címke és a zárójel kiemeli a megosztott gyorsítótár-architektúra fő előnyeit: a memóriabeli példányonkénti gyorsítótárral ellentétben az A és a B alkalmazáspéldány is ugyanabból a központi gyorsítótárból kéri le az adatokat.
A megosztott gyorsítótárazási módszer egyik fontos előnye a méretezhetőség. Számos megosztott gyorsítótár-szolgáltatás egy kiszolgálófürt használatával valósul meg, és szoftver automatikusan osztja el az adatokat a fürtben. Egy alkalmazáspéldány kérést küld a gyorsítótár-szolgáltatásnak. A mögöttes infrastruktúra határozza meg a gyorsítótárazott adatok helyét a fürtben. A gyorsítótárat egyszerűen skálázhatja további kiszolgálók hozzáadásával.
A megosztott gyorsítótárazási módszernek két fő hátránya van:
- A gyorsítótár lassabban érhető el, mert már nincs helyileg tárolva az egyes alkalmazáspéldányok esetében.
- Egy külön gyorsítótár-szolgáltatás implementálása összetettebbé teheti a megoldást.
A gyorsítótárazás használatának szempontjai
A következő szakaszok a gyorsítótár tervezésének és használatának szempontjait ismertetik.
Döntse el, mikor kívánja gyorsítótárazni az adatokat
A gyorsítótárazás jelentősen javíthatja a teljesítményt, a méretezhetőséget és a rendelkezésre állást. Minél több adata van, és minél több felhasználónak kell hozzáférnie ezekhez az adatokhoz, annál nagyobb az előnye a gyorsítótárazásnak. A gyorsítótárazás csökkenti a nagy mennyiségű egyidejű kérés kezeléséhez kapcsolódó késést és versengést az eredeti adattárban.
Előfordulhat például, hogy egy adatbázis csak korlátozott számú egyidejű kapcsolatot támogat. A megosztott gyorsítótárból származó adatok lekérése azonban a mögöttes adatbázis helyett lehetővé teszi, hogy az ügyfélalkalmazások akkor is hozzáférhessenek ezekhez az adatokhoz, ha az elérhető kapcsolatok száma jelenleg kimerült. Emellett ha az adatbázis elérhetetlenné válik, előfordulhat, hogy az ügyfélalkalmazások a gyorsítótárban lévő adatok használatával folytathatják a munkát.
Fontolja meg a gyakran olvasott, de ritkán módosított adatok gyorsítótárazását. Például gyorsítótárazhatja azokat az adatokat, amelyeknél az olvasási műveletek aránya magasabb, mint az írási műveleteké. Ne használja azonban a gyorsítótárat a kritikus információk mérvadó tárolójaként. Ehelyett mentse az összes fontos módosítást egy állandó adattárban. Ha a gyorsítótár nem érhető el, az alkalmazás továbbra is használhatja az adattárat, és nem veszít fontos információkat.
Az adatok hatékony gyorsítótárazási módjának meghatározása
A gyorsítótár hatékony használatához határozza meg a gyorsítótárazáshoz legmegfelelőbb adatokat, és a megfelelő időben gyorsítótárazza azokat. Az alkalmazások első lekérésekor adatokat adhat hozzá a gyorsítótárhoz. Az alkalmazásnak csak egyszer kell lekérnie az adatokat az adattárból, majd a későbbi hozzáférés a gyorsítótár használatával kielégíthető.
Másik lehetőségként a gyorsítótárat részben vagy teljesen feltöltheti előre az adatokkal, általában az alkalmazás indításakor. Ezt a megközelítést inicializálásnak nevezzük. Előfordulhat azonban, hogy nem tanácsos magvetést implementálni egy nagy gyorsítótár esetében, mert ez a megközelítés hirtelen, nagy terhelést okozhat az eredeti adattárra, amikor az alkalmazás elindul.
Elemezze a használati mintákat, és döntse el, hogy teljes mértékben vagy részben előre feltölti-e a gyorsítótárat, és hogy melyik adatokat gyorsítótárazza. Például feltöltheti a gyorsítótárat azon ügyfelek statikus felhasználóiprofil-adataival, akik naponta használják az alkalmazást, de nem azon ügyfelek adataival, akik csak hetente egyszer használják azt.
A gyorsítótárazás általában jól működik az olyan adatokkal, amelyek nem módosíthatók vagy ritkán változnak. Ilyenek például a referenciaadatok, például az e-kereskedelmi alkalmazások termék- és díjszabási információi, vagy a megosztott statikus erőforrások, amelyek létrehozása költséges. Az adatok egy részét vagy egészét az alkalmazás indításakor töltse be a gyorsítótárba az erőforrások iránti kereslet minimalizálása és a teljesítmény javítása érdekében. Érdemes lehet olyan háttérfolyamatot is használnia, amely rendszeres időközönként frissíti a gyorsítótár hivatkozási adatait, hogy biztosan up-to-date legyen. Vagy a háttérfolyamat frissítheti a gyorsítótárat, amikor a referenciaadatok megváltoznak.
A gyorsítótárazás kevésbé hasznos a dinamikus adatok esetében, bár vannak kivételek. További információkért tekintse meg a cikk későbbi részében a Nagy dinamikus adatok gyorsítótárazása című szakaszt. Amikor az eredeti adatok rendszeresen változnak, a gyorsítótárazott adatok gyorsan elavulttá válnak, vagy a gyorsítótár és az eredeti adattár szinkronizálásának többletterhelése csökkenti a gyorsítótárazás hatékonyságát.
A gyorsítótárnak nem kell tartalmaznia egy entitás teljes adatait. Ha például egy adatelem többértékű objektumot jelöl, például egy bank ügyfelet, amelynek neve, címe és számlaegyenlege van, ezek némelyike statikus marad, például a név és a cím. Más elemek, például a számlaegyenleg dinamikusabbak lehetnek. Ilyen helyzetekben hasznos lehet gyorsítótárazni az adatok statikus részeit, és szükség esetén csak a fennmaradó információkat lekérni (vagy kiszámítani).
Végezzen teljesítménytesztelést és használatelemzést annak megállapításához, hogy a gyorsítótár előre feltöltődése vagy igény szerinti betöltése, vagy a kettő kombinációja megfelelő-e. A döntés alapja az adatok változékonysága és használati mintája. A gyorsítótár-kihasználtság és a teljesítményelemzés fontos azokban az alkalmazásokban, amelyek nagy terhelést tapasztalnak, és nagy mértékben méretezhetőnek kell lenniük. Nagy mértékben skálázható forgatókönyvekben például a gyorsítótárat úgy helyezheti el, hogy csúcsidőben csökkentse az adattár terhelését.
A gyorsítótárazással elkerülheti a számítások ismétlését az alkalmazás futása közben. Ha egy művelet átalakítja az adatokat, vagy bonyolult számítást végez, mentheti a művelet eredményeit a gyorsítótárban. Ha később ugyanez a számítás szükséges, az alkalmazás lekérheti az eredményeket a gyorsítótárból.
Az alkalmazások módosíthatják a gyorsítótárban lévő adatokat. Gondoljon azonban a gyorsítótárra átmeneti adattárként, amely bármikor eltűnhet. Ne csak a gyorsítótárban tárolja az értékes adatokat; győződjön meg arról, hogy az eredeti adattárban is megőrzi az adatokat. Ez a módszer minimálisra csökkenti az adatok elvesztésének esélyét, ha a gyorsítótár elérhetetlenné válik.
Tartsa a gyorsítótárat konzisztensen az írások során
Amikor az alkalmazás olyan adatokat módosít, amelyeket szintén gyorsítótáraz, döntse el, hogy a gyorsítótár hogyan marad összhangban a rekordrendszerrel. Két módszer gyakori:
Érvénytelenítés íráskor: Írja be a módosítást az adattárba, majd távolítsa el az érintett gyorsítótár-bejegyzést. A következő olvasási művelet újratölti a gyorsítótárat az adattárolóból. Ez a megközelítés egyszerűnek tartja az írási útvonalat, de az olvasó a gyorsítótár hiányát tapasztalhatja, vagy az elavult adatokat közvetlenül az írás után láthatja. A Cache-Aside minta ezt a megközelítést írja le.
Írási műveletek: Frissítse az adattárat és a gyorsítótárat ugyanazon írási művelet részeként, és csak akkor adja vissza az írási választ, ha mindkét frissítés sikeres volt. Ez a megközelítés lehetővé teszi, hogy az olvasók egy sikeres írás után azonnal megkapják a frissített értéket, nagyobb írási késleltetés és összetettebb koordinációs logika árán.
Az Azure SQL Database és az Azure Managed Redis write-through frissítéseinek az Azure Functionsszel történő koordinálását bemutató teljes körű példáért lásd: Write-through gyorsítótárazás Azure Managed Redis és Azure SQL Database használatával.
Csak olyan olvasásintenzív hozzáférési útvonalakhoz használjon write-through gyorsítótárazást, amelyeknél írás utáni olvasáskor friss adatokra van szükség. Az olyan adatok esetében, amelyek írása után ritkán olvasnak, vagy amelyek folyamatosan változnak, érvényteleníthetők íráskor vagy a gyorsítótár megkerülésével.
Gyorsítótárazd a rendkívül dinamikus adatokat
Az állandó adattárban gyorsan változó információk tárolása többletterhelést jelenthet a rendszeren. Vegyük például azt az eszközt, amely folyamatosan jelenti az állapotot vagy más méréseket. Ha egy alkalmazás úgy dönt, hogy nem gyorsítótárazza ezeket az adatokat azon az alapon, hogy a gyorsítótárazott információk általában elavultak, ugyanez a szempont igaz lehet az adatok adattárból való tárolásakor és lekérésekor. Az adatok mentése és beolvasása során előfordulhat, hogy megváltozik.
Ilyen helyzetben fontolja meg a dinamikus információk gyorsítótárban való tárolásának előnyeit az állandó adattár helyett. Ha az adatok nem kritikusak, és nem igényel naplózást, akkor nem számít, hogy az alkalmi módosítás elveszik-e.
Az adatok lejáratának kezelése gyorsítótárban
A legtöbb esetben a gyorsítótár olyan adatokat tárol, amelyek az eredeti adattárból származó adatok másolatai. Az eredeti adattár adatai a gyorsítótárazás után változhatnak, ami elavultá teheti a gyorsítótárazott adatokat. Számos gyorsítótárazási rendszer lehetővé teszi, hogy a gyorsítótárat úgy konfigurálja, hogy lejárjanak az adatok, ami csökkenti azt az időtartamot, amely alatt az adatok elavultak lehetnek.
A gyorsítótárazott adatok lejárata után a gyorsítótár eltávolítja azokat. Az alkalmazás ezután lekéri az új adatokat az eredeti adattárból, és lecserélheti a gyorsítótárban lévő lejárt adatokat. A gyorsítótár konfigurálásakor beállíthatja az alapértelmezett lejárati szabályzatot. Számos gyorsítótárszolgáltatásban megadhatja az egyes objektumok lejárati idejét is, amikor programozott módon tárolja őket a gyorsítótárban. Egyes gyorsítótárak lehetővé teszik a lejárati időtartam abszolút értékként vagy tolóértékként való megadását, ha az elem egy megadott időn belül nem érhető el. Ez a beállítás felülírja a gyorsítótár-szintű lejárati szabályzatokat, de csak a megadott objektumok esetében.
Note
Vegye figyelembe a gyorsítótár és a benne található objektumok lejárati idejét. Ha túl rövidre teszi, az objektumok túl gyorsan lejárnak, és csökkenti a gyorsítótár használatának előnyeit. Ha túl hosszúra teszi az időszakot, azzal kockáztatja, hogy az adatok elavulttá válnak.
Ha lehetővé teszi, hogy az adatok hosszú ideig a gyorsítótárban maradjanak, előfordulhat, hogy a gyorsítótár megtelik. Ebben az esetben az új elemek gyorsítótárhoz való hozzáadására irányuló kérések miatt a gyorsítótár kényszerítve távolíthatja el a kiürítésnek nevezett folyamat egyes elemeit. A gyorsítótár-szolgáltatások általában a legutóbb használt (LRU) alapon távolítják el az adatokat, azonban rendszerint felülírhatja ezt a szabályt, és megakadályozhatja az elemek eltávolítását. Ha azonban ezt a megközelítést alkalmazza, azzal a kockázattal jár, hogy túllépi a gyorsítótárban elérhető memóriát. Egy olyan alkalmazás, amely egy elemet próbál hozzáadni egy teljes gyorsítótárhoz, kivétellel meghiúsul.
Egyes gyorsítótárazási implementációk más kiürítési szabályzatokat is biztosítanak. A kiürítési szabályzatok típusai a következők:
- A legutóbb használt szabályzat: Eltávolítja a legutóbb használt elemeket a gyorsítótárból abban a reményben, hogy az adatokra nem lesz szükség újra.
- FIFO-elv: Először a legrégebbi adatokat távolítja el a gyorsítótárból.
- Explicit eltávolítási szabályzat: Eltávolítja az elemeket a gyorsítótárból egy eseményindító esemény, például a módosítandó adatok alapján.
Adatok érvénytelenítése ügyféloldali gyorsítótárban
Az ügyféloldali gyorsítótárban tárolt adatok nem tartoznak az ügyfél számára adatokat biztosító szolgáltatás irányításán kívülre. A szolgáltatás nem kényszerítheti közvetlenül az ügyfelet arra, hogy adatokat adjon hozzá vagy távolítson el az ügyféloldali gyorsítótárból.
Ez a korlátozás azt jelenti, hogy a rosszul konfigurált gyorsítótárat használó ügyfelek továbbra is elavult információkat használhatnak. Ha például a gyorsítótár lejárati szabályzatai nincsenek megfelelően implementálva, előfordulhat, hogy az ügyfél elavult információkat használ, amelyek helyileg gyorsítótárazva lesznek, amikor az eredeti adatforrás adatai megváltoznak.
Ha http-kapcsolaton keresztül adatokat kiszolgáló webalkalmazást hoz létre, implicit módon kényszerítheti a webügyfeleket, például a böngészőt vagy a webproxyt a legfrissebb információk lekérésére. Ezt a frissítést az erőforrás frissítésekor az URI módosításával aktiválhatja. A webes ügyfelek általában egy erőforrás URI-ját használják kulcsként az ügyféloldali gyorsítótárban, így ha az URI megváltozik, a webes ügyfél figyelmen kívül hagyja az erőforrás korábban gyorsítótárazott verzióit, és ehelyett lekéri az új verziót.
Az egyidejűség kezelése a gyorsítótárban
Gyakran tervez olyan gyorsítótárakat, amelyeket egy alkalmazás több példánya oszt meg. Minden alkalmazáspéldány képes a gyorsítótárban lévő adatok olvasására és módosítására, így a megosztott adattárakban felmerülő egyidejűségi problémák a gyorsítótárra is érvényesek. Ha egy alkalmazásnak módosítania kell a gyorsítótárban tárolt adatokat, előfordulhat, hogy gondoskodnia kell arról, hogy az alkalmazás egyik példánya által végrehajtott frissítések ne felülírják a másik példány által végrehajtott módosításokat.
Az adatok jellegétől és az ütközések valószínűségétől függően az egyidejűség két megközelítésének egyikét alkalmazhatja:
Optimista: Mielőtt az alkalmazás frissíti az adatokat, ellenőrzi, hogy a gyorsítótárban lévő adatok módosultak-e a lekérés óta. Ha az adatok továbbra is ugyanazok, az alkalmazás végrehajtja a módosítást. Ellenkező esetben az alkalmazás dönti el, hogy frissíti-e. A döntés alapjául szolgáló üzleti logika alkalmazásspecifikus. Ez a megközelítés olyan helyzetekre alkalmas, amikor a frissítések ritkán fordulnak elő, vagy ha nem valószínű, hogy ütközések történnek.
Pesszimista: Amikor az alkalmazás lekéri az adatokat, zárolja az adatokat a gyorsítótárban, hogy megakadályozza egy másik példány módosítását. Ez a folyamat biztosítja, hogy ütközések ne következhessenek be, de blokkolhatja azokat a példányokat is, amelyeknek ugyanazokat az adatokat kell feldolgozniuk. A pesszimista egyidejűség befolyásolhatja a megoldás méretezhetőségét, és csak rövid élettartamú műveletekhez ajánlott. Ez a megközelítés akkor lehet megfelelő, ha az ütközések nagyobb valószínűséggel történnek, különösen akkor, ha egy alkalmazás több elemet frissít a gyorsítótárban, és gondoskodnia kell arról, hogy ezek a módosítások következetesen legyenek alkalmazva.
Magas rendelkezésre állás és méretezhetőség megvalósítása, valamint a teljesítmény javítása
Kerülje a gyorsítótár használatát az adatok elsődleges adattáraként. Ezt a szerepkört az eredeti adattár szolgálja ki, amelyből a gyorsítótár fel van töltve. Az eredeti adattár biztosítja az adatok megőrzését.
Ügyeljen arra, hogy ne vezessen be kritikus függőségeket a megosztott gyorsítótár-szolgáltatás rendelkezésre állásától a megoldásokban. Ha a megosztott gyorsítótár nem érhető el, az alkalmazásnak továbbra is működnie kell. Az alkalmazásnak nem szabad válaszképtelenné válnia vagy meghibásodnia, amíg a gyorsítótár-szolgáltatás folytatására vár.
Ezért az alkalmazásnak készen kell állnia a gyorsítótár szolgáltatás rendelkezésre állásának észlelésére, és vissza kell esnie az eredeti adattárba, ha a gyorsítótár nem érhető el. A Circuit-Breaker minta hasznos a forgatókönyv kezeléséhez. A gyorsítótárat biztosító szolgáltatás helyreállítható, és miután elérhetővé válik, a gyorsítótár újra feltölthető az eredeti adattárból beolvasott adatokkal, például a Cache-Aside-mintát követve.
A rendszer méretezhetőségét azonban befolyásolhatja, ha az alkalmazás visszaesik az eredeti adattárba, amikor a gyorsítótár átmenetileg nem érhető el. A gyorsítótár helyreállítása közben az eredeti adattárat eláraszthatja az adatokra vonatkozó kérések, ami időtúllépéseket és sikertelen kapcsolatokat eredményez.
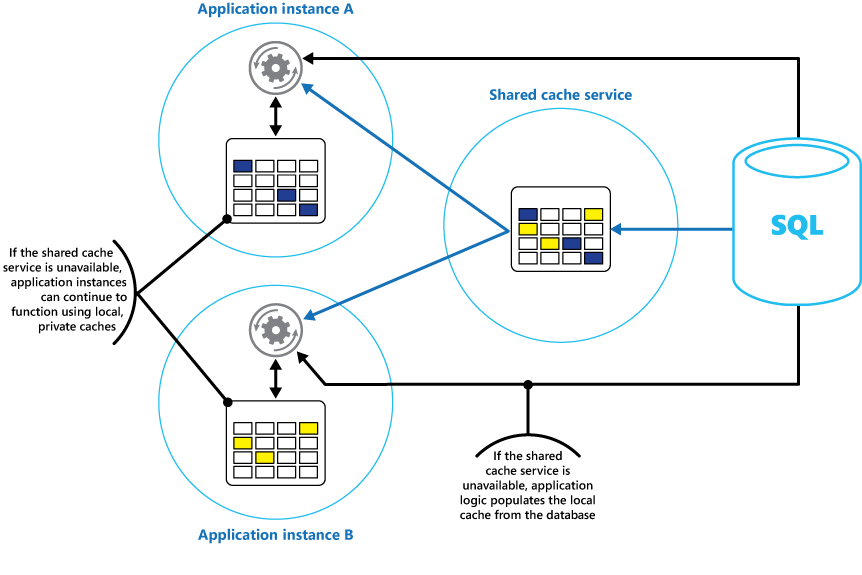
Fontolja meg egy helyi, privát gyorsítótár implementálását egy alkalmazás minden példányában, valamint azt a megosztott gyorsítótárat, amelyhez az összes alkalmazáspéldány hozzáfér. Amikor az alkalmazás lekér egy elemet, először a helyi gyorsítótárban, majd a megosztott gyorsítótárban, végül pedig az eredeti adattárban ellenőrizheti. A helyi gyorsítótár feltölthető a megosztott gyorsítótárban lévő adatokkal, vagy az adatbázisban, ha a megosztott gyorsítótár nem érhető el.
Ez a megközelítés gondos konfigurálást igényel, hogy a helyi gyorsítótár ne legyen túl elavult a megosztott gyorsítótár tekintetében. A helyi gyorsítótár azonban pufferként működik, ha a megosztott gyorsítótár nem érhető el az alábbi ábrán látható módon.
A viszonylag hosszú élettartamú adatokat tartalmazó nagy gyorsítótárak támogatásához egyes gyorsítótár-szolgáltatások magas rendelkezésre állási lehetőséget biztosítanak, amely automatikus feladatátvételt valósít meg, ha a gyorsítótár elérhetetlenné válik. Ez a módszer általában az elsődleges gyorsítótár-kiszolgálón tárolt gyorsítótárazott adatok másodlagos gyorsítótár-kiszolgálóra való replikálását, valamint a másodlagos kiszolgálóra való váltást foglalja magában, ha az elsődleges kiszolgáló meghibásodik, vagy megszakad a kapcsolat.
A több célhelyre történő írásból eredő késés csökkentése érdekében előfordulhat, hogy a másodlagos kiszolgálóra történő replikáció aszinkron módon történik, amikor az adatok az elsődleges kiszolgálón lévő gyorsítótárba kerülnek. Ez a megközelítés azt a lehetőséget eredményezi, hogy a gyorsítótárban tárolt adatok némelyike elveszhet, ha hiba történik, de az adatok arányának kicsinek kell lennie a gyorsítótár teljes méretéhez képest.
Ha egy megosztott gyorsítótár nagy, hasznos lehet a gyorsítótárazott adatok csomópontok közötti particionálása a versengés esélyének csökkentése és a méretezhetőség javítása érdekében. Számos megosztott gyorsítótár támogatja a csomópontok dinamikus hozzáadását és eltávolítását, valamint az adatok partíciók közötti újraegyensúlyozását. Ez a megközelítés magában foglalhatja a fürtözést, amelyben a csomópontok gyűjteménye egyetlen gyorsítótárként jelenik meg az ügyfélalkalmazások számára. Belsőleg azonban az adatok egy előre definiált terjesztési stratégia alapján oszlanak el a csomópontok között, amely egyenletesen egyensúlyozza a terhelést. További információkért tekintse meg a horizontális skálázási mintát.
A fürtözés a gyorsítótár rendelkezésre állását is növelheti. Ha egy csomópont meghibásodik, a gyorsítótár fennmaradó része továbbra is elérhető. A fürtözést gyakran használják a replikációhoz és a feladatátvételhez. Minden csomópont replikálható, és a replika gyorsan online állapotba helyezhető, ha a csomópont meghibásodik.
Sok olvasási és írási művelet valószínűleg egyetlen adatértéket vagy objektumot foglal magában. Időnként azonban szükség lehet nagy mennyiségű adat gyors tárolására vagy lekérésére. Például a gyorsítótár előkészítése magában foglalhatja, hogy több száz vagy több ezer elemet írunk a gyorsítótárba. Előfordulhat, hogy egy alkalmazásnak ugyanannak a kérésnek a részeként nagy számú kapcsolódó elemet is le kell kérnie a gyorsítótárból.
Számos nagy volumenű gyorsítótár kötegműveleteket biztosít ezekhez a célokhoz. Ez a funkció lehetővé teszi, hogy az ügyfélalkalmazás nagy mennyiségű elemet csomagoljon egyetlen kérelembe, ami csökkenti a nagy számú kis kérés végrehajtásának többletterhelését.
Gyorsítótárazás és végleges konzisztencia
Ahhoz, hogy a Cache-Aside minta működjön, a gyorsítótárat feltöltő alkalmazás példányának hozzáféréssel kell rendelkeznie az adatok legújabb és konzisztens verziójához. A végleges konzisztenciát megvalósító rendszerekben (például replikált adattárakban) ez a feltétel nem feltétlenül igaz.
Az alkalmazás egy példánya módosíthatja az adatelemet, és érvénytelenítheti az elem gyorsítótárazott verzióját. Előfordulhat, hogy az alkalmazás egy másik példánya megpróbálja ezt az elemet a gyorsítótárból olvasni, ami gyorsítótártévesztést eredményez. Ezután beolvassa az adatokat az adattárból, és hozzáadja a gyorsítótárhoz. Ha azonban az adattár nincs teljesen szinkronizálva a többi replikával, az alkalmazáspéldány felolvassa és feltölti a gyorsítótárat a régi értékkel.
Az elosztott gyorsítótár egy újabb réteget vezet be ehhez a problémához. A CAP-tétel azt állítja, hogy egy elosztott rendszer a három garancia közül legfeljebb kettőre képes: konzisztencia, rendelkezésre állás és partíciótűrés. Mivel a hálózati partíciók elkerülhetetlenek a felhőkörnyezetekben, a konzisztencia és a rendelkezésre állás között kell választania. A legtöbb elosztott gyorsítótár , beleértve a Redist is, rangsorolja a rendelkezésre állást és a partíciótűrést az erős konzisztenciával szemben. Ez a prioritás azt jelenti, hogy a gyorsítótárreplikából származó olvasások elavult adatokat adhatnak vissza egy hálózati partíció során vagy közvetlenül azután, hogy egy másik csomópontra írnak. A gyorsítótárazási stratégia tervezésekor döntse el, hogy az alkalmazás mekkora mértékű adat-elavulást tolerál, és ennek megfelelően állítsa be a TTL-értékeket. Az aktuális adatok esetében használjon rövidebb TCL-eket, vagy hagyja ki teljesen a gyorsítótárat, és olvassa be a forrásadattárból.
Az elosztott rendszerek adatkonzisztenciájának kezelésével kapcsolatos további információkért lásd a mikroszolgáltatásokra vonatkozó adatkezelési szempontokat.
Gyorsítótárazott adatok védelme
A használt gyorsítótár-szolgáltatástól függetlenül fontolja meg, hogyan védheti meg a gyorsítótárban lévő adatokat a jogosulatlan hozzáféréstől. Két fő szempont:
- A gyorsítótárban lévő adatok bizalmassága.
- Az adatok védelme, amint azok áramlanak a gyorsítótár és a gyorsítótárat használó alkalmazás között.
A gyorsítótárban lévő adatok védelme érdekében a gyorsítótár szolgáltatás olyan hitelesítési mechanizmust implementálhat, amely megköveteli az alkalmazások számára a következő részletek megadását:
- Mely identitások férhetnek hozzá a gyorsítótárban lévő adatokhoz.
- Mely olvasási és írási műveleteket hajthatják végre ezek az identitások.
Az adatok olvasásával és írásával kapcsolatos többletterhelés csökkentése érdekében, miután egy identitás írási vagy olvasási hozzáférést kapott a gyorsítótárhoz, az identitás bármilyen adatot használhat a gyorsítótárban.
Ha korlátoznia kell a gyorsítótárazott adatok részhalmazaihoz való hozzáférést, használja az alábbi módszerek egyikét:
Ossza fel a gyorsítótárat partíciókra különböző gyorsítótár-kiszolgálók használatával. Csak azokhoz a partíciókhoz adjon hozzáférést az identitásoknak, amelyek használatára jogosultak.
Az egyes részhalmazok adatainak titkosítása különböző kulcsokkal. A titkosítási kulcsokat csak olyan identitásokhoz adja meg, amelyeknek hozzáféréssel kell rendelkezniük az egyes részhalmazokhoz. Előfordulhat, hogy egy ügyfélalkalmazás továbbra is le tudja kérni az összes adatot a gyorsítótárban, de csak azokat az adatokat tudja visszafejteni, amelyekhez a kulcsok vannak.
Az adatokat meg kell védeni, amikor azok befelé és kifelé áramlanak a gyorsítótárból. Az ügyfélalkalmazások által a gyorsítótárhoz való csatlakozáshoz használt hálózati infrastruktúra által biztosított biztonsági funkcióktól függ. Ha a gyorsítótár az ügyfélalkalmazásokat üzemeltető szervezet egyik helyszíni kiszolgálójának használatával van implementálva, előfordulhat, hogy a hálózat elkülönítése nem igényel további lépéseket. Ha a gyorsítótár távolról található, és TCP- vagy HTTP-kapcsolatot igényel egy nyilvános hálózaton, például az interneten keresztül, fontolja meg a TLS implementálását.
Gyorsítótárazás megvalósítása az Azure Managed Redis használatával
A cikk további szakaszai a gyorsítótárazási minták Azure Managed Redis használatával történő implementálását ismertetik. Az Azure Managed Redis egy felügyelt Redis-szolgáltatás, amelyet megosztott gyorsítótárként használhat az alkalmazáspéldányok között. Támogatja a kulcs-érték gyorsítótárat, az adatstruktúrákat, például a halmazokat, a rendezett halmazokat és a listákat, valamint az újbóli indulások közötti adatállandóság opcionális fenntartását.
Az elérhető szintekről, a kapacitástervezésről, a hálózatkezelésről és a funkciók részleteiről az Azure Managed Redis dokumentációjában olvashat.
Ügyfélalkalmazások csatlakoztatása és konfigurálása
A Redis számos programozási nyelven támogatja az ügyfélalkalmazásokat. A .NET-alkalmazásokhoz számos ügyfélkódtár érhető el, amelyek mindegyike különböző Redis-számítási feladatokhoz használható. A tár kiválasztása attól függ, hogy a Redist szigorúan gyorsítótárként vagy többmodelles adatplatformként használja-e.
Redis-kiszolgálóhoz való csatlakozáshoz használja az osztály statikus Connect metódusát ConnectionMultiplexer . A metódus által létrehozott kapcsolat az ügyfélalkalmazás teljes élettartama alatt használható. Több egyidejű szál is használhatja ugyanazt a kapcsolatot. Ne csatlakoztassa újra és válassza le a kapcsolatot minden alkalommal, amikor Redis-műveletet hajt végre, mert ez csökkentheti a teljesítményt.
A nyelvspecifikus kapcsolódási példákért lásd: Az Azure Managed Redis használata a .NET Core-ban.
.NET-ügyfélkódtár kiválasztása
Ha Azure Managed Redist használ gyorsítótárazáshoz, használja a következő .NET kódtárakat:
StackExchange.Redis: Alacsony szintű Redis-ügyfél, amely nagy teljesítményt nyújt. Akkor használja, ha közvetlen hozzáférésre van szüksége a Redis-parancsokhoz, az atomi műveletekhez, a tranzakciókhoz, a pipelininghez vagy a Lua-szkriptekhez.
Microsoft. Extensions.Caching.StackExchangeRedis:
IDistributedCacheintegrációt biztosít a ASP.NET Core számára. Egyszerű kulcs-érték gyorsítótárazáshoz használható, ahol az értékek átlátszatlan bájttömbökként vannak tárolva. Ez az absztrakció nem teszi elérhetővé a speciális Redis-adatstruktúrát.
Ezek a kódtárak biztosítják a közös gyorsítótárazási minták létrehozásához szükséges primitíveket, de az alkalmazásnak magát a gyorsítótárazási logikát kell implementálnia.
Gyorsítótárazási minták implementálása
A Redis gyorsítótárazáshoz való használatának legegyszerűbb módja az értékek kulcsok alatti tárolása a kulcs-érték modell használatával. Az értékek lehetnek tetszőleges hosszúságú sztringek vagy bináris adatok, így a Redis jól használható szerializált objektumok, konfigurációs adatok, munkamenet-állapot vagy előre konfigurált eredmények gyorsítótárazására.
Gondosan tervezze meg a kulcsteret, és használjon értelmes (de nem terjengős) kulcsokat. Például a strukturált kulcsok customer:100 (nem csak 100) használatával jelölheti a 100-ás azonosítójú ügyfél kulcsát. Ezzel a sémával megkülönböztetheti a különböző adattípusokat tároló értékeket. A kulccsal orders:100 például a 100-ás azonosítójú rendelés kulcsát is megadhatja.
Bár a sztringek a leggyakoribb gyorsítótárazási módszerek, a Redis számos natív adattípust támogat, például kivonatokat, listákat, készleteket, rendezett halmazokat és streameket, amelyek rugalmasabb gyorsítótárazási mintákat tesz lehetővé. A Redis adattípusokkal kapcsolatos további információkért tekintse meg a Redis adattípusokra vonatkozó dokumentációját.
A Cache-Aside minta implementálása
Az adatok hatékony gyorsítótárazási módjának meghatározásában leírtak szerint gyakori módszer az adatok igény szerinti betöltése a gyorsítótárba. Az alábbi példa először ellenőrzi a gyorsítótárat, majd ha nincs találat, lekéri az adatforrásból az információt, és eltárolja az eredményt a későbbi kérésekhez.
var config = new ConfigurationOptions();
// ... configure endpoint, credentials, TLS, etc.
ConnectionMultiplexer redisHostConnection = ConnectionMultiplexer.Connect(config);
IDatabase cache = redisHostConnection.GetDatabase();

async Task<string> RetrieveItemAsync(string itemKey)
{
    // Attempt to retrieve the item from the Redis cache
    string itemValue = await cache.StringGetAsync(itemKey);

    // If the value returned is null, the item was not found in the cache
    // So retrieve the item from the data source and add it to the cache
    if (itemValue is null)
    {
        itemValue = await GetItemFromDataSourceAsync(itemKey);
        await cache.StringSetAsync(itemKey, itemValue);
    }

    return itemValue;
}
Atomi és kötegműveletek végrehajtása
Ha több ügyfél vagy alkalmazáspéldány osztozik a gyorsítótárhelyen, meg kell akadályoznia, hogy az egyidejű frissítések megrongálják az adatokat. Az általános egyidejűségi stratégiákat a jelen cikk korábbi részében, a gyorsítótár egyidejűségének kezelése című témakörben ismertetjük. A Redis számos olyan mechanizmust biztosít, amelyek implementálják ezeket a stratégiákat.
Atomi, egy kulcson végzett műveletek: Használjon olyan parancsokat, amelyek egyetlen lépésben frissítenek egy értéket, kiküszöbölve azokat a versenyhelyzeteket, amelyek akkor fordulnak elő, amikor a
GETés aSETparancsot külön adják ki.INCR,INCRBY,DECRDECRBYszámértékek atomi növekménye vagy decrementációja. A StackExchange.Redisben használjaIDatabase.StringIncrementAsyncésIDatabase.StringDecrementAsync. Ezek a parancsok olyan számlálókhoz, sebességkorlátozókhoz és kvótakövetéshez hasznosak, ahol egyszerre több ügyfél is frissíti ugyanazt a kulcsot.GETSETatomilag beállít egy kulcsot egy új értékre, és visszaadja az előző értéket. A StackExchange.Redisben használja a következőtIDatabase.StringGetSetAsync:string oldValue = await cache.StringGetSetAsync("data:counter", 0);
Többkulcsos műveletek:
MGETésMSETtöbb sztringérték olvasását vagy írását teszi lehetővé egyetlen hálózati körben, csökkentve a hálózati terhelést, amikor egyszerre több kulccsal kell dolgoznia. AIDatabase.StringGetAsyncés aIDatabase.StringSetAsyncmetódusok túlterheltek, hogy támogassák ezt a funkcionalitást:// Create a list of key-value pairs var keysAndValues = new KeyValuePair<RedisKey, RedisValue>[] { new("data:key1", "value1"), new("data:key99", "value2"), new("data:key322", "value3") }; // Store the list of key-value pairs in the cache await cache.StringSetAsync(keysAndValues); ... // Find all values that match a list of keys RedisKey[] keys = ["data:key1", "data:key99", "data:key322"]; // Values should contain { "value1", "value2", "value3" } RedisValue[] values = await cache.StringGetAsync(keys);Tranzakciók (optimista egyidejűség): A paranccsal figyelhet
WATCHegy vagy több kulcsot, mielőtt tranzakciót indítana.MULTI/EXECHa a figyelt kulcsok a tranzakció elindítása előtt módosulnak, a Redis elveti a tranzakciót, és az ügyfél újra próbálkozhat. A StackExchange könyvtár támogatást nyújt a tranzakciók számára aITransactionfelületen keresztül.A
ITransactionmetódust használva hozhat létreIDatabase.CreateTransactionobjektumot. Az objektum által biztosított metódusokkal parancsokat hívhat meg aITransactiontranzakcióhoz.Az
ITransactioninterfész hozzáférést biztosít az interfész általIDatabaseelért metódusokhoz hasonló metódusokhoz, kivéve, hogy az összes metódus aszinkron. Ez azt jelenti, hogy csak aITransaction.Executemetódus meghívásakor lesznek végrehajtva. A metódus által visszaadott érték azt jelzi,ITransaction.Executehogy a tranzakció sikeresen létrejött -e (igaz), vagy meghiúsult -e (hamis).Az alábbi kódrészlet egy példát mutat be, amely két számlálót növekményesen és dekrementel ugyanazon tranzakció részeként:
ITransaction transaction = cache.CreateTransaction();

var tx1 = transaction.StringIncrementAsync("data:counter1");
var tx2 = transaction.StringDecrementAsync("data:counter2");

bool result = await transaction.ExecuteAsync();

Console.WriteLine($"Transaction {(result ? "succeeded" : "failed")}");

if (result)
{
    long increment = await tx1;
    long decrement = await tx2;

    Console.WriteLine($"Result of increment: {increment}");
    Console.WriteLine($"Result of decrement: {decrement}");
}
A Redis-tranzakciók eltérnek a relációs adatbázisok tranzakcióitól. A
Executemetódus a futtatandó tranzakciót alkotó összes parancsot várólistára állítja, és ha valamelyik parancs érvénytelen, akkor a tranzakció leáll. Ha az összes parancs sikeresen várólistára kerül, minden parancs aszinkron módon fut. Ha valamelyik parancs meghiúsul, a többiek továbbra is feldolgozva maradnak. Ha ellenőriznie kell, hogy egy parancs sikeresen befejeződött-e, kérje le az eredményeket aResultmegfelelő tevékenység tulajdonságával, ahogyan az előző példában is látható.Lua-szkriptelés. Többlépéses frissítések esetén, amelyeknek több kulcs között atominak kell lenniük, Lua-szkriptet futtathat a kiszolgálón. A Redis a teljes szkriptet egyetlen műveletként futtatja anélkül, hogy más parancsokat is összekapcsol.
Note
Fürtözött telepítésekben a tranzakcióban vagy Lua-szkriptben részt vevő összes kulcsnak ugyanabban a "hash slot"-ban kell elhelyezkednie. Használjon hasheket, például
customer:{123}:namevagycustomer:{123}:emaila kapcsolódó kulcsok egymás mellé helyezésére.
Válaszra nem váró gyorsítótár-műveletek végrehajtása
Ha a gyorsítótár frissítése nem befolyásolja az alkalmazás helyességét, például egy nézetszámláló növelését vagy egy nem kritikus statisztika frissítését, kihagyhatja a kiszolgáló válaszára való várakozást. Egy olyan gyorsítótár-művelet esetén, amelynél az alkalmazás elindít egy háttérfeladatot, majd annak befejezésére való várakozás nélkül folytatja a működését. A Redis támogatja az olyan műveleteket, amelyeknél nincs szükség válaszra, így a kliens oldali oda-vissza késleltetés parancsjelzők használatával csökkenthető:
await cache.StringSetAsync("data:key1", 99);
...
cache.StringIncrement("data:key1", flags: CommandFlags.FireAndForget);
Automatikusan lejáró kulcsok megadása
A gyorsítótárban lévő adatok lejáratának kezelése című cikkben ismertetett lejárati stratégiák kulcsonkénti TCL-eken keresztül implementálódnak a Redisben. Amikor egy elemet egy Redis-gyorsítótárban tárol, megadhat egy időtúllépést, amely után a rendszer automatikusan eltávolítja az elemet. A parancs használatával TTL azt is lekérdezheti, hogy mennyi idő áll a kulcs lejárata előtt. Ez a parancs elérhető a StackExchange-alkalmazások számára a IDatabase.KeyTimeToLive metóduson keresztül.
Az alábbi kódrészlet bemutatja, hogyan állíthat be 20 másodperces lejárati időt egy kulcson, és hogyan kérdezheti le a kulcs hátralévő élettartamát:
// Add a key with an expiration time of 20 seconds
await cache.StringSetAsync("data:key1", 99, TimeSpan.FromSeconds(20));
...
// Query how much time a key has left to live
// If the key has already expired, the KeyTimeToLive function returns null
TimeSpan? expiry = cache.KeyTimeToLive("data:key1");
A lejáratot egy adott dátumra és időpontra is beállíthatja a EXPIREAT StackExchange könyvtárban KeyExpireAsync elérhető parancs használatával. Egy paramétert DateTime vesz igénybe:
await cache.StringSetAsync("data:key1", 99);
await cache.KeyExpireAsync("data:key1",
    new DateTime(2026, 9, 1, 0, 0, 0, DateTimeKind.Utc));
Tip
Kézzel is eltávolíthat egy elemet a gyorsítótárból a DEL paranccsal, amely a StackExchange könyvtárban IDatabase.KeyDeleteAsync metódusként érhető el.
Amikor a Redis eléri a memóriakorlátját, egy konfigurált kiürítési szabályzat szerint kiüríti a kulcsokat. Az alapértelmezett szabályzat a volatile-lru, amely a legkevésbé nemrég használt, TTL-lel rendelkező kulcsot távolítja el. Más szabályzatok közé tartozik a allkeys-lru, volatile-randomés noeviction (ami miatt az írási műveletek meghiúsulnak, ha a memória megtelik). Válasszon kilakoltatási szabályzatot annak alapján, hogy az alkalmazás következetesen használ-e TCL-eket, és hogy a lejárat nélküli kulcsokat szeretné-e védeni. További információ: Memóriakezelés.
Gyorsítótárazott elemek keresztkorrelálása
Ha gyorsítótárazza a kapcsolódó elemeket, gyakran úgy kell megtalálnia őket, hogy nem az elsődleges kulcs alapján, hanem a kapcsolat alapján keres. Előfordulhat például, hogy gyorsítótárazza a blogbejegyzéseket, és olyan lekérdezésekre kell válaszolnia, mint "mely bejegyzések osztják meg az Y címkét?" vagy "melyik címkék tartoznak az X bejegyzéshez?"
Az Azure Managed Redisben az ajánlott módszer a RedisJSON és a RediSearch használata. Tárolja az egyes gyorsítótárazott elemeket JSON-dokumentumként a metaadataival, majd hozzon létre egy RediSearch-indexet a lekérdezéshez szükséges mezők felett. A RediSearch kezeli a fordított kereséseket, a címkealapú szűrést, a tartománylekérdezéseket és a teljes szöveges keresést anélkül, hogy az alkalmazásnak külön indexstruktúrákat kellene fenntartania.
Egyszerűbb forgatókönyvek esetén a Redis Sets használatával manuálisan is létrehozhat előre- és fordított indexeket. Tároljon bejegyzésenként egy készletet (a címkéket tartalmazó) és egy címkénkénti készletet (amely tartalmazza a bejegyzésazonosítókat):
foreach (BlogPost post in posts)
{
    string postTagsKey = $"blog:posts:{post.Id}:tags";
    await cache.SetAddAsync(
        postTagsKey, post.Tags.Select(s => (RedisValue)s).ToArray());

    foreach (var tag in post.Tags)
    {
        await cache.SetAddAsync($"tag:{tag}:blog:posts", post.Id);
    }
}
Ezután lekérdezheti egy bejegyzés címkéit a(z) SetMembersAsync használatával, megkeresheti a bejegyzések közös címkéit a(z) SetCombineAsync(SetOperation.Intersect, ...) használatával, vagy lekérdezheti egy megadott címkéhez tartozó összes bejegyzést. Ennek az az ára, hogy az alkalmazásnak mind a normál, mind a fordított halmazokat karban kell tartania, ami a kapcsolatok számának növekedésével növeli az összetettséget.
Legutóbb elért elemek keresése
Sok alkalmazásnak nyomon kell követnie a legutóbb elért vagy megtekintett elemeket. Előfordulhat például, hogy egy blogwebhely megjeleníti a visszatérő látogató legutóbbi olvasási bejegyzéseit. A Redis-listák hatékony lehetőséget nyújtanak a frissességen alapuló gyorsítótárazási minták megvalósítására. Az elemek a lista bármelyik végébe leküldhetők a használatával LPUSH vagy RPUSHhasználatával, és eltávolíthatók a használatával LPOP vagy RPOPhasználatával. A LTRIM segítségével korlátozza a lista hosszát és akadályozza meg a korlátlan memórianövekedést.
Ranglista megvalósítása
A Redis Sorted Sets (ZSETs) úgy tartja fenn a rendezett rangsorokat, hogy az egyes elemeket numerikus pontszámmal társítja. A Redis automatikusan fenntartja a rendelést.
ZADD időigénye O(log N), az olyan tartománylekérdezések pedig, mint a ZRANGE és a ZREVRANGE, O(log N + M) időigényűek, ahol M a visszaadott elemek száma, így a rendezett halmazok nagy elemszám esetén is hatékonyak maradnak.
Elemek hozzáadása ranglistához
Az alábbi példa bemutatja, hogyan adhat hozzá blogbejegyzést és pontszámát egy ranglistához a ZADD következő paranccsal SortedSetAddAsync:
var db = connection.GetDatabase();
string redisKey = "blog:post_rankings";

BlogPost blogPost = ...; // The blog post being ranked

await db.SortedSetAddAsync(redisKey, blogPost.Title, blogPost.Score);
Rangsorolt elemek lekérése
Az elemeket növekvő pontszám sorrendben a következővel SortedSetRangeByRankWithScoresAsynckérdezheti le:
var entries = await db.SortedSetRangeByRankWithScoresAsync(redisKey);

foreach (var entry in entries)
{
    Console.WriteLine($"{entry.Element}: {entry.Score}");
}
Note
SortedSetRangeByRankAsync Csak a tagértékeket adja vissza, a pontszámokat nem.
Top-N elemek lekérése
A legmagasabb pontszámú elemek, például az első 10 bejegyzés lekéréséhez használjon csökkenő sorrendet:
foreach (var post in await cache.SortedSetRangeByRankWithScoresAsync(
                               redisKey, 0, 9, Order.Descending))
{
    Console.WriteLine(post);
}
Elemek lekérése pontszámtartomány szerint
Az elemeket ponthatárok alapján is lekérdezheti a rangsorolás helyett:
foreach (var post in await cache.SortedSetRangeByScoreWithScoresAsync(
                               redisKey, 5000, 100000))
{
    Console.WriteLine(post);
}
Ha meg szeretné akadályozni, hogy egy ranglista határozatlan ideig növekedjen, távolítsa el a régi bejegyzéseket időtartományú kulcsok (például napi vagy heti ranglisták) használatával SortedSetRemoveRangeByRankAsync vagy használatával. A pontszámokat atomilag frissítheti a (SortedSetIncrementAsync) paranccsel ZINCRBY .
Gyorsítótárazza a munkamenet állapotát és a HTML-kimenetet
A Azure Managed Redis használatával munkamenetállapot- és kimeneti gyorsítótáradatokat tárolhat ASP.NET Core és ASP.NET alkalmazásokhoz. Ha a munkamenet-adatokat és a renderelt kimenetet egy megosztott Redis-alapú gyorsítótárban tartja, több példányon futó alkalmazások, például Azure App Service, Azure Kubernetes Service (AKS), Azure Container Appsvagy virtuálisgép-méretezési csoportok konzisztens felhasználói élményt tarthatnak fenn kiszolgálói affinitás nélkül.
Tip
A legjobb teljesítmény érdekében helyezze üzembe az alkalmazást és az Azure Managed Redis-példányt ugyanabban az Azure-régióban.
ASP.NET Core
ASP.NET Core alkalmazások az IDistributedCache absztrakciót és a köztes szoftvert a munkamenethez használják. Az Azure Managed Redis a IDistributedCache csomagon keresztül integrálható Microsoft.Extensions.Caching.StackExchangeRedis-val.
builder.Services.AddStackExchangeRedisCache(options =>
{
    options.Configuration = "<your-cache-name>.<region>.redis.azure.net:10000";
    options.InstanceName = "app-cache:";
});

builder.Services.AddSession();
ASP.NET Core kimeneti gyorsítótárazási köztes szoftver a Redist is használhatja elosztott háttértárként, így az alkalmazások minden példányon megoszthatják a renderelt töredékeket vagy lapokat. További információ: ASP.NET Core kimeneti gyorsítótár-szolgáltató a Redishez.
.NET Aspire integráció
A .NET Aspire-alkalmazások a Aspire.Hosting.Azure.Redis csomag használatával deklarálhatnak egy Azure Managed Redis-erőforrást az alkalmazásgazda szolgáltatásban. A fogyasztó projektek függőség-injektáláson keresztül automatikusan megkapják a kapcsolati beállításokat, ami kiküszöböli a szolgáltatások közötti manuális kapcsolati sztringek kezelését.
// App host: declare the Azure Managed Redis resource
var cache = builder.AddAzureManagedRedis("cache");

builder.AddProject<Projects.ProductService>()
    .WithReference(cache);
A fogyasztószolgáltatások ugyanúgy regisztrálják az elosztott gyorsítótárat, mint bármely más IDistributedCache szolgáltatót. További információ: Ismerkedés a Redis-integrációval.
Magas rendelkezésre állás, méretezhetőség és particionálás
Minden Azure Managed Redis-példány elsődleges/replikareplikát használ. A szolgáltatás figyeli a csomópont állapotát, és automatikusan előléptet egy replikát, ha az elsődleges meghibásodik. Mivel a replikáció aszinkron, a váratlan feladatátvétel során a közelmúltban írt adatok kis része elveszhet. A replikáció, a feladatátvétel és a rétegzett gyorsítótárazás mögötti általános stratégiákról a jelen cikk korábbi, magas rendelkezésre állású és méretezhető teljesítményének megvalósítása és a teljesítmény javítása című témakörben olvashat.
A helyi memóriabeli gyorsítótár és az Azure Managed Redis kombinálásával csökkentheti a késést, és tartalékot biztosíthat, ha a megosztott gyorsítótár ideiglenesen nem érhető el. A Circuit-Breaker minta és a Cache-Aside minta segítenek kezelni ezt a rétegzett megközelítést.
Az egyetlen csomópont kapacitását meghaladó számítási feladatok esetén az Azure Managed Redis támogatja az adatok particionálását (horizontális felosztását) több Redis-csomóponton. Mindkét fürtözési szabályzat esetén az adatok automatikusan a csomópontok között vannak felosztva kulcs–shard megfeleltetésen alapuló hashelés, automatikus feladatátvétel és újraszinkronizálás, valamint online újraosztás (horizontális bővítés és csökkentés) használatával. Az Azure Managed Redis két fürtkezelési szabályzatot támogat:
OSS-fürtkezelési szabályzat (alapértelmezett): Az ügyfelek közvetlenül kommunikálnak a megfelelő szegmenssel, és követik az OSS Redis-fürt szemantikáját, beleértve a MOVED és az ASK átirányításokat. Fürtérzékeny kliensprogramok, mint például a StackExchange.Redis, automatikusan kezelik az átirányításokat. Ez a házirend biztosítja a legalacsonyabb útválasztási többletterhelést.
Redis Vállalati fürtkezelési szabályzat: A proxy transzparens útválasztást biztosít egyetlen végponton keresztül. Az ügyfeleknek nem kell klasztertudatos logikát megvalósítaniuk, és nem kell kezelniük a MOVED/ASK válaszokat. Ez a szabályzat egyszerűbb ügyfélintegrációt kínál, de kis mennyiségű útválasztási többletterhelést vezet be.
Az Azure Managed Redis a nem fürtözött módot is támogatja, amely egyetlen elsődleges/replikapárt használ particionálás nélkül. Ez a mód olyan kisebb munkaterhelésekhez alkalmas, amelyek nem igényelnek horizontális skálázást.
Note
Az egyéni particionálási modellekre, például az ügyféloldali kivonatolásra vagy a nem Microsoft proxykra általában csak a virtuális gépek vagy a Kubernetes ön által felügyelt Redis-telepítéseihez van szükség. Az Azure Managed Redis klaszterezés automatikusan kezeli az útválasztást, a feladatátvételt és az újraparticionálást.
Aktív georeplikáció
A többrégiós rendelkezésre állás érdekében Azure Felügyelt Redis támogatja az aktív georeplikációt, amely Azure régiók példányait egyetlen replikációs csoporthoz kapcsolja. Minden példány képes kezelni az olvasást és az írást, és automatikusan módosíthatja a szinkronizálást. Az alkalmazás felelős a forgalom kifogástalan állapotú példányra való átirányításáért egy regionális hiba során. További információ: Aktív georeplikációs konfigurálás.
Adatmegőrzés
Alapértelmezés szerint a gyorsítótárazott adatok az Azure Managed Redisben a memóriában vannak tárolva, és elveszhetnek, ha egy csomópont újraindul vagy meghibásodik. Olyan számítási feladatok esetében, ahol a gyorsítótár forrásadattárból való újraépítése lassú vagy költséges lenne, az Azure Managed Redis támogatja az opcionális adatmegőrzést:
Az RDB -pillanatképek (Redis-adatbázis) időszakos, időponthoz kötött pillanatképeket hoznak létre egy felügyelt lemezre mentve. Az RDB minimális teljesítményhatással rendelkezik a normál műveletek során, de az utolsó pillanatkép óta írt adatok elveszhetnek.
Az AOF (Append-Only Fájl) minden írási műveletet naplóz a lemezen. Az AOF az írások körülbelül egy másodpercére csökkenti a lehetséges adatvesztést, de nagyobb fájlokat hoz létre, és csökkentheti az írási átviteli sebességet.
Az RDB-t és az AOF-ot együtt is használhatja. A Redis indításkor betölti az RDB-pillanatképet, majd visszajátssza az AOF-naplót a közel teljes helyreállításhoz.
Important
A perzisztencia javítja a csomóponthibákkal szembeni tartósságot, de nem biztonsági mentési vagy katasztrófa-helyreállítási mechanizmus. Kritikus adatok esetén mindig tartsa karban a mérvadó másolatot a forrásadattárban, és használja a Cache-Aside mintát a gyorsítótár újratöltéséhez.
A konfiguráció részleteiért tekintse meg az adatmegőrzés konfigurálását ismertető cikket.
Gyorsítótárazott adatok védelme az Azure Managed Redisben
A gyorsítótárazott adatok védelmének útmutatója a hozzáférés-vezérléssel és az átvitel közbeni adatokkal kapcsolatos problémákat ismerteti. Azure Managed Redis a következő módokon segít a problémák megoldásában:
Elsődleges hozzáférés-vezérlési mechanizmusként használja a Microsoft Entra ID-hitelesítést , és a hozzáférés megadásakor kövesse a minimális jogosultság elvét.
Privát végpontok használatával korlátozza a hálózati hozzáférést, hogy a forgalom ne haladjon át a nyilvános interneten.
Azure Felügyelt Redis TLS használatával titkosítja az átvitel alatt álló adatokat, és titkosítja az inaktív adatokat.
Szerializálási szempontok
Amikor a .NET-objektumokat sztringértékekként tárolja a Redisben, szerializálnia kell őket. Szerializálási formátum kiválasztásakor fontolja meg a teljesítmény, az együttműködési képesség, a verziószámozás és a hasznos adatok mérete közötti kompromisszumot. Nincs egyetlen leggyorsabb szerializáló minden forgatókönyvhöz. A teljesítménytesztek nagymértékben függenek a környezettől, és nem feltétlenül tükrözik a tényleges számítási feladatot.
Ha az Azure Managed Redis szint támogatja a RedisJSON-t, az objektumokat natív JSON-dokumentumként tárolhatja, és az egyes mezőket lekérdezheti a teljes érték deszerializálása nélkül:
public static class RedisJsonExtensions
{
    public static async Task<T?> GetAsync<T>(
        this IDatabase cache,
        string key,
        string path = "$")
    {
        var result = await cache.ExecuteAsync("JSON.GET", key, path);

        if (result.IsNull)
            return default;

        return JsonSerializer.Deserialize<T>(result!);
    }

    public static async Task SetAsync<T>(
        this IDatabase cache,
        string key,
        T value,
        TimeSpan? expiry = null,
        string path = "$")
    {
        var json = JsonSerializer.Serialize(value);

        // Store JSON document
        await cache.ExecuteAsync("JSON.SET", key, path, json);

        // Apply TTL if provided
        if (expiry.HasValue)
        {
            await cache.KeyExpireAsync(key, expiry);
        }
    }

    public static async Task<bool> ExpireAsync(
        this IDatabase cache,
        string key,
        TimeSpan expiry)
    {
        return await cache.KeyExpireAsync(key, expiry);
    }
}
Ha ehelyett Redis-sztringekként szerializálja az értékeket, a formátum gyakori beállításai a következők:
JSON – Emberi olvasásra alkalmas formátum, amely széles körű platformfüggetlen támogatással rendelkezik. Nem a legtömörebb formátum, de jó választás, ha a gyorsítótárazott elemeket közvetlenül a HTTP-ügyfeleknek adják vissza, mert elkerüli a további deszerializálási és újraszerializálási lépéseket.
MessagePack – Kompakt bináris formátum, amely nem rendelkezik sémakövetelményrel. A JSON-hoz képest kisebb csomagokat állít elő, alacsonyabb szerializációs többlettel.
Protokollpufferek (protobuf) – Sémára alapuló bináris formátum, amely kompakt méretű adatokat hoz létre. A nyelvspecifikus kód létrehozásához definíciós fájlokra és fordítási lépésre van szükség
.proto.BSON – Bináris formátum, amely kibővíti a JSON-t több típussal, például dátumokkal és nyers bináris adatokkal. A terhek méretükben hasonlók a JSON-hoz. Praktikus választás, ha az alkalmazás már máshol használja a BSON-t, például a MongoDB-vel.
Kapcsolódó erőforrások
- Az Azure Managed Redis dokumentációja
- Azure Managed Redis – gyakori kérdések
- A Redis dokumentációja
- StackExchange.Redis
Az alkalmazások gyorsítótárazásának megvalósításakor az alábbi minták lehetnek relevánsak:
Cache-Aside minta: Ez a minta azt ismerteti, hogyan tölthet be igény szerinti adatokat egy adattárból származó gyorsítótárba. Emellett segít fenntartani a gyorsítótárban lévő adatok és az eredeti adattár adatai közötti konzisztenciát.
Horizontális skálázási minta: Ez a minta információt nyújt a horizontális particionálás implementálásáról, így javítható a méretezhetőség nagy mennyiségű adat tárolásakor és elérésekor.