Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
Migrálja a számítási feladatokat a klasszikus számításról a kiszolgáló nélküli számításra. A kiszolgáló nélküli számítás automatikusan kezeli a kiépítést, a skálázást, a futtatókörnyezet frissítését és az optimalizálást.
A legtöbb klasszikus számítási feladat minimális vagy kódmódosítás nélkül migrálható. Például az df.cache() és df.persist() használó munkaterhelések többnyire kódváltoztatás nélkül migrálnak. Ez a lap ezekre a számítási feladatokra összpontosít. Bizonyos munkaterhelések, amelyek R- vagy Scala-jegyzetfüzetekre támaszkodnak, klasszikus számítási erőforrást igényelnek, és nem migrálhatók szerver nélküli számítási erőforrásra. Az aktuális korlátozások teljes listájáért tekintse meg a kiszolgáló nélküli számítási korlátozásokat.
Migráció a migrációs ügynökkel
Important
Ez a funkció bétaverzióban érhető el. A munkaterület adminisztrátorai a Számítási Ügynök előnézetet választva engedélyezhetik az Előnézetek oldalán. Lásd: Az Azure Databricks előzetes verziójának kezelése.
Migrációs ügynökkel áthelyezhetsz egyetlen jegyzetfüzetet vagy feladatot szerver nélküli számításra. Az ügynök áttekinti a munkaterhelés környezetét, könyvtárait, Spark konfigurációit, címkéket és kódot, majd minden változtatást külön-külön javaslatként javasol, amit elfogadj vagy elutasíts. Az elfogadott változtatásokat helyben alkalmazzák, és vissza lehet vonni.
Mit vizsgál és változtat az ügynök
| Area | Az ügynök feladata |
|---|---|
| Környezet és könyvtárak | A könyvtártelepítéseket szerver nélküli környezeti specifikációvá fordítja, beleértve %pip telepítéseket, klaszter init szkripteket, klaszterkönyvtárakat a feladatokon, valamint hivatkozásokat egy privát csomagindexre. |
| Környezeti változók | Lefordítja a klaszterkörnyezeti változókat szerver nélküli megfelelőikre, megőrzi a munkaterület titkos hivatkozásait, és elhagyja a platform-által kezelt értékeket. |
| Adat- és tárolóhozzáférés | Szerver nélküli inkompatibilis utakat, például helyi lemezeket dbfs:/és mount útvonalakat ír át Unity Catalog kötetekre. Az ügynök automatikusan alkalmazza az egyértelmű átírásokat, és kéri, hogy válassz egy kötetet, ha a célpont kétértelmű. |
| Spark-konfigurációk | Minden Spark konfigurációt besorol, kommentál azokat a konfigurációkat, amelyek biztonságosan eldobhatók, és megjelöli és eltávolítja azokat a konfigurációkat, amelyeket a szerver nélküli nem támogat. Lefedi mind a klaszterhez csatlakoztatott és a notebookon belüli konfigurációkat. |
| Munkaterhelés kód | Újraírja a szerver nélküli kódot kompatibilis megfelelőkké, például az RDD műveleteket DataFrame műveletekre írva, és módosítja a kódot az ANSI-módú SQL viselkedéshez szerver nélküli rendszeren. |
| Címkék | Egyedi klaszter címkéket, például költségközpontú címkéket, szerver nélküli megfelelőikre fordítja. |
| Teljesítmény mód | A klaszter konfigurációja alapján egy teljesítménymódot javasol. Lásd: Teljesítménymód kiválasztása. |
Requirements
A teljes migráció érdekében ajánlott a munkaterület adminisztrátori hozzáférése. Ennek oka, hogy az ügynök a cél munkaterhelésen túl is vizsgálja a munkaterületi szintű globális init szkripteket. Lehetséges, hogy migrálni tud, ha rendelkezik
CAN MANAGEjogosultsággal a munkaterhelésen, de rendszergazdai jogosultságok nélkül a migrálás hiányzó könyvtárakat, környezeti beállításokat vagy címkéket eredményezhet.Erősítsd meg, hogy hozzáférsz az ügynökhöz. Írd be a
/computeelemet a Genie Code-ban./computeMeg kell jelennie az automatikus kiegészítés menüben. Ha nem jelenik meg, egy munkaterület adminisztrátorának engedélyeznie kell az előnézetet a munkaterületedben.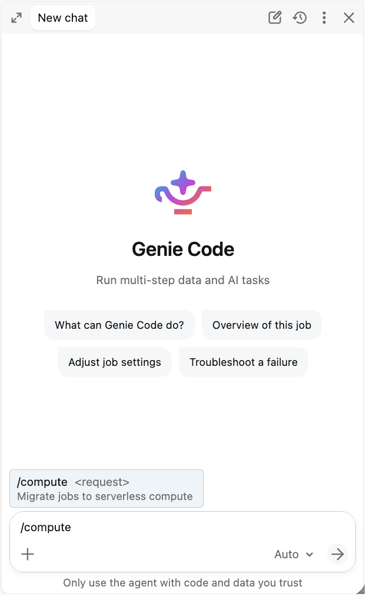
Jegyzetfüzet migrálása
- Nyisd ki azt a jegyzetfüzetet, amit át akarsz vinni.
- Nyisd meg a Genie Code-ot, és futtasd a
/parancspalettán a/compute migrate to serverlessparancsot. - Nézze át az ügynök megállapításait. Az ügynök átvizsgálja a jegyzetfüzet környezetét, könyvtárait és kódját, és minden olyan elemre javasol egy változtatást, amelyre szükség van rá, például egy könyvtártelepítés áthelyezését környezeti specifikációba vagy egy kódcella átírását szerver nélküli üzemmódra.
- Fogadd el vagy utasítsd el az összes javasolt változtatást.
- Alkalmazd azokat a változtatásokat, amiket elfogadtál. Közvetlenül a jegyzetfüzetbe íródnak.
- Csatold a notebookot szerver nélküli rendszerhez, és indítsd el, hogy ellenőrizd, úgy viselkedik-e, ahogy várod. Lásd : Áttelepített munkaterhelés ellenőrzése.
Munka áthelyezése
- Nyisd ki azt az állást, amit át akarsz költözni.
- Nyisd meg a Genie Code-ot, és futtasd a
/parancspalettán a/compute migrate to serverlessparancsot. - Az ügynök klónozza a munkádat, és megpróbálja átmigrálni a klónozott munkát szerver nélküli állapotba.
- Nézze át az ügynök megállapításait. Többfeladatos feladat esetén az ügynök felsorolja az összes feladatot és annak feladatonkénti klaszterkonfigurációját, és mindegyikhez változtatásokat javasol, miközben megőrzi a munka ütemezését.
- Fogadjon el vagy utasítson el minden javasolt módosítást a migráció teljes terjedelmében: a környezetet és a könyvtárakat, a Spark-konfigurációkat, valamint minden olyan munkaterhelési kódot, amelyet módosítani kell.
- Alkalmazd azokat a változtatásokat, amiket elfogadtál. A munka számítása szerver nélküli állapotba kerül.
- Futtasd a feladatot szerver nélküli környezetben, és ellenőrizd az eredményeket. Lásd : Áttelepített munkaterhelés ellenőrzése.
- Opcionálisan, utolsó lépésként az ügynök előhívja a migrált klónt. Visszamásolja a klón konfigurációját és jegyzetfüzeteit az eredeti feladatodra (ugyanaz a munkaazonosító, ütemezés és jogosultságok megmaradása), majd törli a klónt. Ha kihagyod a léptetést, és mindkét feladatot megtartod, szüneteltesd az ütemezést annál a feladatnál, amelyiket épp nem futtatod, különben ugyanaz az eseményindító mindkettőt elindíthatja, és duplikált írási műveleteket vagy egyéb mellékhatásokat okozhat.
Ellenőrizd a migrált munkaterhelést
Az ügynök javaslatokat tesz és alkalmaz változtatásokat, de nem futtatja a munkaterhelést vagy nem ellenőrzi annak kimenetét. Mindig futtass egy migrált munkaterhelést szerver nélkül, és ellenőrizd az eredményeket, mielőtt rá támaszkodnál, különösen olyan munkaterheléseknél, amelyek termelési táblákba írnak. Ha az ügynök olyan változtatást javasol, ami rossznak tűnik, utasítsa el, és küldjön visszajelzést, hogy javíthassuk az ügynököt. Lásd: Termékvisszajelzés küldése.
Tip
Miközben egy migrált munkaterhelést validálsz, futtasd teljesítményoptimalizált módban. Gyorsabban indul, mint a standard mód, így gyorsabb visszajelzést kapsz, amikor megerősíted az eredményeket. Válts arra a módra, ami a legjobban illik a munkaterheléshez, mielőtt gyártásban futtatnád. Lásd: Teljesítménymód kiválasztása.
Ha az ügynök olyasmit talál, amit nem tud biztonságosan migrálni, blokkoló problémát jelez, és alapértelmezés szerint leáll. Kifejezetten utasíthatod arra, hogy túllépjen bizonyos kompatibilitási vagy függőségi akadályokon, de ezzel vállalod annak kockázatát, hogy ezek a függőségek, a költséghozzárendelés vagy a futásidejű viselkedés nem vihetők át, és a munkaterhelés szerver nélküli környezetben meghiúsulhat.
Migrációs változások visszafordítása
Az ügynök által alkalmazott változtatások visszafordíthatók.
Jegyzetfüzetek esetén nyisd ki, és állítsd vissza a migráció előtti verziót. Tekintse meg a Databricks-jegyzetfüzetek verzióelőzményeit.
Egy feladatnál, ha nem népszerűsítetted a migrált klónt, az eredeti feladatod soha nem változott: futtasd úgy, mint korábban, és töröld a klónt. Ha előléptetted a klónt, állítsd vissza abból a biztonsági mentésből, amelyet az ügynök írt, mielőtt bármilyen módosítást végrehajtott volna:
- Nyisd meg a biztonsági mentést a munkaterületed otthonában:
/Workspace/Users/<your-username>/serverless-migration/backups/job-<job-id>/<timestamp>/. Az ügynök ezt az útvonalat a migráció során mutatta. Ha több időbélyeg van, válaszd ki a közvetlenül a migráció előtti időbélyeget. - Nyisd meg a(z)
job.yamlelemet, amely a migráció előtti feladatbeállításokat tartalmazza, majd alkalmazd ezeket a beállításokat ismét ugyanarra a feladatra egyPOST /api/2.2/jobs/resetkéréssel, amely felülírja a feladat beállításait az általad megadott beállításokkal. Be is illesztheted őket a munkakör JSON definíciójába a felhasználói felületen. Ez visszaállítja a munkát a klasszikus számításra. - Nyisd meg a
mapping.yamlelemet, amely felsorolja az összes biztonsági mentésből származó fájlt és az eredeti elérési utat, ahonnan származnak. Másold le minden biztonsági mentési fájlt az eredeti útvonalára, hogy visszafordítsd a kód újraírásait. - Futtasd a feladatot, hogy ellenőrizd, ugyanúgy viselkedik-e, mint a migrálás előtt.
A migráció soha nem törli ezt a biztonsági mentést. Az ügynök által nem módosított feladatok, például a Gitből származó, SQL- vagy dbt-feladatok, a job.yaml elemben vannak rögzítve, de a fájljaik nem kerülnek be a biztonsági mentésbe, ezért szükség esetén az elsődleges forrásból állítsa vissza őket.
Ismert korlátozások
- A következők blokkoló tényezőként vannak jelentve: egyéni lemezképek, ML Runtime-változatok, a 13-asnál korábbi Databricks Runtime-verziók, olyan Spark-konfigurációk, amelyek serverless környezetben nem hagyhatók figyelmen kívül biztonságosan, valamint olyan függőségek, mint az egg-csomagok, a JAR-fájlok és a Maven-kódtárak. A blokkoló azt jelenti, hogy az ügynök megáll, ahelyett, hogy áthelyezné az adott tárgyat. Vagy magad oldhatod meg és újra futtathatod a migrációt, vagy mégis megmondhatod az ügynöknek, hogy migráljon, így az adott elem megoldatlanul marad, és a munkaterhelés szerver nélküli állapotban meghibásodhat.
- Az ügynök az init szkripteket olvassa fel, amelyek a munkaterületi fájlokban vagy Unity Catalog kötetekben tárolódnak. Az ABFSS-ben vagy DBFS-ben tárolt init szkriptek nem olvashatók, és blokkolóként jelentették őket.
- Az ügynök nem vizsgálja meg minden klasszikus számítási attribútumot. A klaszter napló szállítása és az SSH kulcsok nincsenek modellezve, és bár sok DBFS mount függőséget észlel a munkaterhelés kódból, nem sorolja fel vagy oldja fel minden mountot.
- A gyorsítótár- és ellenőrzőponti API-k, a globális ideiglenes nézetek, a DBFS csatoláskezelési hívások, valamint a Scala- vagy R-kód alapértelmezés szerint kizáró oknak számítanak. Utasítást adhatsz az ügynöknek, hogy folytassa, de a megoldatlan funkció változatlan marad, és szerver nélküli állapotban meghibásodhat.
- Olyan munkák, amelyek több mint 10 migrálható feladatot tartalmaznak, jelenleg nem migrálhatók.
- Az ügynök egyszerre egy munkaterhelést migrál. Nincs flottaszintű felderítés, tömeges migráció vagy adminisztratív jóváhagyási munkafolyamat.
- Az ügynök módosításokat javasol, és alkalmazza az általad elfogadottakat, de nem hajtja végre a feladataidat, és nem ellenőrzi az eredmény helyességét. Ellenőrizd a migrált munkaterhelést, mielőtt rá támaszkodnál a termelési adatokhoz.
- Ha a munkaterhelés forrása egy Databricks Asset Bundle vagy egy Git-mappa, az ügynök helyben módosítja a munkaterületi objektumot. Egyeztetd össze ezeket a változtatásokat a csomagoddal vagy a tárolóddal, hogy egy későbbi telepítés ne írja felül a migrációt.
Migráció szerver nélküli formátumra manuálisan
A számítási feladatok klasszikus számításból kiszolgáló nélküli számításba való migrálásához kövesse az alábbi lépéseket:
- Ellenőrizze az előfeltételeket: Ellenőrizze, hogy a munkaterület, a hálózatkezelés és a felhőbeli tárterület hozzáférése megfelel-e a követelményeknek. Lásd: Előfeltételek.
- Kód frissítése: Végezze el a szükséges kód- és konfigurációmódosításokat. Lásd : A kód frissítése.
- Terhelések tesztelése: Ellenőrizze a kompatibilitást és a helyességet az átállás előtt. Lásd Az ön munkaterheléseinek tesztelése.
- Teljesítmény mód kiválasztása: Válassza ki a számítási feladatokra vonatkozó követelményeknek leginkább megfelelő teljesítmény módot. Lásd: Teljesítménymód kiválasztása.
- Migrálás fázisokban: Kiszolgáló nélküli üzembe helyezése növekményesen, új és alacsony kockázatú számítási feladatoktól kezdve. Lásd : Migrálás fázisokban.
- Költségek monitorozása: A kiszolgáló nélküli DBU-használat nyomon követése és riasztások beállítása. Lásd: Költségek monitorozása.
Prerequisites
A migrálás megkezdése előtt előfordulhat, hogy frissítenie kell néhány régi konfigurációt a munkaterületen.
| Előfeltétel | Action | Részletek |
|---|---|---|
| A munkaterület engedélyezve van a Unity Catalog használatára. | Szükség esetén migrálás a Hive Metastore-ból | A Unity Cataloghoz Azure Databricks munkaterület hozzáadása |
| Hálózatkezelés konfigurálva | VPC peering lecserélése hálózati központokra, Private Link vagy tűzfalszabályokra | Kiszolgáló nélküli számításisík-hálózatkezelés |
| Felhőbeli tárterület-hozzáférés | Régi adathozzáférési minták cseréje a Unity Catalog külső helyeivel | Csatlakozás a felhőalapú objektumtárolóhoz a Unity Catalog használatával |
Ellenőrizze, hogy a munkaterület támogatott régióban van-e.
A kód frissítése
Az alábbi szakaszok felsorolják a számítási feladatok kiszolgáló nélküli kompatibilitásához szükséges kódot és konfigurációs módosításokat.
Az adatok elérése
Az örökölt adathozzáférési minták kiszolgáló nélküli rendszereken nem támogatottak. Frissítse a kódot a Unity Catalog használatára.
| Klasszikus minta | Kiszolgáló nélküli csere | Részletek |
|---|---|---|
DBFS elérési utak (dbfs:/...) |
Unity Catalog-kötetek | Mik azok a Unity Catalog-kötetek? |
| Hive Metastore-táblák | Unity Catalog táblák (vagy HMS szövetség) | A Unity Cataloghoz Azure Databricks munkaterület hozzáadása |
| Tárfiók hitelesítő adatai | Unity Catalog külső helyek | Csatlakozás a felhőalapú objektumtárolóhoz a Unity Catalog használatával |
| Egyéni JDBC-JAR-ok | Lakehouse Szövetség | Mi az a lekérdezési összevonás? |
Figyelmeztetés
A DBFS-hozzáférés kiszolgáló nélküli eszközökön korlátozott. A migrálás előtt frissítse a Unity Catalog-kötetek összes dbfs:/ elérési útját. További információ: DbFS-ben tárolt fájlok migrálása.
Példa: DBFS-elérési utak és Hive Metastore-hivatkozások cseréje
# Classic
df = spark.read.csv("dbfs:/mnt/datalake/data.csv", header=True)
df.write.parquet("dbfs:/mnt/output/results")
df = spark.table("my_database.my_table")

# Serverless
df = spark.read.csv("/Volumes/main/sales/raw_data/data.csv", header=True)
df.write.parquet("/Volumes/main/analytics/output/results")
df = spark.table("main.my_database.my_table")  # three-level namespace
API-k és kód
Bizonyos API-k és kódminták nem támogatottak a kiszolgáló nélküli eszközökön. Erre a táblára hivatkozva megállapíthatja, hogy frissíteni kell-e a kódot.
| Klasszikus minta | Kiszolgáló nélküli csere | Részletek |
|---|---|---|
RDD API-k (sc.parallelize, rdd.map) |
DataFrame API-k | A Spark Connect és a Klasszikus Spark összehasonlítása |
spark.sparkContext, sqlContext |
Használja közvetlenül a spark (SparkSession)-t |
A Spark Connect és a Klasszikus Spark összehasonlítása |
Hive változók (${var}) |
SQL DECLARE VARIABLE vagy Python f-stringek |
DECLARE VARIABLE |
| Nem támogatott Spark-konfigurációk | Távolítsa el a nem támogatott konfigurációkat. Kiszolgáló nélküli automatikusan hangolja a legtöbb beállítást. | Spark-tulajdonságok konfigurálása kiszolgáló nélküli jegyzetfüzetekhez és feladatokhoz |
Példa: RDD-műveletek cseréje DataFrame-ekre
from pyspark.sql import functions as F

# sc.parallelize + rdd.map
# Classic:  rdd = sc.parallelize([1, 2, 3]); rdd.map(lambda x: x * 2).collect()
df = spark.createDataFrame([(1,), (2,), (3,)], ["value"])
result = df.select((F.col("value") * 2).alias("value")).collect()

# rdd.flatMap
# Classic:  sc.parallelize(["hello world"]).flatMap(lambda l: l.split(" ")).collect()
df = spark.createDataFrame([("hello world",)], ["line"])
words = df.select(F.explode(F.split("line", " ")).alias("word")).collect()

# rdd.groupByKey
# Classic:  rdd.groupByKey().mapValues(list).collect()
df = spark.createDataFrame([("a", 1), ("b", 2), ("a", 3)], ["key", "value"])
grouped = df.groupBy("key").agg(F.collect_list("value").alias("values")).collect()

# rdd.mapPartitions → applyInPandas
import pandas as pd
def process_group(pdf: pd.DataFrame) -> pd.DataFrame:
    return pd.DataFrame({"total": [pdf["id"].sum()]})
result = (spark.range(100).repartition(4)
    .groupBy(F.spark_partition_id())
    .applyInPandas(process_group, schema="total long").collect())

# sc.textFile → spark.read.text
df = spark.read.text("/Volumes/catalog/schema/volume/file.txt")
Példa: SparkContext API-k cseréje
from pyspark.sql.functions import broadcast

# sc.broadcast → broadcast join
result = main_df.join(broadcast(lookup_df), "key")

# sc.accumulator → DataFrame aggregation
total = df.agg(F.sum("amount")).collect()[0][0]

# sqlContext.sql → spark.sql
result = spark.sql("SELECT * FROM main.db.table")
SQL viselkedési különbségek
A kiszolgáló nélküli számítási környezet alapértelmezés szerint engedélyezi az ANSI módot. A Databricks Runtime alapértelmezés szerint engedélyezi az ANSI módot a 17.0-s és újabb verziókban. Ha a klasszikus számítási környezeted korábbi verziót futtat, egyes, ott sikeresen lefutó lekérdezések serverless környezetben futásidejű hibával meghiúsulnak.
A migrációs eszköz automatikusan módosítja a kódot az ANSI mód szerinti működéshez. Ha manuálisan migrálsz, nézd át az alábbi műveleteket, amelyek viselkedése leggyakrabban változik meg:
| Művelet | Klasszikus számítás kikapcsolt ANSI móddal | Kiszolgáló nélküli számítás |
|---|---|---|
Érvénytelen típuskonverzió, mint például CAST('abc' AS INT) |
Visszatér NULL |
Kiváltja a CAST_INVALID_INPUT hibát |
| Egész túlcsordulás | Körbeteker. Például a 2147483647 + 1-2147483648 értéket ad vissza. |
Kiváltja a(z) ARITHMETIC_OVERFLOW hibát |
| Tizedes aritmetikai túlcsordulás | Visszatér NULL |
Kiváltja a(z) NUMERIC_VALUE_OUT_OF_RANGE hibát |
| Osztás nullával | Visszatér NULL |
Kiváltja a DIVIDE_BY_ZERO hibát |
| Hibás URL parse_url | Visszatér NULL |
Fizetésemelések INVALID_URL |
Ahhoz, hogy NULL értékkel térjen vissza hiba előidézése helyett, cserélje le a műveletet annak try_* megfelelőjére, például try_cast, try_add, try_divide vagy try_parse_url. A Databricks ezt a megközelítést javasolja az ANSI mód kikapcsolása helyett, mert az ANSI mód olyan adatminőségi problémákat hoz felszínre, amelyeket a néma NULL elrejt.
Az ANSI mód kikapcsolásához a típusátalakítások, az aritmetika és az elemzés esetén állítsa a spark.sql.ansi.enabled értékét false értékre. A serverless compute ANSI-szabályokat alkalmaz az implicit castokra a táblába történő beszúrásoknál ettől a beállítástól függetlenül, mert a(z) spark.sql.storeAssignmentPolicy serverless compute esetén nem módosítható. Az ANSI viselkedés teljes leírását lásd itt: ANSI-megfelelőség a Databricks Runtime-ban.
Könyvtárak és környezetek
A tárakat és környezeteket a munkaterület szintjén alapkörnyezetekkel , a jegyzetfüzet szintjén pedig a jegyzetfüzet kiszolgáló nélküli környezetével kezelheti.
| Klasszikus minta | Kiszolgáló nélküli csere | Részletek |
|---|---|---|
| Inicializáló szkriptek | Kiszolgáló nélküli környezetek | A szervermentes környezet konfigurálása |
| Fürt hatókörű könyvtárak | Jegyzetfüzet-hatókörű vagy környezeti könyvtárak | A szervermentes környezet konfigurálása |
| Maven-/JAR-kódtárak | JAR-feladat támogatása feladatokhoz; PyPI jegyzetfüzetekhez | JAR-feladat munkákhoz |
| Docker-tárolók | Kiszolgáló nélküli környezetek könyvtári igényekhez | A szervermentes környezet konfigurálása |
Python csomagok rögzítése requirements.txt reprodukálható környezetekben. Lásd: Specify Python csomagverziók.
Online közvetítés
A streamelési számítási feladatok kiszolgáló nélküli eszközökön támogatottak, de bizonyos eseményindítók nem támogatottak. Frissítse a kódot a támogatott eseményindítók használatára.
| Spark-eseményindító | Támogatott | Jegyzetek |
|---|---|---|
Trigger.AvailableNow() |
Igen | Ajánlott |
Trigger.Once() |
Igen | Ez elavult. A Trigger.AvailableNow() használható helyette. |
Trigger.ProcessingTime(interval) |
No | Visszatér INFINITE_STREAMING_TRIGGER_NOT_SUPPORTED |
Trigger.Continuous(interval) |
No | Használja helyette a Lakeflow-folyamatok folyamatos módját |
Alapértelmezett (nincs beállítás .trigger()) |
No |
.trigger() kihagyása alapértelmezettként ProcessingTime("0 seconds")-t eredményez, ami nem támogatott, amikor kiszolgáló nélküli megoldásokról van szó. Mindig explicit módon állítsa be .trigger(availableNow=True) . |
Folyamatos streamelés esetén migráljon a Spark deklaratív folyamatokhoz folyamatos módban, vagy használjon folyamatos ütemezésű feladatokat a AvailableNow használatával. Nagy források esetén állítsa be a maxFilesPerTrigger vagy maxBytesPerTrigger értékét a memóriahiány okozta hibák elkerülése érdekében.
Példa: Streamelési eseményindítók javítása
# Classic (not supported on serverless — default trigger is ProcessingTime)
query = df.writeStream.format("delta").outputMode("append").start()

# Serverless (explicit AvailableNow trigger)
query = (df.writeStream.format("delta").outputMode("append")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
query.awaitTermination()

# With OOM prevention for large sources
query = (spark.readStream.format("delta")
    .option("maxFilesPerTrigger", 100)
    .option("maxBytesPerTrigger", "10g")
    .load(input_path)
    .writeStream.format("delta")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
Tesztelje a munkaterheléseit
- Gyors kompatibilitási teszt: Futtassa a munkaterhelést klasszikus számítási infrastruktúrán Standard hozzáférési módban és Databricks Runtime 14.3 vagy újabb verzióval. Ha a futtatás sikeres, a számítási feladat kódmódosítások nélkül, kiszolgáló nélkülire migrálható.
- A/B-összehasonlítás (éles környezetben ajánlott): Futtassa ugyanazt a számítási feladatot klasszikus (vezérlés) és kiszolgáló nélküli (kísérlet) rendszeren. Diff kimeneti táblák és ellenőrizze a helyességet. Iterálás, amíg a kimenetek nem egyeznek.
- Ideiglenes konfigurációk: A tesztelés során ideiglenesen beállíthatja a támogatott Spark-konfigurációkat. Távolítsa el őket, miután stabilak.
Teljesítmény mód kiválasztása
A kiszolgáló nélküli feladatok és folyamatok két teljesítménymódot támogatnak: standard és teljesítményoptimalizált. A választott teljesítménymód a számítási feladatokra vonatkozó követelményektől függ.
| Üzemmód | Availability | Induló vállalkozás | A következőkre alkalmas |
|---|---|---|---|
| Standard | Feladatok, Lakeflow-folyamatok | 4-6 perc | Költségérzékeny tétel |
| Teljesítményoptimalizált | Jegyzetfüzetek, feladatok, Lakeflow-folyamatok | Másodperc | Interaktív, késésre érzékeny |
Migrálás fázisokban
- Új számítási feladatok: Indítsa el az összes új jegyzetfüzetet és feladatot kiszolgáló nélküli gépen.
- Alacsony kockázatú számítási feladatok: PySpark-/SQL-számítási feladatok migrálása már standard hozzáférési módban és Databricks Runtime 14.3 vagy újabb verzióban.
- Összetett számítási feladatok: Kódmódosítást igénylő számítási feladatok migrálása (RDD-átírások, DBFS-frissítések, triggerjavítások).
- Fennmaradó számítási feladatok: A képességek bővülése miatt rendszeresen tekintse át azokat.
Költségek figyelése
A kiszolgáló nélküli számlázás a DBU-használaton alapul, nem a fürt üzemidején. A költségvárakozások érvényesítése reprezentatív számítási feladatokkal a nagy léptékű migrálás előtt. A kiszolgáló nélküli költségek monitorozására szolgáló eszközökről és stratégiákról a kiszolgáló nélküli számítás költségeinek figyelése című témakörben olvashat.
További erőforrások
- Ajánlott eljárások kiszolgáló nélküli számításhoz: Optimalizálási tippek kiszolgáló nélküli számítási feladatokhoz
- Kiszolgáló nélküli számítási korlátozások: Az aktuális korlátozások és a nem támogatott funkciók teljes listája
- A kiszolgáló nélküli környezet konfigurálása: Kódtárak és függőségek kezelése
- Támogatott Spark-konfigurációk: Kiszolgáló nélküli Spark-konfigurációk érhetők el
- Spark Connect és klasszikus Spark: Viselkedésbeli különbségek a kiszolgáló nélküli architektúrában
-
Cache DataFrame-ek kiszolgáló nélküli számítási környezetben: Cache DataFrame-ek a(z)
df.cache()ésdf.persist()használatával - Kiszolgáló nélküli hálózati biztonság: Hálózati adapterek, Private Link és tűzfalkonfiguráció
- Kiszolgáló nélküli számítási kibocsátási megjegyzések: Új képességek nyomon követése szállításkor
- Unity Catalog frissítési útmutató: Migrálás a Hive Metastore-ból a Unity Katalógusba
További információkért tekintse meg az alábbi blogbejegyzéseket is:
- Mi a kiszolgáló nélküli számítástechnika?: A kiszolgáló nélküli képességek és az ügyfelek eredményeinek áttekintése
- Az adatfeldolgozás fejlődése: Hogyan alakítja át a kiszolgáló nélküli számítás a jegyzetfüzeteket és a Lakeflow-feladatokat: Hogyan működteti a kiszolgáló nélküli a Lakeflow-feladatokat és -folyamatokat?