Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
Az adatelemzésben a visszatöltés az előzményadatok visszamenőleges feldolgozásának folyamatát jelenti egy olyan adatfolyamon keresztül, amely az aktuális vagy streamelt adatok feldolgozására lett kialakítva.
Ez általában egy külön folyamat, amely adatokat küld a meglévő táblákba. Az alábbi ábrán egy visszatöltési folyamat látható, amely történeti adatokat küld a folyamat bronztábláinak.
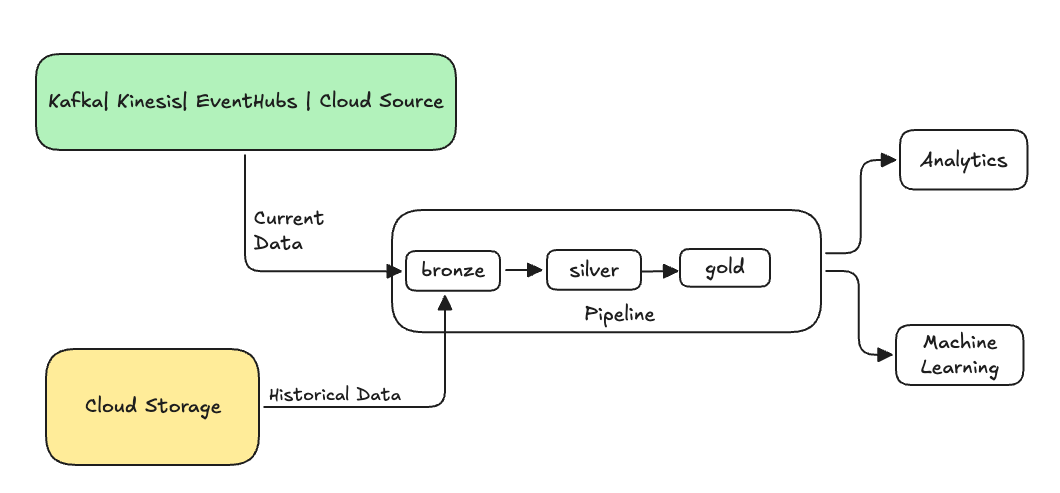
Egyes forgatókönyvek, amelyekhez szükség lehet a visszatöltésre:
- Régi rendszer előzményadatainak feldolgozása gépi tanulási (ML-) modellek betanítása vagy korábbi trendelemzési irányítópult létrehozása érdekében.
- Az adatok egy részhalmazának újrafeldolgozása a felsőbb rétegbeli adatforrásokkal kapcsolatos adatminőségi probléma miatt.
- Az üzleti követelmények megváltoztak, és az adatokat egy másik, a kezdeti folyamat által nem lefedett időszakra kell feltöltenie.
- Az üzleti logika megváltozott, és újra kell dolgoznia az előzményadatokat és az aktuális adatokat is.
A visszatöltési folyamat, amit használsz, a céltáblától és a forrás adataitól függ. Lassan AUTO CDC változó dimenziójú (SCD) 1-es típusú célpont esetén, elsődleges forrást tükröző pillanatképpel használjunk egyszeri AUTO CDC FROM SNAPSHOT folyamatot. SCD migrációhoz, amely visszajátszja a történelmi változásokat, használj egyszeri AUTO CDC folyamatot.
Csak csatolásra vonatkozó visszatöltésekhez: Használj speciális append flow-t, a ONCE opcióval tölts vissza egy csak hozzáfűzhető streaming táblát. A append_flow vagy a CREATE FLOW (csővezetékek) című témakörben találhat további információt a ONCE beállításról.
Szempontok az előzményadatok streamelési táblába való feltöltésekor
- Általában fűzze hozzá az adatokat a bronz streamelési táblához. A következő ezüst- és aranyrétegek átveszik az új adatokat a bronzrétegből.
- Győződjön meg arról, hogy a folyamat képes a duplikált adatok kezelésére, ha ugyanazokat az adatokat többször fűzik hozzá.
- Győződjön meg arról, hogy az előzményadat-séma kompatibilis az aktuális adatsémával.
- Vegye figyelembe az adatmennyiség méretét és a szükséges feldolgozási szolgáltatásszint-megállapodást (SLA), és ennek megfelelően konfigurálja a klaszter- és batchméreteket.
Példa: Utólagos feltöltés hozzáadása egy meglévő folyamathoz
Ebben a példában tegyük fel, hogy van egy folyamat, amely nyers eseményregisztrációs adatokat használ fel egy felhőbeli tárolóforrásból 2025. január 01-től. Később rájössz, hogy az előző három év historikus adatait szeretnéd visszatölteni a további jelentéskészítési és elemzési célokra. Minden adat egy helyen található, év, hónap és nap szerint particionált JSON formátumban.
Kezdeti folyamat
Itt látható a kezdő folyamat kódja, amely növekményesen betölti a nyers eseményregisztrációs adatokat a felhőbeli tárolóból.
Python
from pyspark import pipelines as dp

source_root_path = spark.conf.get("registration_events_source_root_path")
begin_year = spark.conf.get("begin_year")
incremental_load_path = f"{source_root_path}/*/*/*"

# create a streaming table and the default flow to ingest streaming events
@dp.table(name="registration_events_raw", comment="Raw registration events")
def ingest():
    return (
        spark
        .readStream
        .format("cloudFiles")
        .option("cloudFiles.format", "json")
        .option("cloudFiles.inferColumnTypes", "true")
        .option("cloudFiles.maxFilesPerTrigger", 100)
        .option("cloudFiles.schemaEvolutionMode", "addNewColumns")
        .option("modifiedAfter", "2025-01-01T00:00:00.000+00:00")
        .load(incremental_load_path)
        .where(f"year(timestamp) >= {begin_year}") # safeguard to not process data before begin_year
    )
SQL
-- create a streaming table and the default flow to ingest streaming events
CREATE OR REFRESH STREAMING LIVE TABLE registration_events_raw AS
SELECT * FROM read_files(
  "/Volumes/gc/demo/apps_raw/event_registration/*/*/*",
  format => "json",
  inferColumnTypes => true,
  maxFilesPerTrigger => 100,
  schemaEvolutionMode => "addNewColumns",
  modifiedAfter => "2024-12-31T23:59:59.999+00:00"
)
WHERE year(timestamp) >= '2025'; -- safeguard to not process data before begin_year
Itt az modifiedAfter Automatikus betöltő lehetőséget használjuk annak biztosítására, hogy nem dolgozzuk fel a felhőbeli tárolási útvonal összes adatát. A növekményes feldolgozás ezen a határon le van vágva.
Jótanács
Más adatforrások, például a Kafka, a Kinesis és az Azure Event Hubs azonos olvasói lehetőségekkel rendelkeznek ugyanahhoz a viselkedéshez.
Előző 3 év adatainak feltöltése
Most egy vagy több folyamatot szeretne hozzáadni a korábbi adatok visszatöltéséhez. Ebben a példában hajtsa végre a következő lépéseket:
- Használja a
append oncefolyamatot. Ez egyszeri visszatöltést hajt végre, és nem fut tovább az első visszatöltés után. A kód a csővezetékben marad, és ha a csővezeték teljes mértékben frissül, a visszatöltés újra lefut. - Hozzon létre három visszatöltési folyamatot, egyet minden évben (ebben az esetben az adatok év szerint oszlanak meg az elérési úton). Python esetén paraméterezzük a folyamatok létrehozását, az SQL-ben azonban háromszor megismételjük a kódot, minden egyes folyamat esetében egyszer.
Ha a saját projektjén dolgozik, és nem kiszolgáló nélküli számítást használ, érdemes lehet frissítenie a folyamat maximális feldolgozóját. A maximális feldolgozók számának növelése biztosítja, hogy rendelkezik az előzményadatok feldolgozásához szükséges erőforrásokkal, miközben továbbra is feldolgozza az aktuális streamelési adatokat a várt SLA-on belül.
Jótanács
Ha kiszolgáló nélküli számítást használ továbbfejlesztett automatikus skálázással (alapértelmezés szerint), akkor a fürt mérete a terhelés növekedésekor automatikusan nő.
Python
from pyspark import pipelines as dp

source_root_path = spark.conf.get("registration_events_source_root_path")
begin_year = spark.conf.get("begin_year")
backfill_years = spark.conf.get("backfill_years") # e.g. "2024,2023,2022"
incremental_load_path = f"{source_root_path}/*/*/*"

# meta programming to create append once flow for a given year (called later)
def setup_backfill_flow(year):
    backfill_path = f"{source_root_path}/year={year}/*/*"
    @dp.append_flow(
        target="registration_events_raw",
        once=True,
        name=f"flow_registration_events_raw_backfill_{year}",
        comment=f"Backfill {year} Raw registration events")
    def backfill():
        return (
            spark
            .read
            .format("json")
            .option("inferSchema", "true")
            .load(backfill_path)
        )

# create the streaming table
dp.create_streaming_table(name="registration_events_raw", comment="Raw registration events")

# append the original incremental, streaming flow
@dp.append_flow(
        target="registration_events_raw",
        name="flow_registration_events_raw_incremental",
        comment="Raw registration events")
def ingest():
    return (
        spark
        .readStream
        .format("cloudFiles")
        .option("cloudFiles.format", "json")
        .option("cloudFiles.inferColumnTypes", "true")
        .option("cloudFiles.maxFilesPerTrigger", 100)
        .option("cloudFiles.schemaEvolutionMode", "addNewColumns")
        .option("modifiedAfter", "2024-12-31T23:59:59.999+00:00")
        .load(incremental_load_path)
        .where(f"year(timestamp) >= {begin_year}")
    )

# parallelize one time multi years backfill for faster processing
# split backfill_years into array
for year in backfill_years.split(","):
    setup_backfill_flow(year) # call the previously defined append_flow for each year
SQL
-- create the streaming table
CREATE OR REFRESH STREAMING TABLE registration_events_raw;

-- append the original incremental, streaming flow
CREATE FLOW
  registration_events_raw_incremental
AS INSERT INTO
  registration_events_raw BY NAME
SELECT * FROM STREAM read_files(
  "/Volumes/gc/demo/apps_raw/event_registration/*/*/*",
  format => "json",
  inferColumnTypes => true,
  maxFilesPerTrigger => 100,
  schemaEvolutionMode => "addNewColumns",
  modifiedAfter => "2024-12-31T23:59:59.999+00:00"
)
WHERE year(timestamp) >= '2025';


-- one time backfill 2024
CREATE FLOW
  registration_events_raw_backfill_2024
AS INSERT INTO ONCE
  registration_events_raw BY NAME
SELECT * FROM read_files(
  "/Volumes/gc/demo/apps_raw/event_registration/year=2024/*/*",
  format => "json",
  inferColumnTypes => true
);

-- one time backfill 2023
CREATE FLOW
  registration_events_raw_backfill_2023
AS INSERT INTO ONCE
  registration_events_raw BY NAME
SELECT * FROM read_files(
  "/Volumes/gc/demo/apps_raw/event_registration/year=2023/*/*",
  format => "json",
  inferColumnTypes => true
);

-- one time backfill 2022
CREATE FLOW
  registration_events_raw_backfill_2022
AS INSERT INTO ONCE
  registration_events_raw BY NAME
SELECT * FROM read_files(
  "/Volumes/gc/demo/apps_raw/event_registration/year=2022/*/*",
  format => "json",
  inferColumnTypes => true
);
Ez az implementáció számos fontos mintát emel ki.
Az aggodalmak elkülönítése
- A növekményes feldolgozás független a visszatöltési műveletektől.
- Minden folyamat saját konfigurációs és optimalizálási beállításokkal rendelkezik.
- A növekményes és a visszatöltési műveletek között egyértelmű különbség van.
Szabályozott végrehajtás
-
ONCEA beállítás használatával biztosítható, hogy minden egyes visszatöltés pontosan egyszer fusson. - A visszatöltési folyamat a csővezeték gráfban marad, de a befejezés után tétlen állapotba kerül. Használatra kész, amikor automatikusan megtörténik a teljes frissítés.
- A folyamatdefinícióban egyértelmű naplózási napló található a backfill műveletekről.
Feldolgozási optimalizálás
- A nagy méretű utántöltést feloszthatja több kisebb részletre a gyorsabb vagy jobban szabályozott feldolgozás érdekében.
- A továbbfejlesztett automatikus skálázás dinamikusan módosítja a fürt méretét az aktuális fürtterhelés alapján.
Sémafejlődés
- A
schemaEvolutionMode="addNewColumns"kezelők használata zavartalanul kezeli a séma módosításait. - Konzisztens sémaértelmezés van az előzményadatok és az aktuális adatok között.
- Az új oszlopok biztonságosan kezelhetők az újabb adatokban.
Hozzáadj egy backfillt egy AUTO CDC SCD 1-es típusú táblához
Használj egy egyszeri AUTO CDC FROM SNAPSHOT folyamatot, hogy hiteles pillanatképet adj hozzá egy SCD 1-es típusú célponthoz, amely folyamatos változásadat-rögzítési (CDC) feedet is kap. A snapshot verzió és a CDC szekvenálási oszlop egy sorrendi tartományt alkot. Egy újabb CDC esemény elsőbbséget élvez a régebbi pillanatképpel szemben, míg egy újabb pillanatkép elsőbbséget élvez a régebbi CDC eseménnyel szemben.
Requirements
Mielőtt hozzáadnád a háttérfeltöltést, győződj meg róla, hogy a folyamatok megfelelnek a következő követelményeknek:
- A cél SCD Type 1-et használ.
- A célpontnak pontosan egy
AUTO CDC FROM SNAPSHOTáramlása és egy vagy több egyedi nevűAUTO CDCáramlása van. - Minden folyamat ugyanannyi kulcsot használ ugyanabban a sorrendben. A snapshot-flow kulcsneveket a kis- és nagybetűket figyelmen kívül hagyva hasonlítják össze a
AUTO CDCkulcsnevekkel. TöbbAUTO CDCfolyamatnak azonos kulcsneveket és kis- és nagybetűhasználatot kell használnia. - A snapshot verzió és minden CDC szekvenálási oszlop pontosan azonos adattípusú.
- Az
AUTO CDC FROM SNAPSHOTfolyamat nem határozza meg az elvárásokat. - A
AUTO CDCfolyamatok nem használják a(z)IGNORE NULL UPDATESelemet. Python-ban ne állítsd beignore_null_updates,ignore_null_updates_column_listvagyignore_null_updates_except_column_list. - A folyamat triggerelt módot használ. Ez a minta nem támogatja a folyamatos pipeline-eket.
Mindkét folyamattípus használhatja az SQL vagy a Python pipeline interfészt. Ugyanabban a célban keverheted az SQL és a Python flow-okat.
A pillanatképnek a forrás teljes állapotát kell képviselnie az adott verziójában. Ha a snapshotból hiányzik a célkulcs, AUTO CDC FROM SNAPSHOT a hiányt törlésként kezeli a snapshot verzióján. Egy CDC esemény egy újabb verzióval megőrzi vagy helyreállítja a kulcsot.
Adja hozzá a visszatöltést
Egyszeri pillanatkép visszatöltéséhez és a CDC események feldolgozásának folytatásához a következő lépéseket használjuk:
- Tartsd meg a meglévő céltáblát és annak
AUTO CDCfolyamatban lévő folyamatait a folyamatdefinícióban. - Határozd meg a hiteles snapshotot és annak változatát. Egy Python visszahíváshoz az első hívásnak egy pillanatképet és verziót kell visszaadnia. Csak akkor adjon vissza
None, ha legalább egy pillanatképet feldolgoztak. - Adj hozzá egy
AUTO CDC FROM SNAPSHOTflow-tonce=TruePython-ban vagyONCESQL-ben. SQL-visszatöltéshez egy meglévő célpontba foglaljon bele egyWITH VERSIONlekérdezést. EgyWITH VERSIONnélküli SQL snapshot folyamat csak egy kezdeti betöltést támogat egy üres célba. - Indíts egy kiváltott folyamatfrissítést, hogy feldolgozd a backfillt és a folyamatban lévő CDC eseményeket.
A következő példa egy meglévő Python pipeline-val kezdődik, amely fokozatosan dolgozza fel a változásokat .customers_cdc Tegyük fel, hogy már futtattad ezt a folyamatot, és feltöltötted a customers célhelyet:
from pyspark import pipelines as dp
from pyspark.sql.functions import col, expr

@dp.view
def customers_cdc():
    return (
        spark.readStream.table("main.bronze.customers_cdc")
        .withColumn("change_timestamp", col("change_timestamp").cast("timestamp"))
    )


dp.create_streaming_table("customers")

dp.create_auto_cdc_flow(
    name="customers_incremental_cdc",
    target="customers",
    source="customers_cdc",
    keys=["customer_id"],
    sequence_by=col("change_timestamp"),
    apply_as_deletes=expr("operation = 'DELETE'"),
    except_column_list=["operation", "change_timestamp"],
    stored_as_scd_type=1,
)
Ahhoz, hogy ezt a meglévő célt customers_snapshot 2025. január 1-jei állapotával visszatöltsük, add hozzá a következő kódot ugyanahhoz a csővezeték-definícióhoz. Tartsd meg a meglévő céltáblát és AUTO CDC flow-t:
from datetime import datetime, timezone
from typing import Optional, Tuple

from pyspark.sql import DataFrame

backfill_version = datetime(2025, 1, 1, tzinfo=timezone.utc)


def backfill_snapshot_and_version(
    latest_snapshot_version: Optional[datetime],
) -> Optional[Tuple[DataFrame, datetime]]:
    if latest_snapshot_version is None:
        return (spark.read.table("main.legacy.customers_snapshot"), backfill_version)
    return None


dp.create_auto_cdc_from_snapshot_flow(
    target="customers",
    source=backfill_snapshot_and_version,
    keys=["customer_id"],
    stored_as_scd_type=1,
    once=True,
)
A callbacknak az első meghívásakor vissza kell adnia egy pillanatképet és verziót. Ha None visszatér, mielőtt bármilyen pillanatkép feldolgozásra kerülne, a folyamat frissítése meghibásodik. A snapshot feldolgozása után a None visszaadása azt jelzi, hogy nincs további snapshot.
A snapshot verzió egy Python datetime, ami megfelel a Spark SQL TIMESTAMP típusnak. A meglévő AUTO CDC folyamat a(z) change_timestamp típust TIMESTAMP típusra alakítja, hogy a két szekvenciatípus pontosan egyezzen. A példa mindkét flow Python-t használja, de bármelyik flow-t definiálhatod SQL-ben, és keverheted az SQL és Python flow-okat ugyanabban a célban. Az SQL-szintaxissal kapcsolatban, beleértve a nem üres cél szükséges WITH VERSION lekérdezését is, lásd a CREATE FLOW (pipelines) címet.
Miután a snapshot flow sikeresen véglegesítődik, a következő fokozatos frissítések kihagyják azt, miközben a(z) AUTO CDC flow folytatja az új események feldolgozását.
Important
A cél teljes frissítése ismét lefuttatja az egyszeri pillanatkép-folyamatot. Tartsd elérhetővé a pillanatképet, és győződj meg róla, hogy még mindig a kívánt állapotot mutatja, mielőtt teljes frissítést végeznél.
Ez az egységes visszatöltési minta nem támogatja az SCD 2-es típusú vagy bitemporális célokat.
Példa: SCD-cél utólagos feltöltése egy migráció során
Egy gyakori migrációs forgatókönyv egy lassan változó dimenziós (SCD) tábla, amely már létezik egy régi rendszerben, amelynek évek óta gyűjtött története van, de amelynek eredeti változási beosztása már nem elérhető. Mivel az eredeti változási események eltűntek, ehelyett egyszer újrajátszod a régi tábla saját történetét az új AUTO CDC céltáblába, majd a jövőben új CDC feedet csatolsz. További információért AUTO CDC az SCD típusokról lásd : Az AUTO CDC API-k: Egyszerűsítse a változásadat-rögzítést pipelines-szal.
Ez a minta egy egyszeri AUTO CDC folyamat ugyanabba a streaming táblába, amelyet a folyamatos AUTO CDC folyamat céloz meg. A AUTO CDC cél csak AUTO CDC típusú áramlásokat fogad el, így a magnak is AUTO CDC áramlásnak kell lennie. Egy egyszerű INSERT INTO ONCE hozzáfűzési folyamat ugyanabba a táblába nem felel meg az ellenőrzésnek:
-
Hozd létre a célként szolgáló streamelési táblát, amelybe a
AUTO CDCflow ír. -
Egyszer töltse be a régi előzményeket egy
AUTO CDC ONCEolyan flow-val, amely a régi SCD táblát streamként olvassa, a legacy érvényességi kezdőoszlop szerint rendezve. Játssza le újra az örökölt sorokat változási eseményekként, ahelyett, hogy Ön maga alakítaná őket.AUTO CDClétrehozza a__START_ATés__END_ATelőzményoszlopokat egy SCD Type 2 típusú célhoz, ezért ezeket az oszlopokat ne írd közvetlenül. -
Csatlakoztasd a friss változáscsatornát olvasó, folyamatban lévő
AUTO CDCadatfolyamot.AUTO CDCkulcsonként határozza meg a sorrendet, így az átállásnak minden egyes üzleti kulcs esetében külön-külön kell megtörténnie: minden kulcs első éles módosításának az ugyanahhoz a kulcshoz tartozó utolsó betöltött módosítás utánra kell kerülnie. Egy olyan sorozatérték, amely csupán nagyobb a globális korábbi maximumértéknél, egy adott kulcsnál még így is elavult lehet, ezért az adott kulcs első tényleges változása figyelmen kívül marad, vagy hibás sorrendbe kerül.
A következő kód egy streaming táblázatot hoz létre, amely a fent említett lépéseket használja:
CREATE OR REFRESH STREAMING TABLE customers_history;

-- One-time seed: replay the legacy history as change events
CREATE FLOW customers_history_seed
AS AUTO CDC ONCE INTO customers_history
FROM stream(legacy.customers_scd2)
KEYS (customer_id)
SEQUENCE BY valid_from
STORED AS SCD TYPE 2;

-- Ongoing live CDC into the same target
CREATE FLOW customers_history_cdc
AS AUTO CDC INTO customers_history
FROM stream(customers_cdc_bronze)
KEYS (customer_id)
SEQUENCE BY change_timestamp
STORED AS SCD TYPE 2;
Mindkét flow-nak egybe kell egyeznie a kulcsaiban, az SCD típusukban és a szekvenálási oszlop adattípusában. Az előző példában mindkét áramlás időbélyeg alapján sorolódik, amely egyetlen átvágási időt használ a bevetett előzmények elválasztására az élő hírfolyamtól. Ha a régi tábla más típusú értékkel szekvenál, mint az élő hírfolyam, akkor az egyiket úgy küldjük, hogy a típusok egyezzenek.
Ugyanez a felépítés működik SCD 1-es típusú cél esetén is: mindkét folyamban cseréld le a STORED AS SCD TYPE 2 elemet STORED AS SCD TYPE 1 elemre, és a cél kulcsonként csak az aktuális sort őrzi meg. Mielőtt bármelyik mintára hagyatkoznál, ellenőrizd a kulcsok egy mintáján, hogy egy előre feltöltött kulcs első éles módosítása pontosan egy új verziót eredményez-e, és megfelelően lezárja-e az előzőt. Általában itt jelenik meg kulcsonkénti szekvenálási különbség.