Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
Az adaptív lekérdezés-végrehajtás (AQE) a lekérdezések újraoptimalizálása, amely a lekérdezés végrehajtása során történik.
A futtatókörnyezet újraoptimalizálásának az a motivációja, hogy az Azure Databricks rendelkezik a legtöbb up-topontos statisztikával a shuffle és a szórásos csere (az AQE lekérdezési szakasza) végén. Ennek eredményeképpen az Azure Databricks jobb fizikai stratégiát választhat, meghatározhatja az optimális utósorrendbeli partícióméretet és -számot, vagy végezhet olyan optimalizálásokat, amelyekhez korábban tippekre volt szükség, például a ferde kapcsolatok kezelésére.
Ez nagyon hasznos lehet, ha a statisztikai adatgyűjtés nincs bekapcsolva, vagy ha a statisztikák elavultak. Olyan helyeken is hasznos, ahol a statikusan származtatott statisztikák pontatlanok, például egy bonyolult lekérdezés közepén vagy az adateltérés előfordulása után.
Képességek
Az AQE alapértelmezés szerint engedélyezve van. 4 fő funkcióval rendelkezik:
- Dinamikusan átalakítja a rendezett egyesítést szórásos hash illesztéssé.
- Dinamikusan egyesíti a partíciókat (a kis partíciókat ésszerű méretű partíciókká egyesítve) összekeverés utáni cserét követően. A nagyon kis feladatok rosszabb I/O-átviteli sebességgel rendelkeznek, és általában jobban szenvednek az ütemezési többletterheléstől és a feladatbeállítási többletterheléstől. A kis feladatok egyesítése erőforrásokat takarít meg, és javítja a fürt kapacitását.
- Dinamikusan kezeli a rendező-összevonó illesztésben és a keverő hash illesztésben a ferdeségeket úgy, hogy a ferde feladatokat nagyjából egyenlő méretű tevékenységekre osztja (és szükség esetén replikálja őket).
- Dinamikusan észleli és propagálja az üres kapcsolatokat.
Alkalmazás
Az AQE az összes olyan lekérdezésre vonatkozik, amely a következő:
- Nem streaming
- Tartalmaznia kell legalább egy adatcserét (általában összekapcsolás, összesítés vagy ablak esetén), egy al-lekérdezést vagy mindkettőt.
Nem feltétlenül minden AQE által alkalmazott lekérdezés kerül újraoptimalizálásra. Lehet, hogy az újraoptimalizálás más lekérdezési tervet hoz létre, mint a statikusan összeállított. Annak megállapításához, hogy az AQE módosította-e egy lekérdezés tervét, tekintse meg a következő, Lekérdezéstervek című szakaszt.
Lekérdezési tervek
Ez a szakasz azt ismerteti, hogyan vizsgálhatja meg a lekérdezési terveket különböző módokon.
Ebben a szakaszban:
Spark felhasználói felület
AdaptiveSparkPlan csomópont
Az AQE által alkalmazott lekérdezések egy vagy több AdaptiveSparkPlan csomópontot tartalmaznak, általában az egyes fő lekérdezések vagy allekérdezések gyökércsomópontjaként.
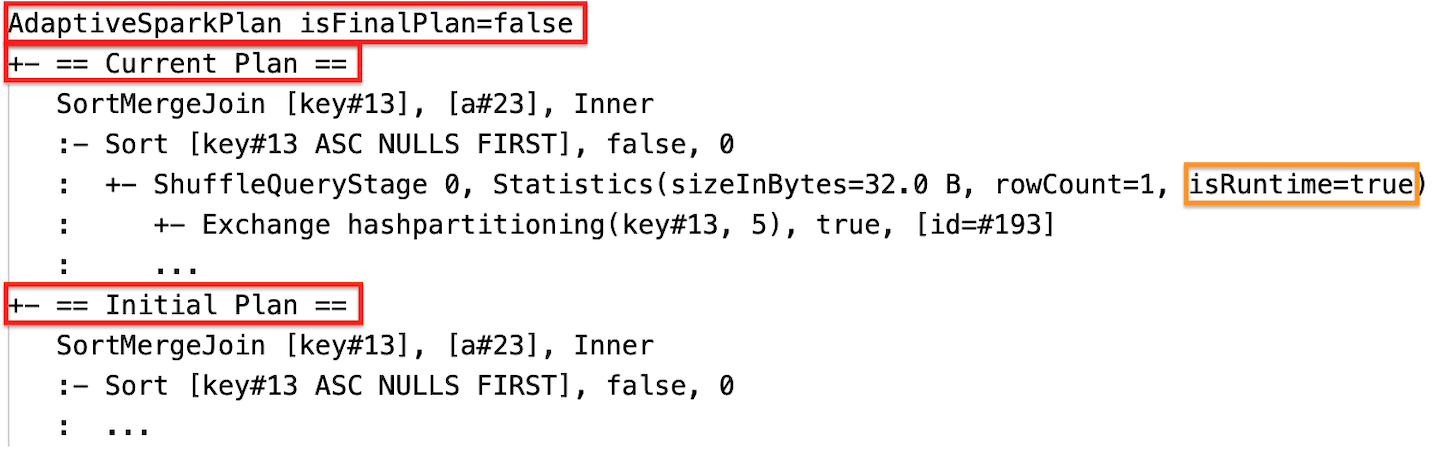
A lekérdezés futtatása előtt vagy amikor fut, a megfelelő isFinalPlan csomópont AdaptiveSparkPlan jelzője false; a lekérdezés végrehajtásának befejeződése után a isFinalPlan jelző true.-re változik.
Fejlődő terv
A lekérdezésterv diagramja a végrehajtás előrehaladtával fejlődik, és a végrehajtás alatt álló legújabb tervet tükrözi. A már végrehajtott csomópontok (amelyekben a metrikák elérhetők) nem változnak, de azok, amelyeket még nem hajtottak végre, az újraoptimalizálások eredményeként idővel változhatnak.
Az alábbiakban egy lekérdezésterv-diagramot láthat:

DataFrame.explain()
AdaptiveSparkPlan csomópont
Az AQE által alkalmazott lekérdezések egy vagy több AdaptiveSparkPlan csomópontot tartalmaznak, általában az egyes fő lekérdezések vagy allekérdezések gyökércsomópontjaként. A lekérdezés futtatása előtt vagy alatt a megfelelő isFinalPlan csomópont AdaptiveSparkPlan jelzője false; a lekérdezés végrehajtása után a isFinalPlan jelző trueváltozik.
Aktuális és kezdeti terv
Az egyes AdaptiveSparkPlan csomópontok között a kezdeti terv (az AQE-optimalizálás alkalmazása előtti terv) és az aktuális vagy a végleges terv is megjelenik attól függően, hogy a végrehajtás befejeződött-e. A jelenlegi terv a végrehajtás előrehaladtával fejlődik.
Futási statisztikák
Az egyes shuffle és broadcast fázisok adatstatisztikákat tartalmaznak.
A szakasz futtatása előtt vagy alatt a statisztikák fordítási időben becsült értékek, a jelző isRuntime pedig false, például: Statistics(sizeInBytes=1024.0 KiB, rowCount=4, isRuntime=false);
A szakasz végrehajtása után a statisztikák futásidőben kerülnek begyűjtésre, és a jelölő isRuntimetrue-re változik, például Statistics(sizeInBytes=658.1 KiB, rowCount=2.81E+4, isRuntime=true)-vé.
A következő egy DataFrame.explain példa:
A végrehajtás előtt

A végrehajtás során
A végrehajtás után

SQL EXPLAIN
AdaptiveSparkPlan csomópont
Az AQE által alkalmazott lekérdezések egy vagy több AdaptiveSparkPlan csomópontot tartalmaznak, általában az egyes fő lekérdezések vagy allekérdezések gyökércsomópontjaként.
Nincs aktuális terv
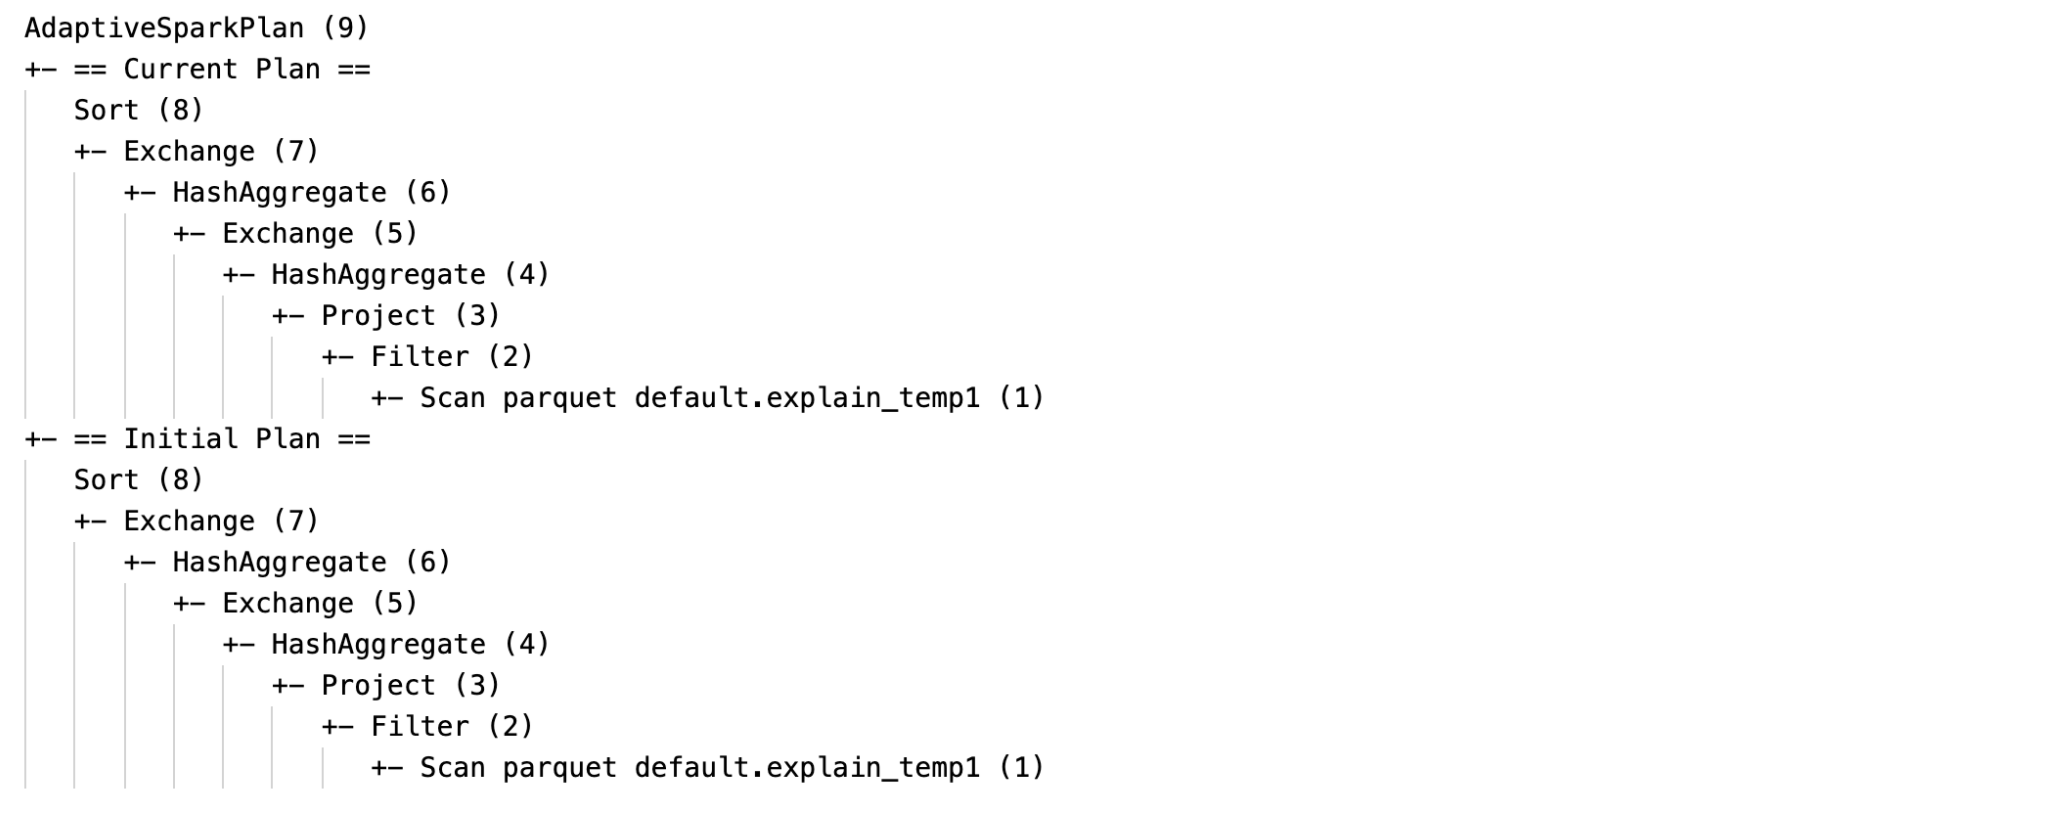
Mivel SQL EXPLAIN nem hajtja végre a lekérdezést, az aktuális terv mindig megegyezik a kezdeti tervvel, és nem tükrözi azt, amit az AQE végül végrehajtana.
Az alábbiakban egy SQL-magyarázó példát mutatunk be:
Hatásosság
A lekérdezési terv megváltozik, ha egy vagy több AQE-optimalizálás érvénybe lép. Ezeknek az AQE-optimalizálásoknak a hatását az aktuális és a végleges tervek, valamint a kezdeti terv és az aktuális és a végleges tervek konkrét tervcsomópontjai közötti különbség mutatja.
Rendezési egyesítési illesztés dinamikus módosítása szórásos kivonat illesztésre: különböző fizikai illesztési csomópontok az aktuális/végleges terv és a kezdeti terv között

Partíciók dinamikus összevonása:
CustomShuffleReadercsomópont,Coalescedtulajdonsággal.

Dinamikusan kezelje a ferde csatlakozást: a
SortMergeJoincsomópont, ahol aisSkewmező igaz.

Az üres kapcsolatok dinamikus észlelése és propagálása: a terv egy részét (vagy egészét) a LocalTableScan csomópont váltja fel üresként a relációs mezővel.


Konfiguráció
Ebben a szakaszban:
- Adaptív lekérdezésvégrehajtás engedélyezése és letiltása
- Automatikusan optimalizált shuffle engedélyezése
- Rendezéses egyesítő csatolás dinamikus módosítása szórásos kivonat csatolássá
- Partíciók dinamikus egyesítése
- A ferde illesztés dinamikus kezelése
- Üres kapcsolatok dinamikus észlelése és propagálása
Adaptív lekérdezés végrehajtásának engedélyezése és letiltása
| Ingatlan |
|---|
|
spark.databricks.optimizer.adaptive.enabled Típus: BooleanAz adaptív lekérdezések végrehajtásának engedélyezése vagy letiltása. Alapértelmezett érték: true |
Automatikusan optimalizált shuffle engedélyezése
| Ingatlan |
|---|
|
spark.sql.shuffle.partitions Típus: IntegerAz illesztések vagy aggregációk adatainak összevonásakor használandó partíciók alapértelmezett száma. Az érték auto beállítása automatikusan optimalizált shuffle-t tesz lehetővé, amely automatikusan meghatározza ezt a számot a lekérdezésterv és a lekérdezés bemeneti adatmérete alapján.Megjegyzés: Strukturált streamelés esetén ez a konfiguráció nem módosítható az azonos ellenőrzőpont-helyről származó lekérdezés-újraindítások között. Alapértelmezett érték: 200 |
A rendezési egyesítés dinamikus átalakítása szórásos hash illesztéssé
| Ingatlan |
|---|
|
spark.databricks.adaptive.autoBroadcastJoinThreshold Típus: Byte StringAz a küszöbérték, amely futásidőben a közvetítési csatlakozásra való váltást aktiválja. Alapértelmezett érték: 30MB |
Partíciók dinamikus egyesítése
| Ingatlan |
|---|
|
spark.sql.adaptive.coalescePartitions.enabled Típus: BooleanEngedélyezze vagy tiltsa le a partíciók egyesítését. Alapértelmezett érték: true |
|
spark.sql.adaptive.advisoryPartitionSizeInBytes Típus: Byte StringA célméret a szenesítés után. A szenesített partícióméretek közel lesznek a célmérethez, de nem lesznek nagyobbak ennél a célméretnél. Alapértelmezett érték: 64MB |
|
spark.sql.adaptive.coalescePartitions.minPartitionSize Típus: Byte StringA partíciók minimális mérete az összevonás után. Az egyesített partícióméretek nem lesznek kisebbek ennél a méretnél. Alapértelmezett érték: 1MB |
|
spark.sql.adaptive.coalescePartitions.minPartitionNum Típus: IntegerA partíciók minimális száma az egybeolvadás után. Nem ajánlott, mert az explicit beállítás felülbírálja. spark.sql.adaptive.coalescePartitions.minPartitionSize.Alapértelmezett érték: 2-szer a klasztermagok száma |
Ferde illesztés dinamikus kezelése
| Ingatlan |
|---|
|
spark.sql.adaptive.skewJoin.enabled Típus: BooleanAz ferde illesztés kezelésének engedélyezése vagy letiltása. Alapértelmezett érték: true |
|
spark.sql.adaptive.skewJoin.skewedPartitionFactor Típus: IntegerAz a tényező, amely a medián partícióméret szorzatával hozzájárul annak meghatározásához, hogy egy partíció ferde-e. Alapértelmezett érték: 5 |
|
spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes Típus: Byte StringEgy küszöbérték, amely hozzájárul annak meghatározásához, hogy egy partíció ferde-e. Alapértelmezett érték: 256MB |
A partíció akkor tekinthető egyenetlennek, ha (partition size > skewedPartitionFactor * median partition size) és (partition size > skewedPartitionThresholdInBytes) is true.
Üres kapcsolatok dinamikus észlelése és propagálása
| Ingatlan |
|---|
|
spark.databricks.adaptive.emptyRelationPropagation.enabled Típus: BooleanA dinamikus üres reláció propagálásának engedélyezése vagy letiltása. Alapértelmezett érték: true |
Gyakori kérdések (GYIK)
Ebben a szakaszban:
- Miért nem sugárzott az AQE egy kis összekapcsolási táblázatot?
- Érdemes-e még az AQE engedélyezése mellett is figyelembe venni a broadcast csatlakozási stratégia javaslatát?
- Mi a különbség a "skew join" hint és az AQE "skew join" optimalizálás között? Melyiket használjam?
- Miért nem módosította automatikusan az AQE az illesztés sorrendjét?
- Miért nem észlelte az AQE az adateltérést?
Miért nem közvetített az AQE egy kis összekapcsolási táblázatot?
Ha a szórásra váró kapcsolat mérete nem éri el ezt a küszöbértéket, de ennek ellenére mégsem kerül szórásra:
- Ellenőrizze az illesztés típusát. A közvetítés bizonyos illesztéstípusok esetében nem támogatott, például egy
LEFT OUTER JOINbal oldali relációja nem közvetíthető. - Az is előfordulhat, hogy a reláció sok üres partíciót tartalmaz, ebben az esetben a feladatok többsége gyorsan befejezhető a rendezési egyesítéssel, vagy potenciálisan optimalizálható a ferde illesztések kezelésével. Az AQE nem módosítja az ilyen rendezéses összekapcsolásokat broadcast hash összekapcsolásokká, ha a nem üres partíciók százalékos aránya alacsonyabb, mint
spark.sql.adaptive.nonEmptyPartitionRatioForBroadcastJoin.
Kell még használnom a broadcast összekapcsolási stratégia tippet, ha az AQE engedélyezve van?
Igen. A statikusan tervezett szórási illesztés általában hatékonyabb, mint az AQE által dinamikusan tervezett, mert az AQE csak akkor válthat szórási illesztésre, amikor már végrehajtotta az elegyítést az illesztés mindkét oldalán (ekkorra már megvannak a tényleges relációs méretek). Így a közvetítési tipp használata továbbra is jó választás lehet, ha jól ismeri a lekérdezést. Az AQE ugyanúgy fogja figyelembe venni a lekérdezési tippeket, mint a statikus optimalizálást, de továbbra is alkalmazhat dinamikus optimalizálásokat, amelyeket a tippek nem érintenek.
Mi a különbség a "skew join" hint és az AQE "skew join" optimalizálás között? Melyiket használjam?
Javasoljuk, hogy az AQE ferde illesztés kezelésére támaszkodjon a ferde illesztés tipp használata helyett, mert az AQE ferde illesztés teljesen automatikus, és általában jobban teljesít, mint a tipp megfelelője.
Miért nem módosította automatikusan az AQE az illesztés sorrendjét?
A dinamikus illesztés átrendezése nem része az AQE-nek.
Miért nem észlelte az AQE az adateltérést?
Két méretfeltételnek kell teljesülnie ahhoz, hogy az AQE ferde partícióként észleljen egy partíciót:
- A partíció mérete nagyobb, mint a
spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes(alapértelmezett 256 MB) - A partíció mérete nagyobb, mint az összes partíció medián mérete szorozva az eltolódott partíciófaktorral
spark.sql.adaptive.skewJoin.skewedPartitionFactor(alapértelmezett 5)
Ezenkívül az AQE ferdeségkezelése csak a shuffle-alapú joinműveletekre alkalmazható (sort merge joinok és shuffle hash joinok). A broadcast csatlakozásokat soha nem torzítva optimalizálják. A támogatott csatlakozások esetén a csatlakozás típusa határozza meg, melyik oldalt tudja az AQE optimalizálni:
| Illesztés típusa | Bal oldali ferdítés optimalizálva | Jobb oldali dőlés optimalizálva |
|---|---|---|
INNER |
Yes | Yes |
CROSS |
Yes | Yes |
LEFT OUTER |
Yes | No |
RIGHT OUTER |
No | Yes |
LEFT SEMI |
Yes | No |
LEFT ANTI |
Yes | No |
FULL OUTER |
No | No |
Például egy LEFT OUTER JOIN esetében csak a bal oldali eltolás optimalizálható, a FULL OUTER JOIN pedig egyik oldalon sem eltolásra optimalizált.
Örökség
Az "Adaptív végrehajtás" kifejezés a Spark 1.6 óta létezik, de a Spark 3.0 új AQE-jének alapjaiban eltér. A funkcionalitás szempontjából a Spark 1.6 csak a "dinamikusan összevonja a partíciókat" részt valósítja meg. A műszaki architektúra szempontjából az új AQE a lekérdezések futásidejű statisztikákon alapuló dinamikus tervezésének és újratervezésének keretrendszere, amely számos optimalizálást támogat, például a cikkben ismertetetteket, és kiterjeszthető a további lehetséges optimalizálás érdekében.