Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
A prioritásos feldolgozás alacsony késésű teljesítményt biztosít, a használatalapú fizetés rugalmasságával. Ebben a cikkben egy modelltelepítésen engedélyezi a prioritásos feldolgozást, ellenőrzi, hogy melyik szolgáltatási szint dolgozta fel a kéréseit, és figyelemmel kíséri a kapcsolódó költségeket.
Előfeltételek
- Egy Azure-előfizetés – Hozzon létre egyet ingyen.
- Egy Microsoft Foundry projekt egy
GlobalStandardvagyDataZoneStandardtípusú üzembe helyezett modellel. - Modellverziók
2025-12-01vagy újabb.
Kulcshasználati esetek
- Konzisztens, alacsony késés a rugalmas felhasználói élmény érdekében.
- Használatalapú fizetéses egyszerűség , hosszú távú kötelezettségvállalások nélkül.
- A skálázható, költséghatékony teljesítmény előnyeit kihasználó munkaidő alatti vagy hirtelen megugró forgalom. Igény szerint kombinálhatja a prioritás-feldolgozást a kiosztott átviteli sebességegységekkel (PTU) az állandó állapotú kapacitás és a költségoptimalizálás érdekében.
Késleltetési cél
Az alábbi táblázat felsorolja az egyes prioritási feldolgozást támogató modellek késési célértékét . A késési célérték kiszámítása p50 kérelemkésés 5 percenkénti alapon történik, és percentilis küszöbértékként van kifejezve. Például a "99% > 50 token másodpercenként (TPS)" azt jelenti, hogy a kérések 99% másodpercenként több mint 50 tokent dolgoz fel.
| Modell | Késési célérték |
|---|---|
| gpt-5.6-terra, 2026-07-09 | 99% > 70 TPS |
| gpt-5.6-sol, 2026-07-09 | 99% > 50 TPS |
| gpt-5.5, 2026-04-24 | 99% > 50 TPS |
| gpt-5.4-mini, 2026-03-17 | 99 % > 100 TPS |
| gpt-5.4, 2026-03-051 | 99% > 50 TPS |
| gpt-5.2, 2025-12-11 | 99% > 50 TPS |
| gpt-5.1, 2025-11-13 | 99% > 50 TPS |
| gpt-4.1, 2025-04-141 | 99% > 80 TPS |
1Hosszú kontextus ennél a modellnél, azaz a becslés szerint a 128 ezer prompttokent meghaladó kéréseket standard feldolgozásra minősítjük vissza, és a standard csomag díjszabása szerint számítjuk fel.
Prioritásfeldolgozás rendelkezésre állása üzembe helyezési típus szerint
A prioritásos feldolgozás engedélyezhető Globális alapértelmezett telepítésekben vagy a Data Zone alapértelmezett (US) telepítésekben. A díjszabással kapcsolatos információkért lásd a Azure OpenAI díjszabási oldalát.
Globális standard modell rendelkezésre állása
| Régió | gpt-5.6-terra, 2026-07-09 | gpt-5.6-sol, 2026-07-09 | gpt-5.5, 2026-04-24 | gpt-5.4-mini, 2026-03-17 | gpt-5.4, 2026-03-05 | gpt-5.2, 2025-12-11 | gpt-5.1, 2025-11-13 | gpt-4.1, 2025-04-14 |
|---|---|---|---|---|---|---|---|---|
| australiaeast | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| brazilsouth | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| canadacentral | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| Kelet-Kanada | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| centralus | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| eastus | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| eastus2 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| francecentral | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| Németország nyugat-közép | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| italynorth | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| japaneast | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| koreacentral | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| northcentralus | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| norwayeast | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| lengyelországcentral | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| southafricanorth | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| southcentralus | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| délkelet-ázsia | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| Dél-India | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| spaincentral | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| swedencentral | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| SvájcNorth | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| svájcnyugat | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| uaenorth | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| uksouth | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| westeurope | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| westus | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| westus3 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
Prioritás-feldolgozás engedélyezése az üzembe helyezés szintjén
A prioritás feldolgozását az üzembe helyezés szintjén és (opcionálisan) a kérés szintjén engedélyezheti.
Megjegyzés
Prioritásos feldolgozás engedélyezhető globális standard vagy Data Zone standard (USA) üzembe helyezésekben. A prioritás-feldolgozás ugyanazt a kvótát használja, mint a standard feldolgozás.
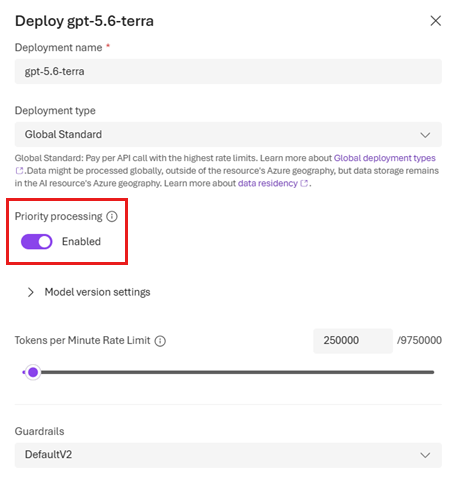
Az Microsoft Foundry portálon kapcsolja be a Priority processing kapcsolót az üzembe helyezés részleteinek lapján az üzembe helyezés létrehozásakor, vagy frissítse az üzembe helyezett modell beállítását az üzembe helyezés részleteinek szerkesztésével.
Megjegyzés
Ha inkább a kódot szeretné használni a prioritás-feldolgozás üzembe helyezési szinten való engedélyezéséhez, ezt a REST API-n keresztül teheti meg az üzembe helyezéshez az service_tier alábbi attribútum beállításával: "properties" : {"service_tier" : "priority"}. Az service_tier attribútum megengedett értékei: default és priority.
default standard feldolgozást jelent, míg priority lehetővé teszi a prioritásos feldolgozást.
Miután egy modelltelepítés prioritás-feldolgozás használatára van konfigurálva, megkezdheti a kérések küldését a modellnek.
Használati metrikák megtekintése
Az erőforrás kihasználtsági mértékét a Azure portál Azure Monitor szakaszában tekintheti meg.
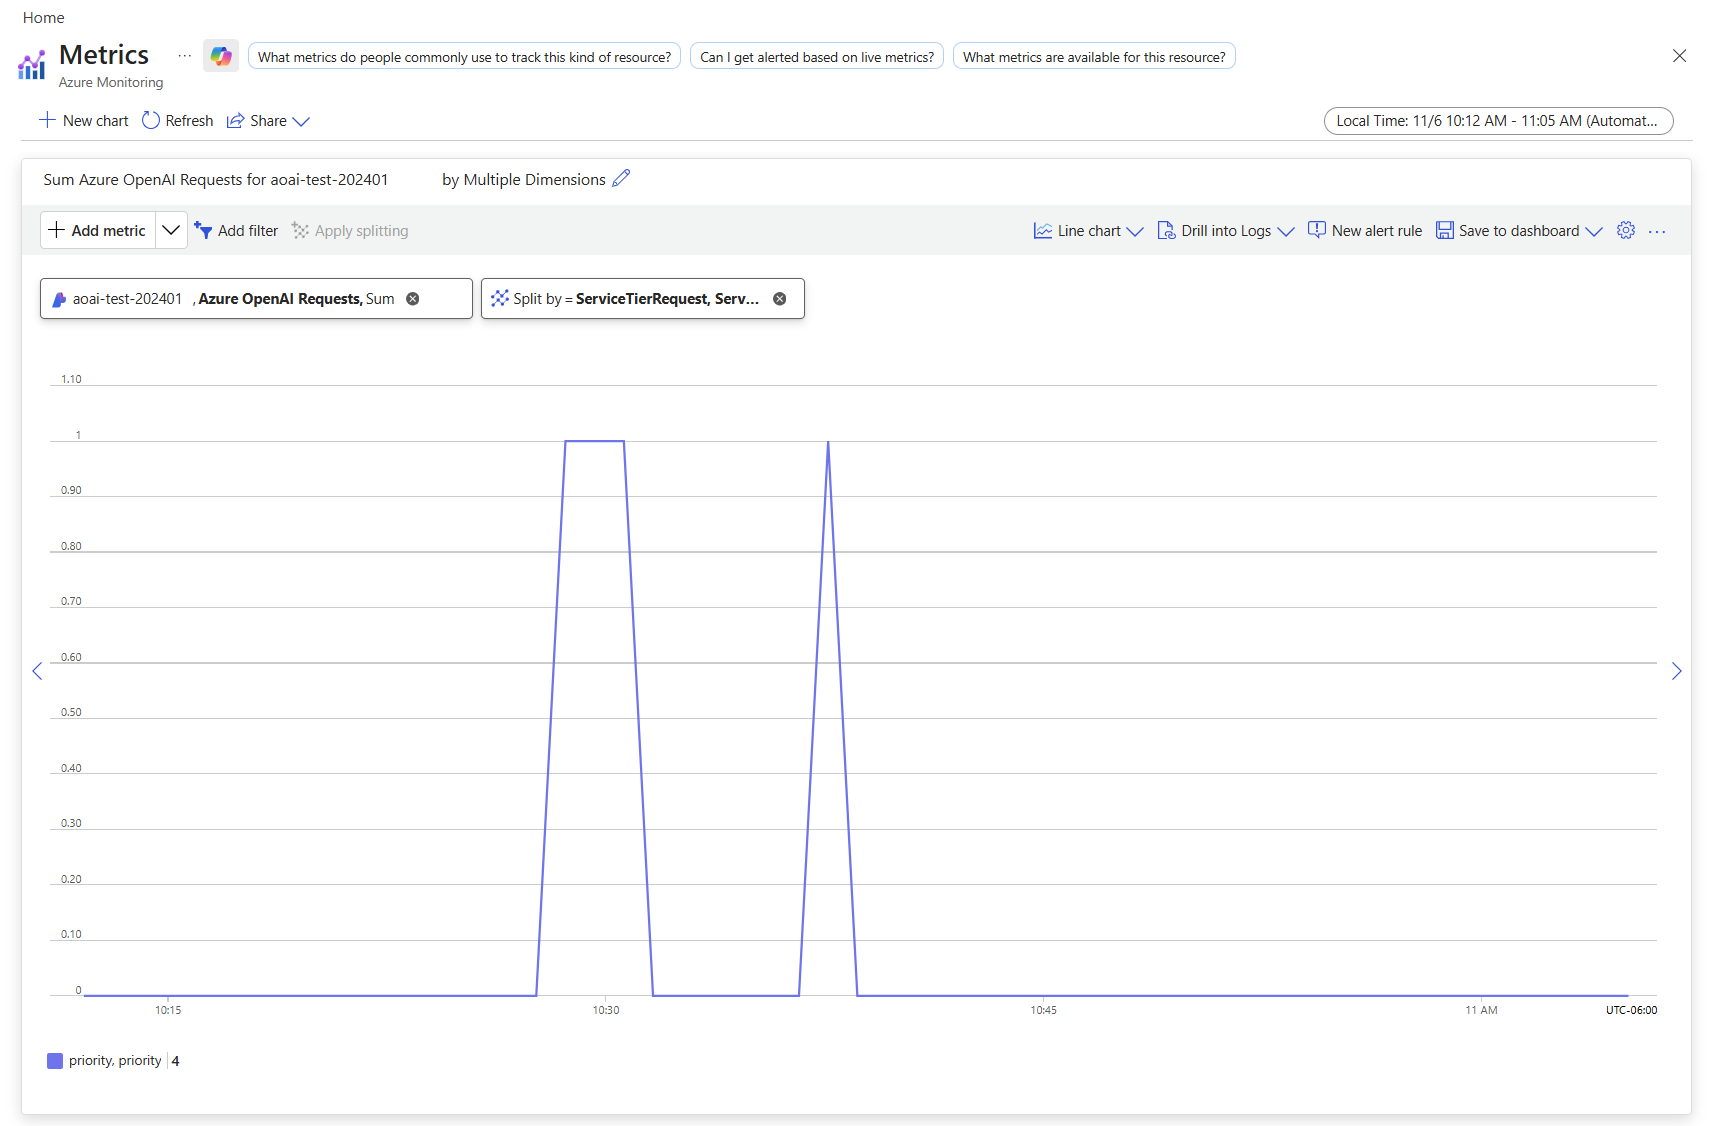
A standard feldolgozás és a prioritás feldolgozása által feldolgozott kérelmek mennyiségének megtekintéséhez ossza fel az eredeti kérelemben szereplő szolgáltatási szint (standard vagy prioritás) szerint:
- Jelentkezzen be a következőbe https://portal.azure.com: .
- Nyissa meg a Azure OpenAI-erőforrást, és válassza a Metrics lehetőséget a bal oldali navigációs sávon.
- A metrikák lapon adja hozzá a Azure OpenAI-kérelmeket metrikát. Választhat más metrikákat is, például Azure OpenAI-késés, Azure OpenAI-használat stb.
- Válassza a Szűrő hozzáadása lehetőséget annak a standard üzemelő példánynak a kiválasztásához, amelynek prioritás-feldolgozási kéréseit feldolgozták.
- Válassza a Felosztás alkalmazása lehetőséget az értékek ServiceTierRequest és ServiceTierResponse szerinti felosztásához.
Az üzemelő példányok figyelésével kapcsolatos további információt itt talál: Monitor Azure OpenAI.
Költségek figyelése
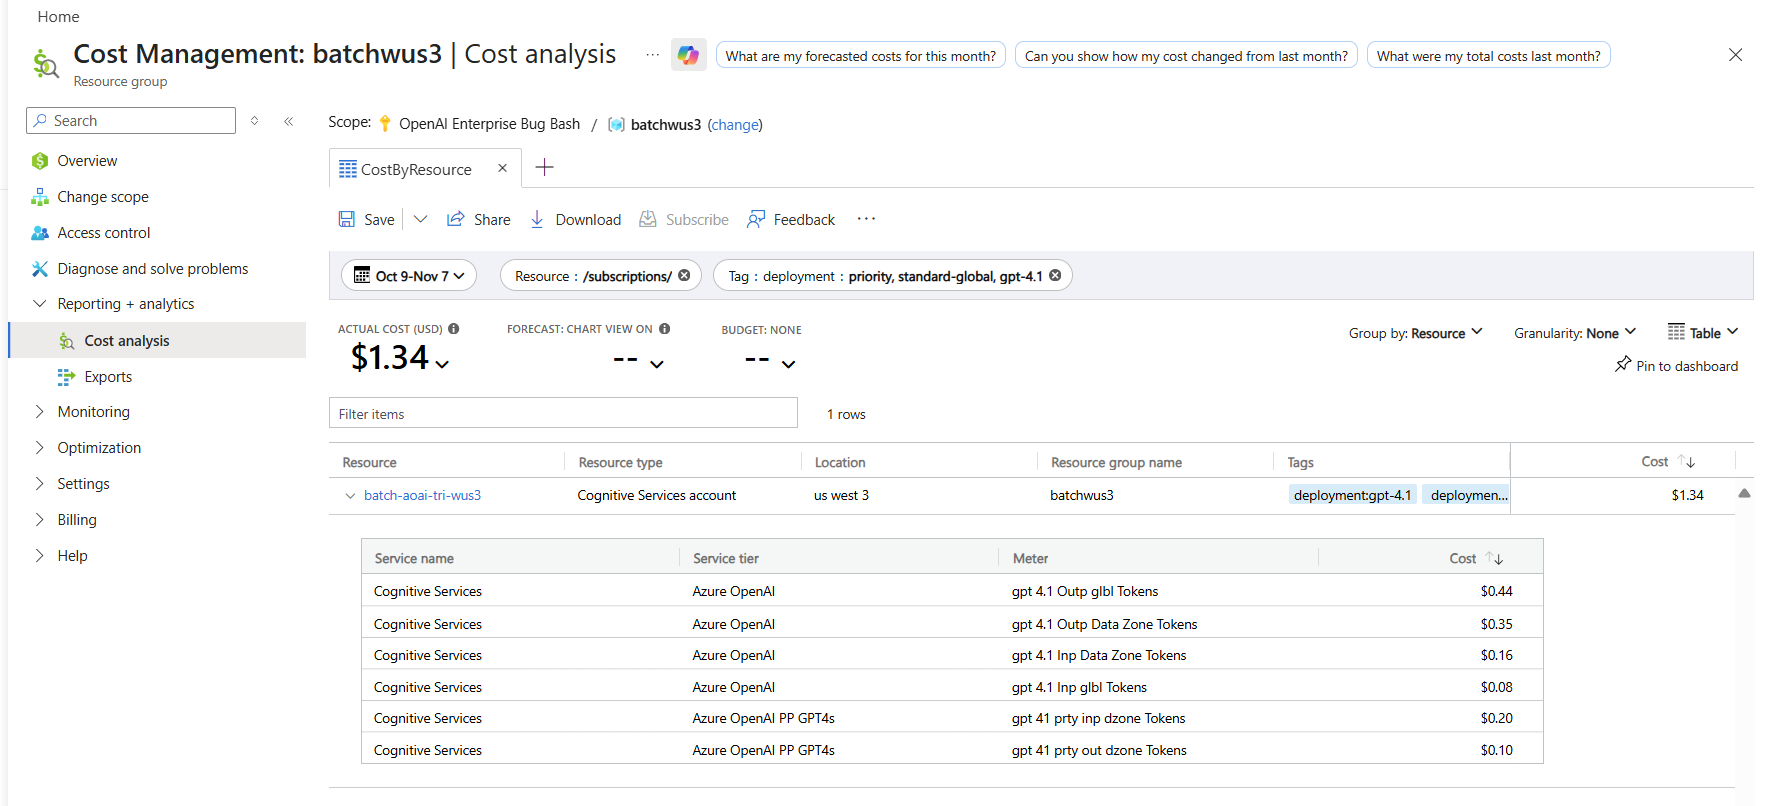
A prioritási és standard kérések költségeinek lebontását a Azure portál költségelemzési oldalán tekintheti meg az üzembehelyezési névre és a számlázási címkékre való szűréssel az alábbiak szerint:
- Nyissa meg a Azure portál költségelemzési lapját.
- (Nem kötelező) Szűrés erőforrás szerint.
- Az üzembe helyezés neve alapján történő szűréshez: Adjon hozzá egy szűrőt a számlázási címkéhez> , válassza ki az üzembe helyezést értékként, majd válassza ki az üzembe helyezés nevét.
További információ a prioritás-feldolgozás díjszabásáról: Azure OpenAI Service díjszabás áttekintése.
Prioritás-feldolgozás engedélyezése a kérés szintjén
Important
2026. szeptember 25-től a Foundry megszünteti a flex-ról a standard feldolgozásra történő automatikus visszaállást azon modellek esetében, amelyek nem támogatják a Flex-feldolgozást. Az ilyen kérések esetében jelenleg a szokásos feldolgozás történik, de a kivezetési dátum után ehelyett HTTP 400-as választ adnak vissza egy invalid_request_error elemmel. Mielőtt ez a módosítás érvénybe lép, ellenőrizze, hogy a modell támogatja-e a Flex-feldolgozást. Ha a standard feldolgozás elfogadható, állítsa be service_tier helyette default .
A prioritás feldolgozásának engedélyezése a kérés szintjén nem kötelező. A csevegővégzítési API és a válasz API is rendelkezik egy opcionális attribútummal service_tier , amely meghatározza a kérések kiszolgálása során használni kívánt feldolgozási típust. Az alábbi példa bemutatja, hogyan állítható be service_tier egy priority válaszkérés során.
curl -X POST https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $AZURE_OPENAI_AUTH_TOKEN" \
  -d '{
     "model": "gpt-4.1",
     "input": "This is a test",
     "service_tier": "priority"
    }'
service_tier Az attribútummal felülbírálhatja az üzembe helyezési szintű beállítást.
service_tier értékeket autovehet fel, defaultés priority.
Ha nem állítja be az attribútumot, az alapértelmezés szerint a következő lesz
auto: .service_tier = autoazt jelenti, hogy a kérés az üzembe helyezés során konfigurált szolgáltatási szintet használja.service_tier = defaultazt jelenti, hogy a kérelem a kiválasztott modell standard díjszabását és teljesítményét használja.service_tier = priorityazt jelenti, hogy a kérés a prioritás-feldolgozási szolgáltatási szintet használja.
Az alábbi táblázat összefoglalja, hogy melyik szolgáltatásszint dolgozza fel a kéréseket a telepítés szintje és a kérésszint beállításai service_tieralapján.
| Üzembe helyezési szintű beállítás | Kérelemszintű beállítás | Szolgáltatásszint által feldolgozott kérés |
|---|---|---|
| alapértelmezett | automatikus, alapértelmezett | Standard |
| alapértelmezett | Prioritás | Elsőbbségi feldolgozás |
| Prioritás | automatikus, prioritás | Elsőbbségi feldolgozás |
| Prioritás | alapértelmezett | Standard |
Korlátozások
A szolgáltatás jelenleg nem támogatja a regionális standard telepítéseket és az UNIÓS adatzónák szabványos üzembe helyezését.
Előfordulhat, hogy a szolgáltatás az alábbi forgatókönyvek során újra átirányít néhány prioritási kérést a standard feldolgozásra* :
- Ha a prioritási feldolgozási jogkivonatok percenkénti gyors növekedése a rámpa sebességkorlátainak eléréséhez vezet. Jelenleg a rámpasebesség-korlát úgy van definiálva, hogy a forgalmat 15 percen belül percenként több mint 50% tokennel növeli.
- Az olyan csúcsidőszakokban, amikor prioritás feldolgozásra érkeznek a kérések,
- A hosszú szövegkörnyezetű kérések a késési céltáblában felsorolt bizonyos modellekhez lettek küldve.
Tipp
Ha rendszeresen találkozik rámpasebesség korlátozásokkal, fontolja meg a PTU megvásárlását a prioritási feldolgozás mellett vagy helyett.
* A szolgáltatás a standard szolgáltatási szint által feldolgozott kéréseket a standard díjszabással számlázza ki. A standard szolgáltatási szint által feldolgozott kérelmek szerepelnek
service_tier = defaulta válaszban, míg a prioritási feldolgozási szint által feldolgozott kérések aservice_tier = priorityválaszban.
Hibaelhárítás
| Kérdés | Okoz | Felbontás |
|---|---|---|
| Standard szintre visszaminősített kérések | Az alábbi helyzetek egyike: - A forgalom 15 percen belül több mint 50%-kal nőtt a tokenszám percenként, elérve a növekedési sebességhatárt. - A prioritás-feldolgozásra irányuló kérelmek csúcsidőszakában küldött kérelmek. - Hosszú szövegkörnyezeti kérelmek küldése a késleltetés céltáblában felsorolt egyes modelleknek. |
- Növelje fokozatosan a forgalmat, ha rámpasebesség-korlátokat tapasztal. - Fontolja meg a PTU megvásárlását állandó állapotú kapacitáshoz. |