Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
Megjegyzés:
Azure AI Keresés a Azure portálon, REST API-kon és Azure SDK-k keresztül érhető el. Emellett a Foundry IQ-t is támogatja, amely a vállalati tartalmakat újrafelhasználható, engedélytudatos tudásbázisokká alakítja át az Microsoft Foundry portálon található ügynökök számára.
Azure AI Keresés két tarifamodellt támogat, amelyek mindegyike különböző számítási feladatokhoz készült:
Dedikált: A keresési egységek (SU-k) által mért rögzített díjszabás. Kiválaszt egy szolgáltatási szintet, és a kiosztott egységek alapján óránként számlázunk.
Kiszolgáló nélküli (előzetes verzió): A számítási egységek óránkénti (CU/óra) és az indexelt tárterület esetén gb/hónap alapján mért fogyasztásalapú díjszabás.
Important
A kiszolgáló nélküli fejlesztői szint jelenleg előzetes verzióban érhető el. Ez az előzetes verzió szolgáltatásszintű szerződés nélkül érhető el, és éles számítási feladatokhoz nem ajánlott. Előfordulhat, hogy bizonyos funkciók nem támogatottak, vagy korlátozott képességekkel rendelkeznek. További információkért lásd: Microsoft Azure Previews Kiegészítő Felhasználási Feltételek.
A kiszolgáló nélküli fejlesztői szint számlázása 2026. szeptember 13-án kezdődött. Az ezen a napon vagy azt követő használat díjai megjelennek a Azure számlán. A használatért 2026. szeptember 13-a előtt nem kell fizetnie.
A kiszolgáló nélküli fejlesztői szint nem támogatja a más tarifacsomagokra való migrálást, és a más szinteken elérhető egyes funkciók nem támogatottak a nyilvános előzetes verzióban. A szolgáltatáskorlátok, a támogatott funkciók és a díjszabás részletei az általános elérhetőség előtt változhatnak.
Az előzetes verzióban a kiszolgáló nélküli díjszabási modell csak bizonyos régiókban támogatott.
A díjszabási modell és a szolgáltatási szint különbségeiről további információt a Díjszabási modell és a szolgáltatási szint kiválasztása című témakörben talál.
A költségek meghatározása a kiszolgáló nélküli modellben
A dedikált és kiszolgáló nélküli díjszabási modellek eltérő módon végzik a munkát a keresési szolgáltatásban. A dedikált szolgáltatások lekérdezéseket, indexelést és eredményfeldolgozást futtatnak a már megvásárolt kiépített kapacitáson. A kiszolgáló nélküli szolgáltatások azt a számítási, memória- és lemez I/O-értéket mérik, amelyet ezek a műveletek használnak fel, és ezt a használatot számítási egységekké (CU-kká) alakítják át. Ennek eredményeképpen a teljesítményoptimalizálás közvetlenül befolyásolja a kiszolgáló nélküli költségeket.
A kiszolgáló nélküli költségek a számítási feladatok végrehajtásához kapcsolódnak:
- A lekérdezések és az indexelés óránkénti számítási egységekben (CU/h) mért számítást használnak fel.
- Az aktív indexek az erőforrás-használatuk és az alapján fogyasztanak számítási kapacitást, hogy mennyi ideig maradnak aktívak.
- Az index az utolsó lekérdezés vagy indexelési kérés után 10 percig aktív marad, mielőtt inaktív lenne.
- Az inaktív indexek nem rendelkeznek minimális vagy fenntartott számítási díjjal. Az inaktív indexek számítási kihasználtsága nullára skálázható. Nincs minimális számítási díj, ha egy index inaktív.
- A tárolás díjszámítása külön történik, a lemezen elfoglalt indexméret alapján, és attól függetlenül folytatódik, hogy az index használatban van-e.
- Az ágensalapú visszakeresés számítási kapacitást igényel a keresési szolgáltatáson belül végrehajtott keresési lekérdezésekhez és orkesztrációhoz.
A tárolási díjak csak az index törlésekor állnak le.
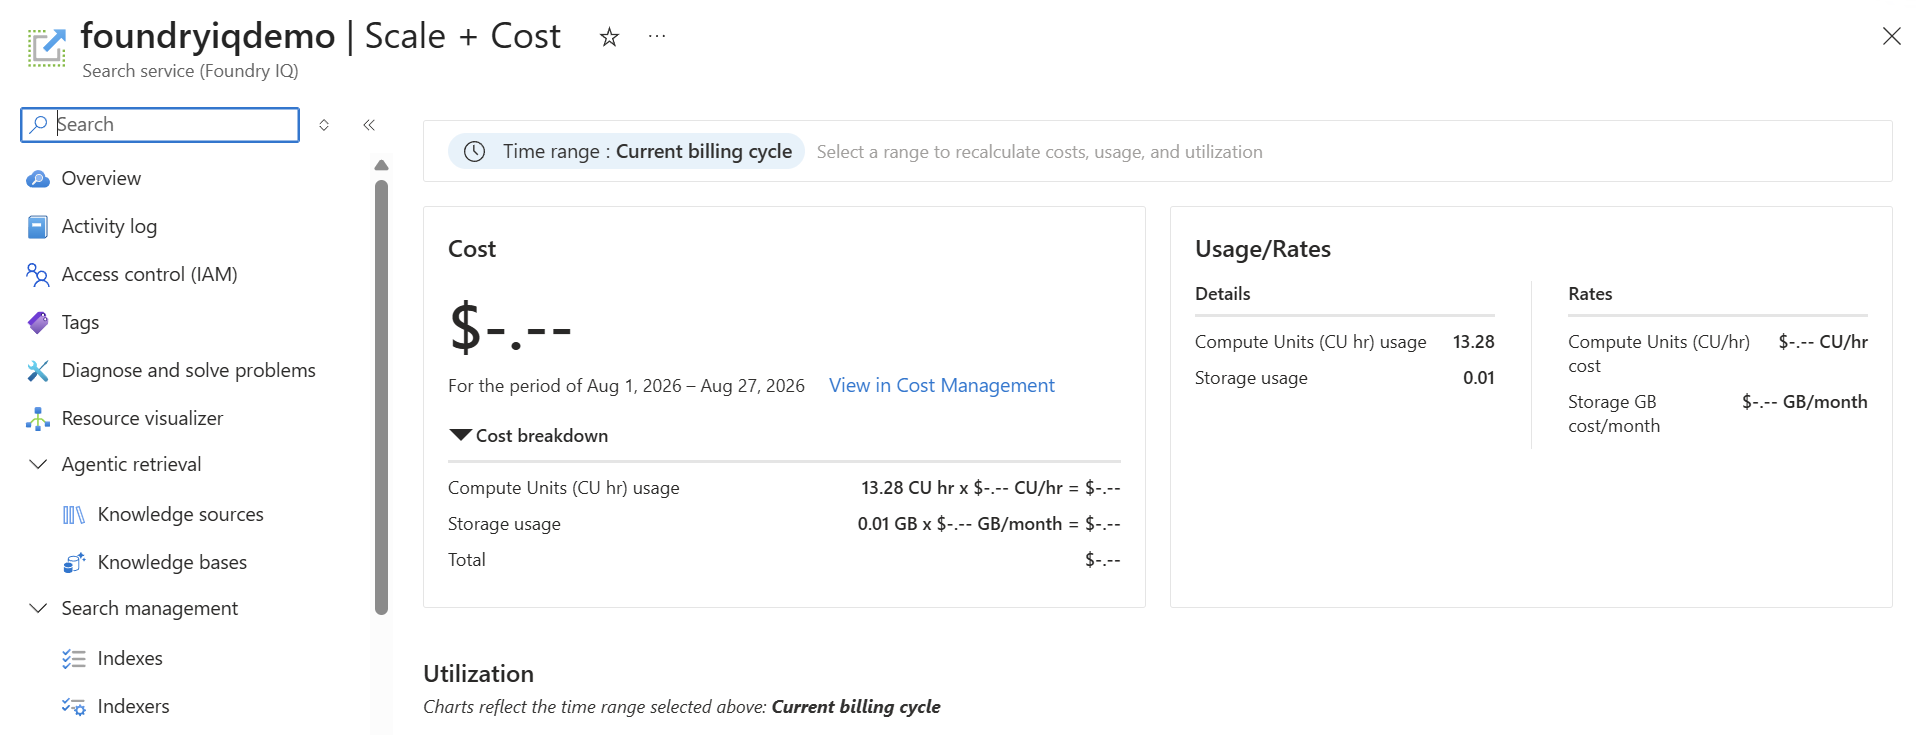
Az aktuális számlázási ciklus költséglebontásának és használati díjainak megtekintéséhez tekintse meg a Méretezés + Költség lapot a Azure portálon.
Hogyan befolyásolja az index mérete a számítási használatot?
Amíg egy index aktív, Azure AI Keresés két véges erőforrást értékel ki a számítási használat meghatározásához:
- Teljes indexméret: Az index lemezen elfoglalt teljes területe, beleértve a szöveget, a metaadatokat és a vektorokat.
- Vektorindex mérete: A vektorindex által használt memória. A memória több erőforrást igényel, mint a lemez, ezért a vektorindex mérete nagyobb súllyal esik latba a CU-kra való átszámításkor.
Azure AI Keresés nem adja hozzá a két eredményként kapott CU-összeget. A számítási használat a nagyobb mennyiségen alapul. A vektorindex mérete például akkor is meghatározhatja a számítási használatot, ha a lemez teljes indexmérete viszonylag kicsi.
Az aktív indexű számítási használat csökkentéséhez határozza meg, hogy melyik erőforrás hozza létre a magasabb CU-értéket. Ezután csökkentse az index teljes méretét, a vektorindex méretét vagy mindkettőt. Az indexelt tárolásért továbbra is külön, GB-onként/havonta felszámított díjat kell fizetni.
A kiszolgáló nélküli díjszabási modell a legköltséghatékonyabb a változó, időszakos vagy kiszámíthatatlan forgalommal rendelkező számítási feladatok esetében, ahol a kiépített kapacitás kihasználatlan lenne.
Important
A kiszolgáló nélküli CU-díjak a keresési szolgáltatáson belül végzett munkát fedik le, beleértve a lekérdezéseket, az indexelést, az eredmények feldolgozását és az ügynöki lekéréses vezénylést. A modellhívások és a keresési szolgáltatáson kívül végzett egyéb műveletek továbbra is a meglévő számlázási mérőszámaikat használják. Ilyenek például a szemantikai rangsorolás, az ügynökalapú lekérdezés-újraírás, a képkinyerés és a készségek végrehajtása.
A számítási egységek (CU-k) ismertetése
A számítási egység (CU) a kiszolgáló nélküli modell keresési és indexelési műveleteinek végrehajtásához szükséges mért rendszererőforrásokat jelöli. A CU költségeit elsősorban a PROCESSZOR, a memória és az I/O kihasználtsága, másodsorban pedig az Index mérete és a dokumentum hasznos adatmérete határozza meg, és a használat számítási egységként van számlázva óránként (CU/h).
A számítási költség a következőkkel skálázódik:
- Lekérdezések összetettsége
- Indexméret (GB) és struktúra
- Dokumentum hasznos tehermérete (KB)
- Mezők száma és lekért eredmények száma
A különböző műveletek eltérő költségprofillal rendelkeznek:
- Lekérdezés: Alacsony költségű. Egyetlen dokumentum lekérése az azonosítója alapján a leghatékonyabb művelet.
- Kulcsszókeresés: Alacsony költség. A szöveges keresés fordított indexeket használ, amelyek a sebességre és az alacsony számítási használatra vannak optimalizálva.
- Vektoros keresés: Magas költség. A vektoros lekérdezések számításilag költségesek, mert hasonlósági számításokat igényelnek a nagy méretű beágyazások esetében. A kulcsszókereséshez képest jelentősen több számítást használnak fel.
- Hibrid keresés: Egyesíti a kulcsszó- és vektorkeresés költségeit, mivel mindkét folyamat minden lekérdezéshez fut, valamint egy kis többletterhelést a kölcsönös rangsor fúziója (RRF) számára az eredmények egyesítése érdekében.
Számítási használat monitorozása
A számítási felhasználás monitorozása segít azonosítani a költséges műveleteket, optimalizálni a lekérdezési mintákat és megbecsülni a költségeket. Minden kérés számítási egységének (CU) költsége lebegőpontos számként jelenik meg a x-ms-azs-compute-units-consumed HTTP-válasz fejlécében. Ezzel a fejléccel azonosíthatja a költséges műveleteket, és optimalizálhatja a lekérdezési mintákat. Az Azure Monitor HTTP-válaszfejléceinek és műveleti eseményeinek vizsgálatával nyomon követheti az összes kérés CU-költségét. Az elérhető monitorozási adatok típusairól és az adatok elemzési módszereiről a Monitor Azure AI Keresés című témakörben olvashat bővebben.
-
Fejléc:
x-ms-azs-compute-units-consumed: <value> - Érték: A felhasznált CU-kat jelölő lebegőpontos szám.
Példa:
Status: 200 OK
Content-Type: application/json
x-ms-azs-compute-units-consumed: 12.45
Ebben a példában a kérelem 12,45 számítási egységet használt fel. Ezzel az értékkel azonosíthatja a magas költségű műveleteket, és összehasonlíthatja a különböző lekérdezési minták relatív költségét.
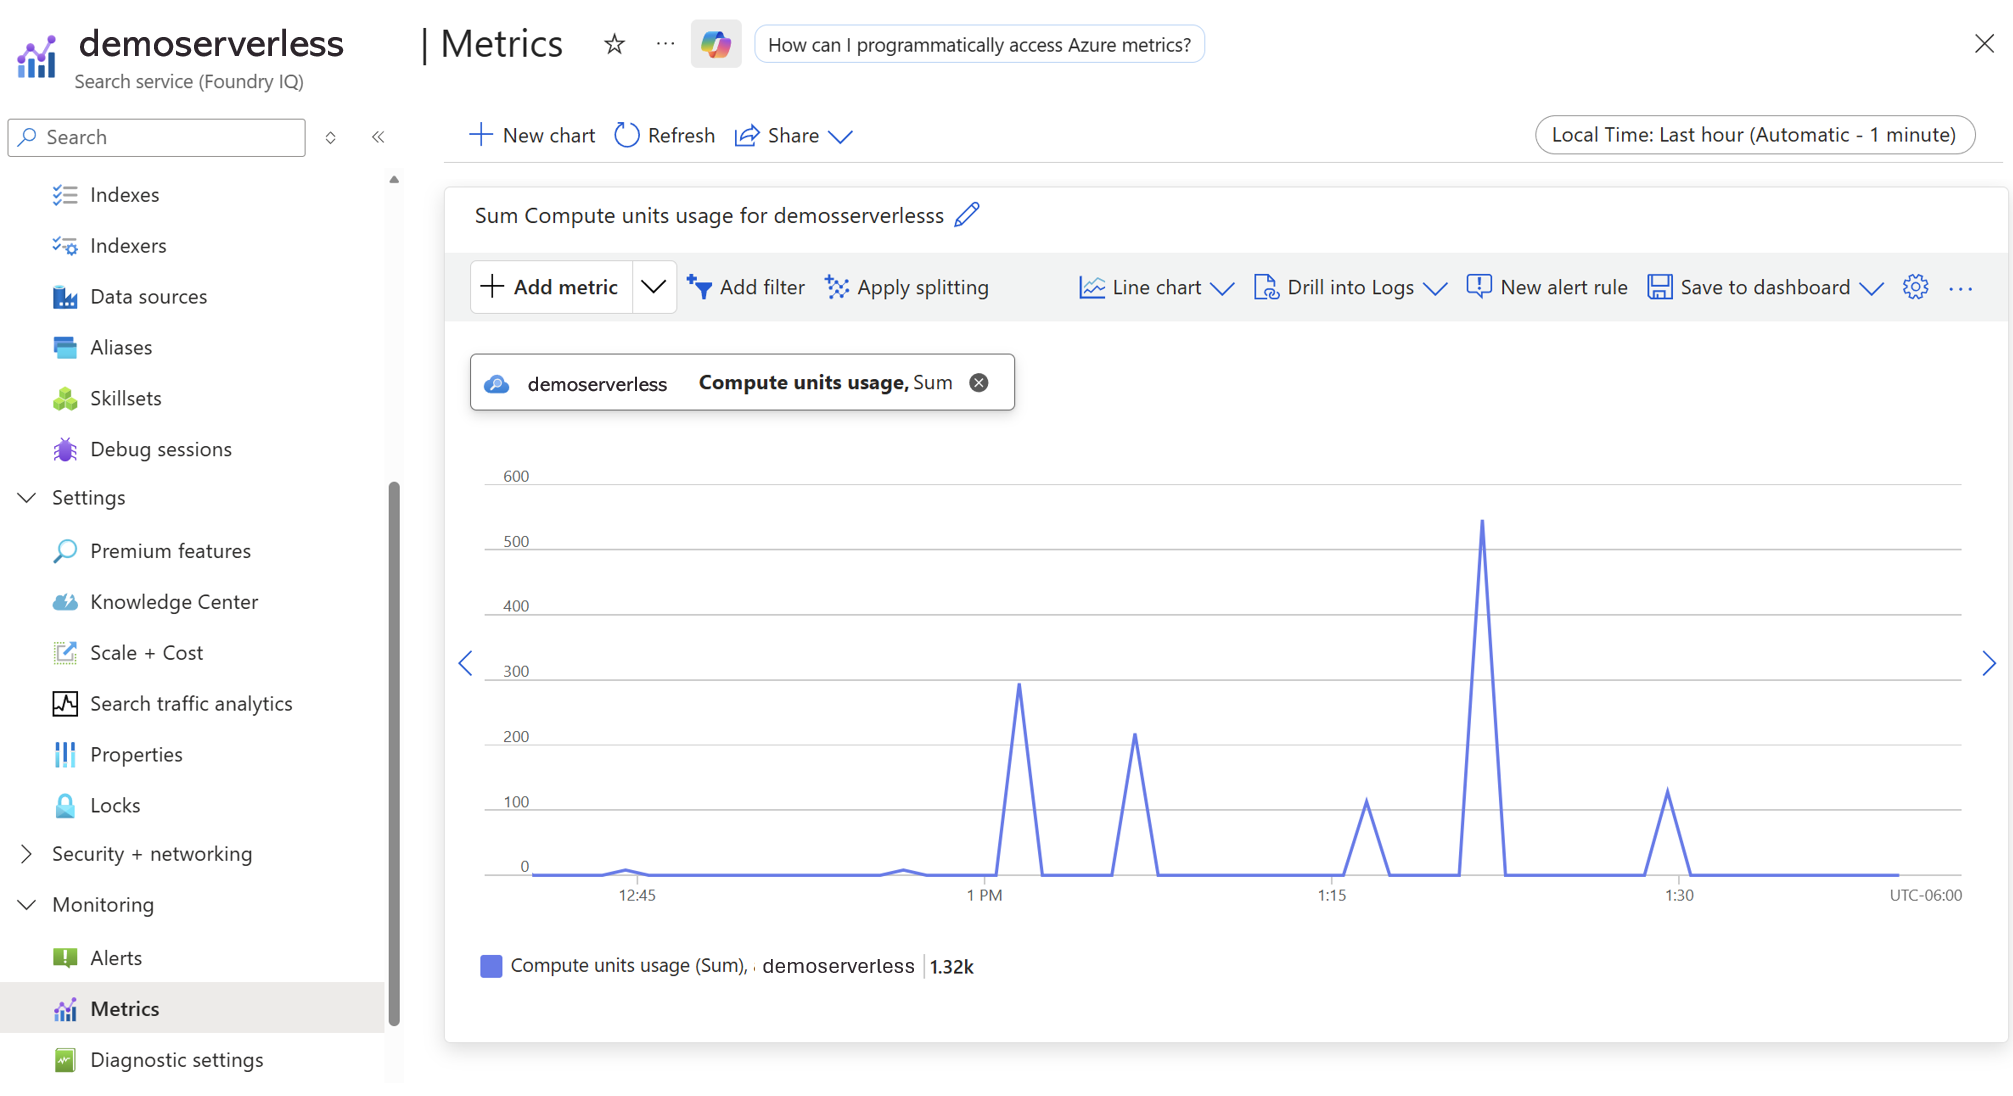
A kiszolgáló nélküli keresési szolgáltatás korábbi számítási felhasználásának áttekintéséhez használja a Azure Monitor metrikákat a Azure portálon:
- Nyissa meg a keresési szolgáltatást.
- Válassza a Metrikák lehetőséget.
- Válassza a + Metrika hozzáadása lehetőséget.
- A metrikalistában válassza a számítási egységek használatát.
- A diagram segítségével elemezheti a használati trendeket, és azonosíthatja a megnövekedett számítási felhasználás időszakait.
Az összesített használat monitorozásával megismerheti a szolgáltatás általános költségeit, és azonosíthatja a legtöbb számítási erőforrást használó számítási feladatokat. Az elérhető monitorozási metrikák leírását a Monitorozási adatok referenciája című témakörben talál. A Azure Monitor naplók segítségével nyomon követheti az összesített CU-használatot az idő függvényében, és korrelálhatja a lekérdezések mennyiségével és a számítási feladatok változásaival.
Riasztások konfigurálása a számítási használathoz
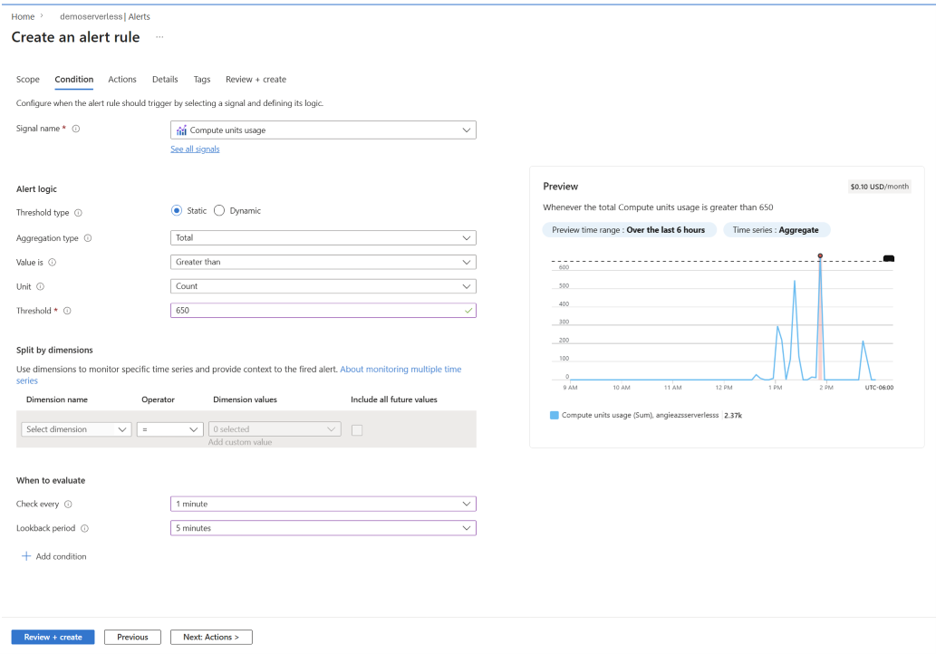
Létrehozhat egy riasztási szabályt, amely értesítést kap, ha a számítási felhasználás eléri a megadott küszöbértéket a Azure portálon.
- A keresési szolgáltatásában lépjen a Riasztások elemre.
- Válassza a + Riasztási szabály létrehozása lehetőséget.
- A Feltétel alatt válassza a Számítási egységek használata lehetőséget jelként.
- Adja meg a riasztási logikát. Eseményindító például akkor, ha a teljes használat nagyobb egy megadott értéknél.
- Konfiguráljon műveleteket, például e-maileket, SMS-eket vagy webhook-értesítéseket.
- Végezze el a többi lépést, és válassza a Véleményezés + létrehozás lehetőséget.
A riasztások segítségével proaktívan reagálhat a váratlan használati kiugró értékekre, és kezelheti a költségeket.
Kiszolgáló nélküli költségek becslése
A Azure díjkalkulátor és a keresési egység (SU)-alapú kapacitástervezési útmutató nem vonatkozik a kiszolgáló nélküli díjszabási modellt használó szolgáltatásokra.
Kiszolgáló nélküli költségek becslése:
- Reprezentatív mintaadatok indexelése.
- Futtasson tipikus indexelési és lekérdezési munkaterheléseket.
- Jegyezze fel az
x-ms-azs-compute-units-consumedegyes műveletekhez visszaadott értéket. - A Azure Monitor metrikák használatával mérje az összesített használatot az idő függvényében.
- Becsülje meg a költségeket a várható éles forgalom alapján.
A Azure portál Méretezés + Költség lapján megtekintheti az aktuális használatot és a költségek becslését.
Mivel az ugyanazon adatok alapján végrehajtott kérések általában hasonló számítási felhasználást eredményeznek, a reprezentatív számítási feladatok megbízható alapot biztosíthatnak a költségbecsléshez.
A kiszolgáló nélküli használat mérése folyamatosan történik, és a számlázáshoz összesítve történik. A rendszer minden percben nyomon követi a számítási felhasználást, és csak számítási erőforrások használata esetén bocsát ki.
A költségek becslésekor használjon kérelemdíj-értékeket az egyes műveletek költségeinek és Azure Monitor metrikáknak az általános szolgáltatáshasználati minták megértéséhez.
Mindkét adatforrás együttes használata a költségek megértéséhez: a kérelemenkénti díjadatok segítenek az egyes műveletek kiértékelésében, míg Azure Monitor metrikák segítenek megérteni az összesített szolgáltatáshasználatot az idő függvényében. A teljes költségképhez vegye figyelembe a számítási egységektől külön számlázott funkciókat is.
A számlázás az egyes kérések helyett az összesített számítási használaton alapul. A használatot egyperces időközökben mérik, és percenként 0,25 CU-ra felfelé kerekítik. Ezek az egyperces használati intervallumok egy óra alatt halmozódnak fel a számlázható CU/óra mennyiség meghatározásához. A rendszerben a felhasználás milli-compute unitokról (mCU) compute unitokká (CU) kerül összesítésre, majd átalakul a számlázáshoz jelentett óránkénti felhasználássá.
A különböző műveletek különböző mennyiségű számítást használnak fel. Általában:
- A kulcsszókeresések általában a legkevésbé számítási erőforrásokat használják.
- A vektoros keresések általában több számítási erőforrást használnak, mint a kulcsszókeresések.
- A hibrid keresések kombinálják a kulcsszó- és vektorkeresési végrehajtást, így általában több számítási erőforrást használnak, mint egyetlen technika.
A tényleges számítási felhasználás olyan tényezőktől függ, mint a lekérdezések összetettsége, az index mérete, az adatmennyiség, a vektorkonfiguráció és a visszaadott eredmények száma. A kérelmek díjainak és az összesített használati metrikáknak a monitorozása segíthet azonosítani az optimalizálási lehetőségeket, és jobban előrejelezni az éles költségeket.
Számítási költségek csökkentése az optimalizálás révén
A hatékony lekérdezések és indextervezés csökkenti a számítási felhasználást és a költségeket.
A séma optimalizálása
Az indexséma határozza meg az alapkonfiguráció számítási és tárolási költségeit:
- Mezőattribútumok korlátozása: Csak akkor engedélyezze az attribútumokat (kereshető, szűrhető, facetable, rendezhető), ha szükséges. Minden attribútum növeli az index méretét és az indexelési költséget.
- Összetett típusok összesimítása: Beágyazott JSON-struktúrák leképezése egyszerű mezőkre vagy gyűjteményekre, ahol lehetséges.
-
Állítsa a retrievable=false értéket a kizárólag szűrésre vagy rendezésre szolgáló mezők esetén: Ha egy mezőt szűrésre vagy rendezésre használnak, de nem kell visszaadni a találatokban, tartsa indexelve, és a lemezen használt tárhely, valamint a GB/hó alapú tárolási költség csökkentése érdekében állítsa a
retrievable=falseértékét erre. - Ha lehetséges, csak beolvasható mezőket használjon: Például a csak megjelenítésre használt mezők (például a kép URL-címei) nem kereshetők.
- A vektorméretek csökkentése: A magasabb dimenziójú vektorok növelik a tárolási és lekérdezési költségeket. Szükség esetén használjon kisebb beágyazási modelleket vagy kvantálást.
- A dokumentum hasznos adatméretének minimalizálása az indexelés előtt: A nagyobb dokumentumok többe kerülnek az indexeléshez. Távolítsa el a felesleges mezőket, vágja le a hosszú szöveget, és szüntesse meg a HTML-t, mielőtt dokumentumokat küldene az indexbe.
Indexelési kérelmek optimalizálása
Az adatok indexbe küldése hatással van a költségekre és az átviteli sebességre is:
Ha lehetséges, nagyobb kötegeket használjon: A kötegelt indexelés csökkenti a kérésenkénti többletterhelést a hálózat amortizálásával és a költségek további dokumentumokban történő feldolgozásával. Általánosságban elmondható, hogy a legfeljebb ~1000 dokumentumból vagy ~16 MB-ból álló kötegek sokkal hatékonyabbak, mint sok kis kérelem. Az optimális kötegméret azonban a számítási feladattól függ. Az átviteli sebesség, a késés és a megbízhatóság egyensúlyának tesztelése.
Csak új vagy módosított adatok indexelése: Lehetőség szerint kerülje a teljes újraindexelést. A csak kiegészítések és frissítések küldése csökkenti a feldolgozott dokumentumok számát, csökkenti a számítási költségeket és javítja a betöltési sebességet.
Ha nincs rá szüksége, hagyja ki a rendszerkép-kinyerési műveletet: A kép kinyerése további feldolgozási munkát tesz lehetővé, és külön költség-illesztővé válhat. Csak olyan dokumentumok vagy munkafolyamatok esetén kapcsolja be, amelyek valójában képtartalmat igényelnek.
Az indexméret növekedésének figyelembe vétele: Ahol lehetséges, hozzon létre kisebb indexeket. Az index növekedésével az indexelési költségek növekednek, mivel több adatot kell tárolni és karbantartani, a műveletek pedig több számítást igényelnek. A nagyon nagy adathalmazok esetében fontolja meg az adatok több index közötti particionálását a teljesítmény és a költségek kezelése érdekében. Bár a költségek az index méretével nőnek, a növekedés alvonalas. A nagyobb indexek műveletenként többe kerülnek, de arányosan nem.
További útmutatásért lásd: tippek a jobb teljesítményhez az Azure AI Keresésben.
Indexelőműveletek optimalizálása
A kiszolgáló nélküli indexelő számítási használata az egyes indexelők futtatása során végzett munkától függ. Sororientált források esetén használja a feldolgozott dokumentumok számát a számítási feladatok mennyiségének mutatójaként. Fájlalapú források, például Azure Blob Storage és Azure Data Lake Storage Gen2 esetén figyelje a feldolgozott forrásadatok mennyiségét. A tényleges számítási használat a dokumentumok hasznos adataitól, az indexszerkezettől, a bővítéstől és a futtatás során végrehajtott egyéb feldolgozástól is függ.
Az indexelő számítási használatának csökkentése:
Változásészlelés és növekményes indexelés használata: Csak új vagy módosított adatok feldolgozása a teljes adatforrás ismételt indexelése helyett.
A megfelelő méretű indexelő ütemezései: Válasszon ki egy olyan ütemezést, amely megfelel az adatfrissítési követelményeknek. A számítási egység telemetriájának használatával értékelje ki az ütemezés gyakoriságának hatását.
Szükségtelen dokumentumtartalom csökkentése: Távolítsa el az indexelendő tartalmat, és zárja ki a szükségtelen fájlokat vagy fájltípusokat.
Hatókör-bővítési készségek körültekintően: Csak olyan mezőkön és dokumentumokon futtassa a készségeket, amelyek bővítést igényelnek, és ne generáljon olyan kimeneteket, amelyeket nem használnak tovább. A számlázható készségek külön tranzakciós díjakat vonhatnak maga után.
Sikertelen és ismételt futtatások figyelése: Az indexelő számítási erőforrásokat használhat fel a meghibásodás előtt elvégzett munkára. Tekintse át a végrehajtási előzményeket és a számítási egység használatát az ismétlődő hibák és az újrapróbálkozási minták azonosításához.
Lekérdezések optimalizálása
A lekérdezések tervezése a változó költségek egyik elsődleges meghatározó tényezője:
Használja a(z)
$selectelemet a visszaadott mezők korlátozásához: Ez csökkenti a hasznos teher méretét és a szerializáláshoz szükséges számítási kapacitást.GET /docs?search=test&$select=id,title,urlA szöveg keresésének korlátozására használható
searchFields: A lekérdezési idő egyeztetésének korlátozása a forgatókönyv szempontjából fontos mezőkkel. Minden további kereshető mező növeli a lekérdezési munkát, és növelheti a CU/h értékét.A pontos egyezéses vagy egyszerű kulcsszó-lekérdezések előnyben részesítése: A fuzzy, a helyettesítő, a regex és az előtag típusú lekérdezések széles indexvizsgálatokat kényszeríthetnek, és jelentősen több CU/h-t használhatnak fel. Csak akkor használja őket, ha részleges egyeztetési viselkedésre van szüksége, és ahol csak lehetséges, válassza ki a pontos egyezést vagy az egyszerűbb kulcsszó-lekérdezéseket.
Ha lehetséges, keresés helyett kereséseket használjon: A dokumentumok azonosító alapján történő lekérése hatékonyabb, mint egy keresési lekérdezés futtatása. Ha ismeri a dokumentum azonosítóját, keresési lekérdezés helyett keressen rá. A keresések hatékonyabbak, mert egy dokumentumot közvetlenül kulcs alapján kérnek le, míg a keresési lekérdezések a teljes lekérdezési folyamatot (elemzés, indexbejárás, pontozás és rangsorolás) indítják el, ami növeli a számítási költségeket.
Kerülje a mély lapozást (
$skip): A nagy$skipértékek növelik a számítást, mert a motornak feldolgoznia, pontszámot kell adnia és rangsorolnia kell a kért oldalt megelőző eredményeket. A motornak például$skip=5000legalább 5000 nem visszaadott eredményt kell feldolgoznia. Ez a választás további számítási egységeket (GPU-kat) használ fel, és növelheti a költségeket. Ehelyett szűrőkkel szűkítse az eredménytset, és$topkorlátozza a visszaadott eredmények számát. Válassza ki a megfelelő méretet$topaz alkalmazásához vagy a felhasználói felületéhez. Bár a$topnem változtatja meg a pontozott egyező dokumentumok számát, a kisebb érték csökkenti az összegyűjtendő, rendezendő és szerializálandó eredmények számát. Csak annyi eredményt kérjen, amennyit az alkalmazásnak szüksége van, és kerülje az olyan lapozási mintákat, amelyek megkövetelik, hogy a motor nagy mennyiségű nem használt eredményt dolgoz fel.A facet count és a facet scope minimalizálása: Csak a felhasználói felületen megjelenített aspektusokat kérje le, és tartsa az egyes aspektusértékeket
countolyan alacsonyan, mint a gyakorlatban. Az aspektusok lekérdezésenkénti összesítéseket igényelnek, és a magas számok növelik a számítási költségeket.Szűrésre használható
search.in: Ha azonosítók vagy értékek listájával szűr, használja asearch.infüggvényt többorfeltétel helyett (példáulid eq '1' or id eq '2'). Ez a megközelítés hatékonyabb, és csökkenti a számítási többletterhelést. Kerülje továbbá a nagy számosságú mezők (azaz a sok egyedi értéket tartalmazó mezők, például egyedi azonosítók vagy szabadszöveges leírások) szűrhetőként vagy facettálhatóként való megjelölését, hacsak ez nem szükséges, mivel ez növeli az index méretét és a lekérdezések költségét.
Optimalizálja adminisztratív kérelmeit
A lekérdezési és indexelési műveletek mellett Azure AI Keresés objektumszintű és szolgáltatásszintű felügyeleti műveleteket is tartalmaz (például indexséma vagy szolgáltatásstatisztika lekérése). Ezek a kérelmek egységes, kérelmenkénti költséggel járnak. Bár minden kérés olcsó, az ismétlődő vagy szükségtelen hívások idővel halmozódhatnak fel, és növelhetik a teljes számítási használatot.
- Kerülje a túlzott adminisztratív kéréseket: Gyorsítótárazza a metaadatokat, például az indexsémákat, az ügyféloldalon ahelyett, hogy ismételten lekérné őket. Az indexséma beolvasása például minden írási művelet előtt szükségtelen költséggel jár. A kiszolgáló nélküli modellben ez a minta közvetlenül növeli a számítási díjakat, míg a dedikált szolgáltatásokban a hatást gyakran elrejti a rögzített óránkénti számlázás.
Vektorköltségek optimalizálása
A vektoros számítási feladatok általában a kiszolgáló nélküli díjszabási modell keresésekor a legmagasabb költségű összetevő, mivel mind a számítási egységekre (lekérdezésekre és indexelésre), mind a tárolóra (a lemez vektorméretére) hatással vannak. A költségek csökkentése érdekében optimalizálja a vektorok tárolási és lekérdezési módját.
Vektoros tárolás és séma optimalizálása
A vektormezők jelentősen növelhetik az index méretét és az indexelési költségeket. A tárolási többletterhelés csökkentéséhez használja az alábbi technikákat:
Tömörítéssel csökkentheti a vektorméretet: Kvantálás alkalmazásával minimális relevanciával csökkentheti a tárterület-lábnyomot. A skaláris kvantálás például akár 4× is csökkentheti a vektorok tárolását, és minimális hatással van a keresés minőségére.
Ha nincs szükség a vektorok tárolására, tiltsa le a tárolást: Ha csak vektorokra van szüksége a kereséshez, ne a lekéréshez, állítsa be a stored=false értéket a vektormezőkre. Így elkerülhető az eredeti vektorok tárolása az indexben, így a tárolási költségek a lekérdezési viselkedés befolyásolása nélkül csökkennek.
Lehetőség szerint használjon kisebb beágyazási dimenziókat: A magasabb dimenziójú vektorok növelik a tárolási és a lekérdezési költségeket. A nem kritikus számítási feladatokhoz használjon kisebb beágyazási modelleket (például 1536 helyett 384 vagy 768 dimenziót) a költségek csökkentése érdekében.
Vektoros lekérdezés végrehajtásának optimalizálása
A vektoros lekérdezések számítási igényesek, mert hasonlósági számításokat igényelnek a nagy dimenziójú adatstruktúrákhoz képest.
A hibrid keresés szelektív használata: A hibrid lekérdezések kulcsszó- és vektorlekérdezéseket is futtatnak. Csak akkor használja, ha a relevancia szempontjából szükséges.
Alacsonyabb maxTextRecallSize hibrid lekérdezésekhez: A
hybridSearch.maxTextRecallSizebeállítás azt szabályozza, hogy hány BM25-rangsorolt eredmény legyen beolvasva a Kölcsönös rangsor fúzióba. Az alapértelmezett érték 1000 (1 és 10 000 közötti tartomány). A számítási erőforrás-felhasználás nagyjából lineárisan arányos ezzel az értékkel, ezért ennek csökkentése a hibrid munkaterhelések költségeinek csökkentésére szolgáló egyik legközvetlenebb eszköz.Az 500 körüli értékek gyakran jelentősen csökkentik a számítást, és kevés relevanciaveszteséggel járnak.
Ha alacsonyabb értékre állítja, kimaradhatnak olyan kulcsszavas egyezések, amelyeket a vektorkeresés nem talál meg, például a pontos kifejezések, azonosítók és betűszavak.
A vektorjelöltek vezérlése külön k-val az egyes vektoros lekérdezéseken.
Tesztelje a reprezentatív lekérdezéseket, és hasonlítsa össze a relevanciát, a késést és a
x-ms-azs-compute-units-consumedfejlécet egy érték rendezése előtt.Szűrők alkalmazása vektoros lekérdezések előtt: Szűkítse a jelöltkészletet a vektorkeresés előtt a feldolgozott adatok mennyiségének csökkentése érdekében. Tekintse meg , hogyan működik a szűrés a vektoros lekérdezésekben.
Költségek csökkentése a használat minimalizálásával
A kiszolgáló nélküli modell csak a felhasznált erőforrásokért számít fel díjakat. Ha nincsenek kérések, a számítási használat ennek megfelelően csökken.
A használati költségek minimalizálása:
- Csak szükség esetén futtassa a lekérdezéseket.
- Kerülje a felesleges vagy túl gyakori kéréseket.
- A használat monitorozása és a számítási feladatok igény szerinti finomhangolása.
Tip
Ugyanaz a lekérdezés eltérő késéssel és CU-profilokkal rendelkezhet attól függően, hogy a szolgáltatás meleg vagy hideg. Az olvasási vagy írási forgalom nélküli időszak után a kiszolgáló nélküli díjszabási modell számítási használata nullára csökken. Előfordulhat, hogy a következő kérés nagyobb késleltetésű lesz, és több CU-t használ fel, amíg az adatútvonalak bemelegszenek. A nagyobb indexek általában hosszabb ideig melegednek, mint a kisebb indexek, így a hidegindítási hatások gyakran észrevehetőbbek a nagyobb szolgáltatásoknál.
Tárolási költségek optimalizálása
A tárterület számlázása GB/havonta történik a lemezindex mérete alapján, amely meghaladhatja a nyers adatméretet. A tárolási költségek csökkentése:
- Távolítsa el a nem használt indexeket.
- A tárolt mezők minimalizálása.
- Sémák tervezése a tárterület-terhelés figyelembevételével.
- Használjon javaslattevőket szelektíven, mert jelentősen növelhetik a tárterület méretét.
Vektorspecifikus technikákkal (tömörítési, metszési és tárolási beállításokkal) kapcsolatban lásd: Optimalizálás vektoros tároláshoz és feldolgozáshoz.
A tárolási és lekérdezési teljesítmény kompromisszumoivel kapcsolatos további útmutatásért lásd Tips for better performance in Azure AI Keresés.