Catatan
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba masuk atau mengubah direktori.
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba mengubah direktori.
Gunakan kit pemrosesan batch untuk melengkapi dan memperluas beban kerja pada kontainer Suara. Tersedia sebagai kontainer, utilitas sumber terbuka ini membantu memfasilitasi transkripsi batch untuk sejumlah besar file audio, di sejumlah titik akhir kontainer ucapan lokal dan berbasis cloud.
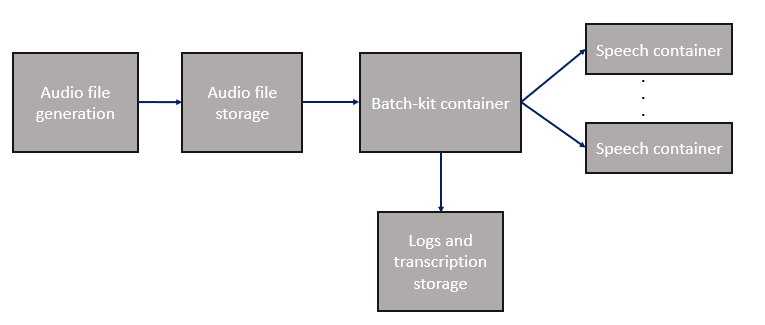
Kontainer batch kit tersedia secara gratis di GitHub dan hub Docker. Anda hanya ditagih untuk kontainer Ucapan yang Anda gunakan.
| Fitur | Deskripsi |
|---|---|
| Distribusi batch file audio | Secara otomatis mengirimkan sejumlah besar file ke titik akhir kontainer Ucapan berbasis lokal atau cloud. File dapat berada di volume yang mematuhi POSIX, termasuk sistem file jaringan. |
| Integrasi Speech SDK | Berikan bendera umum ke Speech SDK, termasuk: hipotesis terbaik n, diarisasi, bahasa, masking kata-kata kotor. |
| Mode Operasi | Jalankan klien batch sekali, terus-menerus di latar belakang, atau buat titik akhir HTTP untuk file audio. |
| Toleransi kegagalan | Coba kembali dan lanjutkan transkripsi secara otomatis tanpa kehilangan kemajuan, dan bedakan antara kesalahan mana yang dapat, dan tidak dapat dicoba kembali. |
| Deteksi ketersediaan titik akhir | Jika suatu titik akhir menjadi tidak tersedia, klien batch terus mentranskripsi dengan menggunakan titik akhir kontainer lainnya. Ketika klien tersedia, secara otomatis akan mulai menggunakan titik akhir. |
| Pertukaran panas titik akhir | Tambahkan, hapus, atau modifikasi titik akhir kontainer Ucapan selama runtime tanpa mengganggu kemajuan batch. Pembaruan segera dilakukan. |
| Pengelogan real time | Pencatatan log secara real-time dilakukan untuk permintaan yang dicoba, cap waktu, dan penyebab kegagalan, termasuk file log Speech SDK untuk setiap file audio. |
Proses audio panjang dengan aman
Kontainer Speech mendukung audio dengan durasi hingga 24 jam. Segmentasikan audio apa pun lebih dari 24 jam sebelum Anda mengirimkannya untuk transkripsi. Ukuran file bukan pengganti durasi yang andal karena pengodean, laju sampel, kedalaman bit, dan jumlah saluran menentukan jumlah byte. Misalnya, 1 GB bukan ambang batas segmentasi universal.
Beberapa alur audio menggunakan penghitung 32-bit untuk menghitung durasi. Sekitar 37,3 jam, penghitung dapat meluap dan menghasilkan durasi yang lebih pendek dan terlihat valid. Dalam hal ini, transkripsi dapat melaporkan keberhasilan tanpa memperingatkan bahwa hasilnya terpotong. Lokasi kode yang tepat dari overflow ini tidak diketahui.
Setelah transkripsi, bandingkan durasi audio asli dengan offset transkrip akhir atau tanda waktu terbaru yang dikenali. Anggap hasil yang berakhir jauh sebelum audio sumber berakhir sebagai tidak lengkap, meskipun transkripsi melaporkan keberhasilan.
Jika Anda mengonversi audio sumber ke RIFF/WAV, gunakan nilai-nilai ini untuk membantu mengidentifikasi tempat luapan terjadi:
- Panjang potongan data WAV yang dikonversi sebesar
274,568,704byte menunjukkan adanya luapan selama konversi atau penulisan file. - Panjang suatu chunk data sebesar
4,569,536,000byte, atau file yang lebih besar dari 4 GB dengan header yang benar, menunjukkan bahwa file tersebut ditulis dengan benar dan overflow terjadi pada tahap selanjutnya dalam alur pemrosesan. Hubungi dukungan Microsoft untuk melibatkan tim engineering dalam menangani kasus ini.
RF64 dan Wave64 (W64) bukan solusi pengganti langsung untuk masalah ini. Setiap pembaca dan jalur pemeriksaan durasi dalam alur harus mendukung format yang dipilih. Misalnya, modul bawaan wave Python menolak file RF64.
Dapatkan gambar kontainer dengan docker pull
Gunakan perintah docker pull untuk mengunduh container batch kit terbaru.
Catatan
Contoh berikut mengambil gambar kontainer publik dari Docker Hub. Sebaiknya autentikasi dengan akun Docker Hub Anda (docker login) terlebih dahulu alih-alih membuat permintaan pull anonim. Untuk meningkatkan keandalan saat menggunakan konten publik, impor dan kelola gambar dalam Azure container registry privat.
Pelajari lebih lanjut cara menangani citra publik.
docker pull docker.io/batchkit/speech-batch-kit:latest
Konfigurasi titik akhir
Klien batch menggunakan file konfigurasi YAML yang menentukan titik akhir kontainer lokal. Tulis contoh berikut ke /mnt/my_nfs/config.yaml, yang digunakan dalam contoh berikut.
MyContainer1:
  concurrency: 5
  host: 192.168.0.100
  port: 5000
  rtf: 3
MyContainer2:
  concurrency: 5
  host: BatchVM0.corp.redmond.microsoft.com
  port: 5000
  rtf: 2
MyContainer3:
  concurrency: 10
  host: localhost
  port: 6001
  rtf: 4
Contoh YAML ini menentukan tiga kontainer ucapan pada tiga host. Host pertama ditentukan oleh alamat IPv4, host kedua berjalan pada VM yang sama dengan klien batch, dan kontainer ketiga ditentukan oleh nama host DNS VM lain. Nilai concurrency menentukan transkripsi file bersamaan maksimum yang dapat berjalan pada kontainer yang sama. Nilai rtf (Real-Time Factor) bersifat opsional dan dapat digunakan untuk menyetel performa.
Klien batch memiliki kemampuan untuk secara dinamis mendeteksi apakah titik akhir tidak tersedia (misalnya, karena restart kontainer atau masalah jaringan), dan ketika titik akhir tersedia kembali. Permintaan transkripsi tidak dikirim ke kontainer yang tidak tersedia, dan klien terus menggunakan kontainer lain yang tersedia. Anda dapat menambahkan, menghapus, atau mengedit titik akhir kapan saja tanpa mengganggu kemajuan batch Anda.
Jalankan kontainer pemrosesan batch
Catatan
- Contoh ini menggunakan direktori yang sama (
/my_nfs) untuk file konfigurasi dan direktori input, output, dan log. Anda dapat menggunakan direktori yang dihosting atau dipasang NFS untuk folder ini. - Menjalankan klien dengan flag
–hakan mencantumkan parameter baris perintah yang tersedia dan nilai defaultnya. - Kontainer pemrosesan batch hanya didukung di Linux.
Gunakan perintah run Docker untuk memulai kontainer. Perintah ini memulai shell interaktif di dalam kontainer.
docker run --network host --rm -ti -v /mnt/my_nfs:/my_nfs --entrypoint /bin/bash /mnt/my_nfs:/my_nfs docker.io/batchkit/speech-batch-kit:latest
Untuk menjalankan klien batch:
run-batch-client -config /my_nfs/config.yaml -input_folder /my_nfs/audio_files -output_folder /my_nfs/transcriptions -log_folder /my_nfs/logs -file_log_level DEBUG -nbest 1 -m ONESHOT -diarization None -language en-US -strict_config
Untuk menjalankan klien batch dan kontainer dalam satu perintah:
docker run --network host --rm -ti -v /mnt/my_nfs:/my_nfs docker.io/batchkit/speech-batch-kit:latest -config /my_nfs/config.yaml -input_folder /my_nfs/audio_files -output_folder /my_nfs/transcriptions -log_folder /my_nfs/logs
Klien mulai dijalankan. Jika file audio ditranskripsikan dalam proses sebelumnya, klien secara otomatis melewati file. File dikirim dengan mekanisme coba lagi otomatis jika terjadi kesalahan sementara, dan Anda dapat membedakan kesalahan mana yang harus dicoba ulang oleh klien. Pada kesalahan transkripsi, klien melanjutkan transkripsi, dan dapat mencoba kembali tanpa kehilangan kemajuan.
Mode Operasi
Kit pemrosesan batch menawarkan tiga mode, menggunakan parameter --run-mode.
Mode ONESHOT mentranskripsikan satu batch file audio (dari direktori input dan daftar file opsional) ke folder output.
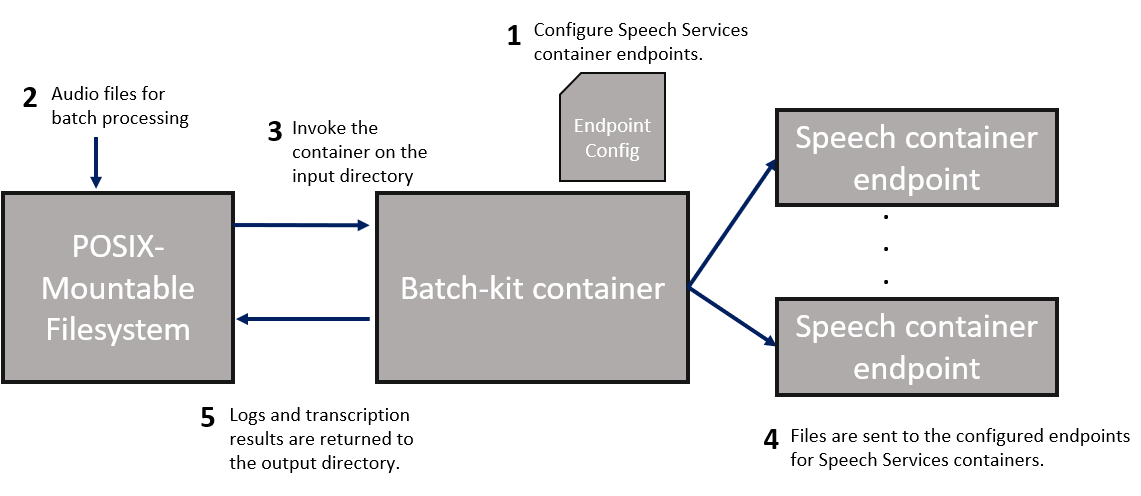
- Tentukan titik akhir kontainer Ucapan yang digunakan oleh klien batch di dalam file
config.yaml. - Tempatkan file audio untuk transkripsi di direktori input.
- Panggil kontainer pada direktori untuk mulai memproses file. Jika file audio sudah ditranskripsikan dalam eksekusi sebelumnya dengan direktori output yang sama (nama file dan checksum yang sama), klien melewati file.
- File dikirim ke titik akhir kontainer dari langkah 1.
- Log dan output kontainer Ucapan ditampilkan ke direktori output yang ditentukan.
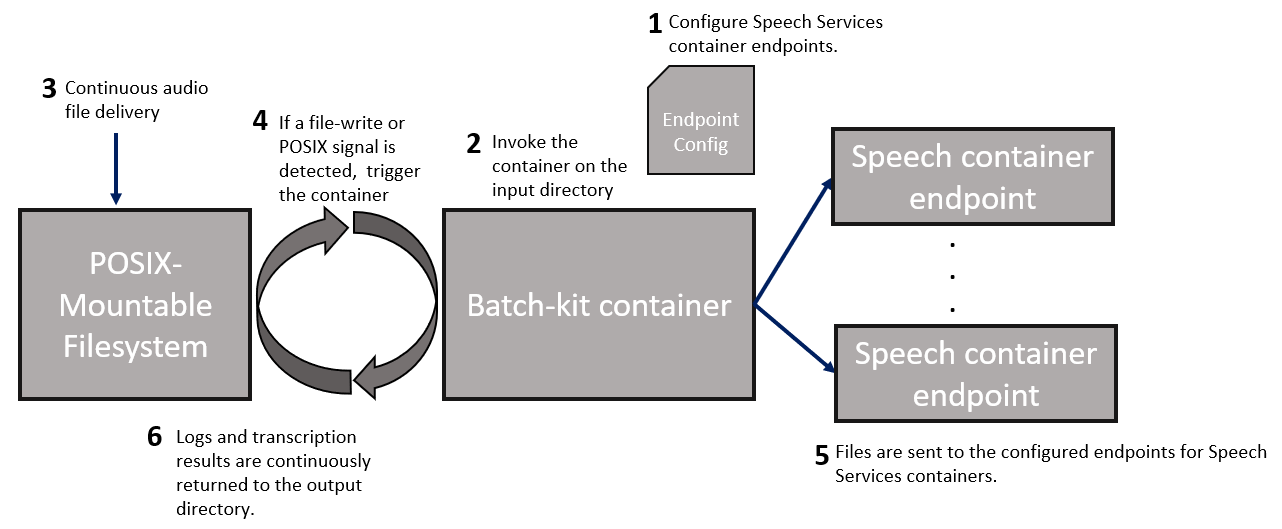

Pencatatan
Catatan
Klien batch dapat menimpa file run.log secara berkala jika terlalu besar.
Klien membuat file run.log dalam direktori yang ditentukan oleh argumen -log_folder dalam perintah run docker. Log dicatat pada level DEBUG secara standar. Log yang sama dikirim ke stdout/stderr, dan difilter tergantung pada argumen -file_log_level atau console_log_level. Log ini hanya diperlukan untuk debugging, atau jika Anda perlu mengirim log untuk dukungan. Folder pengelogan juga berisi log Speech SDK untuk setiap file audio.
Direktori output yang ditentukan dengan -output_folder berisi file run_summary.json , yang ditulis ulang secara berkala setiap 30 detik atau setiap kali transkripsi baru selesai. Anda dapat menggunakan file ini untuk memeriksa kemajuan saat batch berlangsung. Ini juga berisi statistik eksekusi akhir dan status akhir setiap file ketika batch selesai. Batch selesai saat proses berakhir tanpa kesalahan.