Catatan
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba masuk atau mengubah direktori.
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba mengubah direktori.
Panduan ini menunjukkan cara memvalidasi ketahanan kluster Valkey yang disebarkan pada Azure Kubernetes Service (AKS) menggunakan kerangka kerja pengujian beban Locust. Ini berjalan melalui membangun klien pengujian, menyebarkannya ke AKS, mensimulasikan kegagalan, dan menganalisis perilaku kluster.
Note
Artikel ini berisi referensi ke istilah master (utama), yang merupakan istilah yang tidak lagi digunakan Microsoft. Ketika istilah dihapus dari perangkat lunak Valkey, kami akan menghapusnya dari artikel ini.
Membuat contoh aplikasi klien untuk Valkey
Langkah-langkah berikut menunjukkan cara membuat aplikasi klien sampel untuk Valkey.
Aplikasi klien sampel menggunakan kerangka kerja pengujian beban Locust untuk mensimulasikan beban kerja pada kluster Valkey yang Anda konfigurasi dan sebarkan. Kode Python mengimplementasikan kelas Pengguna Locust yang terhubung ke kluster Valkey dan melakukan operasi set dan get. Anda dapat memperluas kelas ini untuk menerapkan operasi yang lebih kompleks.
Note
Kami menyarankan agar Anda menggunakan alur autentikasi paling aman yang tersedia. Alur autentikasi yang dijelaskan dalam prosedur ini memerlukan tingkat kepercayaan yang sangat tinggi pada aplikasi dan membawa risiko yang tidak ada di alur lain. Anda hanya boleh menggunakan alur ini ketika alur lain yang lebih aman, seperti identitas terkelola, tidak layak.
Buat Dockerfile dan
requirements.txtdan letakkan di direktori baru menggunakan perintah berikut:mkdir valkey-client cd valkey-client cat > Dockerfile <<EOF FROM python:3.10-slim-bullseye COPY requirements.txt . COPY locustfile.py . RUN pip install --upgrade pip && pip install --no-cache-dir -r requirements.txt EOF cat > requirements.txt <<EOF valkey locust EOFlocustfile.pyBuat file yang berisi kode aplikasi klien Valkey:cat > locustfile.py <<EOF import time from locust import between, task, User, events,tag, constant_throughput from valkey import ValkeyCluster from random import randint class ValkeyLocust(User): wait_time = constant_throughput(50) host = "valkey-cluster.valkey.svc.cluster.local" def __init__(self, *args, **kwargs): super(ValkeyLocust, self).__init__(*args, **kwargs) self.client = ValkeyClient(host=self.host) def on_stop(self): self.client.close() @task @tag("set") def set_value(self): self.client.set_value("set_value") @task @tag("get") def get_value(self): self.client.get_value("get_value") class ValkeyClient(object): def __init__(self, host, *args, **kwargs): super().__init__(*args, **kwargs) with open("/etc/valkey-password/valkey-password-file.conf", "r") as f: self.password = f.readlines()[0].split(" ")[1].strip() self.host = host self.vc = ValkeyCluster(host=self.host, port=6379, password=self.password, username="default", cluster_error_retry_attempts=0, socket_timeout=2, keepalive=1 ) def set_value(self, key, command='SET'): start_time = time.perf_counter() try: result = self.vc.set(randint(0, 1000), randint(0, 1000)) if not result: result = '' length = len(str(result)) total_time = (time.perf_counter()- start_time) * 1000 events.request.fire( request_type=command, name=key, response_time=total_time, response_length=length, ) except Exception as e: total_time = (time.perf_counter()- start_time) * 1000 events.request.fire( request_type=command, name=key, response_time=total_time, response_length=0, exception=e ) result = '' return result def get_value(self, key, command='GET'): start_time = time.perf_counter() try: result = self.vc.get(randint(0, 1000)) if not result: result = '' length = len(str(result)) total_time = (time.perf_counter()- start_time) * 1000 events.request.fire( request_type=command, name=key, response_time=total_time, response_length=length, ) except Exception as e: total_time = (time.perf_counter()- start_time) * 1000 events.request.fire( request_type=command, name=key, response_time=total_time, response_length=0, exception=e ) result = '' return result EOF
Membangun dan mengunggah image Docker ke ACR
Buat gambar Docker dan unggah ke Azure Container Registry (ACR) menggunakan
az acr buildperintah .az acr build --image valkey-client --registry ${MY_ACR_REGISTRY} .Verifikasi bahwa gambar berhasil didorong menggunakan perintah
az acr repository list.az acr repository list --name ${MY_ACR_REGISTRY} --output tableOutput harus menampilkan gambar
valkey-client, seperti dalam contoh berikut:Result ---------------- valkey-client
Menyebarkan pod klien sampel ke AKS
Buat yang
Podmenggunakan gambar klien Valkey yang dibangun pada langkah sebelumnya menggunakankubectl applyperintah . Spesifikasi pod berisi volume Secret Store CSI dengan kata sandi Valkey yang digunakan klien untuk terhubung ke kluster Valkey.kubectl apply -f - <<EOF --- kind: Pod apiVersion: v1 metadata: name: valkey-client namespace: valkey spec: affinity: nodeAffinity: requiredDuringSchedulingIgnoredDuringExecution: nodeSelectorTerms: - matchExpressions: - key: agentpool operator: In values: - nodepool1 containers: - name: valkey-client image: ${MY_ACR_REGISTRY}.azurecr.io/valkey-client command: ["locust", "--processes", "4"] volumeMounts: - name: valkey-password mountPath: "/etc/valkey-password" volumes: - name: valkey-password csi: driver: secrets-store.csi.k8s.io readOnly: true volumeAttributes: secretProviderClass: "valkey-password" EOFTeruskan port 8089 untuk mengakses antarmuka web Locust pada komputer lokal Anda menggunakan
kubectl port-forwardperintah .kubectl port-forward -n valkey valkey-client 8089:8089Akses antarmuka web Locust di
http://localhost:8089dan mulai pengujian. Anda dapat menyesuaikan jumlah pengguna dan tingkat spawn untuk mensimulasikan beban kerja pada kluster Valkey. Grafik berikut menggunakan 100 pengguna dan tarif 10 spawn: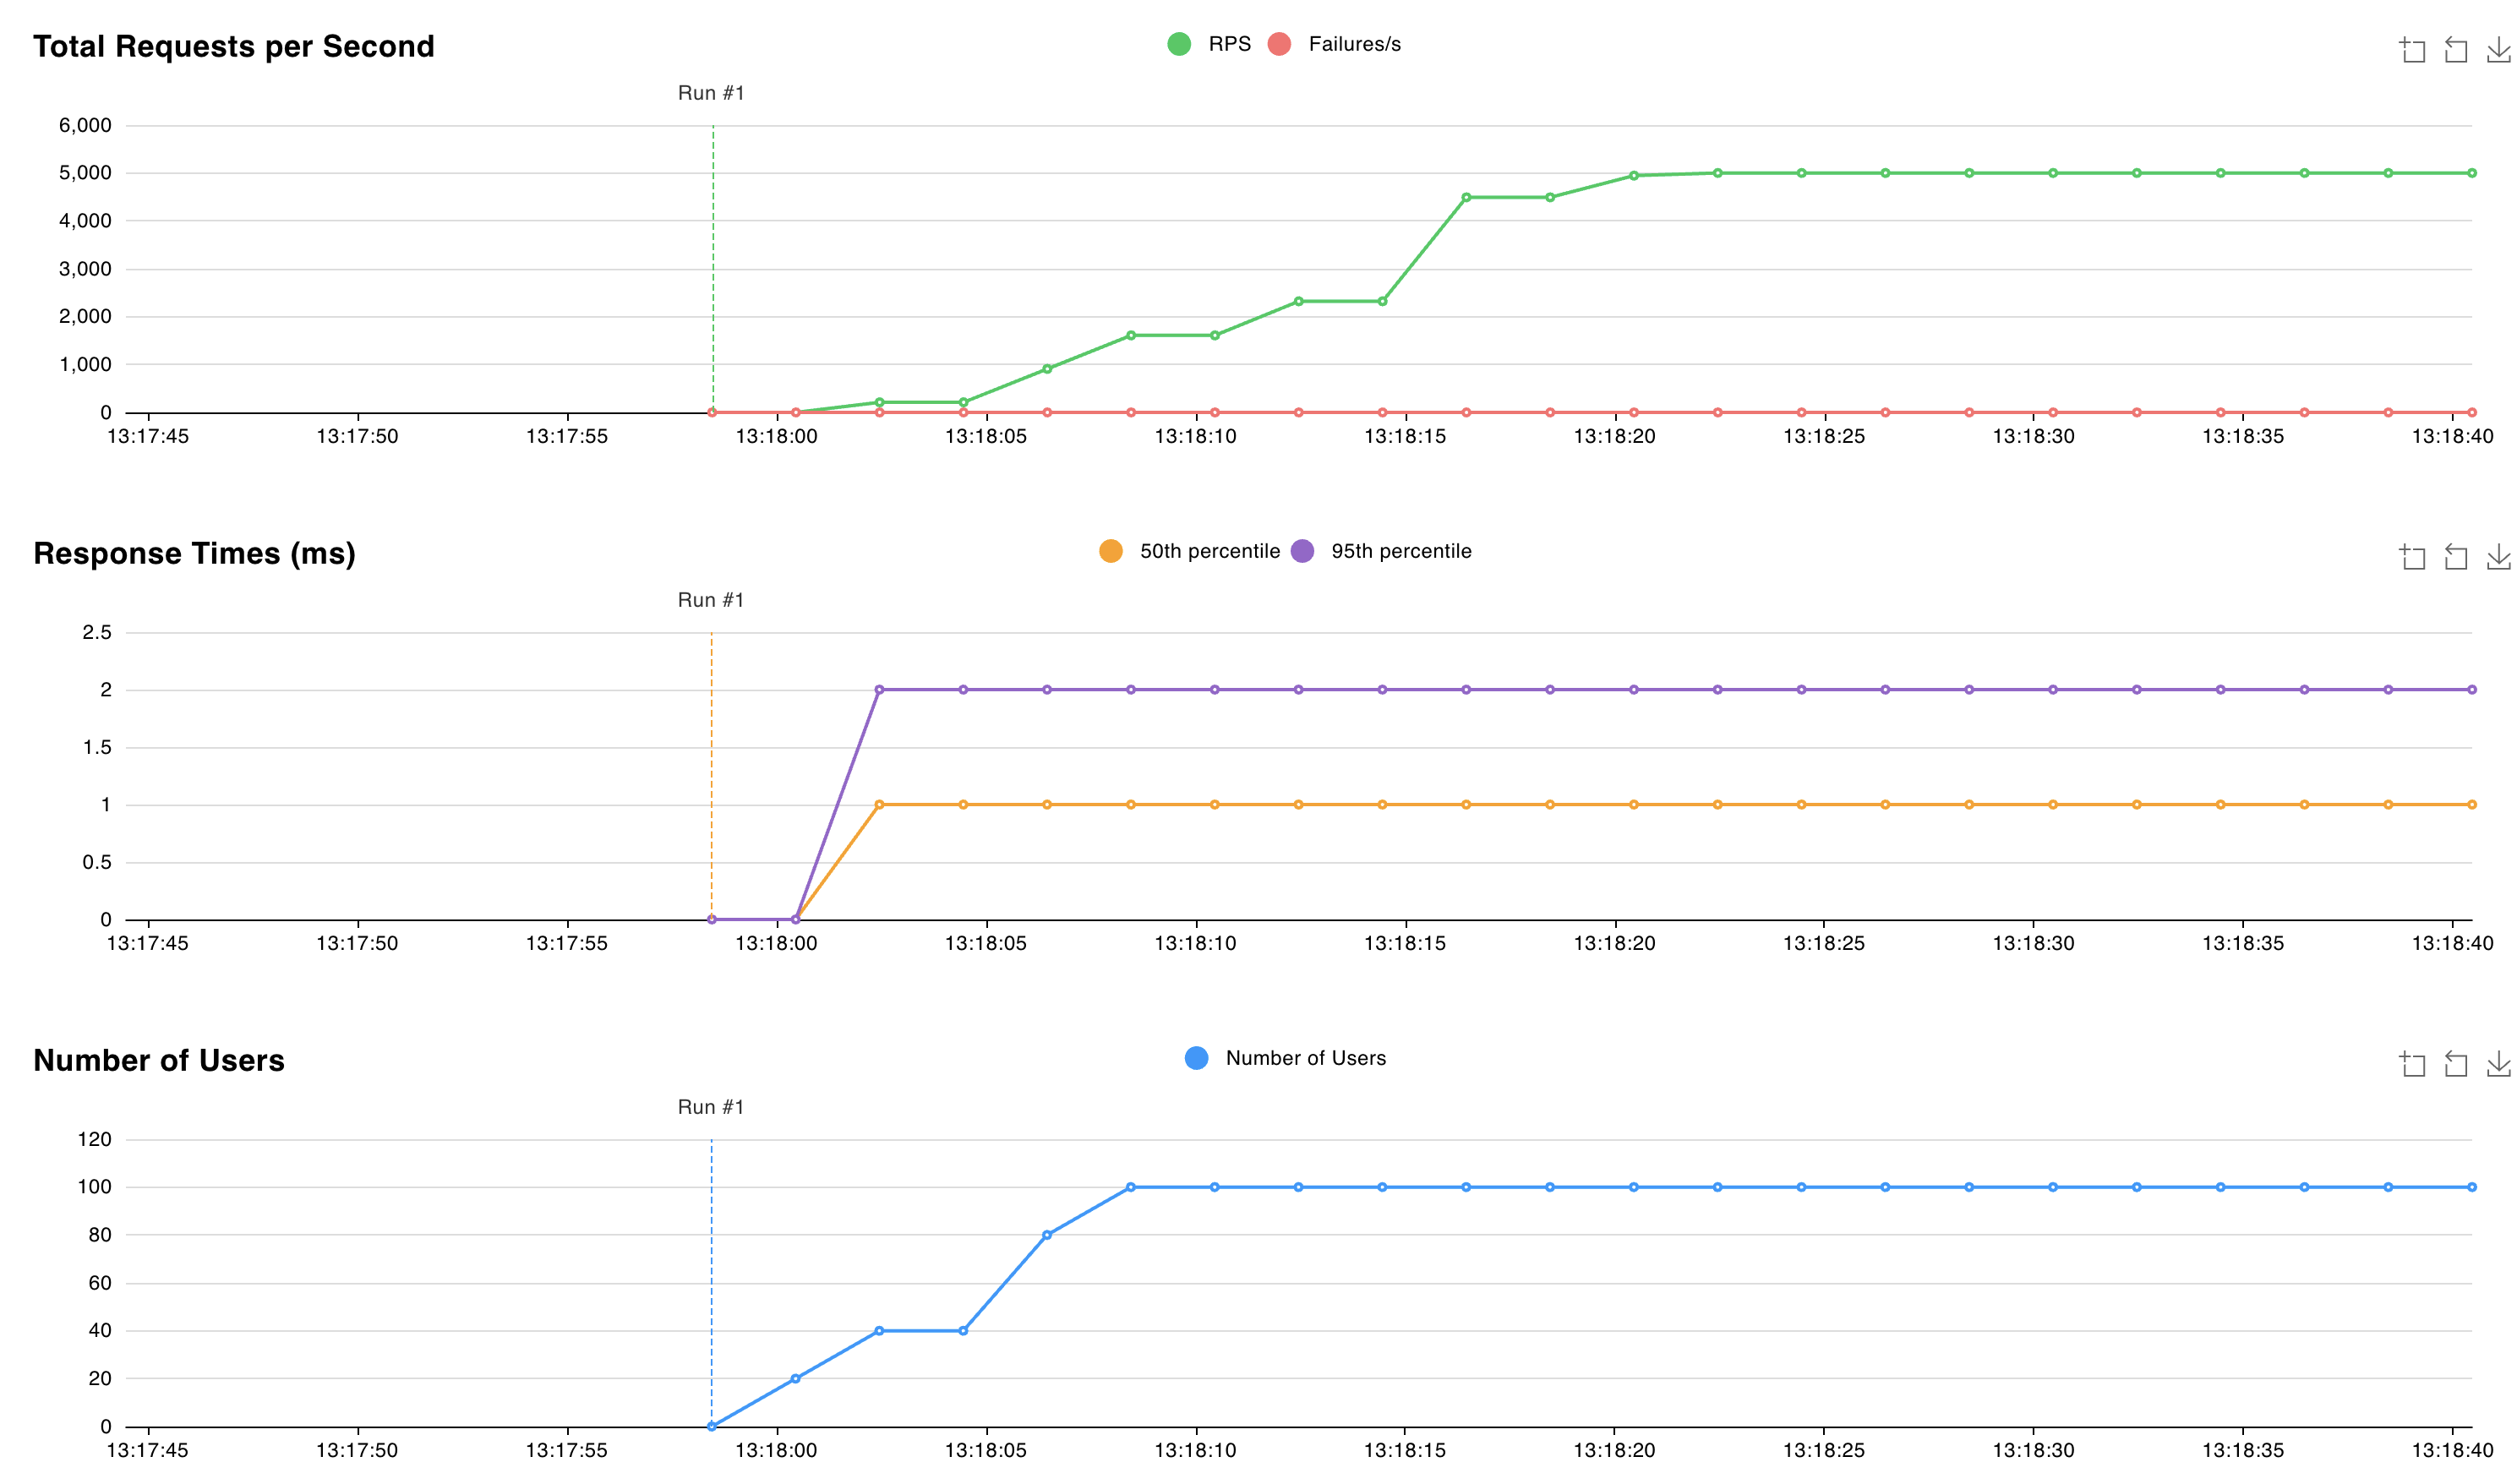
Mensimulasikan kegagalan dan mengamati perilaku kluster Valkey
Simulasikan pemadaman dengan menghapus
StatefulSetmenggunakankubectl deleteperintah dengan--cascade=orphanbendera . Tujuannya adalah agar dapat menghapus satu pod tanpaStatefulSetlangsung menghidupkan kembali pod yang dihapus.kubectl delete statefulset valkey-masters --cascade=orphanHapus pod menggunakan perintah
kubectl delete pod.kubectl delete pod valkey-masters-0Periksa daftar pod menggunakan perintah
kubectl get pods.kubectl get podsOutput harus menunjukkan bahwa pod
valkey-masters-0telah dihapus. Pod lain harus dalam statusRunning, seperti yang ditunjukkan dalam contoh berikut:NAME READY STATUS RESTARTS AGE valkey-client 1/1 Running 0 6m34s valkey-masters-1 1/1 Running 0 16m valkey-masters-2 1/1 Running 0 16m valkey-replicas-0 1/1 Running 0 16m valkey-replicas-1 1/1 Running 0 16m valkey-replicas-2 1/1 Running 0 16mDapatkan log
valkey-replicas-0pod menggunakan perintahkubectl logs valkey-replicas-0.kubectl logs valkey-replicas-0Dalam output, kami mengamati bahwa peristiwa lengkap berlangsung selama sekitar 18 detik:
1:S 05 Nov 2024 12:18:53.961 * Connection with primary lost.
1:S 05 Nov 2024 12:18:53.961 * Caching the disconnected primary state.
1:S 05 Nov 2024 12:18:53.961 * Reconnecting to PRIMARY 10.224.0.250:6379
1:S 05 Nov 2024 12:18:53.961 * PRIMARY <-> REPLICA sync started
1:S 05 Nov 2024 12:18:53.964 # Error condition on socket for SYNC: Connection refused
1:S 05 Nov 2024 12:18:54.910 * Connecting to PRIMARY 10.224.0.250:6379
1:S 05 Nov 2024 12:18:54.910 * PRIMARY <-> REPLICA sync started
1:S 05 Nov 2024 12:18:54.912 # Error condition on socket for SYNC: Connection refused
1:S 05 Nov 2024 12:18:55.920 * Connecting to PRIMARY 10.224.0.250:6379
[..CUT..]
1:S 05 Nov 2024 12:19:10.056 * Connecting to PRIMARY 10.224.0.250:6379
1:S 05 Nov 2024 12:19:10.057 * PRIMARY <-> REPLICA sync started
1:S 05 Nov 2024 12:19:10.058 # Error condition on socket for SYNC: Connection refused
1:S 05 Nov 2024 12:19:10.709 * Node c44d4b682b6fb9b37033d3e30574873545266d67 () reported node 9e7c43890613cc3ad4006a9cdc0b5e5fc5b6d44e     () as not reachable.
1:S 05 Nov 2024 12:19:10.864 * NODE 9e7c43890613cc3ad4006a9cdc0b5e5fc5b6d44e () possibly failing.
1:S 05 Nov 2024 12:19:11.066 * 10000 changes in 60 seconds. Saving...
1:S 05 Nov 2024 12:19:11.068 * Background saving started by pid 29
1:S 05 Nov 2024 12:19:11.068 * Connecting to PRIMARY 10.224.0.250:6379
1:S 05 Nov 2024 12:19:11.068 * PRIMARY <-> REPLICA sync started
1:S 05 Nov 2024 12:19:11.069 # Error condition on socket for SYNC: Connection refused
29:C 05 Nov 2024 12:19:11.090 * DB saved on disk
29:C 05 Nov 2024 12:19:11.090 * Fork CoW for RDB: current 0 MB, peak 0 MB, average 0 MB
1:S 05 Nov 2024 12:19:11.169 * Background saving terminated with success
1:S 05 Nov 2024 12:19:11.884 * FAIL message received from ba36d5167ee6016c01296a4a0127716f8edf8290 () about     9e7c43890613cc3ad4006a9cdc0b5e5fc5b6d44e ()
1:S 05 Nov 2024 12:19:11.884 # Cluster state changed: fail
1:S 05 Nov 2024 12:19:11.974 * Start of election delayed for 510 milliseconds (rank #0, offset 7225807).
1:S 05 Nov 2024 12:19:11.976 * Node d43f370a417d299b78bd1983792469fe5c39dcdf () reported node 9e7c43890613cc3ad4006a9cdc0b5e5fc5b6d44e     () as not reachable.
1:S 05 Nov 2024 12:19:12.076 * Connecting to PRIMARY 10.224.0.250:6379
1:S 05 Nov 2024 12:19:12.076 * PRIMARY <-> REPLICA sync started
1:S 05 Nov 2024 12:19:12.076 * Currently unable to failover: Waiting the delay before I can start a new failover.
1:S 05 Nov 2024 12:19:12.078 # Error condition on socket for SYNC: Connection refused
1:S 05 Nov 2024 12:19:12.581 * Starting a failover election for epoch 15.
1:S 05 Nov 2024 12:19:12.616 * Currently unable to failover: Waiting for votes, but majority still not reached.
1:S 05 Nov 2024 12:19:12.616 * Needed quorum: 2. Number of votes received so far: 1
1:S 05 Nov 2024 12:19:12.616 * Failover election won: I'm the new primary.
1:S 05 Nov 2024 12:19:12.616 * configEpoch set to 15 after successful failover
1:M 05 Nov 2024 12:19:12.616 * Discarding previously cached primary state.
1:M 05 Nov 2024 12:19:12.616 * Setting secondary replication ID to c0b5b2df8a43b19a4d43d8f8b272a07139e0ca34, valid up to offset:     7225808. New replication ID is 029fcfbae0e3e4a1dccd73066043deba6140c699
1:M 05 Nov 2024 12:19:12.616 * Cluster state changed: ok
Selama jendela waktu 18 detik ini, kami mengamati bahwa menulis ke shard milik pod yang dihapus gagal, dan kluster Valkey memilih primer baru. Latensi permintaan melonjakan hingga 60 md selama jendela waktu ini.
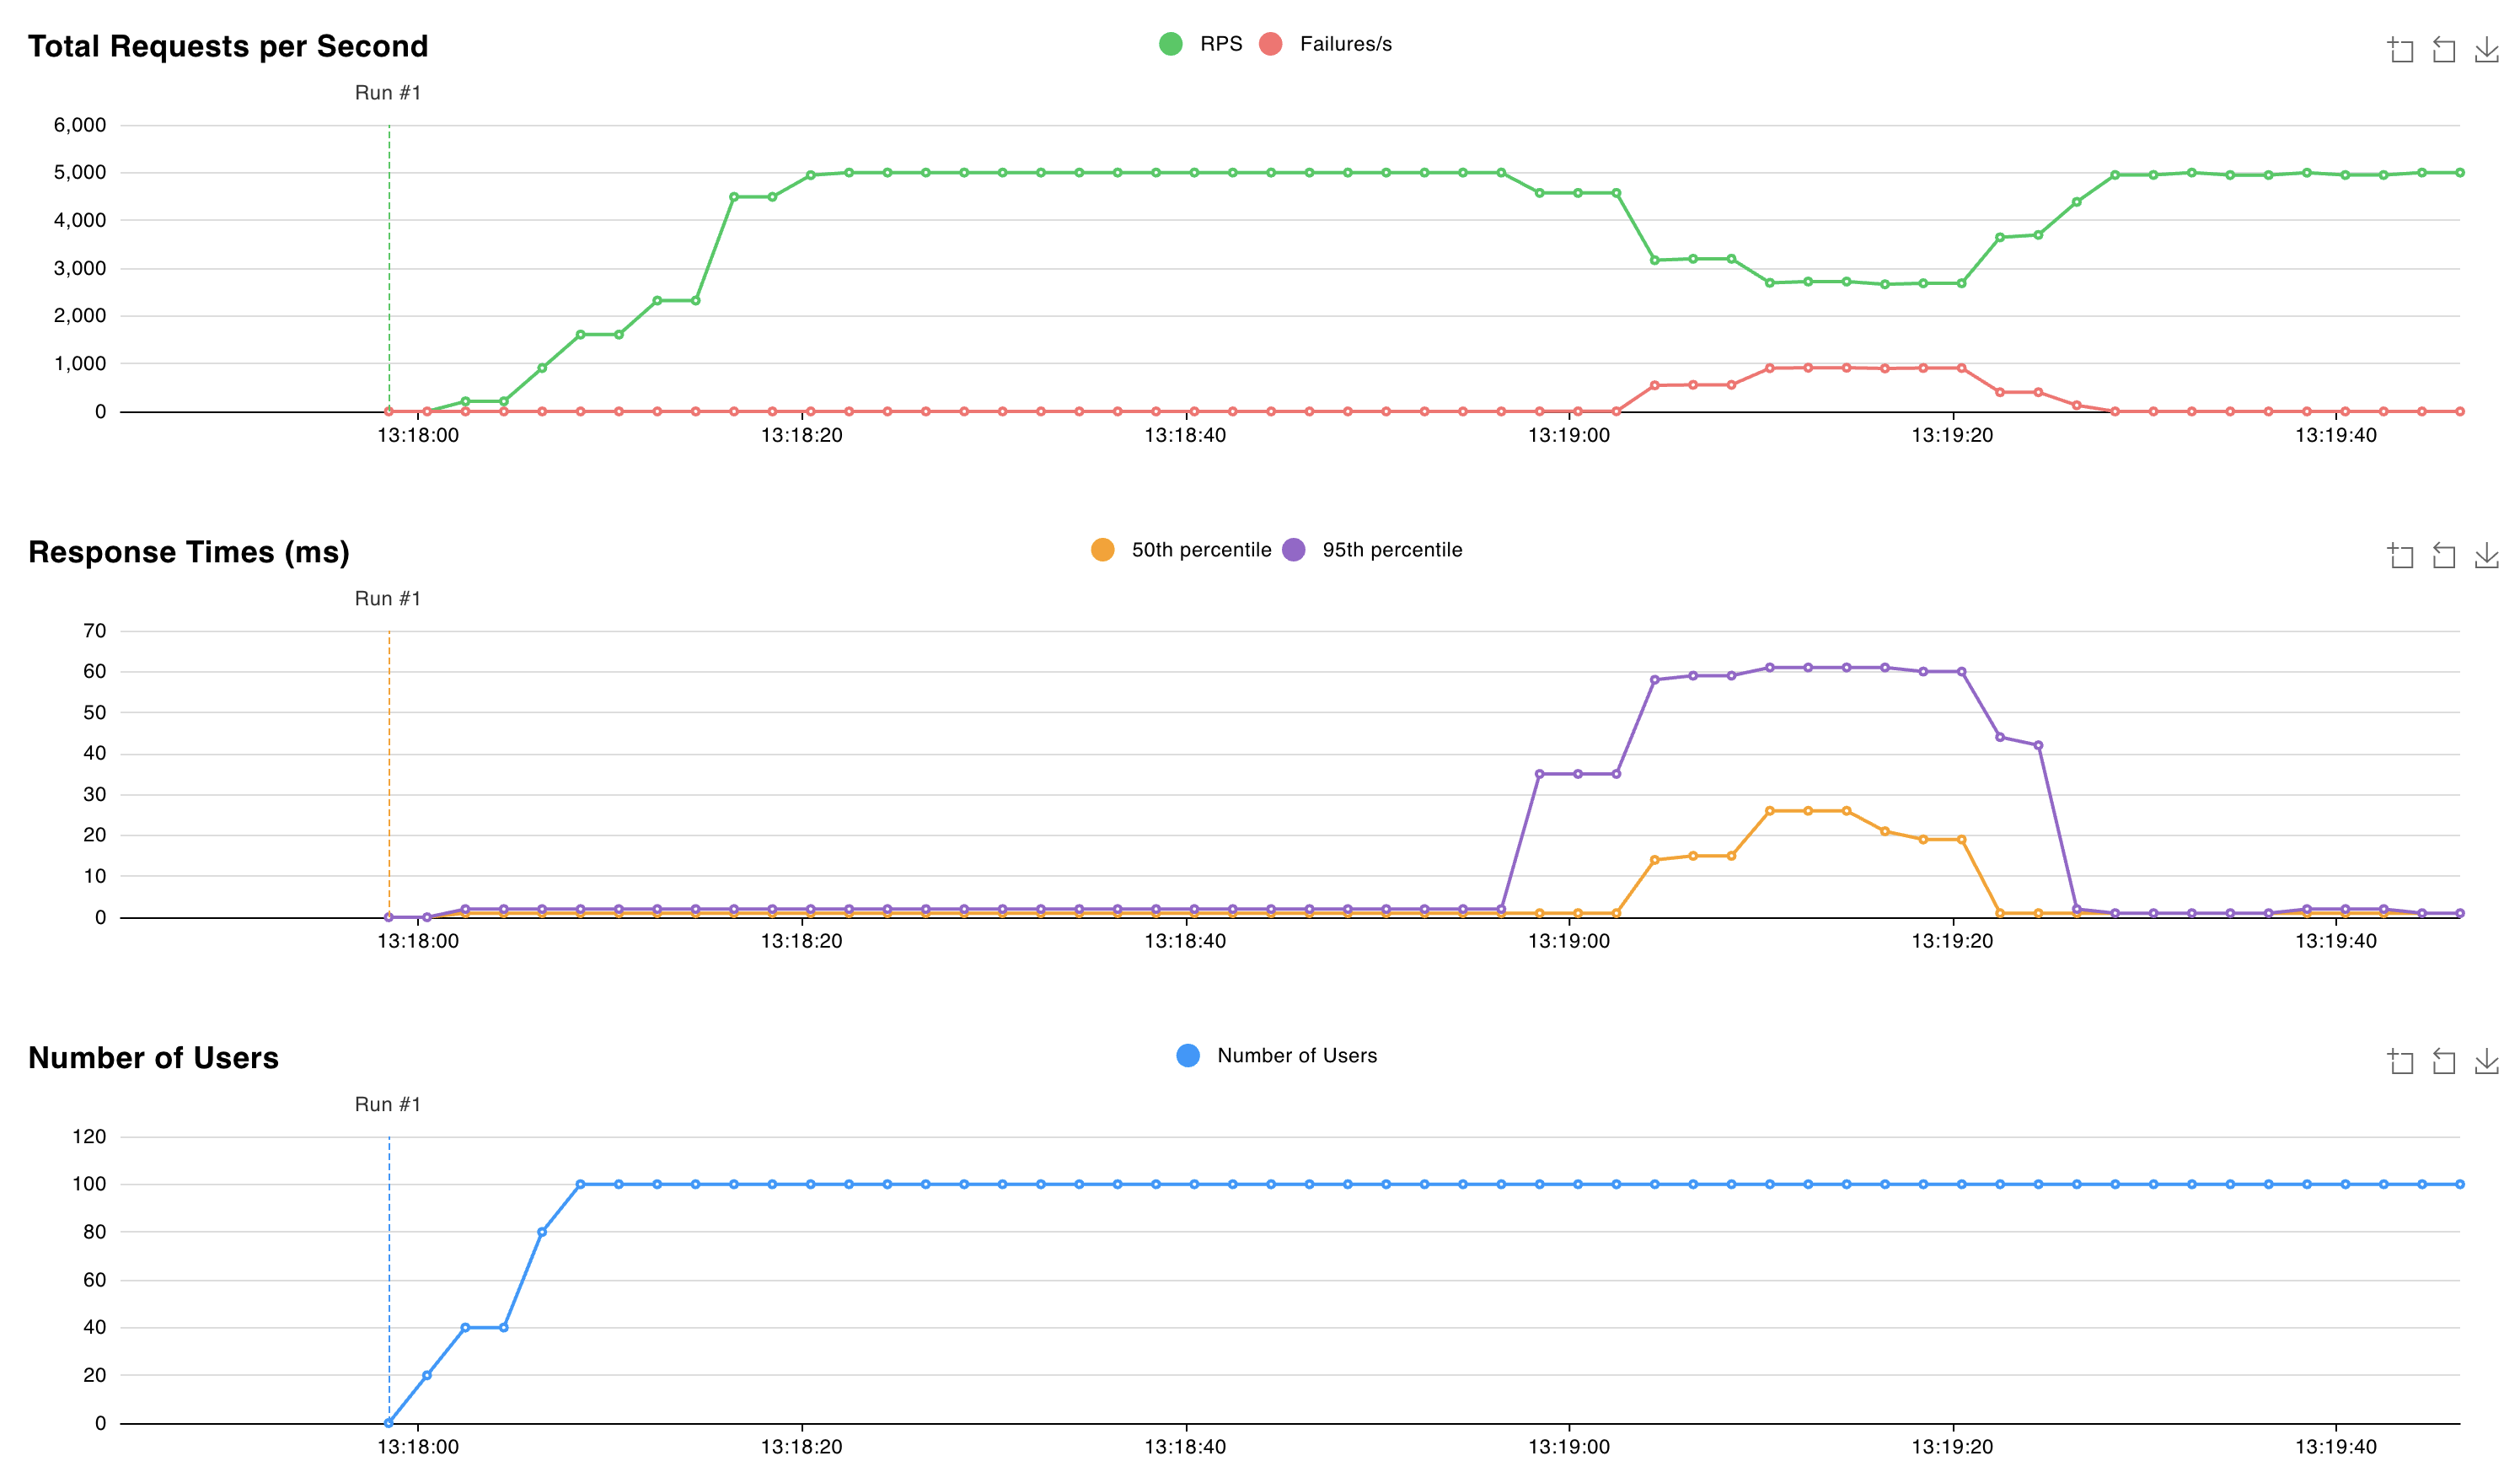
Setelah pemimpin primer baru dipilih, kluster Valkey terus melayani permintaan dengan latensi sekitar 2 ms.
Langkah selanjutnya
Contributors
Microsoft mempertahankan artikel ini. Kontributor berikut awalnya menulisnya:
- Nelly Kiboi | Teknisi Layanan
- Saverio Proto | Teknisi Pengalaman Pelanggan Utama