Catatan
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba masuk atau mengubah direktori.
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba mengubah direktori.
File Azure NetApp
Microsoft Fabric
Pencarian Azure AI
Microsoft Foundry
Pembelajaran Mesin Azure
Ide solusi
Artikel ini menjelaskan ide solusi. Arsitek cloud Anda dapat menggunakan panduan ini untuk membantu memvisualisasikan komponen utama untuk implementasi khas arsitektur ini. Gunakan artikel ini sebagai titik awal untuk merancang solusi yang dirancang dengan baik yang selaras dengan persyaratan spesifik beban kerja Anda.
Ide solusi ini menjelaskan bagaimana Azure NetApp Files Object REST API membantu organisasi menggunakan data file perusahaan yang ada untuk analitik dan AI tanpa terlebih dahulu menyalinnya ke penyimpanan objek terpisah. Aplikasi yang kompatibel dengan Amazon S3 dapat mendukung pencarian dokumen dan analisis yang dibantu AI saat alur kerja NFS dan SMB yang ada terus mengakses data tersebut. Menghindari salinan data sumber terpisah dapat mengurangi waktu untuk melakukan onboarding beban kerja analitik, mengurangi biaya penyimpanan duplikat, dan menghapus alur sinkronisasi yang akan dibuat, dipantau, dan dipecahkan oleh tim. Lebih sedikit repositori data sumber juga berarti lebih sedikit salinan untuk diatur dan dilindungi. Pendekatan ini mendukung modernisasi inkremental tanpa mengharuskan organisasi mengganti aplikasi berbasis file yang ada.
Architecture
Arsitektur ini berfokus pada integrasi Microsoft Fabric dengan Azure NetApp Files melalui Object REST API. Diagram ini juga menunjukkan Azure Databricks sebagai konsumen analitik alternatif dari data Azure NetApp Files yang sama. Anda tidak perlu menyebarkan kedua platform. Aplikasi yang ada terus mengakses data melalui NFS atau SMB, tergantung pada konfigurasi volume dan persyaratan klien.
Azure Databricks komputasi mengakses titik akhir AZURE NETAPP FILES Object REST API melalui permintaan yang kompatibel dengan S3 dengan menggunakan konektor Hadoop S3A. Jalur analitik alternatif ini tidak menggunakan gateway data lokal atau Microsoft OneLake.
Layanan AI hilir dalam diagram ilustrasi. Integrasi penyerapan mereka tidak ditampilkan.
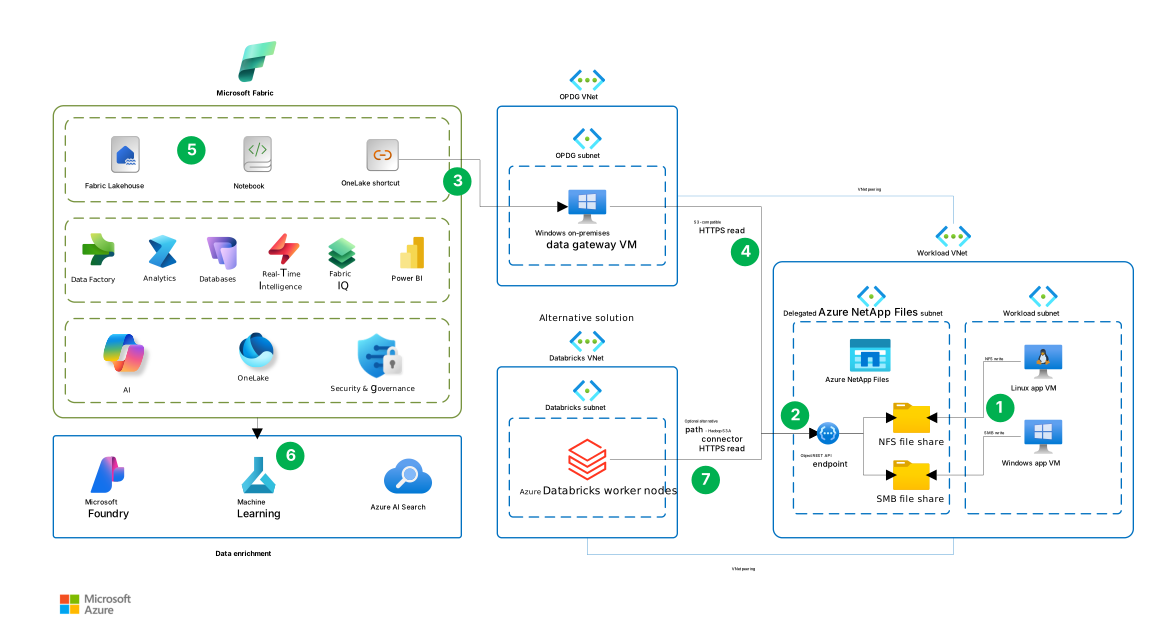
Unduh file Visio dari arsitektur ini.
Aliran Data
Interaksi bernomor berikut menjelaskan diagram arsitektur. Langkah 1 sampai 5 menjelaskan jalur Microsoft Fabric utama. Langkah 6 mewakili pengayaan data hilir opsional. Langkah 7 adalah jalur analitik alternatif, bukan kelanjutan alur Fabric. Panah berlabel BACA HTTPS memperlihatkan permintaan menuju titik akhir REST API Objek; data yang diminta kembali ke konsumen.
Aplikasi menulis data file. Di subnet Beban Kerja, VM aplikasi Linux menulis ke berbagi file NFS, dan VM aplikasi Windows menulis ke berbagi file SMB. Azure NetApp Files menghosting kedua berbagi di subnet yang didelegasikan.
REST API Objek mengekspos data file. Titik akhir di subnet ANF yang Didelegasikan menyediakan akses yang kompatibel dengan S3 ke direktori yang dikonfigurasi pada volume Azure NetApp Files. Koneksi dari titik akhir ke berbagi NFS dan SMB mewakili akses ke data yang ada, bukan salinan ke penyimpanan objek terpisah.
Fabric mengakses data melalui pintasan OneLake. Pintasan mereferensikan data Azure NetApp Files melalui koneksi yang menggunakan VM gateway data lokal Windows di subnet OPDG (gateway data lokal). Pintasan OneLake tersambung ke gateway ini.
Gateway membaca dari Object REST API. Gateway menggunakan peering antara OPDG VNet dan VNet Beban Kerja untuk mencapai titik akhir. Jalur baca HTTPS yang kompatibel dengan S3 menyambungkan gateway ke titik akhir, yang mengakses data file yang dirujuk untuk Fabric. Untuk persyaratan koneksi, lihat Menyambungkan OneLake ke volume Azure NetApp Files.
Fabric memproses dan menganalisis data. Beban kerja Fabric yang didukung menggunakan data melalui pintasan. Misalnya, notebook membaca file yang dirujuk dan menulis hasil turunan ke tabel lakehouse untuk analisis dan pelaporan Power BI. Kotak Fabric dalam diagram menunjukkan kemampuan pemrosesan dan analitik ini.
Layanan hilir opsional memperkaya data. Panah di bawah ini Fabric mengarah ke grup Pengayaan data, yang berisi Microsoft Foundry, Azure Machine Learning, dan Pencarian Azure AI. Langkah ini mewakili pemrosesan hilir opsional. Diagram tidak menunjukkan penyerapan atau orkestrasi yang diperlukan untuk menghubungkan layanan ini, dan pintasan OneLake tidak membuat integrasi tersebut.
Atau, Azure Databricks membaca data file secara langsung. Simpul pekerja di subnet Databricks menggunakan konektor Hadoop S3A untuk mengirim permintaan baca HTTPS ke titik akhir REST API Objek yang sama melalui jaringan virtual yang di-peering. Jalur ini menggantikan jalur akses dan pemrosesan Fabric di langkah 3 hingga 5. Ini tidak melewati gateway data lokal atau OneLake.
Pilih lokasi pintasan berdasarkan cara Anda ingin menggunakan data:
- Tabel Delta yang kompatibel yang ada. Buat pintasan tabel di bagian Tabel lakehouse, yang menargetkan tabel Delta lengkap, termasuk log transaksinya. Fabric mengenali target sebagai tabel yang dapat Anda kueri melalui Spark dan titik akhir analitik SQL, sementara data sumber tetap berada di Azure NetApp Files.
- File untuk akses atau pemrosesan langsung. Buat pintasan di bagian File lakehouse. Beban kerja yang kompatibel dapat membaca file Parquet, CSV, dan JSON mandiri, selain dokumen, tanpa terlebih dahulu menyalin file sumber ke OneLake. Saat analitik hilir memerlukan tabel lakehouse, ubah atau muat data sumber menjadi tabel Delta turunan di OneLake.
File Parquet mandiri tidak secara otomatis tabel Delta. Pintasan di File tidak secara otomatis mendaftarkan targetnya sebagai tabel. Untuk informasi selengkapnya, lihat Tempat menempatkan pintasan di lakehouse.
Components
Komponen berikut mendukung arsitektur yang berfokus pada Fabric dan alternatif Azure Databricks opsional.
Azure NetApp Files adalah layanan penyimpanan file terkelola penuh yang dibangun berdasarkan teknologi NetApp. Dalam arsitektur ini, ia menyimpan himpunan data perusahaan dan menyediakan akses objek yang kompatibel dengan NFS, SMB, dan S3 melalui Object REST API. Ini juga menyediakan kemampuan rekam jepret dan replikasi.
Azure NetApp Files Object REST API mengekspos data file yang ada melalui antarmuka yang kompatibel dengan S3. Dalam arsitektur ini, ini memungkinkan analitik yang kompatibel dan aplikasi AI untuk mengakses data tanpa terlebih dahulu membuat salinan penyimpanan objek terpisah. Antarmuka mendukung subset operasi Amazon S3. Konfirmasikan bahwa operasi yang didukung memenuhi persyaratan aplikasi Anda sebelum memilih integrasi ini.
Microsoft Fabric adalah platform analitik yang menyatukan pergerakan data, pemrosesan data, penyerapan, transformasi, pemrosesan aliran melalui Real-Time Intelligence, dan pembuatan laporan. Dalam arsitektur ini, ia menyediakan platform analitik untuk memproses dan menganalisis data dari Azure NetApp Files melalui pintasan OneLake.
OneLake adalah data lake logis terpadu untuk Fabric. Dalam arsitektur ini, pintasan OneLake membuat data Azure NetApp Files yang dirujuk tersedia untuk beban kerja Fabric yang didukung.
Microsoft Azure Virtual Network menyediakan konektivitas privat antara sumber daya Azure dalam arsitektur ini. Peering jaringan virtual memungkinkan komputer virtual gateway dan komputasi Azure Databricks opsional untuk mencapai titik akhir AZURE NETAPP FILES Object REST API.
Gateway data lokal menyambungkan pintasan OneLake ke titik akhir wadah Azure NetApp Files. Terlepas dari namanya, dalam arsitektur ini, gateway berjalan dalam mode standar pada komputer virtual Azure dengan sistem operasi Windows yang didukung. Pilih gambar yang memenuhi persyaratan penginstalan gateway. Penginstalan Inti Server dan kontainer Windows tidak didukung. Gateway memulai koneksi keluar melalui Azure Relay untuk berkomunikasi dengan Fabric. Tidak diperlukan koneksi masuk dari Fabric. Konfigurasikan firewall atau proksi Anda untuk mengizinkan titik akhir keluar yang dijelaskan dalam Menyesuaikan pengaturan komunikasi untuk gateway data lokal.
Azure Databricks adalah platform analitik alternatif opsional untuk rekayasa data dan beban kerja pembelajaran mesin. Pekerjaan Spark-nya menggunakan konektor Hadoop S3A yang dikonfigurasi untuk titik akhir Object REST API untuk mengakses himpunan data Azure NetApp Files alih-alih menggunakan jalur integrasi Fabric.
Alternatives
Arsitektur ini mencakup beberapa komponen yang dapat Anda ganti dengan layanan atau pendekatan Azure lainnya, tergantung pada persyaratan fungsional dan nonfungsi beban kerja Anda. Pertimbangkan alternatif berikut dan kompromi masing-masing.
Storage
Pertimbangkan persyaratan protokol aplikasi dan performa terukur saat Anda memilih antara Azure Blob Storage dan Azure NetApp Files:
Pilih Blob Storage ketika klien dapat menggunakan Blob Storage REST API atau NFS 3.0 dan tidak memerlukan SMB atau NFS 4.1. Kedua antarmuka dapat mengakses data yang sama. Jalur akses NFS 3.0 Blob Storage dioptimalkan untuk beban kerja berurutan dengan throughput tinggi dan baca-berat di mana throughput lebih penting daripada latensi rendah.
Pilih Azure NetApp Files ketika beban kerja aplikasi dan analitik perlu mengakses file yang sama melalui SMB atau NFS 4.1 dan Object REST API yang kompatibel dengan S3, atau ketika aplikasi file memerlukan I/O acak latensi rendah. Untuk data yang sudah ada di Azure NetApp Files, Object REST API menambahkan akses analitik tanpa memigrasikan aplikasi atau data sumber.
Untuk salah satu opsi, ukur latensi dan throughput end-to-end di bawah beban aplikasi sumber dan analitik bersamaan. Performa NFS atau SMB tidak membuat Object REST API atau performa Fabric, jadi uji jalur akses yang dimaksudkan terhadap persyaratan beban kerja. Bandingkan total biaya, termasuk perubahan aplikasi, migrasi, dan duplikasi dan sinkronisasi yang sedang berlangsung. Untuk perbandingan protokol dan beban kerja, lihat Membandingkan layanan penyimpanan Azure.
Integration
Azure Databricks pekerjaan dapat menggunakan konektor Hadoop S3A untuk membaca data Azure NetApp Files melalui Object REST API, tanpa OneLake atau gateway data lokal. Konfigurasikan kepercayaan TLS dan kredensial yang disimpan dengan aman, dan validasi operasi tulis yang diperlukan sebelum mengandalkan write-back. Jika Anda memerlukan skrip inisialisasi, gunakan skrip cakupan kluster yang disimpan dalam volume Katalog Unity pada komputasi yang didukung, mengikuti panduan skrip init Azure Databricks saat ini.
Detail skenario
Gunakan pola ini ketika himpunan data yang sama harus melayani aplikasi yang mengharapkan sistem file yang dipasang dan analitik atau layanan AI yang mengharapkan antarmuka objek yang kompatibel dengan S3.
Aplikasi yang berjalan pada komputer virtual atau dalam kontainer dapat terus menggunakan Azure NetApp Files melalui NFS atau SMB. Misalnya, mereka dapat menggunakan kode akses file yang ada, berbagi yang dipasang, dan struktur direktori. AZURE NETAPP FILES Object REST API memetakan direktori akar volume atau subdirektori ke wadah yang kompatibel dengan S3 sehingga klien objek yang kompatibel dapat mengakses file dasar yang sama.
Pendekatan ini berguna ketika Anda ingin menambahkan kemampuan analitik atau AI ke beban kerja berbasis file yang ada tanpa mengubah aplikasi sumber untuk menggunakan penyimpanan objek. Alur kerja hilir masih dapat membuat data turunan, seperti himpunan data, indeks, penyematan, dan cache yang diubah, sesuai kebutuhan.
Saat klien file dan objek mengakses data yang sama, perhitungkan perbedaan dalam persyaratan identitas, izin, penguncian, dan konsistensi aplikasi. Tentukan bagaimana produsen memberi sinyal bahwa file atau batch selesai sebelum konsumen objek memprosesnya. Produsen harus selesai menulis dan menutup file sebelum memberi sinyal kesiapan dan membiarkan file-file tersebut tidak berubah saat konsumen memprosesnya. Uji handoff ini untuk percobaan ulang penulisan dan pemrosesan yang terganggu.
Model identitas dan otorisasi juga berbeda di seluruh metode akses. Izin file per pengguna asli tidak secara otomatis dibawa ke Fabric. Konfigurasikan izin Fabric untuk konsumen yang dimaksudkan dan pastikan bahwa identitas yang digunakan oleh Object REST API hanya memiliki akses ke data sumber yang diperlukan. Untuk informasi selengkapnya, lihat Keamanan .
Petakan direktori ke wadah terpisah saat konsumen memerlukan tingkat akses yang berbeda. Klasifikasi data, retensi, otorisasi hilir, dan tata kelola data turunan tetap menjadi tanggung jawab beban kerja. Untuk informasi selengkapnya, lihat Membuat wadah.
Kemungkinan kasus penggunaan
Arsitektur ini dapat mendukung beban kerja yang perlu menganalisis data terstruktur atau tidak terstruktur yang sudah disimpan dalam Azure NetApp Files. Contoh berikut mengilustrasikan berbagai cara agar Fabric dapat menggunakan data tersebut.
Pemrosesan dokumen
Aplikasi dapat menyimpan dokumen, gambar, atau file tidak terstruktur lainnya ke Azure NetApp Files dengan menggunakan NFS atau SMB. Buku catatan Fabric dapat membaca file yang telah selesai dengan menggunakan pintasan OneLake dan mengirim kontennya ke layanan pemrosesan dokumen, seperti Azure Kecerdasan Dokumen, untuk ekstraksi. Simpan data terstruktur yang dihasilkan dalam tabel lakehouse untuk validasi, analisis, dan pelaporan.
Untuk panduan integrasi, lihat Integrasi Kecerdasan Dokumen melalui SynapseML.
Analisis data
Aplikasi dapat menulis data terstruktur, seperti file CSV atau Parquet, ke berbagi Azure NetApp Files. Fabric notebook dapat membaca file yang telah selesai dengan menggunakan pintasan OneLake, menggabungkannya dengan data lakehouse lainnya, dan menulis hasil turunan ke tabel lakehouse.
Pola ini dapat mendukung skenario seperti analisis rekayasa dan kualitas, analisis data sensor, dan pelaporan operasional tanpa mengharuskan aplikasi sumber untuk mengubah cara mereka menyimpan file mereka.
Untuk himpunan data Delta yang kompatibel, buat pintasan OneLake di bagian Tabel lakehouse yang menargetkan tabel Delta lengkap, termasuk log transaksinya. Fabric kemudian dapat mengenali target sebagai tabel, dan data sumber dapat tetap berada di Azure NetApp Files. Untuk informasi selengkapnya, lihat Tempat menempatkan pintasan di lakehouse.
Pencarian dan pengambilan AI
Dokumen yang disimpan di Azure NetApp Files juga dapat berfungsi sebagai konten sumber untuk beban kerja AI. Misalnya, alur kerja pemrosesan dapat membaca dokumen melalui pintasan OneLake dan menggunakannya untuk membangun indeks Pencarian Azure AI untuk pembuatan retrieval-augmented (RAG).
Indeks pencarian dan penyematan apa pun adalah data turunan dan disimpan secara terpisah dari file sumber. Desain alur kerja untuk menjaga konten terindeks tetap sinkron dengan pembaruan sumber, penggantian nama, dan penghapusan. Terapkan juga kontrol akses yang sesuai saat mengambil konten terindeks karena izin SMB dan NFS asli tidak secara otomatis menjadi izin pencarian per pengguna.
Pola yang sama dapat diperluas ke beban kerja AI lainnya. Misalnya, notebook Fabric dapat menyiapkan himpunan data dari file sumber dan menyimpan data yang disiapkan di OneLake untuk dikonsumsi oleh Azure Machine Learning. Untuk opsi dan batasan integrasi, lihat Mengintegrasikan OneLake dengan Azure Machine Learning.
Considerations
Pertimbangan ini mengimplementasikan pilar Azure Well-Architected Framework, yang merupakan serangkaian tenet panduan yang dapat Anda gunakan untuk meningkatkan kualitas beban kerja. Untuk informasi selengkapnya, lihat Well-Architected Framework. Untuk panduan lebih lanjut, lihat rekomendasiWell-Architected Framework untuk Azure NetApp Files.
Reliability
Keandalan membantu memastikan bahwa aplikasi Anda dapat memenuhi komitmen yang Anda buat kepada pelanggan Anda. Untuk informasi selengkapnya, lihat Daftar Periksa Ulasan Desain untuk Keandalan.
Azure NetApp Files berjalan pada armada bare-metal yang toleran terhadap kesalahan yang didukung oleh ONTAP dan menyediakan SLA dengan ketersediaan tinggi. Untuk perlindungan tambahan terhadap pemadaman zona ketersediaan atau regional, Anda dapat secara opsional mengonfigurasi replikasi lintas zona atau lintas wilayah. Replikasi ini asinkron dan memerlukan failover yang dimulai pelanggan ke volume tujuan. Pilih opsi replikasi dan jadwalkan sesuai dengan tujuan pemulihan beban kerja Anda. Untuk informasi selengkapnya, lihat Azure NetApp Files keandalan.
Berbagi satu himpunan data juga membuat ketersediaan penyimpanan menjadi dependensi umum untuk aplikasi file dan analitik. Kemampuan penyimpanan ini tidak menetapkan ketersediaan end-to-end untuk gateway, mengindeks alur, atau mengonsumsi aplikasi. Sejajarkan tujuan pemulihan dengan beban kerja lengkap, termasuk gateway, pemrosesan hilir, dan data turunan.
Satu komputer virtual gateway adalah satu titik kegagalan untuk jalur integrasi Fabric. Untuk beban kerja yang penting bagi bisnis, sebarkan setidaknya dua anggota gateway pada komputer virtual terpisah dalam kluster gateway. Pastikan bahwa setiap anggota dapat mencapai titik akhir Object REST API dan membuat koneksi keluar yang diperlukan. Uji perilaku beban kerja saat anggota gateway menjadi tidak tersedia.
- Pemulihan file dan volume didukung melalui rekam jepret titik waktu yang hemat ruang. Teams dapat memulihkan file individual, mengembalikan volume lengkap, atau membuat volume baru dari titik pemulihan setelah penghapusan, kerusakan, atau proses analitik yang gagal secara tidak disengaja. Untuk operasi pemulihan yang tersedia, lihat Azure NetApp Files perlindungan data berbasis rekam jepret.
Keamanan
Keamanan menjamin perlindungan terhadap serangan yang disengaja dan penyalahgunaan data serta sistem berharga Anda. Untuk informasi selengkapnya, lihat daftar periksa desain untuk tinjauan keamanan.
Mempertahankan lebih sedikit salinan data sumber dapat mengurangi jumlah repositori untuk dilindungi. Azure NetApp Files mengenkripsi data tidak aktif, dan Object REST API menggunakan TLS untuk melindungi data saat transit. Izin akses file bergantung pada protokol:
Klien SMB dan NFS terus menggunakan model autentikasi dan otorisasi yang ada. Daftar kontrol akses (ACL) NTFS yang ada, izin NFS, dan aturan pemetaan identitas tetap berlaku untuk klien tersebut.
Klien REST API objek mengautentikasi dengan menggunakan kunci akses S3. Izin wadah menentukan apakah klien memiliki akses baca-saja atau baca-tulis dalam direktori yang dipetakan. Permintaan objek tidak menyertakan identitas pengguna SMB, NFS, atau hilir individual. Azure NetApp Files melakukan setiap operasi objek sebagai identitas sistem file impersonated bucket yang dikonfigurasi. Izin file dan ACL yang ada hanya dievaluasi terhadap identitas tersebut.
Identitas sistem file yang ditiru adalah ID pengguna (UID) dan ID grup (GID) untuk volume NFS, atau akun pengguna untuk volume SMB. Volume protokol ganda menggunakan jenis identitas yang cocok dengan gaya keamanan yang dikonfigurasi. Identitas ini menentukan izin akses file. Kunci akses S3 mengautentikasi klien objek. Untuk informasi selengkapnya, lihat Keamanan dan izin REST API objek.
Pintasan yang kompatibel dengan OneLake S3 mengautentikasi ke wadah dengan menggunakan ID kunci akses dan kunci akses rahasia. ACL NTFS sumber, izin NFS, dan identitas pemilik file individual tidak disalin atau dipetakan ke OneLake. Fabric pengguna diotorisasi melalui izin OneLake dan Fabric. Mereka hanya dapat mengakses konten yang diekspos ke pintasan melalui wadah dan identitas yang ditiru, tetapi OneLake tidak memberlakukan izin file asli per pengguna. OAuth berbasis Microsoft Entra, perwakilan layanan, dan RoleArn tidak didukung untuk jenis pintasan ini.
Misalnya, pengguna Fabric mungkin dapat membaca dokumen dengan menggunakan pintasan bahkan ketika akun SMB pribadi mereka tidak dapat membacanya secara langsung, jika izin Fabric mengizinkan akses dan identitas yang ditiru wadah dapat membaca dokumen. Sebelum mengekspos direktori, verifikasi bahwa audiens Fabric yang dimaksudkan berwenang untuk mengakses kontennya.
Konfigurasikan identitas yang ditiru wadah hanya dengan izin sumber yang diperlukan beban kerja. Batasi akses ke pintasan dan lakehouse. Gunakan alur kerja sertifikat berbasis Azure Key Vault dan penyimpanan kredensial untuk mengelola sertifikat TLS dan kunci akses S3. Tentukan dan uji prosedur rotasi yang mengoordinasikan perubahan sertifikat dan info masuk dengan pembaruan untuk koneksi Fabric dan konsumen lainnya. Menghasilkan kredensial wadah baru segera membatalkan pasangan yang ada, jadi rencanakan gangguan saat Anda memperbarui konsumen dan memverifikasi akses setelah rotasi.
Jika Anda menggunakan sertifikat TLS yang ditandatangani sendiri, pastikan setiap host gateway mempercayainya. Untuk informasi selengkapnya, lihat Prasyarat gateway OneLake.
Keamanan dan kepatuhan bergantung pada konfigurasi penyimpanan, akses, dan layanan hilir. Sertakan pemrosesan hilir dan data turunan dalam cakupan tata kelola dan kepatuhan Anda. Persyaratan seperti GDPR dan HIPAA berlaku untuk beban kerja lengkap, jika berlaku. Untuk informasi selengkapnya, lihat Keamanan dan izin REST API Objek dan Membuat pintasan yang kompatibel dengan Amazon S3 di OneLake.
Pengoptimalan Biaya
Pengoptimalan Biaya berfokus pada cara untuk mengurangi pengeluaran yang tidak perlu dan meningkatkan efisiensi operasional. Untuk informasi selengkapnya, lihat Daftar periksa tinjauan desain untuk optimalisasi biaya.
Menghindari salinan data sumber terpisah dapat mengurangi biaya penyimpanan dan sinkronisasi duplikat. Seimbangkan penghematan ini terhadap kapasitas dan biaya performa Azure NetApp Files, komputasi gateway, kapasitas Fabric, serta pemrosesan dan penyimpanan hilir.
Contoh perkiraan harga ini mencakup kumpulan kapasitas Standar Azure NetApp Files 1-TiB, komputer virtual Windows D8s_v5 untuk gateway data lokal, dua disk terkelola P10 128-GiB, gateway NAT dengan alamat IP publik dan pemrosesan data keluar, kapasitas Fabric F2, dan penyimpanan OneLake asli 100 GB.
Konfigurasi gateway tunggal tidak sangat tersedia. Biaya Pencarian AI opsional, layanan penyematan, dan Azure Databricks dikecualikan. Sesuaikan sumber daya untuk kapasitas, jaringan, dan persyaratan ketersediaan beban kerja Anda.
Akses dingin: Blok data tidak aktif tingkat, termasuk data rekam jepret, ke penyimpanan berniaya rendah sambil mempertahankan akses file dan objek. Mengevaluasi biaya pengambilan, latensi, dan perubahan throughput khusus tingkat layanan terhadap pola akses beban kerja.
Tingkat layanan dan ukuran yang tepat: Pilih tingkat layanan Azure NetApp Files yang cocok dengan persyaratan kapasitas dan throughput himpunan data. Tingkat layanan Fleksibel memungkinkan Anda untuk menyediakan kapasitas dan throughput kumpulan secara independen. Tinjau kapasitas dan throughput kumpulan yang dapat ditagih saat permintaan berubah untuk menghindari provisi berlebihan yang persisten.
Keunggulan Operasi
Keunggulan Operasional mencakup proses operasi yang menyebarkan aplikasi dan membuatnya tetap berjalan dalam produksi. Untuk informasi selengkapnya, lihat Daftar periksa tinjauan desain untuk Keunggulan Operasional.
Pintasan OneLake mengurangi kompleksitas operasional dengan menghindari alur yang mempertahankan salinan data sumber terpisah untuk analitik. Tanpa alur salinan terpisah, tim tidak perlu menjadwalkan pekerjaan penyalinan, memulihkan dari kegagalan transfer, atau mendamaikan sumber dan menyalin data sebagai bagian dari operasi rutin.
Tim aplikasi sumber dan analitik harus mengoordinasikan perubahan dan respons insiden untuk himpunan data Azure NetApp Files bersama. Menetapkan kepemilikan untuk pemantauan, kegagalan pemrosesan, dan kredensial DAN manajemen sertifikat Object REST API.
Pantau penyimpanan, gateway, dan performa Fabric untuk mengidentifikasi batasan dan menyesuaikan kapasitas atau throughput:
Gunakan Azure Monitor untuk melacak throughput baca dan tulis volume, IOPS baca dan tulis, IOPS lainnya, latensi baca dan tulis rata-rata, konsumsi kapasitas, dan indikator tercapai batas throughput. Pemberitahuan tentang latensi berkelanjutan meningkat, pembatasan QoS berulang, dan ambang kapasitas daripada lonjakan terisolasi; Azure NetApp Files metrik diagregasi melalui interval dan latensi penyimpanan tidak menyertakan setiap komponen REST sisi klien.
Menghubungkan metrik penyimpanan dengan pengukuran sisi klien seperti persentil latensi permintaan, ukuran objek, konkurensi, percobaan ulang, kode status HTTP, CPU, memori, dan throughput jaringan. Melakukannya membedakan batas throughput volume dari klien komputasi berukuran kecil, pengaturan SDK yang tidak efisien, overhead objek kecil, atau jarak jaringan.
Pantau setiap CPU komputer virtual gateway, memori, ruang disk yang tersedia, dan throughput jaringan bersama kesalahan gateway dan waktu penyelesaian beban kerja. Konfigurasikan pemberitahuan untuk tekanan sumber daya berkelanjutan dan ruang disk rendah, menggunakan ambang batas yang ditetapkan selama pengujian beban kerja perwakilan. Gunakan log diagnostik gateway saat memecahkan masalah kesalahan atau akses lambat. Pantau komputer virtual dan jaringan secara terpisah karena diagnostik gateway tidak menyediakan cakupan infrastruktur lengkap.
Pantau pemanfaatan dan pembatasan kapasitas Fabric dengan aplikasi Metrik Kapasitas Fabric. Mengonfigurasi pemberitahuan pemanfaatan kapasitas untuk administrator yang bertanggung jawab. Menghubungkan penggunaan kapasitas dengan pengukuran gateway dan penyimpanan untuk mengidentifikasi apakah penundaan berasal dari akses sumber atau pemrosesan Fabric sebelum mengubah kapasitas.
Efisiensi Performa
Efisiensi Performa mengacu pada kemampuan beban kerja Anda untuk menskalakan untuk memenuhi tuntutan pengguna secara efisien. Untuk informasi selengkapnya, lihat Daftar Periksa Tinjauan Desain untuk Efisiensi Kinerja.
Azure NetApp Files dapat mendukung aplikasi NFS atau SMB yang sensitif terhadap latensi dan analitik atau konsumen AI yang kompatibel dengan S3 menggunakan himpunan data yang sama. Menyimpan data sumber pada satu volume dapat menghapus tahap penyalinan yang sebaliknya akan menunda pengindeksan, pelatihan, atau pemrosesan batch dan mengonsumsi bandwidth klien, jaringan, dan penyimpanan tujuan.
Latensi penyimpanan sub-milidetik pada tingkat layanan Azure NetApp Files yang didukung paling relevan langsung dengan beban kerja NFS dan SMB. Ini tidak menjamin latensi end-to-end untuk permintaan HTTPS Object REST API. Tolok ukur jalur akses yang kompatibel dengan S3 dengan objek representatif dan konkurensi sebelum mengatur tujuan latensi.
Ukuran penyimpanan: Throughput ukuran untuk permintaan gabungan aplikasi file dan konsumen objek. QoS otomatis mengikat throughput volume ke kuota volume. QoS manual memungkinkan alokasi terpisah dalam anggaran throughput kumpulan. Beban kerja perwakilan tolok ukur sebelum menyesuaikan performa.
Ukuran gateway: Ukuran komputer virtual gateway untuk permintaan gabungan beban kerja yang mengakses Azure NetApp Files melalui pintasan OneLake. Gunakan panduan ukuran dan penskalaan gateway sebagai titik awal. Validasi ukuran dengan volume data representatif dan akses bersamaan melalui pintasan. Ukur CPU gateway, memori, dan throughput jaringan bersama waktu penyelesaian beban kerja untuk menentukan apakah akan meningkatkan sumber daya komputer virtual atau menambahkan anggota gateway.
Fabric ukuran kapasitas: Ukuran Fabric kapasitas untuk beban kerja pemrosesan dan pelaporan gabungan, termasuk Power BI. Ikuti panduan dalam panduan perencanaan kapasitas Fabric untuk memperkirakan kapasitas awal, menguji dengan pilot representatif, dan menyesuaikan kapasitas berdasarkan pemanfaatan dan pembatasan terukur.
Tempatkan komputasi yang dekat dengan volume, ukuran jaringan klien dengan tepat, dan uji dengan beban kerja nyata. Tingkatkan paralelisme dan gunakan permintaan besar yang sesuai untuk analitik berurutan, tetapi tutup konkurensi saat latensi atau kesalahan meningkat. Untuk NFS atau SMB, validasi pengaturan pemasangan, protokol, dan aplikasi. Untuk REST, verifikasi dukungan untuk operasi API yang diperlukan klien, dan uji penggunaan kembali koneksi, perilaku unggah, coba lagi, dan daftar objek.
Validasi throughput end-to-end dan latensi di bawah beban bersamaan, dan seimbangkan permintaan analitik dengan persyaratan performa aplikasi sumber.
Kontributor
Microsoft mempertahankan artikel ini. Kontributor berikut menulis artikel ini.
Penulis utama:
- Dan Jackson | Arsitek Solusi Cloud, NetApp
- Anthony Mashford | Arsitek Solusi Cloud, NetApp
- Daniel Söderholm | Insinyur Solusi Senior, Platform Cloud + AI, Microsoft
Kontributor lain:
- Heather Grandy | Insinyur Solusi Senior, Platform Data, Microsoft
Untuk melihat profil LinkedIn nonpublik, masuk ke LinkedIn.
Langkah berikutnya
- Pengenalan REST API objek untuk Azure NetApp Files
- Menyambungkan OneLake ke volume Azure NetApp Files
- Skrip init di Azure Databricks
- Mengintegrasikan OneLake dengan Azure Machine Learning