Catatan
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba masuk atau mengubah direktori.
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba mengubah direktori.
SQL Managed Instance yang diaktifkan oleh Azure Arc disebarkan pada Kubernetes sebagai aplikasi dalam kontainer. Ini menggunakan konstruksi Kubernetes seperti set stateful dan penyimpanan persisten untuk menyediakan bawaan:
- Pemantauan kesehatan
- Deteksi kegagalan
- Failover otomatis untuk menjaga kesehatan layanan.
Untuk meningkatkan keandalan, Anda juga dapat mengonfigurasi SQL Managed Instance yang diaktifkan oleh Azure Arc untuk disebarkan dengan replika tambahan dalam konfigurasi ketersediaan tinggi. Pengontrol data layanan Arc mengelola:
- Pemantauan
- Deteksi kegagalan
- Failover otomatis
Layanan data berkemampuan Arc menyediakan layanan ini tanpa intervensi pengguna. Layanan:
- Menyiapkan grup ketersediaan
- Mengonfigurasi titik akhir cermin basis data
- Menambahkan database ke grup ketersediaan
- Mengkoordinasikan failover dan peningkatan.
Dokumen ini menjelajahi kedua jenis tingkat ketersediaan yang tinggi.
SQL Managed Instance yang diaktifkan oleh Azure Arc menyediakan tingkat ketersediaan tinggi yang berbeda tergantung pada apakah instans terkelola SQL disebarkan sebagai tingkat layanan Tujuan Umum atau tingkat layanan Business Critical .
Ketersediaan tinggi di tingkat layanan Tujuan Umum
Di tingkat layanan Tujuan Umum, hanya ada satu replika yang tersedia, dan ketersediaan tinggi dicapai melalui orkestrasi Kubernetes. Misalnya, jika pod atau node yang berisi image kontainer instans terkelola mengalami crash, Kubernetes mencoba untuk menjalankan pod atau node lain, dan melampirkannya ke penyimpanan persisten yang sama. Selama waktu ini, instans terkelola SQL tidak tersedia untuk aplikasi. Aplikasi perlu menyambungkan kembali dan mencoba kembali transaksi saat pod baru aktif. Jika load balancer adalah jenis layanan yang digunakan, maka aplikasi dapat terhubung kembali ke titik akhir utama yang sama dan Kubernetes akan mengalihkan koneksi ke primer baru. Jika jenis layanan adalah nodeport aplikasi harus terhubung kembali ke alamat IP baru.
Memverifikasi keandalan tinggi bawaan
Untuk memverifikasi ketersediaan tinggi bawaan yang disediakan oleh Kubernetes, Anda dapat:
- Menghapus pod dari instance terkelola yang ada
- Verifikasi bahwa Kubernetes pulih dari tindakan ini
Selama pemulihan, Kubernetes mem-bootstrap pod lain dan melampirkan penyimpanan persisten.
Prasyarat
- Kluster Kubernetes memerlukan penyimpanan jarak jauh bersama
- SQL Managed Instance yang didukung oleh Azure Arc dilengkapi dengan satu replika (standar)
Lihat pod.
kubectl get pods -n <namespace of data controller>Hapus instans pod yang dikelola.
kubectl delete pod <name of managed instance>-0 -n <namespace of data controller>Misalnya
user@pc:/# kubectl delete pod sql1-0 -n arc
pod "sql1-0" deleted
Lihat objek pod untuk memverifikasi bahwa instans terkelola sedang dalam proses pemulihan.
kubectl get pods -n <namespace of data controller>Contohnya:
user@pc:/# kubectl get pods -n arc
NAME                 READY   STATUS    RESTARTS   AGE
sql1-0               2/3     Running   0          22s
Setelah semua kontainer dalam pemulihan pod, Anda dapat terhubung ke instans terkelola.
Ketersediaan tinggi di tingkat layanan Bisnis Penting
Di tingkat layanan Business Critical, selain apa yang disediakan secara asli oleh orkestrasi Kubernetes, SQL Managed Instance for Azure Arc menyediakan grup ketersediaan yang terkandung. Grup ketersediaan yang terkandung dibangun di atas teknologi SQL Server Always On. Ini memberikan tingkat ketersediaan yang lebih tinggi. SQL Managed Instance yang diaktifkan oleh Azure Arc yang disebarkan dengan tingkat layanan Business Critical dapat disebarkan dengan 2 atau 3 replika. Replika ini selalu tetap sinkron satu sama lain.
Dengan grup ketersediaan yang terkandung, setiap pod mengalami crash atau kegagalan node transparan terhadap aplikasi. Grup ketersediaan terkontrol menyediakan setidaknya satu pod lain yang memiliki semua data dari utama dan siap untuk menerima koneksi.
Grup ketersediaan terbatas
Grup ketersediaan mengikat satu atau beberapa database pengguna ke dalam grup logis sehingga jika terjadi failover, seluruh grup database pindah ke replika sekunder sebagai satu kesatuan. Grup ketersediaan hanya mereplikasi data dalam database pengguna tetapi bukan data dalam database sistem seperti login, izin, atau pekerjaan agen. Grup ketersediaan yang terkandung mencakup metadata dari database sistem seperti msdb dan master database. Saat login dibuat atau dimodifikasi di replika utama, mereka secara otomatis juga dibuat di replika sekunder. Demikian pula, ketika pekerjaan agen dibuat atau dimodifikasi di replika utama, replika sekunder juga menerima perubahan tersebut.
SQL Managed Instance yang diaktifkan oleh Azure Arc mengambil konsep grup ketersediaan yang terkandung ini dan menambahkan operator Kubernetes sehingga dapat disebarkan dan dikelola dalam skala besar.
Kemampuan yang berisi grup ketersediaan memungkinkan:
Saat disebarkan dengan beberapa replika, satu grup ketersediaan yang dinamai sama dengan instans terkelola SQL yang diaktifkan Arc akan dibuat. Secara bawaan, AG yang ada memiliki tiga replika, termasuk utama. Semua operasi CRUD untuk grup ketersediaan dikelola secara internal, termasuk membuat grup ketersediaan atau menggabungkan replika ke grup ketersediaan yang dibuat. Anda tidak dapat membuat lebih banyak grup ketersediaan pada sebuah instans.
Semua database secara otomatis ditambahkan ke grup ketersediaan, termasuk semua database pengguna dan sistem seperti
masterdanmsdb. Kemampuan ini menyediakan tampilan sistem tunggal di seluruh replika grup ketersediaan. Perhatikan databasecontainedag_masterdancontainedag_msdbjika Anda terhubung langsung ke instans. Databasecontainedag_*mewakilimasterdanmsdbdi dalam grup ketersediaan.Titik akhir eksternal secara otomatis disediakan untuk menyambungkan ke database dalam grup ketersediaan. Endpoint
<managed_instance_name>-external-svcini berfungsi sebagai pendengar grup ketersediaan.
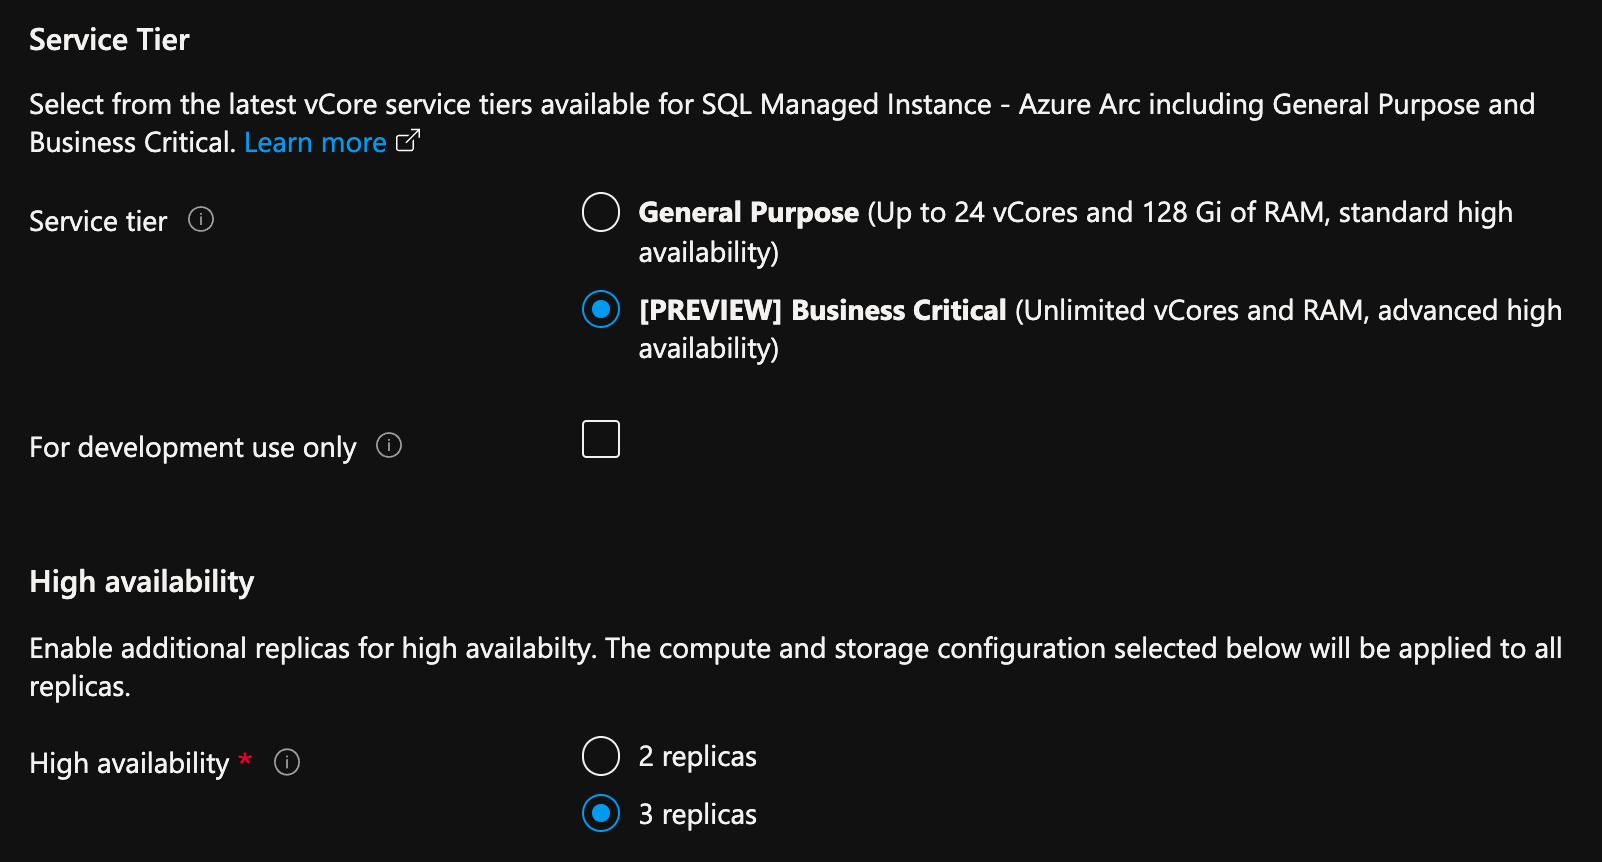
Menyebarkan SQL Managed Instance yang diaktifkan oleh Azure Arc dengan beberapa replika menggunakan portal Microsoft Azure
Dari portal Microsoft Azure, pada halaman buat SQL Managed Instance yang diaktifkan oleh Azure Arc:
- Pilih Konfigurasikan Komputasi + Penyimpanan di bawah Komputasi + Penyimpanan. Portal menunjukkan pengaturan tingkat lanjut.
- Di bawah Tingkat layanan, pilih Bisnis Penting.
- Periksa "Hanya untuk penggunaan pengembangan", jika menggunakan untuk tujuan pengembangan.
- Di bawah Ketersediaan tinggi, pilih 2 replika atau 3 replika.
Menyebarkan dengan beberapa replika menggunakan Azure CLI
Saat SQL Managed Instance yang diaktifkan oleh Azure Arc disebarkan di tingkat layanan Business Critical, penyebaran membuat beberapa replika. Penyiapan dan konfigurasi grup ketersediaan terkonten di antara instans tersebut secara otomatis dilakukan selama proses penyediaan.
Misalnya, perintah berikut membuat instans terkelola dengan 3 replika.
Mode tersambung secara tidak langsung:
az sql mi-arc create -n <instanceName> --k8s-namespace <namespace> --use-k8s --tier <tier> --replicas <number of replicas>
Contoh:
az sql mi-arc create -n sqldemo --k8s-namespace my-namespace --use-k8s --tier BusinessCritical --replicas 3
Mode terhubung langsung:
az sql mi-arc create --name <name> --resource-group <group> --location <Azure location> –subscription <subscription> --custom-location <custom-location> --tier <tier> --replicas <number of replicas>
Contoh:
az sql mi-arc create --name sqldemo --resource-group rg --location uswest2 –subscription xxxxxxx-xxxx-xxxx-xxxx-xxxxxxxxxxxx --custom-location private-location --tier BusinessCritical --replcias 3
Secara default, semua replika dikonfigurasi dalam mode sinkron. Ini berarti setiap pembaruan pada instans utama direplikasi secara sinkron ke setiap instans sekunder.
Melihat dan memantau status ketersediaan tinggi
Setelah penyebaran selesai, sambungkan ke titik akhir utama dari SQL Server Management Studio.
Verifikasi dan ambil titik akhir dari replika utama, lalu sambungkan ke titik akhir tersebut menggunakan SQL Server Management Studio.
Misalnya, jika instans SQL disebarkan menggunakan service-type=loadbalancer, jalankan perintah di bawah ini untuk mengambil titik akhir untuk menyambungkan ke:
az sql mi-arc list --k8s-namespace my-namespace --use-k8s
atau
kubectl get sqlmi -A
Dapatkan titik akhir utama dan sekunder serta status AG
Gunakan perintah kubectl describe sqlmi atau az sql mi-arc show untuk melihat titik akhir utama dan sekunder, serta status ketersediaan tinggi.
Contoh:
kubectl describe sqlmi sqldemo -n my-namespace
atau
az sql mi-arc show --name sqldemo --k8s-namespace my-namespace --use-k8s
Contoh output, output Anda akan berbeda:
 "status": {
    "endpoints": {...
      "mirroring": "10.15.100.150:5022",
      "primary": "10.15.100.150,1433",
      "secondary": "10.15.100.156,1433"
    },
    "highAvailability": {
      "healthState": "OK",
      "mirroringCertificate": "-----BEGIN CERTIFICATE-----\n...\n-----END CERTIFICATE-----"
    },
    "observedGeneration": 1,
    "readyReplicas": "2/2",
    "state": "Ready"
  }
Anda dapat terhubung ke titik akhir utama dengan SQL Server Management Studio dan memverifikasi DMV sebagai:
SELECT * FROM sys.dm_hadr_availability_replica_states
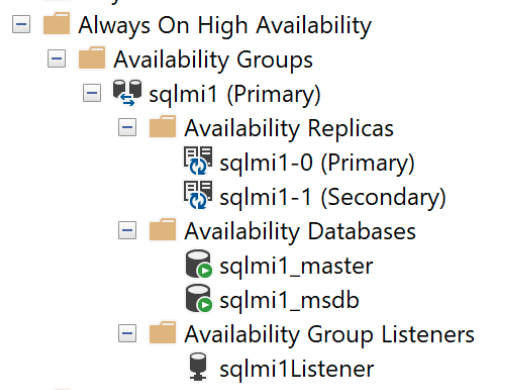
Dan Dasbor Ketersediaan Yang Terkandung:
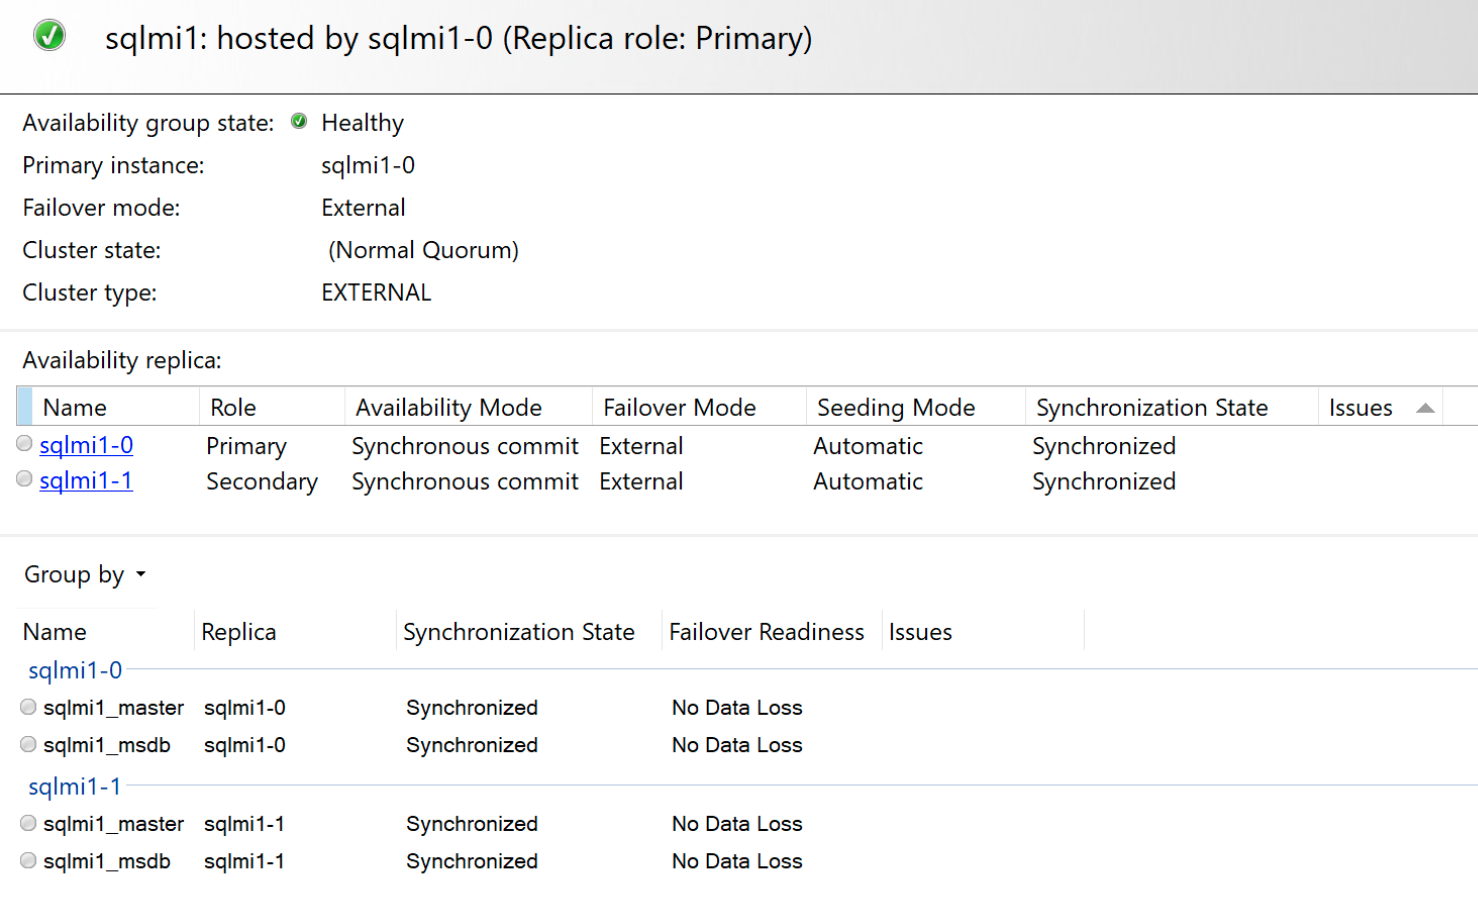
Skenario failover
Tidak seperti grup ketersediaan AlwaysOn SQL Server, grup ketersediaan yang terkandung adalah solusi ketersediaan tinggi terkelola. Oleh karena itu, mode failover terbatas dibandingkan dengan mode yang biasanya tersedia pada grup ketersediaan SQL Server Always On.
Sebarkan instans SQL terkelola pada tingkat layanan Business Critical dalam konfigurasi dua replika atau konfigurasi tiga replika. Efek kegagalan dan pemulihan berikutnya berbeda dengan setiap konfigurasi. Tiga instans replika memberikan tingkat ketersediaan dan pemulihan yang lebih tinggi, daripada dua instans replika.
Dalam dua konfigurasi replika, ketika kedua status node adalah SYNCHRONIZED, jika replika utama menjadi tidak tersedia, replika sekunder secara otomatis dipromosikan ke primer. Ketika replika yang gagal tersedia, ia akan diperbarui dengan semua perubahan tertunda. Jika ada masalah konektivitas antara replika, maka replika utama mungkin tidak melakukan transaksi apa pun karena setiap transaksi perlu dilakukan pada kedua replika sebelum keberhasilan dikembalikan pada replika utama.
Dalam tiga konfigurasi replika, transaksi perlu dilakukan di setidaknya 2 dari 3 replika sebelum mengembalikan pesan sukses kembali ke aplikasi. Jika terjadi kegagalan, salah satu sekunder secara otomatis dipromosikan ke primer sementara Kubernetes mencoba memulihkan replika yang gagal. Ketika replika tersedia, replika secara otomatis bergabung kembali dengan grup ketersediaan yang terkandung dan perubahan yang tertunda disinkronkan. Jika ada masalah konektivitas antara replika, dan lebih dari 2 replika tidak sinkron, replika utama tidak akan melakukan transaksi apa pun.
Nota
Disarankan untuk menyebarkan Business Critical SQL Managed Instance dalam konfigurasi tiga replika daripada konfigurasi dua replika untuk mencapai kehilangan data hampir nol.
Untuk melakukan failover dari replika utama ke salah satu sekunder, untuk peristiwa yang direncanakan, jalankan perintah berikut:
Jika Anda tersambung ke primer, Anda dapat menggunakan T-SQL berikut untuk melakukan failover pada instans SQL ke salah satu sekunder:
ALTER AVAILABILITY GROUP current SET (ROLE = SECONDARY);
Jika Anda tersambung ke sekunder, Anda dapat menggunakan T-SQL berikut untuk menaikkan sekunder yang diinginkan menjadi replika primer.
ALTER AVAILABILITY GROUP current SET (ROLE = PRIMARY);
Replika utama pilihan
Anda juga dapat mengatur replika tertentu untuk menjadi replika utama menggunakan AZ CLI sebagai berikut:
az sql mi-arc update --name <sqlinstance name> --k8s-namespace <namespace> --use-k8s --preferred-primary-replica <replica>
Contoh:
az sql mi-arc update --name sqldemo --k8s-namespace my-namespace --use-k8s --preferred-primary-replica sqldemo-3
Nota
Kubernetes akan mencoba menetapkan replika yang diinginkan, tetapi tidak ada jaminan.
Memulihkan database ke instans multi-replika
Langkah tambahan diperlukan untuk memulihkan database ke dalam grup ketersediaan. Langkah-langkah berikut menunjukkan cara memulihkan database ke dalam instans terkelola dan menambahkannya ke grup ketersediaan.
Mengekspos titik akhir eksternal instans utama dengan membuat layanan Kubernetes baru.
Tentukan pod yang menghosting replika utama. Sambungkan ke instans terkelola dan jalankan:
SELECT @@SERVERNAMEKueri mengembalikan pod yang menempatkan replika utama.
Buat layanan Kubernetes ke instans utama dengan menjalankan perintah berikut jika kluster Kubernetes Anda menggunakan
NodePortlayanan. Ganti<podName>dengan nama server yang dikembalikan pada langkah sebelumnya,<serviceName>dengan nama pilihan untuk layanan Kubernetes yang dibuat.kubectl -n <namespaceName> expose pod <podName> --port=1533 --name=<serviceName> --type=NodePortUntuk layanan LoadBalancer, jalankan perintah yang sama, kecuali bahwa jenis layanan yang dibuat adalah
LoadBalancer. Contohnya:kubectl -n <namespaceName> expose pod <podName> --port=1533 --name=<serviceName> --type=LoadBalancerBerikut adalah contoh perintah ini yang dijalankan terhadap Azure Kubernetes Service, di mana pod yang menghosting utama adalah
sql2-0:kubectl -n arc-cluster expose pod sql2-0 --port=1533 --name=sql2-0-p --type=LoadBalancerDapatkan IP layanan Kubernetes yang dibuat:
kubectl get services -n <namespaceName>Pulihkan database ke titik akhir instans utama.
Tambahkan file cadangan database ke dalam kontainer instans utama.
kubectl cp <source file location> <pod name>:var/opt/mssql/data/<file name> -c <serviceName> -n <namespaceName>Contoh
kubectl cp /home/WideWorldImporters-Full.bak sql2-1:var/opt/mssql/data/WideWorldImporters-Full.bak -c arc-sqlmi -n arcPulihkan file cadangan database dengan menjalankan perintah di bawah ini.
RESTORE DATABASE test FROM DISK = '/var/opt/mssql/data/<file name>.bak'
WITH MOVE '<database name>' to '/var/opt/mssql/data/<file name>.mdf'
,MOVE '<database name>' to '/var/opt/mssql/data/<file name>_log.ldf'
,RECOVERY, REPLACE, STATS = 5;
GO
Contoh
RESTORE Database WideWorldImporters
FROM DISK = '/var/opt/mssql/data/WideWorldImporters-Full.BAK'
WITH
MOVE 'WWI_Primary' TO '/var/opt/mssql/data/WideWorldImporters.mdf',
MOVE 'WWI_UserData' TO '/var/opt/mssql/data/WideWorldImporters_UserData.ndf',
MOVE 'WWI_Log' TO '/var/opt/mssql/data/WideWorldImporters.ldf',
MOVE 'WWI_InMemory_Data_1' TO '/var/opt/mssql/data/WideWorldImporters_InMemory_Data_1',
RECOVERY, REPLACE, STATS = 5;
GO
Tambahkan database ke grup ketersediaan.
Agar database ditambahkan ke AG, database harus berjalan dalam mode pemulihan penuh dan cadangan log harus diambil. Jalankan pernyataan TSQL di bawah ini untuk menambahkan database yang dipulihkan ke dalam grup ketersediaan.
ALTER DATABASE <databaseName> SET RECOVERY FULL;
BACKUP DATABASE <databaseName> TO DISK='<filePath>'
ALTER AVAILABILITY GROUP containedag ADD DATABASE <databaseName>
Contoh berikut menambahkan database bernama
WideWorldImportersyang dipulihkan pada instans:ALTER DATABASE WideWorldImporters SET RECOVERY FULL; BACKUP DATABASE WideWorldImporters TO DISK='/var/opt/mssql/data/WideWorldImporters.bak' ALTER AVAILABILITY GROUP containedag ADD DATABASE WideWorldImporters
Penting
Sebagai praktik terbaik, Anda harus menghapus layanan Kubernetes yang dibuat di atas dengan menjalankan perintah ini:
kubectl delete svc sql2-0-p -n arc
Keterbatasan
SQL Managed Instance yang diaktifkan oleh grup ketersediaan Azure Arc memiliki batasan yang sama dengan grup ketersediaan Kluster Big Data. Untuk informasi selengkapnya, lihat Menyebarkan Kluster Big Data SQL Server dengan ketersediaan tinggi.
Konten terkait
Pelajari selengkapnya tentang Fitur dan Kemampuan SQL Managed Instance yang diaktifkan oleh Azure Arc