Catatan
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba masuk atau mengubah direktori.
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba mengubah direktori.
Migrasikan beban kerja Anda dari komputasi klasik ke komputasi tanpa server. Komputasi tanpa server menangani provisi, penskalaan, peningkatan runtime, dan pengoptimalan secara otomatis.
Sebagian besar beban kerja klasik dapat bermigrasi dengan perubahan kode minimal atau tanpa perubahan. Halaman ini berfokus pada beban kerja tersebut. Beberapa fitur, seperti df.cache, belum didukung pada tanpa server, tetapi tidak akan memerlukan perubahan kode setelah tersedia. Beban kerja tertentu yang bergantung pada notebook R atau Scala memerlukan komputasi klasik dan tidak akan dapat bermigrasi ke tanpa server. Untuk daftar lengkap batasan saat ini, lihat Batasan komputasi tanpa server.
Migrasi dengan agen migrasi
Important
Fitur ini ada di Beta. Administrator ruang kerja dapat mengaktifkannya dari halaman Pratinjau dengan ikut serta dalam pratinjau Agen Komputasi. Lihat Kelola Pratinjau Azure Databricks.
Anda dapat menggunakan agen migrasi untuk memigrasikan satu notebook atau pekerjaan ke komputasi serverless. Agen meninjau lingkungan beban kerja, pustaka, konfigurasi Spark, tag, dan kode, lalu mengusulkan setiap perubahan sebagai saran individual untuk Anda terima atau tolak. Perubahan yang diterima diterapkan langsung dan dapat dikembalikan.
Apa yang ditinjau dan diubah oleh agen
| Area | Apa yang dilakukan agen |
|---|---|
| Lingkungan dan perpustakaan | Menerjemahkan instalasi pustaka ke dalam spesifikasi lingkungan serverless, termasuk instalasi %pip, skrip inisialisasi klaster, pustaka klaster pada job, dan referensi ke indeks paket privat. |
| Variabel lingkungan | Menerjemahkan variabel lingkungan cluster ke versi serverless-nya, mempertahankan referensi rahasia workspace dan menghilangkan nilai yang dikelola platform. |
| Akses data dan penyimpanan | Menulis ulang jalur yang tidak kompatibel tanpa server, seperti disk lokal, dbfs:/, dan jalur mount, ke volume Unity Catalog. Agen menerapkan penulisan ulang yang tidak ambigu secara otomatis dan meminta Anda memilih volume ketika target ambigu. |
| Konfigurasi Spark | Mengklasifikasikan setiap konfigurasi Spark, mengomentari konfigurasi yang aman untuk dihapus, serta menandai dan menghapus konfigurasi yang tidak didukung serverless. Mencakup konfigurasi yang terhubung ke klaster dan konfigurasi dalam notebook. |
| Kode beban kerja | Menulis ulang kode yang tidak didukung oleh serverless ke padanan yang kompatibel, seperti operasi RDD yang ditulis ulang menjadi operasi DataFrame, serta menyesuaikan kode untuk perilaku SQL dalam mode ANSI pada serverless. |
| Tagar | Menerjemahkan tag cluster kustom, seperti tag cost-center, ke padanan serverless-nya. |
| Mode kinerja | Menyarankan mode performa berdasarkan konfigurasi klaster. Lihat Memilih mode performa. |
Persyaratan
Akses admin workspace direkomendasikan untuk memastikan migrasi lengkap. Hal ini karena agen juga memeriksa skrip inisialisasi global di tingkat ruang kerja selain beban kerja target. Anda mungkin dapat melakukan migrasi jika Anda memiliki izin
CAN MANAGEuntuk workload tersebut, tetapi tanpa izin admin, hal ini dapat mengakibatkan library, pengaturan lingkungan, atau tag tidak ikut termigrasi.Konfirmasi Anda memiliki akses ke agen. Ketik
/computedi Genie Code./computeseharusnya muncul di menu pelengkapan otomatis. Jika tidak muncul, admin ruang kerja harus mengaktifkan pratinjau tersebut di ruang kerja Anda.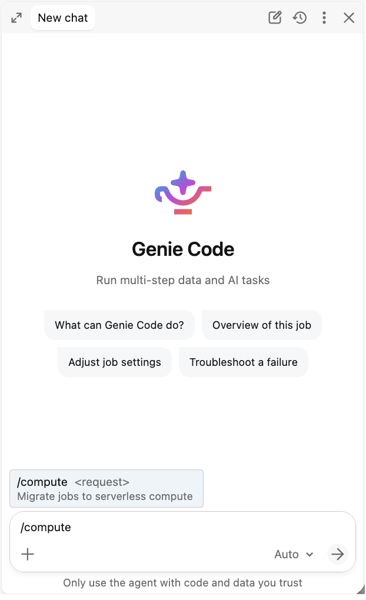
Migrasikan notebook
- Buka buku catatan yang ingin Anda migrasikan.
- Buka Genie Code dan jalankan
/compute migrate to serverlessdari/palet perintah. - Tinjau temuan agen. Agen memindai lingkungan notebook, pustaka, dan kode, serta mengusulkan perubahan untuk setiap item yang membutuhkannya, seperti memindahkan instalasi pustaka ke spesifikasi lingkungan atau menulis ulang sel kode agar berjalan di serverless.
- Terima atau tolak setiap perubahan yang diusulkan.
- Terapkan perubahan yang Anda terima. Data tersebut ditulis langsung di buku catatan itu.
- Sambungkan notebook ke serverless dan jalankan untuk memastikan bahwa berperilaku sesuai harapan. Lihat Memverifikasi beban kerja yang dimigrasikan.
Migrasi pekerjaan
- Buka pekerjaan yang ingin Anda migrasikan.
- Buka Genie Code dan jalankan
/compute migrate to serverlessdari/palet perintah. - Agen akan mengkloning pekerjaan Anda dan mencoba memigrasikan pekerjaan yang dikloning ke serverless.
- Tinjau temuan agen. Untuk pekerjaan multi-tugas, agen mencatat setiap tugas dan konfigurasi klaster per tugasnya, serta mengusulkan perubahan untuk masing-masing sambil mempertahankan jadwal pekerjaan tersebut.
- Terima atau tolak setiap perubahan yang diusulkan di seluruh permukaan migrasi: lingkungan dan pustaka, konfigurasi Spark, serta kode beban kerja yang harus berubah.
- Terapkan perubahan yang Anda terima. Komputasi pekerjaan dialihkan ke serverless.
- Jalankan pekerjaan di serverless dan konfirmasi hasilnya. Lihat Memverifikasi beban kerja yang dimigrasikan.
- Secara opsional, sebagai langkah terakhir, agen mempromosikan klon hasil migrasi. Ia menyalin konfigurasi dan notebook klon kembali ke pekerjaan asli Anda (mempertahankan ID pekerjaan, jadwal, dan izin yang sama), lalu menghapus klon tersebut. Jika Anda melewati promosi dan tetap menjalankan kedua job, jeda jadwal pada job yang tidak sedang Anda jalankan; jika tidak, pemicu yang sama akan menjalankan keduanya dan dapat menyebabkan duplikasi penulisan atau efek samping lainnya.
Verifikasi beban kerja yang dimigrasi
Agen mengusulkan dan menerapkan perubahan, tetapi tidak menjalankan beban kerja Anda atau memverifikasi hasilnya. Selalu jalankan beban kerja yang dimigrasi di serverless dan konfirmasi hasilnya sebelum Anda mengandalkannya, terutama untuk beban kerja yang menulis ke tabel produksi. Jika agen mengusulkan perubahan yang terlihat salah, tolak dan kirimkan umpan balik agar kami dapat memperbaiki agen tersebut. Lihat Mengirimkan umpan balik produk.
Tip
Saat Anda memvalidasi beban kerja yang dimigrasikan, jalankan dalam mode yang dioptimalkan untuk performa. Fitur ini mulai lebih cepat dari mode standar, jadi Anda mendapatkan umpan balik lebih cepat saat mengonfirmasi hasilnya. Beralih ke mode yang paling sesuai dengan beban kerja sebelum dijalankan di produksi. Lihat Memilih mode performa.
Ketika agen menemukan sesuatu yang tidak dapat dimigrasikan dengan aman, ia melaporkan kendala dan berhenti secara bawaan. Anda dapat secara eksplisit menginstruksikannya untuk melewati beberapa kendala kompatibilitas atau dependensi, tetapi hal itu berarti menerima risiko bahwa dependensi, atribusi biaya, atau perilaku runtime tersebut mungkin tidak ikut terbawa, dan beban kerja dapat gagal pada lingkungan serverless.
Batalkan perubahan migrasi
Perubahan yang diterapkan agen dapat dibalik.
Untuk notebook, buka dan pulihkan revisi tepat sebelum migrasi. Lihat Riwayat versi di buku catatan Databricks.
Untuk sebuah pekerjaan, jika Anda tidak mempromosikan klon yang dimigrasikan, pekerjaan asli Anda tidak pernah berubah: jalankan seperti sebelumnya dan hapus klonnya. Jika Anda mempromosikan klon, pulihkan dari cadangan yang dibuat oleh agen sebelum agen tersebut membuat perubahan apa pun:
- Buka folder cadangan di direktori utama ruang kerja Anda:
/Workspace/Users/<your-username>/serverless-migration/backups/job-<job-id>/<timestamp>/. Agen menunjukkan jalur ini selama migrasi. Jika ada beberapa timestamp, pilih yang tepat sebelum migrasi. - Buka
job.yaml, yang menyimpan pengaturan job pra-migrasi Anda, lalu terapkan kembali pengaturan tersebut ke job yang sama dengan requestPOST /api/2.2/jobs/reset, yang menimpa pengaturan job dengan pengaturan yang Anda berikan. Anda juga bisa menempelkannya ke dalam definisi JSON pekerjaan di UI. Ini mengembalikan pekerjaan ke komputasi klasik. - Buka
mapping.yaml, yang mencantumkan setiap file cadangan dan jalur aslinya. Salin setiap file cadangan kembali ke jalur aslinya untuk membatalkan penulisan ulang kode. - Jalankan pekerjaan untuk memastikan perilakunya seperti sebelum migrasi.
Migrasi tidak pernah menghapus cadangan ini. Tugas yang tidak diubah oleh agen, seperti tugas yang berasal dari Git, tugas SQL, atau tugas dbt, dicatat dalam job.yaml, tetapi file-file tersebut tidak disalin ke cadangan, jadi pulihkan dari sumber utama Anda jika diperlukan.
Batasan yang diketahui
- Berikut ini dilaporkan sebagai faktor penghambat: image kustom, varian ML Runtime, versi Databricks Runtime yang lebih lama dari 13, konfigurasi Spark yang tidak dapat diabaikan dengan aman pada serverless, dan dependensi seperti eggs, JAR, dan pustaka Maven. Blocker berarti agen menghentikan item tersebut, bukan memigrasikan. Anda bisa menyelesaikannya sendiri dan menjalankan migrasi lagi, atau meminta agen untuk tetap bermigrasi, yang membuat item tersebut tidak terselesaikan dan mungkin menyebabkan beban kerja gagal di serverless.
- Agen membaca skrip init yang disimpan di file workspace atau volume Unity Catalog. Skrip init yang disimpan di ABFSS atau DBFS tidak dapat dibaca dan dilaporkan sebagai blocker.
- Agen tidak memeriksa setiap atribut komputasi klasik. Pengiriman log klaster dan kunci SSH tidak dimodelkan, dan meskipun mendeteksi banyak ketergantungan mount DBFS dari kode beban kerja, ia tidak mencatat atau menyelesaikan setiap mount.
- API cache dan checkpoint, tampilan sementara global, pemanggilan manajemen mount DBFS, serta kode Scala atau R secara default merupakan penghambat utama. Anda dapat menginstruksikan agen untuk melanjutkan, tetapi fungsi yang belum terselesaikan tetap tidak berubah dan mungkin gagal di serverless.
- Pekerjaan dengan lebih dari 10 tugas yang dapat dimigrasikan saat ini tidak dapat dimigrasikan.
- Agen memigrasi satu beban kerja pada satu waktu. Tidak ada penemuan di seluruh armada, migrasi massal, atau alur kerja persetujuan admin.
- Agen mengusulkan perubahan dan menerapkan perubahan yang Anda terima, tetapi tidak menjalankan beban kerja Anda atau memverifikasi kebenaran output. Verifikasi beban kerja yang dimigrasikan sebelum mengandalkannya untuk data produksi.
- Jika sumber kebenaran beban kerja Anda adalah Databricks Asset Bundle atau folder Git, agen akan menerapkan perubahan pada objek workspace yang ada. Selaraskan perubahan tersebut dengan bundle atau repositori Anda agar penerapan berikutnya tidak menimpa migrasi.
Migrasi ke serverless secara manual
Untuk memigrasikan beban kerja Anda dari komputasi klasik ke komputasi tanpa server, ikuti langkah-langkah berikut:
- Periksa prasyarat: Verifikasi bahwa ruang kerja, jaringan, dan akses penyimpanan cloud Anda memenuhi persyaratan. Lihat Prasyarat.
- Kode pembaruan: Buat perubahan kode dan konfigurasi yang diperlukan. Lihat Memperbarui kode Anda.
- Uji beban kerja Anda: Validasi kompatibilitas dan keakuratan sebelum beralih. Lihat Menguji beban kerja Anda.
- Pilih mode performa: Pilih mode performa yang paling sesuai dengan persyaratan beban kerja Anda. Lihat Memilih mode performa.
- Bermigrasi secara bertahap: Meluncurkan tanpa server secara bertahap, dimulai dengan beban kerja baru dan berisiko rendah. Lihat Bermigrasi secara bertahap.
- Memantau biaya: Melacak konsumsi DBU tanpa server dan menyiapkan pemberitahuan. Lihat Pemantauan biaya.
Prerequisites
Sebelum mulai bermigrasi, Anda mungkin perlu memperbarui beberapa konfigurasi warisan di ruang kerja Anda.
| Prasyarat | Action | Rincian |
|---|---|---|
| Ruang kerja telah diaktifkan untuk Katalog Unity | Bermigrasi dari Apache Hive Metastore jika diperlukan | Mutakhirkan ruang kerja Azure Databricks ke Unity Catalog |
| Jaringan telah dikonfigurasi | Ganti peering VPC dengan aturan NCC, Private Link, atau firewall | Jaringan sarana komputasi tanpa server |
| Akses penyimpanan cloud | Ganti pola akses data lama dengan lokasi eksternal Katalog Unity | Menyambungkan ke penyimpanan objek cloud menggunakan Katalog Unity |
Konfirmasikan ruang kerja Anda berada di wilayah yang didukung.
Memperbarui kode Anda
Bagian berikut mencantumkan kode dan perubahan konfigurasi yang diperlukan untuk membuat beban kerja Anda kompatibel dengan tanpa server.
Akses data
Pola akses data legacy tidak didukung pada serverless. Perbarui kode Anda untuk menggunakan Katalog Unity sebagai gantinya.
| Pola klasik | Penggantian tanpa server | Rincian |
|---|---|---|
Jalur DBFS (dbfs:/...) |
Katalog Volume Unity | Apa yang dimaksud dengan volume pada Katalog Unity? |
| Tabel Metastore Apache Hive | Tabel Katalog Unity (atau Federasi HMS) | Mutakhirkan ruang kerja Azure Databricks ke Unity Catalog |
| Kredensial akun penyimpanan | Lokasi eksternal Katalog Unity | Menyambungkan ke penyimpanan objek cloud menggunakan Katalog Unity |
| Kustom JAR JDBC | Federasi Lakehouse | Apa itu federasi kueri? |
Peringatan
Akses DBFS terbatas pada tanpa server. Perbarui semua jalur dbfs:/ ke volume Katalog Unity sebelum melakukan migrasi. Untuk informasi selengkapnya, lihat Memigrasikan file yang disimpan di DBFS.
Contoh: Ganti jalur DBFS dan referensi Hive Metastore
# Classic
df = spark.read.csv("dbfs:/mnt/datalake/data.csv", header=True)
df.write.parquet("dbfs:/mnt/output/results")
df = spark.table("my_database.my_table")

# Serverless
df = spark.read.csv("/Volumes/main/sales/raw_data/data.csv", header=True)
df.write.parquet("/Volumes/main/analytics/output/results")
df = spark.table("main.my_database.my_table")  # three-level namespace
API dan kode
API dan pola kode tertentu tidak didukung pada tanpa server. Referensikan tabel ini untuk melihat apakah kode Anda perlu diperbarui.
| Pola klasik | Penggantian tanpa server | Rincian |
|---|---|---|
API RDD (sc.parallelize, rdd.map) |
API DataFrame | Membandingkan Spark Connect dengan Spark Classic |
df.cache(), df.persist() |
Menghapus panggilan cache | Batasan komputasi tanpa server |
spark.sparkContext, sqlContext |
Gunakan spark (SparkSession) secara langsung |
Membandingkan Spark Connect dengan Spark Classic |
Variabel Hive (${var}) |
SQL DECLARE VARIABLE atau Python f-strings |
DECLARE VARIABLE |
| Konfigurasi Spark yang tidak didukung | Hapus konfigurasi yang tidak didukung. Serverless secara otomatis menyetel dan mengoptimalkan sebagian besar pengaturan. | Mengonfigurasi properti Spark untuk buku catatan dan pekerjaan tanpa server |
Contoh: Ganti operasi RDD dengan DataFrames
from pyspark.sql import functions as F

# sc.parallelize + rdd.map
# Classic:  rdd = sc.parallelize([1, 2, 3]); rdd.map(lambda x: x * 2).collect()
df = spark.createDataFrame([(1,), (2,), (3,)], ["value"])
result = df.select((F.col("value") * 2).alias("value")).collect()

# rdd.flatMap
# Classic:  sc.parallelize(["hello world"]).flatMap(lambda l: l.split(" ")).collect()
df = spark.createDataFrame([("hello world",)], ["line"])
words = df.select(F.explode(F.split("line", " ")).alias("word")).collect()

# rdd.groupByKey
# Classic:  rdd.groupByKey().mapValues(list).collect()
df = spark.createDataFrame([("a", 1), ("b", 2), ("a", 3)], ["key", "value"])
grouped = df.groupBy("key").agg(F.collect_list("value").alias("values")).collect()

# rdd.mapPartitions → applyInPandas
import pandas as pd
def process_group(pdf: pd.DataFrame) -> pd.DataFrame:
    return pd.DataFrame({"total": [pdf["id"].sum()]})
result = (spark.range(100).repartition(4)
    .groupBy(F.spark_partition_id())
    .applyInPandas(process_group, schema="total long").collect())

# sc.textFile → spark.read.text
df = spark.read.text("/Volumes/catalog/schema/volume/file.txt")
Contoh: Ganti SparkContext dan caching
from pyspark.sql.functions import broadcast

# sc.broadcast → broadcast join
result = main_df.join(broadcast(lookup_df), "key")

# sc.accumulator → DataFrame aggregation
total = df.agg(F.sum("amount")).collect()[0][0]

# sqlContext.sql → spark.sql
result = spark.sql("SELECT * FROM main.db.table")

# df.cache() → remove caching calls
# Materialize expensive intermediate results to Delta as a workaround:
df = spark.read.parquet(path)
result = df.filter("status = 'active'")
expensive_df.write.format("delta").mode("overwrite").saveAsTable("main.scratch.temp")
result = spark.table("main.scratch.temp")
Perbedaan perilaku SQL
Komputasi serverless secara default mengaktifkan mode ANSI. Databricks Runtime mengaktifkan mode ANSI secara default pada versi 17.0 ke atas. Jika komputasi klasik Anda menjalankan versi sebelumnya, beberapa query yang berhasil di sana akan menimbulkan error runtime pada serverless.
agen migrasi secara otomatis menyesuaikan kode untuk perilaku mode ANSI. Jika Anda melakukan migrasi secara manual, tinjau operasi berikut yang paling sering mengubah perilaku:
| Operasi | Komputasi klasik dengan mode ANSI dinonaktifkan | Komputasi tanpa server |
|---|---|---|
Cast tidak valid, seperti CAST('abc' AS INT) |
Mengembalikan NULL |
Menghasilkan CAST_INVALID_INPUT |
| Overflow aritmetika bilangan bulat | Melingkar. Misalnya, 2147483647 + 1 mengembalikan -2147483648. |
Memunculkan ARITHMETIC_OVERFLOW |
| Luapan aritmetika desimal | Mengembalikan NULL |
Memunculkan NUMERIC_VALUE_OUT_OF_RANGE |
| Pembagian dengan nol | Mengembalikan NULL |
Menghasilkan DIVIDE_BY_ZERO |
| URL tidak valid di parse_url | Mengembalikan NULL |
Kenaikan INVALID_URL |
Untuk mengembalikan NULL alih-alih menimbulkan kesalahan, ganti operasi dengan try_* yang setara, seperti try_cast, try_add, try_divide, atau try_parse_url. Databricks merekomendasikan pendekatan ini daripada menonaktifkan mode ANSI, karena mode ANSI memunculkan masalah kualitas data yang disembunyikan silent NULL.
Untuk menonaktifkan mode ANSI untuk cast, aritmetika, dan parsing, atur spark.sql.ansi.enabled ke false. Komputasi tanpa server menerapkan aturan ANSI pada cast implisit pada sisipan tabel tanpa memandang pengaturan ini, karena spark.sql.storeAssignmentPolicy tidak dapat diubah pada komputasi tanpa server. Untuk deskripsi lengkap perilaku ANSI, lihat kepatuhan ANSI di Databricks Runtime.
Pustaka dan lingkungan
Anda dapat mengelola pustaka dan lingkungan di tingkat ruang kerja menggunakan lingkungan dasar dan pada tingkat buku catatan menggunakan lingkungan tanpa server milik buku catatan.
| Pola klasik | Penggantian tanpa server | Rincian |
|---|---|---|
| Skrip Inisialisasi | Lingkungan tanpa server | Mengonfigurasi lingkungan tanpa server |
| Pustaka cakupan kluster | Pustaka lingkup notebook atau lingkungan | Mengonfigurasi lingkungan tanpa server |
| Pustaka Maven dan JAR | Dukungan tugas JAR untuk pekerjaan; PyPI untuk buku catatan | Tugas JAR untuk pekerjaan |
| Kontainer Docker | Lingkungan tanpa server untuk kebutuhan pustaka | Mengonfigurasi lingkungan tanpa server |
Sematkan paket Python di requirements.txt untuk lingkungan yang dapat direproduksi. Lihat versi paket Specify Python.
Siaran Langsung
Beban kerja streaming didukung pada platform serverless, tetapi pemicu tertentu tidak didukung. Perbarui kode Anda untuk menggunakan pemicu yang didukung.
| Pemicu Spark | Dukungan | Catatan |
|---|---|---|
Trigger.AvailableNow() |
Yes | Recommended |
Trigger.Once() |
Yes | Ini tidak digunakan lagi. Gunakan Trigger.AvailableNow() sebagai gantinya. |
Trigger.ProcessingTime(interval) |
No | Mengembalikan INFINITE_STREAMING_TRIGGER_NOT_SUPPORTED |
Trigger.Continuous(interval) |
No | Gunakan mode berkelanjutan Lakeflow Pipelines sebagai gantinya |
Default (tanpa pengaturan .trigger()) |
No | Menghilangkan .trigger() akan default ke ProcessingTime("0 seconds"), yang tidak didukung pada lingkungan serverless. Selalu atur .trigger(availableNow=True) secara eksplisit. |
Untuk streaming berkelanjutan, migrasikan ke Spark Declarative Pipelines dalam mode berkelanjutan atau gunakan pekerjaan jadwal berkelanjutan dengan AvailableNow. Untuk sumber besar, atur maxFilesPerTrigger atau maxBytesPerTrigger untuk mencegah kesalahan di luar memori.
Contoh: Memperbaiki pemicu streaming
# Classic (not supported on serverless — default trigger is ProcessingTime)
query = df.writeStream.format("delta").outputMode("append").start()

# Serverless (explicit AvailableNow trigger)
query = (df.writeStream.format("delta").outputMode("append")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
query.awaitTermination()

# With OOM prevention for large sources
query = (spark.readStream.format("delta")
    .option("maxFilesPerTrigger", 100)
    .option("maxBytesPerTrigger", "10g")
    .load(input_path)
    .writeStream.format("delta")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
Menguji beban kerja Anda
- Uji kompatibilitas cepat: Jalankan beban kerja pada komputasi klasik dengan mode akses Standar dan Databricks Runtime 14.3 atau lebih tinggi. Jika eksekusi berhasil, beban kerja dapat bermigrasi ke tanpa server tanpa perubahan kode apa pun.
- Perbandingan A/B (disarankan untuk produksi): Jalankan beban kerja yang sama pada klasik (kontrol) dan tanpa server (eksperimen). Tabel keluaran diff dan pastikan koreksiannya. Ulangi hingga hasil sesuai.
- Konfigurasi sementara: Anda dapat mengatur konfigurasi Spark yang didukung untuk sementara waktu selama pengujian. Hapus mereka setelah stabil.
Pilih mode performa
Pekerjaan dan alur tanpa server mendukung dua mode performa: standar dan dioptimalkan performa. Mode performa yang Anda pilih tergantung pada persyaratan beban kerja Anda.
| Modus | Availability | Perusahaan rintisan | Paling cocok untuk |
|---|---|---|---|
| Standar | Pekerjaan, alur Lakeflow | 4-6 menit | Batch yang sensitif terhadap biaya |
| Dioptimalkan performa | Notebook, Pekerjaan, alur Lakeflow | Detik | Interaktif, sensitif terhadap latensi |
Bermigrasi secara bertahap
- Beban kerja baru: Mulai semua buku catatan dan pekerjaan baru tanpa server.
- Beban kerja berisiko rendah: Memigrasikan beban kerja PySpark/SQL yang sudah ada pada mode akses standar dan Databricks Runtime 14.3 atau lebih tinggi.
- Beban kerja yang kompleks: Memigrasikan beban kerja yang memerlukan perubahan kode (penulisan ulang RDD, pembaruan DBFS, perbaikan pemicu).
- Beban kerja yang tersisa: Tinjau secara berkala saat kemampuan diperluas.
Memantau biaya
Penagihan tanpa server didasarkan pada konsumsi DBU, bukan waktu aktif kluster. Validasi ekspektasi biaya dengan beban kerja representatif sebelum bermigrasi dalam skala besar. Untuk alat dan strategi untuk memantau biaya tanpa server, lihat Memantau biaya komputasi tanpa server.
Sumber daya tambahan
- Praktik terbaik untuk komputasi tanpa server: Tips pengoptimalan untuk beban kerja tanpa server
- Batasan komputasi tanpa server: Daftar lengkap batasan saat ini dan fitur yang tidak didukung
- Mengonfigurasi lingkungan tanpa server: Mengelola pustaka dan dependensi
- Konfigurasi Spark yang didukung: Konfigurasi Spark tersedia tanpa server
- Spark Connect vs. Spark klasik: Perbedaan perilaku dalam arsitektur tanpa server
- keamanan jaringan Serverless: konfigurasi NCC, Private Link, dan firewall
- Catatan rilis komputasi tanpa server: Lacak kemampuan baru saat dikirim
- Panduan peningkatan Katalog Unity: Migrasi dari Metastore Apache Hive ke Katalog Unity
Anda juga dapat merujuk ke posting blog berikut untuk informasi selengkapnya:
- Apa itu komputasi tanpa server?: Gambaran umum kemampuan tanpa server dan hasil pelanggan
- Evolusi rekayasa data: Bagaimana komputasi tanpa server mengubah buku catatan dan pekerjaan Lakeflow: Cara tanpa server mendukung Pekerjaan dan Alur Lakeflow