Catatan
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba masuk atau mengubah direktori.
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba mengubah direktori.
Proyek sdp-meta dari Databricks Labs menyediakan alat untuk menghasilkan alur dari metadata yang Anda pertahankan.
Note
Proyek sumber terbuka sdp-meta, seperti semua proyek di akun databrickslabs GitHub, hanya ada untuk tujuan eksplorasi. Azure Databricks tidak mendukungnya atau menyediakan perjanjian tingkat layanan (SLA) untuknya. Jangan mengirimkan tiket dukungan Azure Databricks untuk masalah yang terkait dengan proyek ini. Sebagai gantinya, ajukan issue GitHub, yang akan ditinjau jika ada waktu.
Apa itu sdp-meta?
Pipeline Lakeflow memungkinkan Anda menentukan tabel secara deklaratif dan menghasilkan flow dalam pipeline yang membuat tabel tersebut sekaligus menjaganya tetap mutakhir saat data sumber berubah. Namun, jika organisasi Anda memiliki ratusan tabel, menghasilkan dan mengelola alur ini memakan waktu, dan dapat menyebabkan praktik yang tidak konsisten.
Proyek sdp-meta adalah kerangka kerja metaprogramming berbasis metadata yang dirancang untuk bekerja dengan pipeline Lakeflow. Kerangka kerja ini memungkinkan otomatisasi alur data perunggu dan perak dengan memanfaatkan metadata yang dicatat dalam satu set file JSON dan YAML. Saat dijalankan, pipeline generik membaca metadata Anda dan secara dinamis membangun alur yang dijelaskan di dalamnya. Pengolahan perunggu dan perak dapat berjalan dalam pipa terpisah atau bersama-sama dalam pipa gabungan. Anda membuat metadata untuk pipeline Anda, dan sdp-meta membangun pipeline Anda.
Dengan logika Anda terpusat di satu tempat (metadata), sistem Anda lebih cepat, dapat digunakan kembali, dan lebih mudah dipertahankan.
Note
Proyek sdp-meta sebelumnya dinamai dlt-meta, diambil dari fitur Delta Live Tables lama di Azure Databricks.
Delta Live Tables telah digantikan oleh pipa Lakeflow, dan sdp-meta bekerja sama dengan pipa Lakeflow. Jika Anda sedang meningkatkan instalasi yang sudah ada dlt-meta , lihat panduan migrasi di dokumentasi sdp-meta.
Manfaat sdp-meta
Ada dua kasus penggunaan utama untuk sdp-meta:
- Serap dan bersihkan sejumlah besar tabel secara sederhana.
- Menerapkan standar rekayasa data di beberapa alur dan pengguna.
Manfaat menggunakan pendekatan berbasis metadata meliputi:
- Mempertahankan metadata dapat dilakukan tanpa sepengetahuan kode Python atau SQL.
- Mempertahankan metadata, daripada kode, membutuhkan lebih sedikit overhead, dan mengurangi kesalahan.
- Kode dihasilkan oleh sdp-meta, sehingga tetap konsisten dan memiliki kode kustom yang lebih sedikit di antara pipeline dan tabel yang dipublikasikan.
- Anda dapat dengan mudah mengelompokkan tabel ke dalam alur dalam metadata, menghasilkan jumlah alur yang diperlukan untuk memperbarui data Anda secara paling efisien.
Cara kerja sdp-meta
Gambar berikut menunjukkan gambaran umum sistem sdp-meta:
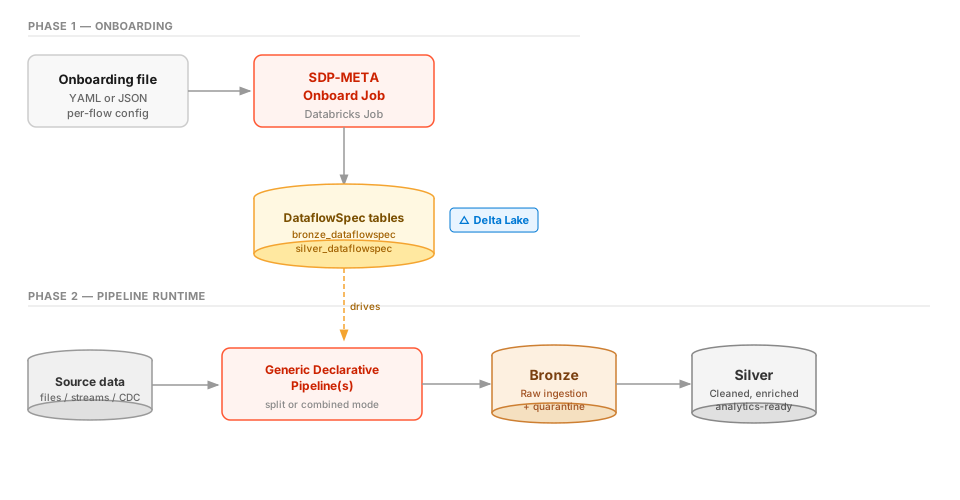
- Anda membuat file metadata sebagai input ke sdp-meta, untuk menentukan file sumber dan output, aturan kualitas, serta pemrosesan yang diperlukan. File onboarding ini dapat ditulis dalam JSON atau YAML.
- Anda menjalankan pekerjaan onboarding SDP-meta. Mesin ini mengompilasi file onboarding ke dalam spesifikasi alur data yang disebut DataflowSpec, dan menyimpannya dalam tabel Delta (
bronze_dataflowspecdansilver_dataflowspec) untuk digunakan nanti. - Saat dijalankan, pipeline generik membaca DataflowSpec dan membangun graf pemrosesan bronze secara dinamis. Aplikasi ini membaca data sumber Anda (file, stream, atau CDC) dan menerapkan ekspektasi data yang tepat agar sesuai dengan aturan kualitas Anda, menghasilkan tabel perunggu dan mengarantina catatan yang gagal pada aturan tersebut.
- Pemrosesan Silver dapat berjalan dalam alur generik yang terpisah, yang merupakan setelan default untuk Bundel Otomatisasi Deklaratif, atau dalam alur yang sama saat Anda menggunakan mode gabungan. Pipeline menggunakan DataflowSpec untuk menerapkan transformasi yang sesuai dan pemrosesan lainnya, sehingga menghasilkan tabel silver yang telah dibersihkan, diperkaya, dan siap untuk analisis.
Anda menjalankan pipeline yang dihasilkan oleh sdp-meta untuk menjaga output tetap mutakhir saat data sumber Anda diperbarui.
Get started
Untuk menggunakan sdp-meta, Anda harus:
- Sebarkan dan konfigurasikan solusi sdp-meta.
- Siapkan metadata untuk tabel lapisan perunggu dan perak Anda.
- Buat tugas untuk mengimpor metadata.
- Gunakan metadata untuk membuat alur untuk tabel Anda.
Proyek sdp-meta mendukung beberapa antarmuka penerapan: bundles (direkomendasikan), CLI interaktif, Databricks App dengan GUI berbasis peramban, server MCP untuk penyiapan dengan bantuan AI, dan Agent Skill portabel untuk agen AI yang memahami keterampilan.
Dokumentasi sdp-meta di GitHub memiliki tutorial untuk membantu Anda memulai proses ini. Untuk informasi lebih lanjut, lihat memulai dengan sdp-meta di GitHub.