Catatan
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba masuk atau mengubah direktori.
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba mengubah direktori.
Kontrol akses
Fitur adalah objek Katalog Unity yang dapat diatur. Akses ke fitur dikontrol oleh CREATE FEATUREREAD FEATUREhak istimewa , , dan MANAGE Unity Catalog. Untuk deskripsi lengkap, lihat Referensi hak istimewa Katalog Unity.
-
CREATE FEATURE: Diperlukan untuk membuat fitur dalam sebuah skema.create_featuredanregister_featurerequireCREATE FEATUREpada skema induk. Mengikuti prinsip hak istimewa paling sedikit, pemberianCREATE FEATUREpada tingkat skema; Anda juga dapat memberikannya pada katalog untuk memungkinkan pembuatan fitur dalam skema apa pun dalam katalog tersebut. -
READ FEATURE: Diperlukan untuk membaca metadata fitur.get_feature,create_training_set, danlist_materialized_featuresmembutuhkanREAD FEATUREpada fitur. Hak istimewa ini tidak memberikan akses ke data fitur dalam tabel output sumber atau materialized. Untuk membaca data pelatihan atau pelayanan, Anda juga harus memilikiSELECTtabel yang relevan.READ FEATURETentu saja, pada sebuah skema atau katalog berlaku untuk semua fitur saat ini dan yang akan datang yang terkandung di dalamnya. -
MANAGE: Diperlukan untuk mengelola siklus hidup dan hibah sebuah fitur. Menghapus fitur dengandelete_feature, dan materialisasi fitur denganmaterialize_features, memerlukanMANAGEpada fitur tersebut. Menghapus fitur materialisasi dengandelete_materialized_featuretidak diatur olehMANAGE: hanya pembuat fitur materialisasi yang dapat menghapusnya.
Semua operasi fitur juga diperlukan USE CATALOG pada katalog induk dan USE SCHEMA pada skema induk. Untuk cara MANAGE dan READ FEATURE berlaku untuk materialisasi, lihat Izin.
API Tampilan Fitur
Feature konstruktor dan register_feature()
Pendekatan yang Feature disarankan adalah membuat objek secara lokal dan menggunakannya register_feature untuk mempertahankannya ke Katalog Unity. Alur kerja dua langkah ini memungkinkan Anda bereksperimen dengan fitur (termasuk create_training_set) sebelum mendaftarkannya.
Feature(
    source: DataSource,                                    # Required: DeltaTableSource, StreamSource, RequestSource, or FeatureViewSource
    function: Union[AggregationFunction, ColumnSelection, CustomUDF], # Required for all features
    entity: Optional[List[str]] = None,                    # Required for DeltaTableSource and StreamSource
    timeseries_column: Optional[str] = None,               # Required for DeltaTableSource and StreamSource
    name: Optional[str] = None,                            # Optional: Feature name (auto-generated if omitted)
    description: Optional[str] = None,                     # Optional: Feature description
)
FeatureEngineeringClient.register_feature() mendaftarkan sebuah yang dibangun Feature secara lokal di Unity Catalog.
FeatureEngineeringClient.register_feature(
    feature: Feature,       # Required: A Feature instance (not already registered)
    catalog_name: str,      # Required: UC catalog name
    schema_name: str,       # Required: UC schema name
) -> Feature
from databricks.feature_engineering.entities import Feature, DeltaTableSource, AggregationFunction, Sum, RollingWindow
from datetime import timedelta

# Step 1: Construct the feature locally
feature = Feature(
    source=DeltaTableSource(catalog_name="main", schema_name="store", table_name="transactions"),
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)

# Step 2: Register in Unity Catalog
fe = FeatureEngineeringClient()
registered_feature = fe.register_feature(
    feature=feature,
    catalog_name="main",
    schema_name="store",
)
create_feature()
FeatureEngineeringClient.create_feature() memvalidasi, membangun, dan langsung mendaftarkan fitur di Unity Catalog dalam satu langkah. Gunakan ini saat Anda tidak perlu bereksperimen dengan fitur secara lokal terlebih dahulu.
FeatureEngineeringClient.create_feature(
    source: DataSource,                                    # Required: DeltaTableSource, StreamSource, RequestSource, or FeatureViewSource
    function: Union[AggregationFunction, ColumnSelection, CustomUDF], # Required for all features
    catalog_name: str,                                     # Required: The catalog name for the feature
    schema_name: str,                                      # Required: The schema name for the feature
    entity: Optional[List[str]] = None,                    # Required for DeltaTableSource and StreamSource
    timeseries_column: Optional[str] = None,               # Required for DeltaTableSource and StreamSource
    name: Optional[str] = None,                            # Optional: Feature name (auto-generated if omitted)
    description: Optional[str] = None,                     # Optional: Feature description
) -> Feature
Parameter:
-
source: Sumber data yang digunakan dalam perhitungan fitur (DeltaTableSource,StreamSource,RequestSource, atauFeatureViewSource). -
function: AnAggregationFunctionyang menggabungkan operator dan jendela waktu,ColumnSelection("column_name")untuk fitur pass-through, atauCustomUDFuntuk transformasi baris demi baris. Lihat Fungsi yang didukung untuk tipe sumber yang kompatibel. -
catalog_name: Nama katalog Unity Catalog untuk fitur ini. -
schema_name: Nama skema Unity Catalog untuk fitur tersebut. -
entity: Daftar nama kolom yang mendefinisikan kunci agregasi atau pencarian (kunci utama). Diperlukan untukDeltaTableSourcedanStreamSource. Misalnya,["user_id"]agregat atau mencari per pengguna. Hilangkan untukRequestSourcedanFeatureViewSource. -
timeseries_column: Kolom timestamp yang digunakan untuk agregasi jendela waktu atau pemilihan nilai terbaru. Diperlukan untukDeltaTableSourcedanStreamSource. Hilangkan untukRequestSourcedanFeatureViewSource. -
name: Nama fitur opsional. Jika dihilangkan, dibuat secara otomatis dari kolom input, fungsi, dan jendela (misalnya,amount_avg_rolling_7d). -
description: Deskripsi opsional tentang fitur ini.
Kembali: Instansi Fitur yang telah divalidasi
Naikkan: ValueError jika ada validasi yang gagal
delete_feature()
Menghapus fitur dari Katalog Unity dengan nama yang sepenuhnya memenuhi syarat.
FeatureEngineeringClient.delete_feature(
    full_name: str,  # Required: '<catalog>.<schema>.<feature_name>'
) -> None
fe.delete_feature(full_name="main.store.amount_sum_rolling_7d")
Sebelum menghapus fitur, hapus atau perbarui model atau spesifikasi fitur apa pun yang mereferensikannya. Sebuah fitur tidak bisa dihapus selama fitur tersebut masih termaterialisasi. Hapus fitur materialized terlebih dahulu, lalu hapus fitur tersebut. Lihat Cara menghapus fitur materialisasi.
Nama yang dibuat secara otomatis
Ketika name dihilangkan, nama dibuat secara otomatis. Nama yang dihasilkan mengikuti pola: {column}_{function}_{window}. Contohnya:
-
price_avg_rolling_1h(harga rata-rata 1 jam) -
transaction_count_rolling_30d_1d(hitungan transaksi 30 hari dengan penundaan 1d dari timestamp event)
Fungsi yang didukung
Fungsi agregasi
Note
Fungsi agregasi dibungkus AggregationFunction bersama dengan jendela waktu, seperti yang dijelaskan di jendela waktu. Setiap fungsi mengambil parameter yang input menentukan kolom sumber untuk diagregasi.
| Function | Description | Contoh kasus penggunaan |
|---|---|---|
Sum(input="column") |
Total dari nilai-nilai | Penggunaan aplikasi harian per pengguna dalam hitung menit |
Avg(input="column") |
Rata-rata nilai | Rata-rata jumlah transaksi |
Count(input="column") |
Jumlah rekaman | Jumlah login per pengguna |
Min(input="column") |
Nilai minimum | Denyut jantung terendah yang direkam oleh perangkat yang dapat dipakai |
Max(input="column") |
Nilai maksimum | Jumlah transaksi tertinggi per sesi |
StddevPop(input="column") |
Simpang siur standar populasi | Varianbilitas jumlah transaksi harian di semua pelanggan |
StddevSamp(input="column") |
Sampel simpang siur standar | Variabilitas rasio klik-tayang kampanye iklan |
VarPop(input="column") |
Ragam populasi | Penyebaran pembacaan sensor untuk perangkat IoT di pabrik |
VarSamp(input="column") |
Varians sampel | Sebaran peringkat film melalui grup sampel |
ApproxCountDistinct(input="column", relativeSD=0.05) |
Perkiraan jumlah unik | Jumlah item berbeda yang dibeli |
ApproxPercentile(input="column", percentile=0.95, accuracy=100) |
Perkiraan persentil | Latensi respons p95 |
First(input="column") |
Nilai pertama | Tanda waktu masuk pertama |
Last(input="column") |
Nilai terakhir | Jumlah pembelian terbaru |
FirstN(input="column", n=3) |
Nilai pertama n sebagai array |
Tiga produk pertama yang dilihat dalam satu sesi |
LastN(input="column", n=3) |
Nilai terakhir n sebagai array |
Tiga status kasus dukungan terbaru |
FirstDistinct(input="column", n=3) |
Nilai pertama n yang berbeda sebagai array |
Tiga kategori produk pertama yang berbeda dilihat |
LastDistinct(input="column", n=3) |
Nilai terakhir n yang berbeda sebagai array |
Tiga kategori pedagang terbaru yang berbeda |
Note
First, , LastFirstN, , LastN, FirstDistinct, dan LastDistinct menerima nilai skalar yang didukung serta ARRAY, MAP, dan STRUCT nilai, termasuk kombinasi bersarang. Mereka secara default mencakup nilai null. Untuk melewati null, tambahkan filter_condition yang secara eksplisit mengecualikan kolom input yang null.
FirstN, LastN, , dan LastDistinct gunakan fitur timeseries_column untuk mengurutkan baris input dan mengembalikan array yang berisi hingga nFirstDistinctnilai. Parameter n tersebut harus berupa bilangan bulat positif.
FirstN dan FirstDistinct memilih nilai dari yang paling awal hingga yang terbaru.
LastN dan LastDistinct pilih nilai dari yang terbaru hingga terawal, lalu kembalikan nilai yang dipilih sesuai urutan timestamp.
FirstDistinct dan LastDistinct menghapus nilai duplikat sambil memilih nilai ke arah tersebut.
Sebagai contoh, jika baris sumber untuk suatu entitas diurutkan oleh event_time , ["A", "A", "B", "C", "B", "B"]fungsi berikut mengembalikan:
| Function | Result |
|---|---|
FirstN(input="event_type", n=3) |
["A", "A", "B"] |
LastN(input="event_type", n=3) |
["C", "B", "B"] |
FirstDistinct(input="event_type", n=3) |
["A", "B", "C"] |
LastDistinct(input="event_type", n=3) |
["A", "C", "B"] |
FirstN, LastN, FirstDistinct, dan LastDistinct membutuhkan databricks-feature-engineering versi 0.17.0 atau lebih baru.
CustomUDF
CustomUDFmenerapkan fungsi yang didefinisikan pengguna (UDF) Unity Catalog Python yang terdaftar ke setiap baris. Gunakan untuk mengubah input permintaan atau menggabungkan nilai fitur. Aplikasi ini tidak menggabungkan baris atau mendefinisikan jendela waktu.
CustomUDF(
    function_name="main.ecommerce.log_amount_udf",
    input_bindings={"amount": "transaction_amount"},
)
input_bindings memetakan setiap nama parameter UDF ke sebuah input. Untuk RequestSource, input adalah nama kolom sumber. Untuk FeatureViewSource, ini adalah referensi fitur hulu. Bind setiap parameter UDF, termasuk parameter dengan default. Tipe input harus cocok dengan tipe parameter UDF secara tepat, tanpa casting numerik implisit. Anda dapat menggunakan tipe input dan return skalar dan kompleks (ARRAY, MAP, dan STRUCT), termasuk kombinasi bersarang.
| Source | Behavior |
|---|---|
RequestSource |
Mengubah kolom dari DataFrame pelatihan atau permintaan inferensi. |
FeatureViewSource |
Menggabungkan nilai fitur hulu. Lihat FeatureViewSource. |
Fitur yang didukung CustomUDF Delta tidak dapat diwujudkan atau disajikan secara online. Untuk mengubah nilai fitur yang didukung tabel untuk pelatihan dan penyajian, definisikan fitur agregasi atau seleksi kolom yang didukung Delta dan referensikan melalui FeatureViewSource.
CustomUDF tidak didukung dengan StreamSource. Untuk mengubah output fitur streaming, referensikan fitur tersebut melalui FeatureViewSource.
CustomUDF dengan RequestSource membutuhkan databricks-feature-engineering versi 0.17.0 atau lebih baru.
Untuk menggunakan , CustomUDFAnda membutuhkan EXECUTE hak istimewa pada UDF, USE CATALOG hak istimewa pada katalog induknya, dan USE SCHEMA hak istimewa pada skema induknya.
Contoh berikut menggunakan NumPy untuk menghitung log(1 + amount), mengurangi skala jumlah transaksi besar. Jalankan di komputasi serverless dengan dependensi UDF kustom diaktifkan.
main.ecommerce Skema harus ada.
spark.sql("""
CREATE OR REPLACE FUNCTION main.ecommerce.log_amount_udf(amount DOUBLE)
RETURNS DOUBLE
LANGUAGE PYTHON
ENVIRONMENT (
  dependencies = '["numpy==1.26.4"]',
  environment_version = '6'
)
AS $$
import numpy as np

if amount is None or not np.isfinite(amount) or amount < 0:
    return None
return float(np.log1p(amount))
$$
""")
Daftarkan fitur yang mengikat kolom transaction_amount permintaan ke parameter amountUDF :
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import (
    CustomUDF, FieldDefinition, RequestSource, ScalarDataType,
)

fe = FeatureEngineeringClient()

log_transaction_amount = fe.create_feature(
    source=RequestSource(
        schema=[
            FieldDefinition(name="transaction_amount", data_type=ScalarDataType.DOUBLE),
        ]
    ),
    function=CustomUDF(
        function_name="main.ecommerce.log_amount_udf",
        input_bindings={"amount": "transaction_amount"},
    ),
    catalog_name="main",
    schema_name="ecommerce",
    name="log_transaction_amount",
)
UDF ENVIRONMENT mengonfigurasi ketergantungan untuk komputasi offline. Untuk penyajian online, juga deklarasikan paket tersebut dalam create_feature_spec(extra_pip_requirements=...) atau log_model(extra_pip_requirements=...). Mereka tidak disalin secara otomatis dari UDF.
Lihat Ketergantungan Fitur Penyajian dan ketergantungan model.
CustomUDF fitur tidak dapat diwujudkan. UDF yang didukung permintaan dan fitur dijalankan sesuai permintaan selama pelatihan dan layanan. Setiap UDF dalam rantai ketergantungan menambah komputasi, jadi jaga fungsi dan rantai tetap kecil. UDF harus menangani input yang hilang, yang bisa offline None maupun NaN online.
Untuk panduan menangani nilai yang hilang, lihat Cara menangani nilai fitur yang hilang.
ColumnSelection (lewat)
ColumnSelection Memilih satu kolom dari sumber tanpa menerapkan agregasi apapun. Ini dibungkus langsung dalam function parameter (bukan di dalam AggregationFunction). Tipe pengembalian, termasuk bersarang ARRAY, MAP, dan STRUCT tipe, disimpulkan dari skema sumber saat fitur dibuat. Mengubah tipe kolom sumber setelah membuat fitur tidak didukung.
| Function | Description | Contoh kasus penggunaan |
|---|---|---|
ColumnSelection("col") |
Nilai terbaru kolom (tanpa agregasi) | Kategori vendor terbaru, pass-through bidang permintaan |
ColumnSelection mendukung sumber data berikut:
-
DeltaTableSource: Mengembalikan nilai terbaru per kunci entitas melalui join titik waktu (tanpa agregasi jendela lookback). -
SdpSource: Mengembalikan nilai terbaru per kunci entitas dari tabel output pipeline, sama sepertiDeltaTableSource. -
StreamSource: Mengembalikan nilai terbaru per kunci entitas dari Stream (tanpa agregasi jendela lookback). -
RequestSource: Melewati nilai yang diberikan saat inferensi (atau diambil dari DataFrame yang diberi label saat pelatihan).
Untuk , DeltaTableSourceColumnSelection fitur mendukung filter_condition dan transformation_sql, diterapkan sebelum pemilihan nilai terbaru, sama seperti fitur agregasi.
from databricks.feature_engineering.entities import (
    ColumnSelection, DeltaTableSource, Feature, FieldDefinition,
    RequestSource, ScalarDataType,
)

delta_source = DeltaTableSource(
    catalog_name="main", schema_name="feature_store", table_name="transactions",
)

request_source = RequestSource(
    schema=[
        FieldDefinition(name="session_duration", data_type=ScalarDataType.DOUBLE),
    ]
)

# ColumnSelection from a Delta table
latest_amount = Feature(
    source=delta_source,
    function=ColumnSelection("amount"),
    entity=["user_id"],
    timeseries_column="transaction_time",
    name="latest_transaction_amount",
)

# ColumnSelection from a RequestSource
session_feature = Feature(
    source=request_source,
    function=ColumnSelection("session_duration"),
    name="session_duration",
)
Contoh: fitur agregasi dan pemilihan kolom
Contoh berikut menunjukkan fitur yang ditentukan melalui sumber data yang sama.
from databricks.feature_engineering.entities import (
    AggregationFunction, Feature, Sum, Avg, ApproxCountDistinct,
    ColumnSelection, RollingWindow,
)
from datetime import timedelta

window = RollingWindow(window_duration=timedelta(days=7))

sum_feature = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(Sum(input="amount"), window),
)

avg_feature = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(Avg(input="amount"), window),
)

distinct_count = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(ApproxCountDistinct(input="product_id", relativeSD=0.01), window),
)

# Column selection (no aggregation, no time window)
latest_amount = Feature(
    source=source,
    function=ColumnSelection("amount"),
    entity=["user_id"],
    timeseries_column="event_time",
    name="latest_amount",
)
Fitur dengan kondisi pemfilteran
Parameter ini filter_condition memungkinkan Anda memfilter baris dari tabel sumber sebelum menghitung agregasi atau memilih nilai kolom terbaru. Ini berfungsi sebagai klausa SQL WHERE yang diterapkan sebelum pengelompokan dan agregasi data.
Note
Untuk fitur agregasi, filter_condition memfilter baris sebelum agregasi, seperti klausa SQL WHERE yang diterapkan sebelum GROUP BY. Ini tidak mengubah granularitas, yang selalu didefinisikan oleh entity pada definisi fitur.
Filter berguna saat bekerja dengan tabel sumber besar yang menyertakan superset data yang diperlukan untuk komputasi fitur, dan meminimalkan kebutuhan untuk membuat tampilan terpisah di atas tabel ini.
from databricks.feature_engineering.entities import AggregationFunction, Sum, Count, RollingWindow, DeltaTableSource
from datetime import timedelta

# Source with filter applied at the source level
high_value_transactions = DeltaTableSource(
    catalog_name="main",
    schema_name="ecommerce",
    table_name="transactions",
    filter_condition="amount > 100",  # Only transactions over $100
)

high_value_sales = Feature(
    source=high_value_transactions,
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=30))),
)

# Multiple conditions
completed_orders_source = DeltaTableSource(
    catalog_name="main",
    schema_name="ecommerce",
    table_name="orders",
    filter_condition="status = 'completed' AND payment_method = 'credit_card'",
)

completed_orders = Feature(
    source=completed_orders_source,
    entity=["user_id"],
    timeseries_column="order_time",
    function=AggregationFunction(Count(input="order_id"), RollingWindow(window_duration=timedelta(days=7))),
)

# Filter on a StreamSource
from databricks.feature_engineering.entities import StreamSource

purchase_stream = StreamSource(
    full_name="main.ecommerce.transactions_stream",
    filter_condition="value.event_type = 'purchase'",
)

purchase_total = Feature(
    source=purchase_stream,
    entity=["value.user_id"],
    timeseries_column="value.event_time",
    function=AggregationFunction(Sum(input="value.amount"), RollingWindow(window_duration=timedelta(hours=1))),
)
Sumber data
DeltaTableSource
DeltaTableSourceadalah objek Python sementara yang digunakan untuk mendefinisikan bagaimana fitur dihitung dari tabel sumber. Ini tidak membuat tabel baru. Ini menentukan konfigurasi untuk membaca data dan menggabungkan fitur.
DeltaTableSource(
    catalog_name: str,                              # Required: Catalog name
    schema_name: str,                               # Required: Schema name
    table_name: str,                                # Required: Table name
    filter_condition: Optional[str] = None,         # Optional: SQL WHERE clause to filter source data
    transformation_sql: Optional[str] = None,       # Optional: SQL SELECT expression for column transformations
    dataframe_schema: Optional[str] = None,         # Required if transformation_sql is set: schema of the resulting DataFrame
    lateness: Optional[SourceLateness] = None,       # Optional: Expected source settling time
)
Parameter:
-
catalog_name,schema_name, :table_nameIdentifikasi tabel Delta sumber di Unity Catalog. -
filter_condition: Klausa SQLWHEREyang diterapkan sebelum agregasi atau pemilihan kolom. Contoh:"status = 'completed'". -
transformation_sql: Ekspresi SQLSELECTyang diterapkan pada tabel sumber. Gunakan ini untuk mengganti nama kolom, tipe cast, atau menghitung kolom turunan sebelum agregasi atau pemilihan kolom. Jika dihilangkan, semua kolom dipilih (*). Contoh:"user_id, CAST(amount AS DOUBLE) AS amount, event_time". -
dataframe_schema: Skema DataFrame hasil setelah transformasi, dalam format Spark StructType JSON (daridf.schema.json()). Diperlukan jikatransformation_sqldisediakan. Ini memberi tahu sistem nama kolom dan jenis yang dihasilkan dari transformasi Anda. -
lateness: ObjekSourceLatenessyang menjelaskan berapa lama sumber biasanya membutuhkan waktu untuk menjadi lengkap dalam waktu peristiwa. Jika dihilangkan, sumber langsung dianggap lengkap.
Saat dan filter_conditiontransformation_sql diatur, kueri yang dihasilkan adalah: SELECT {transformation_sql} FROM {table} WHERE {filter_condition}.
SourceLateness.settling_delay adalah cara yang direkomendasikan untuk mensimulasikan penundaan ETL yang konsisten selama pelatihan yang memengaruhi materialisasi online. Azure Databricks menggeser waktu evaluasi pelatihan yang memenuhi syarat mundur dengan durasi ini sehingga contoh pelatihan tidak menggunakan data yang sebenarnya masih dalam perjalanan online. Selama materialisasi, Azure Databricks menunggu selama periode yang sama sebelum mempublikasikan jendela yang sudah selesai dan melayani jendela terakhir yang selesai selama periode tersebut.
Misalnya, misalkan pekerjaan ETL harian selesai 8 jam setelah tengah malam di zona waktu lokal di mana tengah malam sesuai dengan 07:00 UTC. Gunakan penundaan penyelesaian selama 8 jam dan offset jendela selama 7 jam:
from datetime import timedelta
from databricks.feature_engineering.entities import (
    DeltaTableSource,
    SourceLateness,
    TumblingWindow,
)

source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    lateness=SourceLateness(settling_delay=timedelta(hours=8)),
)

window = TumblingWindow(
    window_duration=timedelta(days=1),
    offset=timedelta(hours=7),
)
Note
Harus timeseries_column bertipe TimestampType atau TimestampNTZType.
DateType tidak didukung untuk seri waktu; cast kolom ke TimestampType first (misalnya, dengan transformation_sql).
Contoh: Menggunakan transformation_sql untuk transformasi kolom
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="raw_events",
    transformation_sql="user_id, CAST(price_cents AS DOUBLE) / 100 AS price, event_time",
    filter_condition="event_type = 'purchase'",
    dataframe_schema=spark.sql(
        "SELECT user_id, CAST(price_cents AS DOUBLE) / 100 AS price, event_time FROM main.analytics.raw_events LIMIT 0"
    ).schema.json(),
)
Contoh: Menurunkan transformation_sql dan dataframe_schema dari DataFrame PySpark
Anda dapat menulis transformasi Anda sebagai kueri PySpark, lalu mengekstrak skema dari DataFrame yang dihasilkan:
df = spark.sql(f"""
  SELECT user_id, CAST(amount AS DOUBLE) / 100 AS amount_dollars, event_time
  FROM main.analytics.events
  WHERE event_date >= date_sub(current_date(), 7)
  LIMIT 0
""")

# Use df.schema.json() as the dataframe_schema
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    transformation_sql="user_id, CAST(amount AS DOUBLE) / 100 AS amount_dollars, event_time",
    filter_condition="event_date >= date_sub(current_date(), 7)",
    dataframe_schema=df.schema.json(),
)
Ekspresi yang didukung transformation_sql
Aturan yang sama berlaku untuk transformation_sql pada dan DeltaTableSourceStreamSource.
transformation_sql mendukung ekspresi baris demi baris apa pun; operasi yang dievaluasi secara independen untuk setiap baris. Mereka tidak mengubah jumlah baris atau korespondensi satu lawan satu dengan sumber. Ekspresi baris demi baris meliputi penggantian nama kolom, cast, operasi aritmatika, dan lainnya.
Operasi yang mengubah bentuk atau jumlah baris tidak didukung, seperti agregasi seperti SUM() atau COUNT(). Gunakan AggregationFunction pada definisi fitur sebagai gantinya.
DeltaTableSource.from_sql()
Sebagai kenyamanan, Anda dapat membuat DeltaTableSource dari kueri SQL. Metode menguraikan kueri untuk mengekstrak nama tabel secara otomatis, transformation_sql, dan filter_condition.
DeltaTableSource.from_sql(
    sql: str,                           # Required: SQL SELECT query
    spark: SparkSession,                # Required: active SparkSession (for schema inference)
) -> DeltaTableSource
Hanya kueri sederhana SELECT ... FROM ... [WHERE ...] yang didukung. SQL kompleks (NY, subkueri, CTA, UNION) ditolak. Untuk kueri kompleks, buat DeltaTableSource langsung dengan transformation_sql dan filter_condition.
from databricks.feature_engineering.entities import (
    AggregationFunction,
    DeltaTableSource,
    Feature,
    Sum,
    TumblingWindow,
)

source = DeltaTableSource.from_sql(
    spark=spark,
    sql=f"SELECT customer_id, event_ts, amount * 2 AS doubled_amount, amount FROM {CATALOG}.{SCHEMA}.{TABLE}",
)

feature = Feature(
    source=source,
    function=AggregationFunction(Sum(input="doubled_amount"), time_window=TumblingWindow(window_duration=timedelta(days=7))),
    entity=["customer_id"], timeseries_column="event_ts",
)
Iterasi dengan to_dataframe()
Gunakan source.to_dataframe() untuk mempratinjau data yang akan digunakan untuk komputasi fitur. Ini berguna untuk iterasi pada filter_condition dan transformation_sql sampai menghasilkan hasil yang diharapkan.
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    filter_condition="event_type = 'purchase'",
)

# Preview the filtered source data
source.to_dataframe().display()
Memahami entitas
Kolom entitas menentukan tingkat agregasi untuk fitur Anda. Mereka ditentukan pada Feature definisi, bukan pada DeltaTableSource. Entitas menentukan:
-
Cara pengelompokan data: Fitur digabungkan berdasarkan kombinasi unik nilai entitas (mirip dengan
GROUP BYSQL) - Struktur kunci utama: Setiap kombinasi entitas unik menghasilkan satu baris fitur yang dihitung
Contoh: Fitur tingkat pelanggan
Kode berikut menggabungkan fitur di tingkat pelanggan (satu baris per pelanggan):
from databricks.feature_engineering.entities import DeltaTableSource

source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="user_events",
)

Feature(
    source=source,
    entity=["user_id"],                # Features aggregated per user
    timeseries_column="event_time",    # Timestamp for time windows
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)
Contoh: Fitur tingkat Pelanggan
Untuk menggabungkan fitur pada tingkat yang lebih rinci (satu baris per kombinasi penyimpanan pelanggan), gunakan beberapa kolom entitas:
source = DeltaTableSource(
    catalog_name="main",
    schema_name="retail",
    table_name="transactions",
)

Feature(
    source=source,
    entity=["user_id", "store_id"],  # Features aggregated per user-store pair
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)
Saat Anda memerlukan fitur pada tingkat agregasi yang berbeda (misalnya, tingkat pelanggan dan tingkat penyimpanan pelanggan), gunakan nilai yang berbeda entity dalam definisi fitur Anda. Hal yang sama DeltaTableSource dapat dibagikan di seluruh fitur dengan konfigurasi entitas yang berbeda.
StreamSource
StreamSource merujuk pada Stream. Aliran berisi koneksi, autentikasi, skema, dan konfigurasi penyerapan untuk sumber streaming. Untuk Kafka, referensi kolom dalam definisi fitur harus diawali dengan value. atau key. untuk menunjukkan bagian mana dari pesan yang akan dibaca.
StreamSource(
    full_name: str,                       # Required: Three-part Stream name (catalog.schema.stream)
    filter_condition: Optional[str] = None,      # Optional: SQL WHERE clause applied before aggregation
    transformation_sql: Optional[str] = None,    # Optional: SQL SELECT expression for column transformations
    dataframe_schema: Optional[str] = None,      # Required if transformation_sql is set: schema of the resulting DataFrame
    lateness: Optional[SourceLateness] = None,    # Optional: Expected source settling time
)
Parameter:
-
full_name: Nama lengkap tiga bagian dari sebuah Stream (misalnya,"my_catalog.my_schema.my_stream"). -
filter_condition(opsional): Klausa SQLWHEREditerapkan pada data aliran sebelum agregasi, menggunakan referensi kolom dengan awalan titik (misalnya,"value.event_type = 'purchase'"). -
transformation_sql(opsional): Ekspresi SQLSELECTyang diterapkan sebelum agregasi atau pemilihan kolom, menggunakan referensi dot-prefix kekeyvaluedan structs. Mendukung ekspresi baris yang sama sepertiDeltaTableSource. Jika dihilangkan, sumber menggunakan semua kolom (*). -
dataframe_schema: Skema SparkStructTypeJSON dari output yang diproyeksikan. Diperlukan jika Anda mengaturtransformation_sql. -
lateness: ObjekSourceLatenessyang menjelaskan berapa lama biasanya waktu streaming untuk selesai dalam waktu event. LihatSourceLateness.settling_delay.
from databricks.feature_engineering.entities import StreamSource

stream_source = StreamSource(
    full_name="my_catalog.my_schema.my_stream",
    filter_condition="value.event_type = 'purchase'",
)
Turunkan dataframe_schema dengan menjalankan proyeksi terhadap tabel ingestion Stream, yang menampilkan key dan value struct.
transformation_sql = (
    "value.amount * value.conversion_rate AS converted_amount, "
    "struct(value.user_id AS user_id, value.event_time AS time) AS event"
)

ingestion_table = "my_catalog.my_schema.events_ingestion"
dataframe_schema = spark.sql(
    f"SELECT {transformation_sql} FROM {ingestion_table} LIMIT 0"
).schema.json()

stream_source = StreamSource(
    full_name="my_catalog.my_schema.my_stream",
    transformation_sql=transformation_sql,
    dataframe_schema=dataframe_schema,
)
SdpSource
SdpSource mendefinisikan fitur pada tabel output dari pipeline Lakeflow yang terpicu. Feature Store menjalankan pipeline sebelum setiap materialisasi dan pengisian ulang, lalu membaca tabel output dengan cara yang sama seperti membaca .DeltaTableSource Untuk alur kerja end-to-end, lihat Gunakan pipeline Lakeflow sebagai sumber fitur.
SdpSource(
    pipeline_id: str,                            # Required: ID of the pipeline that produces the output table
    output_table: str,                           # Required: Three-part name of the pipeline output table to read
    input_tables: Optional[List[str]] = None,    # Optional: Three-part names of the tables the pipeline reads from
    filter_condition: Optional[str] = None,      # Optional: SQL WHERE clause to filter the output table
    transformation_sql: Optional[str] = None,    # Optional: SQL SELECT expression for column transformations
    dataframe_schema: Optional[str] = None,      # Required if transformation_sql is set: schema of the resulting DataFrame
)
Parameter:
-
pipeline_id: ID dari pipeline yang sudah terpicu. Pipa belum harus berjalan. Anda perlu CAN RUN, CAN MANAGE, atau IS OWNER izin untuk itu. Pipa kontinu ditolak. -
output_table: Nama tiga bagian (catalog.schema.table) dari tabel output pipeline yang akan dibaca. Tabel tidak perlu ada sampai pipeline pertama kali berjalan. Ketika sudah ada, itu harus menjadi output dari pipeline, dan Anda harus menggunakannyaSELECT. -
input_tables: Nama tiga bagian dari tabel yang menjadi sumber bacaan pipeline. Diperlukan untuk materialisasi dengan ,TableTriggeryang memulai run saat tabel-tabel ini diperbarui.ColumnSelectionfitur muncul pada pemicu tabel, sehingga mereka membutuhkaninput_tables. Anda dapat mencantumkan hingga 25 tabel, tanpa duplikat, dan setiap tabel harus ada saat Anda membuat fitur tersebut. A hanya memantauTableTriggerlebih dari 10 tabel ketika event file diaktifkan di setiap tabel yang dipantau. -
filter_condition,transformation_sql,dataframe_schema: Diterapkan pada tabel output dengan cara yang sama seperti pada .DeltaTableSourcedataframe_schemadiperlukan jika Anda mengaturtransformation_sql.
SdpSource fitur dukungan ColumnSelection dan fungsi agregasi. Mereka tidak mendukung CustomUDF.
Setelah Anda membuat fitur, sumbernya melaporkan hanya-baca pipeline_state:
-
PENDING: Pipeline belum berjalan, jadi tabel output belum ada. -
RESOLVED: Tabel output sudah ada, dan kolom fitur divalidasi terhadapnya. -
ERROR: Validasi pipeline run atau tabel output gagal.
Contoh berikut mendefinisikan sebuah SdpSource:
from databricks.feature_engineering.entities import SdpSource

source = SdpSource(
    pipeline_id="1234abcd-5678-90ef-1234-567890abcdef",
    output_table="main.features.tutor_review_stats",
    input_tables=["main.raw.reviews", "main.raw.tutors"],
)
refresh_sdp_source()
refresh_sdp_source menjalankan pipeline di balik fitur yang diberikan. Ia memulai satu pembaruan untuk setiap pipeline, atau terhubung ke pembaruan yang sudah berjalan.
FeatureEngineeringClient.refresh_sdp_source(
    *,                                  # Arguments are keyword-only
    features: List[Feature],            # Features with an SdpSource
    wait: bool = True,                  # Wait for the updates to finish
) -> Dict[str, str]                     # Pipeline ID to update ID
Dengan , panggilan menunggu setiap pembaruan selesai, tanpa timeout, lalu menyelesaikan fitur-fiturpipeline_state.wait=True Fitur ini muncul ValueError jika pembaruan gagal atau dibatalkan, atau jika sebuah fitur tetap tidak terselesaikan. Dengan wait=False, panggilan kembali segera setelah pembaruan dimulai.
Untuk menjalankan pipeline fitur sebelum pelatihan, jalankan hal berikut:
fe.refresh_sdp_source(features=[fe.get_feature(full_name="main.features.tutor_avg_score_7d")], wait=True)
RequestSource
RequestSource mendefinisikan skema untuk data yang disediakan pada waktu inferensi dalam payload permintaan daripada dilihat dari tabel yang sudah dimaterialisasi. Selama pelatihan, kolom ini diekstrak dari DataFrame berlabel yang diteruskan ke create_training_set. Selama penyajian model, pemanggil harus menyertakannya dalam payload permintaan HTTP.
RequestSourcedapat digunakan dengan fungsi Tampilan Fitur CustomUDF atau ColumnSelection. Ini tidak mendukung fungsi agregasi atau jendela waktu.
Menentukan skema
Tentukan skema sebagai daftar FieldDefinition objek, masing-masing menentukan nama kolom dan ScalarDataType:
from databricks.feature_engineering.entities import (
    FieldDefinition, RequestSource, ScalarDataType,
)

request_source = RequestSource(
    schema=[
        FieldDefinition(name="transaction_amount", data_type=ScalarDataType.DOUBLE),
        FieldDefinition(name="vendor_id", data_type=ScalarDataType.STRING),
        FieldDefinition(name="transaction_id", data_type=ScalarDataType.STRING),
        FieldDefinition(name="transaction_time", data_type=ScalarDataType.DATE),
    ]
)
Untuk skema yang mencakup array, map, atau struct, pass (Spark StructType JSON dari df.schema.json()) alih-alih schema, atau infer skema dari DataFrame dengan RequestSource.from_dataframe:dataframe_schema
from databricks.feature_engineering.entities import RequestSource

request_source = RequestSource.from_dataframe(dataframe=labeled_df.select("cart_items", "device_info"))
Jenis data yang didukung
RequestSourcemendukung tipe skalar yang didefinisikan dalam ScalarDataType: , , FLOAT, DATEDOUBLESTRINGLONGSHORTBINARYBOOLEANTIMESTAMP. INTEGER Ia juga mendukung ARRAY, , dan STRUCT kolom yang dibangun dari tipe-tipe ini ketika Anda mendefinisikan skema dengan dataframe_schema atau from_dataframeMAP.
MAPKunci harus .STRING
Bagaimana data permintaan dihidrasi
| Konteks | Behavior |
|---|---|
Pelatihan (create_training_set) |
Kolom diekstrak dari DataFrame berlabel. Jenis divalidasi terhadap skema yang dideklarasikan. Ketidakcocokan menimbulkan kesalahan (tidak ada transmisi implisit). |
| Penyajian (titik akhir model) | Kolom ditarik dari dataframe_records atau dataframe_split dalam permintaan HTTP. Nilai JSON dilemparkan ke jenis yang dideklarasikan (misalnya, nomor JSON → DOUBLE). |
Tanda tangan model
Saat model dicatat menggunakan log_model dengan set pelatihan yang menyertakan RequestSource fitur, RequestSource kolom ditambahkan ke tanda tangan model MLflow sebagai input yang diperlukan. Ini berarti skema API titik akhir penyajian mencerminkan pemanggil bidang mana yang harus disediakan pada waktu inferensi.
FeatureViewSource
FeatureViewSourcemenggunakan output dari Feature View lain sebagai input ke .CustomUDF Fitur rantai menghasilkan graf asiklik terarah (DAG). Misalnya, fitur margin dapat menggabungkan agregat pendapatan dan biaya, dan fitur lain dapat mengubah margin tersebut.
Gunakan databricks-feature-engineering versi 0.18.0 atau lebih baru untuk FeatureViewSource.
Meneruskan daftar Feature objek ke features, bukan string nama fitur. Ambil fitur yang terdaftar dengan get_feature. Di , input_bindingsgunakan setiap fitur yang terdaftar.full_name Untuk fitur lokal yang tidak terdaftar, gunakan fitur tersebut name sebagai gantinya.
Contoh berikut mengasumsikan dua fitur terdaftar, revenue_sum_7d dan cost_sum_7d, yang mengembalikan DOUBLE nilai dengan customer_id dan digunakan event_time untuk perhitungan titik-waktu:
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import CustomUDF, FeatureViewSource

fe = FeatureEngineeringClient()
revenue = fe.get_feature(full_name="main.ecommerce.revenue_sum_7d")
cost = fe.get_feature(full_name="main.ecommerce.cost_sum_7d")

spark.sql("""
CREATE OR REPLACE FUNCTION main.ecommerce.margin_udf(revenue DOUBLE, cost DOUBLE)
RETURNS DOUBLE
LANGUAGE PYTHON
AS $$
import math

if revenue is None or cost is None:
    return None
if not math.isfinite(revenue) or not math.isfinite(cost) or revenue <= 0:
    return None
return (revenue - cost) / revenue
$$
""")

margin = fe.create_feature(
    source=FeatureViewSource(features=[revenue, cost]),
    function=CustomUDF(
        function_name="main.ecommerce.margin_udf",
        input_bindings={"revenue": revenue.full_name, "cost": cost.full_name},
    ),
    catalog_name="main",
    schema_name="ecommerce",
    name="margin",
)
Pembatasan berikut berlaku:
- Hanya
CustomUDFdidukung sebagai fungsi. Fitur hulu dapat berupa agregasi, pemilihan kolom, atau fitur lainnyaCustomUDF. - Hilangkan
entitydantimeseries_columnpada fitur turunan. Setiap fitur hulu mempertahankan entitas, timestamp, dan definisi jendela sendiri. - Sebuah fitur hanya memiliki satu sumber. Untuk menggabungkan nilai permintaan dengan fitur yang didukung tabel, definisikan sebuah
RequestSourcefitur dan referensikan keduanya melaluiFeatureViewSource. - Setiap fitur hulu yang dideklarasikan harus digunakan dalam
input_bindings. Siklus tidak diperbolehkan. - Daftarkan fitur hulu sebelum mendaftarkan fitur turunan. Grafik lokal yang tidak terdaftar dapat digunakan untuk
create_training_seteksperimen. - Untuk pelatihan atau servis, Anda membutuhkan
READ FEATUREhak istimewa orMANAGEpada fitur turunan dan fitur transitif huluannya. Gunakan nama fitur yang berbeda di seluruh grafik untuk registrasi dan penyajian, bahkan di seluruh katalog atau skema. - Sebuah fitur dapat merujuk hingga 20 fitur hulu langsung. Grafik terdaftar mendukung kedalaman maksimum lima fitur sepanjang jalur ketergantungan, termasuk fitur dasar.
- Kueri pelatihan tunduk pada batas lima panggilan UDF Unity Catalog per kueri, dihitung di seluruh graf ketergantungan. Untuk melebihinya, gunakan komputasi klasik yang menjalankan Databricks Runtime 18.1 atau lebih tinggi. Pada komputasi serverless dan pada gudang SQL pro dan serverless, diatur
environment_versionhingga atau6lebih tinggi dalam setiap definisi UDF. -
FeatureViewSourcefitur tidak dapat dimaterialisasi atau dievaluasi dengancompute_features. Gunakancreate_training_setuntuk mengevaluasi mereka secara offline. Untuk penyajian online, materialisasikan fitur upstream yang didukung oleh tabel sebagai gantinya.
Untuk evaluasi ketergantungan dan pemilihan output, lihat Latih dengan fitur FeatureViewSource. Untuk penerapan, lihat Serve derived features.
API pelatihan dan inferensi
create_training_set dan score_batch menghitung nilai fitur yang benar sesuai permintaan dari data sumber. Untuk fitur yang mendukung materialisasi offline, seperti agregasi jendela geser pada sumber tabel delta, mewujudkan fitur terlebih dahulu ke penyimpanan offline meningkatkan performa kedua operasi. Saat fitur offline terwujud tersedia, operasi membaca data offline yang telah dikomputasi sebelumnya alih-alih mengolah ulang nilai fitur dari sumber. Lihat Mewujudkan Tampilan Fitur untuk mewujudkan fitur ke penyimpanan offline.
create_training_set()
Membuat himpunan data pelatihan dengan komputasi fitur yang benar tepat waktu. Untuk detailnya, lihat Melatih model dengan Tampilan Fitur.
FeatureEngineeringClient.create_training_set(
    df: DataFrame,                                # DataFrame with training data
    features: Optional[List[Feature]],            # List of Feature objects
    label: Union[str, List[str], None],           # Label column name(s)
    exclude_columns: Optional[List[str]] = None,  # Optional: columns to exclude
) -> TrainingSet
log_model()
Mencatat model dengan metadata fitur untuk pelacakan silsilah data dan pencarian fitur otomatis selama inferensi. Untuk detailnya, lihat Melatih model dengan Tampilan Fitur.
FeatureEngineeringClient.log_model(
    model,                                    # Trained model object
    artifact_path: str,                       # Path to store model artifact
    flavor: ModuleType,                       # MLflow flavor module (e.g., mlflow.sklearn)
    training_set: TrainingSet,                # TrainingSet used for training
    registered_model_name: Optional[str],     # Optional: register model in Unity Catalog
)
score_batch()
Melakukan inferensi batch offline dengan pencarian fitur otomatis. Menggunakan metadata fitur yang disimpan dengan model untuk menghitung fitur yang benar tepat waktu, memastikan konsistensi dengan pelatihan.
FeatureEngineeringClient.score_batch(
    model_uri: str,                           # URI of logged model (e.g., "models:/catalog.schema.model/1")
    df: DataFrame,                            # DataFrame with entity keys and timestamps
) -> DataFrame
DataFrame input harus berisi kolom entitas dan timeseries yang digunakan selama pelatihan. Fitur secara otomatis dihitung dari data sumber.
fe = FeatureEngineeringClient()

# Batch scoring with automatic feature lookup
predictions = fe.score_batch(
    model_uri="models:/main.ecommerce.fraud_model/1",
    df=inference_df,
)
predictions.display()
Jendela waktu
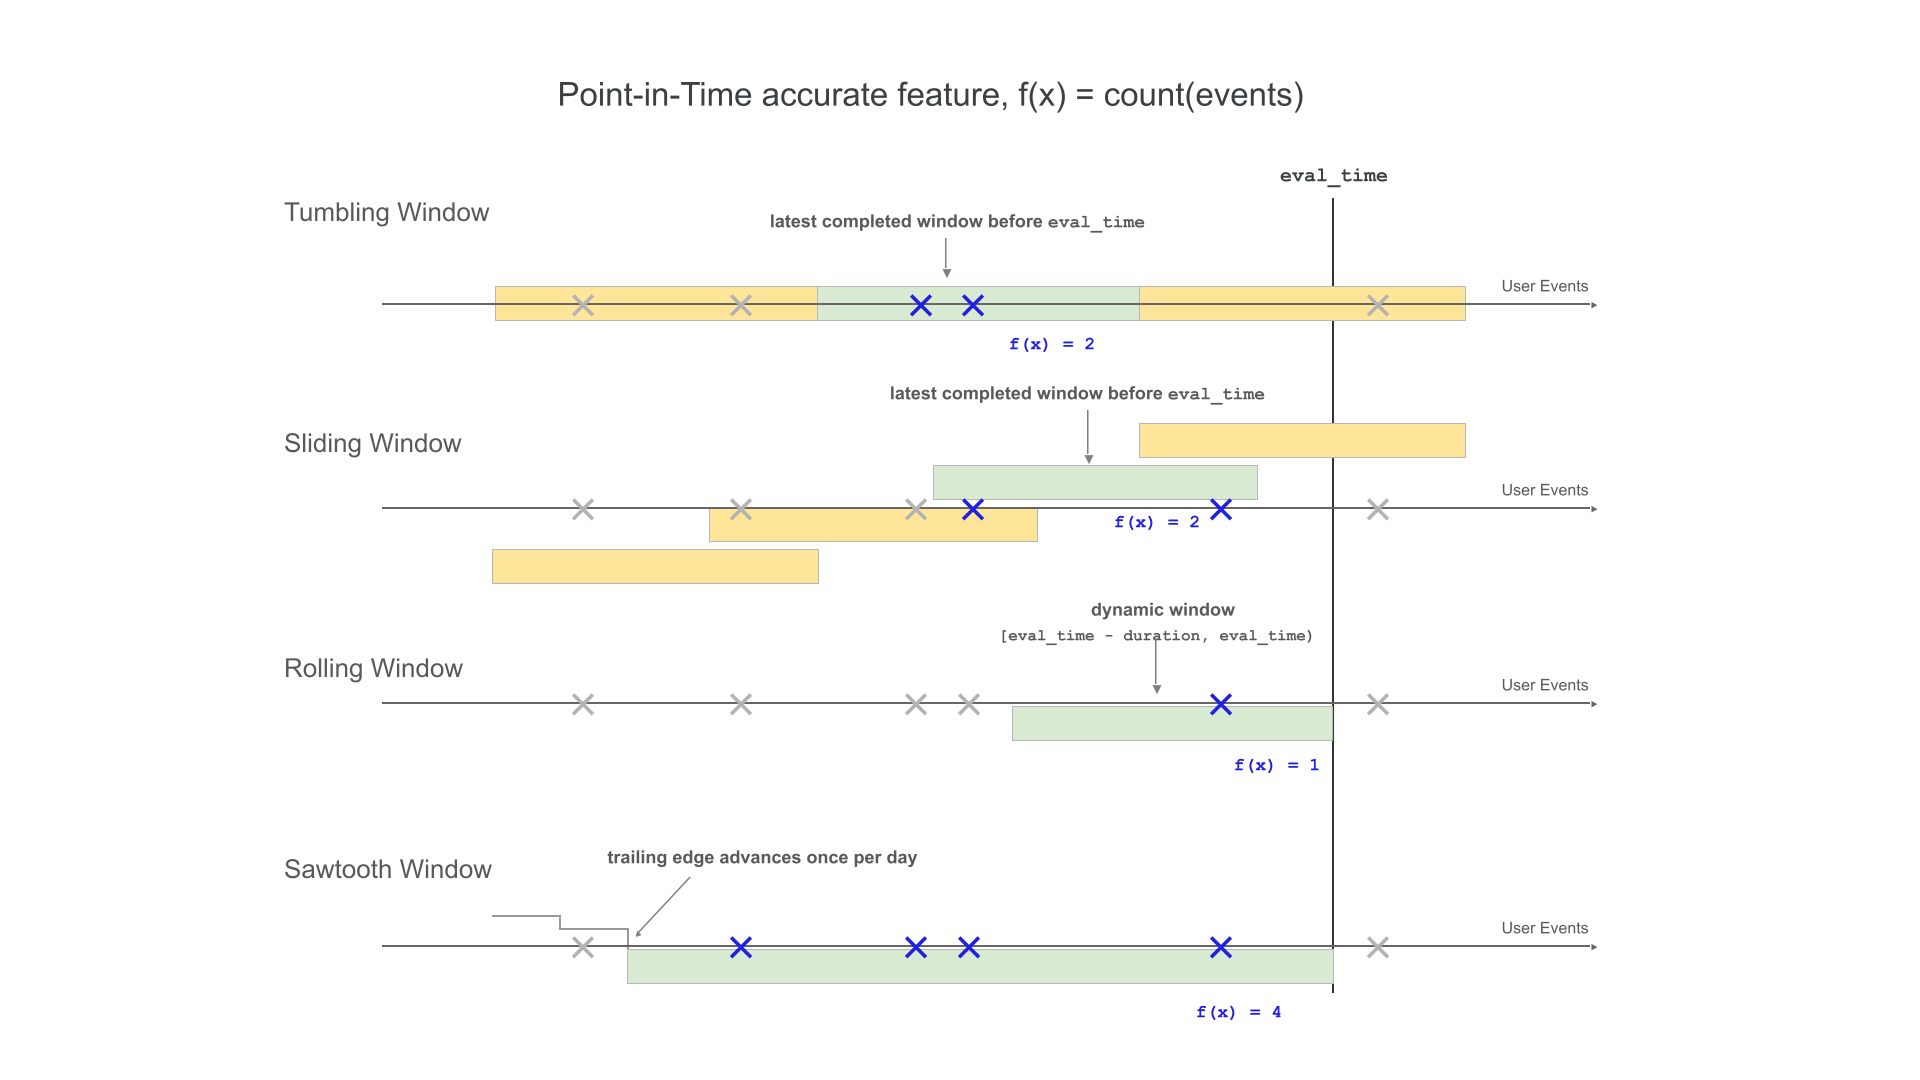
Tampilan Fitur mendukung empat tipe jendela untuk mengontrol perilaku lookback pada agregasi berbasis jendela waktu. Jenis jendela yang tersedia tergantung pada sumber fitur: fitur sumber streaming dapat menggunakan jendela rolling dan sawtooth, dan fitur sumber batch dapat menggunakan jendela rolling, tumbling, dan slide.
- Jendela bergulir melihat ke belakang dari waktu peristiwa. Durasi dan penundaan didefinisikan secara eksplisit.
- Jendela bergulir tetap adalah jendela waktu yang tetap dan tidak tumpang tindih. Setiap titik data milik tepat satu jendela.
- Jendela geser tumpang tindih, jendela waktu bergulir dengan interval slide yang dapat dikonfigurasi.
- Jendela sawtooth menjaga jendela pandang mundur panjang tetap segar di atas sumber streaming menggunakan jalur hybrid batch dan streaming. Lihat jendela Sawtooth.
Ilustrasi berikut menunjukkan jenis jendela berguling, meluncur, bergulir, dan bergigi gergaji.
Penentuan waktu jendela waktu
Gunakan delay untuk mengevaluasi jendela pada titik waktu analitik yang lebih awal. Misalnya, jendela 30 hari dengan penundaan 7 hari menghitung nilai 30 hari sejak satu minggu sebelum waktu evaluasi.
delay tidak bergantung pada waktu kedatangan sumber. Untuk memodelkan waktu yang dibutuhkan data sumber untuk tiba, SourceLateness.settling_delay konfigurasikan saja.
Ketika kedua pengaturan tersedia, mereka akan terbentuk. Azure Databricks memperlakukan jendela tersebut sebagai selesai setelah penundaan penyelesaian sumber dan mengevaluasinya menggunakan penundaan analitik.
Gunakan offset untuk mengubah penyelarasan batas jendela tetap. Secara default, jendela tumbling dan jendela geser disejajarkan ke UTC tengah malam. Misalnya, offset 22 jam menyelaraskan batas harian dengan 22:00 UTC. Untuk mendekati batas di zona waktu lokal, konfigurasikan offset statis relatif terhadap UTC. Offset tidak menyesuaikan dengan waktu hemat daylight, menggeser waktu evaluasi, atau memodelkan data yang terlambat datang.
Tabel berikut merangkum dukungan untuk bidang-bidang ini:
| Ladang | Jendela yang didukung | Batasan |
|---|---|---|
delay |
Berguling, berguling, dan meluncur | Harus berupa non-negatif datetime.timedelta |
offset |
Berguling dan meluncur | Harus tidak negatif dan lebih pendek dari periode* |
SourceLateness.settling_delay |
Fitur rolling, tumbling, dan sliding | Harus berupa non-negatif datetime.timedelta |
start_time |
Berguling, berguling, meluncur, dan bergigi gergaji | Harus berupa datetime.datetime. Untuk gigi gergaji, tidak boleh lebih lambat dari waktu pembuatan fitur. |
*Titik: Untuk jendela tumbling, offset harus lebih pendek dari window_duration. Untuk jendela geser, harus lebih pendek dari slide_duration.
Waktu mulai
Gunakan start_time untuk mengatur batas waktu peristiwa paling awal di UTC di mana sebuah fitur dapat mengeluarkan output. Batas tersebut bersifat inklusif.
start_time Output gerbang. Fitur ini tidak membatasi baris sumber historis yang dapat dibaca oleh jendela, dan tidak mengubah penyelarasan jendela. Jika start_time berada di antara dua batas yang sejajar, output jendela tetap pertama yang memenuhi syarat adalah batas berikutnya.
Dengan start_time, jendela berdurasi tetap dapat dipancarkan sebelum durasi jendela penuh berakhir di sumber. Output awal ini menggunakan riwayat sumber yang tersedia. Misalnya, pertimbangkan jendela geser dengan satu tahun window_duration dan satu hari slide_duration, di atas sumber yang datanya dimulai pada 1 Januari 2024:
- Tanpa
start_time, fitur ini pertama kali dirilis pada 1 Januari 2025, setelah jendela waktu satu tahun penuh dapat dibentuk. - Dijadwalkan
start_timepada 21 Agustus 2024, film ini pertama kali tayang pada 21 Agustus 2024. Output tersebut hanya mencakup riwayat sumber yang tersedia sejauh ini, mulai 1 Januari 2024. Jendela ini mencapai rentang satu tahun penuh pada 1 Januari 2025, dan mulai saat itu menghasilkan output lengkap.
Karena start_time tidak mengubah penyelarasan jendela, nilai antara dua batas yang disejajarkan tidak membuat batas baru. Untuk jendela tumbling dengan batas harian pada tengah malam UTC, a start_time dari 06:00 UTC pertama kali dipancarkan pada batas tengah malam berikutnya. A start_time yang tepat mendarat pada batas tersebut memancarkan pada batas tersebut, karena batas tersebut inklusif.
Jika start_time tidak diatur, jendela tumbling dan jendela geser berdurasi tetap pertama kali memancarkan pada batas yang sejajar setelah jendela penuh dapat dibentuk. Jendela geser seumur hidup dan jendela gulung akan dipancarkan segera setelah data sumber yang memenuhi syarat tersedia.
Note
start_time didukung untuk jendela sawtooth, serta untuk jendela rolling, tumbling, dan sliding pada fitur batch yang menggunakan DeltaTableSource. Fitur ini tidak didukung untuk RollingWindow dengan StreamSource. Lihat jendela Sawtooth.
Contohnya:
from datetime import datetime, timedelta
from databricks.feature_engineering.entities import SlidingWindow

window = SlidingWindow(
    window_duration=timedelta(days=365),
    slide_duration=timedelta(days=1),
    start_time=datetime(2024, 8, 21),
)
Jendela gulung
Note
RollingWindow sebelumnya bernama ContinuousWindow. Jika Anda bermigrasi dari versi SDK sebelumnya, perbarui impor Yang sesuai.
Jendela bergulir up-to-date dan agregat real-time, biasanya digunakan melalui data streaming. Dalam alur streaming, jendela bergulir memancarkan baris baru hanya ketika konten jendela panjang tetap berubah, seperti saat peristiwa masuk atau pergi. Saat fitur jendela bergulir digunakan dalam alur pelatihan, perhitungan fitur titik waktu yang akurat dilakukan pada data sumber menggunakan durasi jendela panjang tetap segera sebelum tanda waktu peristiwa tertentu. Ini membantu mencegah ketidaksesuaian online-offline atau kebocoran data. Fitur pada saat T agregat peristiwa dari [T − durasi, T).
class RollingWindow(TimeWindow):
    window_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    start_time: Optional[datetime.datetime] = None
Tabel berikut mencantumkan parameter untuk jendela bergulir. Waktu mulai dan berakhir jendela didasarkan pada parameter ini sebagai berikut:
- Waktu mulai:
evaluation_time - window_duration - delay(inklusif) - Waktu akhir:
evaluation_time - delay(eksklusif)
| Parameter | Constraints |
|---|---|
delay (opsional) |
Pasti ≥ 0. Menggeser jendela analitik mundur dari timestamp evaluasi. Gunakan SourceLateness.settling_delay untuk memodelkan baseline yang konsisten untuk penundaan kedatangan sumber di stream Anda. |
window_duration |
Harus > menjadi 0 |
start_time (opsional) |
Batas waktu peristiwa paling awal di mana fitur dapat mengeluarkan output. |
from databricks.feature_engineering.entities import RollingWindow
from datetime import timedelta

# Look back 7 days from evaluation time
window = RollingWindow(window_duration=timedelta(days=7))
Tentukan jendela bergulir dengan penundaan menggunakan kode di bawah ini.
# Compute a 7-day value as of one day before the evaluation time
window = RollingWindow(
    window_duration=timedelta(days=7),
    delay=timedelta(days=1)
)
Contoh jendela bergulir
window_duration=timedelta(days=7): Ini membuat jendela tinjauan mundur selama 7 hari yang berakhir pada waktu evaluasi saat ini. Untuk acara pada pukul 14.00 pada hari ke-7, ini termasuk semua acara dari pukul 14:00 pada hari 0 hingga (tetapi tidak termasuk) 14:00 pada hari ke-7.window_duration=timedelta(hours=1), delay=timedelta(minutes=30): Ini membuat jendela lookback selama 1 jam yang berakhir 30 menit sebelum waktu evaluasi. Untuk acara pada pukul 15.00, ini mencakup semua peristiwa dari pukul 13.30 hingga (tetapi tidak termasuk) 14.30.
Gunakan Last untuk membatasi kesegaran nilai terbaru
Gabungkan Last dengan RollingWindow saat nilai terbaru hanya berlaku untuk waktu terbatas. Pada waktu evaluasi, fitur mengembalikan nilai dari baris dengan timestamp terbaru dalam interval ini:
[evaluation_time - delay - window_duration, evaluation_time - delay)
Jika baris terbaru dalam interval mengandung nilai null, fitur mengembalikan null. Jika Anda ingin mengecualikan nilai input null, atur a filter_condition pada sumber.
Kombinasi ini berbeda dari ColumnSelection.
ColumnSelection mengembalikan nilai non-null terakhir yang diamati tanpa kedaluwarsaannya berdasarkan usia.
Untuk fitur batch, kombinasi ini memiliki mode materialisasi khusus yang hanya online. Hanya mendukung DeltaTableSource, Last, , RollingWindowdan TableTrigger. Lihat Materialize nilai terbaru yang dibatasi kesegaran.
Jendela bergulir
Untuk fitur yang ditentukan menggunakan jendela tumbling, agregasi dihitung melalui jendela berdurasi tetap yang telah ditentukan sebelumnya dan bergeser dengan interval geser, menghasilkan jendela yang tidak tumpang tindih yang sepenuhnya membagi waktu. Akibatnya, setiap peristiwa di sumber berkontribusi pada tepat satu jendela waktu. Fitur pada waktunya t mengagregasi data dari jendela yang berakhiran atau sebelum t (eksklusif). Windows dimulai pada epoch Unix.
class TumblingWindow(TimeWindow):
    window_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    offset: Optional[datetime.timedelta] = None
    start_time: Optional[datetime.datetime] = None
Tabel berikut mencantumkan parameter untuk jendela bergulir.
| Parameter | Constraints |
|---|---|
window_duration |
Harus > menjadi 0 |
delay (opsional) |
Pasti ≥ 0. Menggeser jendela analitik mundur dari timestamp evaluasi. |
offset (opsional) |
Harus ≥ 0 dan lebih pendek dari window_duration. Menggeser batas jendela dari tengah malam UTC. |
start_time (opsional) |
Batas waktu peristiwa paling awal di mana fitur dapat mengeluarkan output. |
from databricks.feature_engineering.entities import TumblingWindow
from datetime import timedelta

window = TumblingWindow(
    window_duration=timedelta(days=1),
    delay=timedelta(hours=2),
    offset=timedelta(hours=22),
)
Contoh jendela bergulir
-
window_duration=timedelta(days=5): Ini menciptakan jendela waktu tetap yang telah ditentukan masing-masing 5 hari. Contoh: Jendela #1 mencakup Hari 0 hingga Hari 4, Jendela #2 mencakup Hari 5 hingga Hari 9, Jendela #3 mencakup Hari 10 hingga Hari 14, dan sebagainya. Secara khusus, Jendela #1 mencakup semua acara dengan tanda waktu yang dimulai pada00:00:00.00hari ke-0 hingga (tetapi tidak termasuk) acara apa pun dengan tanda00:00:00.00waktu pada Hari Ke-5. Setiap peristiwa milik tepat satu jendela.
jendela geser
Untuk fitur yang didefinisikan menggunakan jendela geser, agregasi dihitung di atas jendela yang maju dengan interval slide. Jendela geser dapat memiliki durasi tetap atau durasi seumur hidup. Jendela dengan durasi tetap saling tumpang tindih, sehingga setiap event sumber dapat berkontribusi pada agregasi fitur untuk beberapa jendela. Jendela seumur hidup mencakup semua peristiwa sumber sebelum jendela berakhir. Fitur pada waktunya t mengagregasi data dari jendela yang berakhiran atau sebelum t (eksklusif). Windows selaras dengan era Unix.
class SlidingWindow(TimeWindow):
    window_duration: Optional[datetime.timedelta]
    slide_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    offset: Optional[datetime.timedelta] = None
    start_time: Optional[datetime.datetime] = None
Tabel berikut mencantumkan parameter untuk jendela geser.
| Parameter | Constraints |
|---|---|
window_duration |
Harus positif untuk jendela durasi tetap. Atur ke None jendela seumur hidup. |
slide_duration |
Harus positif. Untuk jendela berdurasi tetap, jendela tersebut juga harus lebih pendek dari window_duration. |
delay (opsional) |
Pasti ≥ 0. Menggeser jendela analitik mundur dari timestamp evaluasi. |
offset (opsional) |
Harus ≥ 0 dan lebih pendek dari slide_duration. Menggeser batas jendela dari tengah malam UTC. |
start_time (opsional) |
Batas waktu peristiwa paling awal di mana fitur dapat mengeluarkan output. |
from databricks.feature_engineering.entities import SlidingWindow
from datetime import timedelta

window = SlidingWindow(
    window_duration=timedelta(days=7),
    slide_duration=timedelta(days=1),
    delay=timedelta(hours=2),
    offset=timedelta(hours=22),
)
Contoh jendela geser
-
window_duration=timedelta(days=5), slide_duration=timedelta(days=1): Ini menciptakan jendela 5 hari yang tumpang tindih dan maju 1 hari setiap kali. Contoh: Jendela #1 mencakup Hari 0 hingga Hari 4, Jendela #2 mencakup Hari 1 hingga Hari 5, Jendela #3 mencakup Hari 2 hingga Hari 6, dan sebagainya. Setiap jendela mencakup peristiwa dari00:00:00.00pada hari mulai hingga (tetapi tidak termasuk)00:00:00.00pada hari akhir. Karena jendela tumpang tindih, satu peristiwa dapat termasuk dalam beberapa jendela (dalam contoh ini, setiap peristiwa memiliki hingga 5 jendela yang berbeda).
Jendela seumur hidup
Atur window_duration=None untuk membuat jendela seumur hidup. Pada setiap batas slide, fitur ini menggabungkan semua event sumber untuk entitas dengan timestamp yang lebih awal dari batas tersebut. Misalnya, slide satu hari menghasilkan nilai kumulatif sekali sehari.
Jendela seumur hidup hanya didukung oleh SlidingWindow.
RollingWindow dan TumblingWindow membutuhkan hingga window_duration.
Note
Jendela seumur hidup memerlukan databricks-feature-engineering versi klien yang mendukung window_duration=None dan pengaktifan ruang kerja. Versi klien sebelumnya tidak mendukung sintaks ini.
from datetime import timedelta
from databricks.feature_engineering.entities import (
    AggregationFunction,
    DeltaTableSource,
    Feature,
    SlidingWindow,
    Sum,
)

lifetime_spend = Feature(
    source=DeltaTableSource(
        catalog_name="main",
        schema_name="store",
        table_name="transactions",
    ),
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(
        Sum(input="amount"),
        SlidingWindow(
            window_duration=None,
            slide_duration=timedelta(days=1),
        ),
    ),
    name="lifetime_spend",
)
Jendela bergigi gergaji
Jendela sawtooth adalah agregasi yang mendukung pembaruan yang sangat segar untuk peristiwa terbaru bersama dengan pemadatan harian data historis. Tepi belakang (yang lebih tua) maju dalam langkah tetap setiap hari, sementara tepi depan (baru) tetap mengikuti perkembangan terbaru, sehingga panjang jendela efektif "bergergaji" sepanjang hari. Sebagian besar jendela disajikan dari data dalam tabel ingestion Stream, dan hanya dua hari terakhir yang berasal dari live stream. Ini adalah kompromi yang secara efisien menghitung jendela durasi panjang (diskalakan hingga tahun) sambil tetap responsif terhadap pembaruan segar.
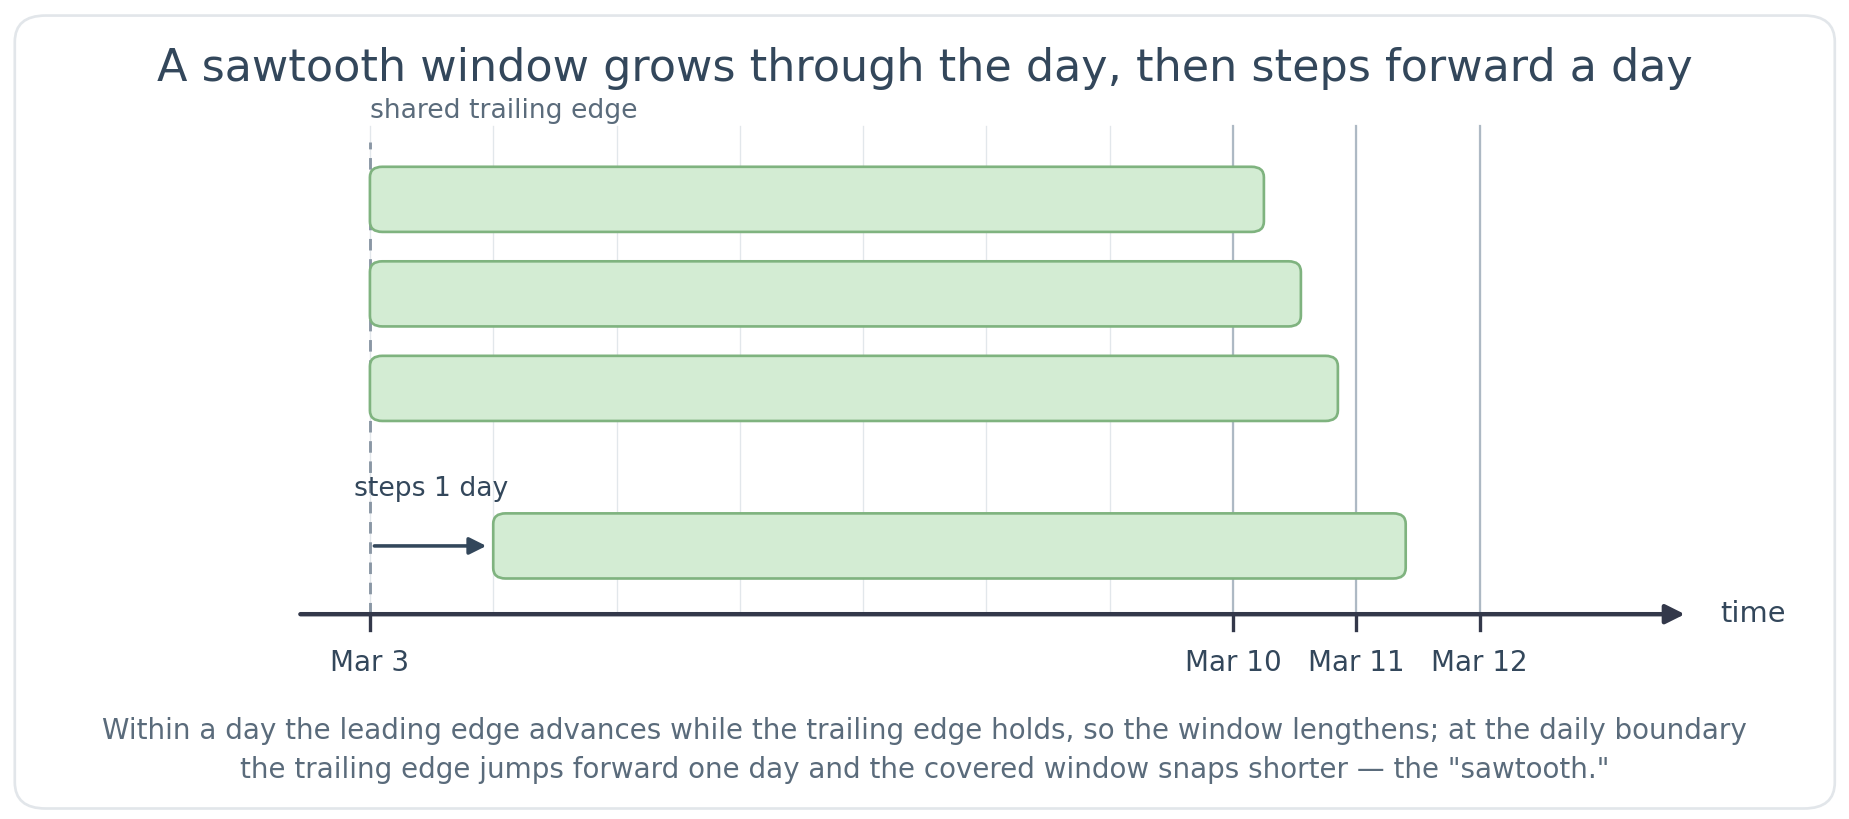
Jendela sawtooth dimaterialisasi dalam jalur hybrid batch dan streaming. Pipeline batch mempertahankan sebagian besar jendela, sementara pipeline streaming menjaga data terbaru tetap segar secara real time. Keduanya digabungkan saat dibaca, sehingga bagi model atau konsumen yang melayani ini adalah satu fitur.
Karena bagian historis dari jendela dihitung oleh pipeline batch, fitur sawtooth siap digunakan segera setelah materialisasi dimulai, bahkan ketika jendela tersebut membentang berbulan-bulan atau bertahun-tahun. Jendela gulung hanya selesai setelah durasi jendela penuhnya berakhir. Batas minimum window_duration harus lebih dari dua hari (batas bawah yang ditegakkan). Databricks merekomendasikan jendela sawtooth untuk durasi lebih dari 7 hari. Untuk jendela yang lebih dari dua hari hingga tujuh hari, pilihlah antara presisi panjang tetap dari jendela gulung dan kesiapan produksi yang lebih cepat dari jendela gigi gergaji.
Note
Fitur sawtooth bergantung pada sejarah yang sudah ada. Tabel ingestion Stream harus berisi data yang mencakup setidaknya durasi jendela penuh, atau jendela yang dihitung tidak lengkap. Jika tidak, atur start_time ke waktu paling awal yang Anda inginkan fitur untuk menyajikan nilai, paling lambat saat Anda membuat fitur tersebut. Nilai mulai dari start_time sebelumnya mencakup riwayat yang tersedia pada titik tersebut. Sebelum 2 hari penuh berlalu, fitur ini hanya mencerminkan data yang telah terwujud sejauh ini. Jangan sajikan film ini dalam produksi sampai 2 hari penuh berlalu. Agregasi di atas jendela kosong mengembalikan 0 untuk Sum dan , dan null untuk Avg, Min, Max, First, VarPopStddevPopLastVarSamp, , dan .StddevSampCount
Untuk mengetahui apakah fitur sawtooth sudah siap, buka Tampilan Fitur di Catalog Explorer. Di bagian Fitur Materialized, batch backfill selesai setelah waktu materialisasi terakhir fitur maju dan statusnya menunjukkan keberhasilan. Bagian streaming dimaterialisasi oleh pipeline deklaratif Lakeflow. Setelah Tampilan Fitur lolos validasi, fitur materialisasi terhubung ke pipeline tersebut, di mana Anda dapat memantau status jalannya.
Jendela gigi gergaji membutuhkan dan StreamSource dimaterialisasi dengan StreamingMode.
class SawtoothWindow(TimeWindow):
    window_duration: datetime.timedelta
    start_time: Optional[datetime.datetime] = None
Tepi jendela bergigi gergaji bergerak berbeda dari jendela gulung: tepi depan mengikuti kejadian terbaru, sementara tepi belakang bergerak sekali sehari, bukan terus-menerus. Setiap hari pada batas tetap 18:00 UTC, tepi belakang melangkah maju ke batas UTC-tengah malam hari itu. Akibatnya, jendela efektif sedikit lebih panjang dan window_duration terus bertambah sepanjang hari sebelum kembali normal pada batas berikutnya. Pelatihan dan penyajian menggunakan batas waktu 18:00 UTC yang sama, sehingga pelatihan offline dan penyajian online tetap konsisten.
| Parameter | Constraints |
|---|---|
window_duration |
Harus lebih dari dua hari. Durasi yang bukan jumlah hari bulat (misalnya, timedelta(days=3, minutes=15)) diperbolehkan, tetapi jendela tersebut tetap diperbarui pada tingkat granularitas harian. |
start_time (opsional) |
Tidak boleh lebih lambat dari waktu pembuatan fitur. |
Atur start_time kapan tabel ingestion Stream menyimpan riwayat lebih sedikit dari window_duration. Tanpanya, pipeline batch menunggu sampai jendela sejarah penuh tersedia. Atur ke waktu paling awal yang Anda inginkan fitur tersebut melayani nilai. Nilai tidak bergantung pada data yang sudah ada di jendela. Fitur ini melayani nilai jendela parsial mulai dan start_time mencapai durasi jendela penuh setelah cukup banyak riwayat terkumpul.
Anda tidak bisa mengatur jendela start_time sawtooth lebih lambat dari saat Anda membuat fitur tersebut.
start_time hanya memutar bagian batch dari jendela, sehingga nilai yang lebih baru akan memungkinkan bagian streaming menampilkan nilai sebelum start_time.
Jendela sawtooth mendukung Sumfungsi , Avg, Count, Min, FirstMaxLastFirstNVarPopStddevPopLastDistinctFirstDistinctVarSampLastNdanStddevSamp fungsi agregasi.
Contoh jendela gigi gergaji
Contoh berikut menunjukkan hitungan transaksi pengguna selama 7 hari. Tepi depan mengikuti peristiwa saat ini sementara tepi belakang melangkah maju satu hari demi satu hari. Untuk acara pada 10 Maret, jendela waktu dimulai sekitar 3 Maret. Seiring berjalannya 10 Maret, tepi depan terus maju sementara tepi belakang bertahan, sehingga bentang tertutup semakin besar. Kemudian, pada awal 11 Maret, tepi belakang naik sekitar 4 Maret. Jendela efektif selalu sedikit lebih lama dari tujuh hari. Dua hari terakhir disajikan dari siaran langsung, dan hari-hari sebelumnya disajikan dari tabel konsumsi Stream.
from databricks.feature_engineering.entities import SawtoothWindow
from datetime import timedelta

# 7-day window kept continuously fresh with streaming data
window = SawtoothWindow(window_duration=timedelta(days=7))
Contoh berikut adalah jumlah 365 hari atas tabel ingestion yang datanya dimulai pada 1 Januari 2026. Dengan start_time pengaturan hingga 1 Januari 2026, fitur ini melayani nilai jendela parsial mulai hari tersebut dan mencakup satu tahun penuh mulai 1 Januari 2027:
from datetime import datetime, timedelta
from databricks.feature_engineering.entities import SawtoothWindow

window = SawtoothWindow(
    window_duration=timedelta(days=365),
    start_time=datetime(2026, 1, 1),
)
Keterbatasan jendela gigi gergaji
- Parameter
delaytidak didukung. -
SourceLateness.settling_delaytidak didukung. - Anda tidak bisa mengatur waktu
start_timeyang lebih lambat dari saat Anda membuat fitur. - Fungsi agregasi selain
Sum,Avg,Count,Min,FirstLastFirstNMaxLastNVarSampStddevPopVarPopFirstDistinctLastDistinctdanStddevSamptidak didukung (misalnya,ApproxCountDistinctdan ).ApproxPercentile - Jendela bergigi gergaji memerlukan .
StreamSourceADeltaTableSourcetidak didukung.
Pemicu materialisasi
Memicu kontrol saat alur materialisasi berjalan. Jenis pemicu tergantung pada jenis fitur.
CronSchedule
Gunakan CronSchedule untuk fitur agregasi batch. Secara default, Azure Databricks mengambil jadwal dari jendela agregasi. Jadwal turunan memperhitungkan periode jendela, jendela delay , dan offset, serta sumber settling_delay sehingga sebuah run tidak mempublikasikan jendela sebelum data sumbernya diharapkan selesai. Jadwal turunan mendukung jendela tumbling dan geser.
Untuk meminta jadwal turunan, hilangkan ekspresi cron.
CronSchedule() dan bentuk eksplisitnya CronSchedule(mode=CronScheduleMode.DERIVED) adalah ekuivalen:
from databricks.feature_engineering.entities import (
    CronSchedule,
    CronScheduleMode,
)

trigger = CronSchedule(mode=CronScheduleMode.DERIVED)
Jangan setkan quartz_cron_expression dengan CronScheduleMode.DERIVED. Saat Anda mengambil fitur materialized, jadwal yang dikembalikan dapat berisi ekspresi cron yang dihitung Azure Databricks.
Untuk mengontrol jadwal secara langsung, berikan ekspresi cron Quartz.
CronScheduleMode.MANUAL disimpulkan ketika Anda memberikan ekspresi:
from databricks.feature_engineering.entities import CronSchedule

trigger = CronSchedule(
    quartz_cron_expression="0 0 * * * ?",  # Hourly
    timezone_id="UTC",
)
TableTrigger
Digunakan TableTrigger untuk ColumnSelection fitur atau fitur agregasi (AggregationFunction) yang didukung oleh a DeltaTableSource atau .SdpSource Untuk , DeltaTableSourcepipeline berjalan setiap kali tabel Delta hulu menerima commit baru.
Untuk fitur agregasi, pipeline dibatasi sehingga tidak berjalan di setiap commit. Secara default, waktu antar run setidaknya setengah dari panjang jendela fitur ( slide_duration jendela geser atau window_duration jendela berguling), dijaga antara 5 menit hingga 1 jam. Misalnya, fitur dengan jendela tumbling 1 jam berjalan maksimal setiap 30 menit, dan fitur dengan jendela 8 jam berjalan maksimal setiap jam. Untuk mengubah ini, atur min_time_between_triggers. Lantai 5 menit berlaku ketika setengah jendela lebih kecil dari itu, jadi jendela yang berdurasi 10 menit atau kurang maksimal setiap 5 menit. Fitur agregasi dengan jendela kurang dari 5 menit tidak dapat menggunakan TableTrigger, gunakan pemicu streaming sebagai gantinya.
from databricks.feature_engineering.entities import TableTrigger

trigger = TableTrigger()
Untuk fitur yang didukung oleh SdpSource, TableTrigger mengawasi tabel sumber input_tables , bukan tabel output. Fitur pada tabel output dan trigger yang sama yang Anda materialisasikan dalam satu panggilan berbagi pekerjaan, yang memantau input_tables semuanya, hingga total 25 tabel. Untuk menonton lebih dari 10 tabel, aktifkan event file pada setiap tabel yang dipantau. Lihat Bagaimana tabel diperhitungkan dalam batas pemicu. Setiap run memperbarui pipeline sebelum fitur tersebut diwujudkan.
Untuk mengontrol kapan run dimulai, atur parameter opsional berikut:
TableTrigger(
    min_time_between_triggers: Optional[timedelta] = None,     # Optional: Shortest gap between two runs
    wait_after_last_change: Optional[timedelta] = None,        # Optional: Quiet period after the last update before a run starts
    condition: Optional[TableTriggerCondition] = None,         # Optional: Which table updates start a run
)
-
min_time_between_triggers: Waktu terpendek yang diizinkan antara dua run. Harus minimal 5 menit. Jika tidak diatur, fitur jendela geser menggunakan setengah darislide_duration, dan fitur jendela tumbling menggunakan setengahwindow_durationdari , yang dijaga antara 5 menit hingga 1 jam. Fitur lain tidak memiliki minimum. -
wait_after_last_change: Berapa lama tabel sumber harus tidak diperbarui sebelum run dimulai, sehingga serangkaian pembaruan mendarat terlebih dahulu. Harus nol atau setidaknya 60 detik. Jika tidak diatur atau nol, run dimulai segera setelah tabel sumber diperbarui. -
condition:TableTriggerCondition.TABLE_TRIGGER_CONDITION_ANY_UPDATED(default) memulai run ketika tabel sumber apa pun diperbarui.TableTriggerCondition.TABLE_TRIGGER_CONDITION_ALL_UPDATEDmemulai run hanya setelah setiap tabel sumber diperbarui.
Contoh berikut menunggu semua tabel input diperbarui, lalu menunggu 10 menit untuk pembaruan lebih lanjut, dan berjalan maksimal setiap jam:
from datetime import timedelta
from databricks.feature_engineering.entities import TableTrigger, TableTriggerCondition

trigger = TableTrigger(
    condition=TableTriggerCondition.TABLE_TRIGGER_CONDITION_ALL_UPDATED,
    wait_after_last_change=timedelta(minutes=10),
    min_time_between_triggers=timedelta(hours=1),
)
StreamingMode
Gunakan StreamingMode untuk menghitung fitur dengan pipeline Structured Streaming yang berkelanjutan yang menulis hasil langsung ke toko online. Ini diperlukan untuk fitur yang didukung oleh StreamSource, dan Anda juga bisa menggunakannya untuk fitur yang didukung oleh DeltaTableSource.
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import (
    StreamSource, Feature, AggregationFunction, Sum,
    RollingWindow, OnlineStoreConfig, StreamingMode,
)
from datetime import timedelta

fe = FeatureEngineeringClient()

stream_source = StreamSource(full_name="my_catalog.my_schema.my_stream")

streaming_feature = fe.create_feature(
    source=stream_source,
    entity=["value.user_id"],
    timeseries_column="value.event_time",
    function=AggregationFunction(
        operator=Sum(input="value.amount"),
        time_window=RollingWindow(window_duration=timedelta(hours=1)),
    ),
    catalog_name="my_catalog",
    schema_name="my_schema",
    name="user_purchase_sum",
)

fe.materialize_features(
    features=[streaming_feature],
    online_config=OnlineStoreConfig(
        catalog_name="my_catalog",
        schema_name="my_schema",
        table_name_prefix="streaming_features_serving",
        online_store_name="feature_store_online",
    ),
    trigger=StreamingMode(),
)
Stream dari DeltaTableSource
Ketika Anda melewatkan StreamingMode() fitur yang didukung oleh DeltaTableSource, pipeline membaca feed data perubahan tabel sebagai sumber streaming, bukan berjalan sebagai pekerjaan batch terjadwal. Ia berjalan dalam mode micro-batch, yang memproses commit baru dalam batch kecil. Sebagai contoh, lihat Definisikan fitur streaming menggunakan DeltaTableSource.
Persyaratan dan perilaku berikut berlaku:
- Tabel sumber harus mengaktifkan feed data perubahan (
delta.enableChangeDataFeed = true). Pipeline memeriksa properti ini saat dimulai dan gagal jika tidak diatur. -
ColumnSelectionfitur dan fitur agregasi yang menggunakan aRollingWindowdengan awindow_durationdidukung. Jendela tumbling, geser, dan sawtooth tidak didukung untuk fitur streamingDeltaTableSource. - Materialisasi dimulai dari versi terbaru tabel dan tidak memproses baris yang sudah ada di tabel. Sampai jendela penuh data baru tiba,
RollingWindownilai hanya mencerminkan data yang dikomitmenkan setelah pipeline dimulai. - Baris yang disisipkan dan diperbarui berkontribusi pada nilai fitur. Menghapus baris dari tabel sumber tidak menghapusnya dari nilai yang sudah diagregasi.
- Anda harus menyediakan
online_config. Fitur streaming hanya tersedia di toko online.
Memilih pemicu
Setiap fitur menggunakan satu trigger; Opsi berdasarkan tipe fitur adalah:
| Jenis fitur | Trigger | Ketika dijalankan |
|---|---|---|
Agregasi (AggregationFunction) dari DeltaTableSource |
CronSchedule |
Dengan jadwal turunan atau manual |
Agregasi (AggregationFunction) dari DeltaTableSource |
TableTrigger |
Pada setiap penerapan tabel sumber |
ColumnSelection (dari DeltaTableSource) |
TableTrigger |
Pada setiap penerapan tabel sumber |
Agregasi (AggregationFunction) dari SdpSource |
CronSchedule |
Dengan jadwal turunan atau manual |
Agregasi atau ColumnSelection dari SdpSource |
TableTrigger |
Tentang pembaruan untuk input_tables |
Fitur dari StreamSource |
StreamingMode |
Streaming berkelanjutan |
RollingWindow agregasi atau ColumnSelection dari DeltaTableSource |
StreamingMode |
Streaming kontinu (micro-batch) |
Satu materialize_features panggilan dapat mencakup fitur batch dengan pemicu SdpSource dan DeltaTableSource fitur yang berbeda, serta SdpSource fitur dari pipeline yang berbeda. Setiap sumber, pipeline, dan jadwal memiliki tugasnya sendiri. Fitur-fitur yang digunakan StreamingMode memerlukan panggilan terpisah.