Catatan
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba masuk atau mengubah direktori.
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba mengubah direktori.
Eksekusi kueri adaptif (AQE) adalah pengoptimalan ulang kueri yang terjadi selama eksekusi kueri.
Sebelum kueri dijalankan, pengoptimal memilih rencana kueri berdasarkan estimasi ukuran data. Perkiraan tersebut mungkin salah jika statistik tabel hilang atau tidak mutakhir, jika data tidak merata, atau untuk langkah-langkah selanjutnya dalam kueri yang kompleks. Rencana yang dibangun berdasarkan estimasi yang salah mungkin menggunakan strategi slow join, membuat terlalu banyak tugas kecil setelah dikocok, atau membuat beberapa tugas berukuran besar yang menunda seluruh tahap. AQE memperbaiki masalah ini dengan mengoptimalkan ulang rencana saat kueri berjalan, berdasarkan ukuran data yang sebenarnya.
Di akhir setiap shuffle atau broadcast exchange, Azure Databricks memiliki statistik yang akurat untuk data yang telah dihasilkan sejauh ini. AQE menggunakan statistik ini untuk memilih strategi fisik yang lebih baik, memilih jumlah dan ukuran partisi pasca-shuffle yang optimal, atau menerapkan optimasi yang jika tidak akan memerlukan petunjuk kueri, seperti penanganan skew join.
AQE diaktifkan secara default. Anda tidak perlu mengubah kueri Anda untuk mendapatkan manfaat darinya. Periksa apakah AQE mengubah rencana kueri saat Anda memecahkan masalah kueri yang lambat. Sesuaikan pengaturan AQE hanya ketika pengaturan default tidak sesuai dengan beban kerja Anda. Lihat rencana kueri dan Konfigurasi.
Kemampuan
AQE memiliki empat fitur utama:
- Mengubah penggabungan sort merge secara dinamis menjadi penggabungan hash broadcast.
- Menggabungkan partisi secara dinamis (menggabungkan partisi kecil menjadi partisi berukuran wajar) setelah pertukaran data secara shuffle. Tugas yang sangat kecil memiliki throughput I/O yang lebih rendah dan cenderung lebih terdampak oleh beban tambahan dari penjadwalan dan penyiapan tugas. Menggabungkan tugas kecil menghemat sumber daya dan meningkatkan throughput kluster.
- Menangani penyimpangan secara dinamis dalam gabungan gabungan sortir dan mengacak gabungan hash dengan memisahkan (dan mereplikasi jika diperlukan) tugas miring menjadi tugas berukuran kira-kira merata.
- Secara dinamis mendeteksi dan menyebarkan relasi kosong, yang merupakan bagian dari kueri yang tidak mengembalikan baris.
Kueri yang didukung
AQE berlaku untuk kueri yang memenuhi kedua kondisi berikut:
- Query ini bukan query streaming.
- Kueri ini berisi setidaknya satu exchange (biasanya dari join, agregat, atau window), setidaknya satu subkueri, atau keduanya.
AQE mengoptimalkan ulang setiap kueri yang didukung, tetapi hasilnya mungkin adalah rencana yang sama seperti yang dikompilasi oleh optimizer sebelum kueri dijalankan. Untuk memeriksa apakah AQE mengubah rencana kueri, lihat Rencana kueri.
Rencana pencarian
Kueri yang diterapkan AQE berisi satu atau beberapa simpul AdaptiveSparkPlan, biasanya sebagai simpul akar dari setiap kueri utama atau sub-kueri. Setiap AdaptiveSparkPlan node memiliki sebuah isFinalPlan flag. Flag ada false sebelum dan selama eksekusi query, dan berubah menjadi true saat query selesai.
Untuk melihat rencana kueri, gunakan UI Spark, DataFrame.explain(), atau SQL EXPLAIN. Masing-masing menunjukkan informasi berbeda tentang bagaimana AQE mengubah rencana.
Antarmuka pengguna Spark
Diagram rencana kueri di UI Spark menampilkan rencana terbaru dan pembaruan saat kueri dijalankan. Node yang sudah berjalan dan memiliki metrik, tidak berubah. Node-node yang belum berjalan mungkin berubah saat AQE mengoptimalkan ulang rencana.
Contoh ini menunjukkan diagram rencana kueri:
diagram rencana kueri 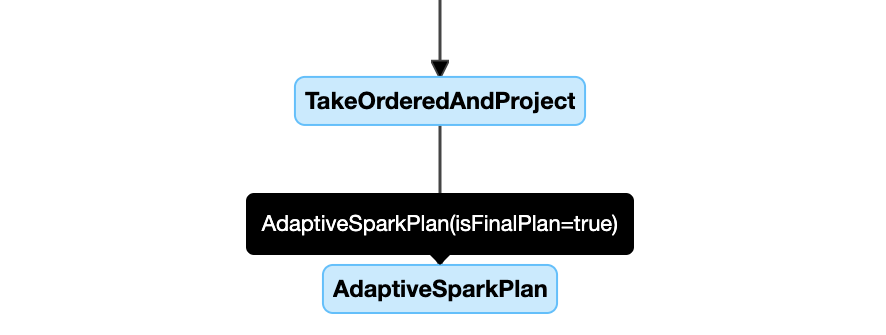
DataFrame.explain()
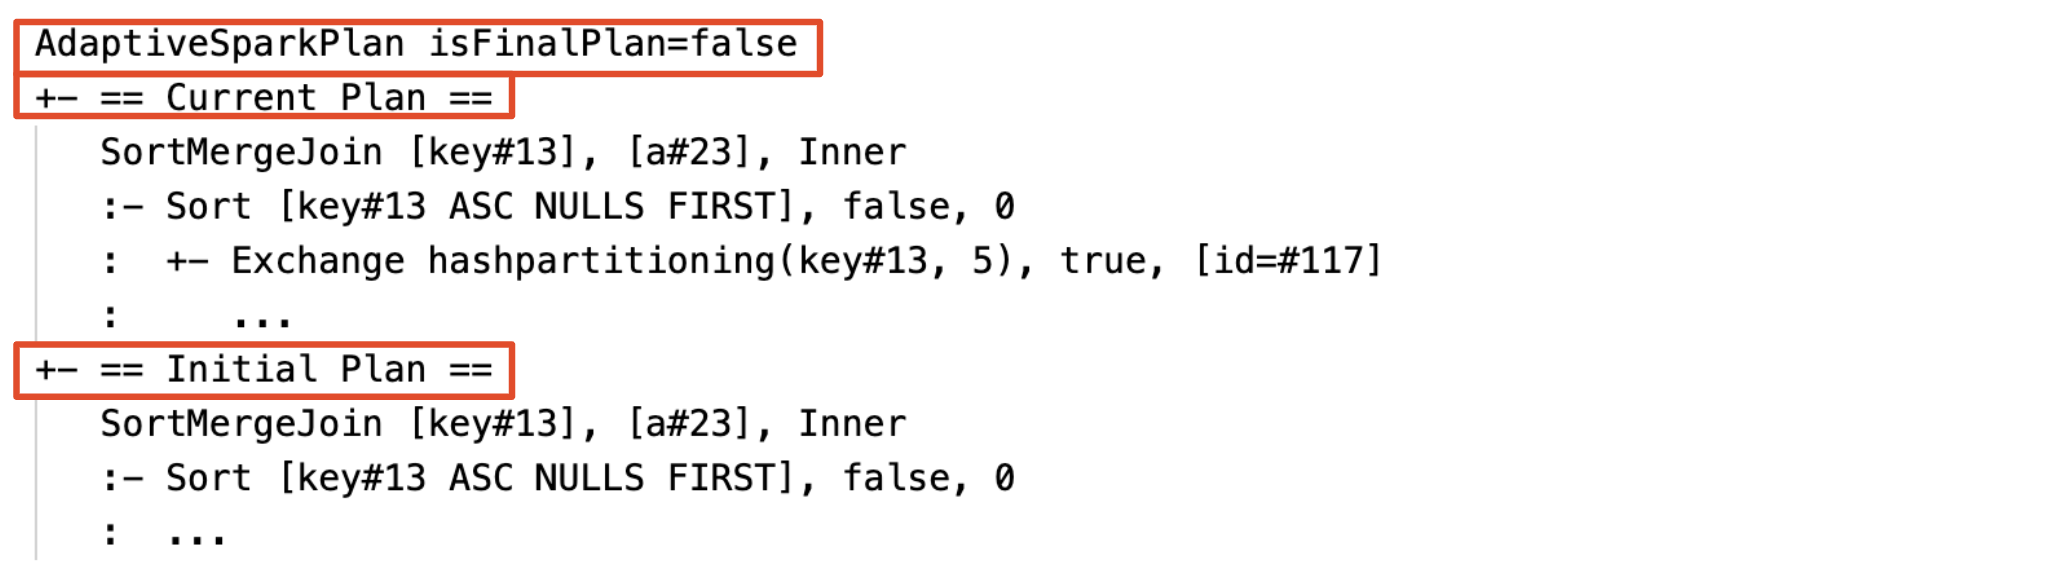
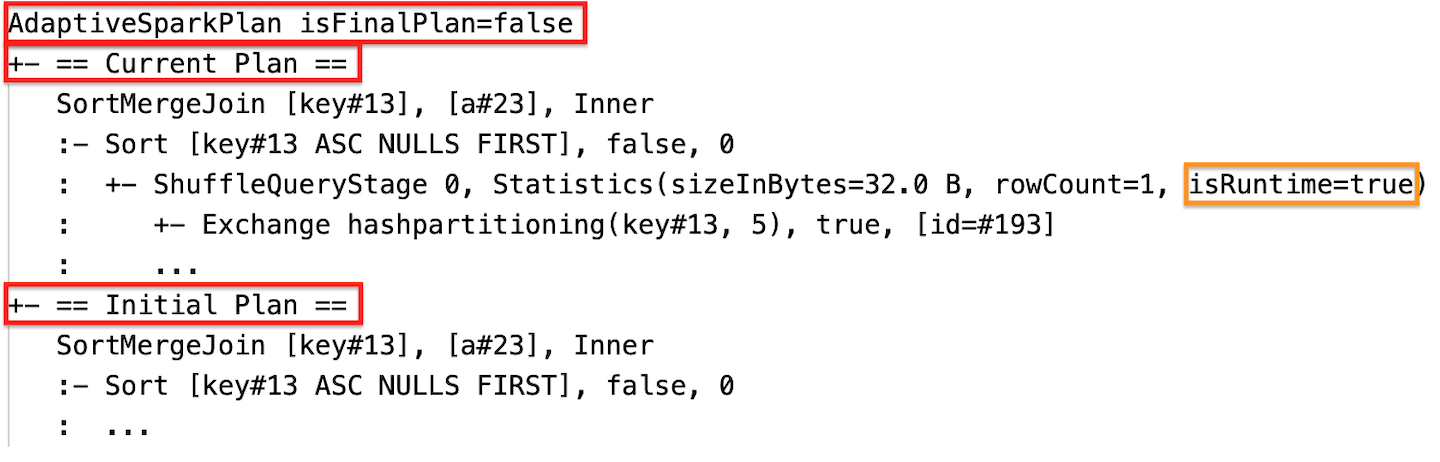
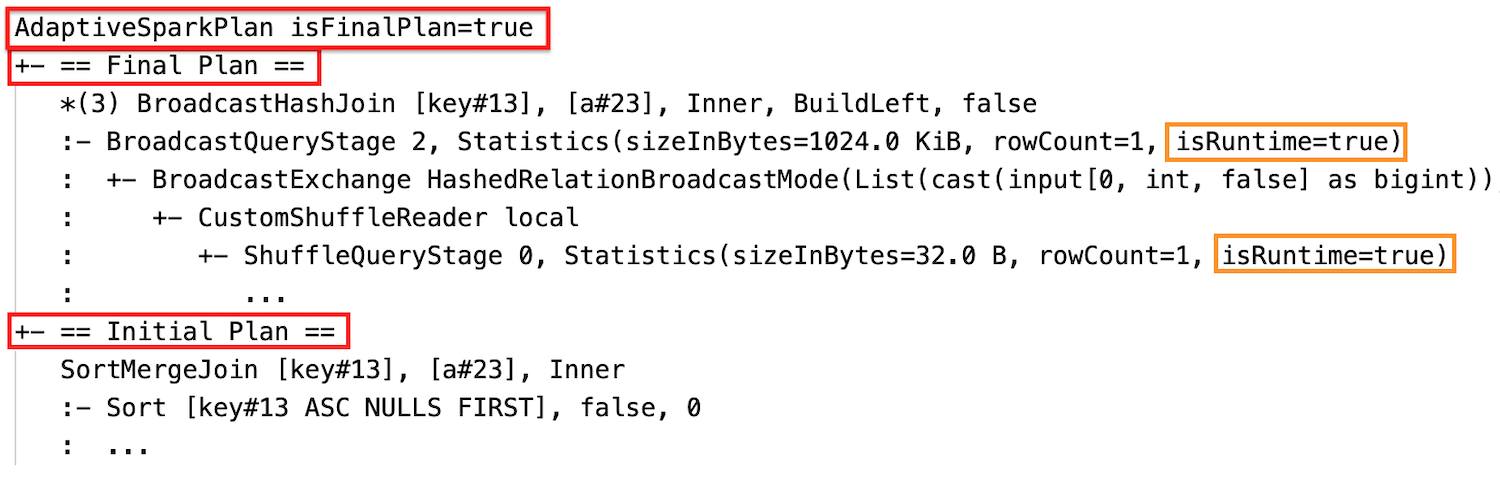
DataFrame.explain() menampilkan dua rencana di bawah setiap AdaptiveSparkPlan node: rencana awal, sebelum AQE menerapkan optimasi apa pun, dan rencana saat ini. Rencana saat ini berubah saat kueri berjalan dan menjadi rencana akhir ketika kueri selesai.
Output mencakup statistik data untuk setiap shuffle dan tahap broadcast. Statistik bergantung pada apakah tahap sudah dijalankan:
- Sebelum dan selama tahap dijalankan,
isRuntimeadalahfalsedan statistik adalah perkiraan saat kompilasi. Contohnya,Statistics(sizeInBytes=1024.0 KiB, rowCount=4, isRuntime=false). - Setelah tahap berjalan,
isRuntimemerupakantruedan statistik adalah pengukuran waktu eksekusi. Contohnya,Statistics(sizeInBytes=658.1 KiB, rowCount=2.81E+4, isRuntime=true).
Tangkapan layar ini menunjukkan DataFrame.explain() output sebelum, selama, dan setelah eksekusi:
Sebelum eksekusi
Saat dijalankan
Setelah eksekusi
SQL EXPLAIN
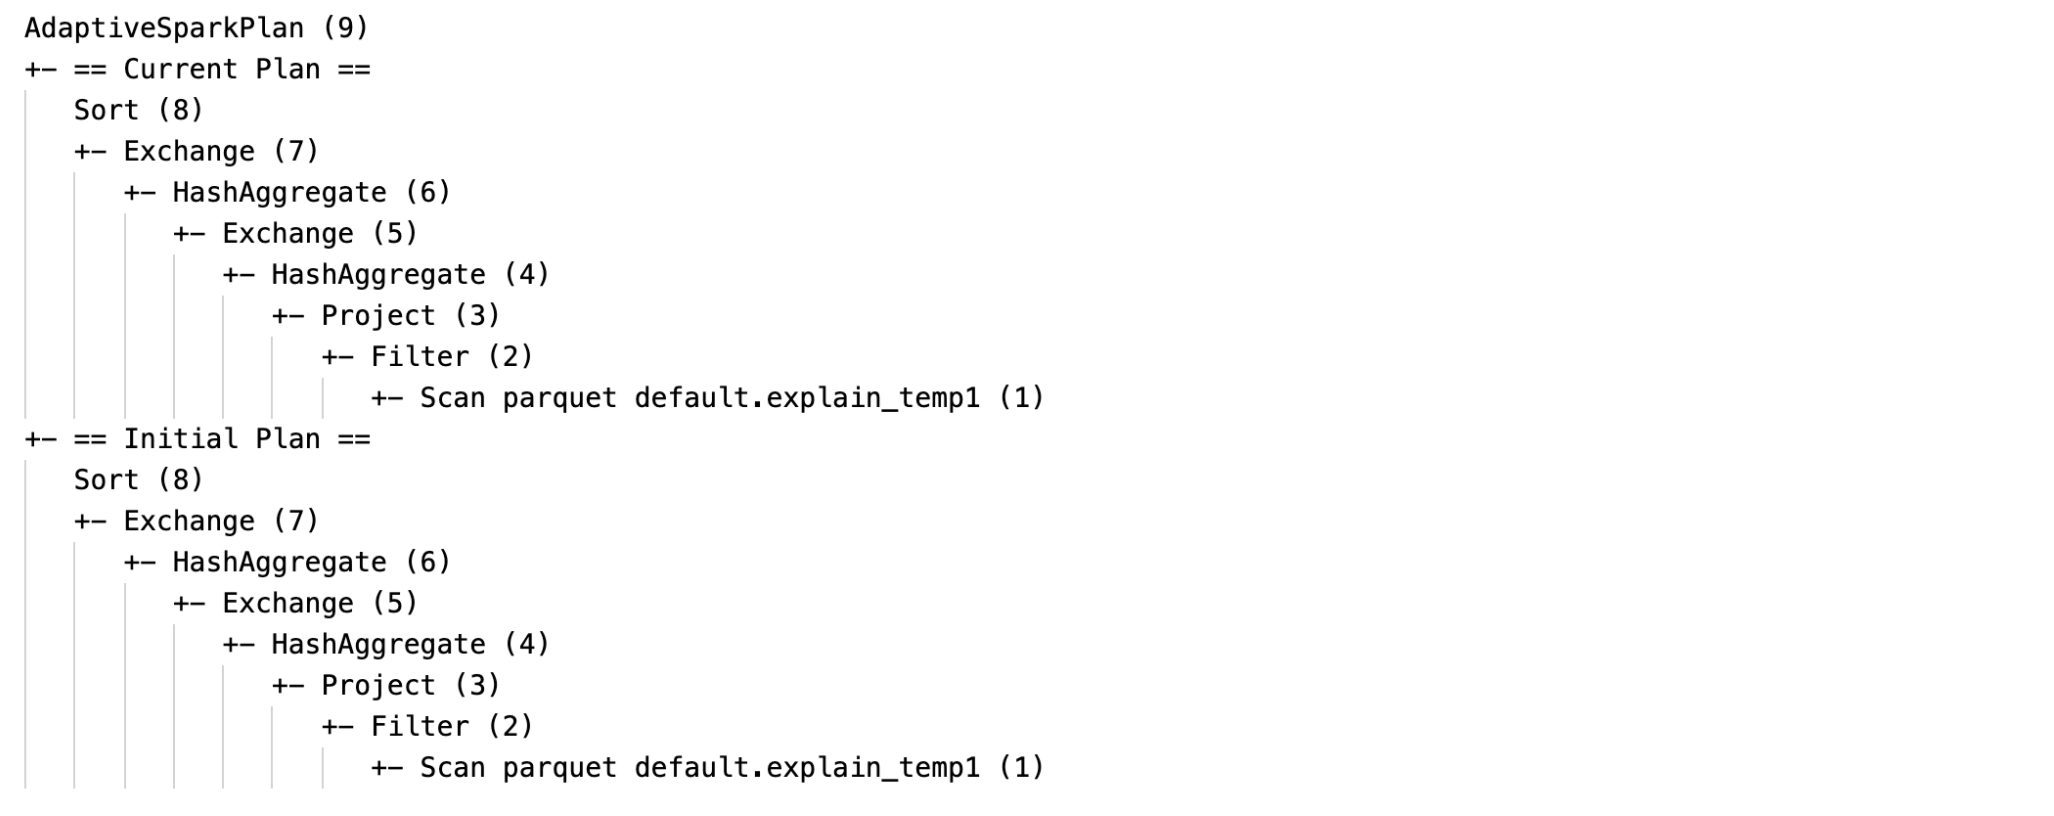
SQL EXPLAIN tidak menjalankan query, jadi AQE tidak bisa mengoptimalkannya ulang. Output hanya menampilkan rencana awal, yang mungkin berbeda dari rencana yang dijalankan AQE.
Contoh ini menunjukkan SQL EXPLAIN output:
Mengidentifikasi optimasi yang diterapkan dalam rencana kueri
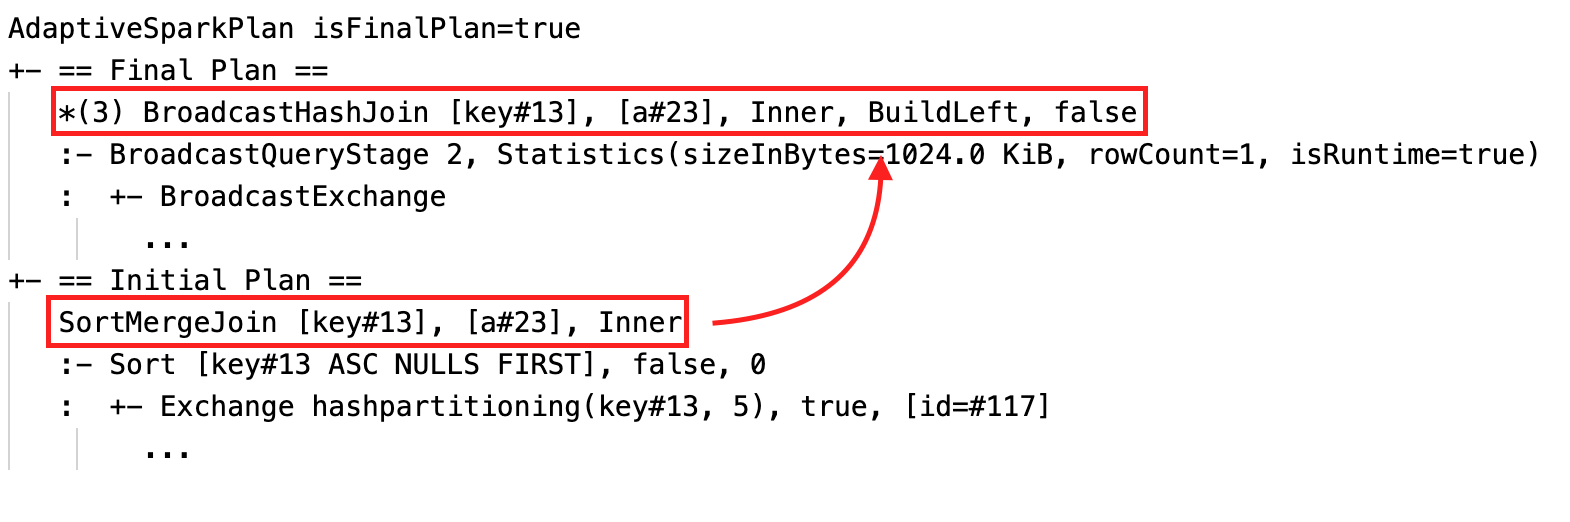
Ketika AQE menerapkan optimasi, rencana kueri berubah. Untuk mengidentifikasi optimasi mana yang diterapkan, bandingkan rencana saat ini atau rencana akhir dengan rencana awal. Setiap optimasi mengubah rencana dengan cara tertentu:
Perubahan strategi join Rencana saat ini atau akhir memiliki node join fisik yang berbeda dari rencana awal.
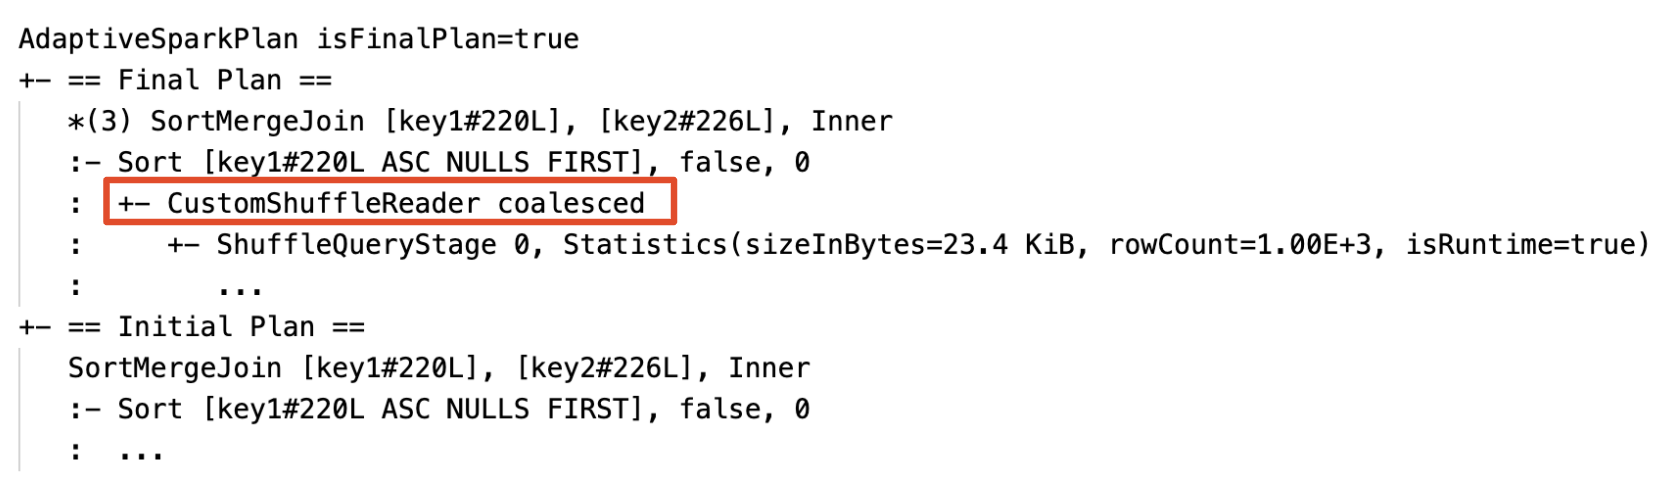
Penggabungan partisi. Rencana berisi node
CustomShuffleReaderdengan propertiCoalesced.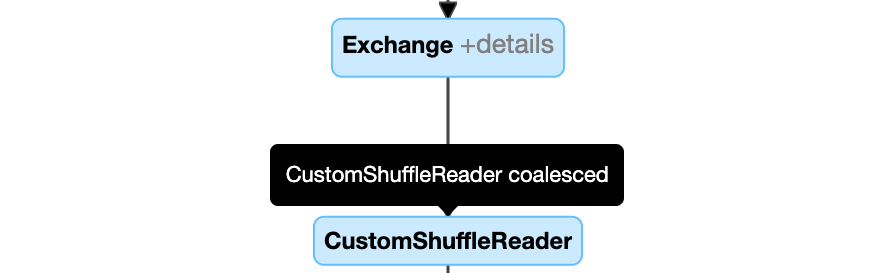
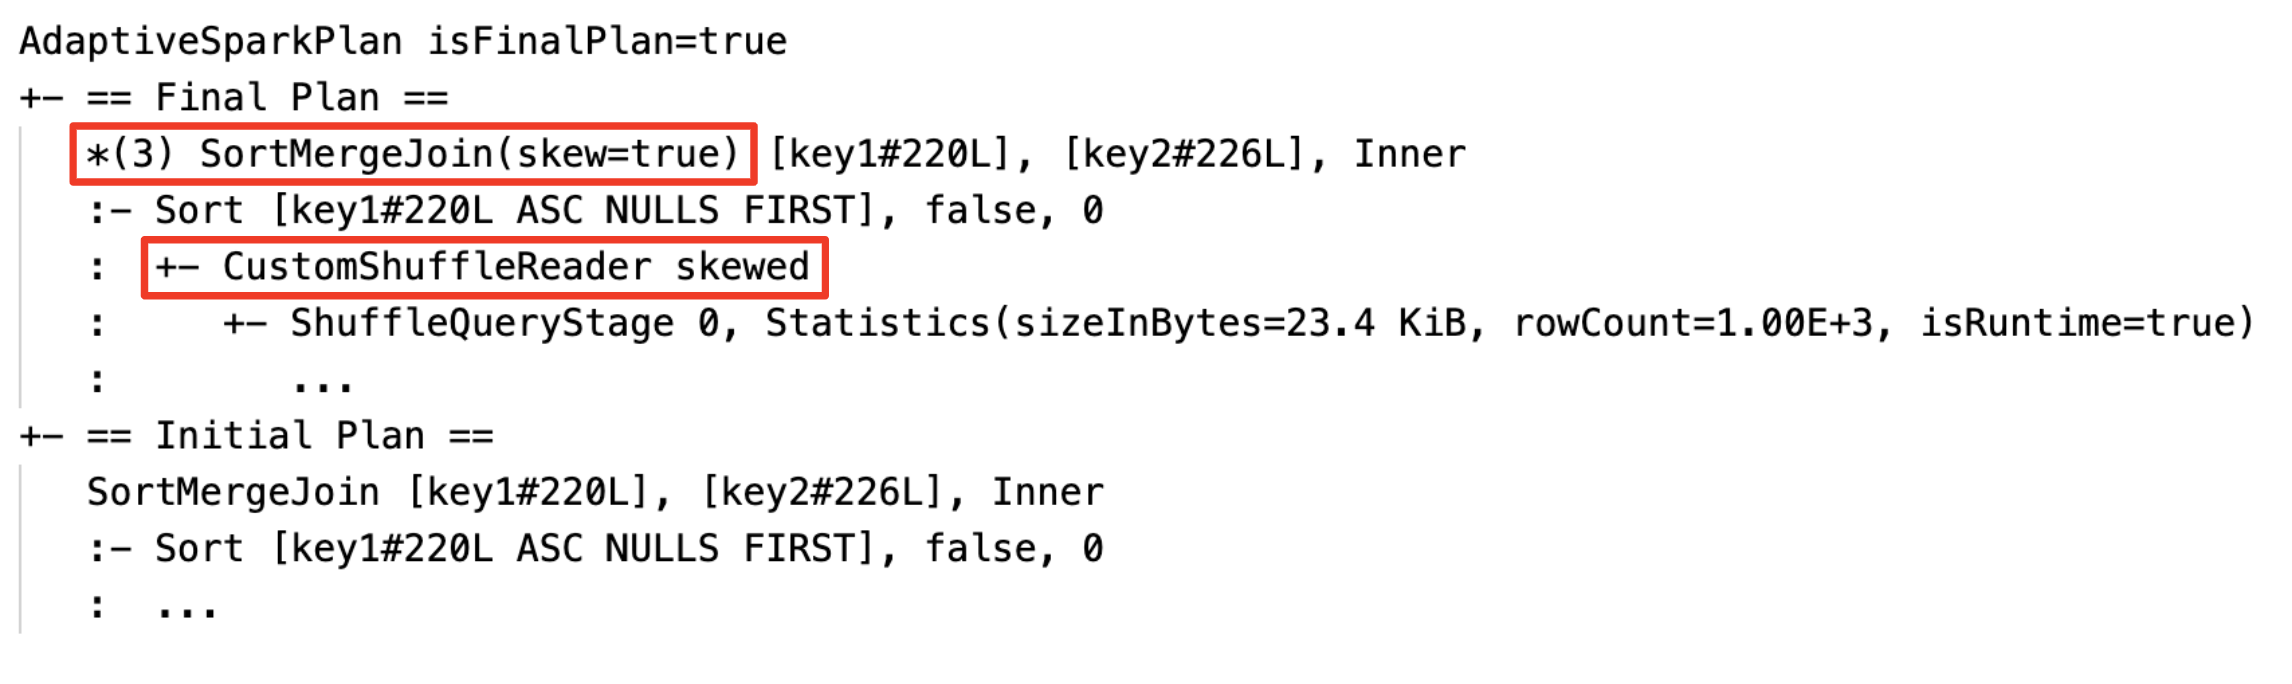
Skew join handling. Rencana berisi sebuah
SortMergeJoinnode denganisSkewfield diatur ketrue.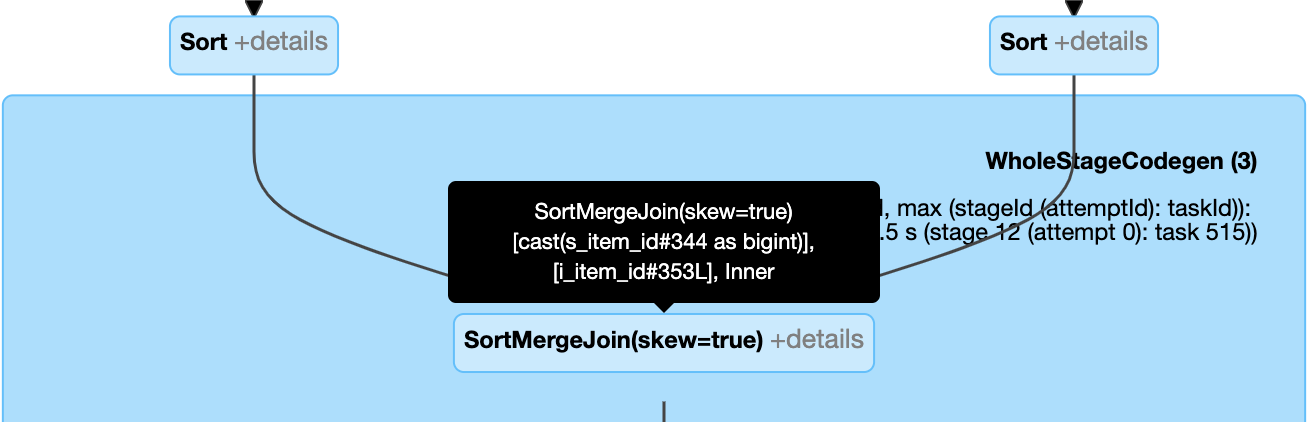
Propagasi relasi kosong.
LocalTableScanNode dengan field relasi kosong menggantikan sebagian atau seluruh rencana.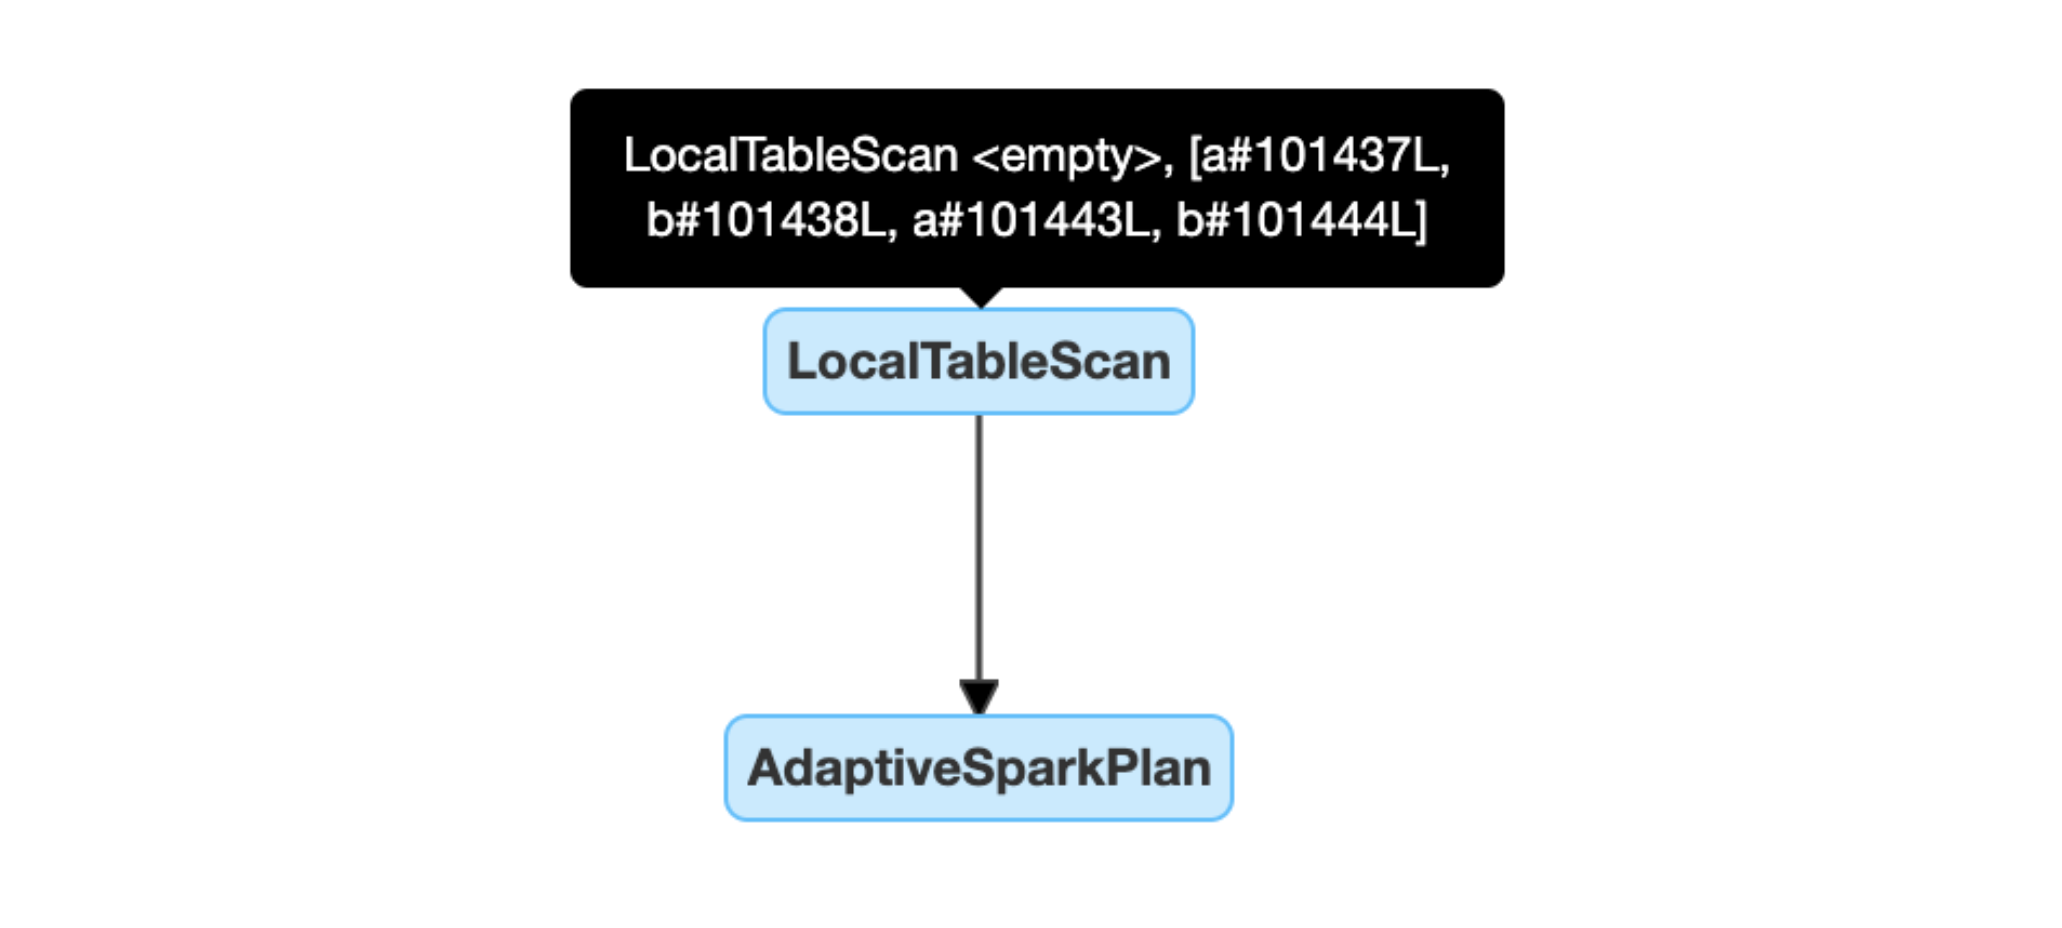
string pemindaian tabel lokal
Konfigurasi
Properti konfigurasi Apache Spark ini mengontrol AQE. Sebagian besar beban kerja tidak perlu mengubah pengaturan bawaan.
Aktifkan AQE dan sesuaikan optimasi individual
Gunakan properti ini untuk mengaktifkan atau mematikan AQE dan menyetel shuffle yang dioptimalkan secara otomatis, switching broadcast join, dan propagasi relasi kosong:
| Harta benda | Type | Default | Description |
|---|---|---|---|
spark.databricks.optimizer.adaptive.enabled |
Boolean |
true |
Mengaktifkan atau menonaktifkan eksekusi kueri adaptif. |
spark.sql.shuffle.partitions |
Integer |
200 |
Jumlah default partisi yang akan digunakan saat mengatur ulang data untuk gabungan atau agregasi. Atur ke auto untuk mengaktifkan shuffle yang dioptimalkan otomatis, yang mengatur angka ini berdasarkan rencana kueri dan ukuran data input kueri.Untuk Structured Streaming, Anda tidak dapat mengubah nilai ini antara restart query dari lokasi checkpoint yang sama. |
spark.databricks.adaptive.autoBroadcastJoinThreshold |
Byte String |
30MB |
Ambang ukuran untuk mengganti sort merge join ke broadcast hash join saat runtime. |
spark.databricks.adaptive.emptyRelationPropagation.enabled |
Boolean |
true |
Mengaktifkan atau menonaktifkan propagasi relasi kosong dinamis. |
Gabungkan partisi secara dinamis
| Harta benda | Type | Default | Description |
|---|---|---|---|
spark.sql.adaptive.coalescePartitions.enabled |
Boolean |
true |
Mengaktifkan atau mematikan penggabungan partisi. |
spark.sql.adaptive.advisoryPartitionSizeInBytes |
Byte String |
64MB |
Ukuran target setelah penggabungan. Partisi yang tergabung mendekati, tetapi tidak lebih besar dari, ukuran ini. |
spark.sql.adaptive.coalescePartitions.minPartitionSize |
Byte String |
1MB |
Ukuran minimum partisi setelah penggabungan. Partisi koalesced tidak lebih kecil dari ukuran ini. |
spark.sql.adaptive.coalescePartitions.minPartitionNum |
Integer |
Dua kali jumlah inti klaster | Jumlah minimum partisi setelah penggabungan. Jangan atur properti ini, karena mengaturnya akan menggantikan spark.sql.adaptive.coalescePartitions.minPartitionSize. |
Menangani penggabungan yang tidak seimbang secara dinamis
| Harta benda | Type | Default | Description |
|---|---|---|---|
spark.sql.adaptive.skewJoin.enabled |
Boolean |
true |
Mengaktifkan atau mematikan penanganan skew join. |
spark.sql.adaptive.skewJoin.skewedPartitionFactor |
Integer |
5 |
Pengali untuk ukuran partisi median yang harus dilampaui oleh sebuah partisi agar dianggap tidak seimbang. |
spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes |
Byte String |
256MB |
Ukuran minimum yang harus dilampaui sebuah partisi agar dianggap tidak seimbang. |
AQE memperlakukan partisi sebagai skew hanya ketika kedua kondisi ini benar: (partition size > skewedPartitionFactor * median partition size) dan (partition size > skewedPartitionThresholdInBytes).
Tanya jawab umum (FAQ)
Mengapa AQE tidak mendistribusikan tabel gabungan yang kecil?
Jika tabel lebih kecil dari spark.databricks.adaptive.autoBroadcastJoinThreshold tetapi AQE tidak melakukan broadcast, periksa penyebab-penyebab berikut:
- Jenis join tidak mendukung broadcast. Beberapa jenis join tidak bisa membroadcast satu sisi. Misalnya, AQE tidak dapat menyiarkan sisi kiri dari
LEFT OUTER JOIN. - Tabel memiliki banyak partisi kosong. Sebagian besar tugas dalam sort merge join selesai dengan cepat, atau penanganan skew join mengoptimalkan join. AQE tidak mengubah sort merge join menjadi broadcast hash join jika persentase partisi yang tidak kosong lebih rendah dari
spark.sql.adaptive.nonEmptyPartitionRatioForBroadcastJoin.
Haruskah saya tetap menggunakan petunjuk broadcast join dengan AQE diaktifkan?
Ya, jika Anda memahami kueri Anda dengan baik. Broadcast join yang direncanakan optimizer sebelum kueri berjalan biasanya berkinerja lebih baik daripada yang direncanakan AQE saat runtime. AQE mungkin baru akan beralih ke broadcast join setelah melakukan shuffle pada kedua sisi join, saat itulah ia mengetahui ukuran tabel yang sebenarnya.
AQE menghormati petunjuk kueri dengan cara yang sama seperti optimasi statis, dan tetap menerapkan optimasi dinamis yang tidak terpengaruh oleh petunjuk tersebut.
Haruskah saya menggunakan petunjuk skew join atau penanganan skew join AQE?
Gunakan penanganan skew join AQE. Fitur ini otomatis dan biasanya performanya lebih baik daripada petunjuk skew join.
Mengapa AQE tidak mengurutkan ulang join saya?
AQE tidak mengubah urutan join saat runtime. Untuk meningkatkan urutan join, kumpulkan statistik tabel agar optimizer berbasis biaya dapat memilih rencana yang lebih baik. Lihat Pengoptimal berbasis biaya.
Mengapa AQE tidak mendeteksi penyimpangan data saya?
AQE memperlakukan partisi sebagai miring hanya ketika kedua kondisi ini benar:
- Partisi lebih besar dari
spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes(default256MB). - Partisi berukuran lebih besar dari
spark.sql.adaptive.skewJoin.skewedPartitionFactor(default5) kali ukuran median partisi.
AQE juga hanya menangani skew pada join berbasis shuffle, yaitu join sortir merge dan shuffle hash join. Itu tidak pernah mengoptimalkan kemencengan dalam join siaran. Untuk join berbasis shuffle, tipe join menentukan sisi mana yang dapat dioptimalkan oleh AQE:
| Tipe penggabungan | Kemiringan dioptimalkan pada sisi kiri | Skew dioptimalkan untuk sisi kanan |
|---|---|---|
INNER |
Yes | Yes |
CROSS |
Yes | Yes |
LEFT OUTER |
Yes | Tidak. |
RIGHT OUTER |
Tidak. | Yes |
LEFT SEMI |
Yes | Tidak. |
LEFT ANTI |
Yes | Tidak. |
FULL OUTER |
Tidak. | Tidak. |
Warisan
Spark 1.6 memperkenalkan fitur yang disebut adaptive execution, tetapi AQE di Spark 3.0 adalah fitur yang berbeda. Eksekusi adaptif Spark 1.6 hanya menggabungkan partisi secara dinamis. AQE adalah kerangka kerja yang merencanakan dan merencanakan ulang kueri berdasarkan statistik runtime, dan mendukung semua optimasi di halaman ini.