Catatan
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba masuk atau mengubah direktori.
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba mengubah direktori.
Important
Item yang ditandai sebagai pratinjau dalam artikel ini saat ini masih dalam pratinjau. Pratinjau ini disediakan tanpa perjanjian tingkat layanan, dan Microsoft tidak merekomendasikannya untuk beban kerja produksi. Fitur tertentu mungkin tidak didukung atau mungkin memiliki kemampuan terbatas. Untuk informasi lebih lanjut, lihat Supplemental Terms of Use for Microsoft Azure Previews.
Important
Pelatihan interaktif memerlukan persetujuan akses secara eksplisit. Minta akses melalui formulir pendaftaran pratinjau dan tunggu persetujuan sebelum membuat sesi pelatihan.
Pelatihan interaktif (pratinjau) adalah API untuk membuat loop pascapelatihan Anda sendiri untuk model dengan bobot terbuka di Microsoft Foundry. Anda mengontrol eksperimen di Python. Foundry menjalankan pengambilan sampel model dan pembaruan adaptasi peringkat rendah (LoRA) pada GPU serverless.
Untuk pembelajaran penguatan (RL), kode Anda mengontrol pengumpulan rollout, reward, advantage, dan penjadwalan pembaruan. Komponen dasar yang sama mendukung pembelajaran yang diawasi, pembelajaran preferensi, distilasi, dan alur kerja fungsi kerugian kustom.
Kapan harus menggunakannya
Gunakan pelatihan interaktif ketika loop pelatihan itu sendiri adalah bagian dari penelitian Anda:
- Anda memerlukan sinyal pembelajaran kustom. Menyediakan demonstrasi, menghitung reward dan keuntungan, atau menyusun loss lokal untuk pembelajaran preferensi atau tujuan lainnya.
- Model Anda berinteraksi dengan lingkungan. Koordinasikan respons model, panggilan alat, pengamatan, dan hadiah di pengendali Anda.
- Anda memerlukan kontrol atas pembaruan individual. Pilih batch, masker token, pengaturan loss, dan parameter optimizer. Tentukan kapan harus mengakumulasi gradien dan menerapkan pembaruan.
- Anda ingin memeriksa dan mengadaptasi eksperimen. Sampel dari adaptor saat ini, evaluasi pada prompt yang dicadangkan untuk evaluasi, dan pilih prompt berikutnya berdasarkan hasil yang diamati.
- Anda perlu mempertahankan dan meneruskan progres. Simpan adaptor dan status pengoptimal, lalu lanjutkan dalam sesi yang kompatibel. Pertahankan posisi himpunan data dan status eksperimen lainnya di driver Anda.
Penyempurnaan terkelola juga mendukung penilai untuk fine-tuning penguatan. Pilih pelatihan interaktif saat Anda memerlukan kontrol atas loop, bukan hanya grader atau setelan job. Lihat Memilih pendekatan pelatihan Anda.
Siapa yang melakukan apa
Program Python Anda adalah pengendali pelatihan. Ini menyiapkan input dan mengoordinasikan eksperimen. Foundry mempertahankan model dan status adaptor dan menjalankan operasi yang diminta.
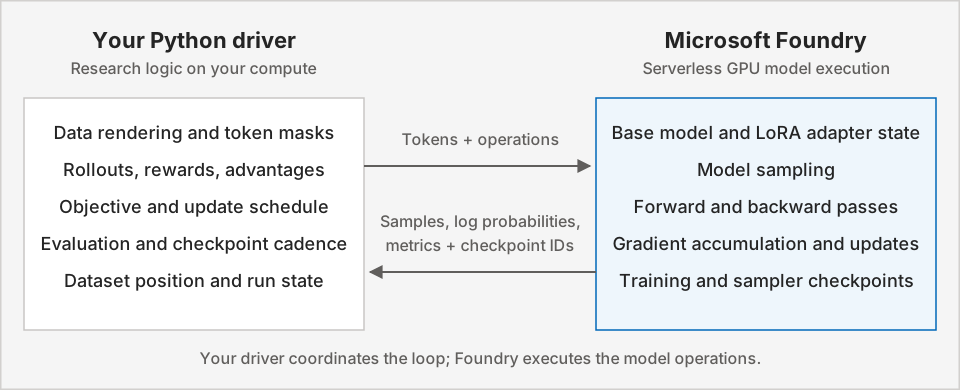
Driver Anda dapat berjalan pada CPU, termasuk mesin Anda sendiri atau lingkungan komputasi. Model hadiah atau lingkungan yang Anda tambahkan dapat memiliki persyaratan komputasinya sendiri. Jaga agar driver tetap berjalan selagi sistem mengelola loop.
Konsep dan primitif inti
Sesi bersifat stateful: komputasi gradien, pembaruan pengoptimal, dan pengambilan sampel adalah operasi terpisah pada model yang dipilih dan adaptor yang dipilih. Pemisahan ini memungkinkan Anda memilih kapan harus mengumpulkan data, mengakumulasi gradien, memperbarui, dan mengevaluasi.
| Blok penyusun | Apa fungsinya |
|---|---|
| Sesi pelatihan dan adaptor LoRA |
FineTuningSession.create menginisialisasi model dasar yang didukung dengan konfigurasi adaptor Anda. Sesi ini menyimpan keadaan yang digunakan oleh operasi berikutnya. |
| Batch dan mask yang ditokenisasi |
Datum membawa input model dan input loss. Masker memilih token mana yang berkontribusi pada pembelajaran, seperti token asisten daripada prompt atau pengamatan alat. |
| Pengambilan sampel |
sample menghasilkan respons dari checkpoint sampler yang dipilih. Input RL memasangkan token yang disampel dengan probabilitas log rollout dan advantage yang diturunkan dari reward. |
| Pass maju dan mundur |
forward mengembalikan output fungsi kehilangan per contoh tanpa mengumpulkan gradien.
forward_backward menghitung objektif yang dipilih dan mengakumulasi gradien. Ini tidak menerapkan pembaruan optimizer. |
| Pembaruan pengoptimalan |
optim_step menerapkan gradien yang terakumulasi dengan parameter Adam Anda. Anda memilih kapan harus memperbarui dan tingkat pembelajaran mana yang akan digunakan. |
| Pos pemeriksaan sampler |
save_weights_for_sampler menyiapkan bobot adaptor untuk pembuatan. Segarkan bobot ini setelah pembaruan sebelum pengambilan sampel dari adaptor yang diperbarui. |
| Checkpoint pelatihan |
save_weights menyimpan bobot adaptor dan status pengoptimal.
FineTuningSession.create_from_checkpoint melanjutkan pelatihan dalam sesi yang kompatibel. |
SDK termasuk cross_entropy untuk pembaruan terawasi dan loss RL seperti importance_sampling dan ppo. Kerugian ini adalah primitive loss, bukan algoritma end-to-end yang telah ditentukan sebelumnya. Untuk kontrak input dan komposisi loss kustom, lihat Konsep utama.
Cara kerja loop RL
Pertimbangkan eksperimen penalaran matematika: model Anda menghasilkan beberapa jawaban untuk setiap masalah, dan program Anda menilai kebenarannya. Untuk contoh praktis, ikuti Memulai.
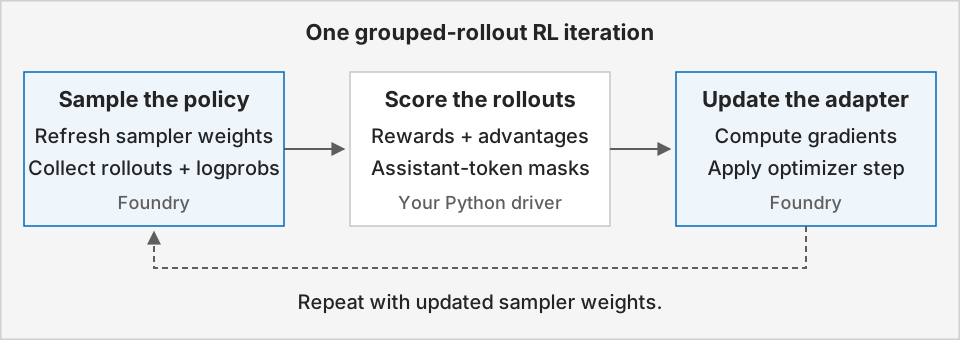
Tetapkan baseline held-out dan uji fungsi reward Anda sebelum pembaruan pertama. Kemudian ulangi:
- Siapkan kebijakan yang berlaku untuk pengambilan sampel. Simpan bobot sampler dari adaptor pelatihan, lalu kumpulkan beberapa respons, atau rollouts, untuk setiap perintah.
- Menilai dan membandingkan respons. Fungsi hadiah Anda menetapkan skor untuk setiap rollout. Kurangi hadiah rata-rata grup prompt untuk menghasilkan advantage setiap peluncuran.
- Siapkan sinyal pembelajaran. Sejajarkan token asisten yang disampel dengan probabilitas log rollout dan advantage-nya. Kecualikan prompt dan pengamatan lingkungan dari sinyal pembelajaran.
- Hitung gradien. Kirim batch ke
forward_backwarddenganimportance_sampling. Selesaikan komputasi gradien sebelum pembaruan yang menggunakannya. - Perbarui adaptor. Panggil
optim_step, lalu refresh bobot sampler sebelum mengumpulkan respons dari kebijakan yang diperbarui. - Nilai dan pertahankan kemajuan. Bandingkan akurasi pada data validasi dengan baseline dan simpan checkpoint pelatihan sesuai interval yang Anda pilih.
Get started
Pilih titik awal yang sesuai dengan tugas Anda:
- Mulai cepat: Ikuti sampel mulai cepat untuk mengkloning repositori dan menjalankan resep pembelajaran penguatan singkat.
- Coba resep lain: Jelajahi repositori sampel fine-tuning untuk contoh pelatihan lainnya.
- Cari operasi: Gunakan cheatsheet SDK (pratinjau) untuk fungsi dan parameter kunci.
- Pahami loop pelatihan: Baca Konsep utama untuk hadiah, keuntungan, masker token, dan checkpoint.
Model dan wilayah yang didukung
Lihat gambaran umum penyempurnaan untuk model yang didukung dan wilayah yang didukung.