Catatan
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba masuk atau mengubah direktori.
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba mengubah direktori.
Berlaku untuk: ✅ Gudang di Microsoft Fabric
Artikel ini menjelaskan metode migrasi dari pool SQL khusus Azure Synapse Analytics ke Microsoft Fabric Data Warehouse.
Petunjuk / Saran
Untuk informasi lebih lanjut tentang strategi dan perencanaan migrasi Anda, lihat Perencanaan migrasi: Azure Synapse Analytics pool SQL khusus untuk Fabric Data Warehouse.
Pengalaman otomatisasi untuk migrasi dari kumpulan SQL khusus Azure Synapse Analytics tersedia menggunakan Fabric Migration Assistant untuk Gudang Data. Sisa artikel ini berisi lebih banyak langkah migrasi manual.
Tabel berikut merangkum metode untuk migrasi skema data (DDL), kode basis data (DML), dan data. Kolom Opsi menautkan ke detail untuk setiap skenario.
| Nomor opsi | Opsi | Apa fungsinya | Keterampilan atau preferensi | Skenario |
|---|---|---|---|---|
| 1 | Data Factory | Konversi skema (DDL) Ekstrak data Penyerapan data |
ADF/Pipeline | Penyederhanaan skema terpadu (DDL) dan migrasi data. Direkomendasikan untuk tabel dimensi. |
| 2 | Pabrik Data dengan partisi | Konversi skema (DDL) Ekstrak data Penyerapan data |
ADF/Pipeline | Menggunakan opsi partisi, direkomendasikan untuk tabel fakta, dengan menyediakan throughput sepuluh kali lebih banyak dibanding opsi 1 untuk meningkatkan paralelisme baca/tulis. |
| 3 | Pabrik Data dengan kode yang dipercepat | Konversi skema (DDL) | ADF/Pipeline | Konversi dan migrasikan skema (DDL) terlebih dahulu, lalu gunakan CETAS untuk mengekstrak dan COPY/Data Factory untuk menyerap data untuk performa penyerapan keseluruhan yang optimal. |
| 4 | Prosedur tersimpan yang mempercepat kode | Konversi skema (DDL) Ekstrak data Penilaian kode |
T-SQL | Pengguna SQL menggunakan IDE dengan kontrol yang lebih terperinci atas tugas mana yang ingin mereka kerjakan. Gunakan COPY/Data Factory untuk menyerap data. |
| 5 | Ekstensi Proyek SQL Database untuk Visual Studio Code | Konversi skema (DDL) Ekstrak data Penilaian kode |
Proyek SQL | Proyek Basis Data SQL untuk penyebaran dengan integrasi opsi 4. Gunakan COPY atau Data Factory untuk menyerap data. |
| 6 | BUAT TABEL EKSTERNAL SEBAGAI HASIL DARI PILIHAN (CETAS) | Ekstrak data | T-SQL | Ekstrak data hemat biaya dan berkinerja tinggi ke Azure Data Lake Storage (ADLS) Gen2. Gunakan COPY/Data Factory untuk menyerap data. |
| 7 | Migrasi menggunakan dbt | Konversi skema (DDL) kode basis data (DML) konversi |
dbt | Pengguna dbt yang ada dapat menggunakan adaptor dbt Fabric untuk mengonversi DDL dan DML mereka. Anda kemudian harus memigrasikan data menggunakan opsi lain dalam tabel ini. |
Pilih beban kerja untuk migrasi awal
Saat memutuskan dari mana memulai pool SQL khusus Synapse untuk proyek migrasi Fabric Data Warehouse, pilih area beban kerja di mana Anda dapat:
- Buktikan kelayakan migrasi ke Fabric Data Warehouse dengan cepat memberikan manfaat dari lingkungan baru. Mulailah dari yang kecil dan sederhana, lalu bersiaplah untuk beberapa migrasi kecil.
- Izinkan waktu staf teknis internal Anda untuk mendapatkan pengalaman yang relevan dengan proses dan alat yang mereka gunakan saat bermigrasi ke area lain.
- Buat templat khusus untuk migrasi lebih lanjut yang sesuai dengan lingkungan Synapse sumber, serta alat dan proses yang tersedia untuk membantu memfasilitasi migrasi.
Petunjuk / Saran
Buat inventaris objek yang akan dimigrasikan, dan dokumentasikan proses migrasi dari awal hingga akhir agar Anda dapat mengulanginya untuk pool SQL khusus atau beban kerja lainnya.
Volume data yang dimigrasikan dalam migrasi awal harus cukup besar untuk menunjukkan kemampuan dan manfaat lingkungan Fabric Data Warehouse, tetapi tidak terlalu besar untuk menunjukkan nilai dengan cepat. Ukuran dalam rentang 1-10 terabyte merupakan ukuran umum.
Migrasi dengan Fabric Data Factory
Bagian ini menjelaskan opsi Data Factory bagi pengguna yang familiar dengan pipeline Azure Data Factory dan Synapse. Antarmuka drag-and-drop menyediakan cara sederhana untuk mengonversi DDL dan memigrasi data.
Fabric Data Factory dapat melakukan tugas-tugas berikut:
- Konversi skema (DDL) ke sintaks Fabric Data Warehouse.
- Buat skema (DDL) di Fabric Data Warehouse.
- Migrasikan data ke Fabric Data Warehouse.
Opsi 1. Migrasi skema dan data - asisten penyalinan data dan aktivitas salin ForEach
Metode ini menggunakan Data Factory Copy data assistant untuk terhubung ke pool SQL khusus sumber, mengonversi sintaks DDL pool SQL dedicated ke Fabric, dan menyalin data ke Fabric Data Warehouse. Anda dapat memilih satu atau beberapa tabel target (untuk himpunan data TPC-DS ada 22 tabel). Ini menghasilkan ForEach untuk melakukan iterasi pada daftar tabel yang dipilih di UI dan memulai 22 utas Aktivitas Salin secara paralel.
- 22
SELECTkueri (satu untuk setiap tabel yang dipilih) dihasilkan dan dijalankan di pool SQL khusus. - Pastikan Anda memiliki DWU dan kelas sumber daya yang sesuai untuk memungkinkan kueri yang dihasilkan dijalankan. Untuk kasus ini, Anda memerlukan minimal DWU1000 dengan
staticrc10untuk memungkinkan maksimal 32 kueri menangani 22 kueri yang dikirimkan. - Menyalin data langsung dari pool SQL khusus ke Fabric Data Warehouse dengan Data Factory memerlukan staging. Proses konsumsi memiliki dua tahap:
- Fase pertama mengekstrak data dari kumpulan SQL khusus ke dalam ADLS. Fase ini disebut tahap penyiapan.
- Fase kedua menginput data bertahap ke dalam Fabric Data Warehouse. Sebagian besar waktu konsumsi dihabiskan pada fase staging, sehingga staging memiliki pengaruh signifikan terhadap performa.
Penggunaan yang disarankan
Dengan menggunakan asisten Copy untuk membuat aktivitas ForEach, Anda mendapatkan antarmuka sederhana untuk mengonversi DDL serta memasukkan tabel yang dipilih dari kumpulan SQL khusus ke Fabric Data Warehouse dalam satu langkah.
Namun, opsi ini tidak memberikan throughput keseluruhan yang optimal. Staging dan kebutuhan untuk menjalankan operasi baca dan tulis secara paralel selama fase source-to-stage merupakan penyebab utama latensi. Gunakan opsi ini hanya untuk tabel dimensi.
Opsi 2. Migrasi DDL/Data - Pipeline menggunakan opsi partisi
Untuk meningkatkan throughput saat Anda memuat tabel fakta yang lebih besar dengan pipeline Fabric, gunakan Copy activity untuk setiap tabel fakta dan aktifkan partisi. Konfigurasi ini memberikan performa Copy activity terbaik.
Gunakan partisi fisik tabel sumber jika tersedia. Jika tabel tidak dipartisi secara fisik, tentukan kolom partisi serta nilai minimum dan maksimum untuk partisi dinamis. Pada tangkapan layar berikut, opsi Sumber pipeline menentukan rentang partisi dinamis berdasarkan ws_sold_date_sk kolom.
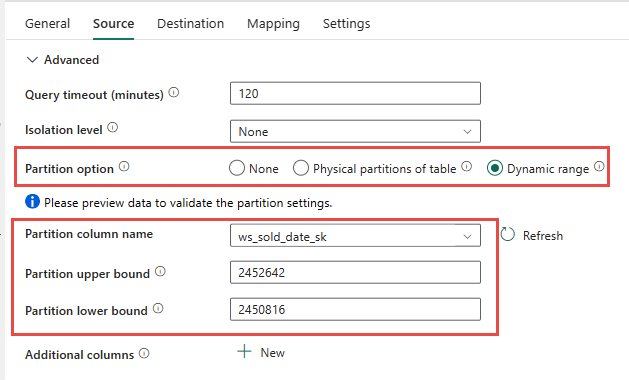
Partisi dapat meningkatkan throughput staging. Pertimbangkan panduan berikut saat Anda mengonfigurasinya:
- Tergantung pada rentang partisi, operasi dapat menghasilkan lebih dari 128 kueri dan menggunakan semua slot konkurensi dalam kumpulan SQL khusus.
- Anda harus meningkatkan skala ke minimal DWU6000 agar semua kueri dapat dieksekusi.
- Sebagai contoh, untuk tabel TPC-DS
web_sales, 163 kueri dikirimkan ke kumpulan SQL khusus. Pada DWU6000, 128 kueri dijalankan sementara 35 kueri berada dalam antrean. - Partisi dinamis secara otomatis menetapkan partisi rentang. Dalam hal ini, rentang 11 hari untuk setiap kueri SELECT yang dikirimkan ke kumpulan SQL khusus. Misalnya:
WHERE [ws_sold_date_sk] > '2451069' AND [ws_sold_date_sk] <= '2451080')
...
WHERE [ws_sold_date_sk] > '2451333' AND [ws_sold_date_sk] <= '2451344')
Penggunaan yang disarankan
Untuk tabel fakta, gunakan Data Factory dengan opsi partisi untuk meningkatkan throughput.
Namun, pembacaan paralel mengharuskan Anda untuk menskalakan pool SQL khusus ke DWU yang lebih tinggi agar dapat menjalankan kueri ekstraksi. Pemartisian meningkatkan kecepatan hingga sepuluh kali lipat dibandingkan dengan tidak menggunakan pemartisian. Anda dapat meningkatkan DWU untuk throughput yang lebih tinggi, tetapi pool SQL khusus mendukung maksimum 128 kueri aktif.
Untuk informasi lebih lanjut tentang pemetaan Synapse DWU ke Fabric, lihat Blog: Memetakan Azure Synapse pool SQL khusus untuk Fabric Data Warehouse komputasi.
Opsi 3. Migrasi DDL - Asisten data salin Aktivitas Salinan Untuk Setiap
Dua opsi sebelumnya cocok untuk basis data yang lebih kecil . Jika Anda membutuhkan throughput yang lebih tinggi, gunakan alternatif berikut:
- Ekstrak data dari pool SQL khusus ke ADLS untuk mengurangi overhead staging.
- Gunakan Data Factory atau perintah COPY untuk menginput data ke gudang Anda.
Penggunaan yang disarankan
Anda dapat terus menggunakan Data Factory untuk mengonversi skema (DDL) Anda. Dengan menggunakan Copy data assistant, Anda dapat memilih tabel tertentu atau Semua tabel. Secara desain, metode ini memigrasikan skema dalam satu langkah, mengekstrak skema tanpa baris dengan menggunakan kondisi palsu, TOP 0 dalam pernyataan query.
Sampel kode berikut mencakup migrasi skema (DDL) dengan Data Factory.
Contoh kode: Migrasi Skema (DDL) dengan Data Factory
Anda dapat menggunakan Fabric Pipelines untuk dengan mudah memigrasikan DDL (skema) objek tabel dari sumber mana pun Azure SQL Database atau pool SQL khusus. Pipeline ini memigrasikan skema (DDL) untuk tabel pool SQL khusus sumber ke Fabric Data Warehouse.
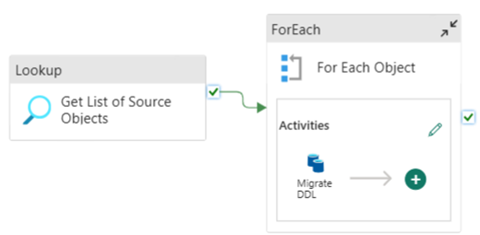
Desain saluran: parameter
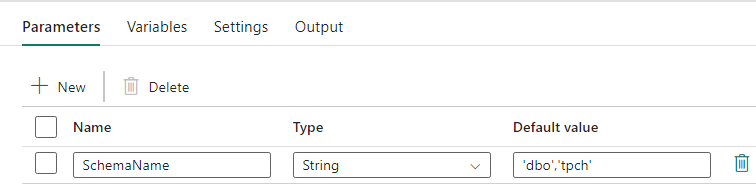
Pipeline ini menerima parameter SchemaName, yang Anda gunakan untuk menentukan skema mana yang akan dimigrasikan. Skema defaultnya adalah dbo.
Di bidang Nilai default, masukkan daftar skema tabel yang dibatasi koma yang menunjukkan skema mana yang akan dimigrasikan: 'dbo','tpch' untuk menyediakan dua skema, dbo dan tpch.
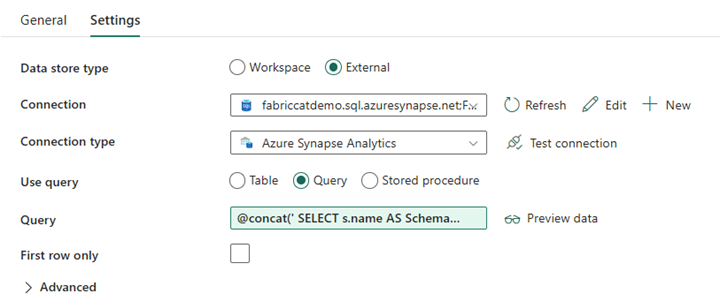
Desain jalur pemrosesan: Aktivitas pencarian data
Buat Aktivitas Pencarian dan atur Koneksi untuk menunjuk ke database sumber Anda.
Di tab Pengaturan:
Atur Jenis penyimpanan data ke Eksternal.
Koneksi adalah kumpulan SQL khusus Azure Synapse Anda. Jenis koneksi adalah Azure Synapse Analytics.
Penggunaan kueri diatur ke Kueri.
Bangun bidang Query menggunakan ekspresi dinamis, sehingga Anda dapat menggunakan parameter
SchemaNametersebut dalam query yang mengembalikan daftar tabel sumber target. Pilih Query lalu pilih Tambah konten dinamis.Ekspresi dalam Aktivitas Pencarian ini menghasilkan pernyataan SQL untuk mengkueri tampilan sistem untuk mengambil daftar skema dan tabel. Parameter ini merujuk
SchemaNameuntuk memungkinkan penyaringan pada skema SQL. Output dari ekspresi ini adalah array skema SQL dan tabel yang digunakan oleh Aktivitas ForEach sebagai input.Gunakan kode berikut untuk mengembalikan daftar semua tabel pengguna dengan nama skema mereka.
@concat('
SELECT s.name AS SchemaName,
t.name  AS TableName
FROM sys.tables AS t
INNER JOIN sys.schemas AS s
ON t.type = ''U''
AND s.schema_id = t.schema_id
AND s.name in (',coalesce(pipeline().parameters.SchemaName, 'dbo'),')
')
Desain alur: ForEach Loop
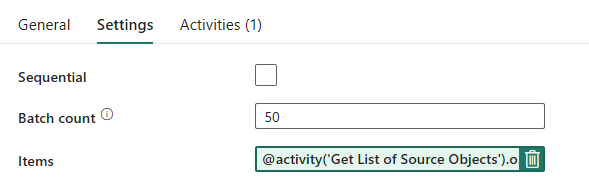
Untuk Loop ForEach, konfigurasikan opsi berikut di tab Pengaturan :
- Nonaktifkan Sequential untuk memungkinkan beberapa iterasi berjalan secara bersamaan.
- Atur Batch count ke
50, membatasi jumlah maksimum iterasi bersamaan. - Gunakan konten dinamis di bidang Item untuk merujuk output dari Aktivitas Pencarian. Gunakan cuplikan kode berikut:
@activity('Get List of Source Objects').output.value
Desain pipa: Aktivitas Salin di dalam Perulangan ForEach
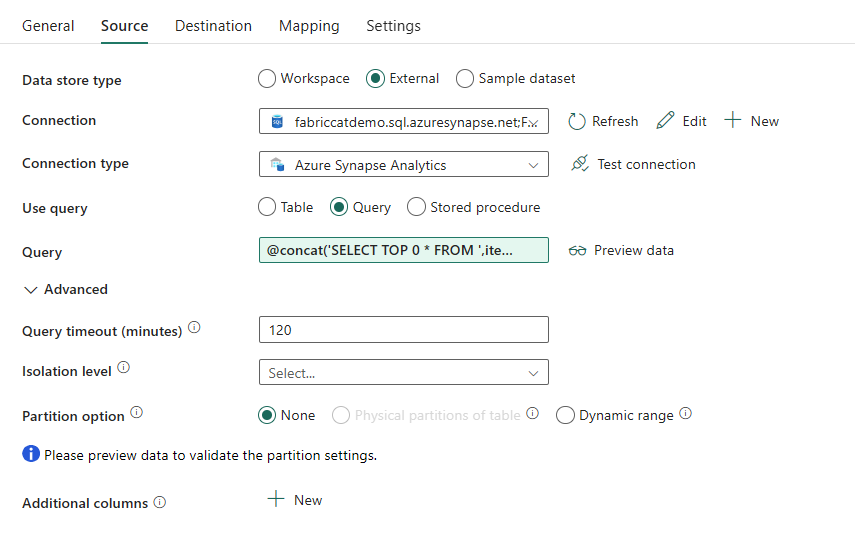
Di dalam Aktivitas ForEach, tambahkan Aktivitas Salin. Metode ini menggunakan Dynamic Expression Language dalam pipeline untuk menyusun pernyataan SELECT TOP 0 * FROM <TABLE> guna memigrasikan hanya skema tanpa data ke gudang data.
Di tab Sumber :
- Atur Jenis penyimpanan data ke Eksternal.
- Koneksi adalah kumpulan SQL khusus Azure Synapse Anda. Jenis koneksi adalah Azure Synapse Analytics.
- Atur Gunakan Kueri ke Kueri.
- Di bidang Query , tempelkan query konten dinamis dan gunakan ekspresi ini yang mengembalikan baris nol, tetapi menyertakan skema tabel:
@concat('SELECT TOP 0 * FROM ',item().SchemaName,'.',item().TableName)
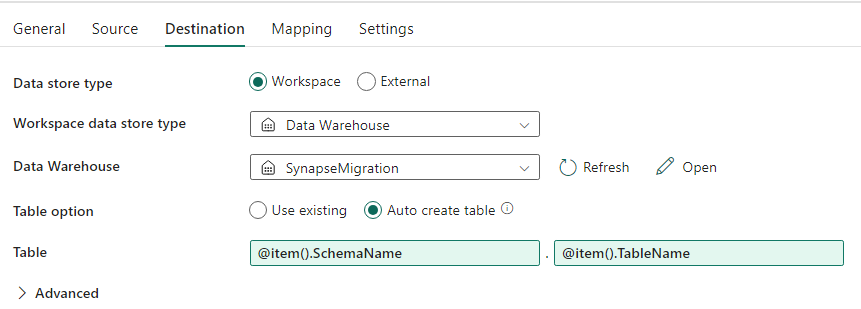
Di tab Tujuan :
- Atur Jenis penyimpanan-data menjadi Ruang Kerja.
- Atur jenis penyimpanan data Workspace ke Data Warehouse dan atur Data Warehouse ke gudang data.
- Skema Tabel tujuan dan nama tabel ditentukan menggunakan konten dinamis.
- Skema merujuk pada bidang iterasi saat ini,
SchemaNamedengan cuplikan:@item().SchemaName - Referensi tabel
TableNamedengan cuplikan:@item().TableName
- Skema merujuk pada bidang iterasi saat ini,
Desain alur: Penampung
Untuk Sink, arahkan ke Gudang Anda dan referensikan Skema Sumber dan nama Tabel.
Saat Anda menjalankan pipeline ini, Anda melihat gudang Anda diisi dengan setiap tabel di sumber Anda, menggunakan skema yang benar.
Migrasi dengan menggunakan prosedur tersimpan di pool SQL khusus Synapse
Opsi ini menggunakan prosedur tersimpan untuk melakukan migrasi ke Fabric Data Warehouse.
Anda bisa mendapatkan sampel kode di microsoft/fabric-migration pada GitHub.com. Kode ini dibagikan sebagai sumber terbuka, jadi jangan ragu untuk berkontribusi berkolaborasi dan membantu komunitas.
Apa yang dapat dilakukan oleh prosedur tersimpan Fabric Migration:
- Konversi skema (DDL) ke sintaks Fabric Data Warehouse.
- Buat skema (DDL) di Fabric Data Warehouse.
- Ekstrak data dari kumpulan SQL khusus Synapse ke ADLS.
- Menandai sintaks Fabric yang tidak didukung untuk kode T-SQL (prosedur tersimpan, fungsi, tampilan).
Penggunaan yang disarankan
Opsi ini sangat cocok untuk Anda jika Anda:
- Terbiasa dengan T-SQL.
- Ingin menggunakan lingkungan pengembangan terintegrasi untuk pengembangan T-SQL.
- Ingin kontrol yang lebih rinci atas tugas yang Anda kerjakan.
Anda dapat menjalankan prosedur tersimpan tertentu untuk konversi skema (DDL), ekstrak data, atau penilaian kode T-SQL.
Untuk migrasi data, gunakan COPY INTO atau Fabric Data Factory untuk menginput data ke gudang Anda.
Bermigrasi menggunakan proyek database SQL
Fabric Data Warehouse mendukung ekstensi SQL Database Projects yang tersedia di dalam Visual Studio Code.
Ekstensi ini tersedia di dalam Visual Studio Code. Fitur ini memungkinkan kemampuan untuk kontrol sumber, pengujian database, dan validasi skema.
Untuk informasi lebih lanjut tentang kontrol sumber, lihat Ikhtisar Pengembangan dan penerapan.
Penggunaan yang disarankan
Gunakan opsi ini jika Anda lebih suka menggunakan SQL Database Project untuk penerapan Anda. Opsi ini mengintegrasikan prosedur tersimpan Fabric Migration ke dalam proyek database SQL untuk memberikan pengalaman migrasi yang mulus.
Proyek SQL Database dapat:
- Konversi skema (DDL) ke sintaks Fabric Data Warehouse.
- Buat skema (DDL) di Fabric Data Warehouse.
- Ekstrak data dari kumpulan SQL khusus Synapse ke ADLS.
- Menandai sintaks yang tidak didukung untuk kode T-SQL (prosedur tersimpan, fungsi, tampilan).
Untuk migrasi data, gunakan COPY INTO atau Data Factory untuk menginput data ke gudang Anda.
Tim Microsoft Fabric CAT menyediakan skrip PowerShell untuk mengekstrak, membuat, dan menyebarkan schema (DDL) serta kode database (DML) melalui proyek database SQL. Untuk panduan, lihat microsoft/fabric-migration di GitHub.
Untuk informasi selengkapnya tentang Proyek SQL Database, lihat Mulai menggunakan ekstensi Proyek SQL Database dan Membangun proyek database dari baris perintah.
Migrasi data dengan CETAS
Perintah T-SQL CREATE EXTERNAL TABLE AS SELECT (CETAS) menyediakan metode yang paling hemat biaya dan optimal untuk mengekstrak data dari pool SQL khusus Azure Synapse ke Azure Data Lake Storage (ADLS) Gen2.
Apa yang dapat dilakukan CETAS:
- Ekstrak data ke ADLS.
- Opsi ini mengharuskan Anda membuat skema (DDL) di gudang sebelum menginput data. Pertimbangkan opsi dalam artikel ini untuk memigrasikan skema (DDL).
Keuntungan dari opsi ini adalah:
- Migrasi hanya mengirimkan satu query per tabel terhadap pool SQL khusus Synapse sumber. Kueri ini tidak menggunakan semua slot konkurensi, dan tidak menghambat ETL produksi pelanggan atau kueri lain yang berjalan secara bersamaan.
- Anda tidak perlu skala ke DWU6000, karena hanya satu slot konkurensi yang digunakan untuk setiap meja, jadi Anda bisa menggunakan DWU yang lebih rendah.
- Ekstrak berjalan paralel di semua node komputasi, dan fitur ini meningkatkan performa.
Penggunaan yang disarankan
Gunakan CETAS untuk mengekstrak data ke ADLS sebagai berkas Parquet. Berkas Parquet menawarkan keunggulan berupa penyimpanan data yang efisien dengan kompresi kolumnar yang memerlukan bandwidth lebih sedikit saat dipindahkan melalui jaringan. Karena Fabric menyimpan data dalam format Delta Parquet, ingesti data 2,5x lebih cepat dibandingkan format file teks, karena tidak ada overhead konversi ke format Delta selama proses ingesti.
Untuk meningkatkan throughput CETAS:
- Tingkatkan operasi CETAS secara paralel, sehingga dapat meningkatkan penggunaan slot konkurensi dan memungkinkan throughput yang lebih tinggi.
- Skalakan DWU pada kumpulan SQL khusus Synapse.
Migrasi melalui dbt
Bagian ini menjelaskan opsi dbt untuk pelanggan yang sudah menggunakan dbt di lingkungan pool SQL khusus Synapse mereka.
Apa yang dapat dilakukan dbt:
- Konversi skema (DDL) ke sintaks Fabric Data Warehouse.
- Buat skema (DDL) di Fabric Data Warehouse.
- Mengonversi kode database (DML) ke sintaks Fabric.
Kerangka kerja dbt menghasilkan DDL dan DML (skrip SQL) dengan cepat dengan setiap eksekusi. Dengan menggunakan file model yang diekspresikan dalam SELECT pernyataan, dbt menerjemahkan DDL/DML secara instan ke platform target mana pun dengan mengubah profil (string koneksi) dan tipe adaptor.
Penggunaan yang disarankan
Kerangka kerja dbt menggunakan pendekatan code-first. Migrasikan data menggunakan opsi yang tercantum dalam dokumen ini, seperti CETAS atau COPY/Data Factory.
Dengan menggunakan adaptor dbt untuk Microsoft Fabric Data Warehouse, Anda dapat memigrasikan proyek dbt yang sudah ada yang menargetkan berbagai platform seperti pool SQL khusus Azure Synapse, Snowflake, Databricks, Google BigQuery, atau Amazon Redshift ke gudang dengan perubahan konfigurasi sederhana.
Untuk memulai proyek dbt yang menargetkan Fabric Data Warehouse, lihat Tutorial: Mengatur dbt untuk Fabric Data Warehouse. Dokumen ini juga mencantumkan opsi untuk berpindah antar gudang dan platform yang berbeda.
Pengambilan data ke dalam Fabric Data Warehouse
Untuk masuk ke Fabric Data Warehouse, gunakan COPY INTO atau Fabric Data Factory, tergantung preferensi Anda. Kedua metode ini adalah opsi yang direkomendasikan dan berkinerja terbaik, karena memiliki throughput kinerja yang setara, dengan syarat file sudah diekstrak ke Azure Data Lake Storage (ADLS) Gen2.
Rancang proses Anda untuk kinerja maksimal dengan mempertimbangkan faktor-faktor berikut:
- Dengan Fabric, tidak ada persaingan sumber daya saat memuat beberapa tabel dari ADLS ke Fabric Data Warehouse secara bersamaan. Akibatnya, tidak ada penurunan kinerja saat menjalankan thread paralel. Throughput penyerapan data maksimum hanya dibatasi oleh daya komputasi kapasitas Fabric Anda.
- Manajemen beban kerja Fabric menyediakan pemisahan sumber daya yang didedikasikan untuk pemrosesan beban dan kueri. Tidak ada perebutan sumber daya saat kueri dan pemuatan data berjalan secara bersamaan.