Catatan
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba masuk atau mengubah direktori.
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba mengubah direktori.
Beralih layanan menggunakan menu tarik-turun Versi. Pelajari selengkapnya tentang navigasi.
Berlaku untuk: ✅ Microsoft Fabric ✅ Azure Data Explorer ✅ Azure Monitor ✅ Microsoft Sentinel
Mengembalikan perkiraan guna jumlah nilai berbeda yang diambil oleh ekspresi skalar di dalam grup ringkasan.
Nilai null diabaikan dan tidak memperhitungkan perhitungan.
Catatan
Fungsi agregasi dcount() terutama berguna untuk memperkirakan kardinalitas set besar. Ini memperdagangkan akurasi untuk performa, dan mungkin mengembalikan hasil yang bervariasi di antara eksekusi. Urutan input mungkin berpengaruh pada outputnya.
Catatan
Fungsi ini digunakan bersama dengan ringkasan operator.
Sintaks
dcount
(
expr[,akurasi])
Pelajari selengkapnya tentang konvensi sintaksis.
Parameter
| Nama | Tipe | Wajib | Deskripsi |
|---|---|---|---|
| expr | string |
✔️ | Input yang nilainya berbeda akan dihitung. |
| ketepatan | int |
Nilai yang menentukan akurasi estimasi yang diminta. Nilai defaultnya adalah 1. Lihat Akurasi estimasi untuk nilai yang didukung. |
Mengembalikan
Mengembalikan perkiraan jumlah nilai kedaluwarsa yang berbeda dalam grup.
Contoh
Contoh berikut menunjukkan berapa banyak jenis peristiwa badai yang terjadi di setiap status.
StormEvents
| summarize DifferentEvents=dcount(EventType) by State
| order by DifferentEvents
Tabel hasil yang ditampilkan hanya menyertakan 10 baris pertama.
| Status | DifferentEvents |
|---|---|
| TEXAS | 27 |
| CALIFORNIA | 26 |
| PENNSYLVANIA | Dua puluh lima |
| GEORGIA | 24 |
| ILLINOIS | Dua puluh tiga |
| MARYLAND | Dua puluh tiga |
| CAROLINA UTARA | Dua puluh tiga |
| MICHIGAN | 22 |
| FLORIDA | 22 |
| OREGON | 21 |
| KANSAS | 21 |
| ... | ... |
Akurasi estimasi
Fungsi ini menggunakan varian dari algoritma HyperLogLog (HLL), yang melakukan estimasi stokastik dari kardinalitas yang ditetapkan. Algoritma ini menyediakan "kenop" yang dapat digunakan untuk menyeimbangkan akurasi dan waktu eksekusi per ukuran memori:
| Akurasi | Kesalahan (%) | Jumlah entri |
|---|---|---|
| 0 | 1.6 | 212 |
| 1 | 0,8 | 214 |
| 2 | 0,4 | 216 |
| 3 | 0.28 | 217 |
| 4 | 0,2 | 218 |
Catatan
Kolom "jumlah entri" adalah jumlah penghitung 1 byte dalam implementasi HLL.
Algoritma ini mencakup beberapa ketentuan untuk melakukan penghitungan sempurna (zero error), jika kardinalitas set berukuran cukup kecil:
- Ketika tingkat akurasi adalah
1, 1000 nilai dikembalikan - Ketika tingkat akurasi adalah
2, 8000 nilai dikembalikan
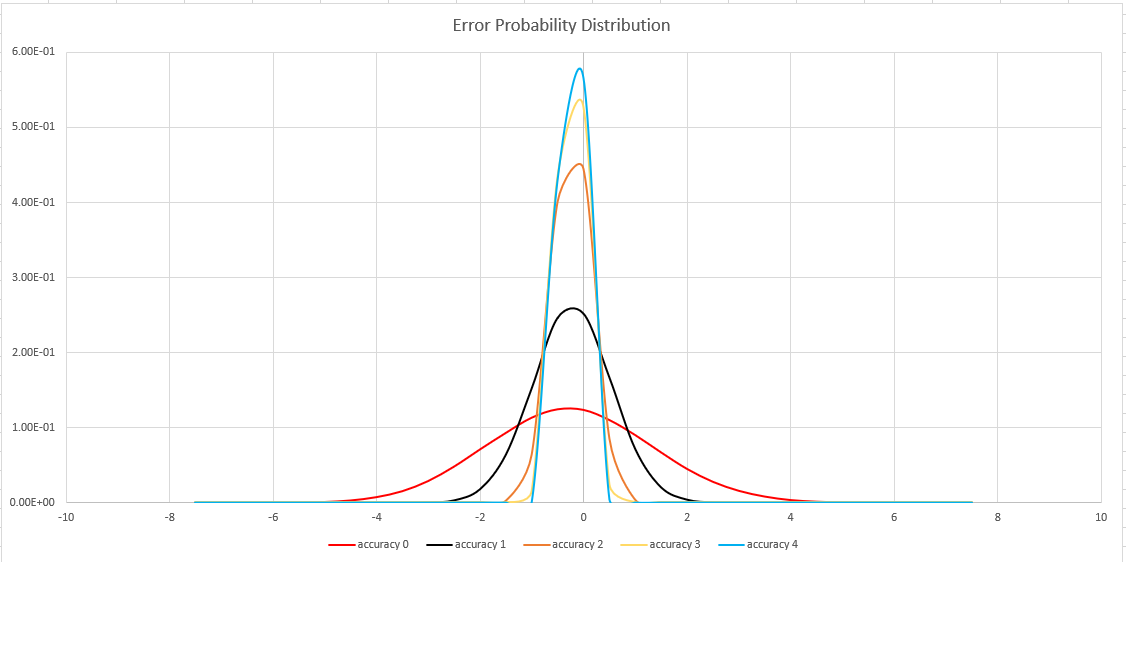
Batas kesalahan bersifat probabilistik, bukan batas teoritis. Nilainya adalah simpangan baku dari distribusi kesalahan (sigma), dan 99,7% estimasi akan memiliki kesalahan relatif di bawah 3 x sigma.
Gambar berikut menunjukkan fungsi distribusi peluang dari kesalahan estimasi relatif, dalam persentase, untuk semua pengaturan akurasi yang didukung:
Konten terkait
- sekilas jenis fungsi Agregasi sekilas
- dcountif() (fungsi agregasi)
- hitungan()
- count_distinct() (fungsi agregasi)