Catatan
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba masuk atau mengubah direktori.
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba mengubah direktori.
Berlaku untuk: SQL ServerAzure SQL DatabaseAzure SQL Managed InstanceDatabase SQL di Microsoft Fabric
Mesin Database SQL Server memproses kueri pada berbagai arsitektur penyimpanan data seperti tabel lokal, tabel yang dipartisi, dan tabel yang didistribusikan di beberapa server. Bagian berikut membahas bagaimana Database Engine memproses kueri dan mengoptimalkan penggunaan ulang kueri melalui caching rencana eksekusi.
Contoh kode dalam artikel ini menggunakan database sampel AdventureWorks2025, AdventureWorksDW2025, atau AdventureWorksLT2025, yang dapat Anda unduh dari repositori GitHub Azure Data SQL Samples Repository.
Mode eksekusi
Mesin Database SQL Server dapat memproses pernyataan Transact-SQL (T-SQL) menggunakan dua mode pemrosesan yang berbeda:
- Eksekusi dalam mode baris
- Eksekusi mode batch
Eksekusi dalam mode baris
Eksekusi mode baris adalah metode pemrosesan kueri yang digunakan dengan tabel dan indeks rowstore, di mana data disimpan dalam format baris. Ketika sebuah kueri dijalankan dan mengakses data di tabel dan indeks rowstore, operator pohon eksekusi dan operator anak membaca setiap baris yang diperlukan, di semua kolom yang ditentukan dalam skema objek. Dari setiap baris yang dibaca, Database Engine kemudian mengambil kolom-kolom yang diperlukan untuk set hasil, sebagaimana direferensikan oleh pernyataan SELECT, predikat JOIN, atau predikat filter.
Catatan
Eksekusi mode baris sangat efisien untuk skenario OLTP, tetapi bisa kurang efisien saat memindai data dalam jumlah besar, misalnya dalam skenario Data Warehousing.
Eksekusi mode batch
Eksekusi mode batch adalah metode pemrosesan kueri yang memproses beberapa baris secara bersamaan (oleh karena itu disebut batch). Setiap kolom dalam batch disimpan sebagai vektor di area memori terpisah, sehingga pemrosesan mode batch berbasis vektor. Pemrosesan mode batch juga menggunakan algoritma yang dioptimalkan untuk set instruksi lanjutan dan peningkatan throughput memori pada prosesor modern.
Eksekusi mode batch awalnya diintegrasikan dan dioptimalkan berdasarkan format penyimpanan columnstore. Mulai dari SQL Server 2019 (15.x) dan di Azure SQL Database, eksekusi mode batch tidak memerlukan indeks columnstore. Untuk informasi selengkapnya, lihat Mode batch di rowstore.
Pemrosesan mode batch beroperasi pada data terkompresi jika memungkinkan, dan menghilangkan exchange operator yang digunakan oleh eksekusi mode baris. Hasilnya adalah paralelisme yang lebih baik dan performa yang lebih cepat.
Ketika sebuah kueri dijalankan dalam mode batch dan mengakses data di indeks columnstore, operator pohon eksekusi dan operator anak membaca beberapa baris bersama-sama dalam segmen kolom. Database Engine hanya membaca kolom yang diperlukan untuk hasil, sebagaimana direferensikan oleh pernyataan SELECT, predikat JOIN, atau predikat filter. Untuk informasi lebih lanjut tentang indeks columnstore, lihat Arsitektur Indeks Columnstore.
Catatan
Eksekusi mode batch sangat efisien untuk skenario pergudangan data yang dapat membaca dan mengagregasi sejumlah besar data.
Pemrosesan pernyataan SQL
Memproses satu pernyataan T-SQL adalah cara paling dasar Database Engine mengeksekusi pernyataan T-SQL. Langkah-langkah berikut mengilustrasikan proses dasar dengan memproses satu pernyataan SELECT yang hanya merujuk pada tabel dasar lokal (tanpa tampilan atau tabel jarak jauh).
Prioritas operator logis
Ketika Anda menggunakan lebih dari satu operator logis dalam sebuah pernyataan, NOT dievaluasi terlebih dahulu, lalu AND, dan akhirnya OR. Operator aritmatika dan bitwise ditangani sebelum operator logika. Untuk informasi lebih lanjut, lihat Prioritas operator.
Dalam contoh berikut, kondisi warna berlaku untuk model produk 21, dan bukan untuk model produk 20, karena AND memiliki prioritas atas OR.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE ProductModelID = 20
      OR ProductModelID = 21
         AND Color = 'Red';
GO
Menggunakan tanda kurung, meskipun tidak diperlukan, dapat meningkatkan keterbacaan kueri dan mengurangi kemungkinan kesalahan karena prioritas operator. Contoh berikut lebih mudah dibaca daripada contoh sebelumnya dan memiliki makna yang sama.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE ProductModelID = 20
      OR (ProductModelID = 21
          AND Color = 'Red');
GO
Anda dapat mengubah arti kueri dengan menambahkan tanda kurung agar OR diperiksa terlebih dahulu. Kueri berikut hanya menemukan produk di bawah model 20 dan 21 yang berwarna merah.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE (ProductModelID = 20
       OR ProductModelID = 21)
      AND Color = 'Red';
GO
Mengoptimalkan pernyataan SELECT
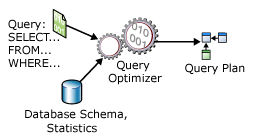
Pernyataan SELECT tidak prosedural; pernyataan tidak menyatakan langkah-langkah tepat yang harus digunakan server database untuk mengambil data yang diminta. Perilaku deklaratif ini berarti server basis data harus menganalisis pernyataan dan basis data untuk menentukan cara paling efisien dalam mengekstrak data yang diminta. Proses ini disebut optimasi rencana kueri. Komponen yang melakukan tugas ini adalah Query Optimizer. Input ke Query Optimizer terdiri dari query, skema basis data (definisi objek), dan statistik objek. Output dari Query Optimizer adalah rencana eksekusi query, kadang disebut sebagai rencana query atau rencana eksekusi. Isi rencana eksekusi dijelaskan lebih rinci dalam penyimpanan cache dan penggunaan ulang rencana eksekusi.
Diagram berikut mengilustrasikan input dan output Query Optimizer selama optimasi satu pernyataan SELECT:
Sebuah SELECT pernyataan hanya mendefinisikan:
- Format kumpulan hasil. Sebagian besarnya ditentukan dalam daftar pilihan. Namun, klausul lain seperti
ORDER BYdanGROUP BYjuga memengaruhi bentuk akhir dari tataan hasil. - Tabel yang berisi data sumber. Ini ditentukan dalam
FROMklausa. - Bagaimana tabel terkait secara logis untuk tujuan
SELECTpernyataan. Ini didefinisikan dalam ekspresi join, yang mungkin muncul dalam klausaWHEREatau dalam klausaONsetelahFROM. - Kondisi yang harus dipenuhi oleh baris dalam tabel sumber untuk memenuhi syarat untuk pernyataan
SELECTtersebut. Ini ditentukan dalam klausaWHEREdanHAVING.
Rencana eksekusi kueri mendefinisikan:
Urutan di mana tabel sumber diakses.
Biasanya, server basis data dapat mengakses tabel dasar dalam banyak urutan untuk membangun set hasil. Misalnya, jika pernyataan mereferensikan
SELECTtiga tabel, server database dapat terlebih dahulu mengaksesTableA, gunakan data dariTableAuntuk mengekstrak baris yang cocok dariTableB, lalu menggunakan data dariTableBuntuk mengekstrak data dariTableC. Urutan lain di mana server database dapat mengakses tabel adalah:TableC, ,TableBTableA, atau
TableB, ,TableATableC, atau
TableB, ,TableCTableA, atau
TableC,TableA,TableBMetode yang digunakan untuk mengekstrak data dari setiap tabel.
Umumnya, ada berbagai metode untuk mengakses data di setiap tabel. Jika hanya beberapa baris dengan nilai kunci tertentu yang diperlukan, server basis data dapat dengan cepat mencari baris atau memindai rentang indeks kecil. Jika semua baris dalam tabel diperlukan, server basis data dapat memindai seluruh tabel atau indeks. Jika semua baris dalam sebuah tabel diperlukan tetapi ada indeks yang kolom kuncinya berada dalam
ORDER BY, melakukan pemindaian indeks alih-alih pemindaian tabel mungkin menghemat pengurutan terpisah pada kumpulan hasil. Jika sebuah tabel sangat kecil, pemindaian penuh mungkin menjadi metode paling efisien untuk hampir semua akses ke tabel tersebut.Metode yang digunakan untuk menghitung perhitungan, dan cara memfilter, mengagregasi, dan mengurutkan data dari setiap tabel.
Saat data diakses dari tabel, berbagai metode melakukan perhitungan pada data seperti menghitung nilai skalar, serta mengagregasi dan mengurutkan data seperti yang didefinisikan dalam teks kueri. Misalnya, saat menggunakan klausa
GROUP BYatauORDER BY, dan cara memfilter data, misalnya saat menggunakan klausaWHEREatauHAVING.
Proses memilih satu rencana eksekusi dari kemungkinan banyak kemungkinan rencana disebut sebagai pengoptimalan. Pengoptimal Kueri adalah salah satu komponen terpenting dari Mesin Database. Meskipun Query Optimizer menggunakan beberapa overhead untuk menganalisis query dan memilih rencana, biaya tambahan ini biasanya terbayar beberapa kali lipat ketika Query Optimizer memilih rencana eksekusi yang efisien. Misalnya, dua perusahaan konstruksi dapat diberikan cetak biru yang identik untuk sebuah rumah. Jika satu perusahaan menghabiskan beberapa hari di awal untuk merencanakan cara membangun rumah, dan perusahaan lain mulai membangun tanpa perencanaan, perusahaan yang meluangkan waktu untuk merencanakan proyeknya kemungkinan besar menyelesaikannya terlebih dahulu.
Query Optimizer adalah optimizer berbasis biaya. Setiap kemungkinan rencana eksekusi memiliki biaya terkait dalam hal jumlah sumber daya komputasi yang digunakan. Pengoptimal Kueri harus menganalisis rencana yang mungkin dan memilih paket dengan perkiraan biaya terendah. Beberapa pernyataan kompleks memiliki ribuan rencana eksekusi yang mungkin. Dalam kasus ini, Pengoptimal Kueri tidak menganalisis semua kemungkinan kombinasi. Sebaliknya, ia menggunakan algoritma kompleks untuk menemukan rencana eksekusi yang memiliki biaya yang cukup dekat dengan biaya minimum yang mungkin.
Query Optimizer tidak selalu memilih rencana eksekusi dengan estimasi biaya terendah. Aplikasi ini menemukan rencana dengan estimasi biaya yang wajar dalam waktu yang tersedia untuk optimasi. Rencana eksekusi paralel mungkin menggunakan lebih banyak sumber daya dibandingkan rencana serial sekaligus mengurangi perkiraan waktu eksekusi.
SQL Server Query Optimizer mengandalkan statistik saat memperkirakan biaya sumber daya dari berbagai metode untuk mengekstrak informasi dari tabel atau indeks. Statistik disimpan untuk kolom dan indeks, serta menyimpan informasi tentang densitas1 dari data yang mendasari. Informasi ini menunjukkan selektivitas nilai dalam indeks atau kolom tertentu. Misalnya, dalam tabel yang mewakili mobil, banyak mobil memiliki produsen yang sama, tetapi setiap mobil memiliki nomor identifikasi kendaraan (VIN) yang unik. Indeks pada VIN lebih selektif daripada indeks pada produsen, karena VIN memiliki kepadatan yang lebih rendah daripada produsen. Jika statistik indeks tidak terkini, Pengoptimal Kueri mungkin tidak membuat pilihan terbaik untuk status tabel saat ini. Untuk informasi selengkapnya tentang kepadatan, lihat Statistik.
1 Kepadatan mendefinisikan distribusi nilai unik yang ada dalam data, atau jumlah rata-rata nilai duplikat untuk kolom tertentu. Saat kepadatan menurun, selektivitas nilai meningkat.
Query Optimizer penting karena memungkinkan server basis data menyesuaikan secara dinamis dengan kondisi yang berubah di basis data tanpa memerlukan input dari pengembang atau administrator basis data. Fitur ini memungkinkan pengembang untuk fokus mendeskripsikan hasil akhir dari kueri. Mereka dapat mempercayai Query Optimizer untuk membangun rencana eksekusi yang efisien untuk kondisi database setiap kali rencana query untuk pernyataan dioptimalkan.
Catatan
SQL Server Management Studio memiliki tiga opsi untuk menampilkan rencana eksekusi:
- Rencana Eksekusi Perkiraan, yaitu rencana yang dikompilasi, sebagaimana dihasilkan oleh Query Optimizer.
- Rencana Eksekusi Aktual, yang sama dengan rencana kompilasi ditambah konteks eksekusinya. Konteks ini mencakup informasi runtime yang tersedia setelah eksekusi selesai, seperti peringatan eksekusi, atau pada versi terbaru Database Engine, waktu yang telah berlalu dan CPU yang digunakan selama eksekusi.
- Statistik Kueri Langsung, yang sama dengan rencana kompilasi beserta konteks eksekusinya. Konteks ini mencakup informasi runtime selama proses eksekusi, dan diperbarui setiap detik. Informasi runtime mencakup, misalnya, jumlah baris yang sebenarnya mengalir melalui operator.
Memproses pernyataan SELECT
Database Engine memproses satu SELECT pernyataan dengan mengikuti langkah-langkah berikut:
- Pengurai memindai
SELECTpernyataan dan memecahnya menjadi unit logis seperti kata kunci, ekspresi, operator, dan pengidentifikasi. - Tree kueri, kadang disebut sequence tree, dibangun untuk menjelaskan langkah-langkah logis yang diperlukan untuk mengubah data sumber ke format yang dibutuhkan oleh set hasil.
- Query Optimizer menganalisis berbagai cara untuk mengakses tabel sumber. Aplikasi ini memilih rangkaian langkah yang mengembalikan hasil dengan kecepatan tercepat dengan menggunakan sumber daya yang lebih sedikit. Memperbarui pohon kueri untuk merekam rangkaian langkah yang sama persis. Versi akhir yang dioptimalkan dari pohon kueri disebut rencana eksekusi.
- Mesin relasional mulai menjalankan rencana. Saat memproses langkah-langkah yang membutuhkan data dari tabel dasar, ia meminta rowset yang diperlukan dari mesin penyimpanan.
- Mesin relasional memproses data yang dikembalikan dari mesin penyimpanan ke dalam format yang ditentukan untuk set hasil dan mengembalikan set hasil ke klien.
Lipatan konstanta dan evaluasi ekspresi
Mesin Database mengevaluasi beberapa ekspresi konstanta lebih awal untuk meningkatkan performa kueri. Teknik optimasi yang digunakan oleh Query Optimizer ini bertujuan untuk menyederhanakan ekspresi saat kompilasi daripada saat runtime. Ini melibatkan evaluasi ekspresi konstan selama kompilasi kueri sehingga rencana eksekusi yang dihasilkan lebih efisien. Proses ini disebut sebagai constant folding. Konstanta adalah literal T-SQL, seperti 3, 'ABC', '2025-12-31', 1.0e3, atau 0x12345678. Misalnya, ambil kueri ini:
SELECT *
FROM Orders
WHERE OrderDate < DATEADD(day, 30 * 12, '2025-01-01');
Di sini, 30 * 12 adalah ekspresi yang konstan. Database Engine mengevaluasi ekspresi ini selama kompilasi, dan dapat menulis ulang kueri secara internal sebagai:
SELECT *
FROM Orders
WHERE OrderDate < DATEADD(day, 360, '2025-01-01');
Ekspresi yang dapat dilipat
Database Engine menggunakan pelipatan konstan dengan jenis ekspresi berikut:
- Ekspresi aritmatika, seperti
1 + 1dan5 / 3 * 2, yang hanya berisi konstanta. - Ekspresi logis, seperti
1 = 1dan1 > 2 AND 3 > 4, yang hanya berisi konstanta. - Fungsi bawaan yang dianggap dapat di-fold oleh Database Engine, termasuk
CASTdanCONVERT. Secara umum, fungsi intrinsik dapat dievaluasi saat kompilasi jika hanya bergantung pada inputnya dan bukan pada informasi kontekstual lain, sepertiSETopsi, pengaturan bahasa, opsi basis data, dan kunci enkripsi. Fungsi nondeterministik tidak dapat dilipat. Fungsi bawaan deterministik dapat dilipat, dengan beberapa pengecualian. - Metode deterministik dari tipe pengguna CLR dan fungsi CLR bernilai skalar deterministik yang didefinisikan pengguna. Untuk informasi selengkapnya, lihat Lipatan Konstan untuk Fungsi dan Metode yang Ditentukan Pengguna CLR.
Catatan
Pengecualian dibuat untuk jenis objek besar. Jika tipe output dari proses pelipatan adalah tipe objek besar (text, ntext, image, nvarchar(max), varchar(max), varbinary(max), json, atau xml), Database Engine tidak melipat ekspresi tersebut.
Ekspresi yang tidak dapat dilipat
Semua jenis ekspresi lainnya tidak dapat dilipat. Secara khusus, jenis ekspresi berikut tidak dapat dilipat:
- Ekspresi nonkonstant seperti ekspresi yang hasilnya bergantung pada nilai kolom.
- Ekspresi yang hasilnya bergantung pada variabel atau parameter lokal, seperti
@x. - Fungsi nondeterministik.
- Fungsi T-SQL yang didefinisikan pengguna.
- Ekspresi yang hasilnya bergantung pada pengaturan bahasa.
- Ekspresi yang hasilnya bergantung pada
SETopsi. - Ekspresi yang hasilnya bergantung pada opsi konfigurasi server.
Contoh ekspresi konstanta yang dapat dilipat dan tidak dapat dilipat
Pertimbangkan kueri berikut:
Catatan
Di Azure SQL Database dan SQL database di Microsoft Fabric, pernyataan USE tersebut tidak tersedia. Sebaliknya, hubungkan langsung ke database yang dimaksud dan jalankan sisa kode sampel.
USE AdventureWorks2025;
GO

SELECT *
FROM Sales.SalesOrderHeader AS s
     INNER JOIN Sales.SalesOrderDetail AS d
         ON s.SalesOrderID = d.SalesOrderID
WHERE TotalDue > 117.00 + 1000.00;
Jika PARAMETERIZATION opsi database tidak diatur ke FORCED untuk kueri ini, ekspresi 117.00 + 1000.00 tersebut dievaluasi dan diganti dengan hasilnya, 1117.00, sebelum kueri dikompilasi. Manfaat dari constant folding ini meliputi:
- Ekspresi tidak harus dievaluasi berulang kali pada waktu eksekusi.
- Nilai ekspresi setelah dievaluasi digunakan oleh Query Optimizer untuk memperkirakan ukuran kumpulan hasil dari bagian kueri
TotalDue > 117.00 + 1000.00.
Di sisi lain, jika dbo.f adalah fungsi skalar yang didefinisikan pengguna, ekspresi dbo.f(100) tersebut tidak dilipat, karena Database Engine tidak melipat ekspresi yang melibatkan fungsi yang ditentukan pengguna, meskipun bersifat deterministik. Untuk informasi lebih lanjut tentang parameterisasi, lihat Parameterisasi paksa.
Evaluasi Ekspresi
Selain itu, beberapa ekspresi yang tidak dapat dilipat menjadi konstanta tetapi argumennya diketahui pada saat kompilasi, baik argumennya adalah parameter atau konstanta, dievaluasi oleh estimator ukuran hasil (kardinalitas) yang merupakan bagian dari pengoptimal selama proses pengoptimalan.
Secara khusus, fungsi bawaan dan operator khusus berikut dievaluasi pada waktu kompilasi jika semua input mereka diketahui: UPPER, , LOWER, RTRIMDATEPART( YY only ), , GETDATE, CAST, dan CONVERT. Operator berikut juga dievaluasi pada waktu kompilasi jika semua input mereka diketahui:
- Operator aritmetika:
+,-,*,/, unary- - Operator logis:
AND,OR,NOT - Operator perbandingan:
<,>,<=,>=,<>,LIKE,IS NULL,IS NOT NULL
Tidak ada fungsi atau operator lain yang dievaluasi oleh Pengoptimal Kueri selama estimasi kardinalitas.
Contoh evaluasi ekspresi waktu kompilasi
Pertimbangkan prosedur tersimpan ini:
USE AdventureWorks2025;
GO

CREATE PROCEDURE MyProc
(
    @d DATETIME
)
AS
SELECT COUNT(*)
FROM Sales.SalesOrderHeader
WHERE OrderDate > @d + 1;
Selama pengoptimalan SELECT pernyataan dalam prosedur, Pengoptimal Kueri mencoba mengevaluasi kardinalitas yang diharapkan dari hasil yang ditetapkan untuk kondisi OrderDate > @d + 1. Ekspresi @d + 1 tidak dilipat secara konstan, karena @d merupakan parameter. Namun, pada waktu pengoptimalan, nilai parameter diketahui. Nilai ini memungkinkan Query Optimizer memperkirakan ukuran kumpulan hasil secara akurat, yang membantunya memilih rencana kueri yang baik.
Sekarang pertimbangkan contoh yang mirip dengan yang sebelumnya, kecuali bahwa variabel @d2 lokal menggantikan @d + 1 dalam kueri dan ekspresi dievaluasi dalam SET pernyataan alih-alih dalam kueri.
USE AdventureWorks2025;
GO

CREATE PROCEDURE MyProc2
(
    @d DATETIME
)
AS
BEGIN
    DECLARE @d2 AS DATETIME;
    SET @d2 = @d + 1;
    SELECT COUNT(*)
    FROM Sales.SalesOrderHeader
    WHERE OrderDate > @d2;
END
Ketika pernyataan SELECT dalam MyProc2 dioptimalkan di Database Engine, nilai dari @d2 tidak diketahui. Oleh karena itu, Query Optimizer menggunakan estimasi default untuk selektivitas OrderDate > @d2 (dalam hal ini 30 persen).
Memproses pernyataan lain
Langkah dasar untuk memproses pernyataan SELECT berlaku untuk pernyataan T-SQL lain seperti INSERT, UPDATE, dan DELETE. Baik pernyataan UPDATE maupun DELETE harus menargetkan kumpulan baris yang akan diubah atau dihapus. Proses mengidentifikasi baris ini adalah proses yang sama yang digunakan untuk mengidentifikasi baris sumber yang berkontribusi pada kumpulan SELECT hasil pernyataan. Baik INSERT maupun UPDATE pernyataan mungkin berisi pernyataan SELECT tertanam yang menyediakan nilai data untuk diperbarui atau disisipkan.
Bahkan pernyataan Data Definition Language (DDL), seperti CREATE PROCEDURE atau ALTER TABLE, bermuara pada serangkaian operasi relasional pada tabel katalog sistem dan terkadang (seperti ALTER TABLE ADD COLUMN) terhadap tabel data.
Meja Kerja
Mesin relasional mungkin perlu membangun worktable untuk melakukan operasi logis yang ditentukan dalam pernyataan T-SQL. Worktable adalah tabel internal yang berisi hasil menengah. Worktables dihasilkan untuk kueri tertentu GROUP BY, ORDER BY, atau UNION. Misalnya, jika sebuah ORDER BY klausa merujuk pada kolom yang tidak tercakup oleh indeks manapun, mesin relasional mungkin perlu menghasilkan worktable untuk mengurutkan hasil ke dalam urutan yang diminta. Meja kerja juga dapat digunakan sebagai gulungan yang menahan sementara hasil eksekusi bagian dari rencana kueri. Worktable dibuat di tempdb, lalu otomatis dihapus saat tidak lagi dibutuhkan.
Lihat resolusi
Prosesor kueri Database Engine memperlakukan tampilan terindeks dan tidak terindeks secara berbeda:
- Database menyimpan baris dari tampilan terindeks dalam format yang sama seperti tabel. Jika Query Optimizer memutuskan untuk menggunakan tampilan terindeks dalam rencana kueri, maka ia memperlakukan tampilan terindeks sama seperti tabel dasar.
- Hanya definisi tampilan yang tidak terindeks yang disimpan, bukan baris tampilan. Query Optimizer menggabungkan logika dari definisi tampilan ke dalam rencana eksekusi yang dibuat untuk pernyataan T-SQL yang merujuk pada tampilan non-indeks.
Logika yang digunakan Query Optimizer untuk memutuskan kapan menggunakan tampilan terindeks mirip dengan logika yang digunakan untuk menentukan kapan menggunakan indeks pada sebuah tabel. Jika data dalam tampilan terindeks memenuhi seluruh atau sebagian kebutuhan pernyataan T-SQL, dan Query Optimizer menentukan bahwa indeks pada tampilan adalah jalur akses berbiaya rendah, maka ia memilih indeks tersebut terlepas dari apakah kueri merujuk pada tampilan tersebut berdasarkan nama.
Ketika pernyataan T-SQL merujuk pada tampilan yang tidak terindeks, parser dan Query Optimizer menganalisis sumber dari pernyataan T-SQL dan tampilan tersebut lalu menggabungkannya menjadi satu rencana eksekusi. Pernyataan T-SQL dan view tidak memiliki rencana terpisah.
Misalnya, pertimbangkan tampilan berikut:
USE AdventureWorks2025;
GO

CREATE VIEW EmployeeName AS
    SELECT h.BusinessEntityID,
           p.LastName,
           p.FirstName
    FROM HumanResources.Employee AS h
         INNER JOIN Person.Person AS p
             ON h.BusinessEntityID = p.BusinessEntityID;
GO
Berdasarkan pandangan ini, kedua pernyataan T-SQL ini melakukan operasi yang sama pada tabel dasar dan menghasilkan hasil yang sama:
USE AdventureWorks2025;
GO

/* SELECT referencing the EmployeeName view. */
SELECT LastName AS EmployeeLastName,
       SalesOrderID,
       OrderDate
FROM Sales.SalesOrderHeader AS soh
     INNER JOIN dbo.EmployeeName AS EmpN
         ON (soh.SalesPersonID = EmpN.BusinessEntityID)
WHERE OrderDate > '20230531';

/* SELECT referencing the Person and Employee tables directly. */
SELECT LastName AS EmployeeLastName,
       SalesOrderID,
       OrderDate
FROM HumanResources.Employee AS e
     INNER JOIN Sales.SalesOrderHeader AS soh
         ON soh.SalesPersonID = e.BusinessEntityID
     INNER JOIN Person.Person AS p
         ON e.BusinessEntityID = p.BusinessEntityID
WHERE OrderDate > '20230531';
Fitur Showplan SQL Server Management Studio (SSMS) menunjukkan bahwa mesin relasional membangun rencana eksekusi yang sama untuk kedua pernyataan SELECT ini.
Menggunakan petunjuk pada tampilan
Jika Anda menempatkan petunjuk pada tampilan dalam sebuah kueri, petunjuk tersebut mungkin bertentangan dengan petunjuk lain yang ditemukan saat tampilan diperluas untuk mengakses tabel dasarnya. Ketika konflik ini terjadi, kueri mengembalikan kesalahan. Misalnya, pertimbangkan tampilan berikut yang berisi petunjuk tabel dalam definisinya:
USE AdventureWorks2025;
GO

CREATE VIEW Person.AddrState
WITH SCHEMABINDING AS
    SELECT a.AddressID,
           a.AddressLine1,
           s.StateProvinceCode,
           s.CountryRegionCode
    FROM Person.Address AS a WITH (NOLOCK), Person.StateProvince AS s
    WHERE a.StateProvinceID = s.StateProvinceID;
Sekarang misalkan Anda memasukkan kueri ini:
SELECT AddressID,
       AddressLine1,
       StateProvinceCode,
       CountryRegionCode
FROM Person.AddrState WITH (SERIALIZABLE)
WHERE StateProvinceCode = 'WA';
Kueri gagal, karena hint SERIALIZABLE pada tampilan Person.AddrState akan menyebar ke tabel Person.Address dan Person.StateProvince di tampilan saat diperluas. Namun, memperluas tampilan juga mengungkapkan NOLOCK petunjuk tentang Person.Address. Karena petunjuk SERIALIZABLE dan NOLOCK bertentangan, mengakibatkan kueri yang salah.
Petunjuk tabel TABLOCK, TABLOCKX, HOLDLOCK, NOLOCK, dan READCOMMITTED saling bertentangan, begitu pula petunjuk tabel REPEATABLEREAD, SERIALIZABLE, ROWLOCK, NOLOCK, dan PAGLOCK.
Petunjuk dapat menyebar melalui tingkat tampilan berlapis. Misalnya, kueri menerapkan HOLDLOCK petunjuk pada tampilan v1. Ketika v1 dibentangkan, Anda akan menemukan bahwa tampilan v2 adalah bagian dari definisinya.
v2Definisi tersebut terdapat NOLOCK petunjuk pada salah satu tabel dasarnya. Tetapi tabel ini juga mewarisi HOLDLOCK petunjuk dari kueri pada tampilan v1. Karena petunjuk NOLOCK dan HOLDLOCK bertentangan, kueri gagal.
Ketika Anda menggunakan petunjuk FORCE ORDER dalam kueri yang berisi view, posisi view dalam konstruksi terurut menentukan urutan join tabel dalam view. Misalnya, kueri berikut memilih dari tiga tabel dan tampilan:
SELECT * FROM Table1, Table2, View1, Table3
WHERE Table1.Col1 = Table2.Col1
    AND Table2.Col1 = View1.Col1
    AND View1.Col2 = Table3.Col2;
OPTION (FORCE ORDER);
Dan View1 didefinisikan seperti yang ditunjukkan dalam contoh berikut:
CREATE VIEW View1 AS
    SELECT Colx,
           Coly
    FROM TableA, TableB
    WHERE TableA.ColZ = TableB.Colz;
Urutan gabungan dalam rencana kueri adalah Table1, , Table2, TableATableB, Table3.
Mengatasi indeks pada tampilan
Seperti halnya indeks lainnya, Database Engine memilih untuk menggunakan tampilan terindeks dalam rencana kuerinya hanya jika Query Optimizer menentukan bahwa hal tersebut bermanfaat untuk dilakukan.
Anda dapat membuat tampilan terindeks di edisi mana pun dari Database Engine. Di beberapa edisi, Query Optimizer secara otomatis mempertimbangkan tampilan terindeks, sementara di edisi lain Anda perlu menggunakan petunjuk tabel NOEXPAND. Penggunaan otomatis tampilan terindeks oleh Query Optimizer hanya didukung pada edisi tertentu dari SQL Server.
Catatan
Azure SQL Database dan Azure SQL Managed Instance mendukung penggunaan otomatis tampilan terindeks tanpa menentukan petunjuk NOEXPAND.
Query Optimizer menggunakan tampilan terindeks ketika kondisi berikut terpenuhi:
- Opsi sesi ini diatur ke
ON:ANSI_NULLSANSI_PADDINGANSI_WARNINGSARITHABORTCONCAT_NULL_YIELDS_NULLQUOTED_IDENTIFIER
- Opsi
NUMERIC_ROUNDABORTsesi diatur keOFF. - Query Optimizer menemukan kecocokan antara kolom indeks tampilan dan elemen dalam kueri, seperti:
- Predikat kondisi pencarian dalam
WHEREklausa - Gabungkan operasi
- Fungsi agregat
-
GROUP BYKlausul - Referensi tabel
- Predikat kondisi pencarian dalam
- Perkiraan biaya untuk menggunakan indeks memiliki biaya terendah dari mekanisme akses apa pun yang dipertimbangkan oleh Pengoptimal Kueri.
- Setiap tabel yang direferensikan dalam kueri (baik secara langsung, atau dengan memperluas tampilan untuk mengakses tabel yang mendasar) yang sesuai dengan referensi tabel dalam tampilan terindeks harus memiliki kumpulan petunjuk yang sama yang diterapkan di dalam kueri.
Catatan
Petunjuk READCOMMITTED dan READCOMMITTEDLOCK selalu dianggap sebagai petunjuk yang berbeda dalam konteks ini, terlepas dari tingkat isolasi transaksi saat ini.
Selain persyaratan untuk SET opsi dan petunjuk tabel, ini adalah aturan yang sama dengan yang digunakan Pengoptimal Kueri untuk menentukan apakah indeks tabel mencakup kueri. Anda tidak perlu menentukan apa pun dalam kueri agar tampilan terindeks dapat digunakan.
Kueri tidak harus secara eksplisit mereferensikan tampilan terindeks dalam FROM klausa untuk Pengoptimal Kueri untuk menggunakan tampilan terindeks. Jika kueri berisi referensi ke kolom dalam tabel dasar yang juga ada dalam tampilan terindeks, dan Pengoptimal Kueri memperkirakan bahwa menggunakan tampilan terindeks menyediakan mekanisme akses biaya terendah, Pengoptimal Kueri memilih tampilan terindeks, mirip dengan cara memilih indeks tabel dasar saat tidak direferensikan secara langsung dalam kueri. Pengoptimal Kueri bisa memilih tampilan saat berisi kolom yang tidak dirujuk oleh kueri, selama tampilan menawarkan opsi biaya terendah untuk mencakup satu atau beberapa kolom yang ditentukan dalam kueri.
Pengoptimal Kueri memperlakukan tampilan terindeks yang direferensikan dalam FROM klausa sebagai tampilan standar. Pengoptimal Kueri memperluas definisi tampilan ke dalam kueri di awal proses pengoptimalan. Kemudian, pencocokan tampilan terindeks dilakukan. Tampilan terindeks dapat digunakan dalam rencana eksekusi akhir yang dipilih oleh Pengoptimal Kueri, atau sebagai gantinya, paket mungkin mewujudkan data yang diperlukan dari tampilan dengan mengakses tabel dasar yang direferensikan oleh tampilan. Pengoptimal Kueri memilih alternatif dengan biaya terendah.
Menggunakan petunjuk dengan tampilan terindeks
Anda bisa mencegah indeks tampilan digunakan untuk kueri dengan menggunakan EXPAND VIEWS petunjuk kueri, atau Anda bisa menggunakan NOEXPAND petunjuk tabel untuk memaksa penggunaan indeks untuk tampilan terindeks yang ditentukan dalam FROM klausul kueri. Namun, Anda harus membiarkan Pengoptimal Kueri secara dinamis menentukan metode akses terbaik untuk digunakan untuk setiap kueri. Batasi penggunaan EXPAND Anda dan NOEXPAND untuk kasus tertentu di mana pengujian telah menunjukkan bahwa pengujian tersebut meningkatkan performa secara signifikan.
Opsi
EXPAND VIEWSmenentukan bahwa Pengoptimal Kueri tidak menggunakan indeks tampilan apa pun untuk seluruh kueri.Saat Anda menentukan
NOEXPANDuntuk sebuah tampilan, Query Optimizer mempertimbangkan penggunaan indeks apa pun yang didefinisikan pada tampilan tersebut.NOEXPANDyang ditentukan dengan klausul opsionalINDEX()memaksa Pengoptimal Kueri untuk menggunakan indeks yang telah ditentukan. Anda hanya dapat menentukanNOEXPANDuntuk tampilan terindeks dan tidak dapat menentukannya untuk tampilan yang tidak terindeks. Penggunaan otomatis tampilan terindeks oleh Query Optimizer hanya didukung pada edisi tertentu dari SQL Server.Catatan
Azure SQL Database dan Azure SQL Managed Instance mendukung penggunaan otomatis tampilan terindeks tanpa menentukan petunjuk
NOEXPAND.
Ketika baik NOEXPAND maupun EXPAND VIEWS tidak ditentukan dalam kueri yang berisi tampilan, tampilan diperluas untuk mengakses tabel dasar. Jika kueri yang membentuk tampilan berisi petunjuk tabel apa pun, petunjuk ini disebarkan ke tabel yang mendasar. (Proses ini dijelaskan lebih rinci dalam View resolution.) Selama kumpulan petunjuk yang ada pada tabel dasar view identik satu sama lain, query tersebut memenuhi syarat untuk dicocokkan dengan tampilan terindeks. Sering kali, hint ini konsisten satu sama lain, karena diwarisi langsung dari view. Namun, jika kueri mereferensikan tabel alih-alih tampilan, dan petunjuk yang diterapkan langsung pada tabel ini tidak identik, kueri seperti itu tidak memenuhi syarat untuk pencocokan dengan tampilan terindeks.
INDEXJika petunjuk , , PAGLOCKROWLOCK, TABLOCKXUPDLOCK, , atau XLOCK berlaku untuk tabel yang direferensikan dalam kueri setelah ekspansi tampilan, kueri tidak memenuhi syarat untuk pencocokan tampilan terindeks.
Jika petunjuk tabel berupa INDEX ( index_val [ ,...n] ) mereferensikan tampilan dalam kueri dan Anda tidak menentukan petunjuk NOEXPAND, maka petunjuk indeks akan diabaikan. Untuk menentukan penggunaan indeks tertentu, gunakan NOEXPAND.
Secara umum, ketika Query Optimizer mencocokkan tampilan terindeks dengan kueri, ia menerapkan petunjuk yang ditentukan pada tabel atau tampilan dalam kueri langsung ke tampilan terindeks. Jika Query Optimizer memilih untuk tidak menggunakan tampilan terindeks, ia akan menyebarkan petunjuk langsung ke tabel yang direferensikan dalam tampilan tersebut. Untuk informasi lebih lanjut, lihat Resolusi tampilan. Penyebaran ini tidak berlaku untuk petunjuk penggabungan. Mereka hanya diterapkan pada posisi asli mereka dalam kueri. Query Optimizer tidak mempertimbangkan join hint saat mencocokkan query dengan tampilan terindeks. Jika rencana kueri menggunakan tampilan terindeks yang cocok dengan bagian kueri yang berisi petunjuk gabungan, petunjuk gabungan tidak digunakan dalam rencana tersebut.
Petunjuk tidak diperbolehkan dalam definisi tampilan terindeks. Database Engine mengabaikan petunjuk di dalam definisi tampilan terindeks saat mengelolanya, atau saat menjalankan kueri yang menggunakan tampilan terindeks.
Untuk informasi selengkapnya, lihat Petunjuk Tabel.
Mengatasi tampilan terpartisi terdistribusi
Prosesor query Database Engine mengoptimalkan kinerja tampilan terdistribusi yang dipartisi. Aspek terpenting dari performa tampilan terpartisi terdistribusi adalah meminimalkan jumlah data yang ditransfer antar server anggota.
Database Engine membangun rencana yang cerdas dan dinamis yang memanfaatkan kueri terdistribusi secara efisien untuk mengakses data dari tabel anggota jarak jauh:
- Prosesor Kueri terlebih dahulu menggunakan OLE DB untuk mengambil definisi batasan pemeriksaan dari setiap tabel anggota. Metode ini memungkinkan prosesor kueri untuk memetakan distribusi nilai kunci di antara tabel anggota.
- Query Processor membandingkan rentang kunci yang ditentukan dalam klausa
WHEREdalam pernyataan T-SQL dengan peta yang menunjukkan bagaimana baris didistribusikan dalam tabel anggota. Prosesor kueri kemudian membangun rencana eksekusi kueri yang menggunakan kueri terdistribusi untuk mengambil hanya baris jarak jauh yang diperlukan untuk menyelesaikan pernyataan T-SQL. Rencana eksekusi juga dibangun sedemikian rupa sehingga akses ke tabel anggota jarak jauh, baik untuk data maupun metadata, tertunda sampai informasi tersebut diperlukan.
Misalnya, pertimbangkan sistem di mana Customers tabel dipartisi di seluruh Server1 (CustomerID dari 1 hingga 3299999), Server2 (CustomerID dari 3300000 sampai 6599999), dan Server3 (CustomerID dari 6600000 sampai 9999999).
Pertimbangkan rencana eksekusi yang dibuat untuk kueri ini yang dijalankan di Server1:
SELECT *
FROM CompanyData.dbo.Customers
WHERE CustomerID BETWEEN 3200000 AND 3400000;
Rencana eksekusi untuk kueri ini mengekstrak baris dengan CustomerID nilai kunci dari 3200000 hingga 3299999 dari tabel anggota lokal, dan mengeluarkan kueri terdistribusi untuk mengambil baris dengan nilai kunci dari 33000000 hingga 3400000 dari Server2.
Database Engine Query Processor juga dapat membangun logika dinamis ke dalam rencana eksekusi kueri untuk pernyataan T-SQL di mana nilai kunci tidak diketahui saat rencana harus dibangun. Misalnya, pertimbangkan prosedur tersimpan ini:
CREATE PROCEDURE GetCustomer
(
    @CustomerIDParameter INT
)
AS
SELECT *
FROM CompanyData.dbo.Customers
WHERE CustomerID = @CustomerIDParameter;
Database Engine tidak dapat memprediksi nilai kunci apa yang diberikan oleh parameter @CustomerIDParameter setiap kali prosedur dijalankan. Karena nilai kunci tidak dapat diprediksi, prosesor kueri juga tidak dapat memprediksi tabel anggota mana yang harus diaksesnya. Untuk menangani kasus ini, Database Engine membangun rencana eksekusi yang memiliki logika kondisional, disebut filter dinamis, untuk mengontrol tabel anggota mana yang diakses, berdasarkan nilai parameter input. Dengan asumsi GetCustomer prosedur tersimpan dijalankan di Server1, logika rencana eksekusi dapat direpresentasikan seperti yang ditunjukkan pada output berikut:
IF @CustomerIDParameter BETWEEN 1 and 3299999
   Retrieve row from local table CustomerData.dbo.Customer_33
ELSE IF @CustomerIDParameter BETWEEN 3300000 and 6599999
   Retrieve row from linked table Server2.CustomerData.dbo.Customer_66
ELSE IF @CustomerIDParameter BETWEEN 6600000 and 9999999
   Retrieve row from linked table Server3.CustomerData.dbo.Customer_99
Database Engine kadang-kadang membangun rencana eksekusi dinamis seperti ini bahkan untuk kueri yang tidak diparameterkan. Pengoptimal Kueri dapat membuat parameter kueri sehingga rencana eksekusi dapat digunakan kembali. Jika Query Optimizer mengparameterisasi query yang merujuk pada tampilan terpartisi, Query Optimizer tidak lagi dapat mengasumsikan baris yang diperlukan berasal dari tabel dasar yang ditentukan. Kemudian hal ini harus menggunakan filter dinamis dalam rencana eksekusi.
Prosedur tersimpan dan eksekusi pemicu
Database Engine hanya menyimpan kode sumber untuk prosedur tersimpan dan trigger. Ketika prosedur atau pemicu tersimpan pertama kali dijalankan, sumber dikompilasi ke dalam rencana eksekusi. Jika prosedur tersimpan atau pemicu kembali dieksekusi sebelum rencana eksekusi dihapus dari memori, mesin relasional mendeteksi rencana yang ada dan menggunakannya kembali. Jika rencana tersebut tidak lagi ada di memori, rencana baru akan dibuat. Proses ini mirip dengan proses yang diikuti Database Engine untuk semua pernyataan T-SQL. Keunggulan utama kinerja yang dimiliki prosedur tersimpan dan trigger di Database Engine dibandingkan batch T-SQL dinamis adalah pernyataan T-SQL mereka selalu sama. Oleh karena itu, mesin relasional dengan mudah mencocokkannya dengan rencana eksekusi yang ada. Prosedur tersimpan dan rencana pemicu mudah digunakan kembali.
Rencana eksekusi untuk prosedur dan pemicu tersimpan dijalankan secara terpisah dari rencana eksekusi untuk batch yang memanggil prosedur tersimpan atau menembakkan pemicu. Pemisahan ini memungkinkan penggunaan ulang yang lebih besar atas prosedur tersimpan dan rencana eksekusi trigger.
Penembolokan dan penggunaan kembali rencana eksekusi
Database Engine menggunakan memori untuk menyimpan rencana eksekusi dan buffer data. Persentase memori yang dialokasikan untuk rencana eksekusi atau data buffer disesuaikan secara dinamis, tergantung pada kondisi sistem. Bagian memori yang menyimpan rencana eksekusi disebut cache rencana.
Penyimpanan cache rencana
Cache rencana memiliki dua simpanan untuk semua rencana yang dikompilasi.
- Penyimpanan cache Rencana Objek (OBJCP), untuk rencana yang terkait dengan objek yang tersimpan, seperti prosedur tersimpan, fungsi, dan pemicu.
- The SQL Plans cache store (SQLCP), untuk rencana yang terkait dengan kueri yang di-parameterisasi otomatis, dinamis, atau tersiap.
Kueri berikut memberikan informasi tentang penggunaan memori untuk dua cache store ini:
SELECT *
FROM sys.dm_os_memory_clerks
WHERE name LIKE '%plans%';
Cache plan memiliki dua penyimpanan tambahan yang tidak menyimpan plan:
- Bound Trees cache store (PHDR) adalah penyimpanan cache untuk struktur data yang digunakan selama kompilasi rencana untuk tampilan, kendala, dan default. Struktur-struktur ini dikenal sebagai pohon terikat atau pohon algebrizer.
- Penyimpanan cache Extended Stored Procedures (XPROC), untuk prosedur sistem yang telah ditentukan, seperti sp_executesql atau xp_cmdshell. Prosedur tersimpan ini menggunakan DLL alih-alih pernyataan T-SQL. Struktur cache hanya berisi nama fungsi dan nama DLL tempat prosedur diimplementasikan.
Komponen rencana eksekusi
Rencana eksekusi Database Engine memiliki komponen utama berikut:
Rencana kompilasi (atau rencana kueri)
Rencana kueri yang dihasilkan oleh proses kompilasi sebagian besar merupakan struktur data baca-saja yang digunakan oleh sejumlah pengguna. Ini menyimpan informasi tentang:
Operator fisik yang menerapkan operasi yang dijelaskan oleh operator logis.
Urutan operator ini, yang menentukan urutan data diakses, difilter, dan dikumpulkan.
Jumlah perkiraan baris data yang diproses melalui operator.
Catatan
Rencana kueri juga menyimpan informasi tentang objek statistik yang digunakan untuk Estimasi Kardinalitas.
Objek dukungan apa yang harus dibuat, seperti worktables atau workfiles di
tempdb.
Rencana kueri tidak menyimpan konteks pengguna atau informasi runtime. Database Engine menentukan jumlah thread pekerja setiap kali Database Engine mengambil rencana dari cache rencana. Rencana paralel yang dicache juga dapat dijalankan secara serial.
Konteks eksekusi
Setiap pengguna yang saat ini menjalankan kueri memiliki struktur data yang menyimpan data spesifik untuk eksekusi mereka, seperti nilai parameter. Struktur data ini disebut konteks eksekusi. Struktur data konteks eksekusi digunakan kembali, tetapi kontennya tidak. Jika pengguna lain menjalankan kueri yang sama, struktur data diinisialisasi ulang dengan konteks untuk pengguna baru.
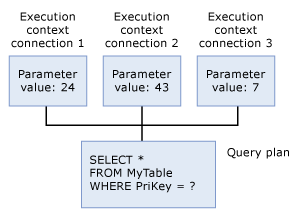
Gunakan kembali paket untuk pernyataan identik
Ketika Database Engine menjalankan pernyataan T-SQL apa pun, ia pertama-tama memeriksa cache rencana untuk memverifikasi bahwa rencana eksekusi yang sudah ada untuk pernyataan T-SQL yang sama ada. Pernyataan T-SQL dianggap sudah ada jika secara harfiah mencocokkan pernyataan T-SQL yang telah dieksekusi sebelumnya dengan rencana yang dicache, karakter demi karakter. Database Engine menggunakan kembali rencana yang sudah ada yang ditemukannya, sehingga menghemat beban kompilasi ulang pernyataan T-SQL. Jika tidak ada rencana eksekusi, Database Engine akan menghasilkan rencana eksekusi baru untuk kueri.
Catatan
Cache rencana tidak menyimpan rencana eksekusi untuk beberapa pernyataan T-SQL, seperti pernyataan operasi massal yang berjalan di rowstore atau pernyataan yang berisi literal string besar. Rencana ini hanya ada selama kueri berjalan.
Database Engine menggunakan algoritma yang efisien untuk menemukan rencana eksekusi yang sudah ada untuk pernyataan T-SQL tertentu apa pun. Di sebagian besar sistem, sumber daya minimal yang digunakan pemindaian ini lebih sedikit dibandingkan sumber daya yang disimpan dengan menggunakan ulang rencana yang sudah ada daripada mengompilasi setiap pernyataan T-SQL.
Algoritma untuk mencocokkan pernyataan T-SQL baru dengan rencana eksekusi yang sudah ada dan tidak digunakan di cache rencana mengharuskan semua referensi objek dikualifikasi sepenuhnya. Misalnya, asumsikan bahwa Person adalah skema default untuk pengguna yang menjalankan pernyataan SELECT berikut. Meskipun contoh ini tidak mengharuskan Anda menyebutkan nama lengkap tabel Person agar dapat dijalankan, ini berarti pernyataan kedua tidak cocok dengan rencana eksekusi yang ada, tetapi pernyataan ketiga memang cocok:
Catatan
Di Azure SQL Database dan SQL database di Microsoft Fabric, pernyataan USE tersebut tidak tersedia. Sebaliknya, hubungkan langsung ke database yang dimaksud dan jalankan sisa kode sampel.
USE AdventureWorks2025;
GO

SELECT *
FROM Person;
GO

SELECT *
FROM Person.Person;
GO

SELECT *
FROM Person.Person;
GO
Mengubah salah satu opsi berikut SET untuk suatu eksekusi tertentu memengaruhi kemampuan untuk menggunakan kembali plan kueri, karena Database Engine melakukan pelipatan konstan dan opsi-opsi ini memengaruhi hasil dari ekspresi tersebut:
ANSI_DEFAULTSANSI_NULL_DFLT_OFFANSI_NULL_DFLT_ONANSI_NULLSANSI_PADDINGANSI_WARNINGSARITHABORTCONCAT_NULL_YIELDS_NULLDATEFIRSTDATEFORMATFORCEPLANLANGUAGENO_BROWSETABLENUMERIC_ROUNDABORTQUOTED_IDENTIFIER
Cache beberapa rencana untuk kueri yang sama
Kueri dan rencana eksekusi dapat diidentifikasi secara unik di Mesin Database, seperti sidik jari:
- Hash rencana kueri adalah nilai hash biner yang dihitung dari rencana eksekusi untuk kueri tertentu, dan digunakan untuk secara unik mengidentifikasi rencana eksekusi yang serupa.
- Hash kueri adalah nilai hash biner yang dihitung pada teks T-SQL dari sebuah kueri, dan digunakan untuk mengidentifikasi kueri secara unik.
Anda dapat mengambil rencana yang sudah dikompilasi dari cache rencana dengan menggunakan handle rencana. Pengidentifikasi sementara ini tetap konstan hanya selama rencana berada di cache. Handle rencana adalah nilai hash yang berasal dari rencana yang dikompilasi dari sekumpulan keseluruhan. Plan handle untuk rencana yang dikompilasi tetap sama meskipun satu atau lebih pernyataan dalam batch dikompilasi ulang.
Catatan
Jika Anda mengompilasi rencana untuk batch alih-alih satu pernyataan, Anda dapat menggunakan handle rencana dan offset pernyataan untuk mendapatkan rencana untuk pernyataan individual dalam batch.
sys.dm_exec_requests DMV berisi kolom statement_end_offset dan statement_start_offset untuk setiap catatan. Kolom-kolom ini merujuk pada statement yang saat ini sedang dijalankan dari batch yang saat ini sedang dijalankan atau objek persisten. Untuk informasi selengkapnya, lihat sys.dm_exec_requests.
DMV sys.dm_exec_query_stats juga memuat kolom-kolom ini untuk setiap catatan. Kolom-kolom ini merujuk pada posisi pernyataan dalam batch atau objek yang tersimpan. Untuk informasi selengkapnya, lihat sys.dm_exec_query_stats.
Teks T-SQL sebenarnya dari sebuah batch disimpan di ruang memori terpisah dari cache rencana, yang disebut cache SQL Manager (SQLMGR). Anda dapat mengambil teks T-SQL untuk rencana yang dikompilasi dari cache SQL Manager dengan menggunakan handle SQL. Pengidentifikasi sementara ini tetap konstan hanya selama setidaknya satu rencana yang mereferensikannya tetap ada di cache rencana. Handle SQL adalah nilai hash yang berasal dari seluruh teks batch, dan dijamin unik untuk setiap batch.
Catatan
Seperti rencana yang dikompilasi, teks T-SQL disimpan per batch, termasuk komentarnya. Handle SQL berisi hash MD5 dari seluruh teks batch dan dijamin unik untuk setiap batch.
Kueri berikut memberikan informasi tentang penggunaan memori untuk cache SQL Manager:
SELECT *
FROM sys.dm_os_memory_objects
WHERE type = 'MEMOBJ_SQLMGR';
Ada hubungan satu-ke-banyak antara handle SQL dan handle plan. Kondisi ini terjadi ketika kunci cache untuk rencana yang dikompilasi berbeda. Perbedaan ini mungkin terjadi karena perubahan opsi SET antara dua eksekusi dari batch yang sama.
Pertimbangkan prosedur tersimpan berikut:
USE WideWorldImporters;
GO

CREATE PROCEDURE usp_SalesByCustomer
(
    @CID INT
)
AS
SELECT *
FROM Sales.Customers
WHERE CustomerID = @CID;
GO

SET ANSI_DEFAULTS ON;
GO

EXECUTE usp_SalesByCustomer 10;
GO
Verifikasi apa yang dapat Anda temukan di cache rencana dengan menggunakan kueri berikut:
SELECT cp.memory_object_address,
       cp.objtype,
       refcounts,
       usecounts,
       qs.query_plan_hash,
       qs.query_hash,
       qs.plan_handle,
       qs.sql_handle
FROM sys.dm_exec_cached_plans AS cp
CROSS APPLY sys.dm_exec_sql_text(cp.plan_handle)
CROSS APPLY sys.dm_exec_query_plan(cp.plan_handle)
     INNER JOIN sys.dm_exec_query_stats AS qs
         ON qs.plan_handle = cp.plan_handle
WHERE text LIKE '%usp_SalesByCustomer%';
GO
Berikut hasilnya.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CC6C534060        Proc      2           1           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Sekarang jalankan prosedur tersimpan dengan parameter yang berbeda, tanpa perubahan lain pada konteks eksekusi:
EXECUTE usp_SalesByCustomer 8;
GO
Verifikasi kembali apa yang bisa Anda temukan di cache rencana. Berikut hasilnya.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CC6C534060        Proc      2           2           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Perhatikan usecounts nilai meningkat menjadi 2, yang berarti rencana cache yang sama digunakan kembali as-is, karena struktur data konteks eksekusi digunakan kembali. Sekarang ubah SET ANSI_DEFAULTS opsi dan jalankan prosedur tersimpan dengan menggunakan parameter yang sama.
SET ANSI_DEFAULTS OFF;
GO

EXECUTE usp_SalesByCustomer 8;
GO
Verifikasi kembali apa yang bisa Anda temukan di cache rencana. Berikut hasilnya.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CD01DEC060        Proc      2           1           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D
0x000001CC6C534060        Proc      2           2           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02B031F111CD01000001000000000000000000000000000000000000000000000000000000
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Perhatikan bahwa sekarang ada dua entri dalam sys.dm_exec_cached_plans output DMV:
- Kolom
usecountsmenampilkan nilai1pada catatan pertama. Nilai ini mewakili plan yang dieksekusi satu kali denganSET ANSI_DEFAULTS OFF. - Kolom
usecountsmenunjukkan nilai2pada rekaman kedua. Nilai ini mewakili rencana yang dieksekusi denganSET ANSI_DEFAULTS ON, karena rencana ini dieksekusi dua kali. - Yang berbeda
memory_object_addressmengacu pada entri rencana eksekusi yang berbeda dalam cache rencana. Namun,sql_handlenilainya sama untuk kedua entri karena merujuk ke batch yang sama.- Eksekusi dengan
ANSI_DEFAULTSdiatur keOFFmemilikiplan_handlebaru dan tersedia untuk digunakan kembali untuk panggilan yang memiliki setSETopsi yang sama. Penangan rencana baru diperlukan karena konteks eksekusi diinisialisasi ulang akibat perubahan pada opsiSET. Namun perubahan itu tidak memicu rekompilasi: kedua entri merujuk pada rencana dan kueri yang sama, sebagaimana dibuktikan oleh nilaiquery_hashdanquery_plan_hashyang sama.
- Eksekusi dengan
Situasi ini berarti Anda memiliki dua entri plan di cache yang sesuai dengan batch yang sama. Hal ini menekankan pentingnya memastikan bahwa opsi SET yang memengaruhi cache rencana sama ketika kueri yang sama dijalankan berulang kali. Pendekatan ini mengoptimalkan penggunaan ulang rencana dan menjaga ukuran cache rencana seminimal mungkin.
Tips
Perangkap umum adalah bahwa klien yang berbeda dapat memiliki nilai default yang berbeda untuk opsi tersebut SET . Misalnya, koneksi yang dibuat melalui SQL Server Management Studio secara otomatis mengatur QUOTED_IDENTIFIER ke ON, sementara SQLCMD mengatur QUOTED_IDENTIFIER ke OFF. Menjalankan kueri yang sama dari kedua klien ini menghasilkan beberapa rencana (seperti yang dijelaskan pada contoh sebelumnya).
Hapus rencana eksekusi dari cache rencana
Rencana eksekusi tetap berada di cache rencana selama ada cukup memori untuk menyimpannya. Ketika tekanan memori ada, Mesin Database SQL Server menggunakan pendekatan berbasis biaya untuk memutuskan rencana eksekusi mana yang akan dihapus dari cache rencana. Untuk membuat keputusan berbasis biaya, Mesin Database SQL Server menyesuaikan variabel biaya saat ini naik atau turun untuk setiap rencana eksekusi berdasarkan faktor-faktor berikut.
Ketika proses pengguna memasukkan rencana eksekusi ke dalam cache, proses pengguna menetapkan biaya saat ini sama dengan biaya kompilasi kueri asli. Untuk rencana eksekusi ad hoc, proses pengguna menetapkan biaya saat ini menjadi nol. Setelah itu, setiap kali proses pengguna merujuk pada rencana eksekusi, biaya saat ini direset ke biaya kompilasi asli. Untuk rencana eksekusi ad hoc, proses pengguna meningkatkan biaya saat ini. Untuk semua rencana, nilai maksimum untuk biaya saat ini adalah biaya kompilasi yang asli.
Ketika tekanan memori ada, Mesin Database SQL Server menghapus rencana eksekusi dari cache rencana. Untuk menentukan rencana mana yang akan dihapus, Mesin Database SQL Server berulang kali memeriksa status setiap rencana eksekusi dan menghapus rencana ketika biayanya saat ini adalah nol. Rencana eksekusi dengan biaya saat ini nol tidak otomatis dihapus saat tekanan memori ada. Ini hanya dihapus ketika Mesin Database SQL Server memeriksa rencana tersebut dan biaya saat ini adalah nol. Saat memeriksa rencana pelaksanaan, Mesin Database SQL Server mendorong biaya saat ini menuju nol dengan mengurangi biaya saat ini jika sebuah kueri saat ini tidak menggunakan rencana tersebut.
Mesin Database SQL Server terus meninjau rencana eksekusi hingga menghapus cukup banyak rencana untuk memenuhi kebutuhan memori. Meskipun tekanan memori ada, rencana eksekusi mungkin memiliki biayanya meningkat dan menurun lebih dari sekali. Ketika tekanan memori tidak lagi ada, Mesin Database SQL Server berhenti mengurangi cost saat ini dari rencana eksekusi yang tidak terpakai. Semua rencana eksekusi tetap berada di cache rencana, bahkan jika biayanya nol.
Mesin Database SQL Server menggunakan monitor sumber daya dan utas pekerja pengguna untuk membebaskan memori dari cache rencana sebagai respons terhadap tekanan memori. Thread resource monitor dan user worker dapat secara bersamaan memeriksa rencana eksekusi untuk menurunkan biaya saat ini untuk setiap rencana eksekusi yang tidak digunakan. Pemantau sumber daya menghapus rencana eksekusi dari cache rencana ketika ada tekanan memori global. Ini membebaskan memori untuk menerapkan kebijakan untuk memori sistem, memori proses, memori kumpulan sumber daya, dan ukuran maksimum untuk semua cache.
Ukuran maksimum untuk semua cache adalah fungsi dari ukuran kumpulan buffer dan tidak dapat melebihi memori server maksimum. Untuk informasi lebih lanjut tentang mengonfigurasi memori server maksimum, lihat setelan max server memory tersebut di sp_configure.
Utas pekerja pengguna menghapus rencana eksekusi dari cache rencana ketika ada tekanan memori cache tunggal. Mereka memberlakukan kebijakan untuk ukuran cache tunggal maksimum dan entri cache tunggal maksimum.
Contoh berikut mengilustrasikan rencana eksekusi mana yang dihapus dari cache paket:
- Rencana eksekusi sering dirujuk sehingga biayanya tidak pernah ke nol. Rencana tetap berada di cache rencana dan tidak dihapus kecuali ada tekanan memori dan cost saat ini bernilai nol.
- Rencana eksekusi ad hoc dimasukkan dan tidak digunakan lagi sampai terjadi tekanan memori. Karena rencana ad hoc diinisialisasi dengan biaya saat ini nol, ketika Mesin Database SQL Server memeriksa rencana eksekusi, ia melihat biaya saat ini nol dan menghapus rencana dari cache rencana. Rencana eksekusi ad hoc tetap berada di cache rencana dengan biaya saat ini nol ketika tekanan memori tidak ada.
Untuk menghapus satu paket atau semua paket secara manual dari cache, gunakan DBCC FREEPROCCACHE. Anda juga dapat menggunakan DBCC FREESYSTEMCACHE untuk membersihkan cache apa pun, termasuk cache rencana. SQL Server 2016 (13.x) dan versi berikutnya, gunakan ALTER DATABASE SCOPED CONFIGURATION CLEAR PROCEDURE_CACHE untuk membersihkan cache prosedur (rencana) untuk database dalam lingkup.
Perubahan pada beberapa pengaturan konfigurasi melalui sp_configure dan reconfigure juga menyebabkan penghapusan rencana dari cache rencana. Anda dapat menemukan daftar pengaturan konfigurasi ini di bagian Keterangan dari artikel DBCC FREEPROCCACHE . Saat Anda melakukan perubahan konfigurasi ini, pesan informasi berikut akan ditulis ke log kesalahan:
SQL Server has encountered %d occurrence(s) of cachestore flush for the '%s' cachestore (part of plan cache) due to some database maintenance or reconfigure operations.
Menyusun ulang rencana eksekusi
Beberapa perubahan dalam database dapat membuat rencana eksekusi menjadi tidak efisien atau tidak valid. Database Engine mendeteksi perubahan ini dan menandai rencana sebagai tidak valid. Rencana baru kemudian harus disusun ulang untuk koneksi berikutnya yang menjalankan kueri. Kondisi yang membatalkan rencana meliputi:
- Perubahan pada tabel atau tampilan yang direferensikan oleh kueri (
ALTER TABLEdanALTER VIEW). - Perubahan pada satu prosedur, yang akan menghapus semua rencana untuk prosedur tersebut dari cache (
ALTER PROCEDURE). - Perubahan pada indeks apa pun yang digunakan oleh rencana eksekusi.
- Pembaruan statistik yang digunakan oleh rencana eksekusi, baik yang secara eksplisit dihasilkan oleh pernyataan seperti
UPDATE STATISTICSatau dihasilkan secara otomatis. - Menghilangkan indeks yang digunakan oleh rencana eksekusi.
- Panggilan eksplisit ke
sp_recompile. - Sejumlah besar perubahan pada kunci (yang dihasilkan oleh pernyataan
INSERTatauDELETEdari pengguna lain yang mengubah tabel yang dirujuk oleh kueri). - Untuk tabel dengan pemicu, jika jumlah baris dalam tabel yang disisipkan atau dihapus tumbuh secara signifikan.
- Menjalankan prosedur tersimpan dengan menggunakan opsi
WITH RECOMPILE.
Kebanyakan kompilasi ulang diperlukan baik untuk kebenaran pernyataan maupun untuk mendapatkan rencana eksekusi kueri yang berpotensi lebih cepat.
Ketika sebuah pernyataan dalam batch memicu rekompilasi, hanya pernyataan itu yang dikompilasi ulang, bukan seluruh batch. Aturan ini berlaku baik batch dikirim melalui prosedur tersimpan, trigger, batch ad hoc, atau pernyataan yang disiapkan.
Rekompilasi tingkat pernyataan menguntungkan kinerja karena, dalam banyak kasus, sejumlah kecil pernyataan menyebabkan rekompilasi dan penalti terkait, baik dalam hal waktu CPU dan penguncian. Penalti ini dihindari untuk pernyataan lain dalam batch yang tidak perlu dikompilasi ulang.
Peristiwa sql_statement_recompile yang diperluas (XEvent) melaporkan kompilasi ulang tingkat pernyataan. XEvent ini terjadi ketika kompilasi ulang tingkat pernyataan diperlukan oleh segala jenis batch. Persyaratan ini mencakup prosedur tersimpan, trigger, batch ad hoc, dan query. Batch dapat dikirim melalui beberapa antarmuka, termasuk sp_executesql, dynamic SQL, metode Prepare, atau metode Execute.
Kolom recompile_causesql_statement_recompile XEvent berisi kode bilangan bulat yang menunjukkan alasan kompilasi ulang. Daftar berikut berisi alasan yang mungkin:
- Opsi kursor berubah
- Kompilasi yang ditangguhkan
-
FOR BROWSEizin diubah -
OPTION (RECOMPILE)Diminta - Rencana berparameter dibersihkan
- Tampilan yang dipartisi berubah
- Rencana yang memengaruhi versi database berubah
- Lingkungan pemberitahuan kueri berubah
- Penyimpanan Query tidak memiliki rencana
- Penerapan rencana Query Store gagal
- Kebijakan memaksa paket Penyimpanan Kueri diubah
- Kumpulan baris jarak jauh berubah
- Skema berubah
-
SETopsi diubah - Statistik berubah
- Tabel sementara diubah
Catatan
Ketika Anda mengatur AUTO_UPDATE_STATISTICS opsi basis data ke ON, kueri dikompilasi ulang ketika mereka menargetkan tabel atau tampilan terindeks yang statistiknya diperbarui atau kardinalitasnya berubah secara signifikan sejak eksekusi terakhir. Perilaku ini berlaku untuk tabel standar yang ditentukan pengguna, tabel sementara, dan tabel yang disisipkan dan dihapus yang dibuat oleh pemicu DML.
Mengatur AUTO_UPDATE_STATISTICS ke OFF menghentikan rekompilasi ini, tetapi statistik yang sudah usang biasanya menurunkan kinerja kueri lebih parah dibandingkan rekompilasi. Untuk informasi lebih lanjut, lihat opsi AUTO_UPDATE_STATISTICS . Tabel inserted dan deleted dari pemicu DML INSTEAD OF dibuat di tempdb, sehingga mengikuti pengaturan AUTO_UPDATE_STATISTICS dari tempdb.
Gunakan parameter eksplisit untuk penggunaan kembali plan
Menggunakan parameter, termasuk parameter bernama dalam aplikasi ADO.NET dan penanda parameter dalam aplikasi OLE DB dan ODBC, dapat meningkatkan penggunaan kembali rencana eksekusi.
Peringatan
Selalu validasi input pengguna dengan menguji jenis, panjang, format, dan rentang. Untuk informasi selengkapnya, lihat Injeksi SQL.
Satu-satunya perbedaan antara dua SELECT pernyataan berikut adalah nilai yang dibandingkan dalam WHERE klausa:
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 4;
Satu-satunya perbedaan antara rencana eksekusi untuk kueri ini adalah nilai yang disimpan untuk dibandingkan dengan kolom ProductSubcategoryID. Meskipun tujuannya adalah agar Database Engine selalu mengenali bahwa pernyataan tersebut menghasilkan rencana yang pada dasarnya sama dan menggunakan kembali rencana tersebut, Database Engine terkadang tidak mendeteksi kesamaan ini dalam pernyataan T-SQL yang kompleks.
Memisahkan konstanta dari pernyataan T-SQL dengan menggunakan parameter membantu mesin relasional mengenali plan eksekusi duplikat. Gunakan parameter dengan cara berikut:
Di T-SQL, gunakan
sp_executesql:DECLARE @MyIntParm AS INT; SET @MyIntParm = 1; EXECUTE sp_executesql N'SELECT * FROM AdventureWorks2025.Production.Product WHERE ProductSubcategoryID = @Parm', N'@Parm INT', @MyIntParm;Metode ini direkomendasikan untuk skrip T-SQL, prosedur tersimpan, atau trigger yang menghasilkan pernyataan SQL secara dinamis.
ADO.NET dengan
SqlClientmenggunakan parameter bernama, seperti@Parm. OLE DB dan ODBC menggunakan penanda parameter. Penanda parameter adalah tanda tanya (?) yang menggantikan konstanta dalam pernyataan SQL dan terikat pada variabel program. Misalnya, Anda akan melakukan hal berikut dalam aplikasi ODBC:Gunakan
SQLBindParameteruntuk mengikat variabel bilangan bulat ke penanda parameter pertama dalam pernyataan SQL.Masukkan nilai bilangan bulat dalam variabel.
Jalankan pernyataan, tentukan penanda parameter (
?):SQLExecDirect(hstmt, "SELECT * FROM AdventureWorks2025.Production.Product WHERE ProductSubcategoryID = ?", SQL_NTS);
SQL Server Native Client OLE DB Provider dan driver SQL Server Native Client ODBC menggunakan
sp_executesqluntuk mengirim pernyataan ke SQL Server ketika penanda parameter digunakan dalam aplikasi.Tulis prosedur tersimpan, yang menggunakan parameter sesuai rancangan.
Jika Anda tidak secara eksplisit membangun parameter dalam desain aplikasi Anda, Anda juga dapat mengandalkan Query Optimizer untuk secara otomatis memparameterisasi kueri tertentu dengan menggunakan perilaku default parameterisasi sederhana. Atau, Anda dapat memaksa Pengoptimal Kueri untuk mempertimbangkan parameterisasi semua kueri dalam database dengan mengatur PARAMETERIZATION opsi ALTER DATABASE pernyataan ke FORCED.
Parameterisasi sederhana
Di Database Engine, penggunaan parameter atau penanda parameter dalam pernyataan T-SQL meningkatkan kemampuan mesin relasional untuk mencocokkan pernyataan T-SQL baru dengan rencana eksekusi yang sudah ada dan telah dikompilasi sebelumnya.
Peringatan
Selalu validasi input pengguna dengan menguji jenis, panjang, format, dan rentang. Untuk informasi selengkapnya, lihat Injeksi SQL.
Jika pernyataan T-SQL dijalankan tanpa parameter, Database Engine akan memparameterisasi pernyataan tersebut secara internal untuk meningkatkan kemungkinan mencocokkannya dengan rencana eksekusi yang sudah ada. Proses ini disebut parameterisasi. Default-nya adalah parameterisasi sederhana, dan Anda dapat mengaktifkan parameterisasi paksa untuk sebuah database.
Pertimbangkan pernyataan ini:
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
Anda dapat menentukan nilai 1 di akhir pernyataan sebagai parameter. Mesin relasional membangun rencana eksekusi untuk batch ini seolah-olah Anda menetapkan sebuah parameter sebagai pengganti nilai 1. Karena parameterisasi sederhana ini, Database Engine mengenali bahwa dua pernyataan berikut menghasilkan rencana eksekusi yang pada dasarnya sama dan menggunakan kembali rencana pertama untuk pernyataan kedua:
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 4;
Saat memproses pernyataan T-SQL yang kompleks, mesin relasional dapat mengalami kesulitan menentukan ekspresi mana yang dapat diparameterkan. Untuk meningkatkan kemampuan mesin relasional mencocokkan pernyataan T-SQL kompleks dengan rencana eksekusi yang sudah ada dan tidak digunakan, tentukan parameter secara eksplisit dengan menggunakan baik sp_executesql maupun penanda parameter.
Catatan
Ketika Anda menggunakan +, -, *, /, atau % operator aritmetika untuk melakukan konversi implisit atau eksplisit dari nilai konstanta int, smallint,tinyint, atau bigint ke tipe data float, real,desimal, atau numerik, Database Engine menerapkan aturan khusus untuk menghitung tipe dan presisi hasil ekspresi. Aturan-aturan ini berbeda, tergantung apakah kueri diparameterkan atau tidak. Oleh karena itu, ekspresi serupa dalam kueri dapat, dalam beberapa kasus, menghasilkan hasil yang berbeda.
Di bawah perilaku default parameterisasi sederhana, Database Engine memparameterisasi kelas kueri yang relatif kecil. Namun, Anda dapat menentukan bahwa semua kueri dalam database diparameterkan dengan tunduk pada batasan tertentu, dengan mengatur opsi PARAMETERIZATION perintah ALTER DATABASE ke FORCED. Perubahan ini dapat meningkatkan kinerja basis data yang mengalami volume kueri bersamaan yang tinggi dengan mengurangi frekuensi kompilasi kueri.
Atau, Anda dapat menentukan bahwa satu kueri, dan kueri lain yang setara secara sintetis tetapi hanya berbeda dalam nilai parameternya, diparameterkan.
Tips
Ketika Anda menggunakan solusi pemetaan objek-relasional (ORM) seperti Entity Framework (EF), kueri aplikasi seperti pohon kueri manual LINQ atau kueri SQL mentah tertentu mungkin tidak diparameterisasi. Keterbatasan ini memengaruhi penggunaan ulang rencana dan kemampuan untuk melacak kueri di Query Store. Untuk informasi selengkapnya, lihat Cache dan parameterisasi Kueri EF dan Kueri SQL Mentah EF.
Parameterisasi paksa
Anda dapat menimpa perilaku parameterisasi sederhana default dari Database Engine dengan menentukan bahwa semua pernyataan SELECT, INSERT, UPDATE, dan DELETE dalam database harus diparameterisasi, dengan tunduk pada batasan tertentu. Aktifkan parameterisasi paksa dengan mengatur opsi PARAMETERIZATION ke FORCED dalam pernyataan ALTER DATABASE. Parameterisasi paksa dapat meningkatkan performa database tertentu dengan mengurangi frekuensi kompilasi kueri dan kompilasi ulang. Database yang mungkin mendapat manfaat dari parameterisasi paksa umumnya adalah database yang mengalami volume kueri bersamaan yang tinggi dari sumber seperti aplikasi point-of-sale.
Ketika Anda mengatur opsi PARAMETERIZATION menjadi FORCED, setiap nilai literal yang muncul dalam pernyataan SELECT, INSERT, UPDATE, atau DELETE, yang diajukan dalam bentuk apa pun, akan diubah menjadi parameter selama kompilasi kueri. Pengecualiannya adalah literal yang muncul dalam konstruksi kueri berikut:
-
INSERT...EXECUTEPernyataan. - Pernyataan di dalam isi prosedur tersimpan, pemicu, atau fungsi yang ditentukan pengguna. Database Engine sudah menggunakan kembali rencana kueri untuk rutinitas ini.
- Prepared statement yang sudah disiapkan dan sudah diparameterisasi di aplikasi sisi klien.
- Pernyataan yang berisi panggilan metode XQuery, di mana metode muncul dalam konteks di mana argumennya biasanya akan diparameterkan, seperti
WHEREklausa. Jika metode muncul dalam konteks di mana argumennya tidak akan diparameterkan, sisa pernyataan diparameterkan. - Pernyataan di dalam kursor T-SQL. (
SELECTpernyataan di dalam kursor API dijadikan parameter.) - Konstruksi kueri yang tidak digunakan lagi.
- Setiap pernyataan yang berjalan dalam konteks
ANSI_PADDINGatauANSI_NULLSdiatur keOFF. - Pernyataan yang berisi lebih dari 2.097 literal yang memenuhi syarat untuk parameterisasi.
- Pernyataan yang mereferensikan variabel, seperti
WHERE T.col2 >= @bb. - Pernyataan yang berisi
RECOMPILEpetunjuk pencarian. - Pernyataan yang berisi
COMPUTEklausa. - Pernyataan yang berisi
WHERE CURRENT OFklausa.
Klausa kueri berikut tidak diparameterisasi. Dalam kasus ini, hanya klausul yang tidak diparameterkan. Klausa lain dalam kueri yang sama dapat memenuhi syarat untuk parameterisasi paksa.
-
<select_list>dari pernyataanSELECTapa pun. Daftar ini mencakupSELECTdaftar subquery danSELECTdaftar di dalam pernyataanINSERT. - Pernyataan subkueri
SELECTyang muncul di dalam pernyataanIF. - Klausa
TOP,TABLESAMPLE,HAVING,GROUP BY,ORDER BY,OUTPUT...INTO, atauFOR XMLdari kueri. - Argumen, baik langsung atau sebagai subekspresi, ke
OPENROWSET,OPENQUERY,OPENDATASOURCE,OPENXML, atau operator apa punFULLTEXT. - Argumen pola dan escape_character dari klausul
LIKE. - Argumen gaya dari klausa
CONVERT. - Konstanta bilangan bulat di dalam
IDENTITYklausul. - Konstanta yang ditentukan dengan menggunakan sintaks ekstensi ODBC.
- Ekspresi yang dapat dilipat secara konstan yang merupakan argumen dari operator
+,-,*,/, dan%. Saat mempertimbangkan kelayakan untuk parameterisasi paksa, Database Engine menganggap sebuah ekspresi sebagai dapat di-constant fold ketika salah satu kondisi berikut benar:- Tidak ada kolom, variabel, atau subkueri yang muncul dalam ekspresi.
- Ekspresi berisi klausa
CASE.
- Argumen ke klausa petunjuk kueri, termasuk argumen number_of_rows dari
FASTpetunjuk kueri, argumen number_of_processors dariMAXDOPpetunjuk kueri, dan argumen number dariMAXRECURSIONpetunjuk kueri.
Parameterisasi terjadi pada tingkat pernyataan T-SQL individual. Dengan kata lain, pernyataan individual dalam batch diparameterkan. Setelah dikompilasi, kueri yang diparameterisasi dijalankan dalam konteks batch tempat kueri tersebut awalnya diajukan. Jika rencana eksekusi untuk sebuah kueri di-cache, Anda dapat menentukan apakah kueri tersebut diparameterisasi dengan merujuk pada kolom sql dari tampilan manajemen dinamis sys.syscacheobjects. Jika sebuah kueri diparameterisasi, nama dan tipe data parameter muncul sebelum teks batch yang dikirim di kolom ini, seperti (@1 TINYINT).
Catatan
Nama parameter bersifat bebas. Pengguna atau aplikasi tidak boleh bergantung pada urutan penamaan tertentu. Selain itu, item berikut dapat berubah antara versi SQL Server dan pemutakhiran pembaruan kumulatif (CU): Nama parameter, pilihan literal yang diparameterkan, dan jarak dalam teks yang diparameterkan.
Jenis data parameter
Ketika Database Engine memparameterkan literal, parameter tersebut dikonversi menjadi tipe data berikut:
- Literal bilangan bulat yang ukurannya seharusnya masuk dalam parameter tipe data int menjadi int. Literal bilangan bulat yang lebih besar yang merupakan bagian dari predikat yang melibatkan operator perbandingan apa pun (termasuk
<,<=,=,!=,>=,>,<>,ANY,BETWEEN,ALL,!>,SOME,!<, danIN) berparameterisasi menjadi numeric(38,0). Literal yang lebih besar yang bukan bagian dari predikat yang melibatkan operator perbandingan akan diparameterisasi menjadi numerik yang presisinya cukup besar untuk mendukung ukurannya dan skalanya 0. - Literal numerik titik tetap yang merupakan bagian dari predikat yang melibatkan operator perbandingan diparameterkan sebagai numerik dengan presisi 38 dan skalanya hanya sebesar yang diperlukan untuk mendukung ukurannya. Literal numerik titik tetap yang bukan bagian dari predikat yang melibatkan operator perbandingan diparameterisasi menjadi numerik yang presisi dan skalanya hanya sebesar yang diperlukan untuk mendukung ukurannya.
- Literal numerik floating point diparameterisasi sebagai float(53).
- Literal string non-Unicode diparameterisasi ke varchar(8000) jika literal tersebut muat dalam 8.000 karakter, dan ke varchar(max) jika ukurannya lebih besar dari 8.000 karakter.
- Literal string Unicode diparameterkan ke nvarchar(4000) jika literal tersebut masuk dalam 4.000 karakter Unicode, dan ke nvarchar(max) jika literal lebih besar dari 4.000 karakter.
- Literal biner diparameterkan menjadi varbinary(8000) jika literal tersebut muat dalam 8.000 byte. Jika ukurannya lebih besar dari 8.000 byte, maka dikonversi ke varbinary(max).
- Literal uang diparameterkan menjadi uang.
Panduan untuk menggunakan parameterisasi paksa
Pertimbangkan poin-poin berikut saat Anda menyetel opsi PARAMETERIZATION ke FORCED:
- Parameterisasi paksa mengubah konstanta literal dalam kueri menjadi parameter saat mengompilasi kueri. Oleh karena itu, Pengoptimal Kueri dapat memilih rencana suboptimal untuk kueri. Secara khusus, Pengoptimal Kueri kurang mungkin mencocokkan kueri dengan tampilan terindeks atau indeks pada kolom yang dihitung. Ini mungkin juga memilih rencana yang suboptimal untuk kueri yang diajukan pada tabel yang dipartisi dan tampilan partisi terdistribusi. Jangan gunakan parameterisasi paksa untuk lingkungan yang sangat bergantung pada tampilan terindeks dan indeks pada kolom yang dihitung. Secara umum, hanya profesional basis data berpengalaman yang sebaiknya menggunakan
PARAMETERIZATION FORCEDopsi ini setelah memastikan bahwa opsi tersebut tidak berdampak buruk pada kinerja. - Kueri terdistribusi yang mereferensikan lebih dari satu database memenuhi syarat untuk parameterisasi paksa selama
PARAMETERIZATIONopsi diatur keFORCEDdalam database yang konteks kuerinya berjalan. - Mengatur opsi
PARAMETERIZATIONkeFORCEDmenghapus semua rencana kueri dari cache rencana database, kecuali yang sedang dikompilasi, dikompilasi ulang, atau dijalankan. Rencana untuk kueri yang sedang dikompilasi atau berjalan selama perubahan pengaturan akan diparameterisasi saat kueri dieksekusi berikutnya. - Menyetel opsi
PARAMETERIZATIONmerupakan operasi online yang tidak memerlukan kunci eksklusif di tingkat basis data. - Pengaturan
PARAMETERIZATIONopsi saat ini dipertahankan saat memasang ulang atau memulihkan database.
Anda dapat mengabaikan perilaku parameterisasi paksa dengan menentukan bahwa parameterisasi sederhana dicoba pada satu query, dan query lain apa pun yang secara sintaksis ekuivalen tetapi hanya berbeda dalam nilai parameternya. Sebaliknya, Anda dapat menentukan bahwa parameterisasi paksa hanya dicoba pada sekumpulan kueri yang setara secara sintetis, bahkan jika parameterisasi paksa dinonaktifkan dalam database. Gunakan plan guides untuk tujuan ini.
Catatan
PARAMETERIZATION Ketika opsi diatur ke FORCED, pelaporan pesan kesalahan dapat berbeda dari ketika PARAMETERIZATION opsi diatur ke SIMPLE: beberapa pesan kesalahan mungkin dilaporkan di bawah parameterisasi paksa, di mana lebih sedikit pesan akan dilaporkan di bawah parameterisasi sederhana, dan nomor baris di mana kesalahan terjadi dapat dilaporkan dengan salah.
Ketika parameterisasi paksa diaktifkan, parameterisasi sederhana masih dapat terjadi. Misalnya, kueri berikut tidak dapat diparameterkan sesuai dengan aturan parameterisasi paksa:
SELECT *
FROM Person.Address
WHERE AddressID = 1 + 2;
Namun, dapat diparameterkan sesuai dengan aturan parameterisasi sederhana. Ketika parameterisasi paksa dicoba tetapi gagal, parameterisasi sederhana masih dicoba.
Menyiapkan pernyataan SQL
Database Engine mendukung persiapan pernyataan T-SQL sebelum eksekusi. Jika sebuah aplikasi perlu menjalankan pernyataan T-SQL beberapa kali, aplikasi dapat menggunakan API database untuk:
- Siapkan pernyataan sekali. Langkah ini mengompilasi pernyataan T-SQL menjadi rencana eksekusi.
- Jalankan rencana eksekusi yang sudah dikompilasi setiap kali perlu menjalankan statement. Pendekatan ini mencegah kompilasi ulang pernyataan T-SQL pada setiap eksekusi setelah eksekusi pertama. Menyiapkan dan menjalankan pernyataan dikontrol oleh fungsi dan metode API. SQL Server Native Client OLE DB Provider dan driver SQL Server Native Client ODBC mendukung model persiapan/eksekusi untuk menjalankan pernyataan T-SQL. Pada permintaan persiapan, penyedia atau driver mengirimkan pernyataan ke SQL Server dengan permintaan untuk menyiapkan pernyataan. Database Engine mengompilasi rencana eksekusi dan mengembalikan handle untuk rencana tersebut kepada penyedia atau driver. Pada permintaan pelaksanaan, penyedia atau driver mengirimkan permintaan kepada server untuk menjalankan rencana yang terkait dengan handle.
Pernyataan yang disiapkan tidak dapat membuat objek sementara di Database Engine. Pernyataan yang disiapkan tidak dapat mereferensikan prosedur tersimpan sistem yang membuat objek sementara, seperti tabel sementara. Prosedur ini harus dijalankan secara langsung.
Penggunaan model persiapan/eksekusi secara berlebihan dapat menurunkan kinerja. Jika sebuah pernyataan hanya dijalankan sekali, eksekusi langsung hanya memerlukan satu kali komunikasi bolak-balik melalui jaringan ke server. Menyiapkan dan mengeksekusi pernyataan T-SQL yang dijalankan hanya satu kali memerlukan perjalanan bolak-balik jaringan tambahan: satu perjalanan untuk menyiapkan pernyataan dan satu perjalanan untuk menjalankannya.
Menyiapkan statement lebih efektif jika Anda menggunakan penanda parameter. Misalnya, asumsikan bahwa aplikasi kadang-kadang diminta untuk mengambil informasi produk dari AdventureWorksLT2025 database sampel. Ada dua cara aplikasi dapat melakukan tugas ini.
Dengan menggunakan pendekatan pertama, aplikasi dapat menjalankan kueri terpisah untuk setiap produk yang diminta:
SELECT *
FROM Production.Product
WHERE ProductID = 63;
Dengan pendekatan kedua, aplikasi melakukan operasi berikut:
Menyiapkan pernyataan yang berisi penanda parameter (
?).SELECT * FROM Production.Product WHERE ProductID = ?;Mengikat variabel program ke penanda parameter.
Setiap kali informasi produk diperlukan, mengisi variabel terikat dengan nilai kunci dan menjalankan pernyataan.
Pendekatan kedua lebih efisien jika pernyataan dijalankan lebih dari tiga kali.
Dalam Database Engine, model prepare/execute tidak memiliki keunggulan kinerja yang signifikan dibandingkan eksekusi langsung, karena cara Database Engine menggunakan kembali rencana eksekusi. Database Engine memiliki algoritma yang efisien untuk mencocokkan pernyataan T-SQL saat ini dengan rencana eksekusi yang dihasilkan untuk eksekusi sebelumnya dari pernyataan T-SQL yang sama. Jika sebuah aplikasi mengeksekusi pernyataan T-SQL dengan penanda parameter beberapa kali, Database Engine akan menggunakan ulang rencana eksekusi dari eksekusi pertama untuk eksekusi kedua dan eksekusi berikutnya (kecuali jika rencana tersebut kedaluwarsa dari cache rencana). Model persiapan/eksekusi masih memiliki manfaat berikut:
- Menemukan rencana eksekusi dengan handle pengenal lebih efisien dibandingkan algoritma yang digunakan untuk mencocokkan pernyataan T-SQL dengan rencana eksekusi yang sudah ada.
- Aplikasi dapat mengontrol kapan rencana eksekusi dibuat dan kapan digunakan kembali.
- Model persiapan/eksekusi portabel ke database lain, termasuk versi SQL Server yang lebih lama.
Sensitivitas parameter
Sensitivitas parameter, yang juga dikenal sebagai parameter sniffing, mengacu pada proses di mana Database Engine melakukan sniffing terhadap nilai parameter saat ini selama kompilasi atau rekompilasi, dan meneruskannya ke Query Optimizer untuk membantu menghasilkan rencana eksekusi kueri yang lebih efisien.
Nilai parameter dilacak selama kompilasi atau kompilasi ulang untuk jenis batch berikut:
- Prosedur tersimpan
- Kueri dikirimkan melalui
sp_executesql - Kueri yang disiapkan
Untuk informasi lebih lanjut tentang pemecahan masalah parameter sniffing, lihat:
- Menyelidiki dan mengatasi masalah sensitif parameter
- Gunakan parameter eksplisit untuk penggunaan kembali plan
- Pengoptimalan Rencana Parameter Sensitif
- Memecahkan masalah kueri terkait rencana eksekusi yang sensitif terhadap parameter di Azure SQL Database
- Menangani masalah kueri dengan rencana eksekusi kueri yang sensitif terhadap parameter di Instance Terkelola Azure SQL
Ketika sebuah query di Database Engine menggunakan petunjuk OPTION (RECOMPILE), Query Optimizer mengubah parameter dan variabel lokal menjadi konstanta waktu kompilasi yang dapat dievaluasi saat kompilasi dan direduksi menjadi literal. Selama kompilasi, optimizer mengetahui dan dapat menggunakan nilai runtime saat ini dari parameter dan variabel lokal sebagaimana mereka ada tepat sebelum pernyataan tersebut. Petunjuk OPTION (RECOMPILE) ini memungkinkan optimizer untuk menghasilkan rencana kueri yang lebih optimal yang disesuaikan dengan nilai spesifik dan memanfaatkan indeks dasar terbaik saat runtime. Untuk parameter, proses ini mengacu bukan pada nilai yang awalnya diteruskan ke batch atau prosedur tersimpan, melainkan pada nilainya pada saat rekompilasi. Nilai-nilai ini mungkin diubah dalam prosedur sebelum mencapai statement yang mencakup RECOMPILE. Perilaku ini dapat meningkatkan performa untuk kueri dengan data input yang sangat bervariasi atau tidak merata, dengan konsekuensi kompilasi kueri setiap kali dieksekusi. Biaya ini bisa sangat tinggi. Hindari menggunakan petunjuk RECOMPILE tanpa menilai dampaknya terhadap seluruh beban kerja.
Variabel lokal dan estimasi kardinalitas
Ketika sebuah kueri menggunakan variabel lokal, Database Engine tidak dapat mendeteksi nilainya saat kompilasi, sehingga memperkirakan kardinalitas menggunakan statistik atau heuristik yang tersedia. Jika statistik ada, biasanya menggunakan nilai Semua Kepadatan (juga dikenal sebagai kepadatan rata-rata) dari histogram statistik untuk memperkirakan berapa banyak baris yang cocok dengan predikat. Namun, jika tidak tersedia statistik untuk kolom tersebut, Database Engine kembali menggunakan estimasi heuristik, seperti mengasumsikan 10% selektivitas untuk predikat kesetaraan, dan 30% untuk ketidaksetaraan dan rentang. Perkiraan ini dapat menyebabkan rencana eksekusi yang kurang akurat. Berikut adalah contoh kueri yang menggunakan variabel lokal.
DECLARE @ProductId AS INT = 100;

SELECT *
FROM Products
WHERE ProductId = @ProductId;
Dalam kasus ini, Database Engine tidak menggunakan nilai 100 untuk mengoptimalkan kueri. Ini menggunakan perkiraan umum.
Pemrosesan kueri paralel
Database Engine menyediakan kueri paralel untuk mengoptimalkan eksekusi kueri dan operasi indeks pada komputer yang memiliki lebih dari satu mikroprosesor (CPU). Karena Database Engine dapat melakukan operasi kueri atau indeks secara paralel dengan menggunakan beberapa thread pekerja sistem operasi, operasi dapat selesai dengan cepat dan efisien.
Selama optimasi kueri, Database Engine mencari kueri atau operasi indeks yang mungkin mendapat manfaat dari eksekusi paralel. Untuk kueri ini, Database Engine memasukkan operator pertukaran ke dalam rencana eksekusi kueri untuk mempersiapkan kueri agar dapat dieksekusi secara paralel. Operator pertukaran adalah operator dalam rencana eksekusi kueri yang menyediakan manajemen proses, redistribusi data, dan kontrol alur. Operator pertukaran mencakup Distribute Streams, Repartition Streams, dan Gather Streams sebagai subjenis operator logis, satu atau beberapa di antaranya dapat muncul dalam output Showplan dari rencana untuk kueri paralel.
Penting
Beberapa konstruksi menghambat kemampuan Database Engine untuk menggunakan paralelisme pada seluruh rencana eksekusi, atau bagian-bagian dari rencana eksekusi.
Konstruksi yang menghambat paralelisme meliputi:
| Membangun | Deskripsi |
|---|---|
| UDF skalar | Untuk informasi lebih lanjut tentang fungsi skalar yang ditentukan pengguna, lihat Buat Fungsi yang ditentukan pengguna. Mulai dari SQL Server 2019 (15.x), Mesin Database SQL Server dapat melakukan inline pada fungsi-fungsi ini dan membuka penggunaan paralelisme selama pemrosesan kueri. Untuk informasi lebih lanjut tentang inlining UDF skalar, lihat Pemrosesan kueri cerdas dalam basis data SQL. |
| Kueri Jarak Jauh | Untuk informasi lebih lanjut tentang Remote Query, lihat Referensi operator showplan logis dan fisik. |
| Kursor dinamis | Untuk informasi lebih lanjut tentang kursor, lihat DECLARE CURSOR. |
| Kueri rekursif | Untuk informasi lebih lanjut tentang rekursi, lihat Pedoman untuk Mendefinisikan dan Menggunakan Ekspresi Tabel Umum Rekursif dan Rekursi dalam T-SQL. |
| Fungsi multi-pernyataan bernilai tabel (MSTVF) | Untuk informasi lebih lanjut tentang MSTVF, lihat Buat Fungsi yang didefinisikan pengguna (Database Engine). |
TOP kata kunci |
Untuk informasi selengkapnya, lihat TOP. |
Rencana eksekusi kueri dapat berisi atribut NonParallelPlanReason dalam elemen QueryPlan , yang menjelaskan mengapa paralelisme tidak digunakan. Nilai untuk atribut ini meliputi:
| Nilai NonParallelPlanReason | Deskripsi |
|---|---|
MaxDOPSetToOne |
Derajat paralelisme maksimum diatur ke 1. |
EstimatedDOPIsOne |
Perkiraan derajat paralelisme adalah 1. |
NoParallelWithRemoteQuery |
Paralelisme tidak didukung dalam kueri jarak jauh. |
NoParallelDynamicCursor |
Rencana paralel tidak didukung untuk kursor dinamis. |
NoParallelFastForwardCursor |
Rencana paralel tidak didukung untuk kursor maju. |
NoParallelCursorFetchByBookmark |
Rencana paralel tidak didukung untuk kursor yang diambil dengan penanda buku. |
NoParallelCreateIndexInNonEnterpriseEdition |
Pembuatan indeks paralel tidak didukung untuk edisi non-Enterprise. |
NoParallelPlansInDesktopOrExpressEdition |
Rencana paralel tidak didukung untuk edisi Desktop dan Ekspres. |
NonParallelizableIntrinsicFunction |
Kueri mereferensikan fungsi intrinsik yang tidak dapat diparalelkan. |
CLRUserDefinedFunctionRequiresDataAccess |
Paralelisme tidak didukung untuk CLR UDF yang memerlukan akses data. |
TSQLUserDefinedFunctionsNotParallelizable |
Kueri mereferensikan Fungsi yang Ditentukan Pengguna T-SQL yang tidak dapat diparalelkan. |
TableVariableTransactionsDoNotSupportParallelNestedTransaction |
Transaksi variabel tabel tidak mendukung transaksi berlapis paralel. |
DMLQueryReturnsOutputToClient |
Kueri DML mengembalikan output ke klien dan tidak dapat diparalelkan. |
MixedSerialAndParallelOnlineIndexBuildNotSupported |
Campuran rencana serial dan paralel yang tidak didukung untuk satu pembangunan indeks online. |
CouldNotGenerateValidParallelPlan |
Gagal memverifikasi rencana paralel, beralih kembali ke proses serial. |
NoParallelForMemoryOptimizedTables |
Paralelisme tidak didukung untuk tabel OLTP dalam memori yang direferensikan. |
NoParallelForDmlOnMemoryOptimizedTable |
Paralelisme tidak didukung untuk DML pada tabel OLTP Dalam Memori. |
NoParallelForNativelyCompiledModule |
Paralelisme tidak didukung untuk modul yang dikompilasi secara asli yang direferensikan. |
NoRangesResumableCreate |
Pembuatan rentang gagal untuk operasi pembuatan yang dapat dilanjutkan. |
Setelah operator pertukaran dimasukkan, hasilnya adalah rencana eksekusi kueri yang berjalan secara paralel. Rencana eksekusi paralel kueri dapat menggunakan lebih dari satu utas kerja. Rencana eksekusi serial, yang digunakan oleh kueri non-paralel (serial), hanya menggunakan satu utas kerja untuk pelaksanaannya. Jumlah aktual thread pekerja yang digunakan oleh query paralel ditentukan saat inisialisasi eksekusi rencana kueri dan bergantung pada kompleksitas rencana serta tingkat paralelisme.
Derajat paralelisme (DOP) menentukan jumlah maksimum prosesor yang dapat digunakan untuk menjalankan tugas paralel. DOP tidak menunjukkan total jumlah thread pekerja yang digunakan oleh sebuah query. Batas DOP diatur per tugas. Ini bukan batas per permintaan atau per kueri. Ini berarti bahwa selama eksekusi kueri paralel, satu permintaan dapat menelurkan beberapa tugas yang ditetapkan ke penjadwal. Lebih banyak prosesor daripada yang ditentukan oleh MAXDOP mungkin digunakan secara bersamaan pada titik tertentu selama eksekusi kueri, ketika tugas yang berbeda dijalankan secara bersamaan. Untuk informasi selengkapnya, lihat panduan thread dan arsitektur tugas.
Query Optimizer tidak menggunakan rencana eksekusi paralel untuk sebuah query jika salah satu dari kondisi berikut benar:
Rencana eksekusi serial sepele, atau tidak melebihi ambang biaya untuk pengaturan paralelisme.
Rencana eksekusi serial memiliki estimasi total biaya subtree yang lebih rendah daripada rencana eksekusi paralel yang dieksplorasi pengoptimal.
Kueri berisi operator skalar atau relasional yang tidak dapat dijalankan secara paralel. Operator tertentu dapat menyebabkan bagian rencana kueri berjalan dalam mode serial, atau seluruh rencana berjalan dalam mode serial.
Catatan
Perkiraan total biaya anak pohon dari rencana paralel dapat lebih rendah dari batas nilai untuk pengaturan paralelisme. Dengan kata lain, total estimasi biaya subtree dari rencana serial melebihinya, dan rencana query dengan total perkiraan biaya subtree yang lebih rendah dipilih.
Tingkat paralelisme (DOP)
Database Engine secara otomatis mendeteksi tingkat paralelisme terbaik untuk setiap instance eksekusi kueri paralel atau operasi bahasa definisi data indeks (DDL). Nilai ini ditentukan berdasarkan kriteria berikut:
Apakah SQL Server berjalan pada komputer yang memiliki lebih dari satu mikroprosesor atau CPU, seperti komputer multiprocessing simetris (SMP). Hanya komputer yang memiliki lebih dari satu CPU yang dapat menggunakan kueri paralel.
Apakah utas pekerja yang memadai tersedia. Setiap kueri atau operasi indeks memerlukan sejumlah utas pekerja untuk melakukan eksekusi. Menjalankan rencana paralel membutuhkan lebih banyak utas pekerja daripada rencana serial, dan jumlah utas pekerja yang diperlukan meningkat dengan tingkat paralelisme. Ketika kebutuhan worker thread dari rencana paralel untuk tingkat paralelisme tertentu tidak dapat dipenuhi, Mesin Database SQL Server secara otomatis menurunkan tingkat paralelisme, atau menjalankan rencana paralel secara serial.
Jenis operasi kueri atau indeks yang dijalankan. Operasi indeks yang membuat atau membangun kembali indeks, atau menghilangkan indeks berkluster dan kueri yang menggunakan siklus CPU sangat merupakan kandidat terbaik untuk rencana paralel. Misalnya, gabungan tabel besar, agregasi besar, dan pengurutan kumpulan hasil besar adalah kandidat yang baik. Untuk kueri dasar, yang sering ditemukan dalam aplikasi pemrosesan transaksi, koordinasi tambahan yang diperlukan untuk menjalankan kueri secara paralel lebih besar daripada potensi peningkatan kinerja. Untuk membedakan antara kueri yang mendapat manfaat dari paralelisme dan yang tidak menguntungkan, Mesin Database SQL Server membandingkan perkiraan biaya eksekusi operasi kueri atau indeks dengan ambang biaya untuk nilai paralelisme . Pengguna dapat mengubah nilai default dari
5menggunakan sp_configure jika pengujian yang tepat menemukan bahwa nilai yang berbeda lebih cocok untuk beban kerja yang sedang berjalan.Apakah ada jumlah baris yang cukup untuk diproses. Jika Pengoptimal Kueri menentukan bahwa jumlah baris terlalu rendah, pengoptimal kueri tidak memperkenalkan operator pertukaran untuk mendistribusikan baris. Dengan demikian, operator dijalankan dalam urutan secara serial. Menjalankan operator dalam rencana serial menghindari skenario ketika biaya startup, distribusi, dan koordinasi melebihi keuntungan yang dicapai oleh eksekusi operator paralel.
Apakah statistik terkini tersedia. Jika tingkat paralelisme tertinggi tidak dimungkinkan, derajat yang lebih rendah dipertimbangkan sebelum rencana paralel ditinggalkan. Misalnya, ketika Anda membuat indeks klaster pada sebuah tampilan, statistik tidak dapat dievaluasi karena indeks klaster tersebut belum ada. Dalam hal ini, Mesin Database SQL Server tidak dapat memberikan tingkat paralelisme tertinggi untuk operasi indeks. Namun, beberapa operator, seperti pengurutan dan pemindaian, masih dapat memperoleh manfaat dari eksekusi paralel.
Catatan
Operasi indeks paralel hanya tersedia di edisi SQL Server Enterprise, Developer, dan Evaluation.
Pada waktu eksekusi, Mesin Database SQL Server menentukan apakah beban kerja sistem saat ini dan informasi konfigurasi yang dijelaskan sebelumnya memungkinkan eksekusi paralel. Jika eksekusi paralel dijaga, Mesin Database SQL Server menentukan jumlah utas pekerja yang optimal dan menyebarkan eksekusi rencana paralel di seluruh utas pekerja tersebut. Saat operasi kueri atau indeks mulai dijalankan pada beberapa utas pekerja untuk eksekusi paralel, jumlah utas pekerja yang sama digunakan hingga operasi selesai. Mesin Database SQL Server memeriksa kembali jumlah keputusan utas pekerja yang optimal setiap kali rencana eksekusi diambil dari cache rencana. Misalnya, satu eksekusi dari rencana paralel yang dicache dapat berjalan secara berseri, eksekusi selanjutnya dari rencana yang sama dapat menggunakan tiga thread pekerja, dan eksekusi ketiga dapat menggunakan empat thread pekerja.
Operator pembaruan dan penghapusan dalam plan eksekusi kueri paralel dijalankan secara serial, tetapi klausul WHERE dari pernyataan UPDATE atau DELETE mungkin dijalankan secara paralel. Perubahan data aktual kemudian diterapkan secara serial ke database.
Mulai dari tingkat kompatibilitas database 110, pernyataan SELECT ... INTO dapat dijalankan secara paralel. Bentuk operator insert lainnya bekerja dengan cara yang sama seperti yang dijelaskan pada versi sebelumnya.
Mulai dari tingkat kompatibilitas database 130, pernyataan INSERT ... SELECT dapat dijalankan secara paralel saat menyisipkan data ke heap atau indeks clustered columnstore (CCI), dan menggunakan hint TABLOCK. Sisipan ke dalam tabel sementara lokal (diidentifikasi dengan awalan #) dan tabel sementara global (diidentifikasi dengan awalan ##) juga diaktifkan untuk paralelisme menggunakan petunjuk TABLOCK ini. Untuk informasi selengkapnya, lihat INSERT .
Kursor statis dan berbasis keyset dapat diisi oleh rencana eksekusi paralel. Namun, perilaku kursor dinamis hanya dapat disediakan oleh eksekusi serial. Pengoptimal Kueri selalu menghasilkan rencana eksekusi serial untuk kueri yang merupakan bagian dari kursor dinamis.
Mengambil alih tingkat paralelisme
Tingkat paralelisme mengatur jumlah prosesor yang akan digunakan dalam eksekusi rencana paralel. Anda dapat mengatur konfigurasi ini pada berbagai level:
Pada tingkat server, dengan menggunakan opsi konfigurasi server max degree of parallelism (
MAXDOP).Berlaku untuk: SQL Server
SQL Server 2019 (15.x) memperkenalkan rekomendasi otomatis untuk mengatur
MAXDOPopsi konfigurasi server selama proses instalasi. Antarmuka pengguna penyiapan memungkinkan Anda menerima pengaturan yang direkomendasikan atau memasukkan nilai Anda sendiri. Untuk informasi selengkapnya, lihat Halaman Konfigurasi Mesin Database - MaxDOP.Level beban kerja, dengan menggunakan
MAX_DOPopsi konfigurasi grup beban kerja Resource Governor.Berlaku untuk: SQL Server
Tingkat basis data, dengan menggunakan
MAXDOPkonfigurasi cakupan basis data.Berlaku untuk: SQL Server, Azure SQL Database, dan Azure SQL Managed Instance
Tingkat pernyataan kueri atau indeks, dengan menggunakan
MAXDOPMAXDOPatau opsi indeks. Misalnya, Anda dapat menggunakan opsiMAXDOPuntuk mengendalikan, dengan menambah atau mengurangi, jumlah prosesor yang didedikasikan untuk operasi indeks online. Dengan cara ini, Anda dapat menyeimbangkan sumber daya yang digunakan oleh operasi indeks dengan sumber daya pengguna serentak.Berlaku untuk: SQL Server, Azure SQL Database, dan Azure SQL Managed Instance
Mengatur max degree of parallelism opsi ke 0 (default) memungkinkan Database Engine menggunakan semua prosesor yang tersedia hingga maksimal 64 prosesor dalam eksekusi rencana paralel. Meskipun Database Engine menetapkan target runtime sebanyak 64 prosesor logis ketika MAXDOP opsi diatur ke 0, Anda dapat mengatur nilai berbeda secara manual jika diperlukan. Pengaturan MAXDOP ke 0 untuk kueri dan indeks memungkinkan Database Engine menggunakan semua prosesor yang tersedia hingga maksimal 64 prosesor untuk kueri atau indeks yang diberikan dalam eksekusi rencana paralel.
MAXDOP bukan nilai yang dipaksakan untuk semua kueri paralel, melainkan target indikatif untuk semua kueri yang memenuhi syarat untuk paralelisme. Ini berarti jika tidak cukup thread pekerja yang tersedia saat runtime, sebuah query mungkin dijalankan dengan tingkat paralelisme yang lebih rendah daripada opsi konfigurasi server MAXDOP.
Tips
Untuk informasi lebih lanjut, lihat rekomendasi MAXDOP untuk pedoman konfigurasi MAXDOP di tingkat server, database, query, atau hint.
Contoh kueri paralel
Kueri berikut menghitung jumlah pesanan yang dilakukan pada kuartal tertentu, mulai 1 April 2024, dan di mana setidaknya satu item pesanan diterima oleh pelanggan lebih lambat dari tanggal yang dikomitmenkan. Kueri ini mencantumkan jumlah pesanan tersebut yang dikelompokkan menurut setiap prioritas pesanan dan diurutkan dalam urutan prioritas naik.
Contoh ini menggunakan nama tabel dan kolom teoritis.
SELECT o_orderpriority,
       COUNT(*) AS Order_Count
FROM orders
WHERE o_orderdate >= '2024/04/01'
      AND o_orderdate < DATEADD(mm, 3, '2024/04/01')
      AND EXISTS (SELECT *
                  FROM lineitem
                  WHERE l_orderkey = o_orderkey
                        AND l_commitdate < l_receiptdate)
GROUP BY o_orderpriority
ORDER BY o_orderpriority;
Asumsikan indeks berikut ditentukan pada lineitem tabel dan orders :
CREATE INDEX l_order_dates_idx
    ON lineitem(l_orderkey, l_receiptdate, l_commitdate, l_shipdate);

CREATE UNIQUE INDEX o_datkeyopr_idx
    ON ORDERS(o_orderdate, o_orderkey, o_custkey, o_orderpriority);
Berikut adalah salah satu kemungkinan rencana paralel yang dihasilkan untuk kueri yang sebelumnya diperlihatkan:
|--Stream Aggregate(GROUP BY:([ORDERS].[o_orderpriority])
                  DEFINE:([Expr1005]=COUNT(*)))
    |--Parallelism(Gather Streams, ORDER BY:
                  ([ORDERS].[o_orderpriority] ASC))
         |--Stream Aggregate(GROUP BY:
                  ([ORDERS].[o_orderpriority])
                  DEFINE:([Expr1005]=Count(*)))
              |--Sort(ORDER BY:([ORDERS].[o_orderpriority] ASC))
                   |--Merge Join(Left Semi Join, MERGE:
                  ([ORDERS].[o_orderkey])=
                        ([LINEITEM].[l_orderkey]),
                  RESIDUAL:([ORDERS].[o_orderkey]=
                        [LINEITEM].[l_orderkey]))
                        |--Sort(ORDER BY:([ORDERS].[o_orderkey] ASC))
                        |    |--Parallelism(Repartition Streams,
                           PARTITION COLUMNS:
                           ([ORDERS].[o_orderkey]))
                        |         |--Index Seek(OBJECT:
                     ([tpcd1G].[dbo].[ORDERS].[O_DATKEYOPR_IDX]),
                     SEEK:([ORDERS].[o_orderdate] >=
                           Apr  1 2024 12:00AM AND
                           [ORDERS].[o_orderdate] <
                           Jul  1 2024 12:00AM) ORDERED)
                        |--Parallelism(Repartition Streams,
                     PARTITION COLUMNS:
                     ([LINEITEM].[l_orderkey]),
                     ORDER BY:([LINEITEM].[l_orderkey] ASC))
                             |--Filter(WHERE:
                           ([LINEITEM].[l_commitdate]<
                           [LINEITEM].[l_receiptdate]))
                                  |--Index Scan(OBJECT:
         ([tpcd1G].[dbo].[LINEITEM].[L_ORDER_DATES_IDX]), ORDERED)
Ilustrasi berikut menunjukkan rencana kueri yang dijalankan dengan tingkat paralelisme sama dengan 4 dan melibatkan gabungan dua tabel.
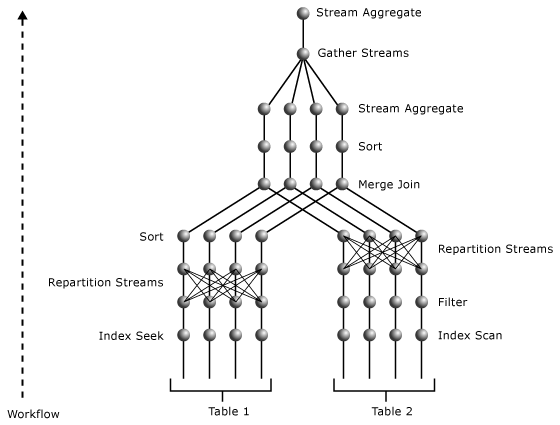
Rencana paralel berisi tiga operator paralelisme. Operator Pencarian Indeks o_datkey_ptr dan operator Pemindaian Indeks l_order_dates_idx dilakukan secara paralel. Proses ini menghasilkan beberapa stream terpisah, yang dapat ditentukan dari operator Paralelisme terdekat di atas operator Index Scan dan Index Seek, masing-masing. Kedua operator melakukan pembagian ulang tipe pertukaran. Mereka menyusun ulang data di antara aliran dan menghasilkan jumlah aliran yang sama pada output mereka seperti pada input mereka. Jumlah aliran ini sama dengan tingkat paralelisme.
Operator paralelisme di atas operator l_order_dates_idx Index Scan mempartisi ulang aliran inputnya menggunakan nilai L_ORDERKEY sebagai kunci. Dengan cara ini, nilai L_ORDERKEY yang sama berakhir di aliran output yang sama. Pada saat yang sama, aliran output mempertahankan urutan pada kolom L_ORDERKEY untuk memenuhi persyaratan input operator Merge Join.
Operator paralelisme di atas operator Index Seek mempartisi ulang aliran inputnya menggunakan nilai O_ORDERKEY. Karena inputnya tidak diurutkan berdasarkan nilai kolom O_ORDERKEY dan kolom ini adalah kolom join di operator Merge Join, operator Sort antara operator paralelisme dan Merge Join memastikan bahwa input diurutkan untuk operator Merge Join pada kolom join. Operator Sort, seperti operator Merge Join, dilakukan secara paralel.
Operator paralelisme paling atas mengumpulkan hasil dari beberapa aliran ke dalam satu aliran. Agregasi parsial yang dilakukan oleh operator Agregat Aliran di bawah operator paralelisme kemudian diakumulasikan menjadi satu nilai SUM untuk setiap nilai O_ORDERPRIORITY yang berbeda pada operator Agregat Aliran di atas operator paralelisme. Karena rencana ini memiliki dua segmen pertukaran, dengan derajat paralelisme sama dengan 4, ia menggunakan delapan thread pekerja.
Untuk informasi lebih lanjut tentang operator yang digunakan dalam contoh ini, lihat referensi operator showplan logis dan fisik.
Operasi indeks paralel
Rencana kueri untuk operasi indeks yang membuat atau membangun ulang indeks, atau menghapus indeks klaster, dapat mendukung operasi paralel multithreaded pada komputer yang memiliki beberapa prosesor.
Catatan
Operasi indeks paralel hanya tersedia di edisi Enterprise.
Database Engine menggunakan algoritma yang sama untuk menentukan tingkat paralelisme (jumlah total thread pekerja terpisah yang akan dijalankan) untuk operasi indeks seperti halnya untuk kueri lainnya. Opsi konfigurasi server max degree of parallelism menetapkan tingkat paralelisme maksimum untuk operasi indeks. Anda dapat menimpa max degree of parallelism nilai untuk operasi indeks individual dengan mengatur MAXDOP opsi indeks pada CREATE INDEXpernyataan , ALTER INDEX, DROP INDEX, dan ALTER TABLE .
Ketika Mesin Database SQL Server membangun rencana eksekusi indeks, jumlah operasi paralel diatur ke nilai terendah dari nilai-nilai berikut:
- Jumlah prosesor, atau CPU, di komputer.
- Nomor yang ditentukan dalam opsi konfigurasi server
max degree of parallelism. - Jumlah CPU yang belum berada di atas ambang batas beban kerja yang dilakukan untuk thread pekerja SQL Server.
Sebagai contoh, pada komputer yang memiliki delapan CPU, tetapi di mana max degree of parallelism diatur ke 6, operasi indeks menggunakan tidak lebih dari enam thread pekerja paralel. Jika lima CPU di komputer melebihi ambang batas pekerjaan SQL Server saat rencana eksekusi indeks dibangun, rencana eksekusi hanya menentukan tiga utas pekerja paralel.
Fase utama dari operasi indeks paralel meliputi:
- Thread pekerja yang mengoordinasi dengan cepat dan secara acak memindai tabel untuk memperkirakan distribusi kunci indeks. Thread pekerja koordinasi menetapkan batas kunci yang menciptakan sejumlah rentang kunci sama dengan derajat operasi paralel, di mana setiap rentang kunci diperkirakan mencakup jumlah baris yang serupa. Sebagai contoh, jika terdapat empat juta baris dalam tabel dan derajat paralelisme adalah 4, thread pekerja koordinasi menentukan nilai kunci yang membatasi empat set baris dengan 1 juta baris di setiap set. Jika thread pekerja koordinasi tidak dapat menetapkan cukup rentang kunci untuk menggunakan semua CPU, maka thread tersebut akan mengurangi tingkat paralelisme.
- Utas pekerja yang mengoordinasikan mendistribusikan sejumlah utas pekerja sesuai dengan jumlah operasi paralel dan menunggu utas pekerja tersebut menyelesaikan tugas mereka. Setiap utas pekerja memindai tabel dasar menggunakan filter yang hanya mengambil baris yang nilai kuncinya berada dalam rentang yang telah ditetapkan untuk utas pekerja. Setiap utas pekerja membangun struktur indeks untuk baris dalam rentang kuncinya. Dalam kasus indeks yang dipartisi, setiap utas pekerja membangun sejumlah partisi tertentu. Partisi tidak dibagikan di antara utas pekerja.
- Setelah semua thread pekerja paralel selesai, thread worker yang mengkoordinasi menghubungkan subunit indeks menjadi satu indeks. Fase ini hanya berlaku untuk operasi indeks offline.
Pernyataan CREATE TABLE atau ALTER TABLE individual dapat memiliki beberapa kendala yang memerlukan pembuatan indeks. Beberapa operasi pembuatan indeks ini dilakukan secara seri, meskipun setiap operasi pembuatan indeks individu mungkin merupakan operasi paralel pada komputer yang memiliki beberapa CPU.
Arsitektur kueri terdistribusi
Database Engine mendukung dua metode untuk merujuk sumber data OLE DB heterogen dalam pernyataan T-SQL:
Nama server tertaut
Gunakan prosedur tersimpan sistem
sp_addlinkedserverdansp_addlinkedsrvloginuntuk memberikan nama server pada sumber data OLE DB. Anda dapat merujuk objek di server yang terhubung ini dalam pernyataan T-SQL dengan nama empat bagian. Misalnya, jika namaDeptSQLSrvrserver tertaut didefinisikan untuk instans SQL Server lain, pernyataan berikut mengacu pada tabel di server tersebut:SELECT JobTitle, HireDate FROM DeptSQLSrvr.AdventureWorks2025.HumanResources.Employee;Anda juga dapat menentukan nama server yang ditautkan dalam pernyataan
OPENQUERYuntuk membuka rowset dari sumber data OLE DB. Anda kemudian dapat merujuk rowset ini seperti tabel dalam pernyataan T-SQL.Nama konektor ad hoc
Untuk referensi yang jarang ke sumber data, tentukan fungsi
OPENROWSETatauOPENDATASOURCEdengan informasi yang diperlukan untuk terhubung ke linked server. Anda kemudian dapat merujuk rowset dengan cara yang sama seperti Anda mereferensikan tabel dalam pernyataan T-SQL:SELECT a.* FROM OPENROWSET ( 'Microsoft.Jet.OLEDB.4.0', 'MSOffice\Access\Samples\Northwind.mdb'; 'Admin'; '', Employees ) AS a;
Database Engine menggunakan OLE DB untuk berkomunikasi antara mesin relasional dan mesin penyimpanan. Mesin relasional memecah setiap pernyataan T-SQL menjadi serangkaian operasi pada set baris dasar OLE DB yang dibuka mesin penyimpanan dari tabel dasar. Proses ini berarti mesin relasional juga dapat membuka rowset dasar OLE DB pada sumber data OLE DB mana pun.
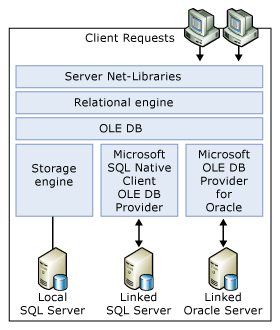
Mesin relasional menggunakan antarmuka pemrograman aplikasi (API) OLE DB untuk membuka set baris di server tertaut, mengambil baris, dan mengelola transaksi.
Untuk setiap sumber data OLE DB yang Anda akses sebagai server tertaut, server yang menjalankan SQL Server harus memiliki penyedia OLE DB. Set operasi T-SQL yang dapat Anda gunakan terhadap sumber data OLE DB tertentu bergantung pada kemampuan penyedia OLE DB.
Untuk setiap instance SQL Server, anggota fixed server role sysadmin dapat mengaktifkan atau menonaktifkan penggunaan nama konektor ad hoc untuk penyedia OLE DB dengan menggunakan properti SQL Server DisallowAdhocAccess. Ketika Anda mengaktifkan akses ad hoc, setiap pengguna yang log masuk ke instance tersebut dapat menjalankan pernyataan T-SQL yang berisi nama konektor ad hoc, merujuk pada sumber data apa pun di jaringan yang dapat diakses oleh penyedia OLE DB. Untuk mengontrol akses ke sumber data, anggota peran server tetap sysadmin dapat menonaktifkan akses ad hoc untuk penyedia OLE DB tersebut, sehingga membatasi pengguna hanya pada sumber data yang dirujuk oleh nama server tertaut yang didefinisikan oleh administrator. Secara default, akses ad hoc diaktifkan untuk penyedia SQL Server OLE DB, dan dinonaktifkan untuk semua penyedia OLE DB lainnya.
Kueri terdistribusi dapat memungkinkan pengguna mengakses sumber data lain (misalnya, file, sumber data non-relasional seperti Direktori Aktif, dan sebagainya) dengan menggunakan konteks keamanan dari akun Windows yang digunakan untuk menjalankan layanan SQL Server. SQL Server menggunakan konteks keamanan login dengan tepat untuk login Windows. Namun, penyamaran tersebut tidak dimungkinkan untuk login SQL Server. Batasan ini berpotensi memungkinkan pengguna kueri terdistribusi mengakses sumber data lain yang tidak memiliki izin untuk mereka akses, tetapi akun yang digunakan layanan SQL Server untuk berjalan memang memiliki izin. Gunakan sp_addlinkedsrvlogin untuk menentukan login tertentu yang berwenang untuk mengakses server tertaut yang sesuai. Opsi ini tidak tersedia untuk nama ad hoc, jadi berhati-hatilah saat mengaktifkan penyedia OLE DB untuk akses ad hoc.
Jika memungkinkan, Database Engine mendorong operasi relasional seperti join, pembatasan, proyeksi, pengurutan, dan operasi GROUP BY ke sumber data OLE DB. Database Engine secara bawaan tidak memindai tabel dasar di SQL Server dan melakukan operasi relasional itu sendiri. Database Engine menanyakan penyedia OLE DB untuk menentukan tingkat tata bahasa SQL yang didukungnya, dan berdasarkan informasi tersebut, mendorong sebanyak mungkin operasi relasional ke penyedia.
Database Engine menentukan mekanisme bagi penyedia OLE DB untuk mengembalikan statistik yang menunjukkan bagaimana nilai kunci didistribusikan dalam sumber data OLE DB. Mekanisme ini memungkinkan Database Engine Query Optimizer menganalisis pola data dalam sumber data dengan lebih baik terhadap kebutuhan setiap pernyataan T-SQL, meningkatkan kemampuan Query Optimizer untuk menghasilkan rencana eksekusi yang optimal.
Pemrosesan kueri pada tabel dan indeks yang dipartisi
Database Engine mendukung pemrosesan kueri yang sadar partisi untuk tabel dan indeks yang dipartisi. Bagian ini menjelaskan bagaimana prosesor kueri menangani objek yang dipartisi, cara menginterpretasikan rencana eksekusi yang melibatkan partisi, dan praktik terbaik untuk meningkatkan kinerja kueri pada objek yang dipartisi.
Catatan
Tabel dan indeks terpartisi didukung dalam edisi SQL Server Standard, mulai dari SQL Server 2016 (13.x) dengan Service Pack 1.
Operasi pencarian baru yang memahami partisi
Di Database Engine, prosesor kueri secara internal melihat tabel yang dipartisi sebagai indeks multikolom dengan PartitionID sebagai kolom terdepan.
PartitionID adalah kolom komputasi tersembunyi yang digunakan secara internal untuk mewakili ID partisi yang berisi baris tertentu. Misalnya, anggap tabel T, yang didefinisikan sebagai T(a, b, c), dipartisi pada kolom a, dan memiliki indeks berkelompok pada kolom b. Tabel yang dipartisi ini diperlakukan sebagai tabel yang tidak dipartisi dengan skema T(PartitionID, a, b, c) dan indeks berkelompok pada kunci komposit (PartitionID, b). Representasi ini memungkinkan Query Optimizer melakukan operasi pencarian berdasarkan PartitionID pada tabel atau indeks yang dipartisi mana pun.
Penghapusan partisi sekarang dilakukan dalam operasi pencarian ini.
Selain itu, Query Optimizer diperluas sehingga operasi pencarian atau pemindaian dengan satu kondisi dapat dilakukan pada PartitionID (sebagai kolom awal logis) dan mungkin kolom kunci indeks lainnya. Prosesor kueri kemudian melakukan pencarian tingkat kedua, dengan kondisi berbeda, pada satu atau lebih kolom tambahan, untuk setiap nilai berbeda yang memenuhi kualifikasi operasi pencarian tingkat pertama. Operasi ini, yang disebut pemindaian skip partisi, memungkinkan Query Optimizer melakukan operasi pencarian atau pemindaian berdasarkan satu kondisi untuk menentukan partisi yang akan diakses, dan operasi pencarian indeks tingkat kedua dalam operator tersebut untuk mengembalikan baris dari partisi tersebut yang memenuhi kondisi berbeda. Misalnya, pertimbangkan kueri berikut.
SELECT *
FROM T
WHERE a < 10
      AND b = 2;
Untuk contoh ini, asumsikan bahwa tabel T, yang didefinisikan sebagai T(a, b, c), dipartisi pada kolom a, dan memiliki indeks berkelompok pada kolom b. Fungsi partisi berikut mendefinisikan batas partisi untuk tabel T:
CREATE PARTITION FUNCTION myRangePF1(INT)
    AS RANGE LEFT
    FOR VALUES (3, 7, 10);
Untuk menyelesaikan kueri, prosesor kueri melakukan operasi pencarian tingkat pertama untuk menemukan setiap partisi yang berisi baris yang memenuhi kondisi T.a < 10. Operasi ini mengidentifikasi partisi yang akan diakses. Dalam setiap partisi yang diidentifikasi, prosesor kemudian melakukan pencarian tingkat kedua ke indeks yang terklaster pada kolom b untuk menemukan baris yang memenuhi kondisi T.b = 2 dan T.a < 10.
Ilustrasi berikut adalah representasi logis dari operasi pemindaian skip partisi. Ini memperlihatkan tabel T dengan data dalam kolom a dan b. Partisi diberi nomor 1 hingga 4 dengan batas partisi yang ditunjukkan oleh garis vertikal putus-putus. Operasi pencarian tingkat pertama ke partisi (tidak ditunjukkan dalam ilustrasi) menentukan bahwa partisi 1, 2, dan 3 memenuhi kondisi pencarian yang diimplikasikan oleh pemartisian yang didefinisikan untuk tabel dan predikat pada kolom a (T.a < 10). Jalur yang dilalui oleh seek tingkat kedua diilustrasikan oleh garis melengkung. Pada dasarnya, operasi ini menelusuri setiap partisi ini untuk baris yang memenuhi kondisi b = 2. Total biaya operasi sama dengan tiga operasi index seek yang terpisah.
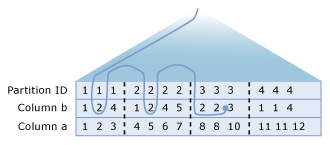
Menampilkan informasi partisi dalam rencana eksekusi kueri
Periksa rencana eksekusi kueri pada tabel dan indeks yang dipartisi dengan menggunakan pernyataan SET SHOWPLAN_XML T-SQL SET atau SET STATISTICS XML, atau dengan menggunakan output rencana eksekusi grafis di SSMS. Misalnya, Anda dapat menampilkan rencana eksekusi waktu kompilasi dengan memilih Tampilkan Rencana Eksekusi Perkiraan pada toolbar Editor Kueri dan rencana run-time dengan memilih Sertakan Rencana Eksekusi Aktual.
Dengan menggunakan alat-alat ini, Anda dapat menemukan informasi berikut:
- Operasi seperti pemindaian, pencarian, penyisipan, pembaruan, penggabungan, dan penghapusan yang mengakses tabel atau indeks yang dipartisi.
- Partisi yang diakses oleh kueri. Sebagai contoh, rencana eksekusi run-time mencakup total jumlah partisi yang diakses dan rentang partisi yang berurutan yang diakses.
- Ketika operasi pemindaian skip partisi digunakan dalam operasi pencarian atau pemindaian untuk mengambil data dari satu atau lebih partisi.
Penyempurnaan informasi partisi
Database Engine menyediakan informasi partisi yang ditingkatkan untuk baik rencana eksekusi pada waktu kompilasi maupun saat run-time. Rencana eksekusi sekarang memberikan informasi berikut:
- Atribut opsional
Partitionedyang menunjukkan bahwa operator, seperti seek, scan, insert, update, merge, atau delete, dilakukan pada tabel yang dipartisi. - Elemen baru
SeekPredicateNewdengan subelemenSeekKeysyang menyertakanPartitionIDsebagai kolom kunci indeks utama dan kondisi filter yang menentukan pencarian rentang padaPartitionID. Kehadiran duaSeekKeyssubelemen menunjukkan pemindaian skip partisi padaPartitionID. - Informasi ringkasan yang menyediakan jumlah total partisi yang diakses. Informasi ini dapat diakses hanya dalam rencana waktu berjalan.
Untuk menunjukkan bagaimana informasi ini ditampilkan dalam output rencana eksekusi grafis dan output XML Showplan, pertimbangkan kueri berikut pada tabel fact_salesyang dipartisi . Kueri ini memperbarui data dalam dua partisi.
UPDATE fact_sales
    SET quantity = quantity - 2
WHERE date_id BETWEEN 20190802 AND 20190902;
Ilustrasi berikut menunjukkan properti Clustered Index Seek operator dalam rencana eksekusi runtime untuk kueri ini. Untuk melihat definisi fact_sales tabel dan definisi partisi, lihat Contoh.
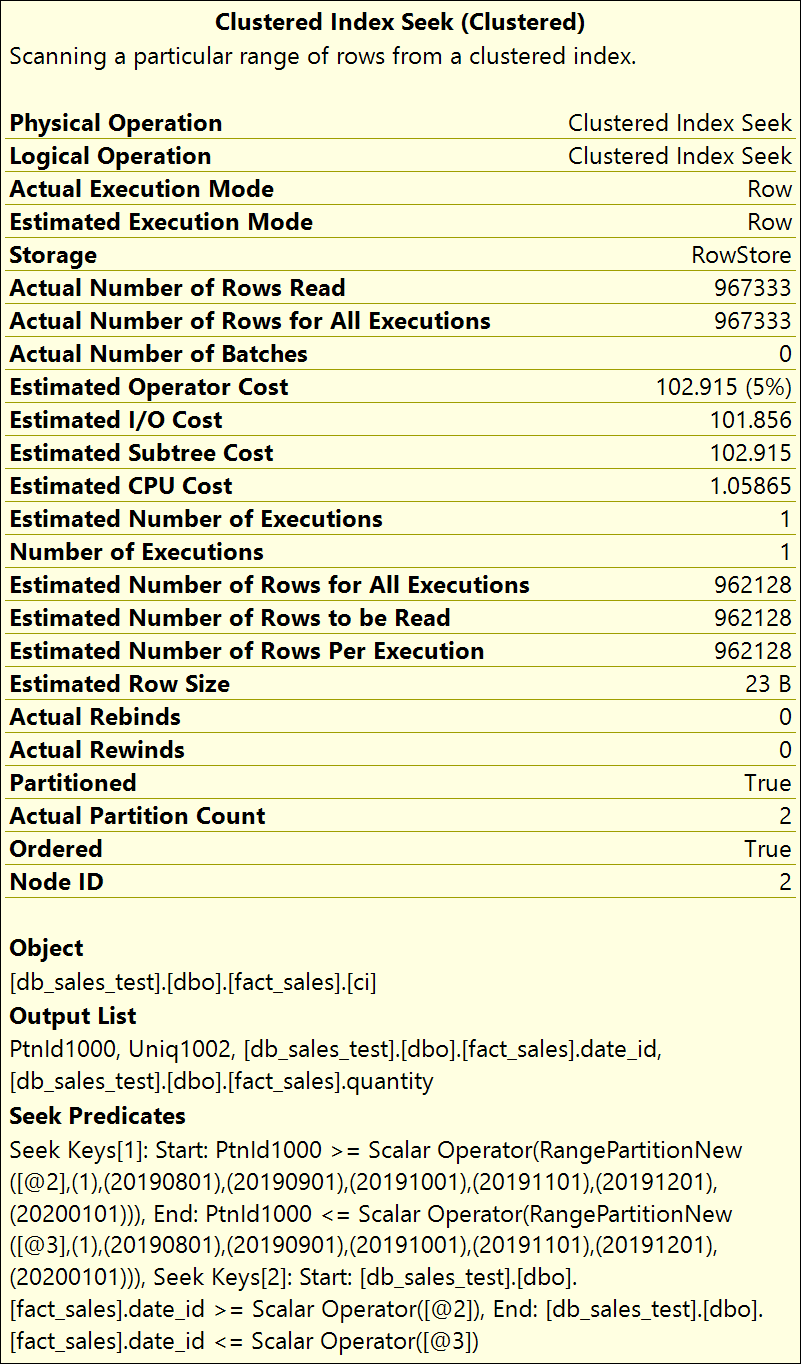
Atribut yang dipartisi
Saat operator seperti Pencarian Indeks dieksekusi pada tabel atau indeks yang dipartisi, atribut Partitioned muncul dalam rencana waktu kompilasi dan waktu eksekusi, dan diatur ke True (1). Atribut tidak muncul saat diatur ke False (0).
Atribut Partitioned dapat muncul di operator fisik dan logis berikut:
- Pemindaian Tabel
- Pemindaian Indeks
- Pencarian Indeks
- Sisipkan
- Perbarui
- Hapus
- Penggabungan
Seperti yang ditunjukkan pada ilustrasi sebelumnya, atribut ini muncul dalam properti operator tempat atribut tersebut didefinisikan. Dalam output XML Showplan, atribut ini muncul seperti Partitioned="1" pada RelOp node operator tempat atribut tersebut didefinisikan.
Predikat pencarian baru
Dalam output XML Showplan, SeekPredicateNew elemen muncul di operator tempat elemen tersebut didefinisikan. Ini dapat berisi hingga dua kemunculan SeekKeys subelemen. Item pertama SeekKeys menentukan operasi pencarian tingkat pertama pada tingkat ID partisi indeks logis. Artinya, operasi seek ini menentukan partisi yang harus diakses untuk memenuhi kondisi kueri. Item kedua SeekKeys menentukan pencarian tingkat kedua yang terjadi dalam setiap partisi yang diidentifikasi dalam pencarian tingkat pertama.
Informasi ringkasan partisi
Dalam rencana eksekusi saat berjalan, informasi ringkasan partisi menyajikan jumlah partisi yang diakses dan identitas partisi aktual yang diakses. Anda dapat menggunakan informasi ini untuk memverifikasi bahwa partisi yang benar diakses dalam kueri dan bahwa semua partisi lain dihilangkan dari pertimbangan.
Informasi berikut disediakan: Actual Partition Count, dan Partitions Accessed.
Actual Partition Count adalah jumlah total partisi yang diakses oleh kueri.
Partitions Accessed, dalam output XML Showplan, adalah informasi ringkasan partisi yang muncul dalam elemen baru RuntimePartitionSummary di RelOp node operator tempat elemen tersebut didefinisikan. Contoh berikut menunjukkan konten RuntimePartitionSummary elemen, menunjukkan bahwa dua total partisi diakses (partisi 2 dan 3).
<RunTimePartitionSummary>
    <PartitionsAccessed PartitionCount="2" >
        <PartitionRange Start="2" End="3" />
    </PartitionsAccessed>
</RunTimePartitionSummary>
Tampilkan informasi partisi dengan menggunakan metode showplan lain
Metode Showplan SHOWPLAN_ALL, SHOWPLAN_TEXT, dan STATISTICS PROFILE tidak melaporkan informasi partisi yang dijelaskan dalam artikel ini, dengan pengecualian berikut. Sebagai bagian SEEK dari predikat, partisi yang akan diakses diidentifikasi oleh predikat rentang pada kolom komputasi yang mewakili ID partisi. Contoh berikut menunjukkan predikat SEEK untuk sebuah operator Clustered Index Seek. Partisi 2 dan 3 diakses, dan operator pencarian memfilter pada baris yang memenuhi kondisi date_id BETWEEN 20190802 AND 20190902.
|--Clustered Index Seek(OBJECT:([db_sales_test].[dbo].[fact_sales].[ci]),
        SEEK:([PtnId1000] >= (2) AND [PtnId1000] <= (3)
                AND [db_sales_test].[dbo].[fact_sales].[date_id] >= (20190802)
                AND [db_sales_test].[dbo].[fact_sales].[date_id] <= (20190902))
                ORDERED FORWARD)
Menginterpretasikan rencana eksekusi untuk tumpukan yang dipartisi
Tumpukan yang dipartisi diperlakukan sebagai indeks logis pada ID partisi. Dalam rencana eksekusi, eliminasi partisi pada heap yang dipartisi direpresentasikan sebagai Table Scan operator dengan SEEK predikat pada ID partisi. Contoh berikut menunjukkan informasi Showplan yang disediakan:
|-- Table Scan (OBJECT: ([db].[dbo].[T]), SEEK: ([PtnId1001]=[Expr1011]) ORDERED FORWARD)
Menginterpretasikan rencana eksekusi untuk gabungan yang dikolokasi
Kolokasi gabungan dapat terjadi ketika dua tabel dipartisi menggunakan fungsi partisi yang sama atau setara dan kolom partisi dari kedua sisi gabungan ditentukan dalam kondisi gabungan kueri. Pengoptimal Kueri dapat menghasilkan rencana di mana partisi setiap tabel yang memiliki ID partisi yang sama digabungkan secara terpisah. Gabungan yang dikolokasi dapat lebih cepat daripada gabungan yang tidak dikolokasi karena dapat membutuhkan lebih sedikit memori dan waktu pemrosesan. Pengoptimal Kueri memilih paket yang tidak dikolokasi atau paket yang dikolokasi berdasarkan perkiraan biaya.
Dalam rencana yang berkolokasi, Nested Loops gabungan membaca satu atau beberapa tabel atau partisi indeks dari sisi dalam. Angka dalam Constant Scan operator mewakili nomor partisi.
Ketika rencana paralel untuk penggabungan yang dikolokasikan dihasilkan untuk tabel atau indeks yang dipartisi, operator Paralelisme muncul di antara operator join Constant Scan dan Nested Loops. Dalam kasus ini, beberapa utas pekerja di bagian luar gabungan masing-masing membaca dan bekerja pada partisi yang berbeda.
Ilustrasi berikut menunjukkan rencana kueri paralel untuk gabungan yang dikolokasi.
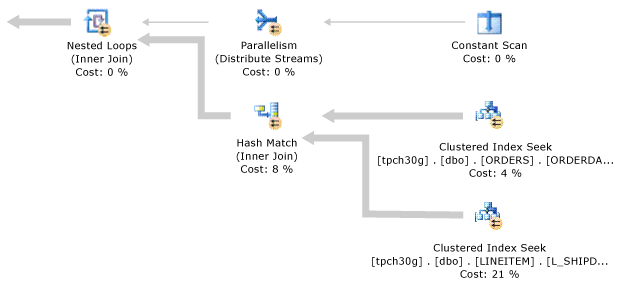
Strategi eksekusi kueri paralel untuk objek yang dipartisi
Prosesor kueri menggunakan strategi eksekusi paralel untuk kueri yang memilih dari objek yang dipartisi. Sebagai bagian dari strategi eksekusi, prosesor kueri menentukan partisi tabel yang diperlukan untuk kueri, dan proporsi utas pekerja untuk dialokasikan ke setiap partisi. Dalam kebanyakan kasus, prosesor kueri mengalokasikan jumlah thread pekerja yang sama atau hampir sama ke setiap partisi, kemudian menjalankan kueri secara paralel pada partisi-partisi tersebut. Paragraf berikut menjelaskan alokasi utas pekerja secara lebih rinci.
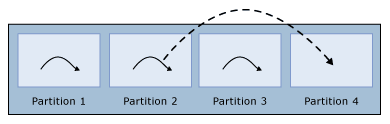
Jika jumlah utas pekerja kurang dari jumlah partisi, prosesor kueri menetapkan setiap utas pekerja ke partisi yang berbeda, awalnya meninggalkan satu atau beberapa partisi tanpa utas pekerja yang ditetapkan. Ketika thread pekerja selesai dijalankan pada partisi, prosesor query akan menugaskannya ke partisi berikutnya hingga setiap partisi diberikan satu thread pekerja tunggal. Penugasan ini adalah satu-satunya kasus di mana prosesor kueri mengalokasikan ulang thread pekerja ke partisi-partisi lain.
Memperlihatkan utas yang ditetapkan ulang bagi pekerja setelah selesai. Jika jumlah utas pekerja sama dengan jumlah partisi, prosesor kueri menetapkan satu utas pekerja ke setiap partisi. Ketika utas pekerja selesai, utas tersebut tidak dialokasikan kembali ke partisi lain.
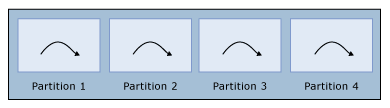
Jika jumlah utas pekerja lebih besar dari jumlah partisi, prosesor kueri mengalokasikan jumlah utas pekerja yang sama untuk setiap partisi. Jika jumlah thread pekerja tidak merupakan kelipatan tepat dari jumlah partisi, prosesor query mengalokasikan satu thread pekerja tambahan ke beberapa partisi untuk menggunakan semua thread pekerja yang tersedia. Jika hanya ada satu partisi, semua thread pekerja akan ditetapkan ke partisi tersebut. Pada diagram berikut, terdapat empat partisi dan 14 thread pekerja. Setiap partisi memiliki tiga thread pekerja yang ditugaskan, dan dua partisi memiliki satu thread pekerja tambahan, sehingga total 14 thread pekerja ditugaskan. Ketika utas pekerja selesai, utas tersebut tidak dialokasikan ulang ke bagian lain.
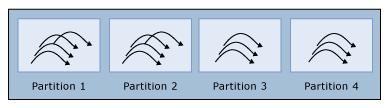
Meskipun contoh sebelumnya menunjukkan cara yang sederhana untuk mengalokasikan thread pekerja, strategi sebenarnya lebih kompleks dan memperhitungkan variabel lain yang terjadi selama eksekusi query. Misalnya, jika tabel dipartisi dan memiliki indeks berkelompok pada kolom A serta sebuah kueri memiliki klausa predikat WHERE A IN (13, 17, 25), prosesor kueri mengalokasikan satu atau lebih thread pekerja ke masing-masing dari tiga nilai pencarian ini (A = 13, A = 17, dan A = 25) alih-alih setiap partisi tabel. Hanya perlu menjalankan query di partisi yang berisi nilai-nilai ini, dan jika semua predikat seek ini berada di partisi tabel yang sama, semua thread pekerja akan ditetapkan ke partisi tabel yang sama.
Untuk mengambil contoh lain, misalkan tabel memiliki empat partisi pada kolom A dengan titik batas (10, 20, 30), indeks pada kolom B, dan kueri memiliki klausa WHERE B IN (50, 100, 150)predikat . Karena partisi tabel didasarkan pada nilai A, nilai B dapat muncul di partisi tabel mana pun. Dengan demikian, prosesor kueri mencari masing-masing dari tiga nilai B (50, 100, 150) di masing-masing dari empat partisi tabel. Prosesor kueri menetapkan thread pekerja secara proporsional sehingga dapat menjalankan masing-masing dari 12 pemindaian kueri ini secara paralel.
Partisi tabel berdasarkan kolom A |
Mencari kolom B di setiap partisi tabel |
|---|---|
Partisi Tabel 1: A < 10 |
B = 50, B = 100, B = 150 |
Partisi Tabel 2: A >= 10 AND A < 20 |
B = 50, B = 100, B = 150 |
Partisi Tabel 3: A >= 20 AND A < 30 |
B = 50, B = 100, B = 150 |
Partisi Tabel 4: A >= 30 |
B = 50, B = 100, B = 150 |
Praktik terbaik
Untuk meningkatkan kinerja kueri yang mengakses sejumlah besar data dari tabel dan indeks besar yang dipartisi, ikuti praktik terbaik berikut:
Stripe setiap partisi di banyak disk. Pendekatan ini sangat relevan saat menggunakan disk berputar.
Jika memungkinkan, gunakan server dengan memori utama yang cukup agar sesuai dengan partisi yang sering diakses, atau semua partisi dalam memori, untuk mengurangi biaya I/O.
Jika data yang Anda query tidak muat di memori, kompres tabel dan indeks untuk mengurangi biaya I/O.
Gunakan server dengan prosesor cepat dan inti prosesor sebanyak yang Anda mampu, untuk memanfaatkan kemampuan pemrosesan kueri paralel.
Pastikan server memiliki bandwidth pengontrol I/O yang memadai.
Buat indeks berkluster pada setiap tabel besar yang dipartisi untuk memanfaatkan pengoptimalan pemindaian pohon B.
Saat memuat data secara massal ke dalam tabel yang dipartisi, ikuti rekomendasi praktik terbaik dalam white paper, The Data Loading Performance Guide.
Contoh
Contoh berikut membuat database pengujian yang berisi satu tabel dengan tujuh partisi. Untuk melihat informasi partisi baik untuk rencana waktu kompilasi maupun run-time, gunakan alat yang dijelaskan dalam Tampilkan informasi partisi dalam rencana eksekusi kueri saat menjalankan kueri dalam contoh ini.
Catatan
Contoh ini menyisipkan lebih dari 1 juta baris ke dalam tabel. Menjalankan contoh ini dapat memakan waktu beberapa menit tergantung pada perangkat keras Anda. Sebelum menjalankan contoh ini, verifikasi bahwa Anda memiliki lebih dari 1,5 GB ruang disk yang tersedia.
Catatan
Di Azure SQL Database dan SQL database di Microsoft Fabric, pernyataan USE tersebut tidak tersedia. Sebaliknya, hubungkan langsung ke master dan database pengguna yang diinginkan secara terpisah. Jalankan setiap batch contoh kode pada koneksi untuk database yang namanya ditentukan oleh pernyataan USE-nya.
USE master;
GO

IF DB_ID(N'db_sales_test') IS NOT NULL
    DROP DATABASE [db_sales_test];
GO

CREATE DATABASE [db_sales_test];
GO

USE db_sales_test;
GO

CREATE PARTITION FUNCTION pf_range_fact(INT)
    AS RANGE RIGHT
    FOR VALUES (20190801, 20190901, 20191001, 20191101, 20191201, 20200101);
GO

CREATE PARTITION SCHEME ps_fact_sales
    AS PARTITION pf_range_fact
    ALL TO ([PRIMARY]);
GO

CREATE TABLE fact_sales
(
    date_id INT,
    product_id INT,
    store_id INT,
    quantity INT,
    unit_price NUMERIC (7, 2),
    other_data CHAR (1000)
) ON ps_fact_sales (date_id);
GO

CREATE CLUSTERED INDEX ci
    ON fact_sales(date_id);
GO

PRINT 'Loading...';

SET NOCOUNT ON;

DECLARE @i AS INT;

SET @i = 1;

WHILE (@i < 1000000)
    BEGIN
        INSERT INTO fact_sales
        VALUES (20190800 + (@i % 30) + 1, @i % 10000, @i % 200, RAND() - 25, (@i % 3) + 1, '');
        SET @i += 1;
    END
GO

DECLARE @i AS INT;

SET @i = 1;

WHILE (@i < 10000)
    BEGIN
        INSERT INTO fact_sales
        VALUES (20190900 + (@i % 30) + 1, @i % 10000, @i % 200, RAND() - 25, (@i % 3) + 1, '');
        SET @i += 1;
    END

PRINT 'Done.';
GO

-- Two-partition query.
SET STATISTICS XML ON;
GO

SELECT date_id,
       SUM(quantity * unit_price) AS total_price
FROM fact_sales
WHERE date_id BETWEEN 20190802 AND 20190902
GROUP BY date_id;
GO

SET STATISTICS XML OFF;
GO

-- Single-partition query.
SET STATISTICS XML ON;
GO

SELECT date_id,
       SUM(quantity * unit_price) AS total_price
FROM fact_sales
WHERE date_id BETWEEN 20190801 AND 20190831
GROUP BY date_id;
GO

SET STATISTICS XML OFF;
GO
Konten terkait
- Referensi operator showplan logis dan fisik
- Gambaran umum Kejadian yang Diperluas
- Praktik terbaik untuk memantau beban kerja dengan Query Store
- Estimasi Kardinalitas (SQL Server)
- Pemrosesan kueri cerdas dalam database SQL
- Prioritas operator (Transact-SQL)
- Gambaran umum rencana eksekusi
- Pusat Performa untuk Mesin Database SQL Server dan Azure SQL Database