Mengatasi duplikat dan null
Masalah kualitas data seperti rekaman duplikat dan nilai null dapat membahayakan analitik dan proses hilir Anda. Apakah duplikat muncul dari beban data bersamaan atau null muncul karena data sumber yang tidak lengkap, mengatasi masalah ini adalah tanggung jawab inti bagi teknisi data yang bekerja di Azure Databricks.
Dalam unit ini, Anda mempelajari cara mengidentifikasi dan mengatasi nilai duplikat, hilang, dan null menggunakan pendekatan SQL dan PySpark.
Mengidentifikasi rekaman duplikat
Sebelum dapat menghapus duplikat, Anda perlu menemukannya. Duplikat biasanya terjadi ketika rekaman yang sama muncul beberapa kali dalam tabel, sering kali karena masalah integrasi data, penyerapan berulang, atau operasi tulis bersamaan.
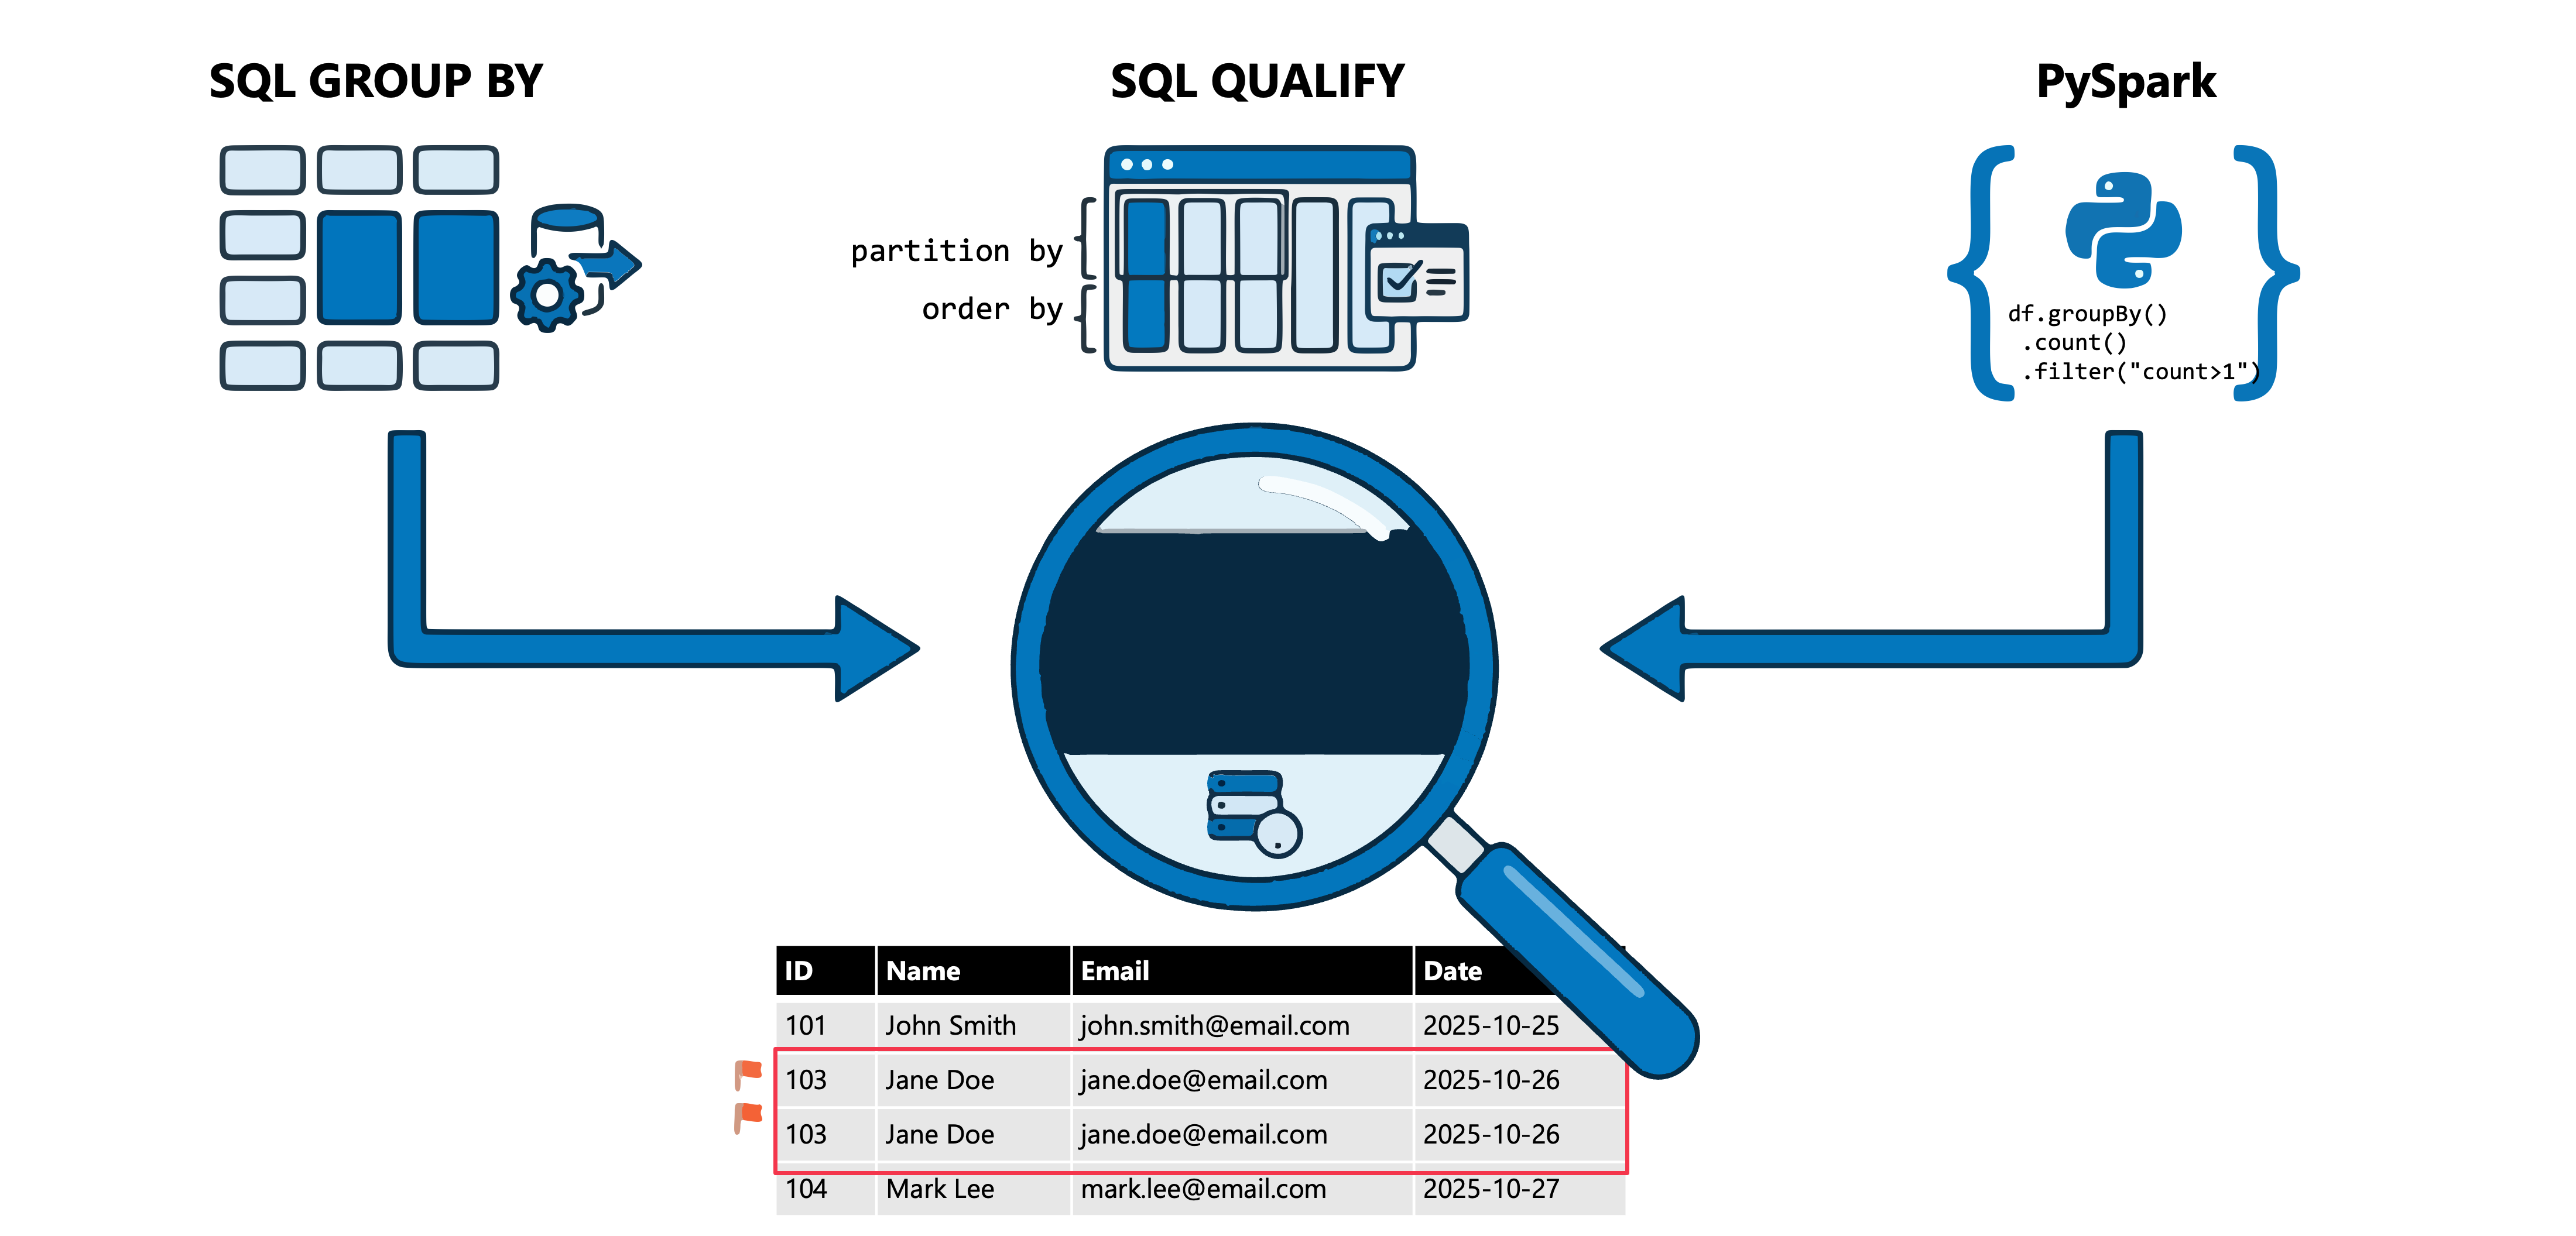
Menggunakan GROUP BY dan HAVING untuk menemukan duplikat
Cara paling mudah untuk mengidentifikasi duplikat adalah dengan mengelompokkan rekaman dan menghitung kemunculan. Klausa HAVING memfilter hasil yang dikelompokkan untuk memperlihatkan hanya nilai yang muncul lebih dari sekali.
SELECT
    customer_id,
    email,
    COUNT(*) AS occurrence_count
FROM sales.customers
GROUP BY customer_id, email
HAVING COUNT(*) > 1
ORDER BY occurrence_count DESC;
Kueri ini mengembalikan semua kombinasi customer_id dan email yang muncul beberapa kali dalam tabel, membantu Anda memahami cakupan duplikasi.
Menggunakan QUALIFY dengan fungsionalitas jendela
Klausa QUALIFY ini menyediakan pendekatan yang lebih sederhana dengan memfilter hasil fungsi jendela secara langsung, tanpa memerlukan subkueri. Pendekatan ini sangat berguna ketika Anda perlu melihat baris duplikat yang sebenarnya, bukan hanya hitungan.
SELECT *
FROM sales.customers
QUALIFY COUNT(*) OVER (PARTITION BY customer_id, email) > 1;
Kueri ini mungkin mengembalikan hasil seperti:
| customer_id | Nama | dibuat_pada | status | |
|---|---|---|---|---|
| 1001 | jane@contoso.com | Jane Doe | 2024-01-15 | Active |
| 1001 | jane@contoso.com | Jane D. | 2024-03-20 | Active |
| 1002 | bob@fabrikam.com | Bob Smith | 2024-02-10 | Pending |
| 1002 | bob@fabrikam.com | Robert Smith | 2024-02-11 | Active |
Dengan pola ini, Anda mendapatkan semua kolom dari baris duplikat, sehingga lebih mudah untuk menyelidiki sumber duplikasi.
Menemukan duplikat menggunakan PySpark
Di PySpark, Anda dapat menggunakan fungsi jendela yang dikombinasikan dengan pemfilteran untuk mengidentifikasi rekaman duplikat:
from pyspark.sql.functions import count
from pyspark.sql.window import Window

window_spec = Window.partitionBy("customer_id", "email")

duplicates_df = (
    df.withColumn("row_count", count("*").over(window_spec))
    .filter("row_count > 1")
    .drop("row_count")
)

display(duplicates_df)
Atau, gunakan exceptAll() metode untuk membandingkan DataFrame asli dengan versi deduplikasi:
df_duplicates = df.exceptAll(df.dropDuplicates(["customer_id", "email"]))
display(df_duplicates)
Metode ini exceptAll() melakukan perbedaan yang ditetapkan yang mempertahankan duplikat. Ini mengembalikan semua baris dari DataFrame pertama yang tidak ada di DataFrame kedua, dengan mempertahankan kemunculan duplikat. Berikut adalah cara kerjanya:
-
df.dropDuplicates(["customer_id", "email"])membuat DataFrame dengan satu baris per kombinasi unik -
exceptAll()membandingkan DataFrame asli dengan versi deduplikasi ini - Untuk setiap kombinasi unik, satu kecocokan diidentifikasi dan dihapus, menyisakan hanya duplikat tambahan.
Misalnya, jika pelanggan 1001 muncul tiga kali di DataFrame asli dan sekali dalam versi deduplikasi, exceptAll() mengembalikan dua baris (kemunculan tambahan).
Nota
Tidak seperti except(), yang menghapus semua baris yang cocok dan mengembalikan hasil yang berbeda, exceptAll() mempertahankan struktur duplikat. Jika Anda memiliki tiga baris yang identik di datanya asli dan satu di set hasil deduplikasi, exceptAll() mengembalikan tepat dua baris.
Menghapus rekaman duplikat
Setelah mengidentifikasi duplikat, Anda dapat memilih strategi resolusi berdasarkan kebutuhan data Anda.
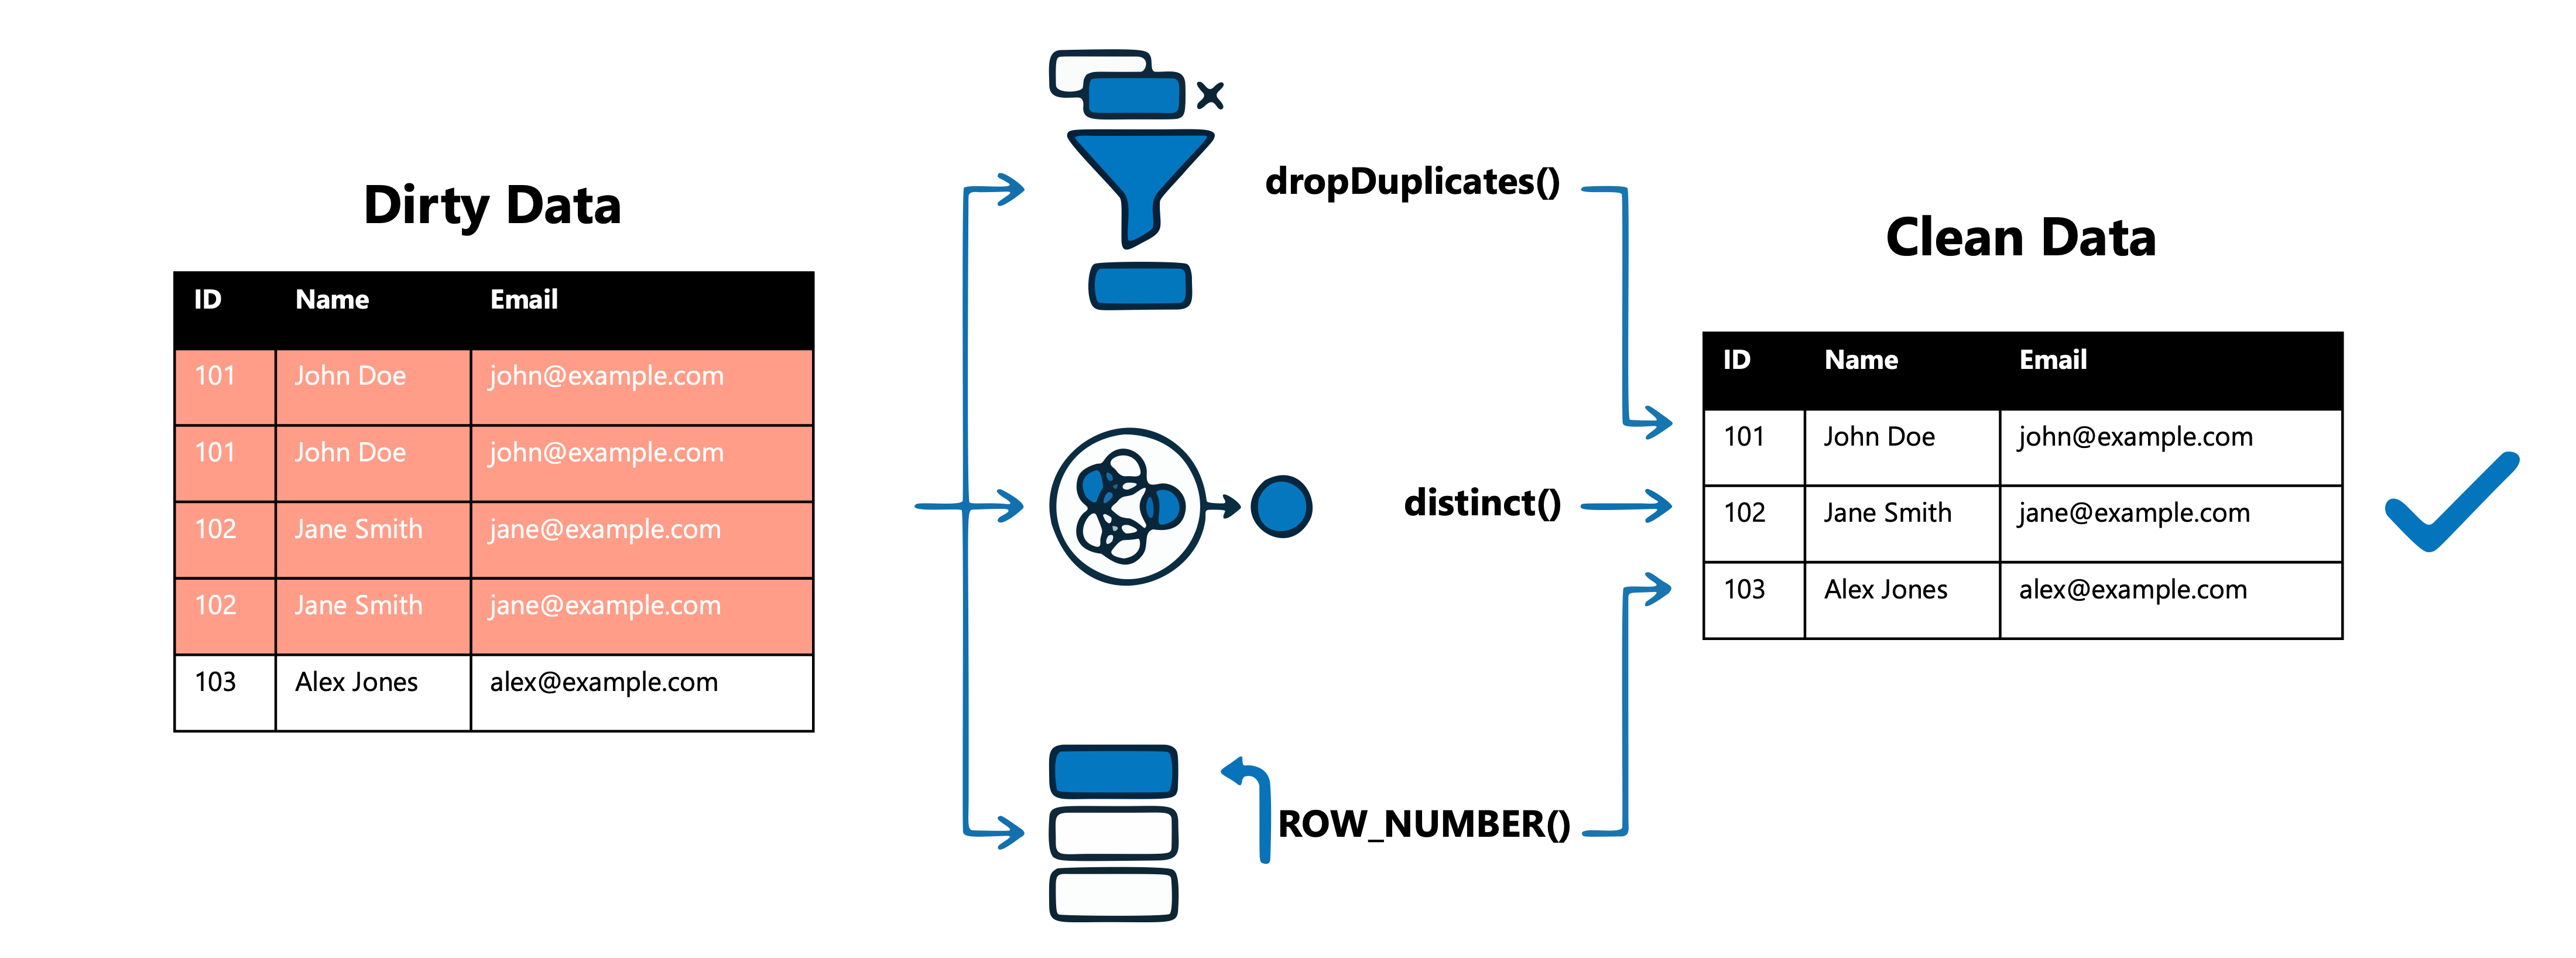
Menghapus duplikat di PySpark
Metode dropDuplicates() ini menghapus baris duplikat berdasarkan kolom yang ditentukan dan menyimpan satu baris untuk setiap kombinasi. Saat baris berbeda di kolom lain, baris yang tersisa tidak dijamin:
df_clean = df.dropDuplicates(["customer_id", "email"])
Untuk deduplikasi baris lengkap di semua kolom, gunakan distinct():
df_unique = df.distinct()
Pertahankan baris tertentu menggunakan ROW_NUMBER
Saat Anda memerlukan kontrol atas duplikat mana yang akan disimpan, gunakan ROW_NUMBER() dengan QUALIFY untuk memilih rekaman berdasarkan kriteria seperti pembaruan terbaru:
SELECT *
FROM sales.customers
QUALIFY ROW_NUMBER() OVER (
    PARTITION BY customer_id
    ORDER BY updated_at DESC
) = 1;
Kueri ini mempartisi catatan berdasarkan customer_id, mengurutkannya menurut updated_at dalam urutan menurun, dan hanya menyimpan catatan terbaru untuk setiap pelanggan.
Menangani nilai (null) dan data yang hilang
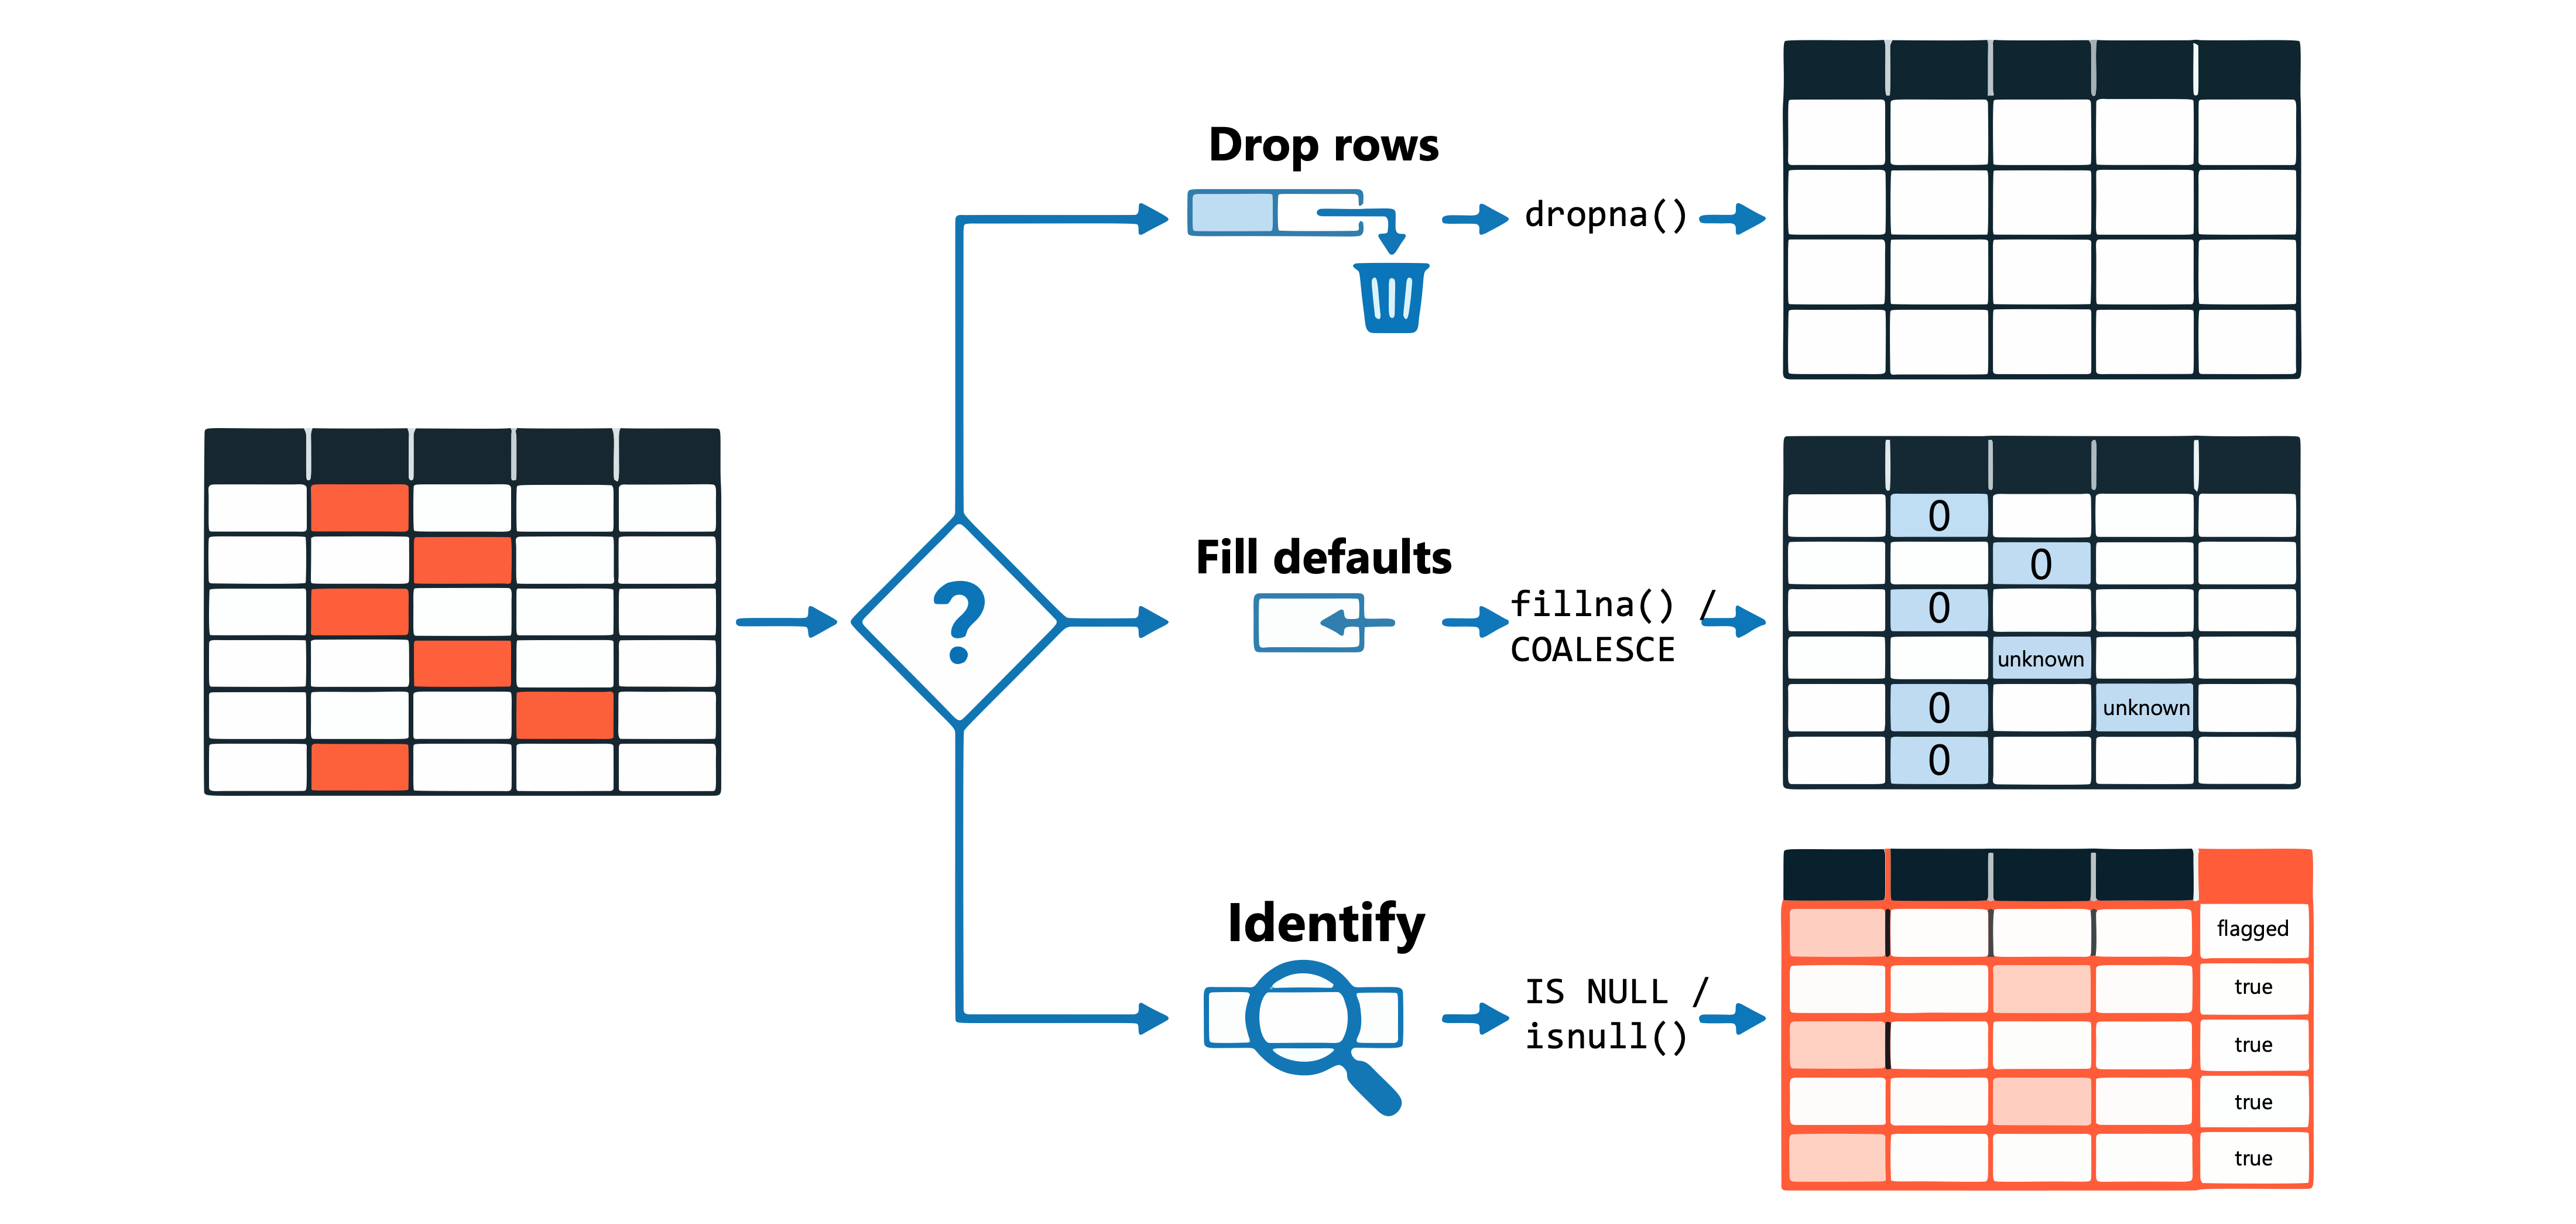
Nilai null mewakili data yang hilang atau tidak diketahui. Bergantung pada persyaratan analisis, Anda mungkin perlu menghapus baris dengan null, menggantinya dengan nilai default, atau menggunakan imputasi statistik.
Mengidentifikasi nilai null
isnull() Gunakan fungsi atau IS NULL operator untuk menemukan rekaman dengan nilai yang hilang:
SELECT *
FROM sales.transactions
WHERE amount IS NULL
   OR customer_id IS NULL;
Untuk menghitung jumlah kemunculan null pada setiap kolom:
SELECT
    COUNT(*) AS total_rows,
    COUNT(*) - COUNT(amount) AS null_amount_count,
    COUNT(*) - COUNT(customer_id) AS null_customer_count
FROM sales.transactions;
Hapus baris dengan nilai null
Di PySpark, dropna() metode menghapus baris yang berisi nilai null:
# Drop rows where any column is null
df_clean = df.dropna()

# Drop rows where all columns are null
df_clean = df.dropna(how="all")

# Drop rows where specific columns are null
df_clean = df.dropna(subset=["customer_id", "amount"])
Parameter how mengontrol perilaku: "any" menghapus baris dengan setidaknya satu null (default), sementara "all" menghapus baris hanya ketika semua kolom yang ditentukan null.
Isi nilai null dengan default
Metode fillna() mengganti nilai null dengan nilai default yang ditentukan:
# Fill null values with a single value (applies only to columns whose data type matches)
df_filled = df.fillna(0)

# Fill specific columns with different values
df_filled = df.fillna({
    "amount": 0,
    "status": "Unknown",
    "quantity": 1
})
Di SQL, gunakan COALESCE fungsi untuk menyediakan nilai default:
SELECT
    customer_id,
    COALESCE(amount, 0) AS amount,
    COALESCE(status, 'Unknown') AS status
FROM sales.transactions;
Pilih strategi yang tepat
Strategi penanganan null yang sesuai tergantung pada konteks data Anda:
| Scenario | Pendekatan yang disarankan |
|---|---|
| Null di kolom wajib seperti pengidentifikasi | Menghapus baris |
| Nilai Null pada bidang numerik untuk agregasi | Isi dengan nol atau rata-rata |
| Null dalam bidang kategoris opsional | Isi dengan placeholder seperti "Tidak Diketahui" |
| Nilai nol yang dapat mengganggu analisis | Lepaskan atau lengkapi berdasarkan pengetahuan spesifik domain |
Petunjuk / Saran
Dokumentasikan keputusan penanganan null Anda. Analis di masa mendatang perlu memahami mengapa nilai tertentu diganti atau dihapus untuk menginterpretasikan hasil kueri dengan benar.
Memahami cara mengidentifikasi dan mengatasi masalah kualitas data ini mempersiapkan Anda untuk membangun alur data yang lebih andal. Dengan data yang bersih, transformasi dan analitik hilir Anda menghasilkan hasil yang dapat dipercaya.