Pilih format tabel data
Teknisi data menghadapi keputusan penting di awal setiap alur data: format tabel mana yang harus menyimpan data Anda? Pilihan ini memengaruhi performa kueri, keandalan transaksi, interoperabilitas dengan platform lain, dan pemeliharaan jangka panjang arsitektur lakehouse Anda.
Azure Databricks mendukung beberapa format penyimpanan, masing-masing dirancang untuk skenario yang berbeda. Memahami perbedaannya membantu Anda memilih format yang tepat untuk persyaratan spesifik Anda.
Memahami format file versus format tabel
Sebelum membandingkan opsi, penting untuk membedakan antara format file dan format tabel. Format file seperti Parquet, CSV, atau JSON menentukan bagaimana data disimpan secara fisik pada disk. Format tabel seperti Delta Lake atau Apache Iceberg dibangun di atas format file dengan menambahkan lapisan metadata yang melacak transaksi, perubahan skema, dan lokasi file data.
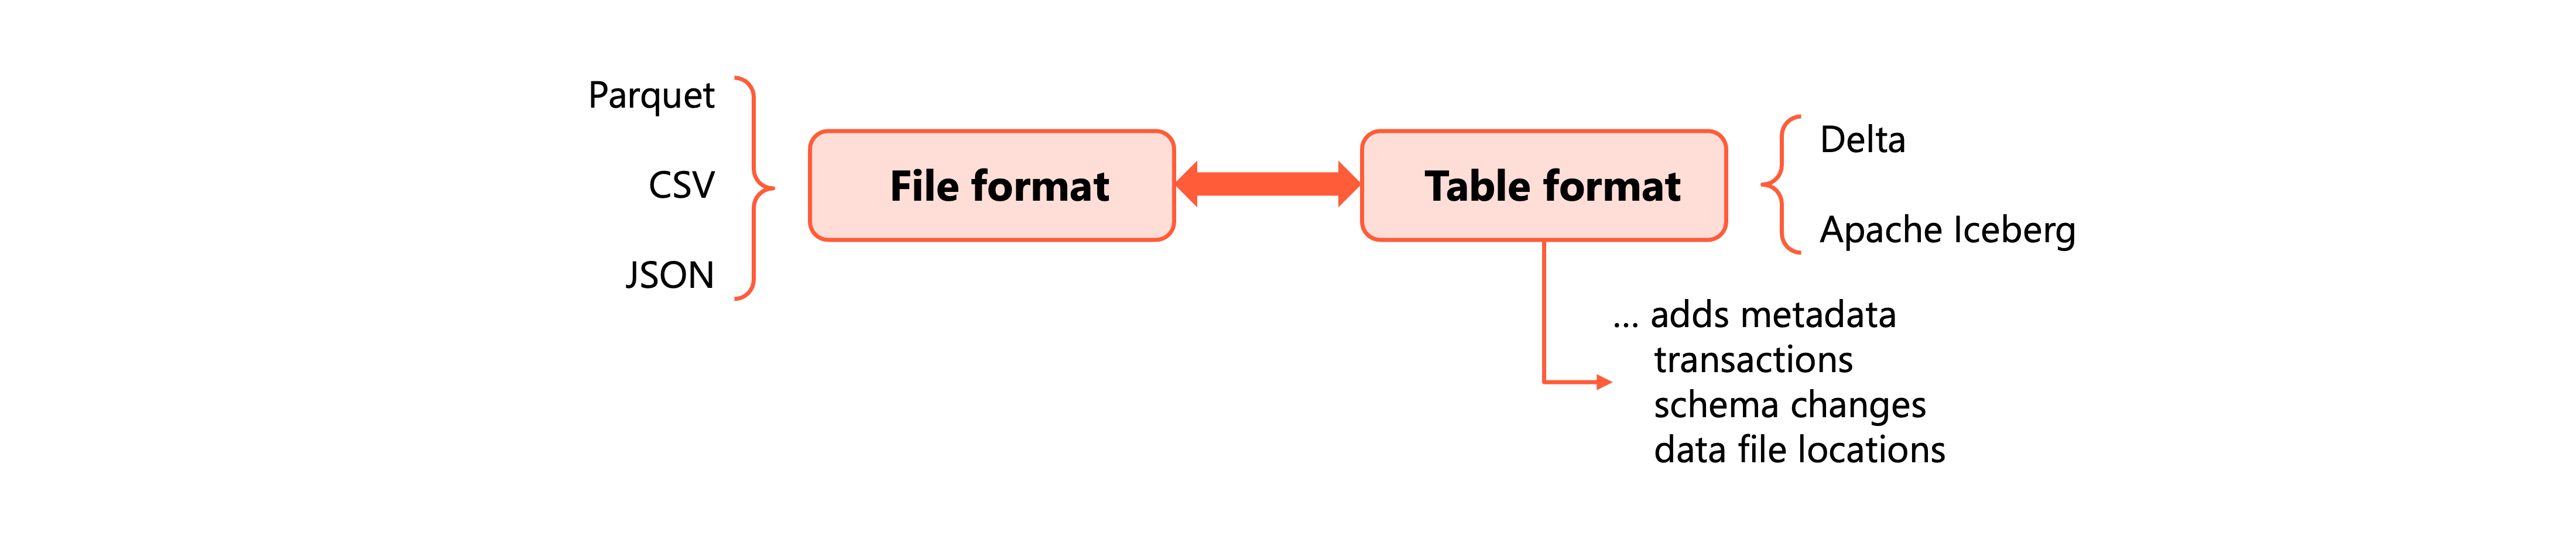
Delta Lake dan Apache Iceberg menggunakan Parquet sebagai format file yang mendasar. Perbedaan utama terletak pada lapisan metadata yang memungkinkan fitur canggih seperti transaksi ACID, perjalanan waktu, dan evolusi skema.
Cara Parquet menyimpan data secara berbeda
Parquet menggunakan penyimpanan berbasis kolom daripada penyimpanan berbasis baris. Perbedaan mendasar ini secara signifikan berdampak pada performa kueri analitik.
Dalam format berbasis baris seperti CSV, data diatur menurut rekaman. Membaca satu kolom memerlukan pemindaian setiap baris dalam file. Dalam format kolom seperti Parquet, data untuk setiap kolom disimpan bersama-sama. Saat kueri hanya membutuhkan kolom tertentu, Parquet hanya membaca kolom tersebut dan melewati sisanya sepenuhnya.
Parquet menata data ke dalam grup baris, masing-masing berisi potongan kolom. Setiap potongan kolom menyimpan statistik termasuk nilai minimum dan maksimum untuk segmen data tersebut. Saat Anda menjalankan kueri dengan kondisi filter, mesin kueri memeriksa statistik ini terlebih dahulu. Jika nilai filter berada di luar rentang min/maks dari grup baris, mesin melewati pembacaan seluruh bagian tersebut.
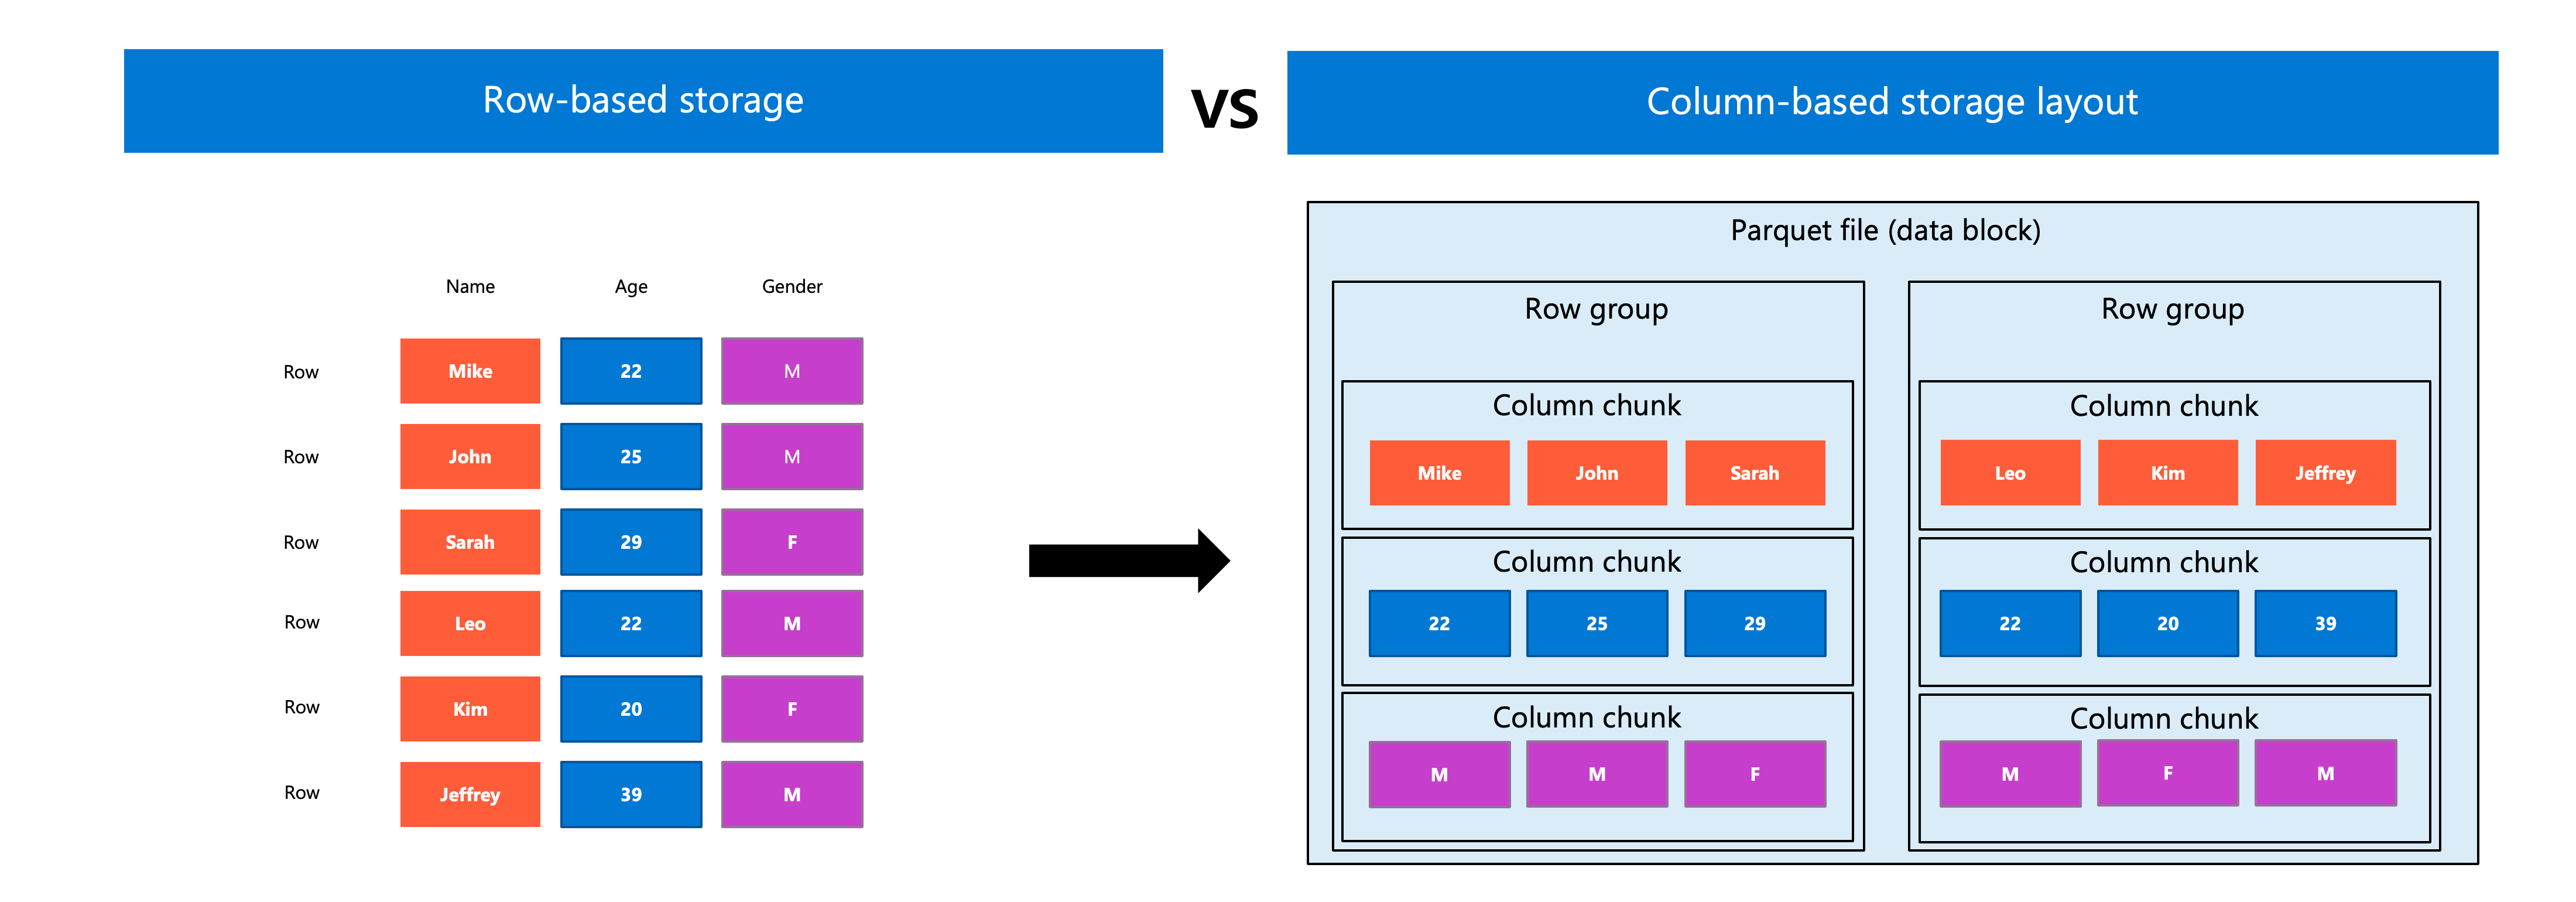
Pendekatan kolumnar ini menyediakan dua teknik pengoptimalan yang secara dramatis meningkatkan performa analitik:
- Pemangkasan kolom: Mesin hanya membaca kolom referensi kueri Anda, mengurangi I/O secara substansial.
- Penurunan Predikat: Kondisi filter dievaluasi berdasarkan statistik kolom sebelum pembacaan data, memungkinkan untuk sepenuhnya melewati grup baris yang tidak relevan.
Untuk beban kerja analitis yang biasanya mengakses subset kolom di banyak baris, Parquet secara substansial mengungguli format berbasis baris.
Delta Lake sebagai format default
Delta Lake adalah format penyimpanan default untuk semua tabel di Azure Databricks. Saat Anda membuat tabel tanpa menentukan format, Azure Databricks secara otomatis menggunakan Delta Lake.
Delta Lake memperluas file Parquet dengan log transaksi yang merekam setiap perubahan pada tabel Anda. Log ini memungkinkan beberapa kemampuan yang tidak disediakan Parquet saja:
Transaksi ACID: Beberapa pembaca dan penulis bersamaan dapat mengakses tabel yang sama tanpa kerusakan data. Setiap transaksi selesai sepenuhnya atau tidak menghasilkan apa-apa.
Perjalanan waktu: Mengkueri versi tabel Anda sebelumnya menggunakan tanda waktu atau nomor versi. Batalkan perubahan jika diperlukan.
Penerapan dan evolusi skema: Tabel memvalidasi data yang masuk berdasarkan skema yang telah ditentukan, mencegah data yang rusak atau tidak kompatibel untuk memasuki lakehouse Anda. Saat persyaratan berubah, Anda dapat menambahkan kolom baru, memodifikasi jenis data, atau mengganti nama kolom tanpa menulis ulang data yang ada.
Batch dan streaming terpadu: Gunakan tabel yang sama sebagai sumber atau pengolah batch dan streaming.
Delta Lake terintegrasi secara mendalam dengan platform Azure Databricks. Fitur seperti pengklusteran cair dan pengoptimalan prediktif tersedia untuk Delta Lake dan tabel Apache Iceberg terkelola di Unity Catalog. Perubahan aliran data, terutama untuk Delta Lake dan bergantung pada log transaksinya.
Untuk sebagian besar skenario di Azure Databricks, Delta Lake adalah pilihan yang direkomendasikan. Ini menyediakan manfaat performa Parquet beserta jaminan transaksi yang dibutuhkan oleh sistem data produksi.
Apache Iceberg untuk skenario lintas platform
Apache Iceberg adalah format tabel terbuka alternatif yang didukung Azure Databricks untuk tabel terkelola dan asing. Seperti Delta Lake, Iceberg menyediakan kemampuan transaksi ACID, evolusi skema, dan perjalanan waktu yang dibangun di atas file Parquet.
Struktur logis Iceberg yang hierarkis dan terdefinisi dengan baik membuatnya sangat fleksibel, mendukung skalabilitas dan pengoptimalan tingkat lanjut. Ini mendukung pruning manifes, statistik tingkat file, partisi tersembunyi, dan evolusi partisi.
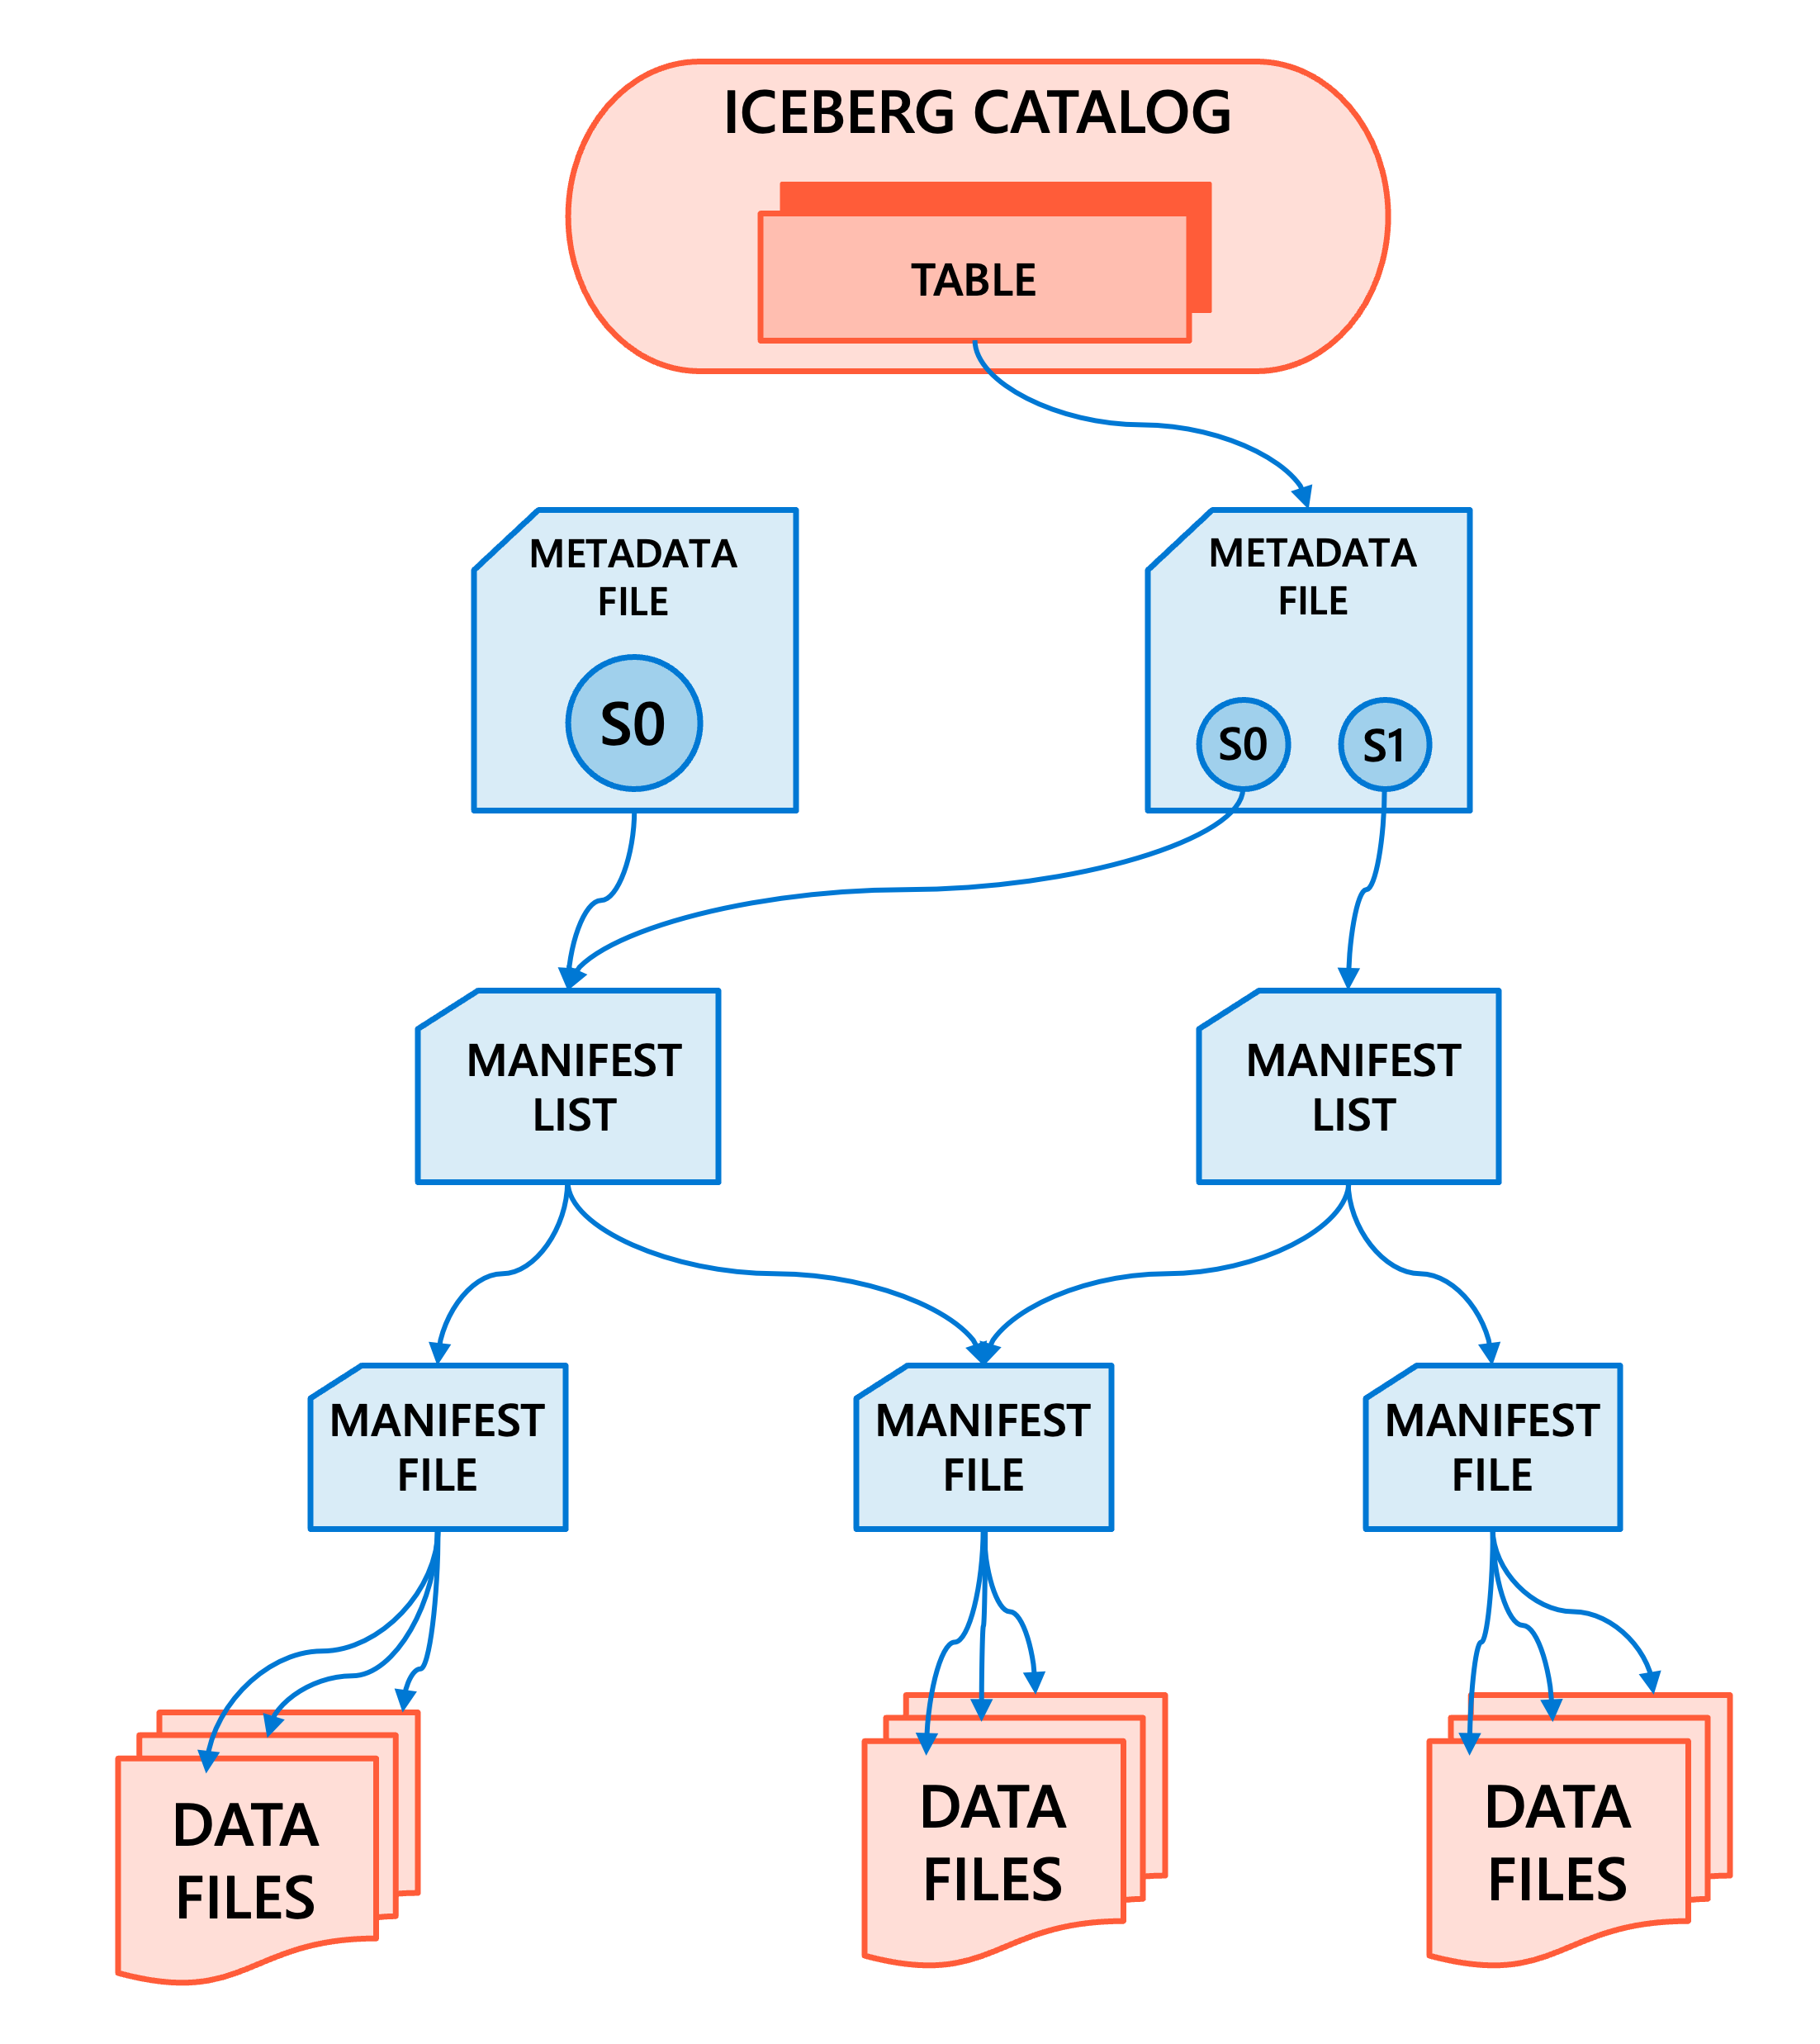
Alasan utama untuk memilih Iceberg adalah interoperabilitas. Iceberg banyak diadopsi di seluruh ekosistem data, termasuk platform seperti Snowflake, Amazon Athena, Trino, Apache Spark, dan Apache Flink. Jika organisasi Anda menjalankan beban kerja di beberapa platform yang perlu membaca dan menulis tabel yang sama, Iceberg menyediakan format umum yang dipahami semua platform.
Unity Catalog dapat mengelola tabel Iceberg secara langsung, memungkinkan Azure Databricks berfungsi sebagai katalog Iceberg untuk mesin eksternal. Anda juga dapat membaca tabel Iceberg yang dikelola oleh katalog lain seperti AWS Glue atau Snowflake Horizon Catalog melalui koneksi tabel asing.
Pertimbangkan Iceberg saat:
- Data Anda perlu diakses oleh beberapa mesin pemrosesan di luar Azure Databricks.
- Organisasi Anda telah menstandarkan Iceberg untuk berbagi data lintas platform.
- Anda terintegrasi dengan sistem yang tidak mendukung Delta Lake.
Untuk beban kerja yang berjalan terutama dalam Azure Databricks, Delta Lake tetap menjadi format yang direkomendasikan karena fitur integrasi dan pengoptimalan platform yang lebih dalam.
Saat format berbasis baris berlaku
CSV dan JSON tetap menjadi pilihan yang valid untuk skenario tertentu, meskipun kurang efisien untuk analitik skala besar.
Gunakan CSV atau JSON saat:
- Anda menerima data dari sistem eksternal dalam format ini sebagai zona pendaratan awal.
- Anda memerlukan data yang dapat dibaca manusia untuk penelusuran kesalahan atau inspeksi cepat.
- Anda mengintegrasikan dengan sistem yang hanya mendukung format berbasis teks.
- Volume data cukup kecil sehingga perbedaan performa dapat diabaikan.
Untuk penyimpanan persisten data analitik, konversikan file CSV atau JSON masuk ke tabel Delta Lake selama proses ingestion. Konversi ini menangkap keuntungan efisiensi penyimpanan kolumnar sambil menambahkan jaminan transaksi.
Menerapkan kriteria keputusan
Memilih format tabel bergantung pada persyaratan spesifik Anda. Mulailah dengan Delta Lake sebagai pilihan default Anda, lalu evaluasi alternatif hanya ketika batasan tertentu mengharuskannya.
| Pertimbangan | Danau Delta | Apache Iceberg | CSV/JSON |
|---|---|---|---|
| Kinerja analitik | Baik Sekali | Baik Sekali | Mis |
| Transaksi ACID | Yes | Yes | Tidak. |
| Perjalanan waktu | Yes | Yes | Tidak. |
| Integrasi Azure Databricks | Mendalam | Didukung | Dasar |
| Kompatibilitas lintas platform | Tumbuh | Lebar | Universal |
| Direkomendasikan untuk produksi | Yes | Ya (ketika interoperabilitas diperlukan) | Tidak (hanya zona pendaratan) |
Pilihan Anda juga bergantung pada standar organisasi. Jika tim arsitektur Anda telah menetapkan konvensi untuk format tabel, selaras dengan keputusan tersebut untuk mempertahankan konsistensi di seluruh platform data Anda.