Menerapkan pemeriksaan validasi
Alur data sering menemukan rekaman dengan nilai yang hilang, pengidentifikasi duplikat, atau nilai yang berada di luar rentang yang dapat diterima. Tanpa pemeriksaan validasi, masalah kualitas data ini menyebar ke hilir, menyebabkan analitik yang salah, laporan yang gagal, dan keputusan bisnis yang tidak dapat diandalkan. Pemeriksaan validasi menangkap masalah ini pada titik penyerapan data, memastikan bahwa hanya aliran data berkualitas melalui alur Anda.
Dalam unit ini, Anda mempelajari cara menerapkan pemeriksaan validasi untuk nullability, kardinalitas data, dan pemeriksaan rentang menggunakan ekspektasi pipeline Lakeflow dan batasan tabel Delta Lake.
Memahami pendekatan validasi di Azure Databricks
Azure Databricks menyediakan dua mekanisme utama untuk menerapkan pemeriksaan validasi: ekspektasi alur dan batasan tabel. Setiap pendekatan melayani skenario yang berbeda dan menawarkan kemampuan yang berbeda.
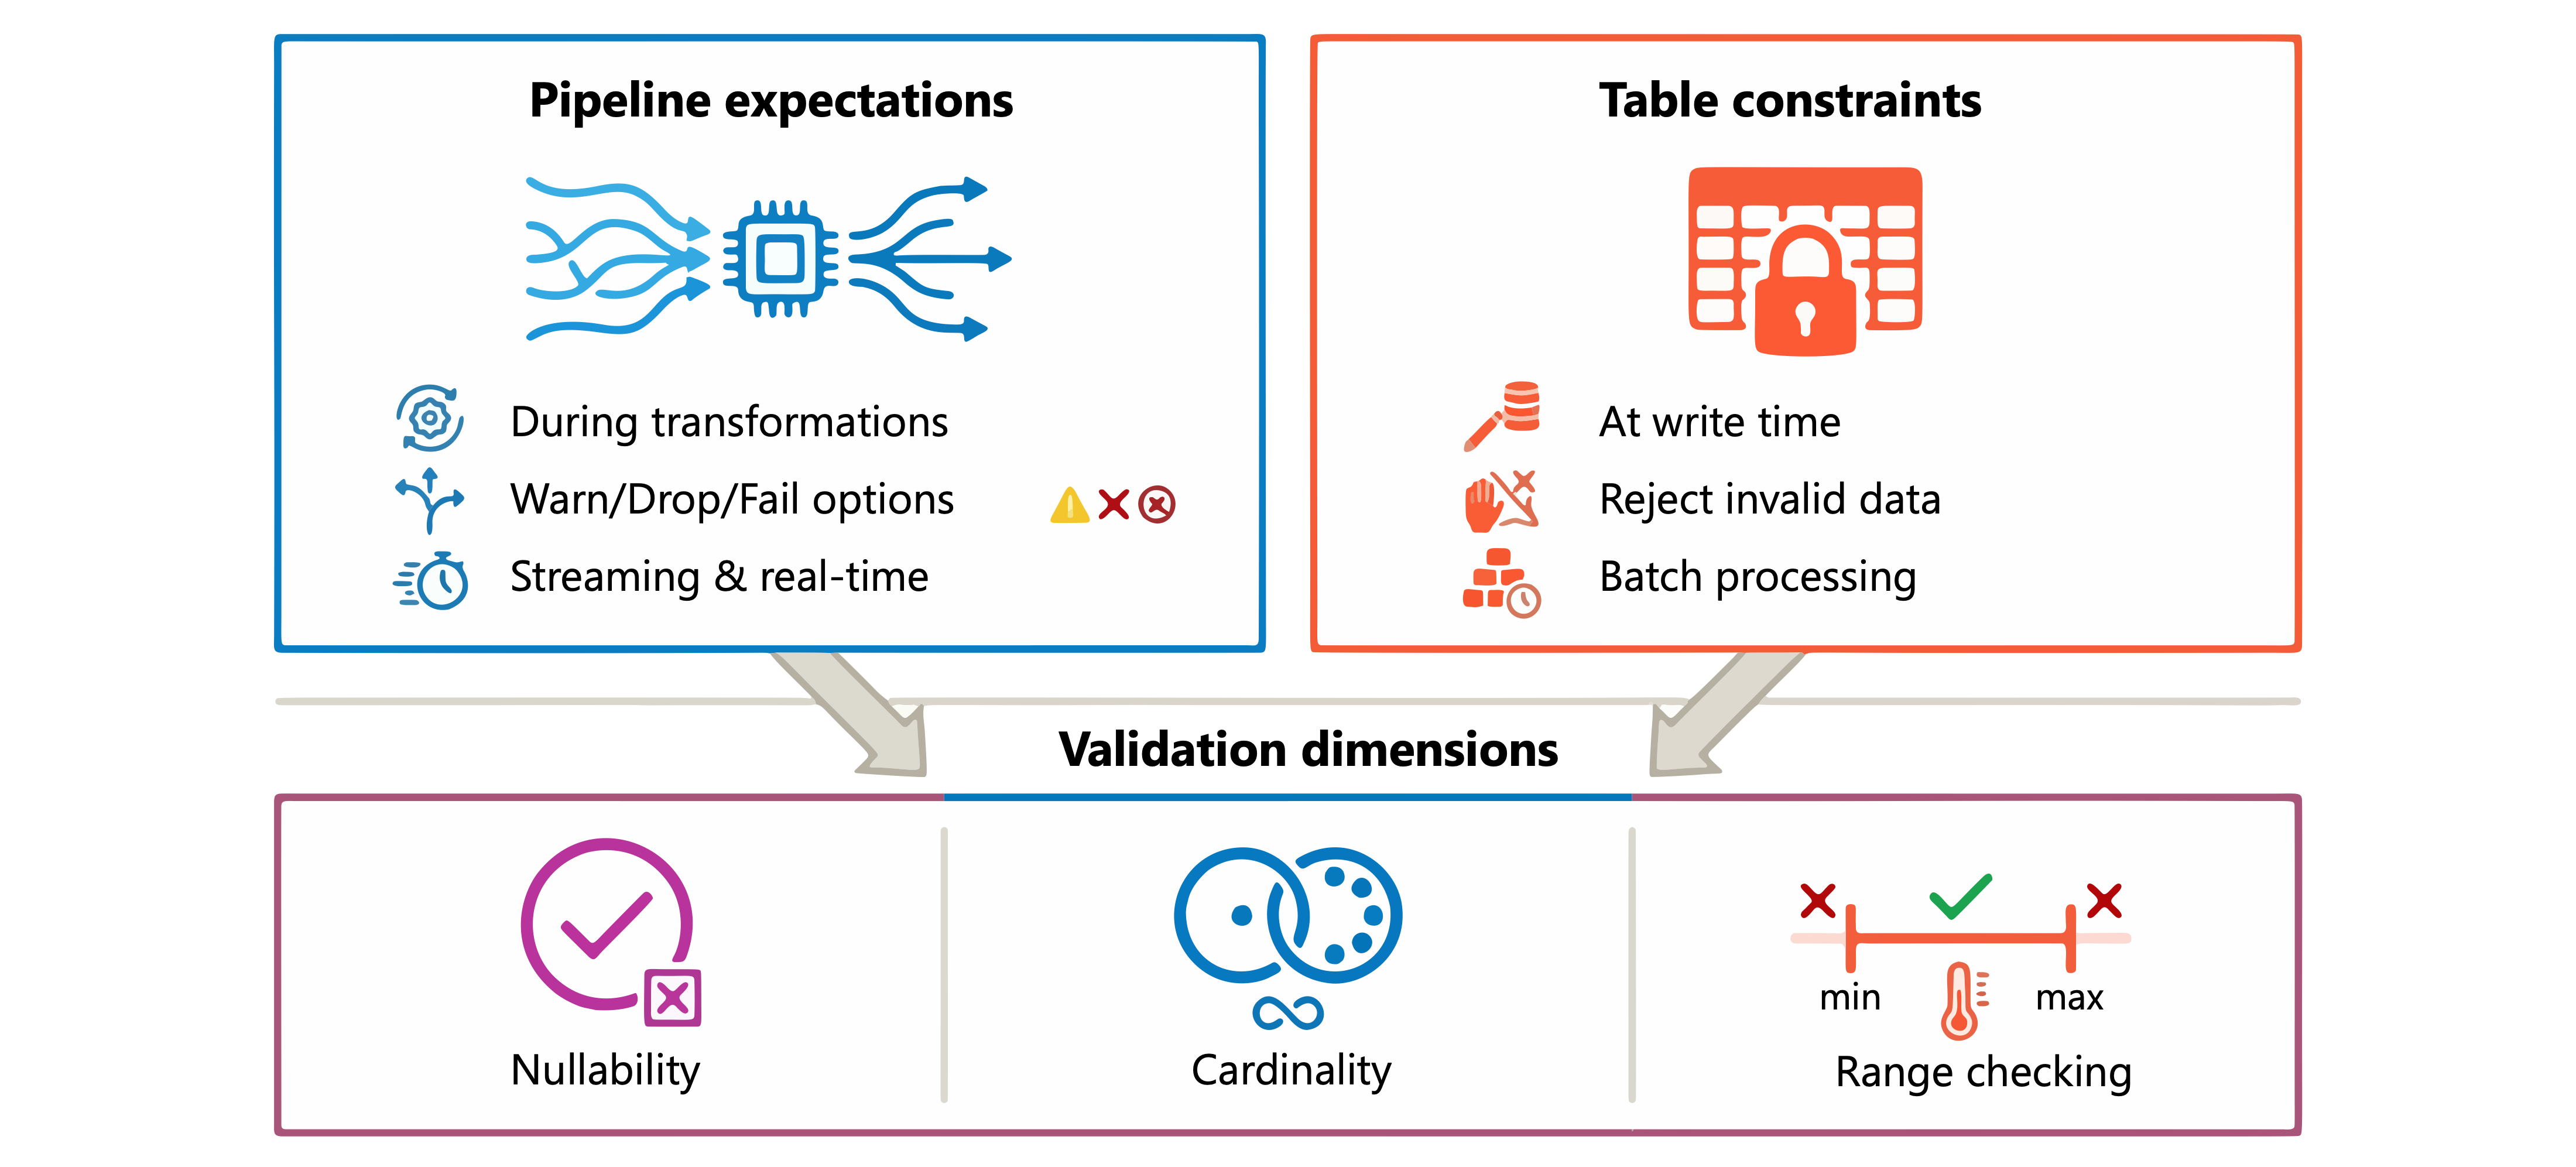
Ekspektasi pipeline menerapkan validasi selama transformasi data di alur Lakeflow. Ekspektasi memungkinkan Anda memperingatkan, menghilangkan rekaman yang tidak valid, atau gagal alur saat data melanggar aturan Anda. Pendekatan ini berfungsi dengan baik untuk tabel streaming dan tampilan materialisasi di mana Anda membutuhkan kontrol kualitas real-time.
Batasan tabel menerapkan aturan langsung pada tabel Delta Lake. Batasan menolak data yang tidak valid pada waktu tulis, mencegah rekaman buruk masuk ke tabel Anda. Pendekatan ini sesuai dengan pemrosesan dan skenario batch yang memerlukan jaminan integritas data yang ketat.
Dengan pendekatan ini, Anda dapat memvalidasi tiga dimensi utama kualitas data: nullability (memastikan adanya nilai yang diperlukan), kardinalitas data (memverifikasi keunikan jika diharapkan), dan pemeriksaan rentang (mengonfirmasi nilai berada dalam batas yang dapat diterima).
Menerapkan pemeriksaan nullability
Validasi nullability memastikan bahwa kolom yang diperlukan berisi nilai. Pertimbangkan tabel pelanggan di mana email dan customer_id harus selalu memiliki nilai. Anda dapat menerapkan pemeriksaan ini menggunakan ekspektasi dalam pipeline Anda.
Menggunakan Python, tambahkan dekorator ekspektasi ke definisi tabel streaming Anda:
from pyspark import pipelines as dp

@dp.table
@dp.expect_or_drop("valid_email", "email IS NOT NULL")
@dp.expect_or_drop("valid_customer_id", "customer_id IS NOT NULL")
def customers():
    return spark.readStream.table("raw.customers")
Validasi yang sama dalam SQL menggunakan klausul CONSTRAINT :
CREATE OR REFRESH STREAMING TABLE customers(
    CONSTRAINT valid_email EXPECT (email IS NOT NULL) ON VIOLATION DROP ROW,
    CONSTRAINT valid_customer_id EXPECT (customer_id IS NOT NULL) ON VIOLATION DROP ROW
) AS SELECT * FROM STREAM(raw.customers);
Untuk tabel Delta Lake di luar alur, gunakan NOT NULL batasan dalam definisi tabel:
CREATE TABLE customers (
    customer_id INT NOT NULL,
    email STRING NOT NULL,
    first_name STRING,
    last_name STRING
);
Anda juga dapat menambahkan batasan nullability ke tabel yang ada:
ALTER TABLE customers ALTER COLUMN email SET NOT NULL;
Nota
Sebelum menambahkan batasan NOT NULL ke tabel yang sudah ada, Azure Databricks memverifikasi bahwa semua baris yang ada memenuhi batasan. Operasi gagal jika ada nilai null di kolom .
Memvalidasi kardinalitas data
Validasi kardinalitas memastikan bahwa kolom yang diharapkan berisi nilai unik benar-benar demikian. Pemeriksaan ini sangat penting untuk kunci primer, pengidentifikasi transaksi, dan bidang lain di mana duplikat menunjukkan masalah kualitas data.
Harapan alur dapat memvalidasi kardinalitas dengan memeriksa kondisi yang menunjukkan masalah keunikan. Misalnya, Anda dapat memverifikasi bahwa Nomor Jaminan Sosial hanya muncul sekali per orang:
from pyspark.sql.window import Window
from pyspark.sql.functions import count

@dp.table
@dp.expect("unique_ssn_per_person", "ssn_count = 1")
def employees():
    df = spark.table("raw.employees")
    w = Window.partitionBy("ssn")
    return df.withColumn("ssn_count", count("*").over(w))
Untuk pemeriksaan kardinalitas yang lebih komprehensif, gabungkan ekspektasi dengan logika agregasi dalam transformasi Anda:
CREATE OR REFRESH MATERIALIZED VIEW order_validation AS
SELECT
    order_id,
    COUNT(*) as occurrence_count
FROM orders
GROUP BY order_id
HAVING COUNT(*) > 1;
Tampilan material ini mengidentifikasi setiap ID pesanan duplikat, memungkinkan Anda untuk menyelidiki dan menyelesaikan masalah kardinalitas.
Delta Lake mendukung batasan kunci utama yang mendokumentasikan keunikan yang diharapkan, meskipun batasan ini hanya bersifat informasi dan tidak diberlakukan.
CREATE TABLE orders (
    order_id INT NOT NULL,
    customer_id INT,
    order_date DATE,
    CONSTRAINT orders_pk PRIMARY KEY (order_id)
);
Petunjuk / Saran
Meskipun batasan kunci utama tidak diberlakukan, batasan kunci tersebut membantu pengoptimalan kueri dan mendokumen struktur yang dimaksudkan model data Anda. Gunakan ekspektasi alur untuk secara aktif menerapkan keunikan.
Menerapkan pemeriksaan rentang
Validasi rentang mengonfirmasi bahwa nilai numerik, tanggal, dan nilai lainnya termasuk dalam batas yang dapat diterima. Pemeriksaan ini menangkap kesalahan entri data, gangguan sistem, dan masalah integrasi yang menghasilkan nilai di luar rentang.
Tentukan harapan rentang menggunakan operator perbandingan atau BETWEEN klausa:
@dp.table
@dp.expect_or_fail("valid_age", "age BETWEEN 0 AND 150")
@dp.expect_or_fail("valid_salary", "salary >= 0")
@dp.expect_or_fail("valid_hire_date", "hire_date <= current_date()")
def employees():
    return spark.readStream.table("raw.employees")
Di SQL, terapkan pemeriksaan rentang yang sama:
CREATE OR REFRESH STREAMING TABLE transactions(
    CONSTRAINT valid_amount EXPECT (amount > 0) ON VIOLATION DROP ROW,
    CONSTRAINT valid_date EXPECT (transaction_date <= current_date()) ON VIOLATION DROP ROW,
    CONSTRAINT valid_quantity EXPECT (quantity BETWEEN 1 AND 10000) ON VIOLATION DROP ROW
) AS SELECT * FROM STREAM(raw.transactions);
Untuk tabel Delta Lake, gunakan CHECK batasan untuk memberlakukan rentang pada waktu tulis:
ALTER TABLE employees ADD CONSTRAINT valid_age CHECK (age >= 18 AND age <= 120);
ALTER TABLE transactions ADD CONSTRAINT positive_amount CHECK (amount > 0);
Pemeriksaan rentang juga dapat memvalidasi aturan bisnis yang menggabungkan beberapa kondisi:
@dp.expect("valid_discount", """
    discount_percent >= 0
    AND discount_percent <= 100
    AND (discount_percent <= 50 OR customer_tier = 'PREMIUM')
""")
Harapan ini memastikan diskon tetap dalam batas dan memberlakukan bahwa hanya pelanggan premium yang menerima diskon lebih dari 50%.
Pilih tindakan untuk kegagalan validasi
Saat validasi gagal, Anda memilih bagaimana alur Anda merespons. Setiap tindakan sesuai dengan persyaratan bisnis dan tingkat kekritisan data yang berbeda.
| Tindakan | Skenario penggunaan | Perilaku |
|---|---|---|
| Peringatkan (default) | Pemantauan dan analisis | Catatan tidak valid ditulis ke target; metrik dicatat |
| Drop | Pembersihan data | Rekaman tidak valid dihapus sebelum ditulis |
| Gagal | Integritas data penting | Alur berhenti; transaksi digulung balik |
Gunakan tindakan peringatan saat Anda memerlukan visibilitas ke dalam masalah kualitas data tanpa memblokir aliran data:
@dp.expect("has_phone", "phone_number IS NOT NULL")
Gunakan drop ketika rekaman yang tidak valid harus difilter secara diam-diam:
@dp.expect_or_drop("complete_address", "street IS NOT NULL AND city IS NOT NULL")
Gunakan gagal ketika integritas data kritis dan rekaman yang tidak valid tidak dapat diterima:
@dp.expect_or_fail("valid_account_balance", "balance >= 0")
Anda dapat melihat metrik ekspektasi di UI alur dengan memilih himpunan data dengan harapan dan membuka tab Kualitas data. Metrik ini membantu Anda memantau tingkat lulus validasi dan mengidentifikasi masalah kualitas data sistematis.
Sekarang setelah Anda memahami cara menerapkan pemeriksaan validasi, Anda dapat memastikan alur data Anda mempertahankan standar kualitas untuk nullability, kardinalitas, dan rentang nilai.