Catatan
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba masuk atau mengubah direktori.
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba mengubah direktori.
Visual Studio menggunakan ekspresi reguler .NET untuk menemukan dan mengganti teks.
Sintaks ekspresi reguler
Tabel berikut berisi beberapa karakter ekspresi reguler, operator, konstruksi, dan contoh pola. Untuk referensi yang lebih lengkap, lihat bahasa ekspresi reguler .
| Maksud | Ekspresi | Contoh |
|---|---|---|
| Cocokkan karakter tunggal apa pun (kecuali pemutus baris). Untuk informasi selengkapnya, lihat Karakter apa pun. | . |
a.o cocok dengan "aro" dalam "around" dan "abo" dalam "about" tetapi bukan "acro" dalam "across" |
| Cocokkan nol atau lebih kemunculan ekspresi sebelumnya (cocok dengan karakter sebanyak mungkin). Untuk informasi selengkapnya, lihat Mencocokkan nol kali atau lebih. | * |
a*r cocok dengan "r" di "rak", "ar" di "ark", dan "aar" pada "aardvark" |
| Cocokkan karakter apa pun nol atau lebih kali. | .* |
c.*e cocok dengan "cke" dalam "racket", "comme" dalam "comment", dan "code" dalam "code" |
| Cocokkan satu atau beberapa kemunculan ekspresi sebelumnya (cocokkan karakter sebanyak mungkin). Untuk informasi selengkapnya, lihat Mencocokkan satu atau beberapa kali. | + |
e+d cocok dengan "eed" di "feeder" dan "ed" dalam "faded" |
| Cocokkan karakter apa pun satu atau beberapa kali. | .+ |
e.+e cocok dengan "eede" di "feeder" tetapi tidak menemukan kecocokan di "feed" |
| Cocokkan nol atau lebih kemunculan ekspresi sebelumnya (cocokkan karakter sesegel mungkin). Untuk informasi selengkapnya, lihat pencocokan nol atau lebih kali (pencocokan malas). | *? |
\w*?d cocok dengan "fad" dan "ed" dalam "pudar" tetapi tidak seluruh kata "pudar" karena kecocokan malas |
| Cocokkan satu atau beberapa kemunculan ekspresi sebelumnya (cocokkan seberapa sedikit karakter yang mungkin). Untuk informasi selengkapnya, lihat Pencocokan satu atau beberapa kali (pencocokan lambat). | +? |
e\w+? cocok dengan "ee" dalam "tidur" dan "ed" dalam "pudar" tetapi tidak menemukan kecocokan dalam "pudar" |
| Antarkan string yang cocok ke awal baris atau string | ^ |
^car cocok dengan kata "mobil" hanya ketika muncul di awal garis |
| Pasang string pencocokan ke akhir baris | \r?$ |
car\r?$ cocok dengan "mobil" hanya ketika muncul di akhir garis |
| Kaitkan string pencocokan ke akhir file | $ |
car$ cocok dengan "mobil" hanya jika muncul di akhir file |
| Mencocokkan satu karakter dalam satu set | [abc] |
b[abc] cocok dengan "ba", "bb", dan "bc" |
| Mencocokkan karakter apa pun dalam berbagai karakter | [a-f] |
be[n-t] cocok dengan "bet" dalam "between", "ben" dalam "beneath", dan "bes" dalam "beside", tetapi tidak menemukan kecocokan dalam "below" |
| Mengambil dan secara implisit menomori ekspresi yang terkandung dalam tanda kurung | () |
([a-z])X\1 cocok dengan "aXa" dan "bXb", tetapi bukan "aXb". "\1" mengacu pada grup ekspresi pertama "[a-z]". Untuk informasi selengkapnya, lihat Kelompok tangkapan dan pola penggantian. |
| Membatalkan pertandingan | (?! abc) |
real(?!ity) menemukan kecocokan "real" dalam "realty" dan "really" tetapi tidak dalam "reality." Ini juga menemukan "real" kedua (tetapi bukan "real" pertama) dalam "realityreal". |
| Cocokkan karakter apa pun yang tidak berada dalam sekumpulan karakter tertentu. Untuk informasi selengkapnya, lihat Grup karakter negatif. | [^abc] |
be[^n-t] cocok dengan "bef" di "before", "beh" di "behind", dan "bel" di "below", tetapi tidak menemukan kecocokan di "beneath". |
| Cocokkan ekspresi sebelum atau yang setelah simbol | | |
(sponge|mud) bath cocok dengan "mandi spons" dan "mandi lumpur" |
| Escape karakter yang mengikuti garis miring terbalik | \ |
\^ cocok dengan karakter ^ |
| Tentukan jumlah kemunculan karakter atau grup sebelumnya. Untuk informasi selengkapnya, lihat Cocokkan tepat n kali. | {n}, di mana 'n' adalah jumlah kemunculan |
x(ab){2}x cocok dengan "xababx"x(ab){2,3}x cocok dengan "xababx" dan "xabababx" tetapi bukan "xababababx" |
| Cocokkan teks dalam kategori Unicode. Untuk informasi selengkapnya tentang kelas karakter Unicode, lihat Properti Karakter Unicode Standard 15.0. | \p{X}, di mana "X" adalah nomor Unicode. |
\p{Lu} cocok dengan "T" dan "D" di "Thomas Doe" |
| Cocokkan dengan batas kata | \b (Di luar kelas karakter, \b menentukan batas kata, dan di dalam kelas karakter, \b menentukan backspace.) |
\bin cocok dengan "in" di "inside" tetapi tidak menemukan kecocokan dalam "pinto" |
| Cocokkan pemisahan baris (yaitu, pengembalian kursor diikuti oleh baris baru, atau hanya baris baru) | \r?\n |
End\r?\nBegin cocok dengan "End" dan "Begin" hanya ketika "End" adalah string terakhir dalam baris dan "Begin" adalah string pertama di baris berikutnya |
| Cocokkan karakter kata | \w |
a\wd cocok dengan "add" dan "a1d" tetapi tidak dengan "a d" |
| Cocok dengan karakter non-kata apa pun | \W |
a\Wd cocok dengan "a d" tetapi bukan "dan" |
| Sesuaikan karakter ruang kosong | \s |
Public\sInterface cocok dengan frasa "Antarmuka Publik" |
| Cocok dengan karakter non-spasi kosong | \S |
\S+ cocok dengan "end", "A11", atau "end?". |
| Cocok dengan karakter digit desimal | \d |
\d cocok dengan "4" dan "0" dalam "wd40" |
| Cocok dengan karakter non-digit apa pun | \D |
\D cocok dengan "w" dan "d" dalam "wd40" |
Contoh ekspresi reguler yang menggabungkan beberapa operator dan konstruksi untuk mencocokkan angka heksadesimal adalah \b0[xX]([0-9a-fA-F]+)\b. Ekspresi ini cocok dengan "0xc67f" tetapi bukan "0xc67g".
Tips
Dalam sistem operasi Windows, sebagian besar garis berakhiran "\r\n" (pengembalian pengangkutan diikuti oleh baris baru). Karakter ini tidak terlihat tetapi ada di editor dan diteruskan ke layanan ekspresi reguler .NET. Ketika Anda menangani file dari web atau dari sistem operasi non-Windows, pastikan untuk memperhitungkan kemungkinan bahwa mereka menggunakan baris baru hanya untuk jeda baris.
Menangkap grup dan pola penggantian
Grup penangkapan menandai subekspresi dari ekspresi reguler dan menangkap substring dari string masukan. Anda dapat menggunakan grup yang diambil dalam ekspresi reguler itu sendiri (misalnya, untuk mencari kata berulang), atau dalam pola pengganti. Untuk informasi terperinci, lihat konstruksi pengelompokan dalam ekspresi reguler.
Untuk membuat grup pengambilan bernomor, kelilingi subekspresi dengan tanda kurung dalam pola ekspresi reguler. Tangkapan dinomori secara otomatis dari kiri ke kanan berdasarkan posisi tanda kurung pembuka dalam regular expression. Untuk mengakses grup yang diambil, pertimbangkan contoh berikut:
Dalam ekspresi reguler: Gunakan
\number. Misalnya,\1dalam ekspresi reguler(\w+)\s\1mereferensikan grup pengambilan pertama(\w+).Dalam pola pengganti: Gunakan
$number. Misalnya, ekspresi reguler yang dikelompokkan(\d)([a-z])menentukan dua grup: grup pertama berisi satu digit desimal, dan grup kedua berisi satu karakter antara dan z. Ekspresi menemukan empat kecocokan dalam string berikut: 1a 2b 3c 4d. String penggantiz$1mereferensikan grup pertama saja ($1), dan mengonversi string menjadi z1 z2 z3 z4.
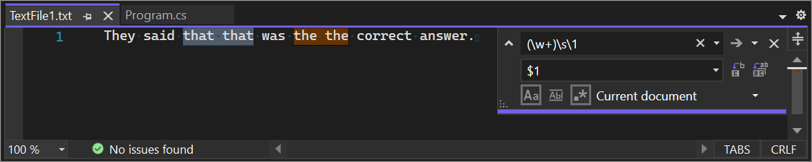
Gambar berikut menunjukkan sebuah regex (\w+)\s\1 dan sebuah string pengganti $1. Ekspresi reguler dan pola pengganti mereferensikan grup pengambilan pertama yang secara otomatis bernomor 1. Saat Anda memilih Ganti semua dalam kotak dialog Ganti Cepat di Visual Studio, kata berulang dihapus dari teks.
Tips
Dalam kotak dialog Ganti Cepat, pastikan untuk memilih tombol Gunakan Ekspresi Reguler, atau tekan Alt+E.
Grup penangkapan bernama
Alih-alih mengandalkan penomoran otomatis dari grup pengambilan, Anda dapat memberinya nama. Sintaksis untuk grup pengambilan bernama (?<name>subexpression).
Grup pengambilan bernama, seperti grup pengambilan bernomor, dapat digunakan dalam ekspresi reguler itu sendiri atau dalam pola pengganti. Untuk mengakses grup tangkap bernama, pertimbangkan contoh berikut:
Dalam ekspresi reguler: Gunakan
\k<name>. Misalnya,\k<repeated>dalam ekspresi reguler(?<repeated>\w+)\s\k<repeated>mereferensikan grup pengambilan yang bernamarepeateddan subekspresinya\w+.Dalam pola pengganti: Gunakan
${name}. Misalnya,${repeated}.
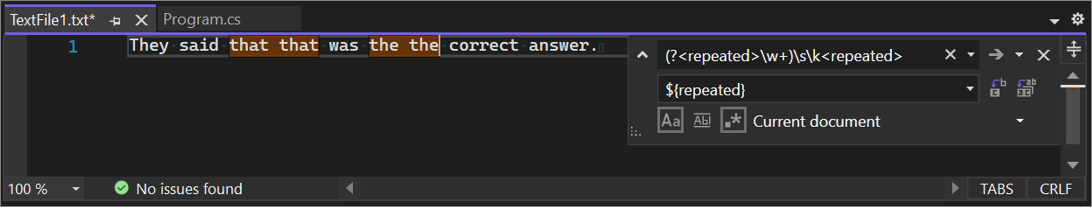
Gambar berikut menunjukkan sebuah regex (?<repeated>\w+)\s\k<repeated> dan sebuah string pengganti ${repeated}. Ekspresi reguler dan pola pengganti mereferensikan grup pengambilan bernama repeated. Saat Anda memilih Ganti semua dalam kotak dialog Ganti Cepat di Visual Studio, kata berulang dihapus dari teks.
Tips
Pastikan untuk memilih tombol Gunakan Ekspresi Reguler (atau tekan Alt+E) dalam kotak dialog Ganti Cepat.
Untuk informasi selengkapnya tentang kelompok penangkapan terberi nama, lihat Subekspresi yang sesuai dengan nama. Untuk informasi lebih lanjut tentang ekspresi reguler yang digunakan dalam pola penggantian, lihat Substitusi dalam ekspresi reguler.
Contoh
| Pola | Deskripsi |
|---|---|
int ([_A-Za-z][_A-Za-z0-9]*) |
Cocokkan definisi bilangan bulat tunggal. Pengidentifikasi dimulai dengan satu huruf besar atau huruf kecil, diikuti dengan nol atau lebih (ditunjukkan oleh *) huruf atau angka. Pengidentifikasi ditangkap sebagai $1 oleh tanda kurung luar. |
(private\|internal\|public)*\s*([\w]+\s+)int\s+([_A-Za-z][_A-Za-z0-9]*)\s+=\s+[+-]+(\d)+ |
Cocokkan deklarasi bilangan bulat C# yang diinisialisasi dengan literal bilangan bulat, serta menangkap berbagai komponennya, termasuk tingkat akses, pengubah seperti const atau static, pengidentifikasi, dan nilai yang ditetapkan. Perhatikan penggunaan \s+ untuk setidaknya satu karakter spasi putih, atau \s* jika spasi kosong mungkin atau mungkin tidak terjadi. |
foreach\s*\(([\w\d]*)\s+([\w\d]*)\s+in\s+(.*)\) |
Cocokkan baris pembuka dari perulangan foreach. Tanda kurung harfiah diloloskan dengan garis miring terbelakang (\). Berbagai grup ditangkap sebagai $1, $2, dan $3 oleh tanda kurung yang tidak dilewati. |
#define\s+([_A-Za-z][_A-Za-z0-9]*) |
Cocok dengan definisi #define (tanpa nilai, jika ada). Token yang ditentukan disimpan dalam $1. |
#include\s+["<](.*)[">] |
Kecocokan termasuk dalam file sumber C++. |
Konten terkait
- Referensi Cepat : Bahasa Ekspresi Reguler
- Temukan dan ganti teks