Nota
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare ad accedere o modificare le directory.
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare a modificare le directory.
Il concetto di multi-tenancy in Esplora dati di Azure si riferisce al servire diversi tenant e alla memorizzazione dei loro dati in un unico cluster.
Importante
È anche possibile progettare una soluzione multi-tenant nel carico di lavoro Microsoft Fabric Real-Time Intelligence usando i database KQL all'interno di un Eventhouse.
Un tenant può rappresentare un cliente, un gruppo di utenti o qualsiasi classificazione degli utenti in cui i dati devono essere separati lungo i limiti dei tenant. È anche possibile avere uno scenario multi-tenancy a più livelli, ad esempio più applicazioni con più tenant. Questo articolo non illustra questo scenario, ma si applicano principi simili.
Un fattore importante è il modo in cui gli utenti finali accedono ai dati del tenant. Quando gli utenti finali accedono direttamente ad Esplora dati di Azure, il controllo di accesso deve essere configurato in Esplora dati di Azure per limitare la visualizzazione degli utenti ai propri dati. Quando un'applicazione proxy accede ai dati in Azure Esplora dati, l'applicazione può eseguire l'isolamento.
Questo articolo descrive alcune architetture di distribuzione e fornisce caratteristiche per ognuna. È possibile usare le caratteristiche per decidere quale architettura funziona meglio per la soluzione.
Vicino rumoroso
In generale, la condivisione di un cluster tra molti tenant, indipendentemente dall'architettura usata, significa che i diversi tenant condividono le risorse del cluster. Questo può portare allo schema negativo del vicino rumoroso.
Ad esempio, se un tenant esegue molte query o ingestioni intensive dal punto di vista computazionale, è probabile che altri inquilini siano interessati dalla scarsità di risorse. Questa operazione può essere mitigata usando i gruppi di carico di lavoro. È anche possibile usare i criteri per controllare la memorizzazione nella cache e l'archiviazione complessiva.
Panoramica delle architetture
Le sezioni successive illustrano in dettaglio le architetture di distribuzione. Questa sezione contrasta le architetture per facilitare il processo decisionale.
| Architecture | Strengths |
|---|---|
| Un tenant per database | - Isolamento dei tenant: nessuna necessità di proxy - Può avere diversi criteri, come i criteri di conservazione, per ogni tenant - Flessibilità nell'evoluzione dello schema per tenant - Rimozione rapida e semplice dei dati del tenant |
| Una tabella per molti locatari | - Consolidamento efficiente dei dati e gestione degli spazi di archiviazione - Evoluzione semplificata dello schema - Ideale per le viste materializzate - Ideale per il partizionamento |
| Un tenant per tabella in un database singolo | Non consigliata |
Architettura: un tenant per database
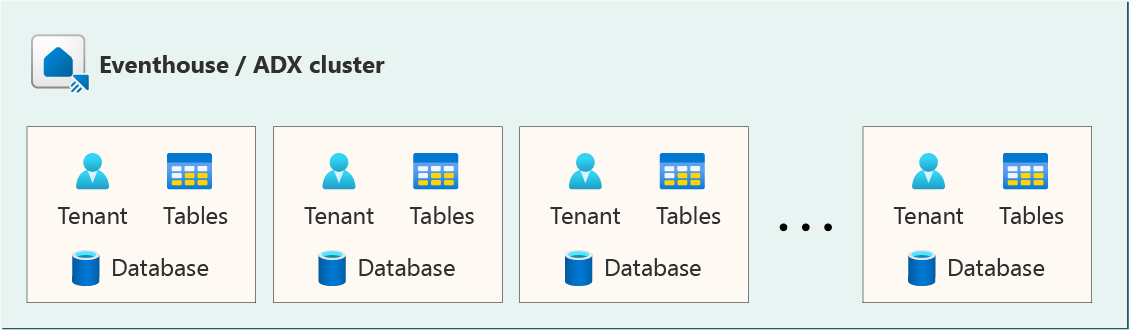
Si tratta di un'architettura popolare e semplice. Ogni tenant ottiene il proprio database. Ogni database ha lo stesso schema.
Le caratteristiche di questa architettura sono:
Provisioning di un nuovo tenant: richiede la creazione di un nuovo database e l'implementazione delle entità dello schema su di esso.
Rimozione di un tenant: richiede l'eliminazione del database. L'eliminazione di un database può essere eseguita in pochi secondi. Utilizza risorse piccole e costanti che non sono lineari con il volume di dati del tenant.
Aggiornamenti degli schemi di database: ogni tenant può essere aggiornato in modo indipendente in momenti diversi. Le applicazioni che accedono ai database devono essere consapevoli della versione di ogni database con cui interagiscono.
Criteri di conservazione e memorizzazione nella cache: ogni tenant può avere criteri univoci, che consentono di fornire criteri di conservazione e memorizzazione nella cache personalizzati ai clienti.
Limite di sicurezza per tenant:
- Per l'applicazione multi-tenant (proxy): configurare l'applicazione per specificare come destinazione il database pertinente. Usare restrizione di accesso per le query per impedire query tra database.
- Per gli utenti con accesso diretto: agli utenti è possibile concedere l'accesso a livello di database. Concedere agli utenti l'accesso diretto al database crea una dipendenza per i dettagli di implementazione, rendendo difficile modificare l'implementazione. È pertanto consigliabile usare l'approccio proxy per accedere al database.
Aggregazione di dati da più tenant su larga scala: usare l'operatore union per aggregare i dati tra i database. Tuttavia, questo metodo può diventare complesso man mano che aumenta il numero di tenant. Anche se l'aggregazione dei dati da più tenant potrebbe essere un obiettivo di progettazione dal punto di vista del tenant, potrebbe essere di interesse per il proprietario della soluzione aggregare i dati di tutti i tenant per raccogliere statistiche.
Frammentazione degli extents: ogni tenant che inserisce alcuni record per tabella di database porta alla creazione di piccoli extents che in seguito devono essere uniti. Ciò comporta costi più elevati per la gestione degli extent. È quindi consigliabile usare l'inserimento in streaming, ad esempio Hub eventi o l'inserimento di Griglia di eventi. Per utilizzare l'ingestione in streaming, è necessario assicurarsi che sia abilitata sia sul cluster che sulla tabella.
Viste materializzate e criteri di partizionamento. Con l'aumentare del numero di tenant, è importante ricordare che ci sono limiti al numero di viste materializzate e criteri di partizione che un cluster può eseguire in modo efficiente.
Connessioni dati di Griglia di eventi e Hub eventi: queste connessioni dati vengono create per ogni database. Pertanto, questa architettura richiede una connessione dati e un'istanza di Griglia di eventi o di Hub eventi per ogni tenant, che aggiunge complessità di gestione. Considerare l'uso del routing degli eventi per Event Hubs e Event Grid.
Architettura: una tabella per molti tenant
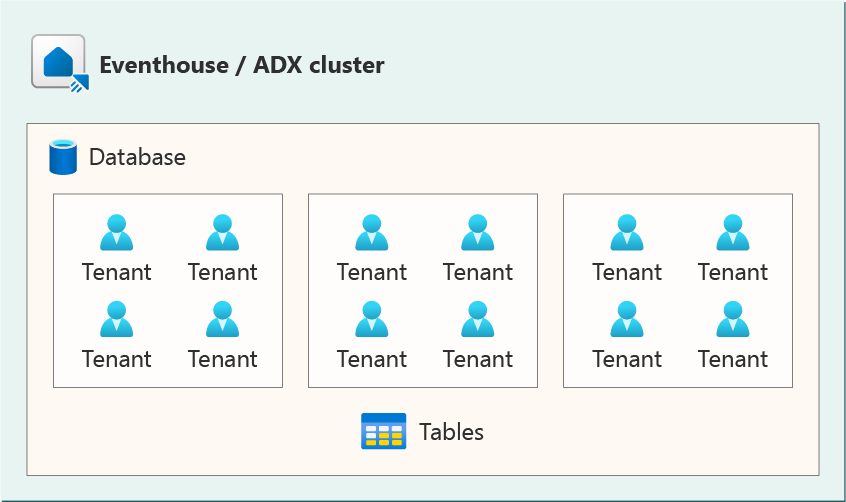
Questa architettura è più aggressiva nel consolidamento, usando un database singolo per tutti i tenant. Ogni tabella nel database ha una colonna ID tenant o equivalente, che consente di filtrare i dati di un singolo tenant. È possibile partizionare le tabelle in base al tenant per migliorare le prestazioni delle query, poiché la maggior parte delle query è probabilmente filtrata in base al tenant. Se possibile, è consigliabile prendere in considerazione la partizione con un'altra colonna usando una chiave di partizione composta . Ad esempio, è possibile creare una chiave di partizione composta concatenando l'ID tenant e i valori di un'altra colonna.
Le caratteristiche di questa architettura sono:
Provisioning di un nuovo tenant: il provisioning di un nuovo tenant non richiede né la creazione di alcun database né la modifica dello schema. Il nuovo Tenant ID viene utilizzato nei nuovi record.
Rimozione di un tenant: richiede un'eliminazione temporanea o un'eliminazione definitiva dei dati del tenant. È possibile raggruppare più ripuliture, ad esempio, alla fine della settimana per limitare l'impatto sull'utilizzo delle risorse.
Aggiornamenti degli schemi di database: lo schema di tutti i tenant viene aggiornato contemporaneamente. Poiché tutti i tenant condividono la tabella, la modifica degli schemi di tabella cambia tutti i tenant contemporaneamente.
Criteri di conservazione e memorizzazione nella cache: i criteri sono gli stessi per tutti i tenant perché condividono tutte la stessa tabella.
Limite di sicurezza per tenant:
- Per l'applicazione multitenant (proxy): utilizzare l'istruzione Restrict
- Per gli utenti con accesso diretto: usare i criteri di sicurezza a livello di riga e acquisire familiarità con le relative limitazioni. Concedere agli utenti l'accesso diretto al database crea una dipendenza per i dettagli di implementazione, rendendo difficile modificare l'implementazione. È pertanto consigliabile usare l'approccio proxy per accedere al database.
Aggregazione di dati da più tenant su larga scala: gli utenti con autorizzazioni di accesso sufficienti possono eseguire una query di aggregazione standard sui dati di più tenant.
Frammentazione degli extent: poiché tutti i tenant ingeriscono i dati nella stessa tabella, i dati possono in genere essere consolidati e ingeriti in modo efficiente in uno o in alcuni extent.
Viste materializzate e criteri di partizionamento: possono essere usati nella tabella multi-tenant. È possibile migliorare le prestazioni partizionando in base all'ID tenant o alla colonna equivalente. Per altre informazioni, vedere Scenari per i criteri di partizione.
Connessioni dati di Event Grid ed Event Hubs: hai consolidato le connessioni dati poiché i dati per tutti i tenant finiscono in un'unica tabella.
Architettura: un tenant per tabella in un database singolo
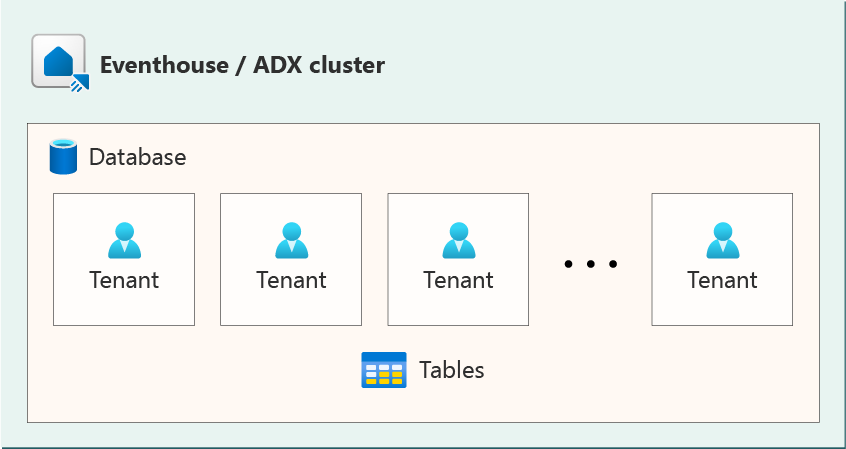
Questa architettura è una combinazione delle architetture precedenti in cui i dati di tutti i tenant finiscono in un singolo database ma tabelle separate. Questa architettura non riesce a acquisire tutti i vantaggi delle altre architetture.
Anche se i dati di ogni tenant sono separati, si trovano tutti nello stesso contesto di sicurezza dello stesso database. Analogamente all'architettura multi-database, questa architettura può causare la frammentazione. Il nome della tabella è diverso per ogni tenant e pertanto le query devono essere personalizzate per ogni tenant.