Nota
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare ad accedere o modificare le directory.
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare a modificare le directory.
È possibile interagire con i file dell'area di lavoro archiviati in Azure Databricks a livello di codice. In questo modo vengono abilitate attività come:
- Archiviazione di piccoli file di dati insieme a notebook e codice.
- Scrittura di file di log nelle directory sincronizzate con Git.
- Importazione di moduli tramite percorsi relativi.
- Creazione o modifica di un file di specifica dell'ambiente.
- Scrittura dell'output dai notebook.
- Scrittura dell'output dall'esecuzione di librerie come Tensorboard.
È possibile creare, modificare, rinominare ed eliminare file dell'area di lavoro a livello di codice in Databricks Runtime 11.3 LTS e versioni successive. Questa funzionalità è supportata per i notebook in Databricks Runtime 16.2 o superiori e per l'ambiente serverless 2 o superiore.
Nota
Per disabilitare la scrittura nei file dell'area di lavoro, impostare la variabile di ambiente del cluster WSFS_ENABLE_WRITE_SUPPORT=false. Per altre informazioni, vedere variabili di ambiente .
Nota
Nei Databricks Runtime 14.0 e versioni successive, la directory di lavoro predefinita corrente (CWD) per il codice eseguito localmente è la directory che contiene il notebook o lo script in esecuzione. Si tratta di una modifica del comportamento rispetto a Databricks Runtime 13.3 LTS e versioni precedenti. Fare riferimento a Qual è la directory di lavoro corrente predefinita?.
Negli ambienti serverless, la presenza di una directory di lavoro non è garantita, quindi usa percorsi assoluti per fare riferimento ai file. Si veda Limitazioni di calcolo serverless.
Leggere i percorsi dei file
Usare i comandi della shell per leggere i percorsi dei file, ad esempio in un repository o nel file system locale.
Per determinare il percorso dei file, immettere quanto segue:
%sh ls
-
I file non si trovano in un repository: Il comando restituisce il file system
/databricks/driver. -
File si trovano in un repository: Il comando restituisce un repository virtualizzato, ad esempio
/Workspace/Repos/name@domain.com/public_repo_2/repos_file_system.
Leggere i file dell'area di lavoro dei dati
È possibile leggere a livello di codice file di dati di piccole dimensioni, come ad esempio i file .csv o .json, direttamente dal codice nei vostri notebook. L'esempio seguente utilizza Pandas per interrogare i file archiviati in una directory contrassegnata come /data, relativa alla radice del repository del progetto.
import pandas as pd
df = pd.read_csv("./data/winequality-red.csv")
df
È possibile usare Spark per leggere i file di dati. È necessario fornire a Spark il percorso completo.
- I file dell'area di lavoro nelle cartelle Git usano il percorso
file:/Workspace/Repos/<user-folder>/<repo-name>/path/to/file. - I file dell'area di lavoro nella directory personale utilizzano il percorso
file:/Workspace/Users/<user-folder>/path/to/file.
È possibile copiare il percorso assoluto o relativo in un file dal menu a discesa accanto al file:
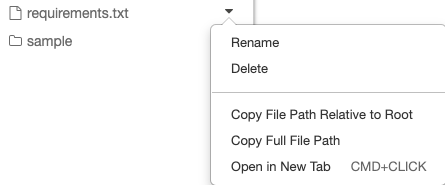
L'esempio seguente illustra l'uso di {os.getcwd()} per ottenere il percorso completo.
import os
spark.read.format("csv").load(f"file:{os.getcwd()}/my_data.csv")
Nota
Nelle aree di lavoro in cui la radice e i mount DBFS sono disabilitati, è anche possibile usare dbfs:/Workspace per accedere ai file dell'area di lavoro utilizzando le utilità Databricks. Ciò richiede Databricks Runtime 13.3 LTS o versione successiva. Vedere Disabilitare l'accesso alla radice e ai montaggi DBFS nell'area di lavoro di Azure Databricks esistente.
Per altre informazioni sui file in Azure Databricks, vedere Usare file in Azure Databricks.
Creare, aggiornare ed eliminare file ed directory a livello di codice
È possibile modificare a livello di codice i file dell'area di lavoro in Azure Databricks, in modo analogo al modo in cui si lavora con i file in qualsiasi file system standard.
Nota
In Databricks Runtime 16.2 e versioni successive e nell'ambiente serverless 2 e versioni successive, tutte le interazioni a livello di codice con i file sono disponibili anche per i notebook. Per informazioni sulla conversione di un file in un notebook, vedere Convertire un file in un notebook.
Nota
La directory genitore di un file deve già esistere prima che tu scriva su di essa. Azure Databricks memorizza temporaneamente nel buffer le scritture dei file e le scarica nell'area di lavoro in modo asincrono, quindi la scrittura in un percorso la cui directory padre non esiste non riesce con AsyncFlushFailedException solo dopo la chiamata di scrittura, anziché nel momento in cui la si effettua. Crea prima la directory genitore, come mostrato nell'esempio seguente.
Gli esempi seguenti usano pacchetti e funzionalità Python standard per creare e modificare file e directory.
import os

# Create a new directory

os.mkdir('dir1')

# Create a new file and write to it

with open('dir1/new_file.txt', "w") as f:
    f.write("new content")

# Append to a file

with open('dir1/new_file.txt', "a") as f:
    f.write(" continued")

# Delete a file

os.remove('dir1/new_file.txt')

# Delete a directory

os.rmdir('dir1')
import shutil

# Copy a dashboard

shutil.copy("my-dashboard.lvdash.json", "my-dashboard-copy.lvdash.json")

# Move a query to a shared folder

shutil.move("test-query.dbquery","shared-queries/")