Nota
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare ad accedere o modificare le directory.
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare a modificare le directory.
Azure Batch esegue processi batch paralleli e HPC (High Performance Computing) su larga scala in Azure. Batch crea e gestisce pool di nodi di calcolo, installa le applicazioni da eseguire e pianifica l'esecuzione dei processi nei nodi.
Quando si usa Azure, l'affidabilità è una responsabilità condivisa. Microsoft offre una gamma di funzionalità per supportare la resilienza e il ripristino. L'utente è responsabile della comprensione del funzionamento di tali funzionalità all'interno di tutti i servizi usati e della selezione delle funzionalità necessarie per soddisfare gli obiettivi aziendali e gli obiettivi di tempo di attività.
Questo articolo descrive come rendere resiliente Azure Batch agli errori transitori, agli errori dei nodi di calcolo, agli errori della zona di disponibilità, ai malfunzionamenti dell'intera area di Azure e alla manutenzione del servizio. Vengono inoltre descritte le raccomandazioni per la distribuzione di produzione, l'architettura di affidabilità di Batch, il backup e il ripristino di Batch e informazioni chiave sul contratto di servizio di Azure Batch.
Raccomandazioni per la distribuzione di produzione
Per i carichi di lavoro di produzione, seguire le procedure consigliate per Azure Batch, incluse queste raccomandazioni sull'affidabilità:
Progetta attività per tollerare interruzioni e riesecuzione. Rendere le attività idempotenti, creare checkpoint per le attività di lunga durata e rendere persistenti i dati di output e di diagnostica necessari in un archivio durevole. Per altre informazioni, vedere Resilienza a errori temporanei e resilienza agli errori dei nodi di calcolo.
Usare più nodi di calcolo quando il carico di lavoro deve continuare dopo un guasto del nodo. Non è garantito che i singoli nodi di calcolo rimangano disponibili. Effettuare il provisioning di nodi sufficienti in modo che i nodi utilizzabili rimanenti possano eseguire attività riprogrammate.
Usare il posizionamento della zona di disponibilità se supportato. Configurare il posizionamento della zona di disponibilità quando l'area geografica, lo SKU della macchina virtuale e la configurazione del carico di lavoro lo supportano. I nodi nelle zone integre possono continuare a eseguire attività durante un'interruzione della zona, ma pianifica una riduzione della capacità perché la capacità di sostituzione dipende dalla quota e dalla disponibilità delle macchine virtuali nelle zone integre. Per altre informazioni, vedere Resilienza agli errori della zona di disponibilità.
Progettare i processi per indirizzarsi ai pool in modo dinamico anziché a un ID pool fisso. Questa architettura consente di reindirizzare un processo a un pool funzionante se il pool originale diventa non disponibile o non riesce a scalare fino alla capacità desiderata. Migliora la continuità aziendale durante la manutenzione o il guasto del pool.
Mantenere aggiornate le configurazioni del pool. Monitorare il supporto di Batch per le date di fine del ciclo di vita (EOL) delle immagini delle macchine virtuali e degli SKU ed eseguire la migrazione dei pool prima dell'EOL. Seguire le indicazioni per la manutenzione del servizio per mantenere aggiornato l'agente del nodo Batch.
Panoramica dell'architettura di affidabilità
Questa sezione descrive alcuni degli aspetti importanti del funzionamento del servizio più rilevanti dal punto di vista dell'affidabilità. La sezione presenta l'architettura logica, che include alcune delle risorse e delle funzionalità distribuite e usate. Illustra anche l'architettura fisica, che fornisce informazioni dettagliate sul funzionamento del servizio sotto le quinte.
Architettura logica
Azure Batch usa diversi tipi di risorse per eseguire carichi di lavoro batch. La configurazione di queste risorse determina il modo in cui il carico di lavoro risponde ai guasti.
Tutte le risorse e l'elaborazione batch sono associate a un account Batch. Una soluzione Batch usa i componenti logici seguenti:
Account di Batch: risorsa a livello di area con cui sono associati pool, processi, attività e altre risorse di Batch. Crei l'account e ne selezioni l'area, la modalità di allocazione del pool e le impostazioni di autenticazione.
Pool: raccolta di nodi di calcolo in cui vengono eseguite le attività. La configurazione di un pool definisce l'immagine e le dimensioni della macchina virtuale, il numero di nodi di destinazione, il comportamento di ridimensionamento, la rete e il posizionamento della zona. È possibile configurare ogni pool per fornire la capacità, il posizionamento e l'ambiente operativo necessari per il carico di lavoro. Il numero di nodi di destinazione è la capacità richiesta, ma il numero di nodi allocati può essere inferiore a causa di limiti di quota, vincoli di capacità o errori di allocazione.
Job e attività: Un job gestisce una raccolta di attività ed è associato a un pool. Un'attività consente l'esecuzione di un'applicazione o di uno script in un nodo di calcolo. Si definiscono job, attività, vincoli, dipendenze, criteri di nuovo tentativo e pool in cui viene eseguito ogni job.
Account di archiviazione associato: Un account Archiviazione di Azure collegato facoltativamente a un account Batch. La maggior parte delle soluzioni Batch usa un account di archiviazione associato per i file dell'applicazione, i file di risorse delle attività, i dati di input e i dati di output.
Dopo aver collegato un account di archiviazione a un account Batch, Batch vi si riferisce come account di archiviazione automatica. Un account autostorage è necessario per i pacchetti dell'applicazione e può anche archiviare i file di risorse delle attività.
L'affidabilità di una soluzione Batch dipende dalle risorse di archiviazione. Si è responsabili della selezione di una configurazione di ridondanza di archiviazione che soddisfi i requisiti di ripristino quando si crea l'account di archiviazione. Spostare l'output delle attività e altri dati durevoli dai nodi di calcolo all'archiviazione. Per informazioni sulle opzioni di affidabilità Archiviazione di Azure, vedere Affidabilità in Archiviazione BLOB di Azure.
Per altre informazioni, vedere Flusso di lavoro e risorse del servizio Batch e account Batch e account Archiviazione di Azure.
Architettura fisica
Azure Batch dispone di un piano di controllo regionale che elabora le operazioni di gestione sugli account Batch e altre risorse di Batch, ad esempio pool, processi e attività. È separato dai nodi di calcolo che eseguono attività.
I pool Azure Batch usano Macchine virtuali di Azure e set di scalabilità di macchine virtuali. Un nodo di calcolo è una macchina virtuale che elabora parte di un carico di lavoro batch. Ogni nodo appartiene a un pool ed esegue attività assegnate dal servizio Batch. L'agente di nodo Batch viene eseguito in ogni nodo e fornisce l'interfaccia di comando e controllo tra il nodo e il servizio Batch. I nodi di calcolo e la relativa risorsa di archiviazione locale sono effimeri. Quando un nodo esce da un pool, le modifiche apportate al sistema operativo e ai file andranno perse.
La modalità di allocazione del pool dell'account Batch determina dove Batch crea le risorse correlate alle macchine virtuali e di calcolo:
- Modalità di allocazione del pool di servizi Batch: Batch alloca le risorse nelle sottoscrizioni Azure gestite dal servizio Batch.
- Modalità di allocazione del pool di sottoscrizione utente: Batch crea le risorse direttamente nella sottoscrizione che contiene l'account Batch.
Le responsabilità per l'architettura fisica sono suddivise nel modo seguente:
Microsoft: Microsoft gestisce il piano di controllo batch regionale e l'infrastruttura del servizio. Batch effettua il provisioning dei nodi di calcolo in base alla configurazione del pool e alla capacità disponibile, pianifica le attività, monitora lo stato di salute dei nodi e tenta di ripristinare i nodi dopo i guasti dell'infrastruttura. Batch può rimettere in coda le attività interrotte per l'esecuzione in un altro nodo disponibile.
L'utente: selezionare l'immagine e le dimensioni della macchina virtuale, i tipi di nodo, il numero di nodi di destinazione, la configurazione del ridimensionamento, la rete e il posizionamento della zona di disponibilità.
Si è anche responsabili della gestione di capacità sufficiente per tollerare guasti dei nodi, monitorare gli stati dei nodi e delle attività, mantenere corrente il sistema operativo guest e l'agente del nodo, progettare attività per tollerare la riesecuzione e spostare dati durevoli dai nodi di calcolo.
Il ripristino dei nodi batch non garantisce che un carico di lavoro continui senza interruzioni. Per altre informazioni, vedere Resilienza ai guasti dei nodi di calcolo.
Resilienza a errori temporanei
Gli errori temporanei sono errori brevi e intermittenti nei componenti. Si verificano spesso in un ambiente distribuito come il cloud e fanno parte delle normali operazioni. Gli errori temporanei si correggono dopo un breve periodo di tempo. È importante che le applicazioni possano gestire gli errori temporanei, in genere ritentando le richieste interessate.
Tutte le applicazioni ospitate nel cloud devono seguire le indicazioni sulla gestione degli errori temporanei di Azure quando comunicano con qualsiasi API, database e altri componenti ospitati nel cloud. Per ulteriori informazioni, vedi Raccomandazioni per la gestione di errori temporanei.
All'interno di una soluzione Batch, gli errori temporanei possono influire sia sulle applicazioni che sugli script eseguiti come attività e su tutte le applicazioni che chiamano le API Batch per gestire le risorse di Batch. Batch fornisce meccanismi di nuovo tentativo a livello di attività. Sei responsabile della configurazione dei vincoli di attività, rendendo le attività idempotenti (sicure da eseguire più volte) e configurando il comportamento di ripetizione dei tentativi per le chiamate al servizio Batch e ad altre dipendenze.
Tentativi di task e limiti di tempo
Configurare maxTaskRetryCount per controllare quante volte Batch ritenta un'attività dopo la chiusura del processo con un codice di uscita diverso da zero:
- Il valore predefinito,
0, indica che Batch non ritenta l'attività dopo un codice di uscita diverso da zero. - Un numero intero positivo imposta un numero massimo di nuovi tentativi dopo il tentativo iniziale.
- Un valore di
-1consente tentativi illimitati. Questo valore non è consigliato perché un errore persistente può causare l'esecuzione illimitata dell'attività.
Progettare ogni attività in modo che sia idempotente in modo che i tentativi non causino il danneggiamento dei dati o l'output duplicato. Per le attività a esecuzione prolungata, usare il checkpoint in modo che un nuovo tentativo possa continuare dall'avanzamento salvato. Per altre informazioni, vedere Progettazione di tentativi e riesecuzione.
Impostare il vincolo maxWallClockTime per un'attività o un processo per interrompere l'attività o il processo che non procede entro un periodo accettabile. Un limite di tempo limita anche l'effetto di errori ripetuti. Selezionare conteggi dei tentativi e limiti di tempo allineati agli obiettivi di ripristino del carico di lavoro.
Errori temporanei nelle dipendenze delle attività
Le applicazioni e gli script eseguiti come attività batch spesso chiamano altri componenti, ad esempio Archiviazione di Azure, database o API. Batch non gestisce le singole richieste inviate dal codice del task a queste dipendenze. Implementare la gestione degli errori temporanei nel codice dell'attività o usare le funzionalità di ripetizione dei tentativi fornite dall'SDK della dipendenza. Seguire le indicazioni di ogni dipendenza per identificare gli errori per cui è possibile eseguire un nuovo tentativo, selezionare le impostazioni di backoff e timeout appropriate e rispettare le istruzioni per i nuovi tentativi, ad esempio l'intestazione Retry-After. Ripetere solo le operazioni che sono sicure da ripetere.
Se un errore di dipendenza causa la chiusura del processo attività con un codice di uscita diverso da zero, Batch può ritentare l'intera attività in base a maxTaskRetryCount. Batch, tuttavia, non ritenta una singola richiesta di dipendenza all'interno di un'attività in esecuzione.
Tentativi delle richieste di API Batch
Le applicazioni in esecuzione all'esterno del servizio possono chiamare le API Batch per creare e gestire pool, processi, attività, nodi di calcolo e altre risorse batch. Configurare i client con criteri di ripetizione che durano almeno cinque minuti per gestire gli errori temporanei del servizio Batch o della rete.
Usare il supporto predefinito dell'SDK per i tentativi ripetuti quando è disponibile. Ad esempio, la libreria client Azure.Compute.Batch per .NET espone il comportamento di ripetizione dei tentativi tramite Azure.Core le opzioni di ripetizione dei tentativi.
Se si interagisce direttamente con le API del servizio Batch dal codice, attendere alcuni secondi prima di riprovare, usare il backoff esponenziale con randomizzazione (jitter) per evitare richieste di ripetizione dei tentativi sincronizzate e rispettare l'intestazione Retry-After restituita con risposte di throttling come 429 Too Many Requests e 503 Service Unavailable.
Un timeout della richiesta non significa necessariamente che Batch non sia riuscito a elaborare la richiesta. Dopo un timeout, ripetere l'operazione quando è sicuro farlo oppure recuperare lo stato della risorsa per determinare se l'operazione originale è riuscita. Per altre informazioni, vedere Gestione e rilevamento degli errori in Azure Batch.
Resilienza ai guasti dei nodi di calcolo
Un nodo di calcolo può diventare non disponibile a causa di un errore dell'infrastruttura, di un problema del sistema operativo o di configurazione. Batch tenta di recuperare i nodi interessati da errori dell'infrastruttura, ma non può recuperare automaticamente ogni errore correlato alla configurazione. Ad esempio, se un pacchetto dell'applicazione o un contenitore non si installa, è necessario correggere il problema sottostante e potrebbe essere necessario rimuovere e sostituire il nodo interessato.
Se un errore del nodo interrompe un'attività, Batch può ritentare l'attività nello stesso nodo, se possibile, fino a un limite interno. Se l'attività non può continuare su tale nodo, Batch può accodarla nuovamente per l'esecuzione in un altro nodo disponibile. Questi tentativi di ripristino basati sul servizio sono indipendenti da maxTaskRetryCount e possono verificarsi anche quando il relativo valore è 0.
processo di ripristino del nodo gestito da Microsoft
Microsoft gestisce il ripristino dei nodi basato sul servizio e il nuovo accodamento delle attività. Se il servizio Batch smette di ricevere heartbeat da un nodo abbastanza a lungo per attivare il ripristino, Batch può eseguire le azioni seguenti:
-
Isolare il nodo: Batch considera il nodo non integro, ne imposta lo stato su
unusablee interrompe la pianificazione di nuove attività. - Identificare le attività interessate: Batch identifica le attività in esecuzione nel nodo come candidate per la riprogrammazione.
-
Rimettere in coda le attività idonee: se un'attività interessata è ancora salvata nello stato
running, Batch può reimpostarla suactivein modo che l'utilità di pianificazione possa assegnarla a un altro nodo. Batch non reimposta né riesegue un'attività già salvata nello statocompleted. - Ripristinare il nodo: Batch tenta di ripristinare il nodo in uno stato integro o di sostituire la macchina virtuale sottostante.
Il ripristino non è istantaneo. Un'attività può rimanere nello stato running mentre Batch rileva l'errore del nodo e tenta di riprogrammare l'attività. Se non è disponibile alcun altro nodo di calcolo, l'attività può rimanere in tale stato fino a quando Batch non potrà riprogrammarla. Per altre informazioni, vedere Limitazioni note per le attività batch.
Se il nodo originale riprende segnali heartbeat regolari prima dell'inizio della sostituzione, Batch può restituirlo a uno stato stabile. Se la sostituzione è già iniziata, Batch può invece rimuovere la macchina virtuale originale ed effettuare il provisioning di una sostituzione.
Responsabilità dell'utente
Il ripristino basato sul servizio non garantisce l'esecuzione ininterrotta delle attività o una capacità rimanente sufficiente. Sei responsabile delle azioni seguenti:
Mantenere una capacità sufficiente: Se il carico di lavoro deve continuare mentre un nodo non è disponibile, effettuare il provisioning di nodi sufficienti affinché i nodi rimanenti possano eseguire le attività riprogrammate. Senza un altro nodo utilizzabile, le attività interrotte devono attendere.
Monitora la capacità utilizzabile: Tenere traccia dei conteggi e degli stati dei nodi aggregati in modo che sia possibile rilevare quando un pool non dispone più di nodi utilizzabili sufficienti per il carico di lavoro. Gli stati come
unusable,startTaskFailed,unknownepreemptedindicano una capacità ridotta. Per altre informazioni, vedere Monitorare le soluzioni Batch conteggiando attività e nodi in base allo stato.Esaminare i nodi problematici: se le attività hanno esito negativo ripetutamente, vengono rimesse in coda o rimangono nello stato
runningdopo che il nodo assegnato diventa inutilizzabile o lascia il pool, usare i metadati dell'attività per determinare se i problemi sono associati a un nodo specifico.Prima di rimuovere un nodo con problemi, caricare i log dell'agente del nodo Batch e conservare i log attività pertinenti perché rimuovendo il nodo vengono eliminati i file locali. I log dell'agente del nodo possono aiutare supporto tecnico Microsoft a diagnosticare i problemi del servizio Batch o dei nodi, mentre i log attività, ad esempio stdout e stderr, consentono di identificare i problemi di applicazione e configurazione. Per altre informazioni, vedere File di log dell'agente node.
Proteggere l'avanzamento e i dati dell'attività: Progettare attività per tollerare interruzioni e riesecuzione. Spostare checkpoint, output e altri dati durevoli dai nodi di calcolo perché l'archiviazione locale è temporanea.
Per altre informazioni, vedere Azure Batch pool e errori del nodo e gestione e rilevamento degli errori in Azure Batch.
Resilienza ai guasti delle zone di disponibilità
Le zone di disponibilità sono gruppi di data center separati fisicamente all'interno di un'area di Azure. In caso di guasto in una zona, i servizi possono passare a una delle zone restanti.
Batch supporta le zone di disponibilità in due modi principali:
Piano di controllo: il piano di controllo Batch è resiliente alle zone in molte aree. In tali aree, le operazioni di gestione sugli account Batch e altre risorse batch possono continuare durante un errore di zona. Microsoft non pubblica quali regioni forniscono la resilienza del piano di controllo.
Pool: È possibile configurare un pool di Batch per l'uso del posizionamento della zona di disponibilità. Se una zona non è più disponibile, i nodi di calcolo nelle zone integre rimangono disponibili per la pianificazione delle attività.
Per il posizionamento dei nodi di calcolo, questo modello di supporto è simile alla ridondanza della zona in altri servizi di Azure perché un singolo pool può contenere nodi di calcolo in più zone di disponibilità. Batch, tuttavia, distribuisce i nodi tra le zone nei limiti del possibile. Tenta di usare tutte le zone nell'area, ma non garantisce il posizionamento in ogni zona o una distribuzione uniforme. Non è possibile selezionare zone specifiche o controllare il numero di nodi posizionati in ogni zona.
Il diagramma seguente illustra un account Batch di esempio. L'account ha un singolo pool con i nodi distribuiti tra tre zone di disponibilità:
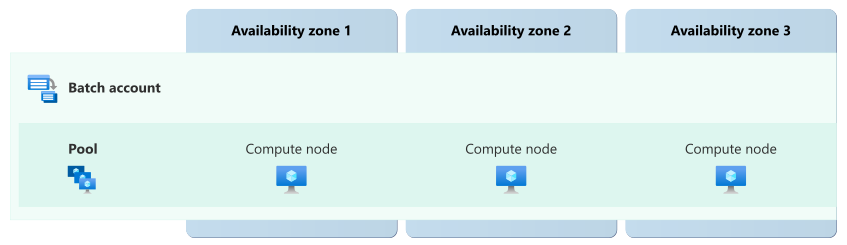
Il diagramma mostra un account Batch che contiene un pool. Il pool ha tre nodi di calcolo, con un nodo visualizzato in ognuna delle zone di disponibilità 1, 2 e 3. Il posizionamento della zona di disponibilità si applica ai nodi di calcolo e non determina la resilienza del piano di controllo Batch rispetto alla zona. La distribuzione è un esempio perché Batch usa il bilanciamento best-effort e non garantisce un nodo in ogni zona.
Sei responsabile di rendere resilienti rispetto alle zone altre risorse dipendenti, ad esempio account di archiviazione. Esaminare le guide sull'affidabilità per ogni servizio. Per altre informazioni, vedere Guide all'affidabilità per i servizi di Azure.
Requirements
Supporto dell'area geografica: Creare il pool in un'area geografica di Azure che supporta le zone di disponibilità.
Disponibilità dello SKU della macchina virtuale: Lo SKU della macchina virtuale selezionato deve essere disponibile in più zone dell'area. Usare la Resource SKUs List API per controllare il campo
locationInforelativo allo SKU della macchina virtuale.Accesso alla sottoscrizione: Per la modalità di allocazione del pool di sottoscrizioni utente, la sottoscrizione non deve avere una restrizione dell'offerta di zona per lo SKU di macchina virtuale selezionato. Controllare
ResourceSkuRestrictionsnella risposta dell'API Elenco SKU di risorse. Se esiste una restrizione, inviare una richiesta di supporto per richiedere la rimozione.Comunicazione tra nodi: Un pool non può usare un criterio di posizionamento della zona di disponibilità quando la comunicazione tra nodi è abilitata con uno SKU di macchina virtuale abilitato per InfiniBand.
Distribuzione di istanze tra zone
Quando si abilita il posizionamento della zona di disponibilità, Batch tenta di allocare nodi di calcolo in tutte le zone di disponibilità nella regione selezionata. Questa allocazione viene eseguita al meglio possibile. Batch controlla perché la distribuzione e il numero di nodi in ogni zona potrebbe non essere uguale.
Cost
Batch non aggiunge un addebito per l'abilitazione del posizionamento della zona di disponibilità. Vengono fatturate le risorse di calcolo, archiviazione, rete e altre Azure usate dal carico di lavoro. Se si effettua il provisioning di nodi aggiuntivi per tollerare la perdita di una zona, tali nodi comportano i normali addebiti. Per altre informazioni, vedere prezzi Azure Batch.
Configurare il supporto delle zone di disponibilità
Creare un nuovo pool con posizionamento della zona di disponibilità: Per creare un pool con posizionamento della zona di disponibilità abilitato, vedere Creare un pool di Batch tra zone di disponibilità.
Modificare il posizionamento della zona di disponibilità in un pool esistente: È necessario selezionare il posizionamento della zona di disponibilità quando si crea il pool. Non è possibile modificare un pool esistente per usare le zone di disponibilità.
È possibile creare un pool di sostituzione e aggiornare ognuno dei processi/lavori per usarlo seguendo questa procedura:
Disabilitare il processo batch: usare l'operazione Disabilita processo e selezionare il modo in cui Batch gestisce le attività in esecuzione quando si invia la richiesta:
-
Attendi: Batch arresta l'avvio di nuove attività e consente alle attività in esecuzione di terminare nel pool esistente. Il processo rimane nello stato
disablingfino al termine delle attività in esecuzione. - Rimetti in coda: Batch interrompe le attività in esecuzione e le restituisce alla coda. Le attività possono essere eseguite di nuovo dopo aver abilitato il job.
- Terminare: Batch interrompe le attività in esecuzione e le contrassegna come completate con informazioni sull'esito negativo che indicano che sono state terminate. Le attività non vengono eseguite di nuovo dopo aver abilitato il processo pianificato.
Le attività già nello stato
active, ossia in coda ma non in esecuzione, rimangono in coda con ogni opzione.Attendere che il processo raggiunga lo stato
disabledprima di continuare. A questo punto, nessuna attività è in esecuzione e Batch non pianifica nuove attività.-
Attendi: Batch arresta l'avvio di nuove attività e consente alle attività in esecuzione di terminare nel pool esistente. Il processo rimane nello stato
Modificare il pool di processi: usare l'operazione Aggiorna processo per impostare il
poolInfo.poolIddel processo sul pool di sostituzione. Batch consente solo la modifica di questa proprietà mentre il processo si trova nellodisabledstato . Assicurarsi che il pool di sostituzione esista e abbia capacità utilizzabile prima di abilitare il job. Se il pool non esiste, Batch accetta l'aggiornamento, ma non può pianificare le attività fino a quando non si crea il pool.Abilitare il processo: usare l'operazione Abilita processo. Il job passa attraverso lo stato
enablingallo statoactive. Batch pianifica quindi le attività in coda, incluse le attività restituite alla coda dall'opzione Requeue , nel pool di sostituzione. Le attività completate quando Batch ha usato l'opzione Attendi e le attività completate dall'opzione Termina non vengono eseguite di nuovo.
Pianificazione e gestione della capacità
Il normale processo di ripristino dei nodi di Batch tenta di sostituire i nodi che diventano inutilizzabili durante un errore della zona e riporta il pool al numero di nodi di destinazione configurato. Non aumenta questo valore. Per mantenere una capacità sufficiente affinché il carico di lavoro possa continuare quando una zona non è disponibile, prendere in considerazione il sovraprovisioning della capacità del pool usando la scalabilità automatica o manualmente:
Se si usa la scalabilità automatica: Fare riferimento alla
$UsableNodeCountvariabile definita dal servizio nella formula di scalabilità automatica del pool per rilevare quando la capacità utilizzabile scende al di sotto della baseline richiesta dal carico di lavoro.$UsableNodeCountè una variabile di scalabilità automatica batch per il pool la cui formula viene valutata, non una metrica di Monitoraggio di Azure. Monitoraggio di Azure pubblica le metriche del numero di nodi batch nell'ambito dell'account Batch e tali metriche non hanno unapoolIddimensione.Se si gestisce la capacità manualmente: Usare l'operazione List Pool Node Counts per recuperare i conteggi dei nodi dedicati e spot in ogni stato per ogni pool. L'operazione non restituisce un singolo conteggio di nodi utilizzabili. Valutare gli stati in grado di eseguire l'attività, quali
idleerunning, rispetto a stati non disponibili o problematici, qualiunusable,unknown,offlineestartTaskFailed. I conteggi restituiti potrebbero non essere aggiornati, quindi elencare i nodi di calcolo del pool quando è necessario un conteggio esatto.
Batch distribuisce i nodi tra le zone nel modo più efficiente possibile, quindi la distribuzione effettiva potrebbe non essere uguale. Non presupporre che i nodi vengano distribuiti equamente tra le zone quando si pianifica il dimensionamento della capacità. Verificare che il carico di lavoro possa soddisfare gli obiettivi di ripristino con capacità del pool ridotta.
Comportamento quando tutte le zone sono integre
Questa sezione descrive cosa aspettarsi quando un pool di Batch usa il posizionamento della zona di disponibilità e tutte le zone sono operative.
Operazione tra zone: Batch pianifica le attività nei nodi di calcolo disponibili in tutto il pool, indipendentemente dalla zona che contiene ogni nodo.
Replica dei dati tra zone: I nodi di calcolo batch sono temporanei e Batch non replica i file di attività tra le zone. Si è responsabili dello spostamento di input, output, checkpoint e dati di diagnostica che devono sopravvivere alla perdita di nodi nell'archiviazione durevole. Configurare la ridondanza dell'account di archiviazione per soddisfare i requisiti di disponibilità.
Comportamento durante un errore di zona
Questa sezione descrive cosa aspettarsi quando un pool di Batch usa il posizionamento della zona di disponibilità e una zona di disponibilità non è disponibile.
Rilevamento e risposta: Microsoft monitora l'integrità del servizio Batch e del nodo di calcolo. Durante un guasto della zona, Batch rileva una perdita prolungata dell'heartbeat dei nodi interessati e avvia il normale processo di ripristino dei nodi. I nodi nelle zone integre rimangono disponibili e Batch può continuare a pianificare le attività.
Batch tenta di ripristinare il pool nel numero di nodi di destinazione configurato tramite il normale processo di ripristino, ma non aumenta tale numero di nodi. Sei responsabile della richiesta di capacità aggiuntiva se il target non fornisce capacità sufficiente per il carico di lavoro.
- Notifica: Microsoft non invia automaticamente una notifica quando una zona è inattiva. È tuttavia possibile usare Integrità dei servizi di Azure per comprendere l'integrità complessiva del servizio, inclusi eventuali errori di zona, ed è possibile configurare gli avvisi di integrità dei servizi per notificare eventuali problemi.
Attività attive: Le attività in esecuzione sui nodi interessati vengono interrotte. Batch potrebbe riprogrammare le attività nei nodi disponibili come parte del relativo comportamento di ripristino interno. Progettare attività per tollerare nuovi tentativi e riesecuzione, come descritto in Resilienza a errori temporanei e resilienza ai guasti dei nodi di calcolo.
Perdita di dati prevista: I file nei nodi di calcolo interessati non sono disponibili durante l'interruzione e vengono persi se i nodi vengono reimpostati con una nuova immagine o rimossi dal pool. Batch non replica questi file tra le zone. I dati salvati in modo permanente nell'archiviazione durevole rimangono disponibili in base alla configurazione di ridondanza della risorsa di archiviazione.
Tempo di inattività previsto: Le attività nei nodi integri continuano. Le attività interrotte subiscono un periodo di inattività fino a quando Batch non può riprogrammarle in nodi utilizzabili. Se non è disponibile alcun nodo utilizzabile, un'attività potrebbe rimanere nello stato
runningfino a quando Batch non potrà riprogrammarla. Il tempo di ripristino dipende dalla capacità del pool disponibile e dal carico di lavoro in coda.Le operazioni di gestione sugli account Batch e altre risorse batch continuano se l'account si trova in un'area in cui il piano di controllo è resiliente alla zona. In altre aree, le operazioni di gestione potrebbero non essere disponibili fino al ripristino della zona interessata.
Ridistribuzione: dopo una perdita prolungata di heartbeat, Batch contrassegna i nodi interessati come
unusablee li invia per la sostituzione tramite il normale processo di ripristino dei nodi. Batch tenta di ripristinare il pool al numero di nodi di destinazione configurato, ma la capacità di sostituzione dipende dalla quota e dalla disponibilità delle VM nelle zone integre.I processi rimangono associati al pool durante questa operazione. Batch continua a pianificare le attività dai job attivi su nodi utilizzabili in zone sane. Se i nodi di sostituzione vengono allocati e diventano utilizzabili, Batch può anche pianificare le attività in tali nodi.
Questo processo di ripristino non aumenta il numero di nodi di destinazione configurato. Se il carico di lavoro richiede capacità oltre tale obiettivo, aumentarla manualmente o configurare la formula di scalabilità automatica del pool per farlo.
Ripristino della zona
Batch gestisce il processo di ripristino quando una zona si riprende dopo un errore. Batch segue lo stesso processo definito in Resilienza ai guasti dei nodi di calcolo.
Batch non garantisce che i nodi vengano ribilanciati uniformemente tra le zone di disponibilità dopo il ripristino. Il posizionamento della zona rimane eseguito nel modo più efficiente possibile.
Verifica dei guasti di zona
Non è possibile simulare un'interruzione effettiva della zona di disponibilità Azure per i test. Usare invece un pool non di produzione per interrompere le attività rappresentative e mettere fuori servizio un numero sufficiente di nodi di calcolo per approssimare la perdita di capacità prevista. Prendere in considerazione l'uso delle operazioni di nodo supportate seguenti:
- Riavvia i nodi selezionati.
- Disabilitare la pianificazione delle attività nei nodi selezionati.
- Rimuovere i nodi selezionati dal pool.
Quando un'operazione consente di scegliere come gestire le attività in esecuzione, selezionare l'opzione Requeue in modo che Batch possa pianificare le attività interrotte nei nodi rimanenti.
Durante il test, verificare che Batch riprogrammi le attività interrotte e che la riesecuzione non produca output duplicato o incoerente. Verificare che i checkpoint e l'output rimangano disponibili dall'archiviazione durevole, il monitoraggio rilevi la perdita di nodi e la riduzione della capacità e il carico di lavoro possa terminare con la capacità rimanente.
Queste operazioni convalidano l'interruzione e la riprogrammazione delle attività, l'idempotenza, il checkpoint e la gestione dell'output durevole. Tuttavia, non riproducono ogni effetto di un errore a livello di zona.
Resilienza agli errori a livello di area
Un account Batch e i relativi pool sono limitati a una singola area geografica di Azure. Se l'area riscontra un errore, potrebbero essere interessati i processi e i pool di Batch.
Batch non esegue la replica degli account, della configurazione del pool, dei processi, delle attività, dei pacchetti dell'applicazione o dei dati delle attività in un'altra area geografica e non fornisce il failover tra aree geografiche integrato. Sei responsabile del deployment e dell'esecuzione di una soluzione Batch multiregione quando il carico di lavoro deve tollerare un guasto a livello di regione.
Soluzioni multiregione personalizzate per la resilienza
Per creare una soluzione multiarea, distribuire almeno un account Batch in ogni area usata dalla progettazione del ripristino di emergenza. Gli account Batch operano in modo indipendente tra aree. Si è responsabili della selezione delle regioni, dell'implementazione e del funzionamento delle risorse in ogni regione e del coordinamento della configurazione, della replica, del failover e del failback.
È possibile progettare un approccio attivo-attivo che invia il lavoro in più aree durante il normale funzionamento o un approccio attivo-passivo che mantiene la distribuzione secondaria pronta per il failover. Le progettazioni attive-attive possono ridurre i tempi di ripristino perché entrambe le distribuzioni elaborano il lavoro durante le normali operazioni, mentre le progettazioni attive-passive possono ridurre i costi di calcolo dello stato stabile.
L'elenco seguente fornisce esempi di responsabilità quando si progetta la soluzione:
Distribuzione: Precreare gli account Batch, i pool o le definizioni di distribuzione del pool, gli account di archiviazione, le risorse di rete e altre dipendenze in ogni area. Verificare che ogni area selezionata supporti le funzionalità di Batch, le dimensioni delle macchine virtuali e i servizi dipendenti richiesti dal carico di lavoro. Mantenere ogni account Batch e le risorse di archiviazione usate dalle attività nella stessa area quando possibile per evitare la latenza non necessaria. Definire account, pool e risorse di supporto di Batch usando l'infrastruttura come codice in modo che la configurazione possa essere riprodotta in modo coerente tra aree.
Quote e capacità: Verificare le quote dell'account Batch, della sottoscrizione e della famiglia di macchine virtuali applicabili in ogni area di ripristino e richiedere aumenti prima di un'interruzione quando necessario. Una quota è un limite, non una garanzia di capacità. La disponibilità delle macchine virtuali varia in base all'area, alla famiglia di macchine virtuali e al tempo. Per altre informazioni, vedere Account Batch e quote di core.
Replica dei dati: Mantenere disponibili pacchetti dell'applicazione, immagini del contenitore, dati di input e dati di riferimento in ogni area di ripristino. Batch non replica automaticamente questi elementi.
Replica di archiviazione: Configurare la ridondanza dell'archiviazione e la replica dei dati tra aree in base all'obiettivo del punto di ripristino. Verificare che i dati replicati siano accessibili da ogni area di ripristino. Per le opzioni di affidabilità dell'archiviazione, vedere Affidabilità in Archiviazione BLOB di Azure.
Selezione dell'area geografica: Se le applicazioni funzionano con l'account Batch, progettarle in modo che possano selezionare un altro account Batch e le risorse di archiviazione associate senza richiedere una distribuzione del codice.
Failover: Batch non sposta automaticamente il carico di lavoro in un'altra area. Sei responsabile del rilevamento di un'interruzione, della determinazione del modo in cui l'interruzione influisce sul carico di lavoro, dell'arresto degli invii all'account Batch interessato, dell'indirizzamento di un nuovo lavoro a un account Batch in un'area integra e di decidere se inviare di nuovo i processi interrotti. I risultati del lavoro o delle attività che non sono stati replicati all'esterno dell'area interessata potrebbero non essere disponibili o andare persi. Il tempo di ripristino dipende dal modello di distribuzione, dalla capacità disponibile, dalla replica dei dati e dall'automazione.
Ripristino dell'area: Dopo il ripristino della disponibilità del servizio nell'area interessata, convalidare l'account Batch, i pool, le dipendenze di archiviazione e lo stato del processo prima di indirizzare il lavoro a tale area. Riconciliare le attività duplicate o parzialmente completate prima della reinviazione. Batch non coordina questo processo né riconcilia lo stato tra gli account regionali.
Test: Testare regolarmente il processo completo di ripristino regionale in un ambiente non di produzione. Simulare che una distribuzione regionale diventi non disponibile, indirizzare direttamente gli invii a un altro account Batch regionale, convalidare l'accesso ai pacchetti dell'applicazione e ai dati di input, eseguire processi rappresentativi, raccogliere l'output e fare pratica per restituire la distribuzione ripristinata al servizio. Misurare i risultati in base all'obiettivo del tempo di ripristino e all'obiettivo del punto di ripristino.
Backup e ripristino
Azure Batch non è un archivio durevole per i dati di input e output del carico di lavoro. Microsoft gestisce il servizio Batch, ma si è responsabili di preservare la configurazione e i dati necessari per ricreare il carico di lavoro:
Configurazione batch: Definire account Batch, pool, processi e risorse di supporto usando l'infrastruttura come codice, ad esempio Bicep e definizioni di processi controllati dalla versione. Questi artefatti offrono un modo ripetibile per ricreare la configurazione nella stessa regione o in un'altra regione. Verificare regolarmente che le definizioni possano distribuire un pool di agenti ed eseguire un processo rappresentativo.
Metadati batch: Batch mantiene i record di job e attività finché non elimini il job o l'attività associata, ma questi record non sono un backup. Se è necessario conservare questa cronologia, mantenere i record necessari all'esterno di Batch.
Dati nei nodi di calcolo: I nodi di calcolo sono temporanei e i relativi file system non sono un backup o una memoria persistente. I dati di un nodo vengono persi quando il nodo viene reimpostato con una nuova immagine o lascia un pool. Batch può anche eliminare i file di attività dopo la scadenza del periodo di conservazione. Rendere persistenti i log di output e di diagnostica necessari in una risorsa di archiviazione durevole prima del completamento di un'attività. Per le attività a esecuzione prolungata, rendere persistenti i checkpoint durante l'esecuzione. Per altre informazioni, vedere Rendere persistente l'output di processi e attività e Monitorare Azure Batch.
Dati negli account di archiviazione automatica: Un account di archiviazione automatica associato può contenere pacchetti dell'applicazione e file di risorse delle attività. Oltre a configurare la ridondanza che soddisfi gli obiettivi di ripristino, valutare se è necessario proteggere questi dati da eliminazioni o danneggiamenti accidentali. Per altre informazioni, vedere Backup e ripristino in Archiviazione BLOB di Azure.
Test di ripristino e recupero
Per ripristinare, distribuire Batch e la configurazione delle risorse di supporto, ripristinare o riconnettere i dati di input e gli artefatti dell'applicazione necessari e inviare di nuovo il lavoro che non è stato completato. Testare periodicamente sia la ricostruzione delle risorse che il ripristino dei dati in un ambiente di ripristino isolato o non di produzione. Usare le definizioni con il controllo delle versioni e i dati sottoposti a backup, eseguire un processo rappresentativo, verificare l'output risultante e l'accesso alle dipendenze e misurare il tempo di ripristino e l'obiettivo del punto di ripristino (RPO) raggiunti rispetto agli obiettivi. Verificare che le attività siano idempotenti in modo che la nuova sottomissione di operazioni incerte non corrompa i dati o crei un output duplicato.
Resilienza alla manutenzione del servizio
Microsoft esegue la manutenzione della piattaforma e coordina gli aggiornamenti dell'infrastruttura per Azure Batch e altri servizi. Sei responsabile della configurazione del comportamento di aggiornamento del pool e della progettazione delle attività per tollerare l'interruzione.
Manutenzione host: Azure usa tecniche di manutenzione come la migrazione in tempo reale, quando possibile. Se la manutenzione richiede il riavvio o lo spostamento di un nodo di calcolo, l'esecuzione di attività può essere interrotta e Batch potrebbe ripianificarle. Rendere le attività idempotenti e rendere persistenti i checkpoint e l'output in una risorsa di archiviazione durevole.
Sistema operativo guest: Sei responsabile di mantenere aggiornati il sistema operativo guest e l'agente del nodo Batch. Il comportamento di aggiornamento del sistema operativo dipende dall'immagine e dalla configurazione di aggiornamento. Con la configurazione appropriata, gli aggiornamenti automatici delle immagini del sistema operativo per i pool di Batch possono aggiornare i nodi del pool senza interrompere le attività in esecuzione. Gli aggiornamenti automatici delle immagini del sistema operativo non supportano ogni immagine del sistema operativo Batch.
Aggiornamenti dell'agente del nodo: Gli aggiornamenti automatici delle immagini del sistema operativo non aggiornano automaticamente l'agente del nodo Batch. Gli agenti del nodo Batch non vengono aggiornati automaticamente finché un pool dispone di nodi di calcolo. Per ricevere un node agent più recente, ridimensionare il pool a zero nodi e aumentarlo di nuovo o sostituire il pool. Prima di rimuovere i nodi, mantenere i log di diagnostica e l'output dei task necessari. Per altre informazioni, vedere Aggiornamenti dell'agente del nodo Batch.
Segui le indicazioni per la distribuzione di produzione e le indicazioni relative ai guasti dei nodi di calcolo per consentire al carico di lavoro di continuare a funzionare o riprendersi quando la manutenzione interrompe le attività o rende i nodi di calcolo non disponibili.
Contratto di servizio
Il contratto di servizio per i servizi di Azure descrive la disponibilità prevista di ogni servizio e le condizioni che la soluzione deve soddisfare per raggiungere tale aspettativa di disponibilità. Per ulteriori informazioni, vedere Accordi sul livello di servizio (SLA) per i servizi online.
Lo SLA di disponibilità di Azure Batch si applica alle operazioni eseguite sull'API Batch. Per informazioni dettagliate sui tipi di operazioni incluse, vedere la formulazione del contratto di servizio. Le dimensioni del pool, la distribuzione della zona e i servizi dipendenti influiscono sulla disponibilità end-to-end del carico di lavoro, ma non modificano i termini del contratto di servizio di Batch.