Nota
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare ad accedere o modificare le directory.
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare a modificare le directory.
Si applica a: SQL ServerDatabase SQL di AzureIstanza gestita di SQL di AzureDatabase SQL in Microsoft Fabric
Il motore di database di SQL Server consente di elaborare le query su diverse architetture di archiviazione dei dati, come tabelle locali, tabelle partizionate e tabelle distribuite su più server. Le sezioni seguenti trattano come il motore di database elabora le query e ottimizza il riutilizzo delle query tramite la cache del piano di esecuzione.
Gli esempi di codice in questo articolo utilizzano il AdventureWorks2025, AdventureWorksDW2025, o AdventureWorksLT2025 database di esempi, che puoi scaricare dal repository GitHub Azure Data SQL Samples Repository.
Modalità di esecuzione
Il Motore di database di SQL Server può elaborare Transact-SQL istruzioni (T-SQL) utilizzando due modalità di elaborazione distinte:
- Esecuzione in modalità riga
- Esecuzione in modalità batch
Esecuzione in modalità riga
L'esecuzione in modalità riga è un metodo di elaborazione delle query utilizzato con tabelle e indici rowstore, dove i dati sono memorizzati in formato riga. Quando viene eseguita una query e accede ai dati nelle tabelle e negli indici dei rowstore, gli operatori dell'albero di esecuzione e gli operatori figli leggono ogni riga richiesta, su tutte le colonne specificate nello schema dell'oggetto. Da ogni riga letta, il motore di database recupera quindi le colonne richieste per l'insieme di risultati, come indicato da un'istruzione SELECT, da un predicato JOIN o da un predicato di filtro.
Nota
L'esecuzione in modalità riga è molto efficiente per scenari OLTP, ma può essere meno efficiente quando si scansionano grandi quantità di dati, ad esempio in scenari di Data Warehousing.
Esecuzione in modalità batch
L'esecuzione in modalità batch è un metodo di elaborazione delle query che elabora più righe insieme (da cui il termine batch). Ogni colonna all'interno di un batch viene archiviata come vettore in un'area separata della memoria, pertanto l'elaborazione in modalità batch è basata su vettore. L'elaborazione in modalità batch utilizza anche algoritmi ottimizzati per i set di istruzioni avanzati e per il maggiore throughput della memoria nei processori moderni.
L'esecuzione in modalità batch era originariamente integrata e ottimizzata attorno al formato di archiviazione columnstore. A partire da SQL Server 2019 (15.x) e da database SQL di Azure, l'esecuzione in modalità batch non richiede indici columnstore. Per ulteriori informazioni, consultare la modalità batch in rowstore.
L'elaborazione in modalità batch funziona su dati compressi quando possibile ed elimina l'operatore di scambio utilizzato dall'esecuzione in modalità riga. Ne derivano un migliore parallelismo e prestazioni più veloci.
Quando una query viene eseguita in modalità batch e accede ai dati negli indici columnstore, gli operatori dell'albero di esecuzione e gli operatori figlio leggono più righe insieme nei segmenti di colonna. Il motore di database legge solo le colonne richieste per il risultato, come indicato da un'istruzione SELECT, JOIN predicato o predicato di filtro. Per maggiori informazioni sugli indici degli Columnstore, vedi Architettura dell'Indice Columnstore.
Nota
L'esecuzione in modalità batch è molto efficiente per scenari di data warehousing dove può leggere e aggregare grandi quantità di dati.
Elaborazione di istruzioni SQL
Elaborare una singola istruzione T-SQL è il modo più basilare con cui il motore di database esegue le istruzioni T-SQL. I passaggi seguenti illustrano il processo di base elaborando una singola SELECT istruzione che fa riferimento solo a tabelle base locali (senza viste o tabelle remote).
Ordine di precedenza degli operatori logici
Quando si usano più di un operatore logico in un'affermazione, NOT viene valutato per primo, poi AND, e infine OR. Gli operatori aritmetici e bitwise sono gestiti prima degli operatori logici. Per ulteriori informazioni, vedi Precedenza operatore.
Nel seguente esempio, la condizione di colore si applica al modello prodotto 21, e non al modello prodotto 20, perché AND ha precedenza su OR.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE ProductModelID = 20
      OR ProductModelID = 21
         AND Color = 'Red';
GO
L'uso delle parentesi, anche quando non è obbligatorio, può migliorare la leggibilità delle query e ridurre la probabilità di errori dovuti alla precedenza dell'operatore. L'esempio seguente è più leggibile rispetto a quello precedente e ha lo stesso significato.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE ProductModelID = 20
      OR (ProductModelID = 21
          AND Color = 'Red');
GO
È possibile modificare il significato della query aggiungendo le parentesi in modo da imporre la priorità dell'operatore OR nell'ordine di valutazione. La query seguente trova solo i prodotti di colore rosso dei modelli 20 e 21.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE (ProductModelID = 20
       OR ProductModelID = 21)
      AND Color = 'Red';
GO
Ottimizzare le istruzioni SELECT
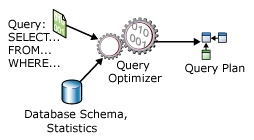
Un'istruzione SELECT non definisce esattamente la procedura che il server di database deve eseguire per recuperare i dati richiesti. Questo comportamento dichiarativo significa che il server del database deve analizzare l'istruzione e il database per determinare il modo più efficiente per estrarre i dati richiesti. Questo processo è chiamato ottimizzazione del piano di interrogazione. Il componente che svolge questo compito è l'Ottimizzatore di Query. L'input al Query Optimizer consiste nella query, nello schema del database (definizioni degli oggetti) e nelle statistiche degli oggetti. L'output del Query Optimizer è un piano di esecuzione delle query, talvolta chiamato query plan o piano di esecuzione. I contenuti di un piano di esecuzione sono descritti in modo più dettagliato in Execution plan caching and reuse.
Il diagramma seguente illustra gli input e output del Query Optimizer durante l'ottimizzazione di una singola SELECT istruzione:
Un'istruzione SELECT definisce solo:
- Il formato del set di risultati. Questo elemento viene nella maggior parte dei casi specificato nell'elenco di selezione. Altre clausole, ad esempio
ORDER BYeGROUP BY, possono tuttavia influire sul formato finale del set di risultati. - Le tabelle che contengono i dati di origine. Questo è specificato nella clausola
FROM. - La relazione logica delle tabelle ai fini della dichiarazione
SELECT. Questo è definito nell'espressione join, che può apparire nella clausolaWHEREo in una clausolaONsuccessiva aFROM. - Le condizioni che le righe delle tabelle di origine devono soddisfare per qualificarsi per l'istruzione
SELECT. Queste condizioni vengono specificate nelle clausoleWHEREedHAVING.
Un piano di esecuzione della query definisce:
La sequenza di accesso alle tabelle di origine.
Tipicamente, il server di database può accedere alle tabelle base in molte sequenze per costruire il set di risultati. Ad esempio, se l'istruzione
SELECTfa riferimento a tre tabelle, il server di database può accedere innanzitutto aTableA, usare i dati diTableAper estrarre le righe corrispondenti daTableB, quindi usare i dati diTableBper estrarre i dati daTableC. Di seguito vengono indicate le altre sequenze di accesso alle tabelle utilizzabili dal server di database:TableC,TableB,TableA, o
TableB,TableA,TableC, o
TableB,TableC,TableA, o
TableC,TableA,TableBI metodi usati per estrarre i dati da ogni tabella.
Per accedere ai dati di ogni tabella sono in genere disponibili metodi diversi. Se sono richieste solo poche righe con valori chiave specifici, il server del database può rapidamente cercare le righe o scansionare un piccolo intervallo di indici. Se tutte le righe della tabella sono necessarie, il server del database può invece scansionare l'intera tabella o l'indice. Se tutte le righe di una tabella sono richieste ma c'è un indice le cui colonne chiave sono in un
ORDER BY, eseguire una scansione dell'indice invece di una scansione della tabella potrebbe evitare un ordinamento separato del set di risultati. Se una tabella è molto piccola, le scansioni complete potrebbero essere il metodo più efficiente per quasi tutti gli accessi alla tabella.I metodi usati per eseguire i calcoli e i modi usati per filtrare, aggregare e ordinare i dati da ogni tabella.
Man mano che i dati vengono accessi dalle tabelle, diversi metodi eseguono calcoli sui dati, come il calcolo dei valori scalari, aggregando e ordinando i dati come definito nel testo della query. Ad esempio, quando si usa una clausola
GROUP BYoORDER BYclausola, e come filtrare i dati, ad esempio quando si usa una clausolaWHEREoHAVINGclausola.
Il processo di scelta di un piano di esecuzione è denominato ottimizzazione. Query Optimizer è uno dei più importanti componenti del motore di database. Sebbene il Query Optimizer utilizzi un certo overhead per analizzare la query e selezionare un piano, questo overhead viene in genere recuperato più volte quando il Query Optimizer sceglie un piano di esecuzione efficiente. Si supponga, ad esempio, che il progetto di costruzione di una casa venga assegnato a due imprese edili diverse. Se un'azienda dedica qualche giorno all'inizio a pianificare come costruire la casa, e l'altra inizia a costruire senza pianificazione, l'azienda che si prende il tempo di pianificare il progetto probabilmente finisce per prima.
Il Query Optimizer è un ottimizzatore basato sui costi. A ogni piano di esecuzione possibile corrisponde un costo in termini di quantità di risorse del computer utilizzate. Query Optimizer analizza i piani possibili e sceglie il piano con il costo stimato minore. Alcune istruzioni complesse hanno migliaia di possibili piani di esecuzione. In questi casi, Query Optimizer non analizza tutte le combinazioni possibili, ma utilizza algoritmi complessi per individuare rapidamente un piano di esecuzione il cui costo si avvicini il più possibile al costo minimo teorico.
L'ottimizzatore di query non sceglie necessariamente il piano di esecuzione con il costo stimato più basso. Trova un piano con un costo stimato ragionevole entro il tempo disponibile per l'ottimizzazione. Un piano di esecuzione parallelo potrebbe utilizzare più risorse di un piano di esecuzione seriale, riducendo però il tempo di esecuzione stimato.
L'Ottimizzatore di Query di SQL Server si basa sulle statistiche quando stima i costi delle risorse di diversi metodi per estrarre informazioni da una tabella o da un indice. Le statistiche sono conservate per colonne e indici, e contengono informazioni sulla densità1 dei dati sottostanti. Queste informazioni indicano la selettività dei valori in un particolare indice o colonna. Ad esempio, in una tabella che rappresenta automobili, molte automobili vengono prodotte dallo stesso costruttore, ma a ciascuna è assegnato un numero di identificazione univoco. Un indice basato sul numero di identificazione del veicolo è più selettivo rispetto all'indice basato sul produttore, perché il numero di identificazione del veicolo ha una densità minore rispetto al produttore. Se le statistiche dell'indice non sono aggiornate, Query Optimizer potrebbe non scegliere la soluzione migliore per lo stato corrente della tabella. Per altre informazioni sulle densità, vedere Statistiche.
1 La densità definisce la distribuzione di valori univoci esistenti nei dati, o il numero medio di valori duplicati per una determinata colonna. Man mano che la densità diminuisce, aumenta la selettività di un valore.
L'Ottimizzatore di Query è importante perché consente al server di database di adattarsi dinamicamente alle condizioni mutevoli del database senza richiedere input da parte di uno sviluppatore o di un amministratore del database. Questa funzione permette agli sviluppatori di concentrarsi nel descrivere il risultato finale della query. Possono fidarsi del Query Optimizer per costruire un piano di esecuzione efficiente per lo stato del database ogni volta che il piano di query di un'istruzione viene ottimizzato.
Nota
SQL Server Management Studio propone tre opzioni per visualizzare i piani di esecuzione:
- Il Piano di Esecuzione Stimato, che è il piano compilato, come prodotto dall'Ottimizzatore di Query.
- Il Piano di Esecuzione Reale, che è lo stesso del piano compilato più il suo contesto di esecuzione. Questo contesto include informazioni di runtime disponibili dopo il completamento dell'esecuzione, come avvisi di esecuzione, o nelle versioni più recenti del motore di database, il tempo trascorso e il tempo CPU utilizzato durante l'esecuzione.
- Le Statistiche di Query in Tempo Reale sono le stesse del piano compilato più il suo contesto di esecuzione. Questo contesto include informazioni di runtime durante l'esecuzione e viene aggiornato ogni secondo. Le informazioni a tempo di esecuzione includono, ad esempio, il numero effettivo di righe che scorrono attraverso gli operatori.
Elaborare un'istruzione SELECT
Il motore di database elabora una singola SELECT istruzione seguendo questi passaggi:
- Il parser esegue l'analisi dell'istruzione
SELECTe la suddivide in unità logiche, quali parole chiave, espressioni, operatori e identificatori. - Un albero di query, talvolta chiamato albero di sequenza, viene costruito per descrivere i passaggi logici necessari per trasformare i dati sorgente nel formato richiesto dall'insieme dei risultati.
- L'ottimizzatore di query analizza diversi modi per accedere alle tabelle sorgente. Seleziona la serie di passaggi che restituisce i risultati più rapidamente utilizzando meno risorse. Aggiorna l'albero delle query per registrare esattamente questa serie di passaggi. La versione finale ottimizzata dell'albero della query è denominato piano di esecuzione.
- Il motore relazionale inizia a eseguire il piano. Mentre elabora i passaggi che necessitano di dati dalle tabelle base, richiede i rowset richiesti al motore di storage.
- Il motore relazionale elabora i dati restituiti dal motore di archiviazione nel formato definito per il set di risultati e restituisce il set di risultati al client.
Valutazione delle espressioni e costante piegamento
Il motore di database valuta alcune espressioni costanti in una fase preliminare per migliorare le prestazioni delle query. Questa tecnica di ottimizzazione utilizzata dall'ottimizzatore di query mira a semplificare le espressioni in tempo di compilazione piuttosto che in tempo di esecuzione. Implica la valutazione delle espressioni costanti durante la compilazione delle query in modo che il piano di esecuzione risultante sia più efficiente. Questo processo è chiamato constant folding. Una costante è un letterale T-SQL, come 3, 'ABC', '2025-12-31', 1.0e3, o 0x12345678. Ad esempio, eseguire questa query:
SELECT *
FROM Orders
WHERE OrderDate < DATEADD(day, 30 * 12, '2025-01-01');
Qui, 30 * 12 è un'espressione costante. Il motore di database valuta questa espressione durante la compilazione e può riscrivere internamente la query come:
SELECT *
FROM Orders
WHERE OrderDate < DATEADD(day, 360, '2025-01-01');
Espressioni piegabili
Il motore di database utilizza il folding costante con i seguenti tipi di espressioni:
- Espressioni aritmetiche che contengono solo costanti, ad esempio
1 + 1e5 / 3 * 2. - Espressioni logiche che contengono solo costanti, ad esempio
1 = 1e1 > 2 AND 3 > 4. - Funzioni integrate che il motore di database considera compatibili con il folding, inclusi
CASTeCONVERT. Generalmente, una funzione intrinseca è foldable se dipende solo dai suoi input e non da altre informazioni contestuali, comeSETopzioni, impostazioni linguistiche, opzioni del database e chiavi di cifratura. Le funzioni non deterministiche non sono riducibili. Le funzioni predefinite deterministiche sono soggette a semplificazione, con alcune eccezioni. - Metodi deterministici dei tipi CLR definiti dall'utente e delle funzioni CLR a valori scalari deterministici definite dall'utente. Per altre informazioni, vedere Elaborazione delle costanti in fase di compilazione per funzioni e metodi CLR definiti dall'utente.
Nota
Viene fatta un'eccezione per i tipi di oggetto grande. Se il tipo di output del processo di folding è un tipo large object (text, ntext, image, nvarchar(max), varchar(max), varbinary(max), json o xml), il motore di database non esegue il folding dell'espressione.
Espressioni non pieghevoli
Tutti gli altri tipi di espressioni non sono riducibili. In particolare, le seguenti tipologie di espressioni non sono comprimibili:
- Espressioni non costanti, ad esempio un'espressione il cui risultato dipende dal valore di una colonna.
- Espressioni il cui risultato dipende da una variabile o un parametro locale, ad esempio
@x. - Funzioni non deterministiche.
- Funzioni T-SQL definite dall'utente.
- Espressioni il cui risultato dipende dalle impostazioni della lingua.
- Espressioni i cui risultati dipendono dalle
SETopzioni. - Espressioni il cui risultato dipende dalle opzioni di configurazione del server.
Esempi di espressioni costanti pieghevoli e non pieghevoli
Considera la query seguente:
USE AdventureWorks2025;
GO

SELECT *
FROM Sales.SalesOrderHeader AS s
     INNER JOIN Sales.SalesOrderDetail AS d
         ON s.SalesOrderID = d.SalesOrderID
WHERE TotalDue > 117.00 + 1000.00;
Se l'opzione PARAMETERIZATION database non è impostata su FORCED per questa query, l'espressione 117.00 + 1000.00 viene valutata e sostituita dal suo risultato, 1117.00, prima che la query venga compilata. I vantaggi di questo constant folding includono:
- L'espressione non deve essere valutata più volte in fase di esecuzione.
- Il valore dell'espressione dopo essere stata valutata viene utilizzato dall'Ottimizzatore di Query per stimare la dimensione dell'insieme di risultati della porzione della query
TotalDue > 117.00 + 1000.00.
D'altra parte, se dbo.f è una funzione scalare definita dall'utente, l'espressione dbo.f(100) non viene semplificata, perché il motore di database non semplifica le espressioni che coinvolgono funzioni definite dall'utente, anche se sono deterministiche. Per maggiori informazioni sulla parametrizzazione, vedi Parametrizzazione forzata.
Valutazione di espressioni
Alcune espressioni per cui non viene eseguita l'elaborazione delle costanti ma i cui argomenti sono noti in fase di compilazione, sia che si tratti di parametri o di costanti, vengono valutate tramite lo strumento per la stima delle dimensioni del set di risultati (cardinalità) che è incluso in Query Optimizer durante l'ottimizzazione.
In particolare, se tutti gli input sono noti, in fase di compilazione vengono valutati gli operatori speciali e le funzioni predefinite seguenti: UPPER, LOWER, RTRIM,DATEPART( YY only ), GETDATE, CAST e CONVERT. Anche gli operatori seguenti vengono valutati in fase di compilazione se tutti i relativi input sono noti:
- Operatori aritmetici:
+,-,*,/, unario- - Operatori logici:
AND,OR,NOT - Operatori di confronto:
<,>,<=,>=,<>,LIKE,IS NULL,IS NOT NULL
Gli altri operatori o funzioni non vengono valutati da Query Optimizer durante la stima della cardinalità.
Esempi di valutazione delle espressioni in fase di compilazione
Considerare la stored procedure seguente:
USE AdventureWorks2025;
GO

CREATE PROCEDURE MyProc
(
    @d DATETIME
)
AS
SELECT COUNT(*)
FROM Sales.SalesOrderHeader
WHERE OrderDate > @d + 1;
Durante l'ottimizzazione dell'istruzione SELECT nella procedura, Query Optimizer prova a valutare la cardinalità prevista del set di risultati per la condizione OrderDate > @d + 1. L'espressione @d + 1 non viene elaborata come costante perché @d è un parametro. Durante l'ottimizzazione, tuttavia, il valore del parametro è noto. Questo valore permette all'Ottimizzatore di Query di stimare con precisione la dimensione del set di risultati, il che lo aiuta a selezionare un buon piano di interrogazione.
Si consideri ora un esempio simile a quello precedente, ad eccezione del fatto che una variabile @d2 locale sostituisce @d + 1 nella query e l'espressione viene valutata in un'istruzione SET anziché nella query.
USE AdventureWorks2025;
GO

CREATE PROCEDURE MyProc2
(
    @d DATETIME
)
AS
BEGIN
    DECLARE @d2 AS DATETIME;
    SET @d2 = @d + 1;
    SELECT COUNT(*)
    FROM Sales.SalesOrderHeader
    WHERE OrderDate > @d2;
END
Quando l'SELECTistruzione in MyProc2 è ottimizzata nel motore di database, il valore di @d2 non è noto. Pertanto, l'ottimizzatore di query utilizza una stima predefinita per la selettività di OrderDate > @d2 (in questo caso 30 percento).
Elaborare altre istruzioni
I passaggi base per elaborare un'istruzione SELECT si applicano ad altre istruzioni T-SQL come INSERT, UPDATE, e DELETE. Le istruzioni UPDATE e DELETE devono puntare all'insieme di righe da modificare o eliminare. usando un processo di identificazione delle righe corrispondente a quello che consente di identificare le righe di origine che formano il set di risultati di un'istruzione SELECT . Entrambe UPDATE le istruzioni e INSERT potrebbero contenere istruzioni incorporate SELECT che forniscono i valori dati da aggiornare o inserire.
Anche le istruzioni del Data Definition Language (DDL), come CREATE PROCEDURE o ALTER TABLE, si risolvono in una serie di operazioni relazionali sulle tabelle di catalogo di sistema e talvolta (come ALTER TABLE ADD COLUMN) contro le tabelle dei dati.
Tabelle di lavoro
Il motore relazionale potrebbe aver bisogno di costruire una tabella di lavoro per eseguire un'operazione logica specificata in un'istruzione T-SQL. Le worktable sono tabelle interne che contengono risultati intermedi. Le tabelle di lavoro vengono generate per alcune query GROUP BY, ORDER BYo UNION . Ad esempio, se una ORDER BY clausola fa riferimento a colonne che non sono coperte da indici, il motore relazionale potrebbe dover generare una tabella di lavoro per ordinare l'insieme di risultati nell'ordine richiesto. Le tabelle di lavoro vengono a volte utilizzate anche come spool per conservare temporaneamente il risultato dell'esecuzione di una parte di un piano di query. I tavoli da lavoro sono creati in tempdb, e poi vengono eliminati automaticamente quando non servono più.
Risoluzione delle viste
Il processore di query del motore di database tratta in modo diverso le viste indicizzate e non indicizzate:
- Il database memorizza le righe di una vista indicizzata nello stesso formato di una tabella. Se l'Ottimizzatore di Query decide di utilizzare una vista indicizzata in un piano di interrogazione, tratta la vista indicizzata allo stesso modo di una tabella base.
- Viene archiviata solo la definizione di una vista non indicizzata e non le righe della vista. L'ottimizzatore di query incorpora la logica della definizione della vista nel piano di esecuzione che costruisce per l'istruzione T-SQL che fa riferimento alla vista non indicizzata.
La logica che il Query Optimizer utilizza per decidere quando utilizzare una vista indicizzata è simile a quella che utilizza per decidere quando utilizzare un indice su una tabella. Se i dati nella vista indicizzata coprono tutto o parte dell'istruzione T-SQL, e il Query Optimizer determina che un indice nella vista è il percorso di accesso a basso costo, sceglie l'indice indipendentemente dal fatto che la query faccia riferimento alla vista per nome.
Quando un'istruzione T-SQL fa riferimento a una vista non indicizzata, il parser e l'ottimizzatore di query analizzano la definizione sia dell'istruzione T-SQL sia della vista e poi le risolvono in un unico piano di esecuzione. L'istruzione T-SQL e la vista non hanno piani separati.
Si consideri, ad esempio, la vista seguente:
USE AdventureWorks2025;
GO

CREATE VIEW EmployeeName AS
    SELECT h.BusinessEntityID,
           p.LastName,
           p.FirstName
    FROM HumanResources.Employee AS h
         INNER JOIN Person.Person AS p
             ON h.BusinessEntityID = p.BusinessEntityID;
GO
Sulla base di questa visione, entrambe queste istruzioni T-SQL eseguono le stesse operazioni sulle tabelle base e producono gli stessi risultati:
USE AdventureWorks2025;
GO

/* SELECT referencing the EmployeeName view. */
SELECT LastName AS EmployeeLastName,
       SalesOrderID,
       OrderDate
FROM Sales.SalesOrderHeader AS soh
     INNER JOIN dbo.EmployeeName AS EmpN
         ON (soh.SalesPersonID = EmpN.BusinessEntityID)
WHERE OrderDate > '20230531';

/* SELECT referencing the Person and Employee tables directly. */
SELECT LastName AS EmployeeLastName,
       SalesOrderID,
       OrderDate
FROM HumanResources.Employee AS e
     INNER JOIN Sales.SalesOrderHeader AS soh
         ON soh.SalesPersonID = e.BusinessEntityID
     INNER JOIN Person.Person AS p
         ON e.BusinessEntityID = p.BusinessEntityID
WHERE OrderDate > '20230531';
La funzione Showplan di SQL Server Management Studio (SSMS) mostra che il motore relazionale costruisce lo stesso piano di esecuzione per entrambe queste SELECT istruzioni.
Usare hint con le viste
Se inserisci hint nelle viste di una query, potrebbero entrare in conflitto con altri hint scoperti quando la vista si espande per accedere alle sue tabelle di base. Quando si verifica questo conflitto, la query restituisce un errore. Si consideri, ad esempio, la vista seguente nella cui definizione è contenuto un hint di tabella:
USE AdventureWorks2025;
GO

CREATE VIEW Person.AddrState
WITH SCHEMABINDING AS
    SELECT a.AddressID,
           a.AddressLine1,
           s.StateProvinceCode,
           s.CountryRegionCode
    FROM Person.Address AS a WITH (NOLOCK), Person.StateProvince AS s
    WHERE a.StateProvinceID = s.StateProvinceID;
Si supponga a questo punto di immettere la query seguente:
SELECT AddressID,
       AddressLine1,
       StateProvinceCode,
       CountryRegionCode
FROM Person.AddrState WITH (SERIALIZABLE)
WHERE StateProvinceCode = 'WA';
La query fallisce, perché l'hint nella view Person.AddrState si propaga sia alle tabelle Person.Address che a Person.StateProvince nella view quando viene espansa. L'espansione della vista consente anche di rilevare il suggerimento NOLOCK su Person.Address. Gli hint SERIALIZABLE e NOLOCK sono in conflitto tra loro, pertanto la query risultante non è corretta.
Gli hint di tabella PAGLOCK, NOLOCK, ROWLOCK, TABLOCK e TABLOCKX sono in conflitto tra loro, così come gli hint di tabella HOLDLOCK, NOLOCK, READCOMMITTED, REPEATABLEREAD e SERIALIZABLE.
Gli hint possono propagarsi in più livelli di viste nidificate. Si supponga, ad esempio, una query che applica l'hint HOLDLOCK in una vista v1. Quando v1 viene espanso, scopri che quella vista v2 fa parte della sua definizione.
v2 la cui definizione include un hint in una delle sue tabelle di base. Anche questa tabella eredita l'hint HOLDLOCK dalla query sulla vista v1. Poiché gli hint NOLOCK e HOLDLOCK sono in conflitto tra loro, la query fallisce.
Quando usi l'hint FORCE ORDER in una query che contiene una vista, la posizione della vista nella costruzione ordinata determina l'ordine di join delle tabelle all'interno della vista. La query seguente, ad esempio, consente di selezionare da tre tabelle e una vista:
SELECT * FROM Table1, Table2, View1, Table3
WHERE Table1.Col1 = Table2.Col1
    AND Table2.Col1 = View1.Col1
    AND View1.Col2 = Table3.Col2;
OPTION (FORCE ORDER);
E View1 è definita come mostrato nel seguente esempio:
CREATE VIEW View1 AS
    SELECT Colx,
           Coly
    FROM TableA, TableB
    WHERE TableA.ColZ = TableB.Colz;
L'ordine di join nel piano di query sarà quindi Table1, Table2, TableA, TableB, Table3.
Risolvere indici delle viste
Come per ogni indice, il motore di database sceglie di utilizzare una vista indicizzata nel proprio piano di query solo se il Query Optimizer ritiene vantaggioso farlo.
Puoi creare viste indicizzate in qualsiasi edizione del motore di database. In alcune edizioni, il Query Optimizer considera automaticamente la vista indicizzata, mentre in altre è necessario usare il NOEXPAND suggerimento della tabella. L'uso automatico di una vista indicizzata da parte dell'Ottimizzatore di Query è supportato solo in specifiche edizioni di SQL Server.
Nota
I database SQL di Azure e le istanze gestite di Azure SQL supportano l'utilizzo automatico delle viste indicizzate senza bisogno di specificare il suggerimento NOEXPAND.
L'Ottimizzatore di Query utilizza una vista indicizzata quando sono soddisfatte le seguenti condizioni:
- Le opzioni relative alla sessione indicate di seguito sono impostate su
ON:ANSI_NULLSANSI_PADDINGANSI_WARNINGSARITHABORTCONCAT_NULL_YIELDS_NULLQUOTED_IDENTIFIER
- L'opzione di sessione
NUMERIC_ROUNDABORTè impostata suOFF. - L'ottimizzatore di query trova una corrispondenza tra le colonne indici della vista e gli elementi della query, come ad esempio:
- Predicati di condizione di ricerca nella
WHEREclausola - Operazioni di join
- Funzioni di aggregazione
-
GROUP BYClausole - Riferimenti a tabelle
- Predicati di condizione di ricerca nella
- Il costo stimato necessario per l'utilizzo dell'indice è inferiore a quello di qualsiasi altro meccanismo di accesso considerato in Query Optimizer.
- Ogni tabella a cui si fa riferimento nella query, direttamente oppure espandendo una vista per accedere alle tabelle sottostanti, corrispondente a un riferimento alla tabella nella vista indicizzata, deve disporre dello stesso set di hint ad essa applicato nella query.
Nota
Gli hint READCOMMITTED e READCOMMITTEDLOCK sono sempre considerati diversi in questo contesto, indipendentemente dal livello corrente di isolamento delle transazioni.
Ad eccezione dei requisiti relativi alle opzioni SET e agli hint di tabella, si tratta delle stesse regole usate da Query Optimizer per determinare se l'indice di una tabella copre una query. Non è necessario specificare altro nella query per usare una vista indicizzata.
Non è necessario che una query faccia riferimento in modo esplicito a una vista indicizzata nella clausola FROM affinché Query Optimizer usi la vista indicizzata. Se la query include riferimenti alle colonne delle tabelle di base incluse anche nella vista indicizzata e tramite Query Optimizer si stima che l'utilizzo della vista indicizzata è il meccanismo di accesso più economico, in Query Optimizer viene scelta la vista indicizzata con modalità analoghe a quelle utilizzate per scegliere gli indici delle tabelle di base a cui non viene fatto riferimento diretto in una query. Query Optimizer può scegliere la vista quando include colonne a cui non fa riferimento la query a condizione che la vista stessa rappresenti la soluzione più economica ai fini della copertura di una o più colonne specificate nella query.
Query Optimizer elabora le viste indicizzate a cui fa riferimento la clausola FROM come viste standard. Tramite Query Optimizer la definizione della vista viene espansa nella query all'inizio del processo di ottimizzazione. Viene quindi eseguita la ricerca della corrispondenza nella vista indicizzata. La vista indicizzata può essere usata nel piano di esecuzione finale selezionato da Query Optimizer oppure il piano potrebbe ottenere dalla vista i dati necessari accedendo alle tabelle di base a cui fa riferimento la vista. Tramite Query Optimizer viene scelta l'alternativa con il costo inferiore.
Usare gli hint con viste indicizzate
È possibile impedire l'uso delle viste indicizzate da parte di una query usando l'hint per la query EXPAND VIEWS oppure è possibile usare l'hint di tabella NOEXPAND per fare in modo che venga impiegato un indice per una vista indicizzata specificata nella clausola FROM di una query. È tuttavia consigliabile lasciar determinare in modo dinamico a Query Optimizer i metodi di accesso migliori da utilizzare per ogni query. Limitare l'uso delle istruzioni EXPAND e NOEXPAND a casi specifici in cui i test hanno dimostrato che migliorano significativamente le prestazioni.
L'opzione
EXPAND VIEWSspecifica che in Query Optimizer non verranno usati indici delle viste per l'intera query.Quando specifichi
NOEXPANDper una vista, il Query Optimizer considera l'uso di qualsiasi indice definito sulla vista. Se l'opzioneNOEXPANDviene specificata con la clausolaINDEX()facoltativa, Query Optimizer userà gli indici specificati. Puoi specificareNOEXPANDsolo per una vista indicizzata e non puoi specificarla per una vista non indicizzata. L'uso automatico di una vista indicizzata da parte dell'Ottimizzatore di Query è supportato solo in specifiche edizioni di SQL Server.Nota
I database SQL di Azure e le istanze gestite di Azure SQL supportano l'utilizzo automatico delle viste indicizzate senza bisogno di specificare il suggerimento
NOEXPAND.
Quando non viene specificata né l'opzione NOEXPAND né EXPAND VIEWS in una query contenente una vista, la vista viene espansa per accedere alle tabelle sottostanti. Se l'interrogazione che compone la vista contiene delle indicazioni sui tavoli, queste vengono propagate alle tabelle sottostanti. (Questo processo è spiegato più dettagliatamente in Risoluzione della vista.) Finché gli hint presenti nelle tabelle sottostanti della vista sono identici tra loro, la query può corrispondere a una vista indicizzata. La maggior parte delle volte, questi indizi si abbinano tra loro, perché vengono ereditati direttamente dalla vista. Tuttavia, se la query fa riferimento a tabelle anziché a viste, e gli hint applicati direttamente a tali tabelle non sono identici, una tale query non è idonea per essere confrontata con una vista indicizzata. Se gli hint INDEX, PAGLOCK, ROWLOCK, TABLOCKX, UPDLOCK o XLOCK vengono applicati alle tabelle citate nella query dopo l'espansione della vista nel contesto della query, la query non è idonea per la corrispondenza di viste indicizzate.
Se un hint di tabella nel formato INDEX ( index_val [ ,...n] ) fa riferimento a una vista in una query e non viene specificato anche l'hint NOEXPAND, l'hint per l'indice viene ignorato. Per specificare l'uso di un determinato indice, usare NOEXPAND.
Generalmente, quando il Query Optimizer abbina una vista indicizzata a una query, applica qualsiasi suggerimento specificato nelle tabelle o nelle viste della query direttamente alla vista indicizzata. Se l'Ottimizzatore di Query sceglie di non utilizzare una vista indicizzata, propaga eventuali suggerimenti direttamente alle tabelle citate nella vista. Per ulteriori informazioni, vedi Risoluzione dello schermo. Questa propagazione non riguarda gli hint di join, Sono applicati solo nella loro posizione originale nella query. L'ottimizzatore di query non considera gli hint di join quando abbina le query a viste indicizzate. Se un piano di query utilizza una vista indicizzata che corrisponde a una parte di una query contenente un hint di join, allora l'hint di join non viene utilizzato nel piano.
Nelle definizioni delle viste indicizzate non sono consentiti hint. Il motore di database ignora i suggerimenti all'interno delle definizioni di visualizzazione indicizzata quando li mantiene o quando esegue query che utilizzano viste indicizzate.
Per altre informazioni, vedere Suggerimenti di tabella.
Risolvere viste partizionate distribuite
Il processore di query del motore di database ottimizza le prestazioni delle viste partizionate distribuite. Per le prestazioni delle viste partizionate distribuite, l'aspetto più importante è rappresentato dalla necessità di ridurre al minimo la quantità di dati trasferiti tra server membri.
Il motore di database costruisce piani intelligenti e dinamici che utilizzano in modo efficiente le query distribuite per accedere ai dati da tabelle membri remote:
- Query Processor usa prima di tutto OLE DB per recuperare le definizioni del vincolo CHECK da ogni tabella membro. Questo metodo consente al processore di query di mappare la distribuzione dei valori chiave tra le tabelle dei membri.
- Il Query Processor confronta gli intervalli di chiavi specificati in una clausola di istruzione
WHERET-SQL con la mappa che mostra come le righe sono distribuite nelle tabelle membri. Il processore di query quindi costruisce un piano di esecuzione delle query che utilizza query distribuite per recuperare solo quelle righe remote necessarie per completare l'istruzione T-SQL. Il piano di esecuzione è inoltre costruito in modo tale che qualsiasi accesso alle tabelle membri remoti, sia per dati che per metadati, venga ritardato fino a quando le informazioni non sono necessarie.
Si consideri, ad esempio, un sistema in cui la tabella Customers è partizionata tra Server1 (CustomerID da 1 a 3299999), Server2 (CustomerID da 3300000 a 6599999) e Server3 (CustomerID da 6600000 a 9999999).
Considerare quindi il piano di esecuzione compilato per la query eseguita in Server1:
SELECT *
FROM CompanyData.dbo.Customers
WHERE CustomerID BETWEEN 3200000 AND 3400000;
Il piano di esecuzione di questa query estrae dalla tabella membro locale le righe con valori di chiave CustomerID compresi tra 3200000 e 3299999 e quindi esegue una query distribuita per recuperare da Server2 le righe con valori di chiave compresi tra 3300000 e 3400000.
Il motore di database Query Processor può anche costruire logica dinamica nei piani di esecuzione delle query per istruzioni T-SQL in cui i valori chiave non sono noti quando il piano deve essere costruito. Si consideri, ad esempio, la stored procedure seguente:
CREATE PROCEDURE GetCustomer
(
    @CustomerIDParameter INT
)
AS
SELECT *
FROM CompanyData.dbo.Customers
WHERE CustomerID = @CustomerIDParameter;
Il motore di database non può prevedere quale valore chiave viene fornito dal @CustomerIDParameter parametro ogni volta che la procedura viene eseguita. Poiché il valore della chiave non può essere previsto, il processore delle query non può nemmeno prevedere a quale tabella membro deve accedere. Per gestire questo caso, il motore di database costruisce un piano di esecuzione che ha logica condizionale, chiamata filtri dinamici, per controllare quale tabella membro viene consultata, in base al valore del parametro di input. Assumendo che la GetCustomer stored procedure sia stata eseguita su Server1, la logica del piano di esecuzione può essere rappresentata come mostrato nel seguente output:
IF @CustomerIDParameter BETWEEN 1 and 3299999
   Retrieve row from local table CustomerData.dbo.Customer_33
ELSE IF @CustomerIDParameter BETWEEN 3300000 and 6599999
   Retrieve row from linked table Server2.CustomerData.dbo.Customer_66
ELSE IF @CustomerIDParameter BETWEEN 6600000 and 9999999
   Retrieve row from linked table Server3.CustomerData.dbo.Customer_99
Il motore di database a volte costruisce questi tipi di piani di esecuzione dinamici anche per query non parametrizzate. Query Optimizer può parametrizzare una query affinché il piano di esecuzione possa essere riutilizzato. Se l'Ottimizzatore di Query parametrizza una query che fa riferimento a una vista partizionata, non può più assumere che le righe richieste provengano da una tabella base specificata. Deve quindi utilizzare filtri dinamici nel piano di esecuzione.
Esecuzione di stored procedure e trigger
Il motore di database memorizza solo la sorgente per le stored procedure e i trigger. Quando una stored procedure o un trigger viene eseguito per la prima volta, il codice sorgente viene compilato in un piano di esecuzione. Se la stored procedure o il trigger vengono eseguiti nuovamente prima che il piano di esecuzione decada dalla memoria, il motore relazionale rileva e riutilizza il piano esistente. Se il piano viene rimosso dalla memoria, viene costruito un nuovo piano. Questo processo è simile a quello che il motore di database segue per tutte le istruzioni T-SQL. Il principale vantaggio prestazionale che le stored procedure e i trigger hanno nel motore di database rispetto ai lotti di T-SQL dinamico è che le loro istruzioni T-SQL sono sempre le stesse. Pertanto, il motore relazionale abbina facilmente i piani di esecuzione esistenti. I piani di stored procedure e trigger sono quindi facilmente riutilizzabili.
Il piano di esecuzione delle stored procedure e dei trigger viene eseguito indipendentemente dal piano di esecuzione del batch che chiama la stored procedure o che attiva il trigger. Questa separazione consente un maggiore riutilizzo dei piani di esecuzione della stored procedure e del trigger.
Memorizzazione nella cache e riutilizzo del piano di esecuzione
Il motore di database utilizza la memoria per memorizzare sia i piani di esecuzione che i data buffer. La percentuale di memoria allocata ai piani di esecuzione o ai data buffer viene adattata dinamicamente, a seconda dello stato del sistema. La parte di memoria che memorizza i piani di esecuzione è chiamata plan cache.
Archivi della cache del piano
La cache dei piani ha due archivi per tutti i piani compilati:
- L'archivio cache Object Plans (OBJCP), per i piani associati agli oggetti persistenti, come procedure memorizzate, funzioni e trigger.
- L'archivio cache SQL Plans (SQLCP), per piani relativi a query autoparametrizzate, dinamiche o preparate.
La seguente query fornisce informazioni sull'uso della memoria per questi due archivi di cache:
SELECT *
FROM sys.dm_os_memory_clerks
WHERE name LIKE '%plans%';
La cache dei piani ha due archivi aggiuntivi che non conservano i piani:
- L'archivio cache Bound Trees (PHDR), per le strutture dati utilizzate durante la compilazione del piano per viste, vincoli e valori predefiniti. Queste strutture sono note come bound tree o alberi algebrizer.
- L'archivio cache Extended Stored Procedures (XPROC), per procedure di sistema predefinite, come sp_executesql o xp_cmdshell. Queste stored procedure utilizzano una DLL invece delle istruzioni T-SQL. La struttura memorizzata contiene solo il nome della funzione e il nome DLL in cui la procedura è implementata.
Componenti del piano di esecuzione
I piani di esecuzione del motore di database comprendono i seguenti componenti principali:
Piano compilato (o piano di interrogazione)
Il piano di query generato dal processo di compilazione è per lo più una struttura dati rientrante e di sola lettura usata da più utenti. Archivia informazioni su:
Operatori fisici che implementano l'operazione descritta dagli operatori logici.
Ordine di questi operatori, che determina l'ordine in cui i è possibile accedere ai dati, filtrarli e aggregarli.
Il numero di righe stimate che passano attraverso gli operatori.
Nota
Il piano di query memorizza anche informazioni sugli oggetti statistici utilizzati per la Stima della Cardinalità.
Oggetti di supporto da creare, ad esempio tabelle di lavoro o file di lavoro in
tempdb.
Il piano di query non memorizza alcun contesto utente o informazioni di runtime. Il motore di database determina il numero di worker thread ogni volta che recupera un piano dalla cache del piano. Un piano parallelo memorizzato nella cache può anche essere eseguito in serie (serial).
Contesto di esecuzione
Ogni utente che attualmente esegue la query possiede una struttura dati che contiene i dati specifici per la loro esecuzione, come i valori dei parametri. Questa struttura dati è chiamata contesto di esecuzione. Le strutture dei dati del contesto di esecuzione vengono riutilizzate, ma il loro contenuto no. Se un altro utente esegue la stessa query, le strutture dei dati vengono reinizializzate con il contesto del nuovo utente.
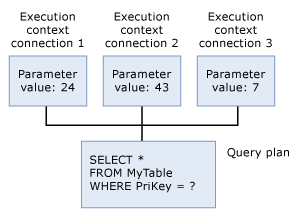
Riutilizzo dei piani per istruzioni identiche
Quando il motore di database esegue qualsiasi istruzione T-SQL, prima esamina la cache del piano per verificare che esista un piano di esecuzione esistente per la stessa istruzione T-SQL. L'istruzione T-SQL si qualifica come esistente se corrisponde letteralmente, carattere per carattere, a un'istruzione T-SQL eseguita in precedenza con un piano memorizzato nella cache. Il motore di database riutilizza qualsiasi piano esistente che trova, risparmiando il sovraccarico di ricompilare l'istruzione T-SQL. Se non esiste un piano di esecuzione, il motore di database genera un nuovo piano di esecuzione per la query.
Nota
La cache dei piani non persiste i piani di esecuzione per alcune istruzioni T-SQL, come le istruzioni di operazioni bulk che girano su rowstore o le istruzioni contenenti grandi letterali di stringa. Questi piani esistono solo mentre la query è in corso.
Il motore di database utilizza un algoritmo efficiente per trovare eventuali piani di esecuzione esistenti per qualsiasi specifica istruzione T-SQL. Nella maggior parte dei sistemi, le risorse minime utilizzate da questa scansione sono inferiori rispetto a quelle risparmiate riutilizzando i piani esistenti invece di compilare ogni istruzione T-SQL.
Gli algoritmi per abbinare le nuove istruzioni T-SQL ai piani di esecuzione esistenti e non utilizzati nella cache del piano richiedono che tutti i riferimenti agli oggetti siano pienamente qualificati. Ad esempio, supponiamo che Person sia lo schema predefinito per l'utente che esegue le seguenti SELECT istruzioni. Sebbene questo esempio non richieda di qualificare pienamente la tabella Person per essere eseguita, significa che la seconda istruzione non corrisponde a un piano esistente, ma la terza istruzione corrisponde:
USE AdventureWorks2025;
GO

SELECT *
FROM Person;
GO

SELECT *
FROM Person.Person;
GO

SELECT *
FROM Person.Person;
GO
Modificare una delle seguenti SET opzioni per una data esecuzione influisce sulla possibilità di riutilizzare i piani, perché il motore di database esegue constant folding e queste opzioni influenzano i risultati di tali espressioni:
ANSI_DEFAULTSANSI_NULL_DFLT_OFFANSI_NULL_DFLT_ONANSI_NULLSANSI_PADDINGANSI_WARNINGSARITHABORTCONCAT_NULL_YIELDS_NULLDATEFIRSTDATEFORMATFORCEPLANLANGUAGENO_BROWSETABLENUMERIC_ROUNDABORTQUOTED_IDENTIFIER
Memorizzare più piani nella cache per la stessa query
Le query e i piani di esecuzione sono identificabili in modo univoco nel motore di database, proprio come un'impronta digitale:
- Per valore hash del piano di query si intende un valore hash binario calcolato sul piano di esecuzione per una determinata query che consente di identificare in modo univoco piani di esecuzioni analoghi.
- L'hash della query è un valore hash binario calcolato sul testo T-SQL di una query e viene utilizzato per identificare in modo univoco le query.
Puoi recuperare un piano compilato dalla cache del piano usando un plan handle. Questo identificatore transitorio rimane costante solo mentre il piano rimane nella cache. Il gestore del piano è un valore hash derivato dal piano compilato dell'intero batch. Il handle del piano per un piano compilato rimane lo stesso anche se una o più istruzioni del batch vengono ricompilate.
Nota
Se compili un piano per un batch invece di una singola istruzione, puoi usare il handle del piano e gli offset dell'istruzione per ottenere il piano per singole istruzioni nel batch.
Il sys.dm_exec_requests DMV contiene le colonne statement_start_offset e statement_end_offset per ogni registro. Queste colonne si riferiscono all'istruzione attualmente in esecuzione di un batch attualmente in esecuzione o di un oggetto persistente. Per altre informazioni, vedere sys.dm_exec_requests.
Il sys.dm_exec_query_stats DMV contiene anche queste colonne per ogni registro. Queste colonne si riferiscono alla posizione di un'istruzione all'interno di un batch o di un oggetto persistente. Per altre informazioni, vedere sys.dm_exec_query_stats.
Il testo effettivo di T-SQL di un batch viene memorizzato in uno spazio di memoria separato dalla cache del piano, chiamato cache SQL Manager (SQLMGR). Puoi recuperare il testo T-SQL per un piano compilato dalla cache di SQL Manager usando un handle SQL. Questo identificatore transitorio rimane costante solo finché almeno un piano che vi fa riferimento rimane nella cache del piano. L'handle SQL è un valore hash derivato dall'intero testo batch, ed è garantito unico per ogni batch.
Nota
Come un piano compilato, il testo T-SQL viene memorizzato per batch, inclusi i commenti. Il handle SQL contiene l'hash MD5 dell'intero testo batch ed è garantito unico per ogni batch.
La seguente query fornisce informazioni sull'uso della memoria per la cache di SQL Manager:
SELECT *
FROM sys.dm_os_memory_objects
WHERE type = 'MEMOBJ_SQLMGR';
Esiste una relazione uno-a-molti tra un handle SQL e i handle dei piani. Questa condizione si verifica quando la chiave cache per i piani compilati è diversa. Questa differenza potrebbe verificarsi a causa di variazioni nelle SET opzioni tra due esecuzioni dello stesso lotto.
Si consideri la seguente stored procedure:
USE WideWorldImporters;
GO

CREATE PROCEDURE usp_SalesByCustomer
(
    @CID INT
)
AS
SELECT *
FROM Sales.Customers
WHERE CustomerID = @CID;
GO

SET ANSI_DEFAULTS ON;
GO

EXECUTE usp_SalesByCustomer 10;
GO
Verifica cosa puoi trovare nella cache del piano usando la seguente richiesta:
SELECT cp.memory_object_address,
       cp.objtype,
       refcounts,
       usecounts,
       qs.query_plan_hash,
       qs.query_hash,
       qs.plan_handle,
       qs.sql_handle
FROM sys.dm_exec_cached_plans AS cp
CROSS APPLY sys.dm_exec_sql_text(cp.plan_handle)
CROSS APPLY sys.dm_exec_query_plan(cp.plan_handle)
     INNER JOIN sys.dm_exec_query_stats AS qs
         ON qs.plan_handle = cp.plan_handle
WHERE text LIKE '%usp_SalesByCustomer%';
GO
Il set di risultati è il seguente.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CC6C534060        Proc      2           1           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Ora esegui la stored procedure con un parametro diverso, senza altre modifiche al contesto di esecuzione:
EXECUTE usp_SalesByCustomer 8;
GO
Controlla ancora una volta cosa riesci a trovare nella cache del piano di esecuzione. Il set di risultati è il seguente.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CC6C534060        Proc      2           2           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Si noti che il usecounts valore aumenta a 2, il che significa che lo stesso piano memorizzato nella cache viene riutilizzato as-is, perché le strutture dati del contesto di esecuzione vengono riutilizzate. Ora cambia l'opzione SET ANSI_DEFAULTS ed esegui la procedura memorizzata usando lo stesso parametro.
SET ANSI_DEFAULTS OFF;
GO

EXECUTE usp_SalesByCustomer 8;
GO
Controlla ancora una volta cosa riesci a trovare nella cache dei piani. Il set di risultati è il seguente.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CD01DEC060        Proc      2           1           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D
0x000001CC6C534060        Proc      2           2           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02B031F111CD01000001000000000000000000000000000000000000000000000000000000
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Si noti che ora nell'output DMV sys.dm_exec_cached_plans sono presenti due voci:
- La
usecountscolonna mostra il valore1nel primo record. Questo valore rappresenta il piano eseguito una volta conSET ANSI_DEFAULTS OFF. - La
usecountscolonna mostra il valore2nel secondo record. Questo valore rappresenta il piano eseguito conSET ANSI_DEFAULTS ON, perché è stato eseguito due volte. - Il diverso
memory_object_addresssi riferisce a un'altra voce del piano di esecuzione nella cache dei piani. Il valoresql_handleè tuttavia lo stesso per entrambe le voci perché fanno riferimento allo stesso batch.- L'esecuzione con
ANSI_DEFAULTSimpostato suOFFha un nuovoplan_handleed è disponibile per il riutilizzo per chiamate che hanno lo stesso insieme di opzioniSET. Il nuovo handle del piano è necessario perché il contesto di esecuzione è stato reinizializzato a causa della modifica delle opzioniSET. Ma quel cambiamento non innesca una ricompilazione: entrambe le voci si riferiscono allo stesso piano e alla stessa query, come dimostrano gli stessi valoriquery_plan_hashequery_hash.
- L'esecuzione con
Questa situazione significa che hai due voci di piano nella cache corrispondenti allo stesso lotto. Sottolinea l'importanza di assicurarsi che la cache del piano che influenza le opzioni di SET sia la stessa quando le stesse query vengono eseguite ripetutamente. Questo approccio ottimizza il riutilizzo del piano e mantiene la dimensione della cache del piano al minimo richiesto.
Suggerimento
Un problema comune è che i diversi client possono avere valori predefiniti diversi per le SET opzioni. Ad esempio, una connessione effettuata tramite SQL Server Management Studio imposta QUOTED_IDENTIFIER automaticamente a ON, mentre SQLCMD imposta QUOTED_IDENTIFIER a OFF. Eseguire le stesse query da questi due client porta a piani multipli (come descritto nell'esempio precedente).
Rimuovere piani di esecuzione dalla cache dei piani
I piani di esecuzione rimangono nella cache del piano finché c'è abbastanza memoria per memorizzarli. Quando esiste pressione di memoria, il Motore di database di SQL Server utilizza un approccio basato sui costi per decidere quali piani di esecuzione rimuovere dalla cache del piano. Per prendere una decisione basata sui costi, il Motore di database di SQL Server aumenta e diminuisce una variabile di costo corrente per ogni piano di esecuzione in base ai seguenti fattori.
Quando un processo utente inserisce un piano di esecuzione nella cache, il processo utente imposta il costo corrente pari al costo originale di compilazione della query. Per i piani di esecuzione ad hoc, il processo utente imposta il costo corrente a zero. Dopodiché, ogni volta che un processo utente fa riferimento a un piano di esecuzione, il costo corrente viene reimpostato al costo di compilazione originale. Per i piani di esecuzione ad hoc, il processo utente aumenta il costo corrente. Per tutti i piani, il valore massimo per il costo corrente corrisponde al costo di compilazione originale.
Quando esiste pressione di memoria, il Motore di database di SQL Server rimuove i piani di esecuzione dalla cache dei piani. Per determinare i piani da rimuovere, il motore di database di SQL Server esamina ripetutamente lo stato di ogni piano di esecuzione e rimuove i piani quando il relativo costo corrente è pari a zero. Un piano di esecuzione con costo corrente zero non viene rimosso automaticamente quando esiste pressione di memoria. Viene rimosso solo quando il Motore di database di SQL Server esamina il piano e il costo attuale è zero. Quando si esamina un piano di esecuzione, il motore di database di SQL Server riduce il costo corrente avvicinandolo a zero, qualora una query non utilizzi attualmente il piano.
Il Motore di database di SQL Server continua a esaminare i piani di esecuzione finché non rimuove abbastanza piani per soddisfare i requisiti di memoria. In caso di un numero eccessivo di richieste di memoria, è probabile che il costo di un piano di esecuzione venga incrementato e decrementato più di una volta. Quando la pressione di memoria non esiste più, il Motore di database di SQL Server smette di ridurre il costo attuale dei piani di esecuzione inutilizzati. Tutti i piani di esecuzione rimangono nella cache del piano, anche se il loro costo è zero.
Il motore di database di SQL Server usa il monitor delle risorse e i thread di lavoro dell'utente per liberare memoria dalla cache dei piani in risposta alla pressione della memoria. Il monitor delle risorse e i thread di lavoro utente possono esaminare contemporaneamente i piani per ridurre il costo corrente di ogni piano di esecuzione non utilizzato. Il monitoraggio risorse rimuove i piani di esecuzione dalla cache dei piani quando è presente un numero eccessivo di richieste di memoria globale libera memoria per applicare i criteri relativi alla memoria di sistema, alla memoria dei processi, al pool di risorse e alla dimensione massima per tutte le cache.
Le dimensioni massime di tutte le cache sono rappresentate da una funzione relativa alle dimensioni del pool di buffer e non possono superare la memoria massima del server. Per maggiori informazioni sulla configurazione della memoria massima del server, consulta l'impostazione max server memory in sp_configure.
Quando esiste una pressione della memoria cache singola, i thread di lavoro utente rimuovono i piani di esecuzione dalla cache dei piani. Applicano le regole per la dimensione massima della singola cache e per il numero massimo di voci per cache.
L'esempio seguente indica quali piani di esecuzione vengono rimossi dalla cache dei piani:
- A un piano di esecuzione viene fatto riferimento di frequente in modo che il costo non sia mai pari a zero. Il piano rimane nella cache del piano e non viene rimosso a meno che non ci sia pressione di memoria e il costo attuale sia zero.
- Viene inserito un piano di esecuzione ad hoc, cui non viene fatto nuovamente riferimento prima che sia presente un utilizzo elevato di memoria. Poiché i piani ad hoc sono inizializzati con un costo corrente zero, quando il Motore di database di SQL Server esamina il piano di esecuzione, rileva il costo corrente zero e rimuove il piano dalla cache del piano. Il piano di esecuzione ad hoc rimane nella cache del piano con un costo attuale zero quando la pressione di memoria non esiste.
Per rimuovere manualmente un singolo piano o tutti i piani dalla cache, usare DBCC FREEPROCCACHE. Puoi anche usare DBCC FREESYSTEMCACHE per cancellare qualsiasi cache, inclusa la cache del piano di esecuzione. SQL Server 2016 (13.x) e versioni successive, utilizzate ALTER DATABASE SCOPED CONFIGURATION CLEAR PROCEDURE_CACHE per cancellare la cache della procedura (plan) per il database corrente.
Un cambiamento in alcune impostazioni di configurazione tramite sp_configure e reconfigure causa anche la rimozione dei piani dalla cache dei piani. È possibile trovare l'elenco di queste impostazioni di configurazione nella sezione Osservazioni dell'articolo DBCC FREEPROCCACHE. Quando effettui questa modifica di configurazione, il seguente messaggio informativo viene scritto nel registro errori:
SQL Server has encountered %d occurrence(s) of cachestore flush for the '%s' cachestore (part of plan cache) due to some database maintenance or reconfigure operations.
Ricompilare i piani di esecuzione
Alcune modifiche in un database possono rendere un piano di esecuzione inefficiente o invalido. Il motore di database rileva questi cambiamenti e segna il piano come non valido. Per la successiva connessione che esegue la query, pertanto, è necessaria la ricompilazione di un nuovo piano. Le condizioni che invalidano un piano includono:
- Modifiche a una tabella o vista a cui fa riferimento la query (
ALTER TABLEeALTER VIEW). - Modifiche a una singola procedura, che rimuoverebbe tutti i piani per quella procedura dalla cache (
ALTER PROCEDURE). - Modifiche agli indici utilizzati dal piano di esecuzione.
- Aggiornamenti alle statistiche utilizzate dal piano di esecuzione, che siano generate esplicitamente da un'istruzione come
UPDATE STATISTICSoppure generate automaticamente. - Eliminazione di un indice utilizzato dal piano di esecuzione.
- Chiamata esplicita a
sp_recompile. - Grande quantità di modifiche alle chiavi, generate dalle istruzioni
INSERToDELETEeseguite da altri utenti che modificano una tabella a cui fa riferimento la query. - Nel caso di tabelle con trigger, se il numero di righe nelle tabelle inserite o eliminate aumenta significativamente.
- Eseguire una procedura memorizzata usando l'opzione
WITH RECOMPILE.
La maggior parte delle ricompilazioni è necessaria sia per la correttezza delle istruzioni sia per ottenere eventualmente piani di esecuzione delle query più rapidi.
Quando un'istruzione all'interno di un batch attiva la ricompilazione, solo quell'istruzione viene ricompilata, non l'intero batch. Questa regola si applica sia che il batch venga inviato tramite una procedura memorizzata, un trigger, un batch ad hoc o un'istruzione preparata.
La ricompilazione a livello di istruzione migliora le prestazioni perché, nella maggior parte dei casi, un piccolo numero di istruzioni causa ricompilazioni e le relative penalità, in termini di tempo CPU e blocchi. Queste penalità sono quindi evitate per le altre istruzioni del lotto che non necessitano di ricompilazione.
L'evento sql_statement_recompile esteso (XEvent) segnala ricompilazione a livello di istruzione. Questo evento XEvent si verifica quando una ricompilazione a livello di istruzione è richiesta da qualsiasi tipo di batch. Questo requisito include stored procedure, trigger, batch ad hoc e query. I lotti possono essere inviati tramite diverse interfacce, tra cui sp_executesqlSQL dinamico, metodi Prepare o metodi Execute.
La recompile_cause colonna di sql_statement_recompile XEvent contiene un codice intero che indica il motivo della ricompilazione. Il seguente elenco contiene le possibili ragioni:
- Opzioni cursore modificate
- Compilazione posticipata
- Autorizzazione
FOR BROWSEmodificata -
OPTION (RECOMPILE)richiesta. - Piano parametrizzato azzerato
- Vista partizionata modificata
- Piano che influisce sulla versione del database modificato
- Ambiente di notifica query modificato
- Piano mancante nell'archivio query
- Forzatura del piano nel Query Store fallita
- Politica di forzatura del piano del Query Store modificata
- Il set di righe remoto è stato modificato
- Schema modificato
-
SETopzione modificata - Statistiche modificate
- Tabella temporanea modificata
Nota
Quando imposti l'opzione database AUTO_UPDATE_STATISTICS su ON, le query vengono ricompilate quando hanno come destinazione tabelle o viste indicizzate le cui statistiche vengono aggiornate o le cui cardinalità cambiano significativamente dall'ultima esecuzione. Questo comportamento si applica alle tabelle standard definite dall'utente, alle tabelle temporanee e alle tabelle inserite ed eliminate, create dai trigger DML.
Impostare AUTO_UPDATE_STATISTICS su OFF blocca queste ricompilazioni, ma le statistiche obsolete di solito peggiorano le prestazioni delle query più delle ricompilazioni. Per maggiori informazioni, consulta l'opzione AUTO_UPDATE_STATISTICS . Le tabelle inserted e deleted dei trigger DML INSTEAD OF sono create in tempdb, quindi seguono l'impostazione AUTO_UPDATE_STATISTICS di tempdb.
Utilizzare parametri espliciti per il riutilizzo del piano
L'uso di parametri, inclusi i parametri nominati nelle applicazioni ADO.NET e i marcatori di parametro nelle applicazioni OLE DB e ODBC, può aumentare il riutilizzo dei piani di esecuzione.
Avviso
Convalidare sempre gli input utente testando tipo, lunghezza, formato e intervallo. Per altre informazioni, vedere Attacco intrusivo nel codice SQL.
L'unica differenza tra le due istruzioni SELECT seguenti è rappresentata dai valori confrontati nella clausola WHERE :
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 4;
L'unica differenza tra i piani di esecuzione delle due query è rappresentata dal valore archiviato per il confronto con la colonna ProductSubcategoryID . Sebbene l'obiettivo sia che il motore di database riconosca sempre che le istruzioni generano essenzialmente gli stessi piani e li riutilizzi, il motore di database a volte non rileva questa somiglianza nelle istruzioni T-SQL complesse.
Separare le costanti dall'istruzione T-SQL utilizzando parametri aiuta il motore relazionale a riconoscere piani duplicati. Usa i parametri nei seguenti modi:
In T-SQL, si utilizza
sp_executesql:DECLARE @MyIntParm AS INT; SET @MyIntParm = 1; EXECUTE sp_executesql N'SELECT * FROM AdventureWorks2025.Production.Product WHERE ProductSubcategoryID = @Parm', N'@Parm INT', @MyIntParm;Questo metodo è consigliato per script T-SQL, stored procedure o trigger che generano istruzioni SQL dinamicamente.
ADO.NET con
SqlClientutilizza parametri nominati, come@Parm. OLE DB e ODBC utilizzano indicatori di parametro. I marcatori di parametro sono punti interrogativi (?) che sostituiscono una costante in un'istruzione SQL e sono legati a una variabile di programma. In un'applicazione ODBC, ad esempio, verrebbero eseguite le operazioni seguenti:Usare
SQLBindParameterper associare una variabile integer al primo marcatore di parametro in un'istruzione SQL.Inserire il valore intero nella variabile.
Esegui l'istruzione, specificando il marcatore del parametro (
?):SQLExecDirect(hstmt, "SELECT * FROM AdventureWorks2025.Production.Product WHERE ProductSubcategoryID = ?", SQL_NTS);
Il SQL Server Native Client OLE DB Provider e il driver ODBC di SQL Server Native Client usano
sp_executesqlper inviare istruzioni a SQL Server quando vengono utilizzati marcatori di parametro nelle applicazioni.Scrivi stored procedure, che utilizzano parametri per definizione.
Se non incorpori esplicitamente parametri nel design delle tue applicazioni, puoi anche affidarti all'Ottimizzatore delle Query per parametrizzare automaticamente determinate query usando il comportamento predefinito della parametrizzazione semplice. In alternativa, è possibile forzare Query Optimizer affinché esegua la parametrizzazione di tutte le query nel database impostando l'opzione PARAMETERIZATION dell'istruzione ALTER DATABASE su FORCED.
Parametrizzazione semplice
Nel motore di database, l'uso di parametri o marcatori di parametro nelle istruzioni T-SQL aumenta la capacità del motore relazionale di abbinare nuove istruzioni T-SQL con i piani di esecuzione esistenti e precedentemente compilati.
Avviso
Convalidare sempre gli input utente testando tipo, lunghezza, formato e intervallo. Per altre informazioni, vedere Attacco intrusivo nel codice SQL.
Se un'istruzione T-SQL viene eseguita senza parametri, il motore di database parametrizza internamente l'istruzione per aumentare la possibilità di farla corrispondere a un piano di esecuzione esistente. Questo processo è chiamato parametrizzazione. L'impostazione predefinita è la parametrizzazione semplice, e puoi abilitare la parametrizzazione forzata per un database.
Considera la seguente affermazione:
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
Puoi specificare il valore 1 alla fine dell'istruzione come parametro. Il motore relazionale costruisce il piano di esecuzione per questo lotto come se si specificasse un parametro al posto del valore 1. Grazie a questa semplice parametrizzazione, il motore di database riconosce che le seguenti due istruzioni generano essenzialmente lo stesso piano di esecuzione e riutilizza il primo piano per la seconda istruzione:
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 4;
Quando si elaborano istruzioni T-SQL complesse, il motore relazionale può avere difficoltà a determinare quali espressioni possano essere parametrizzate. Per aumentare la capacità del motore relazionale di abbinare istruzioni T-SQL complesse a piani di esecuzione esistenti e non utilizzati, specifica esplicitamente i parametri utilizzando sp_executesql o gli indicatori di parametro.
Nota
Quando si utilizzano gli operatori aritmetici +, -, *, / o % per eseguire la conversione implicita o esplicita dei valori costanti int, smallint, tinyint o bigint nei tipi di dati float, real, decimal o numeric, il motore di database applica regole specifiche per calcolare il tipo e la precisione dei risultati delle espressioni. Queste regole differiscono a seconda che la query sia parametrizzata. Espressioni simili nelle query possono pertanto in alcuni casi generare risultati diversi.
Con il comportamento predefinito della parametrizzazione semplice, il motore di database parametrizza una classe relativamente piccola di query. È tuttavia possibile fare in modo che tutte le query in un database vengano parametrizzate, rispettando determinate limitazioni, impostando l'opzione PARAMETERIZATION del comando ALTER DATABASE su FORCED. Questo cambiamento può migliorare le prestazioni dei database che sperimentano un alto volume di query concorrenti riducendo la frequenza delle compilazioni di query.
In alternativa, è possibile specificare la parametrizzazione di una singola query e di tutte le altre con sintassi equivalente ma che differiscono solo per i valori dei parametri.
Suggerimento
Quando si utilizza una soluzione di mappatura ogget-relazionale (ORM) come Entity Framework (EF), query applicative come alberi manuali di query LINQ o alcune query SQL grezze potrebbero non essere parametrizzate. Questa limitazione influisce sul riutilizzo del piano e sulla capacità di tracciare le query nel Query Store. Per altre informazioni, consultare Memorizzazione nella cache e parametrizzazione delle query EF e Query SQL grezze EF.
Parametrizzazione forzata
Puoi sovrascrivere il comportamento predefinito di parametrizzazione semplice del motore di database specificando che tutte le istruzioni SELECT, INSERT, UPDATE e DELETE in un database vengano parametrizzate, soggette a certe limitazioni. Abilita la parametrizzazione forzata impostando l'opzione PARAMETERIZATION su FORCED nell'istruzione ALTER DATABASE . La parametrizzazione forzata potrebbe offrire un miglioramento delle prestazioni di alcuni database riducendo la frequenza delle operazioni di compilazione e ricompilazione delle query. I database che potrebbero essere soggetti a un miglioramento delle prestazione grazie alla parametrizzazione forzata sono in genere quelli che ricevono volumi elevati di query simultanee da origini quali le applicazioni POS.
Quando imposti l'opzione PARAMETERIZATION su FORCED, qualsiasi valore letterale che appare in un'istruzione SELECT, INSERT, UPDATE o DELETE, inviata in qualsiasi forma, viene convertito in un parametro durante la compilazione della query. Le eccezioni consistono in valori letterali presenti nei costrutti di query seguenti:
- Istruzioni.
INSERT...EXECUTE - Istruzioni all'interno dei corpi delle stored procedure, dei trigger o delle funzioni definite dall'utente. Il motore di database già riutilizza i piani di query per queste routine.
- Istruzioni precompilate già parametrizzate sull'applicazione lato cliente.
- Istruzioni contenenti chiamate al metodo XQuery, in cui il metodo appare in un contesto in cui i relativi argomenti verrebbero in genere parametrizzati, ad esempio una clausola
WHERE. Se il metodo appare in un contesto in cui i suoi argomenti non vengono parametrizzati, il resto dell'istruzione viene parametrizzato. - Istruzioni all'interno di un cursore T-SQL. Le istruzioni
SELECTall'interno dei cursori API vengono parametrizzate. - Costrutti di query deprecati.
- Qualsiasi istruzione eseguita nel contesto di
ANSI_PADDINGoANSI_NULLSimpostati suOFF. - Istruzioni contenenti oltre 2.097 valori letterali idonei per la parametrizzazione.
- Istruzioni che fanno riferimento a variabili, ad esempio
WHERE T.col2 >= @bb. - Istruzioni contenenti l'hint per la query
RECOMPILE. - Le dichiarazioni che contengono una clausola
COMPUTE. - Le dichiarazioni che contengono una clausola
WHERE CURRENT OF.
Le seguenti clausole di query non sono parametrizzate. In questi casi, soltanto le clausole non vengono parametrizzate. Altre clausole all'interno della stessa query possono essere idonee per la parametrizzazione forzata.
- Il
<select_list>di qualsiasiSELECTaffermazione. Questa lista includeSELECTelenchi di sottoquery eSELECTelenchi all'interno di istruzioniINSERT. - Istruzioni
SELECTdelle sottoquery che appaiono dentro un'istruzioneIF. - Clausole
TOP,TABLESAMPLE,HAVING,GROUP BY,ORDER BY,OUTPUT...INTOoFOR XMLdi una query. - Argomenti, diretti o sottoespressioni, a
OPENROWSET,OPENQUERY,OPENDATASOURCE,OPENXMLo qualsiasi operatoreFULLTEXT. - Gli argomenti pattern ed escape_character di una clausola
LIKE. - L'argomento dello stile di una clausola
CONVERT. - Costanti intere all'interno di una clausola
IDENTITY. - Costanti specificate utilizzando la sintassi delle estensioni ODBC.
- Espressioni per le quali è possibile eseguire l'elaborazione delle costanti in fase di compilazione che rappresentano argomenti degli operatori
+,-,*,/e%. Quando si valuta l'idoneità alla parametrizzazione forzata, il motore di database considera un'espressione come soggetta a constant folding quando una delle seguenti condizioni è vera:- Nell'espressione non è inclusa alcuna colonna, variabile o subquery.
- L'espressione contiene una clausola
CASE.
- Argomenti per le clausole di hint di query, inclusi l'argomento number_of_rows dell'hint di query
FAST, l'argomento number_of_processors dell'hint di queryMAXDOPe l'argomento number dell'hint di queryMAXRECURSION.
La parametrizzazione avviene a livello di singole istruzioni T-SQL. In altri termini, le singole istruzioni presenti in un batch vengono parametrizzate. Dopo la compilazione, una query parametrizzata viene eseguita nel contesto del batch in cui è stata originariamente inviata. Se un piano di esecuzione per una query è memorizzato in cache, puoi determinare se la query è stata parametrizzata facendo riferimento alla sql colonna della sys.syscacheobjects dynamic management view. Se una query è parametrizzata, i nomi e i tipi di dati dei parametri precedono il testo del lotto inviato in questa colonna, come (@1 TINYINT).
Nota
I nomi dei parametri sono arbitrari. Gli utenti o le applicazioni non dovrebbero affidarsi a un ordine di denominazione particolare. Inoltre, i seguenti elementi possono cambiare tra le versioni di SQL Server e gli aggiornamenti cumulativi (CU): nomi dei parametri, la scelta dei letterali parametrizzati e la spaziatura nel testo parametrizzato.
Tipi di dati dei parametri
Quando il motore di database parametrizza i letterali, i parametri vengono convertiti nei seguenti tipi di dati:
- I valori letterali interi la cui dimensione rientrerebbe altrimenti nel tipo di dati int vengono parametrizzati come int. I valori letterali interi più grandi che fanno parte di predicati che coinvolgono qualsiasi operatore di confronto (include
<,<=,=,!<,>,>=,<>,!>,!=,ALL,SOME,BETWEEN,ANY, andIN) vengono parametrizzati come numeric(38,0). Letterali più grandi che non fanno parte di predicati che coinvolgono operatori di confronto vengono parametrizzati come numeric, la cui precisione è appena sufficiente a supportarne la dimensione e la cui scala è 0. - Letterali numerici a punto fisso che sono parti di predicati che coinvolgono operatori di confronto sono parametrizzati come numerico, la cui precisione è 38 e la cui scala è appena abbastanza grande da supportarne la dimensione. Letterali numerici a punto fisso che non fanno parte di predicati che coinvolgono operatori di confronto sono parametrizzati come numeric, la cui precisione e scala sono appena sufficientemente grandi da supportarne la dimensione.
- I letterali numerici in virgola mobile parametrizzano in float(53).
- I valori letterali stringa non Unicode vengono parametrizzati come varchar(8000) se il letterale rientra entro 8.000 caratteri, e varchar(max) se è superiore a 8.000 caratteri.
- I valori letterali di stringa Unicode vengono parametrizzati come nvarchar(4000) se il letterale rientra entro 4.000 caratteri Unicode, e come nvarchar(max) se il letterale è superiore a 4.000 caratteri.
- I letterali binari vengono parametrizzati come varbinary(8000) se il letterale si adatta entro 8.000 byte. Se è più grande di 8.000 byte, viene convertito in varbinary(max).
- I valori letterali di denaro vengono parametrizzati come money.
Linee guida per l'utilizzo della parametrizzazione forzata
Considera i seguenti punti quando imposti l'opzione PARAMETERIZATION su FORCED:
- La parametrizzazione forzata trasforma le costanti letterali in una query in parametri durante la compilazione di una query. È pertanto probabile che in Query Optimizer vengano scelti piani non ottimali per le query. In particolare, è meno probabile che Query Optimizer associ la query a una vista indicizzata o a un indice in una colonna calcolata. Potrebbero inoltre essere scelti piani non ottimali per le query formulate nelle tabelle partizionate e nelle viste partizionate distribuite. Non usare parametrizzazione forzata per ambienti che si basano molto su viste indicizzate e indici su colonne calcolate. Generalmente, solo i professionisti esperti di database dovrebbero utilizzare questa
PARAMETERIZATION FORCEDopzione dopo aver stabilito che non influisce negativamente sulle prestazioni. - Le query distribuite che fanno riferimento a più di un database sono idonee per la parametrizzazione forzata a condizione che l'opzione
PARAMETERIZATIONsia impostata suFORCEDnel database nel cui contesto viene eseguita la query. - Impostare l'opzione
PARAMETERIZATIONsuFORCEDsvuota tutti i piani di query dalla cache dei piani di un database, tranne quelli attualmente in fase di compilazione, ricompilazione o in esecuzione. I piani per le query che sono in fase di compilazione o vengono eseguite durante il cambio di impostazione vengono parametrizzati la volta successiva che la query viene eseguita. - Impostare l'opzione
PARAMETERIZATIONè un'operazione online che non richiede blocchi esclusivi a livello di database. - L'impostazione corrente dell'opzione
PARAMETERIZATIONviene mantenuta quando un database viene ricollegato o ripristinato.
Puoi sovrascrivere il comportamento della parametrizzazione forzata specificando che la parametrizzazione semplice debba essere tentata su una singola query, e su qualsiasi altra query sintatticamente equivalente ma che differisce solo nei valori dei parametri. Viceversa è possibile specificare che la parametrizzazione forzata venga tentata solo su un set di query sintatticamente equivalenti, anche se disabilitata nel database. Usa guide piano a questo scopo.
Nota
Quando l'opzione PARAMETERIZATION è impostata su FORCED, la segnalazione dei messaggi di errore potrebbe presentare differenze rispetto a quando l'opzione PARAMETERIZATION è impostata su SIMPLE: potrebbero segnalati più messaggi di errore nei casi di parametrizzazione forzata, laddove sarebbe segnalato un numero di messaggi di errore inferiore in nei casi di parametrizzazione semplice e i numeri di riga nei quali si sono verificati gli errori potrebbero non essere segnalati correttamente.
Quando viene attivata la parametrizzazione forzata, la parametrizzazione semplice può essere comunque eseguita. La query seguente, ad esempio, non può essere parametrizzata in base alle regole di parametrizzazione forzata:
SELECT *
FROM Person.Address
WHERE AddressID = 1 + 2;
La query può tuttavia essere parametrizzata in base alle regole di parametrizzazione semplice. Quando un tentativo di parametrizzazione forzata ha esito negativo, viene successivamente tentata la parametrizzazione semplice.
Preparare le istruzioni SQL
Il motore di database supporta la preparazione delle istruzioni T-SQL prima dell'esecuzione. Se un'applicazione deve eseguire più volte un'istruzione T-SQL, può utilizzare l'API del database per:
- Preparare la dichiarazione una sola volta. Questo passaggio compila l'istruzione T-SQL in un piano di esecuzione.
- Esegui il piano di esecuzione precompilato ogni volta che è necessario eseguire l'istruzione. Questo approccio impedisce la ricompilazione dell'istruzione T-SQL in ogni esecuzione dopo la prima volta. La preparazione e l'esecuzione delle istruzioni è controllata dalle funzioni e dai metodi dell'API. Il SQL Server Native Client OLE DB Provider e il driver ODBC Native Client di SQL Server supportano il modello prepare/execute per l'esecuzione delle istruzioni T-SQL. A una richiesta di preparazione, il provider o il driver invia l'istruzione a SQL Server con una richiesta di preparazione dell'istruzione. Il motore di database compila un piano di esecuzione e restituisce un handle per quel piano al provider o al driver. Alla richiesta di esecuzione, il provider o il driver invia al server una richiesta di esecuzione del piano associato all'handle.
Le istruzioni preparate non possono creare oggetti temporanei nel motore di database. Nelle istruzioni preparate, infatti, non è consentito fare riferimento a stored procedure di sistema che creano oggetti temporanei, ad esempio tabelle temporanee. Tali procedure devono essere eseguite in modo diretto.
L'uso eccessivo del modello preparazione/esecuzione può degradare le prestazioni. Se un'istruzione viene eseguita solo una volta, l'esecuzione diretta richiede un solo round-trip di rete al server. Preparare ed eseguire un'istruzione T-SQL eseguita solo una volta richiede un round trip di rete aggiuntivo: un viaggio per preparare l'istruzione e un viaggio per eseguirla.
Preparare un'istruzione è più efficace se si usano indicatori di parametro. Si supponga, ad esempio, che a un'applicazione venga richiesto occasionalmente di recuperare informazioni sui prodotti dal database di esempio AdventureWorksLT2025 . Ci sono due modi in cui l'applicazione può svolgere questo compito.
Utilizzando il primo approccio, l'applicazione può eseguire una query separata per ciascun prodotto richiesto:
SELECT *
FROM Production.Product
WHERE ProductID = 63;
Utilizzando il secondo approccio, l'applicazione esegue le seguenti operazioni:
Prepara un'istruzione che contiene un marcatore di parametro (
?).SELECT * FROM Production.Product WHERE ProductID = ?;Associare una variabile di programma al marcatore di parametro.
A ogni richiesta di informazioni sui prodotti, inserisci nella variabile associata il valore chiave ed esegui l'istruzione.
Il secondo approccio è più efficiente se l'istruzione viene eseguita più di tre volte.
Nel motore di database, il modello prepare/execute non ha un vantaggio significativo sulle prestazioni rispetto all'esecuzione diretta, a causa del modo in cui il motore di database riutilizza i piani di esecuzione. Il motore di database dispone di algoritmi efficienti per abbinare le istruzioni T-SQL attuali con piani di esecuzione generati per le esecuzioni precedenti della stessa istruzione T-SQL. Se un'applicazione esegue più volte un'istruzione T-SQL con marcatori di parametro, il motore di database riutilizza il piano di esecuzione della prima esecuzione per la seconda e le successive (a meno che il piano non venga rimosso dalla cache dei piani). Il modello di preparazione/esecuzione presenta comunque i vantaggi seguenti:
- Trovare un piano di esecuzione tramite un handle identificativo è più efficiente rispetto agli algoritmi usati per abbinare un'istruzione T-SQL ai piani di esecuzione esistenti.
- L'applicazione può controllare quando il piano di esecuzione viene creato e quando viene riutilizzato.
- Il modello di preparazione/esecuzione è utilizzabile con altri database, incluse le versioni precedenti di SQL Server.
Sensibilità ai parametri
La sensibilità ai parametri, nota anche come parameter sniffing, si riferisce a un processo in cui il motore di database rileva i valori attuali dei parametri durante la compilazione o la ricompilazione e li trasmette al Query Optimizer per potenzialmente aiutare a generare piani di esecuzione delle query più efficienti.
I valori dei parametri vengono individuati durante la compilazione o ricompilazione per i seguenti tipi di batch:
- Procedure memorizzate
- Richieste inoltrate tramite
sp_executesql - Query preparate
Per maggiori informazioni sulla risoluzione di problemi di sniffing dei parametri, vedi:
- Analizzare e risolvere i problemi sensibili ai parametri
- Utilizzare parametri espliciti per il riutilizzo del piano
- Ottimizzazione dei piani sensibili ai parametri
- Risolvere i problemi relativi ai piani di esecuzione delle query sensibili ai parametri nel database SQL di Azure
- Risolvere i problemi relativi alle query con piani di esecuzione sensibili ai parametri nell’Istanza gestita di SQL di Azure
Quando una query nel motore di database utilizza l'hintOPTION (RECOMPILE), il Query Optimizer trasforma parametri e variabili locali in costanti di compilazione che possono essere valutate come costanti e ridotte a letterali. Durante la compilazione, l'ottimizzatore conosce e può utilizzare i valori di runtime attuali dei parametri e delle variabili locali così come sono immediatamente prima di quell'istruzione. L'indicazione OPTION (RECOMPILE) consente all'ottimizzatore di generare un piano di query più ottimale, adattato ai valori specifici, e di sfruttare i migliori indici sottostanti in tempo reale. Per i parametri, questo processo non fa riferimento ai valori originariamente passati al batch o alla stored procedure, ma ai relativi valori al momento della ricompilazione. Questi valori possono essere modificati all'interno della procedura prima di raggiungere l'enunciato che include RECOMPILE. Questo comportamento può migliorare le prestazioni per query con dati di input altamente variabili o sbilanciati, a costo di compilare la query ogni volta che viene eseguita. Questo costo può essere elevato. Evita di usare l'hint RECOMPILE senza valutarne l'impatto sull'intero carico di lavoro.
Variabili locali e stime di cardinalità
Quando una query utilizza variabili locali, il motore di database non può determinarne automaticamente i valori al momento della compilazione, quindi stima la cardinalità usando statistiche o euristiche disponibili. Se esistono statistiche, in genere usa il valore All Density (noto anche come densità media) dall'istogramma statistico per stimare il numero di righe corrispondenti al predicato. Tuttavia, se non sono disponibili statistiche per la colonna, il motore di database si basa su stime euristiche, come assumere 10% selettività per predicati di uguaglianza e 30% per disuguaglianze e intervalli. Queste stime potrebbero portare a piani di esecuzione meno accurati. Ecco un esempio di query che usa una variabile locale.
DECLARE @ProductId AS INT = 100;

SELECT *
FROM Products
WHERE ProductId = @ProductId;
In questo caso, il motore di database non utilizza il valore 100 per ottimizzare la query. Usa una stima generale.
Elaborazione parallela di query
Il motore di database fornisce query parallele per ottimizzare l'esecuzione delle query e le operazioni di indicizzazione per computer che dispongono di più di un microprocessore (CPU). Poiché il motore di database può eseguire un'operazione di query o indicizzazione in parallelo utilizzando diversi thread worker del sistema operativo, l'operazione si completa rapidamente ed efficientemente.
Durante l'ottimizzazione delle query, il motore di database cerca query o operazioni di indice che potrebbero beneficiare di un'esecuzione parallela. Per queste query, il motore di database inserisce operatori di scambio nel piano di esecuzione della query per preparare la query all'esecuzione parallela. Un operatore di scambio è un operatore del piano di esecuzione della query responsabile della gestione dei processi, della ridistribuzione dei dati e del controllo di flusso. L'operatore di scambio include gli operatori logici Distribute Streams, Repartition Streams e Gather Streams come sottotipi, uno o più dei quali possono apparire nell'output Showplan del piano di esecuzione parallela di una query.
Importante
Alcuni costrutti ostacolano la capacità del motore di database di utilizzare il parallelismo sull'intero piano di esecuzione, o su parti del piano di esecuzione.
I costrutti che impediscono il parallelismo includono:
| Costruire | Descrizione |
|---|---|
| UDF scalari | Per maggiori informazioni sulle funzioni scalari definite dall'utente, vedi Crea funzioni definite dall'utente. A partire da SQL Server 2019 (15.x), Motore di database di SQL Server può eseguire l'inlining di queste funzioni e sbloccare l'uso del parallelismo durante l'elaborazione delle query. Per maggiori informazioni sull'inlining scalare UDF, vedi Elaborazione intelligente delle query nei database SQL. |
| Query remota | Per maggiori informazioni su Remote Query, vedi Riferimento dell'operatore showplan logico e fisico. |
| Cursori dinamici | Per maggiori informazioni sui cursori, vedi DECLARE CURSOR. |
| Query ricorsive | Per ulteriori informazioni sulla ricorsione, consulta Linee guida per definire e usare espressioni di tabella comuni ricorsive e Ricorsione in T-SQL. |
| Funzioni con valori di tabella con istruzioni multiple (MSTVF) | Per maggiori informazioni sugli MSTVF, vedi Create User-defined Functions (motore di database). |
TOP parola chiave |
Per altre informazioni, vedere TOP. |
Un piano di esecuzione delle query può contenere l'attributo NonParallelPlanReason nell'elemento QueryPlan che descrive il motivo per cui non è stato usato il parallelismo. I valori per questo attributo sono:
| Valore NonParallelPlanReason | Descrizione |
|---|---|
MaxDOPSetToOne |
Grado massimo di parallelismo impostato a 1. |
EstimatedDOPIsOne |
Il grado stimato di parallelismo è 1. |
NoParallelWithRemoteQuery |
Il parallelismo non è supportato per le query remote. |
NoParallelDynamicCursor |
Piani paralleli non supportati per i cursori dinamici. |
NoParallelFastForwardCursor |
Piani paralleli non supportati per i cursori avanzamento rapido. |
NoParallelCursorFetchByBookmark |
Piani paralleli non supportati per i cursori che eseguono il recupero tramite segnalibro. |
NoParallelCreateIndexInNonEnterpriseEdition |
Creazione di indici paralleli non supportata per edizioni diverse da Enterprise Edition. |
NoParallelPlansInDesktopOrExpressEdition |
Piani paralleli non supportati per Desktop Edition ed Express Edition. |
NonParallelizableIntrinsicFunction |
La query fa riferimento a una funzione intrinseca non parallelizzabile. |
CLRUserDefinedFunctionRequiresDataAccess |
Il parallelismo non è supportato per una funzione CLR definita dall'utente che richiede l'accesso ai dati. |
TSQLUserDefinedFunctionsNotParallelizable |
La query fa riferimento a una funzione definita dall'utente in T-SQL che non è parallelizzabile. |
TableVariableTransactionsDoNotSupportParallelNestedTransaction |
Le transazioni di variabili di tabella non supportano transazioni parallele annidate. |
DMLQueryReturnsOutputToClient |
Query DML che restituisce l'output al client e non è parallelizzabile. |
MixedSerialAndParallelOnlineIndexBuildNotSupported |
Combinazione non supportata di piani seriali e paralleli per una singola compilazione indice online. |
CouldNotGenerateValidParallelPlan |
Verifica del piano parallelo non superata, si sta ripristinando al piano seriale. |
NoParallelForMemoryOptimizedTables |
Parallelismo non supportato per le tabelle OLTP in memoria a cui si fa riferimento. |
NoParallelForDmlOnMemoryOptimizedTable |
Parallelismo non supportato per DML in una tabella OLTP in memoria. |
NoParallelForNativelyCompiledModule |
Parallelismo non supportato per i moduli compilati in modo nativo a cui si fa riferimento. |
NoRangesResumableCreate |
Generazione dell'intervallo non riuscita per un'operazione di creazione ripristinabile. |
Dopo l'inserimento degli operatori di scambio, si ottiene un piano di esecuzione parallela della query. Un piano di esecuzione di query parallele può utilizzare più di un thread di lavoro. Un piano di esecuzione seriale, utilizzato da una query non parallela (seriale), impiega un solo thread di lavoro per la sua esecuzione. Il numero effettivo di thread worker utilizzati da una query parallela è determinato all'inizializzazione dell'esecuzione del piano di query e dipende dalla complessità del piano e dal grado di parallelismo.
Il grado di parallelismo (DOP) specifica il numero massimo di processori che possono essere utilizzati per eseguire un compito parallelo. Il DOP non indica il numero totale di thread worker utilizzati da una query. Il limite DOP viene impostato per task. Non è un limite per richiesta o per interrogazione. Ciò significa che durante l'esecuzione di query parallele, una singola richiesta può generare più task che vengono assegnate a un pianificatore. Più processori di quelli specificati da MAXDOP potrebbero essere utilizzati contemporaneamente in un dato punto dell'esecuzione della query, quando diversi compiti vengono eseguiti contemporaneamente. Per altre informazioni, vedere la guida all'architettura di thread e attività.
L'ottimizzatore di query non utilizza un piano di esecuzione parallelo per una query se una delle seguenti condizioni è vera:
Il piano di esecuzione seriale è semplice o non supera la soglia di costo per l'impostazione del parallelismo.
Il piano di esecuzione seriale ha un costo del sottoalbero stimato inferiore rispetto a qualsiasi piano di esecuzione parallela esplorato dall'ottimizzatore.
La query contiene operatori scalari o relazionali che non possono essere eseguiti in parallelo. Alcuni operatori possono portare all'esecuzione in modalità seriale di una sezione del piano di query o dell'intero piano.
Nota
Il costo totale stimato del sottoalbero di un piano parallelo può essere inferiore alla soglia di costo per l'impostazione di parallelismo. In altre parole, il costo totale stimato del sottoalbero del piano seriale lo superava, e veniva scelto il piano di query con il costo totale stimato più basso del subalbero.
Grado di parallelismo (DOP)
Il motore di database rileva automaticamente il miglior grado di parallelismo per ogni istanza di un'esecuzione parallela di query o di un'operazione di definizione dati indice (DDL). Determina questo valore basandosi sui seguenti criteri:
Esecuzione di SQL Server in un computer con più microprocessori o CPU, ad esempio un computer SMP (Symmetric Multiprocessing). Solo i computer con più CPU possono utilizzare le query parallele.
Se sono disponibili un numero sufficiente di thread di lavoro. Per l'esecuzione di una query o di un'operazione su un indice è necessario un numero specifico di thread di lavoro. L'esecuzione di un piano parallelo richiede un numero di thread di lavoro maggiore rispetto all'esecuzione di un piano seriale e il numero di thread di lavoro necessari aumenta con il grado di parallelismo. Quando il requisito di worker thread del piano parallelo per un certo grado di parallelismo non può essere soddisfatto, il Motore di database di SQL Server riduce automaticamente il grado di parallelismo, oppure esegue il piano parallelo in modo seriale.
Tipo di query o di operazione sull'indice eseguita. Le operazioni di creazione o ricompilazione di un indice o di eliminazione di un indice cluster e le query che utilizzano molte risorse CPU sono candidate ideali per un piano parallelo. Esempi di operazioni di questo tipo sono i join di tabelle di grandi dimensioni, le aggregazioni di ampia portata e gli ordinamenti di set di risultati estesi. Nelle query di base, frequentemente presenti nelle applicazioni di elaborazione delle transazioni, il coordinamento aggiuntivo necessario per eseguire una query in parallelo supera il potenziale aumento delle prestazioni. Per distinguere le query che possono trarre vantaggio dal parallelismo o meno, il motore di database di SQL Server confronta il costo stimato per l'esecuzione della query o dell'operazione sull'indice con il valore soglia costo per parallelismo. Gli utenti possono modificare il valore predefinito di
5usando sp_configure se test adeguati rilevano che un valore diverso è più adatto al carico di lavoro in esecuzione.Presenza di un numero sufficiente di righe da elaborare. Se Query Optimizer determina che il numero di righe è troppo basso, non introduce operatori di scambio per distribuire le righe. Gli operatori vengono pertanto eseguiti in modo seriale, Eseguire gli operatori in un piano seriale evita le situazioni in cui i costi di avvio, distribuzione e coordinamento superano i guadagni ottenuti dall'esecuzione parallela degli operatori.
Disponibilità delle statistiche attuali. Se il grado di parallelismo massimo non è disponibile, prima di abbandonare il piano parallelo vengono considerati i gradi inferiori. Ad esempio, quando crei un indice clusterizzato su una vista, le statistiche non possono essere valutate, perché l'indice clusterizzato non esiste ancora. In questo caso, il motore di database di SQL Server non può fornire il grado di parallelismo massimo per l'operazione sull'indice. Alcuni operatori, ad esempio quelli relativi all'ordinamento e all'analisi, possono tuttavia trarre vantaggi dall'esecuzione parallela.
Nota
Le operazioni parallele sugli indici sono disponibili solo nelle edizioni Enterprise, Developer ed Evaluation di SQL Server.
Al momento dell'esecuzione, il motore di database di SQL Server determina se il carico di lavoro di sistema corrente e i dati di configurazione illustrati in precedenza consentono l'esecuzione parallela. Se l'esecuzione parallela è garantita, il motore di database di SQL Server determina il numero ottimale di thread di lavoro e suddivide l'esecuzione del piano parallelo tra tali thread di lavoro. Dal momento in cui viene avviata l'esecuzione parallela su più thread di lavoro di una query o di un'operazione sull'indice, viene usato lo stesso numero di thread di lavoro fino al completamento dell'operazione. Il motore di database di SQL Server riesamina il numero ottimale di decisioni di thread di lavoro ogni volta che viene recuperato un piano di esecuzione dalla cache dei piani. Ad esempio, un'esecuzione di un piano parallelo con cache può essere eseguita in modo seriale, un'esecuzione successiva dello stesso piano può utilizzare tre worker thread e una terza esecuzione può usare quattro worker thread.
Gli operatori di aggiornamento ed eliminazione in un piano di esecuzione di query parallele vengono eseguiti in modo seriale, ma la clausola WHERE di un'istruzione UPDATE o DELETE può essere eseguita in parallelo. Le modifiche apportate ai dati verranno quindi applicate in modo seriale al database.
A partire dal livello di compatibilità del database 110, l'istruzione SELECT ... INTO può essere eseguita in parallelo. Altre forme di operatori di insert funzionano allo stesso modo descritto nelle versioni precedenti.
A partire dal livello di compatibilità del database 130, l'istruzione INSERT ... SELECT può essere eseguita in parallelo inserendo in heap o indici clustered columnstore (CCI), e utilizzando il TABLOCK hint. Le operazioni di INSERT nelle tabelle temporanee locali (identificate dal prefisso #) e nelle tabelle temporanee globali (identificate dai prefissi ##) sono anch'esse abilitate per il parallelismo tramite l'hint TABLOCK. Per altre informazioni, vedere INSERT.
I cursori statici e gestiti da keyset possono essere popolati tramite piani di esecuzione parallela. La funzionalità dei cursori dinamici può invece essere implementata solo tramite l'esecuzione seriale. Query Optimizer genera sempre un piano di esecuzione seriale per le query che fanno parte di un cursore dinamico.
Sovrascrivere i gradi di parallelismo
Il grado di parallelismo imposta il numero di processori da usare durante l'esecuzione di piani paralleli. Puoi impostare questa configurazione a vari livelli:
A livello di server, utilizzando l'opzione di configurazione del server max degree of parallelism (
MAXDOP).Si applica a: SQL Server
SQL Server 2019 (15.x) ha introdotto raccomandazioni automatiche per impostare l'opzione
MAXDOPdi configurazione del server durante il processo di installazione. L'interfaccia utente del programma di installazione consente di accettare le impostazioni consigliate o di immettere valori personalizzati. Per altre informazioni, vedere Pagina Configurazione del motore di database - MaxDOP.A livello di carico di lavoro, utilizzando l'opzione
MAX_DOPdi configurazione del gruppo di carico di lavoro Resource Governor.Si applica a: SQL Server
A livello di database, utilizzando la
MAXDOPconfigurazione con ambito database.Si applica a: SQL Server, database SQL di Azure e Istanza gestita di SQL di Azure
A livello di query o istruzione, utilizzando il
MAXDOPMAXDOPo l'opzione index. Ad esempio, puoi usare l'opzioneMAXDOPper controllare, aumentando o riducendo, il numero di processori dedicati a un'operazione di indicizzazione online. In questo modo, puoi bilanciare le risorse utilizzate da un'operazione di indicizzazione con quelle degli utenti concorrenti.Si applica a: SQL Server, database SQL di Azure e Istanza gestita di SQL di Azure
Impostando l'opzione max degree of parallelism su 0 (predefinito), il motore di database può utilizzare tutti i processori disponibili fino a un massimo di 64 processori in un'esecuzione parallela del piano. Sebbene il motore di database stabilisca un target di runtime di 64 processori logici quando l'opzione MAXDOP è impostata su 0, puoi impostare manualmente un valore diverso se necessario. L'impostazione di MAXDOP su 0 per query e indici consente al motore di database di utilizzare tutti i processori disponibili fino a un massimo di 64 processori per le query o gli indici specificati in un'esecuzione parallela del piano.
MAXDOP non è un valore imposto per tutte le query parallele, ma piuttosto un target provvisorio per tutte le query idonee al parallelismo. Ciò significa che se non sono disponibili abbastanza thread worker in fase di esecuzione, una query potrebbe essere eseguita con un grado di parallelismo inferiore rispetto all'opzione MAXDOP di configurazione del server.
Suggerimento
Per maggiori informazioni, consulta le raccomandazioni MAXDOP per le linee guida sulla configurazione di MAXDOP MAXDOP a livello di server, database, query o hint.
Esempio di query parallela
La seguente query conta il numero di ordini effettuati in un trimestre specifico, a partire dal 1° aprile 2024, e in cui almeno una voce dell'ordine è stata ricevuta dal cliente dopo la data promessa. La query indica il numero totale di tali ordini raggruppati per priorità di ordine e disposti in ordine di priorità crescente.
Nell'esempio seguente vengono utilizzati nomi di tabelle e colonne fittizi.
SELECT o_orderpriority,
       COUNT(*) AS Order_Count
FROM orders
WHERE o_orderdate >= '2024/04/01'
      AND o_orderdate < DATEADD(mm, 3, '2024/04/01')
      AND EXISTS (SELECT *
                  FROM lineitem
                  WHERE l_orderkey = o_orderkey
                        AND l_commitdate < l_receiptdate)
GROUP BY o_orderpriority
ORDER BY o_orderpriority;
Si supponga che per le tabelle lineitem e orders vengano definiti gli indici seguenti:
CREATE INDEX l_order_dates_idx
    ON lineitem(l_orderkey, l_receiptdate, l_commitdate, l_shipdate);

CREATE UNIQUE INDEX o_datkeyopr_idx
    ON ORDERS(o_orderdate, o_orderkey, o_custkey, o_orderpriority);
Di seguito viene riportato un possibile piano parallelo generato per la query indicata in precedenza:
|--Stream Aggregate(GROUP BY:([ORDERS].[o_orderpriority])
                  DEFINE:([Expr1005]=COUNT(*)))
    |--Parallelism(Gather Streams, ORDER BY:
                  ([ORDERS].[o_orderpriority] ASC))
         |--Stream Aggregate(GROUP BY:
                  ([ORDERS].[o_orderpriority])
                  DEFINE:([Expr1005]=Count(*)))
              |--Sort(ORDER BY:([ORDERS].[o_orderpriority] ASC))
                   |--Merge Join(Left Semi Join, MERGE:
                  ([ORDERS].[o_orderkey])=
                        ([LINEITEM].[l_orderkey]),
                  RESIDUAL:([ORDERS].[o_orderkey]=
                        [LINEITEM].[l_orderkey]))
                        |--Sort(ORDER BY:([ORDERS].[o_orderkey] ASC))
                        |    |--Parallelism(Repartition Streams,
                           PARTITION COLUMNS:
                           ([ORDERS].[o_orderkey]))
                        |         |--Index Seek(OBJECT:
                     ([tpcd1G].[dbo].[ORDERS].[O_DATKEYOPR_IDX]),
                     SEEK:([ORDERS].[o_orderdate] >=
                           Apr  1 2024 12:00AM AND
                           [ORDERS].[o_orderdate] <
                           Jul  1 2024 12:00AM) ORDERED)
                        |--Parallelism(Repartition Streams,
                     PARTITION COLUMNS:
                     ([LINEITEM].[l_orderkey]),
                     ORDER BY:([LINEITEM].[l_orderkey] ASC))
                             |--Filter(WHERE:
                           ([LINEITEM].[l_commitdate]<
                           [LINEITEM].[l_receiptdate]))
                                  |--Index Scan(OBJECT:
         ([tpcd1G].[dbo].[LINEITEM].[L_ORDER_DATES_IDX]), ORDERED)
L'illustrazione seguente mostra un piano di query eseguito con un grado di parallelismo uguale a 4 e che coinvolge una join a due tabelle.
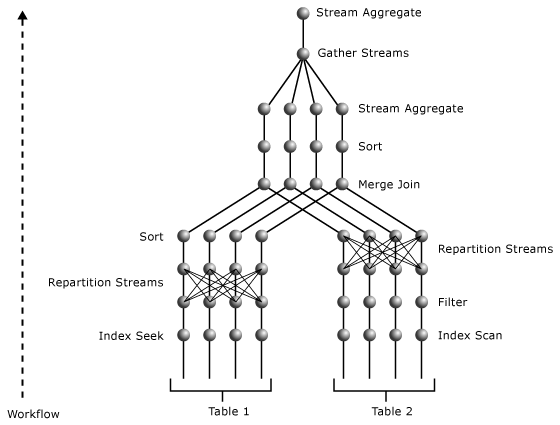
Il piano parallelo contiene tre operatori di parallelismo. Sia l'operatore Index Seek dell'indice o_datkey_ptr che l'operatore Index Scan dell'indice l_order_dates_idx vengono eseguiti in parallelo. Questo processo produce diversi flussi esclusivi, che possono essere determinati dagli operatori di parallelismo più vicini sopra gli operatori Index Scan e Index Seek, rispettivamente. Entrambi gli operatori stanno ripartizionando il tipo di exchange. Rimescolano i dati tra i flussi e producono lo stesso numero di flussi sulla loro uscita quanti hanno sull'input. Questo numero di flussi equivale al grado di parallelismo.
L'operatore di parallelismo sopra l'operatore l_order_dates_idx Index Scan ripartiziona i suoi flussi di input usando il valore di L_ORDERKEY come chiave. In questo modo, lo stesso valore di L_ORDERKEY viene incluso nello stesso flusso di output. Allo stesso tempo, i flussi di output mantengono l'ordine della colonna L_ORDERKEY per soddisfare il requisito di input dell'operatore Merge Join.
L'operatore di parallelismo sopra l'operatore Index Seek ripartiziona i suoi flussi di input usando il valore di O_ORDERKEY. Poiché il suo input non è ordinato sui valori della colonna O_ORDERKEY e questa colonna è la colonna join nell'operatore Merge Join , l'operatore Sort tra gli operatori parallelismo e Merge Join assicura che l'input sia ordinato per l'operatore Merge Join sulle colonne di join. Analogamente all'operatore Merge Join, l'operatore Sort viene eseguito in parallelo.
L'operatore di parallelismo superiore riunisce i risultati di numerosi flussi in un singolo flusso. Le aggregazioni parziali eseguite dall'operatore Stream Aggregate sottostante all'operatore di parallelismo vengono quindi riunite in un singolo valore SUM per ogni valore diverso di O_ORDERPRIORITY nell'operatore Stream Aggregate sopra l'operatore di parallelismo. Poiché questo piano ha due segmenti di scambio, con un grado di parallelismo uguale a 4, utilizza otto thread di lavoro.
Per maggiori informazioni sugli operatori usati in questo esempio, vedi il riferimento degli operatori Logical and physical showplan.
Operazioni parallele sugli indici
I piani di query per operazioni di indice che creano o ricostruiscono un indice, o che eliminano un indice clusterato, possono supportare operazioni parallele e multithread su computer con più processori.
Nota
Le operazioni di indice parallelo sono disponibili solo nell'edizione Enterprise.
motore di database utilizza gli stessi algoritmi per determinare il grado di parallelismo (il numero totale di thread di lavoro separati da eseguire) per le operazioni sugli indici come per altre query. L'opzione di configurazione server max degree of parallelism stabilisce il grado massimo di parallelismo per un'operazione sull'indice. Puoi sovrascrivere il valore max degree of parallelism per le singole operazioni di indice impostando l'opzione di indice MAXDOP nell'istruzione CREATE INDEX, ALTER INDEX, DROP INDEX e ALTER TABLE.
Quando il Motore di database di SQL Server costruisce un piano di esecuzione dell'indice, il numero di operazioni parallele viene impostato al valore più basso tra questi valori:
- Il numero di processori, o CPU, presenti nel computer.
- Il numero specificato nell'opzione
max degree of parallelismdi configurazione del server. - Il numero di CPU che non sono già al di sopra di una soglia di lavoro svolto per i thread di lavoro di SQL Server.
Ad esempio, su un computer che ha otto CPU, ma dove max degree of parallelism è impostato su 6, l'operazione di indicizzazione utilizza non più di sei thread worker paralleli. Se 5 CPU del computer hanno superato la soglia di carico di elaborazione per SQL Server al momento della compilazione del piano di esecuzione per l'indice, il piano userà solo 3 thread di lavoro paralleli.
Le principali fasi di un'operazione di indicizzazione parallela includono:
- Un thread di lavoro di coordinamento esegue rapidamente l'analisi casuale della tabella per produrre una stima della distribuzione delle chiavi dell'indice. Il thread di lavoro coordinante stabilisce i confini delle chiavi che creano un numero di intervalli di chiavi pari al grado di parallelismo, dove ogni intervallo di chiavi è stimato per coprire numeri simili di righe. Ad esempio, se ci sono quattro milioni di righe nella tabella e il grado di parallelismo è 4, il thread di lavoro coordinante determina i valori chiave che delimitano quattro insiemi di righe con 1 milione di righe in ciascun insieme. Se il thread di lavoro coordinante non riesce a stabilire intervalli di chiavi sufficienti per usare tutte le CPU, riduce di conseguenza il grado di parallelismo.
- Il thread di lavoro di coordinamento recapita un numero di thread di lavoro pari al grado di operazioni parallele e attende che tali thread di lavoro completino le rispettive operazioni. Ogni thread di lavoro esegue l'analisi della tabella di base usando un filtro che recupera solo le righe con valori di chiave inclusi nell'intervallo assegnato al thread di lavoro. Ogni thread di lavoro compila una struttura di indice per le righe nella propria gamma di chiavi. Nel caso di indici partizionati ogni thread di lavoro compila un numero specifico di partizioni. Le partizioni non sono condivise tra i thread di lavoro.
- Dopo che tutti i thread worker paralleli sono completati, il thread worker coordinante collega le subunità indice in un unico indice. Questa fase viene eseguita solo nelle operazioni sugli indici offline.
Le istruzioni individuali CREATE TABLE o ALTER TABLE possono avere molteplici vincoli che richiedono la creazione di un indice. Le operazioni di creazione dell'indice vengono eseguite in serie, anche se in un computer con più CPU ogni singola operazione potrebbe essere eseguita in parallelo.
Architettura delle query distribuita
Il motore di database supporta due metodi per fare riferimento a fonti di dati OLE DB eterogenee nelle istruzioni T-SQL:
Nomi di server collegati
Utilizzare le stored procedure di sistema
sp_addlinkedserveresp_addlinkedsrvloginper assegnare un nome server a una sorgente dati OLE DB. Puoi fare riferimento agli oggetti in questi server collegati tramite istruzioni T-SQL con nomi a quattro parti. Se ad esempio si definisce il nome del server collegatoDeptSQLSrvrper un'altra istanza di SQL Server, l'istruzione seguente fa riferimento a una tabella di tale server:SELECT JobTitle, HireDate FROM DeptSQLSrvr.AdventureWorks2025.HumanResources.Employee;Puoi anche specificare il nome del server collegato in un'istruzione
OPENQUERYper aprire un set di righe dalla sorgente dati OLE DB. Puoi quindi fare riferimento a questo set di righe come una tabella nelle istruzioni T-SQL.Nomi di connettore ad hoc
Per riferimenti poco frequenti a una sorgente dati, specificare le funzioni
OPENROWSEToOPENDATASOURCEcon le informazioni necessarie per connettersi al server collegato. Puoi quindi fare riferimento al rowset nello stesso modo in cui fai riferimento a una tabella nelle istruzioni T-SQL:SELECT a.* FROM OPENROWSET ( 'Microsoft.Jet.OLEDB.4.0', 'MSOffice\Access\Samples\Northwind.mdb'; 'Admin'; '', Employees ) AS a;
Il motore di database utilizza OLE DB per comunicare tra il motore relazionale e il motore di storage. Il motore relazionale scompone ogni istruzione T-SQL in una serie di operazioni su righeset base di OLE DB che il motore di archiviazione apre dalle tabelle base. Questo processo significa che il motore relazionale può anche aprire rowset OLE DB di base su qualsiasi fonte di dati OLE DB.
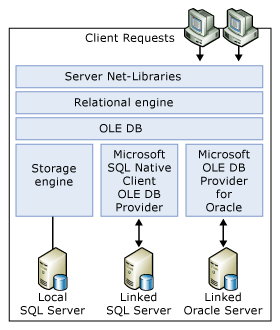
Il motore relazionale utilizza l'API OLE DB per aprire i set di righe nei server collegati, recuperare le righe e gestire le transazioni.
Per ogni sorgente dati OLE DB a cui accedi come server collegato, il server che esegue SQL Server deve avere un provider OLE DB. L'insieme di operazioni T-SQL che puoi utilizzare contro una specifica sorgente di dati OLE DB dipende dalle capacità del provider OLE DB.
Per ogni istanza di SQL Server, i membri del ruolo del server fisso sysadmin possono abilitare o disabilitare l'uso di nomi di connettori ad hoc per un provider OLE DB utilizzando la proprietà DisallowAdhocAccess di SQL Server. Quando si abilita l'accesso ad hoc, qualsiasi utente connesso a quell'istanza può eseguire istruzioni T-SQL contenenti nomi di connettori ad hoc, facendo riferimento a qualsiasi fonte dati sulla rete a cui il provider OLE DB può accedere. Per controllare l'accesso alle fonti dati, i membri del ruolo di server fisso sysadmin possono disabilitare l'accesso ad hoc per quel fornitore OLE DB, limitando così gli utenti solo a quelle fonti dati citate da nomi server collegati definiti dagli amministratori. Per impostazione predefinita, l'accesso ad hoc è abilitato per il provider OLE DB di SQL Server e disabilitato per tutti gli altri provider OLE DB.
Le query distribuite possono consentire agli utenti di accedere a un'altra sorgente dati (ad esempio, file, fonti dati non relazionali come Active Directory, ecc.) utilizzando il contesto di sicurezza dell'account Windows sotto cui il servizio SQL Server è in esecuzione. SQL Server assume correttamente l'identità del login per i login di Windows. Tuttavia, questa impersonificazione non è possibile per i login di SQL Server. Questa limitazione può potenzialmente permettere a un utente di query distribuita di accedere a un'altra fonte dati per la quale non ha permessi, ma l'account sotto cui il servizio SQL Server è in esecuzione possiede i permessi. Usare sp_addlinkedsrvlogin per definire gli account di accesso specifici autorizzati ad accedere al server collegato corrispondente. Questo controllo non è disponibile per nomi ad hoc, quindi fai attenzione quando abiliti un provider OLE DB per l'accesso ad hoc.
Quando possibile, il motore di database spinge operazioni relazionali come joins, restrizioni, proiezioni, ordinamenti e operazioni GROUP BY alla sorgente dati OLE DB. Il motore di database non esegue per impostazione predefinita la scansione della tabella di base in SQL Server né esegue esso stesso le operazioni relazionali. Il motore di database interroga il provider OLE DB per determinare il livello di grammatica SQL che supporta e, sulla base di queste informazioni, invia quante più operazioni relazionali possibile al provider.
Il motore di database specifica un meccanismo per un fornitore OLE DB di restituire statistiche che indicano come i valori chiave vengono distribuiti all'interno della sorgente dati OLE DB. Questo meccanismo consente al motore di database Query Optimizer di analizzare meglio il modello dei dati nella sorgente dati rispetto ai requisiti di ogni istruzione T-SQL, aumentando la capacità del Query Optimizer di generare piani di esecuzione ottimali.
Elaborazione delle query su tabelle e indici partizionati
Il motore di database supporta l'elaborazione delle query consapevole delle partizioni per tabelle e indici partizionati. Questa sezione descrive come il processore di query gestisce gli oggetti partizionati, come interpretare i piani di esecuzione che coinvolgono la partizionazione e le migliori pratiche per migliorare le prestazioni delle query sugli oggetti partizionati.
Nota
Le tabelle e gli indici partizionati sono supportati nell'edizione standard di SQL Server, a partire da SQL Server 2016 (13.x) con Service Pack 1.
Nuova operazione di ricerca con riconoscimento delle partizioni
Nel motore di database, il processore di query vede internamente una tabella partizionata come un indice multicolonna con PartitionID come colonna iniziale.
PartitionID è una colonna calcolata nascosta usata internamente per rappresentare il valore ID della partizione che contiene una riga specifica. Ad esempio, supponiamo che la tabella T, definita come T(a, b, c), sia partizionata su colonna a, e abbia un indice raggruppato su colonna b. Questa tabella partizionata è trattata come una tabella non partizionata con lo schema T(PartitionID, a, b, c) e un indice clusterizzato sulla chiave composita (PartitionID, b). Questa rappresentazione consente all'Ottimizzatore di Query di eseguire operazioni di ricerca basate su PartitionID in qualsiasi tabella o indice partizionato.
L'eliminazione della partizione viene ora eseguita durante tale operazione di ricerca.
Inoltre, il Query Optimizer è esteso in modo che si possa eseguire su PartitionID un'operazione di ricerca o scansione con una condizione (come colonna logica iniziale) e possibilmente su altre colonne chiave dell'indice. Il processore di query esegue quindi una ricerca di secondo livello, con una condizione diversa, su una o più colonne aggiuntive, per ogni valore distinto che soddisfa il criterio di qualificazione per l'operazione di ricerca di primo livello. Questa operazione, chiamata partition skip scan, permette all'Ottimizzatore di Query di eseguire un'operazione di ricerca o scansione basata su una condizione per determinare le partizioni a cui accedere, e un'operazione di ricerca di indice di secondo livello all'interno di quell'operatore per restituire righe da queste partizioni che soddisfano una condizione diversa. Considerare ad esempio la query seguente.
SELECT *
FROM T
WHERE a < 10
      AND b = 2;
Per questo esempio, supponiamo che la tabella T, definita come T(a, b, c), sia partizionata su colonna a, e abbia un indice raggruppato su colonna b. La seguente funzione di partizione definisce i limiti delle partizioni per la tabella T:
CREATE PARTITION FUNCTION myRangePF1(INT)
    AS RANGE LEFT
    FOR VALUES (3, 7, 10);
Per risolvere la query, Query Processor esegue un'operazione di ricerca di primo livello per individuare tutte le partizioni contenenti righe che soddisfano la condizione T.a < 10. Questa operazione identifica le partizioni a cui accedere. All'interno di ogni partizione identificata, il processore esegue quindi una ricerca di secondo livello nell'indice clusterizzato sulla colonna b per trovare le righe che soddisfano la condizione T.b = 2 e T.a < 10.
L'illustrazione seguente è una rappresentazione logica dell'operazione di partition skip scan. Include la tabella T con i dati nelle colonne a e b. Le partizioni sono numerate da 1 a 4 e i limiti delle partizioni sono contraddistinti da righe verticali tratteggiate. Un'operazione di ricerca di primo livello sulle partizioni (non mostrata nell'illustrazione) determina che le partizioni 1, 2 e 3 soddisfano la condizione di ricerca implicita dalla partizionazione definita per la tabella e il predicato sulla colonna a (T.a < 10). Il percorso percorso dalla ricerca del secondo livello è illustrato dalla linea curva. Fondamentalmente, l'operazione esegue una ricerca in ciascuna di queste partizioni per le righe che soddisfano la condizione b = 2. Il costo totale dell'operazione è lo stesso di quello di tre operazioni di ricerca tramite indice separate.
Visualizzare informazioni sul partizionamento nei piani di esecuzione delle query
Esamina i piani di esecuzione delle query su tabelle e indici partizionati usando le istruzioni SET SHOWPLAN_XML T-SQL SET o SET STATISTICS XML, oppure utilizzando l'output grafico del piano di esecuzione in SSMS. Ad esempio, puoi visualizzare il piano di esecuzione in fase di compilazione selezionando Visualizza Piano di Esecuzione Stimato nella barra degli strumenti di Editor di query e il piano di esecuzione in fase di esecuzione selezionando Includi piano di esecuzione effettivo.
Utilizzando questi strumenti, puoi trovare le seguenti informazioni:
- Le operazioni come scansioni, ricerche, inserimenti, aggiornamenti, fusioni e cancellazioni accedono a tabelle o indici partizionati.
- Partizioni a cui viene effettuato l'accesso tramite la query. Ad esempio, i piani di esecuzione in fase di esecuzione includono il conteggio totale delle partizioni a cui si accede e gli intervalli di partizioni contigue a cui si accede.
- Viene utilizzata un'operazione di skip scan di partizione in un'operazione di ricerca o scansione per recuperare dati da una o più partizioni.
Miglioramenti apportati alle informazioni sulle partizioni
Il motore di database fornisce informazioni avanzate di partizionamento sia per i piani di esecuzione in tempo di compilazione che in tempo di esecuzione. I piani di esecuzione includono ora le informazioni seguenti:
- Un attributo opzionale
Partitionedche indica che un operatore, come seek, scansione, inserimento, aggiornamento, fusione o cancellazione, viene eseguito su una tabella partizionata. - Un elemento
SeekPredicateNewnuovo con un sottoelementoSeekKeysche includePartitionIDcome colonna chiave di indice iniziale e condizioni di filtro che specificano ricerche di intervallo suPartitionID. La presenza di dueSeekKeyssottoelementi indica una scansione di salto di partizione suPartitionID. - Informazioni di riepilogo che includono il totale delle partizioni a cui viene effettuato l'accesso. Queste informazioni sono disponibili solo nei piani della fase di esecuzione.
Per mostrare come vengono visualizzate queste informazioni nell'output del piano di esecuzione grafico e nell'output dell'Showplan XML, considera la query seguente sulla tabella partizionata fact_sales. Questa query implica l'aggiornamento dei dati in due partizioni.
UPDATE fact_sales
    SET quantity = quantity - 2
WHERE date_id BETWEEN 20190802 AND 20190902;
Nella figura seguente sono illustrate le proprietà dell'operatore Clustered Index Seek nel piano di esecuzione di runtime per questa query. Per visualizzare la definizione della fact_sales tabella e la definizione della partizione, vedi Esempio.
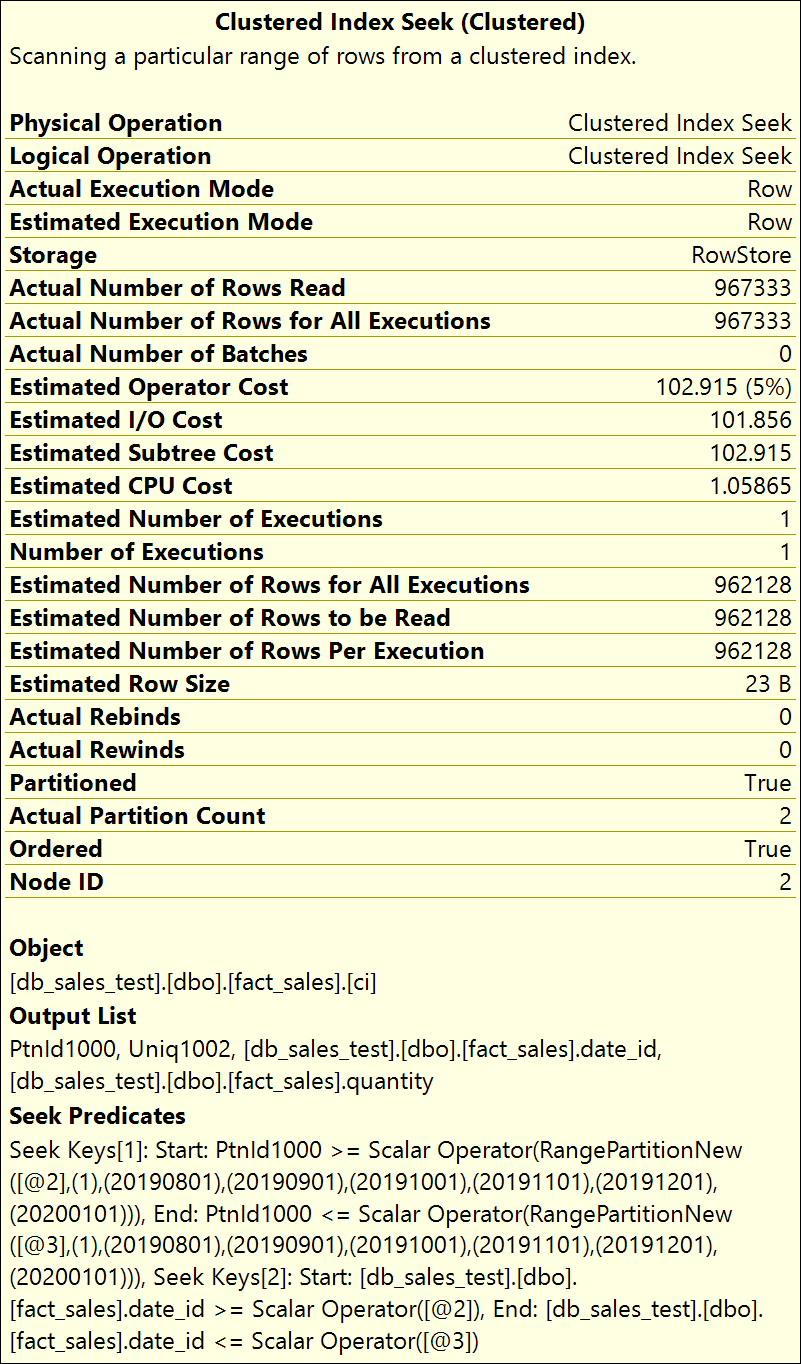
Attributo partizionato
Quando su una tabella o un indice partizionato si esegue un operatore quale Index Seek, l'attributo Partitioned viene incluso sia nel piano della fase di compilazione che in quello della fase di esecuzione ed è impostato su True (1). L'attributo non viene visualizzato quando è impostato a False (0).
L'attributo Partitioned può essere visualizzato negli operatori fisici e logici seguenti:
- Scansione della tabella
- Scansione dell'Indice
- Ricerca tramite indice
- Inserisci
- Aggiornamento
- Elimina
- Fusione
Come mostrato nell'illustrazione precedente, questo attributo appare nelle proprietà dell'operatore in cui è definito. Nell'output XML Showplan, questo attributo appare come Partitioned="1" nel RelOp nodo dell'operatore in cui è definito.
Nuovo predicato di ricerca
Nell'output XML Showplan, l'elemento SeekPredicateNew appare nell'operatore in cui è definito. Può contenere fino a due occorrenze del sottoelemento SeekKeys. Il primo elemento SeekKeys specifica l'operazione di ricerca di primo livello a livello di ID della partizione dell'indice logico. Cioè, questa operazione di ricerca determina le partizioni a cui è necessario accedere per soddisfare le condizioni della query. Il secondo SeekKeys elemento specifica la ricerca di secondo livello che avviene all'interno di ciascuna partizione identificata nella ricerca di primo livello.
Informazioni di riepilogo sulle partizioni
Nei piani di esecuzione della fase di esecuzione le informazioni di riepilogo sulle partizioni includono il totale delle partizioni e l'identità delle partizioni effettive a cui viene effettuato l'accesso. È possibile utilizzare queste informazioni per verificare che le partizioni a cui viene effettuato l'accesso tramite la query sono corrette e che tutte le altre partizioni non vengono considerate.
Vengono fornite le informazioni seguenti: Actual Partition Counte Partitions Accessed.
Actual Partition Count corrisponde al numero totale di partizioni a cui si accede tramite la query.
Partitions Accessed, nell'output XML Showplan, è l'informazione riassuntiva della partizione che appare nel nuovo RuntimePartitionSummary elemento nel RelOp nodo dell'operatore in cui è definito. Nell'esempio seguente è illustrato il contenuto dell'elemento RuntimePartitionSummary , in cui è indicato che viene eseguito l'accesso a due partizioni totali, ovvero la 2 e la 3.
<RunTimePartitionSummary>
    <PartitionsAccessed PartitionCount="2" >
        <PartitionRange Start="2" End="3" />
    </PartitionsAccessed>
</RunTimePartitionSummary>
Visualizza le informazioni delle partizioni utilizzando altri metodi di showplan
I metodi SHOWPLAN_ALL, SHOWPLAN_TEXT e STATISTICS PROFILE di Showplan non segnalano le informazioni sulle partizioni descritte in questo articolo, con l'unica eccezione illustrata di seguito. In quanto incluse nel predicato SEEK , le partizioni a cui eseguire l'accesso sono identificate da un predicato di intervallo nella colonna calcolata che rappresenta l'ID di partizione. L'esempio seguente mostra il predicato SEEK per un operatore Clustered Index Seek . Viene effettuato l'accesso alle partizioni 2 e 3 e l'operatore di ricerca applica il filtro sulle righe che soddisfano la condizione date_id BETWEEN 20190802 AND 20190902.
|--Clustered Index Seek(OBJECT:([db_sales_test].[dbo].[fact_sales].[ci]),
        SEEK:([PtnId1000] >= (2) AND [PtnId1000] <= (3)
                AND [db_sales_test].[dbo].[fact_sales].[date_id] >= (20190802)
                AND [db_sales_test].[dbo].[fact_sales].[date_id] <= (20190902))
                ORDERED FORWARD)
Interpretare i piani di esecuzione per heap partizionati
Un heap partizionato viene considerato come un indice logico sull'ID di partizione. In un piano di esecuzione, l'eliminazione delle partizioni su un heap partizionato è rappresentata come un Table Scan operatore con un SEEK predicato sull'ID della partizione. Nell'esempio seguente sono illustrate le informazioni di Showplan fornite:
|-- Table Scan (OBJECT: ([db].[dbo].[T]), SEEK: ([PtnId1001]=[Expr1011]) ORDERED FORWARD)
Interpretare i piani di esecuzione per join collocati
La collocazione dei join può verificarsi quando due tabelle vengono partizionate utilizzando una funzione di partizionamento identica o equivalente e le colonne di partizionamento di entrambi lati del join sono specificate nella condizione di join della query. Il Query Optimizer può generare un piano in cui le partizioni di ogni tabella con ID di partizione uguali vengono unite separatamente. I join collocati possono risultare più rapidi di quelli non collocati perché possono richiedere una minor quantità di memoria e tempi di elaborazione inferiori. Query Optimizer sceglie un piano non collocato o un piano collocato sulla base delle stime dei costi.
In un piano collocato, il join Nested Loops legge una o più partizioni di tabelle o indici dalla parte interna. I numeri all'interno degli operatori Constant Scan rappresentano i numeri della partizione.
Quando si generano piani paralleli per join collocati su tabelle o indici partizionati, un operatore Parallelism compare tra gli operatori di join Constant Scan e Nested Loops. In questo caso, ognuno dei thread di lavoro sul lato esterno del join legge ed elabora una partizione diversa.
Nella figura seguente è mostrato un piano di query parallela per un join collocato.
Strategia di esecuzione delle query parallele per oggetti partizionati
Query Processor utilizza una strategia di esecuzione parallela per query che eseguono la selezione da oggetti partizionati. Nell’ambito della strategia di esecuzione, Query Processor determina le partizioni della tabella necessarie per eseguire la query e la proporzione di thread di lavoro da allocare a ogni partizione. Nella maggior parte dei casi, Query Processor alloca un numero di thread di lavoro uguale o quasi uguale a ogni partizione, quindi esegue la query in parallelo tra le partizioni. Nei paragrafi seguenti, l'allocazione dei thread di lavoro viene descritta in modo più dettagliato.
Se il numero di thread di lavoro è minore di quello delle partizioni, Query Processor assegna ogni thread di lavoro a una partizione diversa, lasciando inizialmente una o più partizioni senza un thread di lavoro assegnato. Quando un thread worker termina di eseguire su una partizione, il processore di query lo assegna alla partizione successiva finché a ciascuna partizione viene assegnato un singolo thread worker. Questa assegnazione è l'unico caso in cui il processore di query rialloca thread worker ad altre partizioni.
Mostra il thread di lavoro riassegnato una volta terminato. Se il numero di thread di lavoro è uguale a quello delle partizioni, Query Processor assegna un thread di lavoro a ogni partizione. Quando un thread di lavoro termina, non viene riallocato ad altre partizioni.
Se il numero di thread di lavoro è maggiore di quello delle partizioni, Query Processor alloca un numero uguale di thread di lavoro a ogni partizione. Se il numero di worker thread non è un multiplo esatto del numero di partizioni, il query processor assegna un worker thread extra ad alcune partizioni per utilizzare tutti i worker thread disponibili. Se c'è una sola partizione, tutti i thread worker sono assegnati a quella partizione. Nel diagramma seguente, ci sono quattro partizioni e 14 thread di lavoro. Ogni partizione ha assegnati tre worker thread e due partizioni hanno un worker thread aggiuntivo, per un totale di 14 assegnazioni di worker thread. Quando un thread di lavoro termina, non viene riassegnato ad altre partizioni.
Sebbene gli esempi precedenti suggeriscano un modo semplice per allocare i worker thread, la strategia effettiva è più complessa e tiene conto di altre variabili che si verificano durante l'esecuzione della query. Ad esempio, se la tabella è partizionata e ha un indice clusterizzato su una colonna A e una query ha la clausola predicato WHERE A IN (13, 17, 25), il processore di query assegna uno o più thread worker a ciascuno di questi tre valori di ricerca (A = 13, A = 17 e A = 25) invece di ciascuna partizione della tabella. È necessario eseguire la query nelle partizioni che contengono questi valori e, se tutti questi predicati di ricerca si trovano nella stessa partizione della tabella, tutti i worker thread sono assegnati alla stessa partizione della tabella.
Per fare un altro esempio, supponiamo che la tabella abbia quattro partizioni sulla colonna A con punti di confine (10, 20, 30), un indice sulla colonna B e che la query abbia una clausola di predicato WHERE B IN (50, 100, 150). Poiché le partizioni delle tabelle si basano sui valori di A, i valori di B possono verificarsi in qualsiasi partizione della tabella. Pertanto, il processore di query cerca ciascuno dei tre valori di B (50, 100, 150) in ciascuna delle quattro partizioni delle tabelle. Il query processor assegna i thread di lavoro in modo proporzionale in modo da poter eseguire ciascuna di queste 12 scansioni di query in parallelo.
Partizioni della tabella basate sulla colonna A |
Cerca la colonna B in ogni partizione della tabella |
|---|---|
Partizione della tabella 1: A < 10 |
B = 50, B = 100, B = 150 |
Partizione della tabella 2: A >= 10 AND A < 20 |
B = 50, B = 100, B = 150 |
Partizione della tabella 3: A >= 20 AND A < 30 |
B = 50, B = 100, B = 150 |
Partizione della tabella 4: A >= 30 |
B = 50, B = 100, B = 150 |
Procedure consigliate
Per migliorare le prestazioni delle query che accedono a una grande quantità di dati da grandi tabelle e indici partizionati, segui queste best practice:
Eseguire lo striping di ogni partizione tra molti dischi. Questo approccio è particolarmente rilevante quando si utilizzano dischi rotanti.
Quando possibile, utilizzare un server con memoria principale sufficiente per contenere partizioni a cui viene effettuato l'accesso frequentemente o a tutte le partizioni in memoria per ridurre il costo delle operazioni di I/O.
Se i dati che interroghi non entrano in memoria, comprimi le tabelle e gli indici per ridurre i costi di I/O.
Utilizzare un server con processori veloci e il maggior numero possibile di core del processore per sfruttare a pieno la funzionalità di elaborazione di query parallele.
Assicurarsi che per il server sia disponibile larghezza di banda sufficiente del controller I/O.
Creare un indice clusterizzato in ogni tabella partizionata grande per sfruttare le ottimizzazioni della scansione dell'albero B.
Quando si caricano dati in massa in tabelle partizionate, segui le raccomandazioni di best practice contenute nel white paper, The Data Loading Performance Guide.
Esempio
Nell'esempio seguente viene creato un database di test che contiene un'unica tabella con sette partizioni. Per visualizzare le informazioni di partizionamento sia per i piani a tempo di compilazione che per quelli a tempo di esecuzione, usa gli strumenti descritti in Display partizioning information nei piani di esecuzione delle query quando esegui le query in questo esempio.
Nota
In questo esempio nella tabella viene inserito più di un milione di righe. A seconda dell'hardware disponibile. l'esecuzione di questo esempio può richiedere diversi minuti. Prima di eseguire questo esempio, verificare di disporre di almeno 1,5 GB di spazio libero su disco.
USE master;
GO

IF DB_ID(N'db_sales_test') IS NOT NULL
    DROP DATABASE db_sales_test;
GO

CREATE DATABASE db_sales_test;
GO

USE db_sales_test;
GO

CREATE PARTITION FUNCTION pf_range_fact(INT)
    AS RANGE RIGHT
    FOR VALUES (20190801, 20190901, 20191001, 20191101, 20191201, 20200101);
GO

CREATE PARTITION SCHEME ps_fact_sales
    AS PARTITION pf_range_fact
    ALL TO ([PRIMARY]);
GO

CREATE TABLE fact_sales
(
    date_id INT,
    product_id INT,
    store_id INT,
    quantity INT,
    unit_price NUMERIC (7, 2),
    other_data CHAR (1000)
) ON ps_fact_sales (date_id);
GO

CREATE CLUSTERED INDEX ci
    ON fact_sales(date_id);
GO

PRINT 'Loading...';

SET NOCOUNT ON;

DECLARE @i AS INT;

SET @i = 1;

WHILE (@i < 1000000)
    BEGIN
        INSERT INTO fact_sales
        VALUES (20190800 + (@i % 30) + 1, @i % 10000, @i % 200, RAND() - 25, (@i % 3) + 1, '');
        SET @i += 1;
    END
GO

DECLARE @i AS INT;

SET @i = 1;

WHILE (@i < 10000)
    BEGIN
        INSERT INTO fact_sales
        VALUES (20190900 + (@i % 30) + 1, @i % 10000, @i % 200, RAND() - 25, (@i % 3) + 1, '');
        SET @i += 1;
    END

PRINT 'Done.';
GO

-- Two-partition query.
SET STATISTICS XML ON;
GO

SELECT date_id,
       SUM(quantity * unit_price) AS total_price
FROM fact_sales
WHERE date_id BETWEEN 20190802 AND 20190902
GROUP BY date_id;
GO

SET STATISTICS XML OFF;
GO

-- Single-partition query.
SET STATISTICS XML ON;
GO

SELECT date_id,
       SUM(quantity * unit_price) AS total_price
FROM fact_sales
WHERE date_id BETWEEN 20190801 AND 20190831
GROUP BY date_id;
GO

SET STATISTICS XML OFF;
GO
Contenuto correlato
- Riferimento dell'operatore per piani di esecuzione logici e fisici
- Panoramica degli eventi estesi
- Procedure consigliate per il monitoraggio dei carichi di lavoro con Query Store
- Stima della cardinalità (SQL Server)
- Elaborazione di query intelligenti nei database SQL
- Precedenza degli operatori (Transact-SQL)
- Panoramica del piano di esecuzione
- Centro prestazioni per il motore di database di SQL Server e il database SQL di Azure