AI Builder でのテキスト認識事前構築済みモデルは、画像やドキュメントから印刷テキストと手書きテキストを抽出します。 このモデルを Power Automate で使用すると、スキャンしたドキュメント、写真、PDF のテキストを自動的に処理するワークフローを作成できるため、効率的なデータ処理と他のアプリケーションとの統合が可能になります。
Power Automate でのテキスト認識事前構築済みモデルの使用に関するガイドをこのドキュメントで提供します。
Power Automate クラウド フローの初期化
Power Automate クラウド フローの初期化は、自動化プロセスを設定する最初のステップです。 このステップでは、クラウド フローのトリガーと初期入力パラメーターを定義できます。 初期化時に、クラウド フローが正しく起動し、テキスト認識タスクを効率的に処理するために必要な情報があることを確認できます。
クラウド フローを初期化するには、以下の手順に従ってください:
Power Automate にサインインします。
ナビゲーション メニューで、マイ フロー を選択し、新しいフロー>インスタント クラウド フロー を選択します。
クラウド フローに名前を付け、このフローをトリガーする方法を選択します の下の フローを手動でトリガーする を選択した後、作成 を選択します。
手動でフローをトリガー を展開し、入力タイプとして +入力の追加>ファイル を選択します。
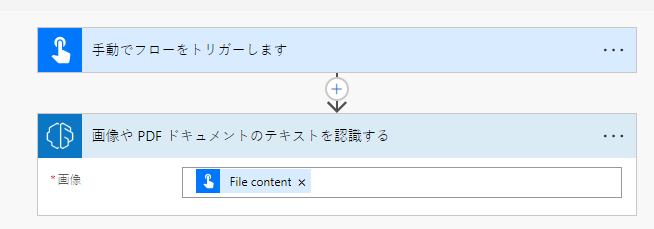
+新しいステップ>AI Builder 選択し、アクションのリストにある 画像や PDF ドキュメントのテキストを認識する を選択します。
画像入力を選択し、次に動的なコンテンツ リストからファイル コンテンツを選択します。
結果を処理するには、文書全文、ページテキスト、または文書テキストを行単位で使用できます。
ドキュメント テキスト全体またはページ全体のテキストを取得します
ドキュメント全体のテキストまたは特定のページテキストに対してアクションを実行する必要がある場合、このオプションが便利です。 ページ テキストを使用する例としては、部分文字列を検索したり、下流のアクションに渡す場合などがあります。
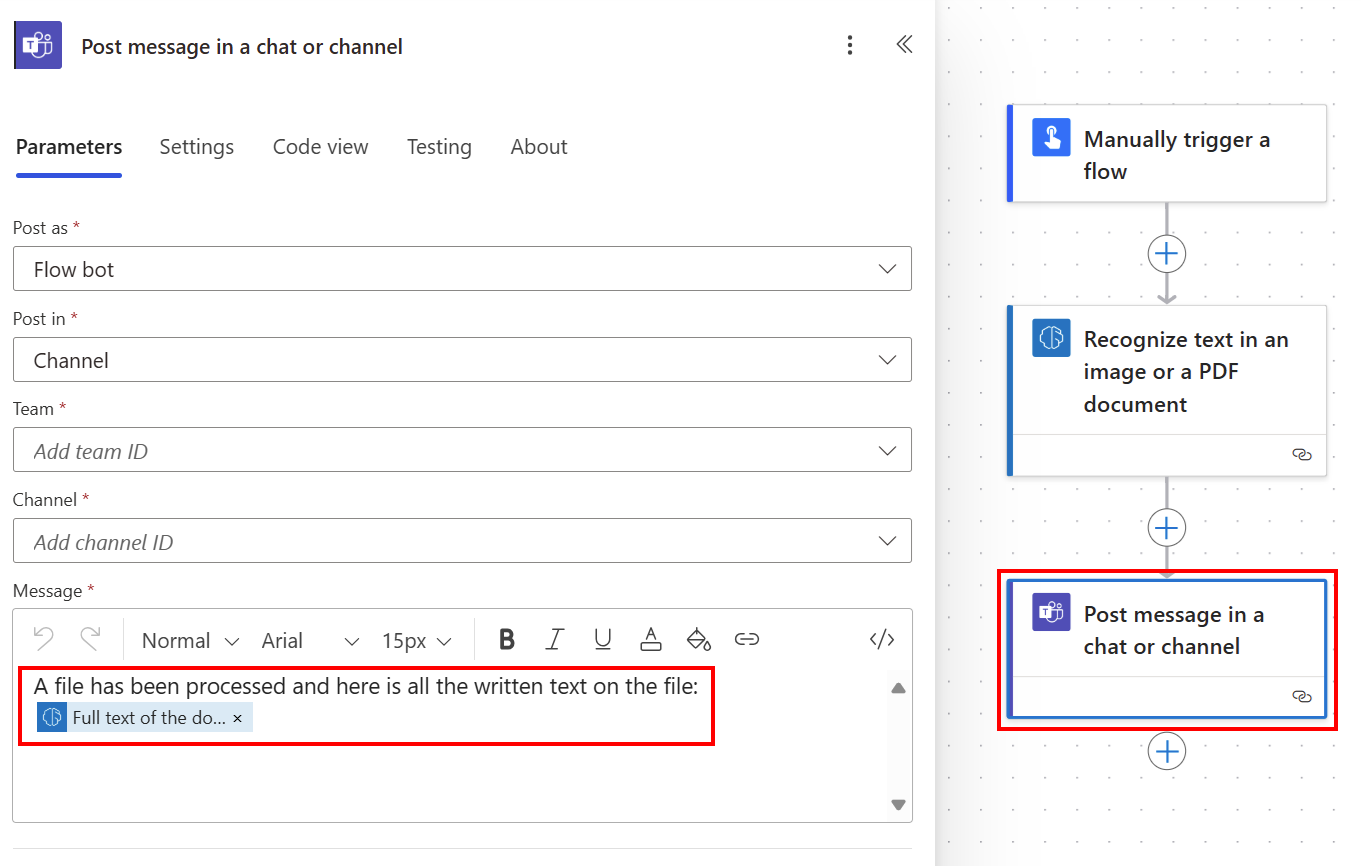
抽出されたすべてのテキストは、動的コンテンツ リストから ドキュメントのフル テキスト を使用して Teams チャネルに投稿できます。
ドキュメントのテキストを行ごとに取得します
ドキュメントのテキストを行ごとに取得すると、特定のテキスト行を分離したり、都合のよいときにテキストの書式を変更したりする必要がある場合に便利です。
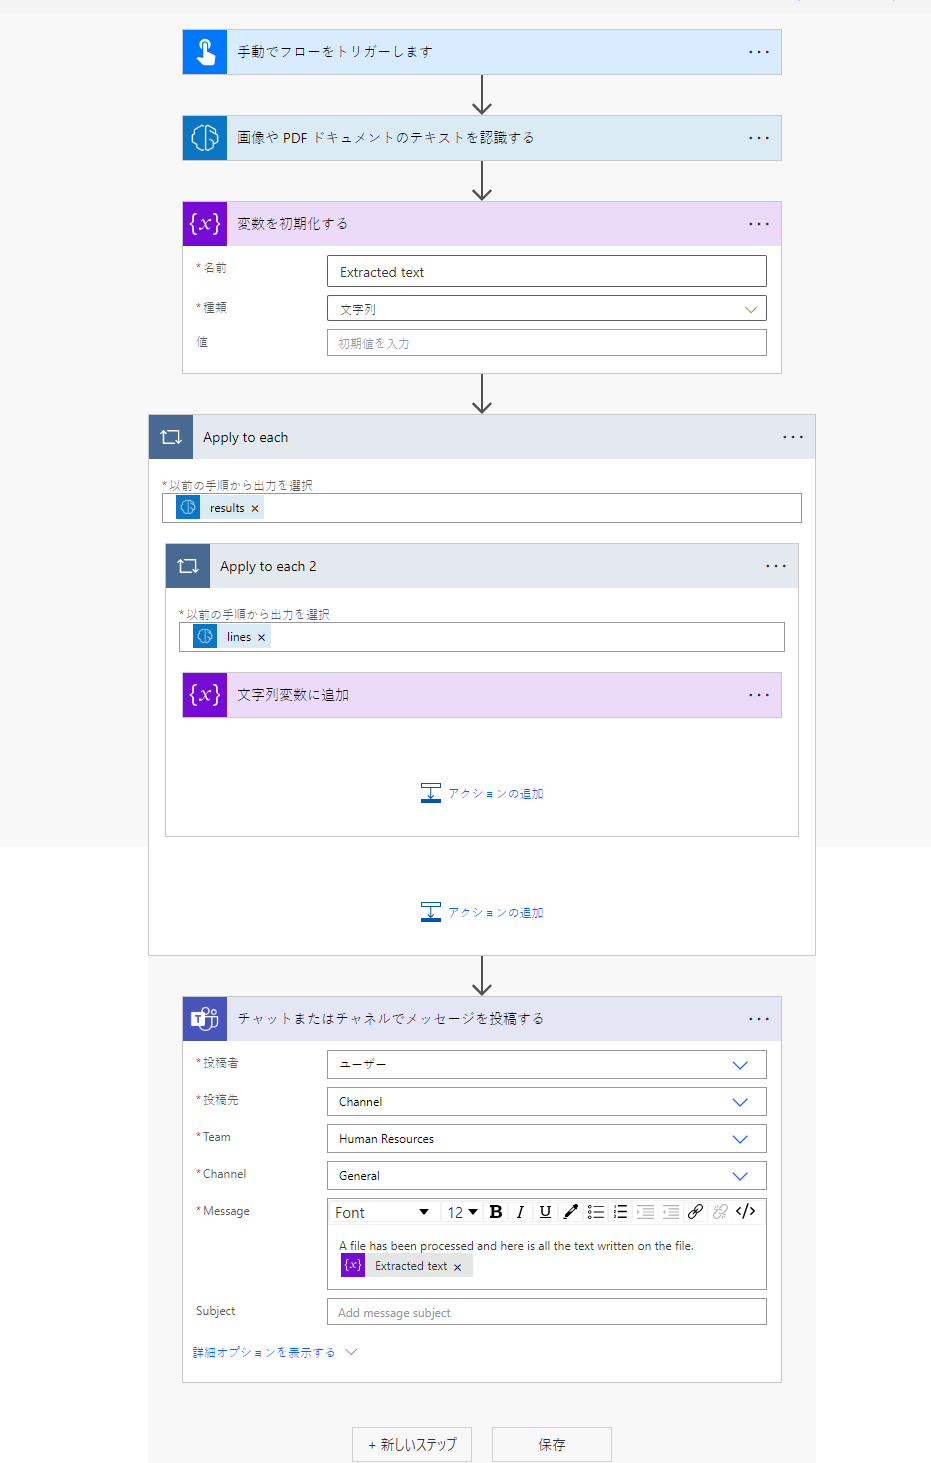
文字列の変数を作成するには、+新規ステップ>コントロール を選択して、変数の初期化 を選択します。
たとえば 抽出されたテキスト という名前を付けます。
+新規ステップ>コントロール を選択して、文字列変数の追加 を選択します。
値 フィールドの動的コンテンツから テキスト を選択します。
これは、ページのリスト内の行テキストのリストを読み取っているときに、2 つの それぞれに適用 アクションを自動生成します。 その後、抽出されたすべてのテキストを Teams チャネルに投稿できます。
ご報告: これで、テキスト認識モデルを使用するクラウド フローを作成できました。 お客様のニーズに合うまで、このクラウド フローを基にして構築を継続できます。 右上にある保存を選択し、テストを選択してクラウド フローを試します。
Parameters
AI Builder のテキスト認識事前構築済みモデルには次の入力パラメーターと出力パラメーターが含まれています。
input
| 件名 | Required | タイプ | プロパティ |
|---|---|---|---|
| イメージ | 可 | file | 分析する画像 |
出力
検出されたテキストは、結果リストの行サブ リストに埋め込まれます。 最初に それぞれに適用 アクションから 行 を選択する必要があり、次の列すべてを表示します。
| 件名 | 型 | 内容 |
|---|---|---|
| テキスト | 文字列 | 検出されたテキスト行を含む文字列 |
| ページ番号 | string | テキストのページ番号が検出されました |
| 座標 | 浮動小数 | 検出されたテキストの座標 |
| ドキュメントの全文 | string | 検出された全文 |
| ページの全文 | string | 全ページ テキストが検出されました |