このコンテンツは次に適用されます:🟩v4.0 (GA) | 以前のバージョン:🟦v3.1 (GA)🟥v3.0 (廃止)
カスタム分類モデルでは、入力ファイル内の各ページを分類して、1 つまたは複数のドキュメントを識別できます。 分類子モデルでは、入力ファイル内の 1 つのドキュメントの複数のドキュメントまたは複数のインスタンスを識別することもできます。 ドキュメント インテリジェンス カスタム モデルでは、作業を開始するためにドキュメント クラスごとに 5 つのトレーニング ドキュメントが必要です。 カスタム分類モデルのトレーニングを開始するには、クラスごとに少なくとも 5 つのドキュメント と 2 つのクラス のドキュメントが必要です。
カスタム分類モデルの入力要件
トレーニング データ セットがドキュメント インテリジェンスの入力要件に従っていることを確認します。
次のファイル形式がサポートされています。
| モデル | 画像: JPEG/JPG、PNG、BMP、TIFF、HEIF |
Office: Word (DOCX)、Excel (XLSX)、PowerPoint (PPTX)、HTML |
|
|---|---|---|---|
| 読む | ✔ | ✔ | ✔ |
| レイアウト | ✔ | ✔ | ✔ |
| 一般ドキュメント | ✔ | ✔ | |
| プリビルド | ✔ | ✔ | |
| カスタム抽出 | ✔ | ✔ | |
| カスタム分類 | ✔ | ✔ | ✔ |
- 写真とスキャン: 最良の結果を得るには、ドキュメントごとに 1 つの明確な写真または高品質のスキャンを提供します。
- PDF とTIFF: PDF とTIFF の場合、最大 2,000 ページを処理できます。 (Free レベルのサブスクリプションでは、最初の 2 ページのみが処理されます)。
- ファイル サイズ: ドキュメントを分析するためのファイル サイズは、有料 (S0) レベルでは 500 MB、Free (F0) レベルでは 4 MB です。
- 画像の寸法: 寸法は、50 ピクセル x 50 ピクセルから 10,000 ピクセル x 10,000 ピクセルの間である必要があります。
- パスワード ロック: PDF がパスワードロックされている場合は、提出前にロックを解除する必要があります。
- テキストの高さ: 抽出するテキストの最小高さは、1024 x 768 ピクセルの画像で 12 ピクセルです。 このディメンションは、1 インチあたり 150 ドットの約 8 ポイントのテキストに対応します。
- カスタム モデル トレーニング: トレーニング データの最大ページ数は、カスタム テンプレート モデルの場合は 500 ページ、カスタム ニューラル モデルの場合は 50,000 ページです。
- カスタム抽出モデルトレーニング: トレーニング データの合計サイズは、テンプレート モデルの場合は 50 MB、ニューラル モデルの場合は 1 GB です。
- カスタム分類モデル トレーニング: トレーニング データの合計サイズは 1 GB で、最大 10,000 ページです。 2024-11-30 (GA) の場合、トレーニング データの合計サイズは 2 GB で、最大 10,000 ページです。
- Office ファイルの種類 (DOCX、XLSX、PPTX): 文字列の最大長の制限は 800 万文字です。
トレーニング データのヒント
トレーニング用にデータセットをさらに最適化するには、次のヒントに従います。
可能であれば、画像ベースのドキュメントではなく、テキストベースの PDF ドキュメントを使用します。 スキャンされた PDF はイメージとして処理されます。
フォームイメージの品質が低い場合は、より大きなデータセット (10 から 15 個の画像など) を使用します。
トレーニング データをアップロードする
トレーニング用のフォームまたはドキュメントのセットをまとめたら、それをAzure BLOB ストレージ コンテナーにアップロードする必要があります。 コンテナーを使用してAzure storage アカウントを作成する方法がわからない場合は、Azure ポータルの Azure Storage クイックスタートに従ってください。 Free 価格レベル (F0) を使用してサービスを試し、後で運用環境用の有料レベルにアップグレードできます。 データセットがフォルダーとして整理されている場合は、Studio でラベルにフォルダー名を使用してラベル付けプロセスを簡略化できるため、その構造を維持します。
Document Intelligence Studio で分類プロジェクトを作成する
Document Intelligence Studio は、データセットを完成させ、モデルをトレーニングするために必要な API 呼び出しを提供し、調整します。
まず、 ドキュメント インテリジェンス スタジオに移動します。 Studio を初めて使用するときは、 サブスクリプション、リソース グループ、およびリソースを初期化する必要があります。 次に、 カスタム プロジェクトの前提条件 に従って、トレーニング データセットにアクセスするように Studio を構成します。
Studio で、ページのカスタム モデル セクションで [ カスタム分類モデル ] タイルを選択し、[ プロジェクトの作成 ] ボタンを選択します。
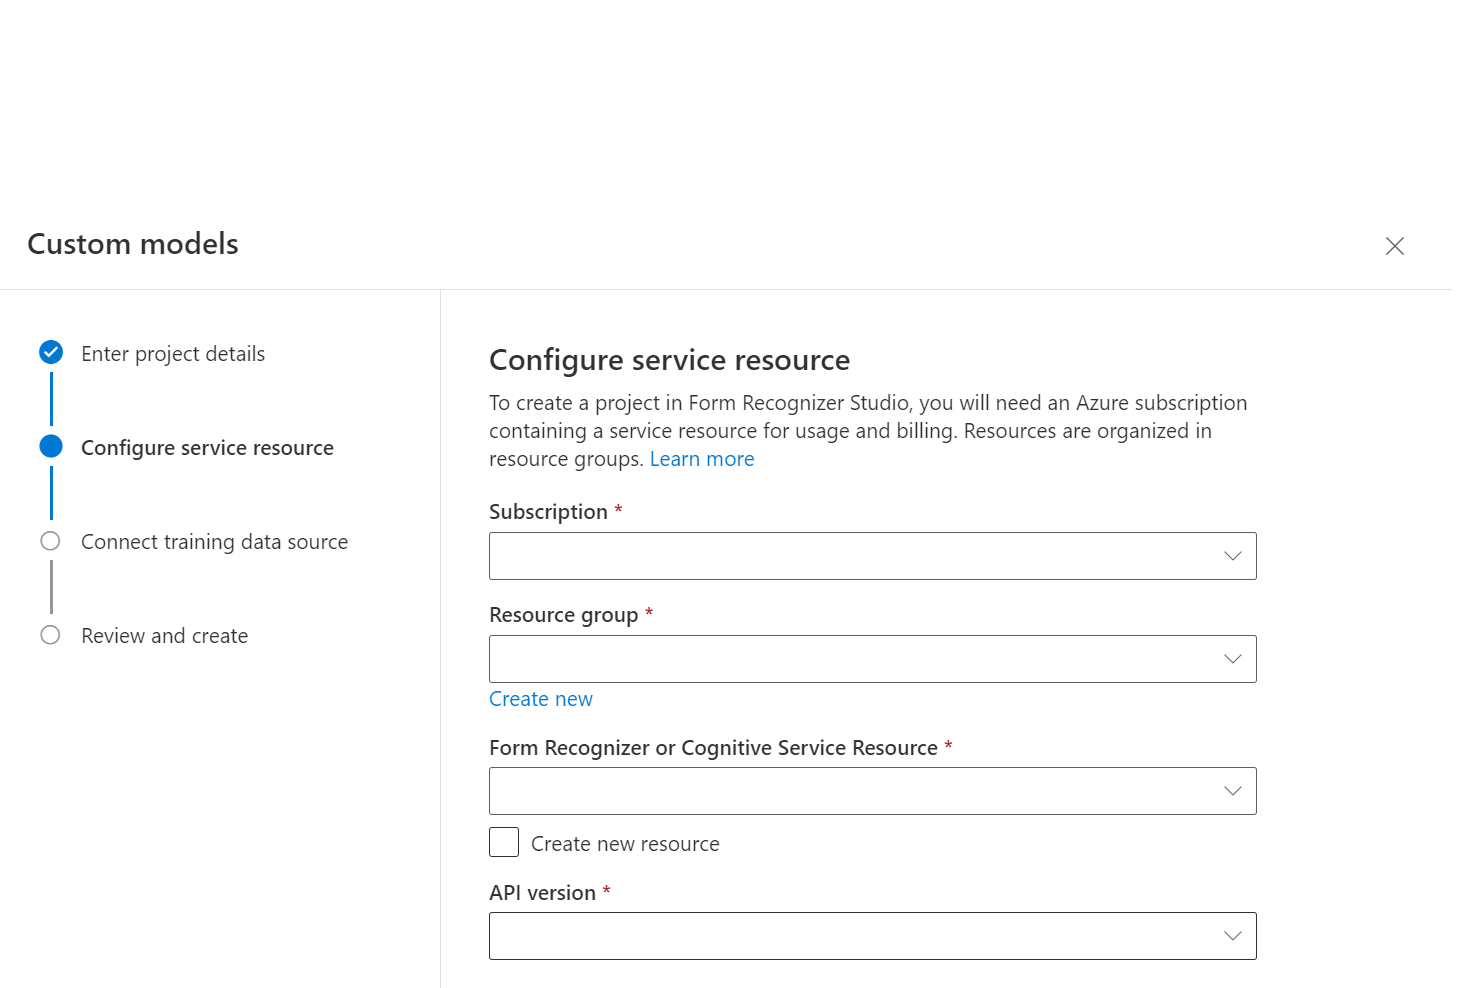
Create Projectダイアログで、projectの名前、必要に応じて説明を入力し、[続行] を選択します。次に、続行する前に、ドキュメント インテリジェンス リソースの作成を選択するか選択します。
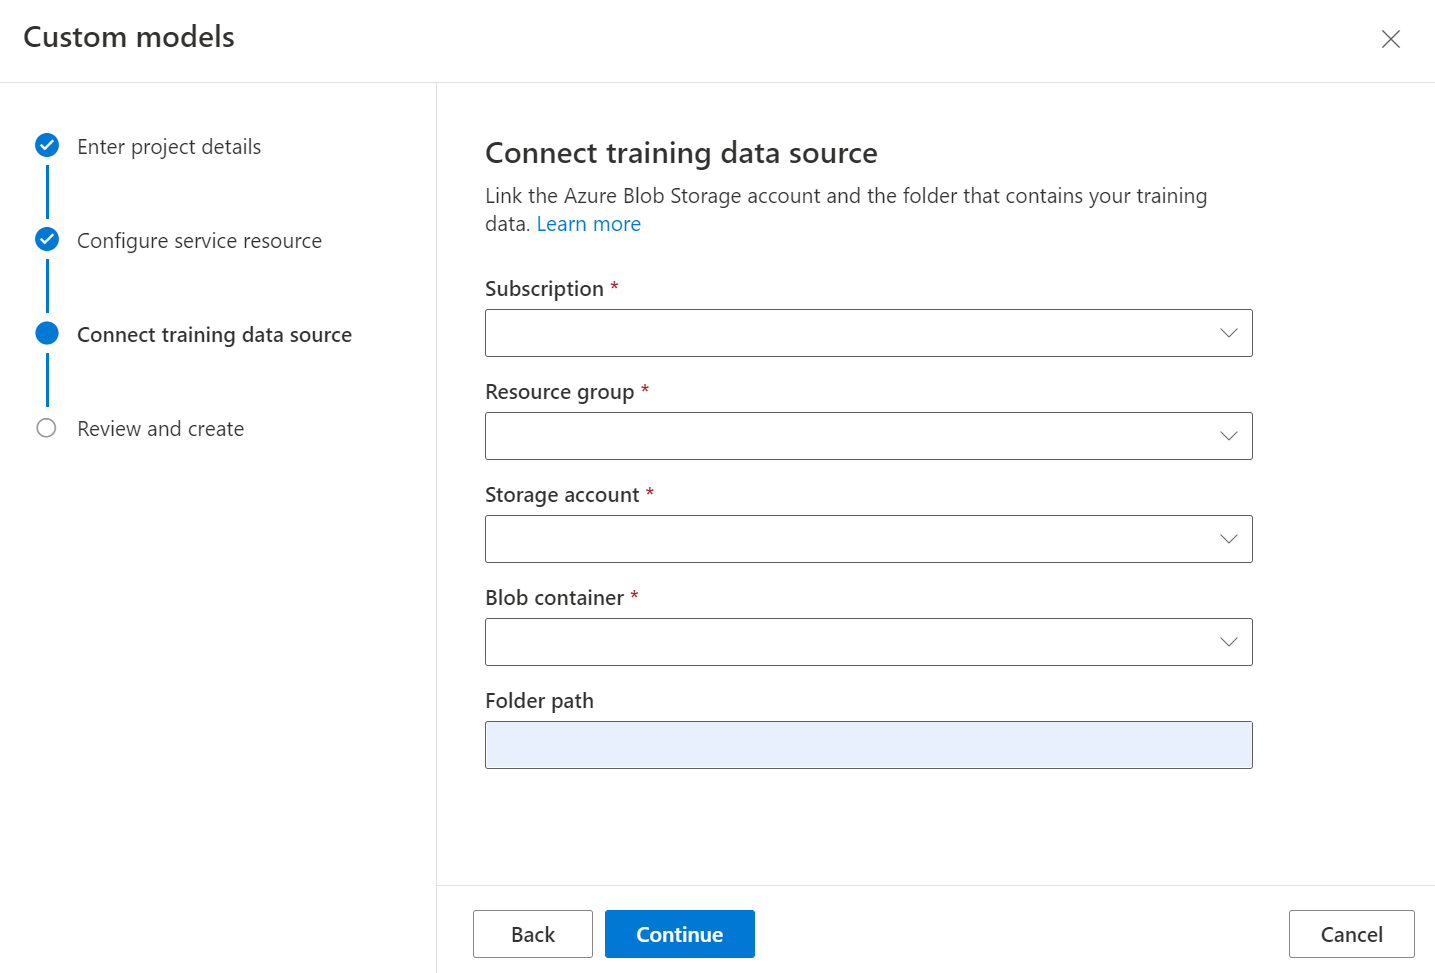
次に、カスタム モデル トレーニング データセットのアップロードに使用したストレージ アカウントを選択します。 トレーニング ドキュメントがコンテナーのルートにある場合は、 フォルダー パス を空にする必要があります。 ドキュメントがサブフォルダーにある場合は、[フォルダー パス] フィールドにコンテナー ルートからの相対 パス を入力します。 ストレージ アカウントが構成されたら、[続行] を選択します。
重要
トレーニング データセットは、フォルダー名がドキュメントのラベルまたはクラスであるフォルダーごとに整理できます。 または、Studio でラベルを割り当てることができるドキュメントのフラット リストを作成することもできます。
カスタム分類子をトレーニングするには、データセット内の各ドキュメントのレイアウト モデルからの出力が必要です。 モデルトレーニングプロセスの前にすべてのドキュメントでレイアウトを実行します。
最後に、projectの設定を確認し、
[Project を選択して新しいprojectを作成します。 これで、ラベル付けウィンドウに表示され、データセット内のファイルが一覧表示されます。
データにラベルを付ける
プロジェクトでは、各ドキュメントに適切なクラス ラベルを付けるだけで済みます。
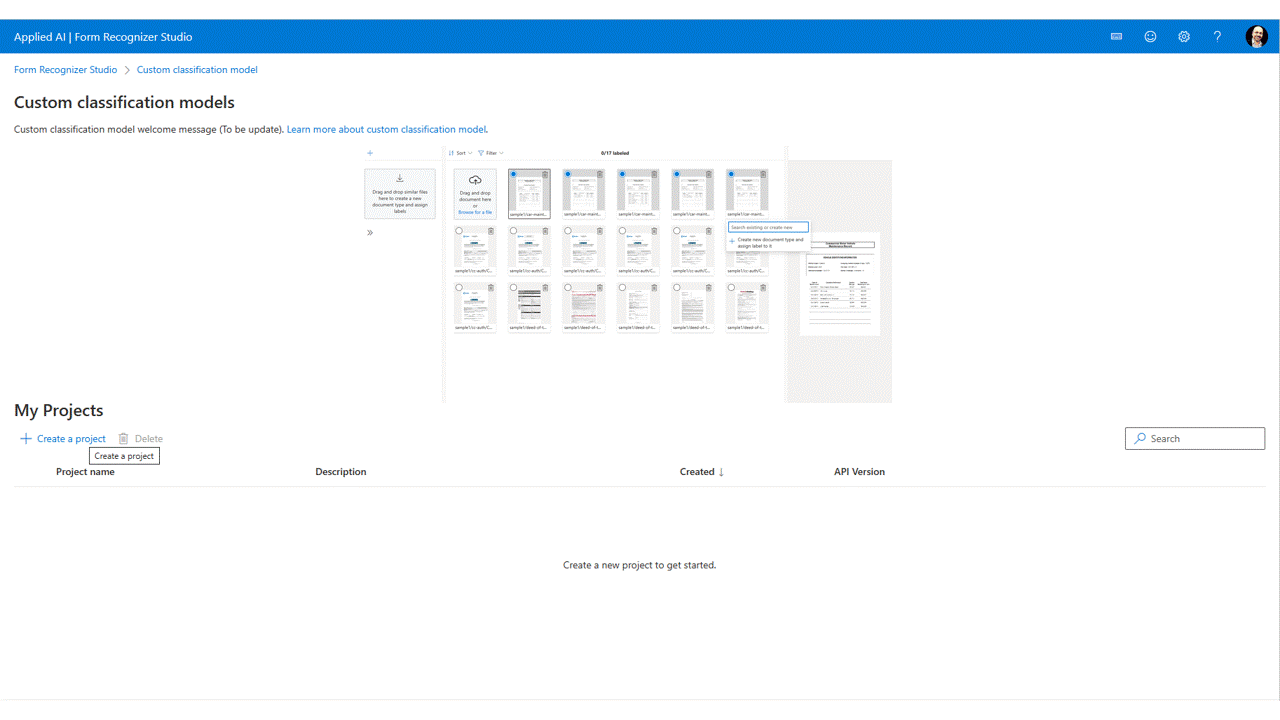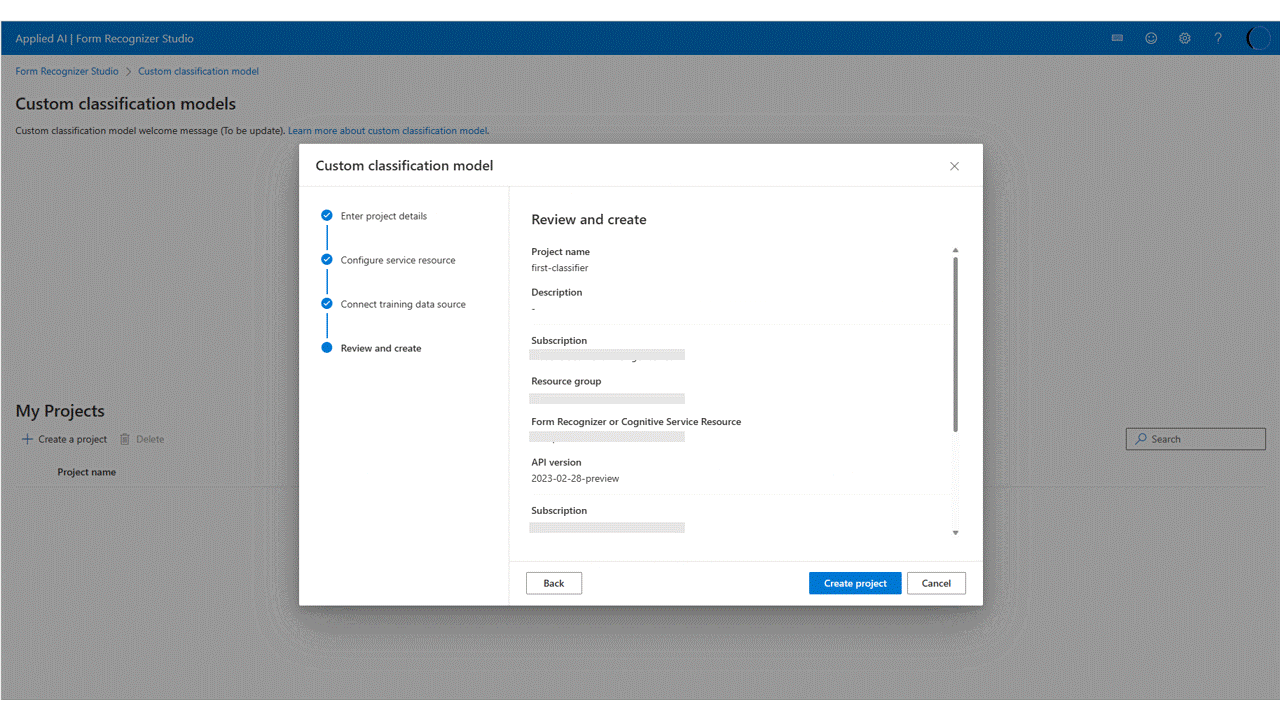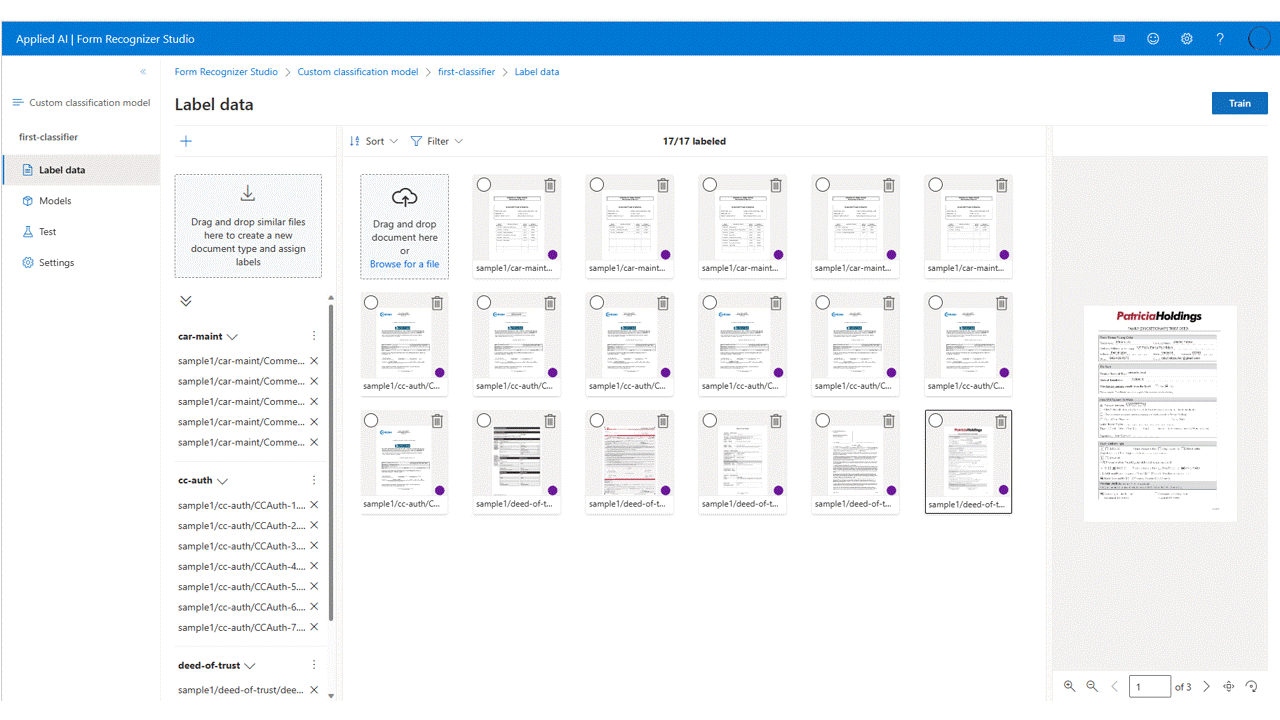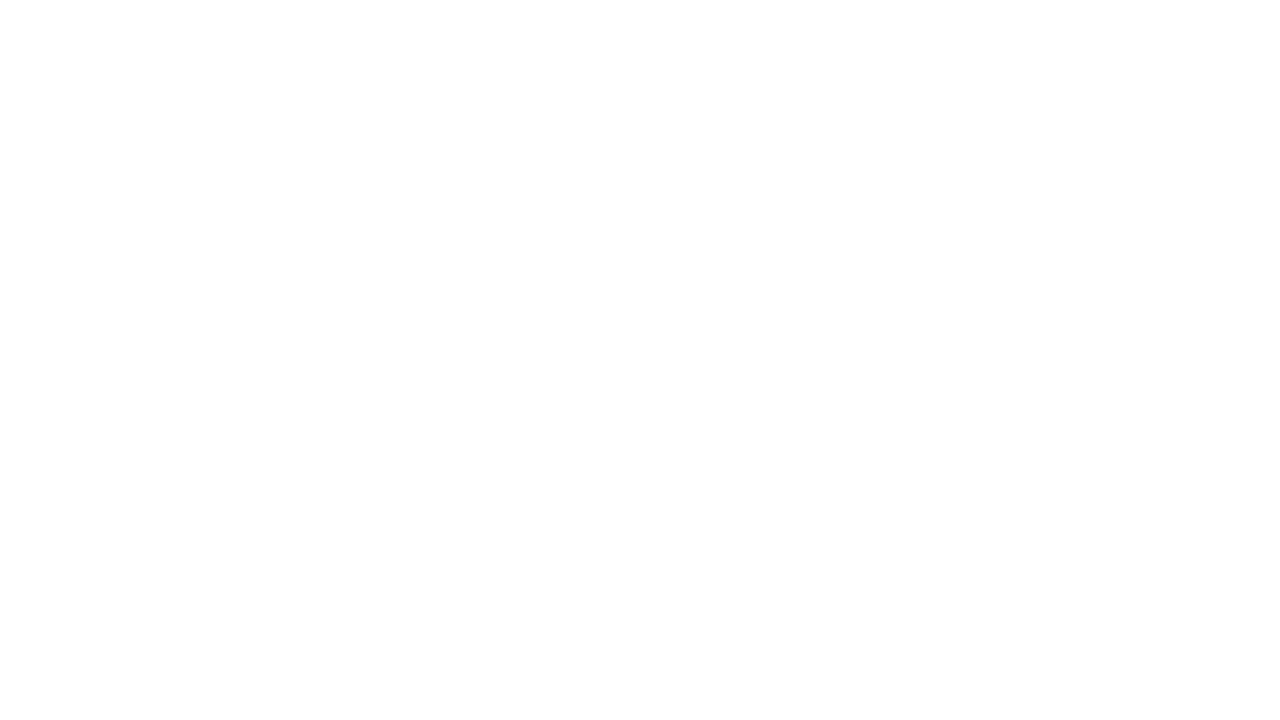
ストレージにアップロードしたファイルがファイル一覧に表示され、ラベルが付けられます。 データセットにラベルを付けるオプションがいくつかあります。
ドキュメントがフォルダーに整理されている場合、フォルダー名をラベルとして使用するように求められます。 この手順により、ラベル付けが 1 回の選択に簡素化されます。
ドキュメントにラベルを割り当てるには、ラベルを割り当てる
add label selection markを選択します。コントロール選択を使用して、ラベルに割り当てるドキュメントを複数選択します。
これで、データセット内のすべてのドキュメントにラベルが付けられます。 ストレージ アカウントを見ると、トレーニング データセット内の各ドキュメントに対応する .ocr.json ファイルと、ラベルが付いた各クラスの新しい class-name.jsonl ファイルが見つかります。 このトレーニング データセットは、モデルをトレーニングするために送信されます。
モデルをトレーニングする
データセットにラベルが付いているので、モデルをトレーニングする準備ができました。 右上隅にある [トレイン] ボタンを選択します。
トレインモデル ダイアログで、一意の分類子 ID とオプションで説明を指定します。 分類子 ID は文字列データ型を受け入れます。
[ トレーニング ] を選択してトレーニング プロセスを開始します。
分類子モデルは数分でトレーニングされます。
[モデル] メニューに移動して、トレーニング操作の状態を表示します。
モデルをテストする
モデルのトレーニングが完了したら、モデルの一覧ページでモデルを選択してモデルをテストできます。
モデルを選択し、[ テスト ] ボタンを選択します。
ファイルを参照するか、ドキュメント セレクターにファイルをドロップして、新しいファイルを追加します。
ファイルを選択した状態で、[ 分析 ] ボタンを選択してモデルをテストします。
モデルの結果は、識別されたドキュメントの一覧、識別された各ドキュメントの信頼度スコア、および特定された各ドキュメントのページ範囲と共に表示されます。
特定された各ドキュメントの結果を評価して、モデルを検証します。
SDK または API を使用してカスタム分類子をトレーニングする
Studio は、カスタム分類子をトレーニングするために API 呼び出しを調整します。 分類子トレーニング データセットには、トレーニング モデルの API のバージョンと一致するレイアウト API からの出力が必要です。 古い API バージョンのレイアウト結果を使用すると、モデルの精度が低下する可能性があります。
データセットにレイアウト結果が含まれていない場合、Studio によってトレーニング データセットのレイアウト結果が生成されます。 API または SDK を使用して分類子をトレーニングする場合は、個々のドキュメントを含むフォルダーにレイアウト結果を追加する必要があります。 レイアウトの結果は、レイアウトを直接呼び出すときに API 応答の形式にする必要があります。 SDK オブジェクト モデルは異なります。
layout resultsが API の結果であり、SDK responseではないことを確認します。
トラブルシューティング
分類モデルには、各トレーニング ドキュメントのレイアウト モデルの結果が必要です。 レイアウト結果を指定しない場合、Studio は分類子をトレーニングする前に、各ドキュメントのレイアウト モデルの実行を試みます。 このプロセスは制限されており、結果として429応答が返される可能性があります。
Studio では、分類モデルを使用してトレーニングする前に、各ドキュメントで レイアウト モデル を実行し、元のドキュメントと同じ場所にアップロードします。 レイアウト結果が追加されたら、ドキュメントを使用して分類子モデルをトレーニングできます。