ベクター検索は、ベクトルの形でデータベースに格納されている情報を検索する方法です。 ベクトルは、テキストや画像などのメディアの機能や特性を表す数値のグループです。 情報内のセマンティック リレーションシップをキャプチャするため、正確なキーワード マッチングを超えた類似性検索が可能になります。
Azure には、ベクター化されたデータを格納および検索するための複数の方法が用意されています。 この記事は、アプリケーションに適したベクター検索サービスAzure選択するのに役立ちます。
この記事では、ベクトル検索機能に基づいて次のサービスを比較します。
- Azure AI 検索
- Azure Cosmos DB (NoSQL)
- Azure DocumentDB
- Azure Database for PostgreSQL
- Azure Managed Redis
- Azure SQL データベース
各サービスのシステム要件を比較するには、「候補となるサービスと機能のマトリックスを選択する」を参照してください。
サービス候補を選択する
このセクションでは、ニーズに最適なサービスを選択するのに役立ちます。 選択肢を絞り込むには、まずシステム要件を検討します。
主な要件
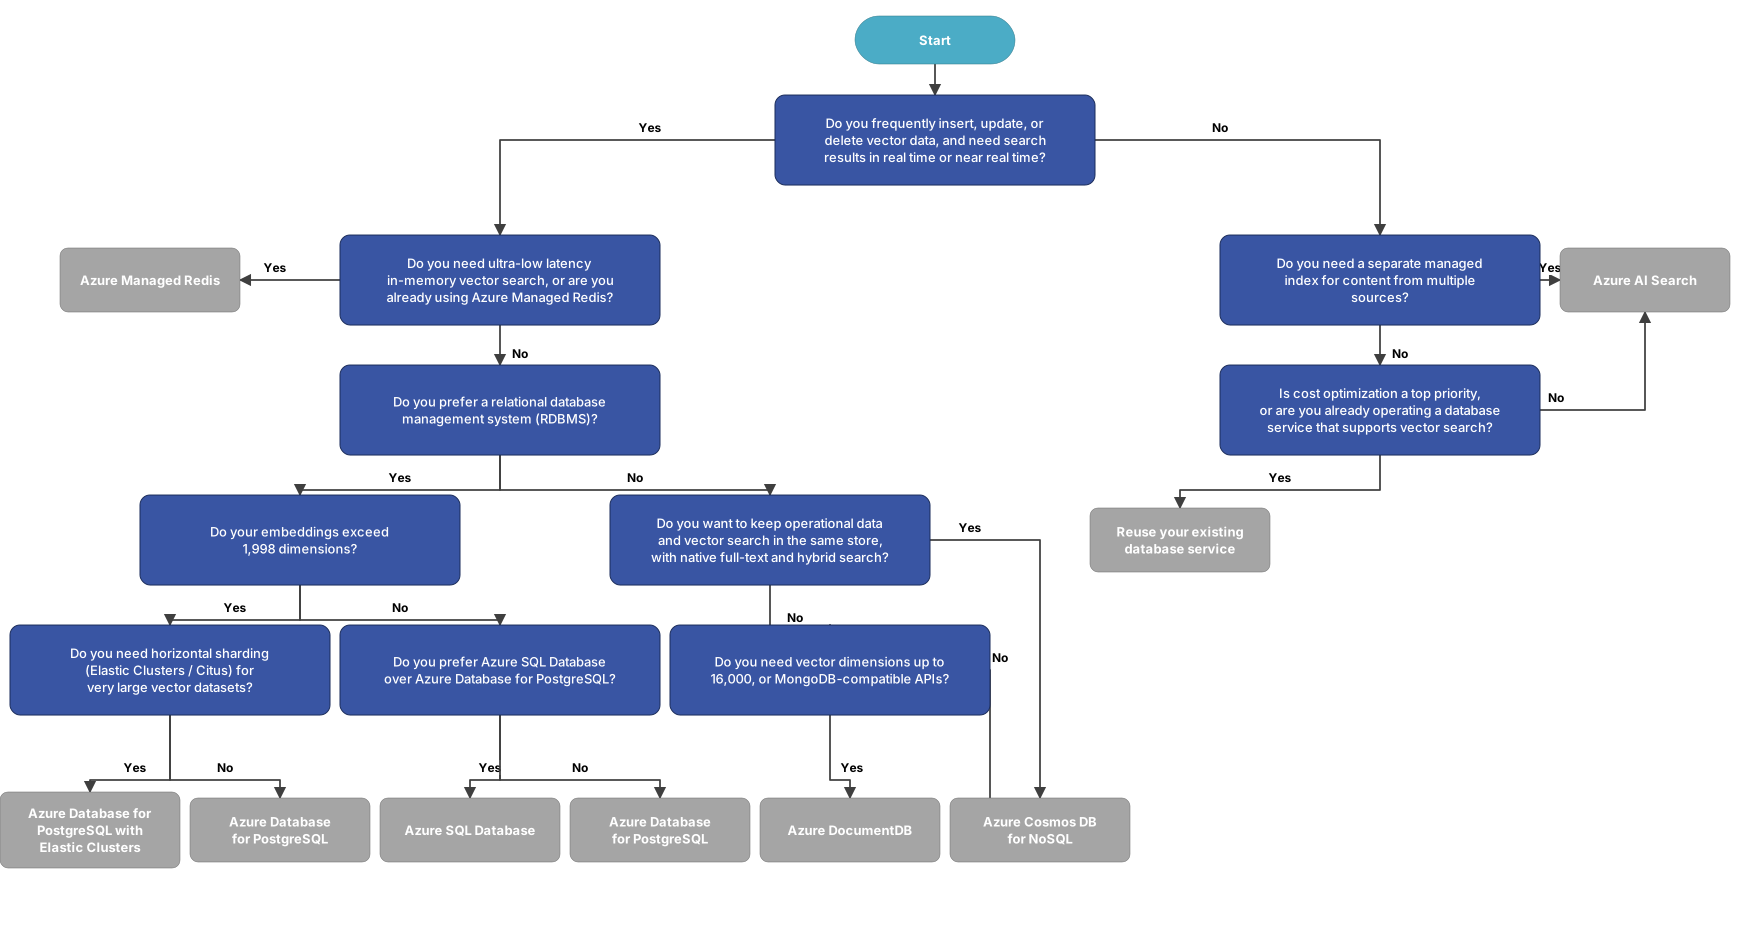
従来のデータベース ソリューションと AI Search のどちらを使用するかを決定するには、要件と、データに対してライブまたはリアルタイムのベクター検索を実行できるかどうかを検討します。 ベクター化されたフィールドの値を頻繁に変更し、それらの変更をリアルタイムまたはほぼリアルタイムで検索できる必要がある場合は、従来のリレーショナル データベースまたはNoSQL データベースがシナリオに最適です。 同様に、既存のデータベースがパフォーマンス 目標を満たす最適な方法である可能性があります。 ただし、ワークロードでリアルタイムまたはほぼリアルタイムのベクター検索が不要で、ベクターのインデックスを管理できる場合は、AI Search を使用できます。
従来のデータベース ソリューションを選択する場合は、チームのスキル セットと既存のデータベースに基づいてデータベース サービスを選択します。 NoSQLのAzure Cosmos DBなど、データベース サービスを既に使用している場合は、そのサービスがシナリオに最も簡単なソリューションである可能性があります。
NoSQLのAzure Cosmos DBは、運用データとベクター検索を同じシステムに保持し、フルテキスト スコアリング、ハイブリッド検索、または組み込みの再ランク付けが必要な場合に適しています。 セマンティック リランカーはプレビュー段階です。 アプリケーションがレコードとその埋め込みを一緒に書き込むときに、更新されたアイテムに対してクエリを実行する前に、別の検索インデックスを同期する必要はありません。
AI Search は、ファセットやオートコンプリートなどの統合されたベクター化と検索固有の機能を備えた、複数のソースのコンテンツに対して個別のマネージド インデックスが必要な場合に適しています。
Azure Database for PostgreSQLでは、エラスティック クラスターを使用した水平スケーリングがサポートされます。これは、水平シャーディングをサポートするオープンソース Citus 拡張機能のマネージド オファリングです。 この機能は、ベクター データを複数のノードに分散します。これは、大規模なベクター データセットに役立ちます。
超低待機時間、メモリ内ベクター検索が必要な場合、またはキャッシュまたはセッション管理のために Redis が既にデプロイされている場合は、managed Redis Azure検討してください。
各データベース サービスには、ベクター検索 に固有の機能と制限があります 。 データベースの種類に必要な機能があることを確認します。
新しいサービスと追加のデータベース インスタンスにより、コストと複雑さが増す可能性があります。 オーバーヘッドを減らすために、既存の設計を引き続き使用できます。 現在のデータベースでのベクター検索は、専用のベクター検索サービスよりもコスト効率が高い場合があります。
高度な取得機能のサポートは、サービスによって異なります。 NoSQLとAzure DocumentDB のAzure Cosmos DBは、逆ランク 融合 (RRF) を使用してフルテキスト検索とベクター検索を組み合わせたネイティブ ハイブリッド検索を提供します。 NoSQLのAzure Cosmos DBでは、プレビューでセマンティック リランカーも提供されます。 AI Search では、マネージド検索機能としてハイブリッド検索とセマンティック ランク付けが提供されます。 これらの機能を提供しないサービスの場合は、アプリケーションまたはデータベース コードに必要なランク付けロジックを実装します。
機能マトリックス
このセクションの表は、ベクトル検索サービスの機能Azureまとめたものです。 使用可能なサービスと要件を比較します。 一部のサービスは特定のシナリオに適しているため、各表に示されているトレードオフを考慮してください。
Microsoft Fabricで作業している場合は、イベントハウスをベクター データベースとして使用することで、ベクター類似性検索 (VSS) に Real-Time インテリジェンスを使用できます。 詳細については、Fabricドキュメントを参照してください。
基本機能
ベクター データ型、近似最近傍 (ANN) ベクター インデックス、ベクター ディメンションの制限、複数のベクター フィールド、および複数のベクター インデックスのネイティブ サポートは、サービスによって異なります。 ワークロードには、これらの機能の 1 つ以上が必要な場合があります。
次の表に、各Azure サービスのベクター機能を示します。
| 能力 | Azure Cosmos DB for NoSQL | Azure DocumentDB | Azure Database for PostgreSQL | Azure マネージド再配布 | AI検索 | SQL Database |
|---|---|---|---|---|---|---|
| 組み込みのベクトル検索 | はい | 可1 | 可2 | はい3 | はい4 | はい |
| ベクトル データ型 | はい | はい | はい | はい | はい | はい5 |
| ディメンションの制限6 | 4,0967、またはフラット インデックス付き 505 | 構成に応じて 16,0008、4,000、または 2,000 | 16,0009 または 2,000 | 32,768 | 4,09610 | 1,998 11 |
| 複数のベクトル フィールド | はい | はい12 | はい | はい | はい | はい |
| 複数のベクトル インデックス | はい | はい13 | はい | はい | はい | はい |
- Azure DocumentDB では、埋め込みでのベクター検索がサポートされています。
-
pgvectorPostgreSQL の拡張機能であり、ベクター検索をサポートします。pg_diskann拡張機能は、大規模な効率的な ANN 検索のための DiskANN ベースのベクター インデックス作成を提供します。 - Azure Managed Redis の RediSearch モジュールは、ベクター検索を提供します。
- AI Search ではベクターがサポートされています。
- SQL Database では、ベクター データ型がサポートされています。
- OpenAI 埋め込みモデルには、text-embedding-ada-002 および text-embedding-3-small 用の 1,536 次元と、text-embedding-3-large 用の 3,072 ディメンションが含まれます。 Azure Vision マルチモーダル埋め込みモデルには、画像とテキストの両方に 1,024 個のディメンションがあります。
- フラット インデックス型を使用してインデックスを作成するベクターは、最大 505 次元を持つことができます。 量子化されたFlat または DiskANN インデックスの種類を使用してインデックスを作成するベクターは、最大 4,096 次元を持つことができます。
- DiskANN と製品量子化を使用して、最大 16,000 次元のベクトルにインデックスを付けることができます。 半精度の階層ナビゲーション可能な小さな世界 (HNSW) または IVFFlat は、最大 4,000 次元のベクター インデックスをサポートします。 圧縮を使用しない場合、インデックス作成の既定の最大ベクトル次元は 2,000 です。 詳細については、Azure DocumentDB のベクター次元を参照してください。
- ベクターには、最大 16,000 個のディメンションを含めることができます。 ただし、IVFFlat および HNSW アルゴリズムを使用したインデックス作成では、最大 2,000 次元のベクトルがサポートされます。
- AI Search では、Matryoshka Representation Learning ベースの ディメンションの切り捨てがサポートされています。 テキスト埋め込み 3 モデルでは、ベクターディメンションを減らすことができます。 たとえば、256 次元または 512 ディメンションを使用できます。
- SQL Database では、最大 1,998 次元のネイティブ ベクター データ型がサポートされています。
- 各Azure DocumentDB ベクター インデックスは、1 つのベクター パスを対象とします。 クエリを実行する必要があるベクター フィールドごとに個別のベクター インデックスを作成します。
- Azure DocumentDB コレクションには複数のインデックスを作成できますが、特定のベクター パスをターゲットにできるのは 1 つのベクター インデックスだけです。
検索方法
ワークロードでは、多くの場合、ベクター検索とフルテキスト検索またはハイブリッド検索を組み合わせる必要があります。 ハイブリッド検索は、フルテキスト検索またはセマンティック検索とベクター検索を組み合わせたものです。 ハイブリッド検索と再ランク付けを組み合わせると、ワークロードの精度が高くなります。 独自のコードを使用して、ハイブリッド検索と再ランク付けを手動で実装することも、ベクター ストアがこのワークロード要件をどのようにサポートしているかを検討することもできます。
| 検索メソッド | Azure Cosmos DB for NoSQL | Azure DocumentDB | Azure Database for PostgreSQL | Azure マネージド再配布 | AI検索 | SQL Database |
|---|---|---|---|---|---|---|
| フルテキスト検索 | はい12 | 可2 | はい3 | はい4 | はい | はい5 |
| ハイブリッド検索 | はい6 | はい7 | はい8 | はい9 | はい10 | はい11 |
| 組み込みの再ランク付け | はい (プレビュー)13 | いいえ | いいえ | いいえ | 可1 | いいえ |
- セマンティック ランク付けでは、フルテキスト検索とベクター検索の結果が再ランク付けされます。
- Azure DocumentDB では、テキスト インデックスを使用した検索とクエリがサポートされています。
- PostgreSQL では、フルテキスト検索がサポートされています。
- Azure Managed Redis では、テキスト トークン化、ステミング、ランク付けなど、RediSearch モジュールを使用したフルテキスト検索がサポートされています。
- SQL Serverでは、フルテキスト検索がサポートされます。
- NoSQLのAzure Cosmos DBでは、RRF を使用した BM25 フルテキスト スコアリングとベクター検索を組み合わせたハイブリッド検索がサポートされます。 コンポーネントのランク付けに重みを割り当てることができます。
- Azure DocumentDB では、フルテキスト検索とベクター検索と逆ランク 融合を組み合わせたハイブリッド検索がネイティブにサポートされます。
- ハイブリッド検索は組み込まれませんが、サンプル コードを使用できます。
- Azure Managed Redis では、VSS とテキスト、数値、タグ、および geo フィールドの属性フィルターを組み合わせて使用したハイブリッド検索がサポートされます。
- フルテキスト検索、ベクター検索、セマンティックランク付けを組み合わせたハイブリッド検索は、AI Search の機能です。
- SQL Database とSQL Serverのハイブリッド検索の例を使用できます。
- NoSQLのAzure Cosmos DBでは、フルテキスト検索とフルテキスト スコアリングがサポートされます。
- NoSQLのAzure Cosmos DBのセマンティック リランカーはプレビュー段階です。 サポートされているAzure Cosmos DB SDK を使用して、ベクター、フルテキスト、またはハイブリッド クエリの結果を再ランク付けできます。
ベクトル データ インデックス作成アルゴリズム
ベクトル データのインデックス作成は、ベクトルを効率的に格納および取得する機能です。 インデックス作成は、データ ソースに対する類似性検索と最近隣クエリの速度と精度に影響します。
インデックスでは通常、完全な k ニアレスト ネイバー (Ek-NN) アルゴリズムまたは ANN アルゴリズムが使用されます。 Ek-NN は、すべてのデータ ポイントに対して完全な検索を実行し、正確な k の最も近い近傍を返します。 少量のデータを検索する場合、Ek-NN はミリ秒単位で動作します。 データセットが大きい場合は、待機時間が発生する可能性があります。
DiskANN、 HNSW、 および IVFFlat は ANN アルゴリズム インデックスです。 適切なインデックス作成戦略を選択するには、データセットの性質、クエリの特定の要件、使用可能なリソースなど、さまざまな要因を慎重に考慮する必要があります。 DiskANN は、データセットの変更に適応し、計算リソースを節約できます。 HNSW は、高速なクエリ応答を必要とし、データセットの変更に適応できるシステムに優れています。 IVFFlat は、ハードウェア リソースが制限されている環境やクエリ ボリュームが多くない環境で有効です。
次の表に、使用可能なベクター データインデックスの種類を示します。
| インデックス作成のアプローチ | Azure Cosmos DB for NoSQL | Azure DocumentDB | Azure Database for PostgreSQL | Azure マネージド再配布 | AI検索 | SQL Database |
|---|---|---|---|---|---|---|
| DiskANN | はい | 可1 | 可2 | いいえ | いいえ | はい3 |
| Ek-NN | はい | はい | はい | はい4 | はい | はい |
| HNSW | いいえ | 可1 | はい | はい5 | はい | いいえ |
| IVFFlat | いいえ | はい | はい | いいえ | いいえ | いいえ |
| その他 | Flat、quantizedFlat6 | パスごとに 1 つのベクター フィールドとインデックス78 | - | - | スカラー量子化、二項量子化9 | - |
- 詳細については、「Azure DocumentDB の統合ベクター ストア」を参照してください。
詳細については、「 DiskANN for Azure Database for PostgreSQL .- ネイティブ DiskANN ベクター インデックス作成はプレビュー段階です。 詳細については、SQL データベース エンジンのベクター検索とベクター インデックスを参照してください。
- Azure Managed Redis では、ブルート フォース検索に FLAT インデックスの種類を使用した Ek-NN 検索がサポートされています。
- Azure Managed Redis では、ANN 検索用の HNSW がサポートされます。 詳細については、 VSS を参照してください。
- 詳細については、「 ベクター インデックス作成ポリシー」を参照してください。
- インデックス作成は、パスごとに 1 つのベクターにのみ適用されます。
- ベクター パスごとに作成できるインデックスは 1 つだけです。
- AI Search では、 スカラー量子化とバイナリ量子化 がサポートされ、検索インデックスのベクター サイズが小さくなります。
類似性と距離の計算機能
ベクター検索では、 コサインの類似性、 ドット積、 ユークリッド距離 の計算方法がサポートされています。 これらのメソッドを使用して、2 つのベクトル間の類似性または距離を計算します。
予備データ分析では、メトリックとユークリッド距離を使用して、さまざまなデータ構造の分析情報を抽出できます。 一般に、テキスト分類はユークリッド距離の下でより優れたパフォーマンスを発揮します。 特定のテキストに最も類似したテキストの検索は、通常、コサイン類似度を使用するとより適切に機能します。
Azure OpenAI 埋め込みでは、ドキュメントとクエリの間の計算の類似性にコサインの類似性が依存します。
| 組み込みのベクトル比較計算 | Azure Cosmos DB for NoSQL | Azure DocumentDB | Azure Database for PostgreSQL | Azure マネージド再配布 | AI検索 | SQL Database |
|---|---|---|---|---|---|---|
| コサイン類似度 | 可1 | はい | はい | 可2 | はい | はい3 |
| ユークリッド距離 | 可1 | はい | はい | 可2 | はい | はい3 |
| ドット積 | 可1 | はい | はい | 可2 | はい | はい3 |
- 詳細については、NoSQLのAzure Cosmos DBのベクトル距離計算を参照してください。
- Azure Managed Redis では、コサインの類似性、ユークリッド距離、および内部積距離メトリックがサポートされています。 詳細については、 VSS を参照してください。
- 詳細については、SQL Database と SQL Server の距離計算の例を参照してください。
Azure OpenAI とその他のコンポーネントとの統合
ベクター検索を他のMicrosoftコンポーネントにリンクできます。 たとえば、OpenAI Azureは、VSS のデータおよび入力クエリのベクターを作成するのに役立ちます。
| 能力 | Azure Cosmos DB for NoSQL | Azure DocumentDB | Azure Database for PostgreSQL | Azure マネージド再配布 | AI検索 | SQL Database |
|---|---|---|---|---|---|---|
| Foundry IQ の統合 | いいえ | いいえ | いいえ | いいえ | はい | いいえ |
| Foundry Agent Service の統合 | 可1 | いいえ | 可2 | 可2 | はい3 | 可2 |
| 統合Azure OpenAI 埋め込み生成 | いいえ | いいえ | はい4 | いいえ | はい5 | はい6 |
| セマンティック カーネルの統合 | はい7 | はい8 | はい9 | はい10 | はい11 | はい12 |
- Foundry Agent Service の統合は、エージェント状態ストレージを通じて提供されます。
- Foundry Agent Service の統合は、データ、ベクター検索、またはツール アクセスを通じて提供されます。
- Foundry Agent Service の統合は、ナレッジの取得とベクター検索を通じて提供されます。
- Azure AI 拡張機能を使用できます。
- AI Search には、テキスト チャンクをベクター化するスキルが含まれています。
- 埋め込みモデル デプロイ用のストアド プロシージャを作成できます。
- このサービスは、メモリ コネクタとベクター データベース コネクタとしてサポートされています。 詳細については、C# のドキュメントとPythonドキュメントを参照してください。
- このサービスは、ベクター データベース コネクタとしてサポートされています。 詳細については、C# のドキュメントとPythonドキュメントを参照してください。
- このサービスは、メモリ コネクタとベクター データベース コネクタとしてサポートされています。 詳細については、 C# のドキュメントを参照してください。
- このサービスは、ベクター データベース コネクタとしてサポートされています。 詳細については、「 Redis コネクタの使用」を参照してください。
- このサービスは、メモリ コネクタとベクター データベース コネクタとしてサポートされています。 詳細については、C# のドキュメントとPythonドキュメントを参照してください。
- このサービスはメモリ コネクタとしてサポートされています。
運用上の考慮事項
機能マトリックスは、機能要件を満たすサービスを識別します。 複数のサービスが適格な場合は、各オプションがデータの配置、鮮度、フィルター処理、容量、埋め込みメンテナンスにどのように影響するかを比較します。
データの配置と鮮度
NoSQL、Azure DocumentDB、Azure Database for PostgreSQL、およびAzure SQL DatabaseのAzure Cosmos DBは、ワークロードの運用レコードを含む埋め込みを格納できます。 アプリケーションが埋め込みを生成し、レコードを使用して書き込む場合、両方の値がデータベースの書き込みパスを介して更新されます。 この設計により、個別の検索インデックス同期プロセスが回避されます。
AI Search では、ソース システムとは別の検索インデックスが保持されます。 ドキュメントをインデックスにプッシュしたり、インデクサーを使用して サポートされているデータ ソースからデータをプルしたりすることができます。 個別のインデックスを使用すると、複数のシステムのコンテンツを結合して整形し、トランザクション ワークロードとは別に取得をスケーリングできます。 また、検索可能なデータの別のコピーも作成されます。 ソースの更新と対応するインデックスの更新の間の時間を考慮します。
運用レコードが頻繁に変更され、取得で更新された値を使用する必要がある場合は、併置された設計を選択します。 コーパスが複数のシステムにまたがる場合、またはマネージド コンテンツの抽出、エンリッチメント、ベクター化が必要な場合は、個別の検索インデックスを選択します。
フィルター処理とパーティション分割
ほとんどの実稼働ベクター クエリでは、フィルターを使用して、テナント、セキュリティ、ドキュメント セット、またはアプリケーションの境界を適用します。 再呼び出しと待機時間の両方に影響を与える可能性があるため、ベクター検索を使用してフィルターを評価します。
- NoSQLのAzure Cosmos DBで、
VectorDistanceを使用するクエリのWHERE句にサポートされている述語を追加します。 パーティション キー フィルターは、検索を一致する論理パーティションに制限します。 - Azure DocumentDB で、サポートされているフィルターを
cosmosSearch演算子に追加します。 - AI Search では、フィルター可能な非ベクター フィールドを作成し、 ベクター フィルター モード を使用して、サービスがベクター取得の前後にフィルターを適用するかどうかを制御します。
容量と地域設計
サービスでは異なるスケーリングと課金単位が使用されるため、定価比較では特定のワークロードのコストは表示されません。 モデルインデックスサイズ、ベクトルディメンション、クエリレート、更新率、レプリカ、パーティション、およびデータベーススループット。 別の検索インデックスを評価するときに、ソース データベースのコストを含めます。
地域設計も異なります。
- Azure Cosmos DBでは、Azure リージョン間で組み込みのデータ分散が提供され、複数の書き込みリージョンがサポートされます。
- AI Search はリージョン サービスです。 マルチリージョン AI 検索設計では、各リージョンで検索サービスを使用し、インデックスを揃え続けるプロセスが必要です。
埋め込みを最新の状態に保つ
埋め込みとは、派生データです。 ソース コンテンツが変更されたとき、または別の埋め込みモデルを採用したときに再生成します。
AI Search インデクサーは、サポートされているソースのチャンクと統合ベクター化を調整できます。 データベース中心の設計では、アプリケーションまたはデータ パイプラインがこれらの手順を実行し、結果のベクターを書き込みます。 変更フィードまたはソース イベントはそのプロセスを開始できますが、更新された埋め込みを格納するまで、新しいコンテンツは意味的に検索できません。
寄稿者
Microsoft では、この記事を保持しています。 次の共同作成者がこの記事を書きました。
主要著者
その他の共同作成者:
公開されていない LinkedIn プロフィールを見るには、LinkedIn にサインインしてください。
次のステップ
- インテリジェントなアプリケーションと AI
- Azure SQLと Azure OpenAI を使用した VSS
- Azure SQL と SQL Server でのネイティブ ベクターのサポート
- Azure Cosmos DB ベクトル データベース
- Azure Managed Redis の VSS
- vector search in Azure AI 検索
- Azure Cosmos DB for NoSQL でのベクター検索