Important
この機能は ベータ版です。 これを使うには、ワークスペース管理者がプレビューページからAI/BIダッシュボードのマテリアライゼーションを有効にする必要があります。 Manage Azure Databricks プレビューを参照してください。
AI/BIダッシュボードはダッシュボードスコープ化されたデータセットに基づいて構築されています。 デフォルトではすべてのデータセットがリアルタイムで評価されるため、ダッシュボードが読み込まれたりビューアが操作したりするたびに、基礎となるクエリ、結合、ソーススキャンがSQLウェアハウス上で再度実行されます。 高価なソースクエリや多数のジョインで構成されたダッシュボードでは、すべてのやり取りでクエリをやり直すのは遅くコストもかかります。
データセットママチャライゼーションは、データセットの背後に結果を事前に計算・保存するため、重い作業はスケジュール上で一度だけ行われるもので、ダッシュボードのロードやインタラクションごとに行われるのではなく、 その後、インタラクションは保存された結果からレンダリングされるため、公開ダッシュボードの処理が速くなります。
マテリアライゼーションはUnity Catalogのメトリックビューマテリアライゼーション技術を使用しています。 メトリック ビューについては、「具体化」を参照してください。
何が実現するか
マテリゼーションはデータセットデータを事前計算し、保存します。 保存される内容は、2つのデータセットタイプによって異なります。
- SQLデータセットの場合、全体のクエリ結果は事前に計算され保存されます。
- ローカルメトリックビューでは、行レベルのデータモデル(ソースデータ、結合フィールド、フィルターフィールド)が保存され、測度はクエリ時に事前計算されたベースに対して計算されます。
Benefits
データセットママリゼーションは以下の利点を提供します:
- リモデリングなしでより高速なダッシュボード。 高価なジョインやソーススキャンは、毎回のロードではなくスケジュール上で一度実行されるため、ダッシュボードが大きなテーブルを再照会する際の待ち時間の体験がなくなります。
- 読み取り時のデータウェアハウスコストを削減 ベースデータモデルを事前に計算することで、すべてのビューアやページロードごとに同じ重いクエリを繰り返すことを避け、冗長な倉庫使用を削減します。
- 運用上のオーバーヘッドもありません。 Azure Databricksは、マテリアル化されたデータを作成、保存、更新してくれます。 管理すべきパイプラインやスキーマ、ストレージはありません。
Costs
データセットのマテリアル化にはストレージおよび計算コストが発生します:
- ストレージ マテリアル化されたデータを保存する費用を支払う必要があります。 料金は使用する保存装置によって異なります。 Unity Catalogのストレージの概要については、「 Unity Catalogを使ったクラウドオブジェクトストレージへの接続」をご覧ください。
- コンピューティング。 初期の作成とリフレッシュはサーバーレスのLakeflowパイプライン上で実行され、計算料金が発生します。 Lakeflow パイプラインの料金をご覧ください。
これらのコストを、繰り返しのソーススキャンや結合を避けるコストと比較検討してください。 データの新鮮さと計算コストのバランスを取ったリフレッシュスケジュールを選択してください。
マテリアライゼーションを使うタイミング
マテリアライゼーションが必ずしもパフォーマンスの正しいレバーとは限りません。 利点は、データセットの繰り返しの完全な再計算(スキャンと結合)を、事前に計算されたテーブルに対する読み取りに置き換えることにあります。 以下のいずれかが適用される場合、データセットを具現化します:
- 非常にインタラクティブなダッシュボード。 ダッシュボードには多くのフィルター、クロスフィルタリング、またはドリルダウン機能があります。 マテリアライゼーションがなければ、すべてのやり取りでデータセットクエリが再実行されるため、事前にデータセットを計算してもセッション中に何度も効果が出ます。
- 高価なデータセット。 このデータセットは、マルチテーブル結合、ヘビービューや共通テーブル式(CTE)、ウィンドウ関数、または多数のテーブルにまたがるユニオンで構成されています。
- 大規模なテーブルの選択フィルター。 データセットは数十億行の中から、例えば一つの地域や直近7日間のような小さなサブセットを選択します。 物質化はごく一部の集合のみを保存します。
- 予定された新鮮度への耐性。 データは、リアルタイムである必要はなく、1時間ごとや1日ごとなど、ダッシュボードの更新スケジュールと同程度の鮮度であれば十分です。
小規模なデータセットやダッシュボードがめったに読み込まれない場合、ライブクエリは十分に速いことが多いため、マテリアライゼーションはコストに見合わないかもしれません。 マテリアライゼーションは公開ごとに、データセットごとにオプトインされるため、効果がある場合にのみ適用できます。
必要条件
- AI/BI ダッシュボードへのアクセス。
- ダッシュボードは 「データ権限共有 」オプションで公開されています。 個別のデータ権限で公開されたダッシュボードでは、マテリアル化はサポートされていません。 「 共有データのアクセス許可とは」を参照してください。
- ワークスペースでサーバーレスコンピュートが有効です。 初期の作成と刷新はサーバーレスのLakeflowパイプライン上で行われます。 サーバーレス SQL ウェアハウスのセットアップを参照してください。
- Databricks Runtime 17.3以降で実行されているSQLウェアハウスに対するCAN USE権限
データセットのママリゼーションを有効にする
データセットはデフォルトでマテライゼーションが選択されていますが、ダッシュボードではマテライズはオフで、公開時に マテライズ・データセット のオプションをオンにするまでは有効です。
どのデータセットを具現化するか選びます
データタブで、データセットの隣にあるマテリアル化アイコンをクリックして、そのデータを含めるか除外します。
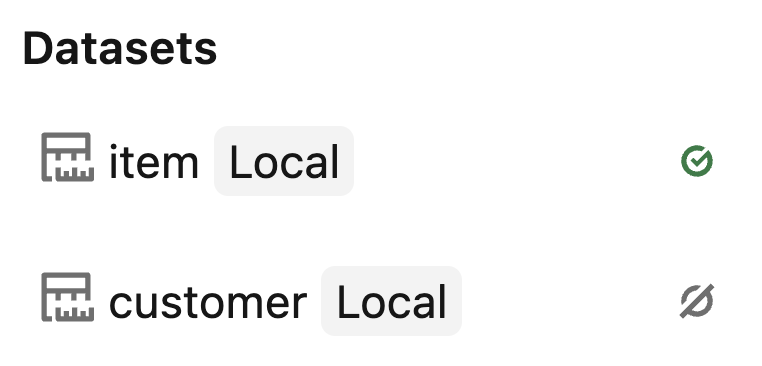
マテリアライゼーションからデータセットを除外すると、そのデータセットに対するクエリはライブ結果を返し、マテリアライズされたデータセットに対するクエリは最新のマテリアライゼーション実行を反映します。 すべてのデータセットが同じマテリアライゼーションスケジュールを使用している場合、ウィジェットは一貫したデータの新鮮性を保ちます。
マテリアライズして公開
- ドラフトダッシュボードで 「公開 」をクリックしてください。
- 公開ダイアログで 「データ権限を共有する 」を選択してください。
- 「 Materialize datasets」 オプションをオンにして、 Data タブで選択したデータセットをマテリアル化してください。
- [公開] をクリックします。
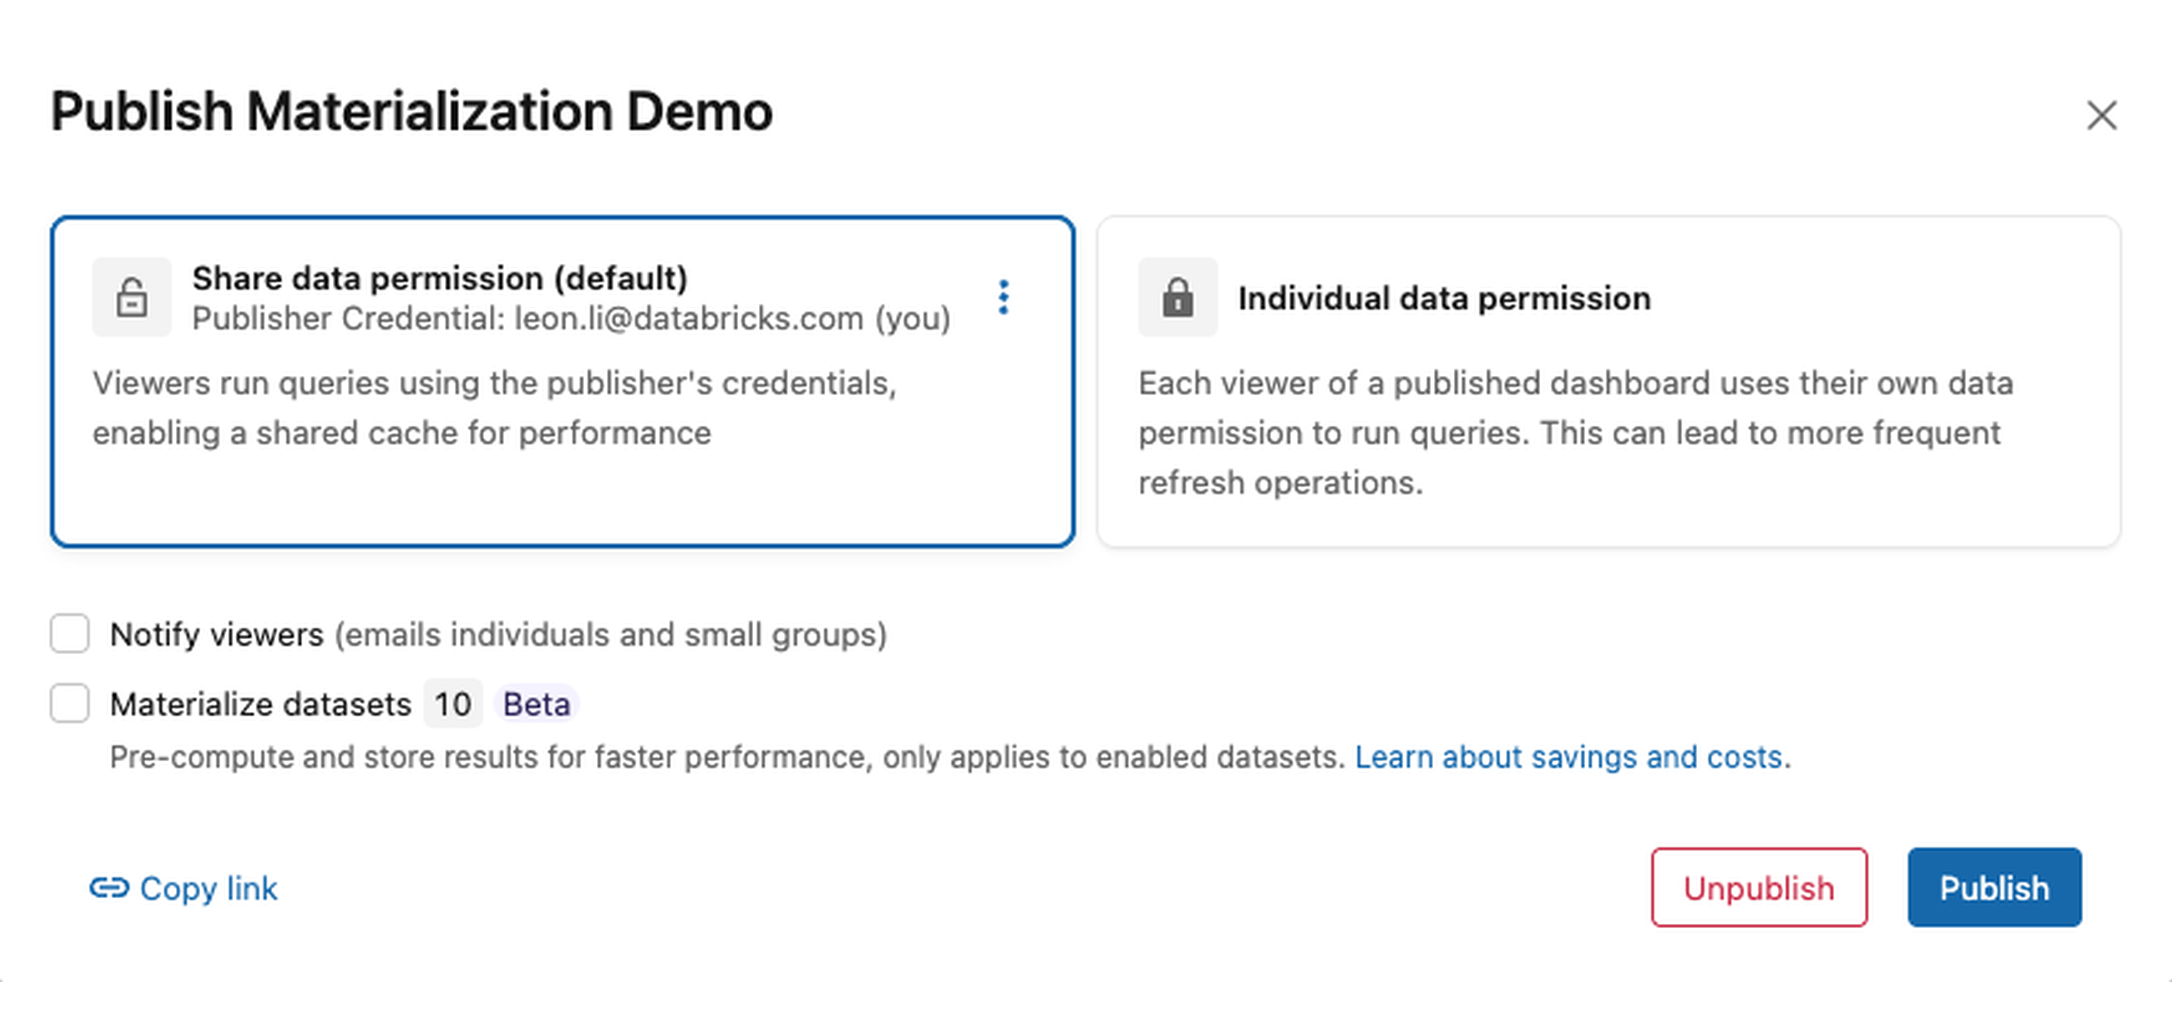
各公開で Materialize datasets オプションをオンにしてください。
リフレッシュスケジュールを設定しましょう
ダッシュボードの更新スケジュール上で、具体化されたデータリフレッシュが行われます。 ダッシュボードのスケジュールを使ってリフレッシュ頻度を調整してください。
ダッシュボードにスケジュールがない場合は、マテリアライゼーションを有効にしたまま公開すると、日々の更新スケジュールが追加されます。 既存の時刻表は保存されています。 アクティブなスケジュールがなければ、マテリアル化されたデータは作成後に自動的に更新されません。
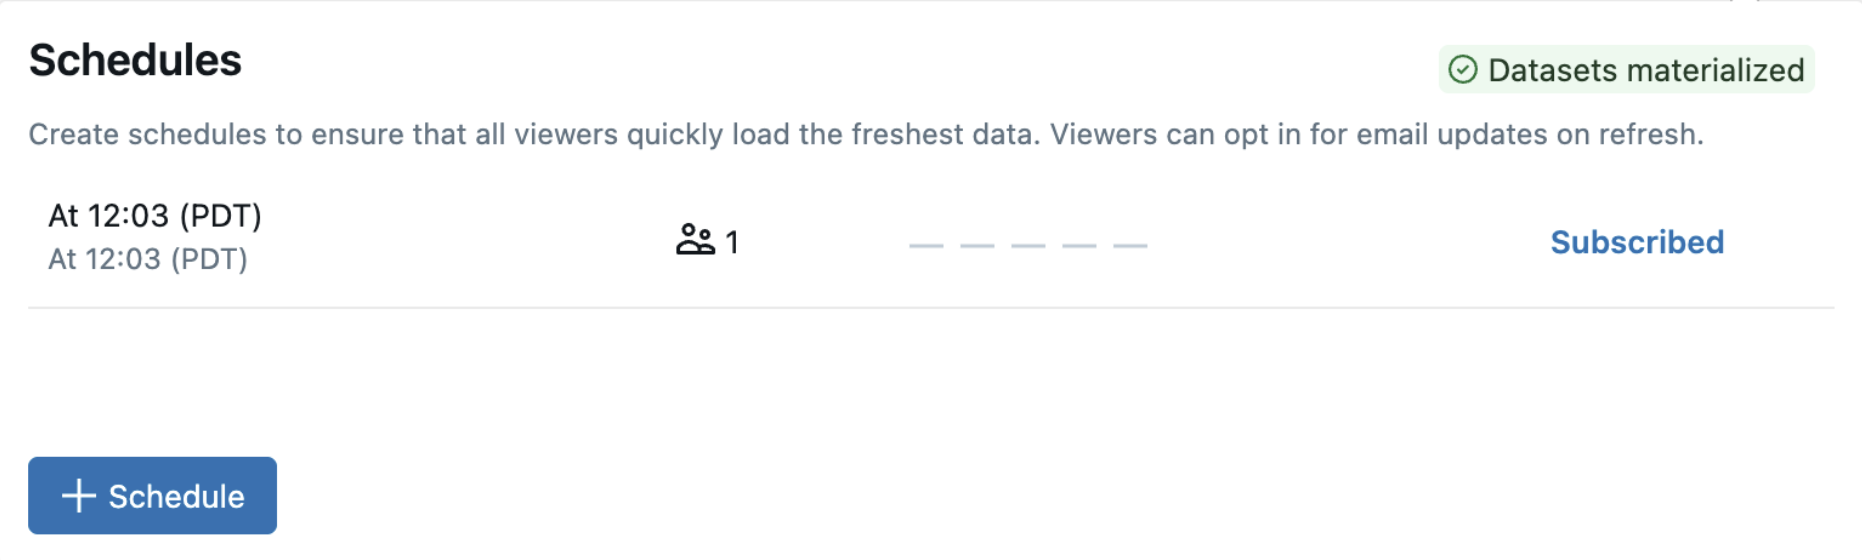
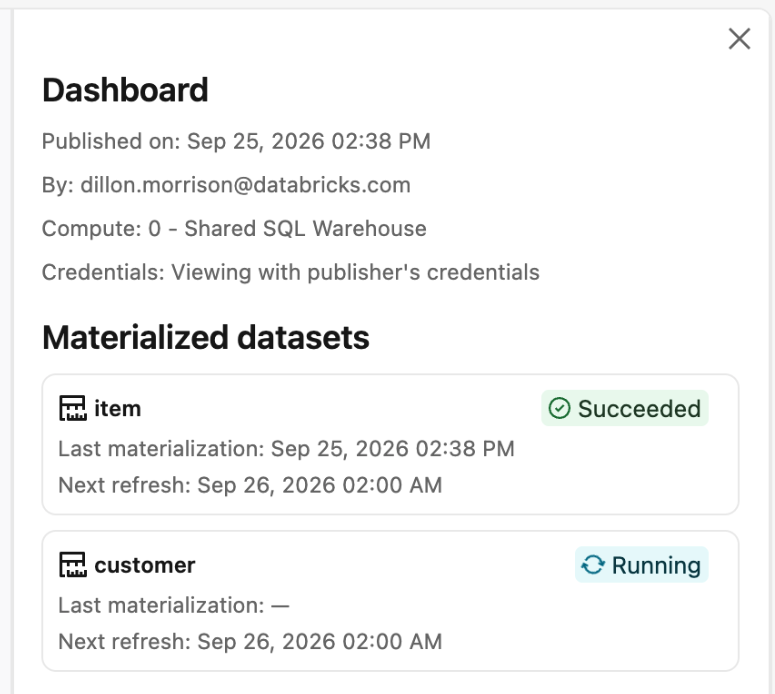
マテリアライゼーションの状況を見る
公開されたダッシュボードで、  を開き、 メニューから「Info」を選択してください。 サイドバーには各マテリアル化されたデータセットの状態と更新情報が表示されます。
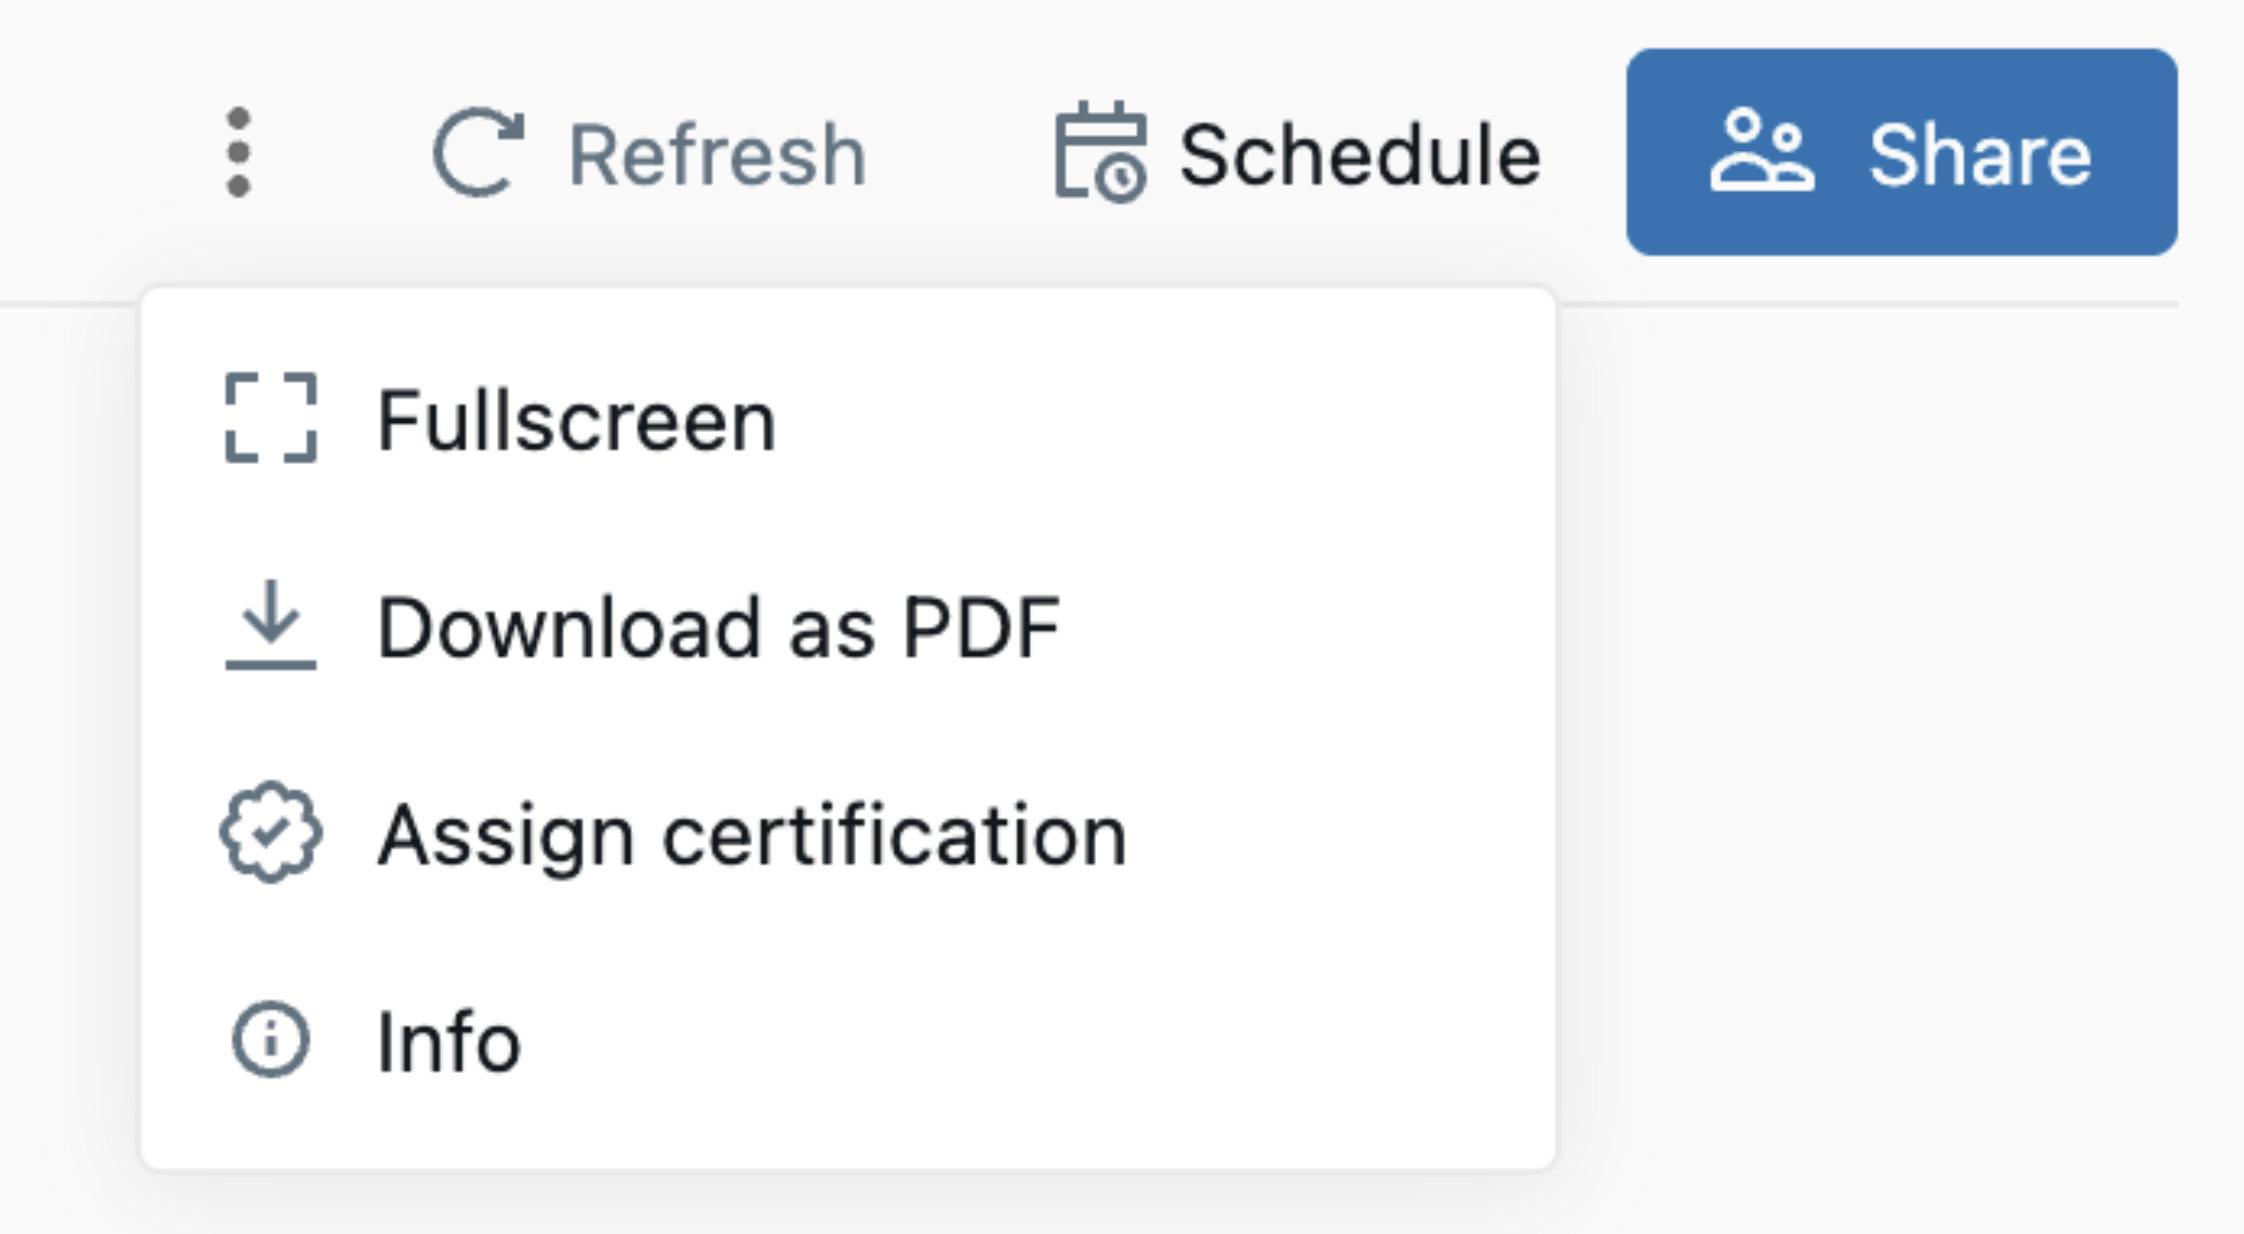
再利用と清掃
Azure Databricksは、マテリアル化されたデータのライフサイクルを管理します:
- 改訂版を越えて再利用すること。 同じユーザーによってダッシュボードが再公開され、データセットが変更されなければ、既存のマテリアライゼーションが再利用され、計算の無駄を避けられます。
- 自動清掃。 Azure Databricksは、定義変更や公開解除後など、公開ダッシュボードが参照しなくなったマテリゼーションをドロップします。
再公開は必ずしも物質化されたデータを更新するわけではありません。
制限事項
データセットママリゼーションには以下の制限があります:
- 公開ダッシュボードのみ。 マテリアライゼーションは公開されたダッシュボードに適用されます。 ドラフトは引き続きライブデータを照会しています。
- パラメータ化されたデータセットはありません。 パラメータを定義したデータセットは物質化できません。 パラメータ化されたデータセットをマテリアル化に切り替えると、Azure Databricksはそれをマテライズするのではなく失敗として報告します。
- リフレッシュはダッシュボードのスケジュールに従ってのみ行われます。 データセットごとの個別の更新スケジュールはありません。 マテリアライゼーションは、ダッシュボードで設定されたスケジュール更新の間隔で更新されます。
- サーバーレス必須。 初期の作成とリフレッシュはサーバーレスのLakeflowパイプライン上で動作するため、ワークスペースはサーバーレス計算が有効になっている必要があります。
- 保護されたデータはマテリアライズからは配信されません。 行レベルのセキュリティ、カラムマスク、属性ベースのアクセス制御(ABAC)ポリシーで保護されたソースデータに対しては、ママリゼーションを作成することはできません。 マテリゼーション作成後に行レベルのセキュリティがソーステーブルに追加されると、その後のメトリックビューに対するクエリはマテリアライズをバイパスし、ソースデータに対して実行されます。
- データ共有の許可が必要です。 共有データ権限で公開した場合にのみマテリアル化を有効にできます。 個別のデータ権限で公開する場合は有効にできません。
よく寄せられる質問
以下の質問は、データセットのマテリアライゼーションの挙動、リフレッシュ、権限について扱います。
マテリアライゼーションは私の指標や結果に影響を与えるのでしょうか?
マテリアライゼーションはデータセットのクエリロジックを保持しますが、データは最新の成功した更新を反映します。 局所指標ビューでは、クエリ時に物質化されたデータに対して測定値を計算します。 何が実現するか見てみましょう。
もし物質化が準備できていなかったり利用できない場合はどうなりますか?
マテリアライゼーションがクエリ時に準備されていないか利用できない場合、クエリはライブデータのクエリではなくエラーを返します。 マテリアライゼーションが完了するのを待ってから、クエリを再度実行します。
物質化されたデータはどこに保存されているのでしょうか?
Azure Databricksは、マテリアル化されたデータを管理された内部ストレージに保存し、公開ダッシュボードにスコープを割り当てます。 Unity Catalogに公開するものは何もなく、管理すべきスキーマやストレージもありません。 アクセスは引き続きダッシュボードと基礎となるデータ権限に従っています。
物質化されたデータはどのくらいの頻度で更新されますか?
ダッシュボードの更新スケジュール上で、具体化されたデータリフレッシュが行われます。 「 更新スケジュールを設定する」を参照してください。
マテリアル化はどのような計算を使っていますか?
初期の作成とリフレッシュはどちらもAzure Databricksが管理するサーバーレスのLakeflowパイプライン上で動作します。 だからこそ、ワークスペースでサーバーレスコンピュートを有効にする必要があります。
マテリアライゼーションは権限に影響を与えるのでしょうか?
No. マテリアライゼーションはデータへの追加アクセスを許可しません。 アクセスは依然としてダッシュボードの共有設定と公開に使われた権限に従います。
再出版したらどうなる?
既存のマテリアライゼーションは、同じユーザーが変更されていないデータセットを再公開することで再利用可能です。 「 再利用とクリーンアップ」を参照してください。 各公開で Materialize datasets オプションをオンにしてください。