Genie Codeは、解析、分類、抽出、検証をオーケストレーションすることで、ドキュメント処理パイプラインをエンドツーエンドで構築します。 非構造化PDF、契約書、請求書を指し示すと、ラベル付きデータと照らして品質を評価し、改善を繰り返します。そうすればパイプラインが本番環境に対応できるかどうかを判断できます。
必要条件
Genie Codeを使って文書処理を行うには:
- Genie Codeのエージェント能力の要件を満たすこと。
-
AI機能の要件を満たすこと。 文書処理機能(
ai_parse_document、ai_extract、ai_classify)は、サーバーレス計算またはサポートされているリージョン内のSQLウェアハウス上で動作します。 - Unity Catalogでソースドキュメントのボリュームと結果のスキーマにアクセスできるようにしましょう。
Genie Codeで文書処理パイプラインを構築する
Jobs & PipelinesのページかSQLエディタでGenie Codeを開いてください。
目標を述べ、情報源を指し示してください。 お使いのボリューム、テーブル、ファイルを参照してください。
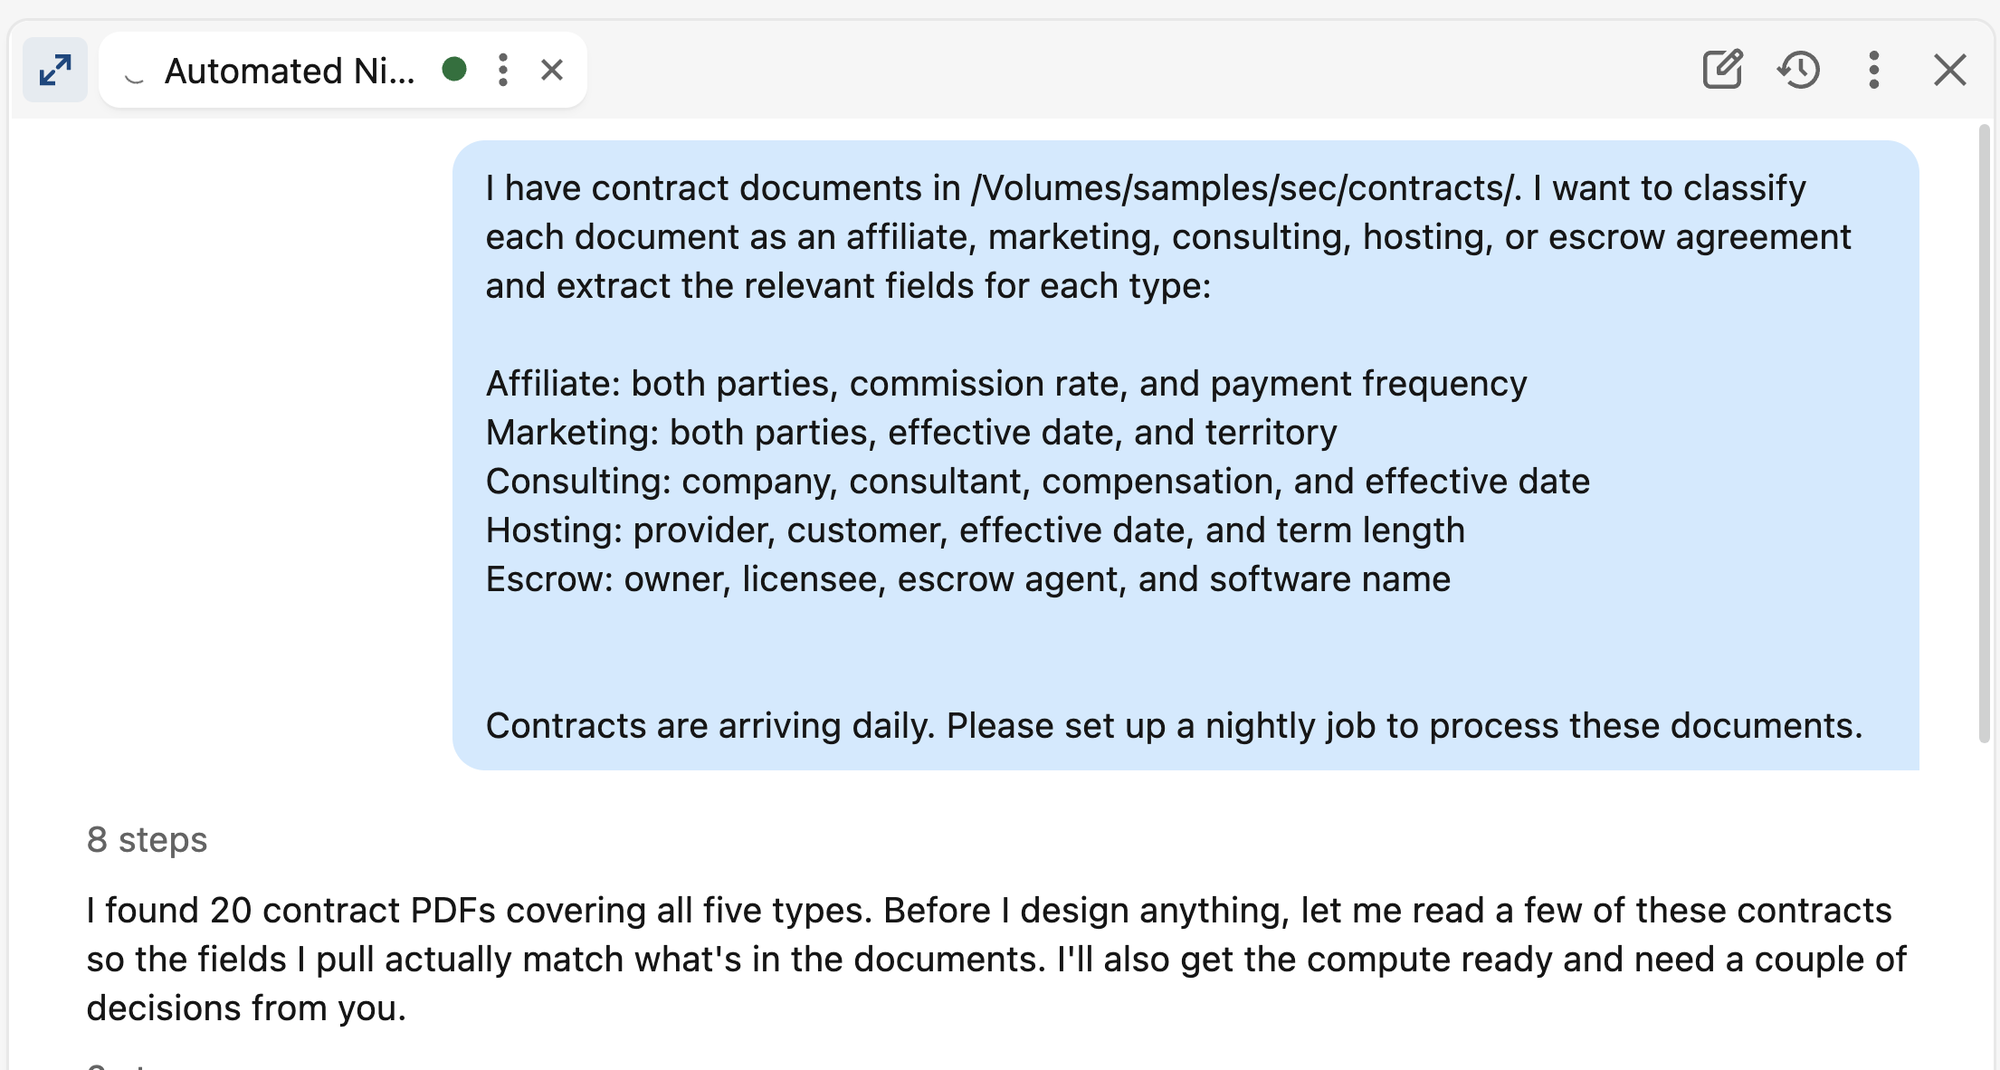
積み重ねていきましょう。 Genie Codeが十分な素材を揃えた後、ベストプラクティスを使ってLakeflowジョブを構築します。
確認して実行。 生成されたSQLやタスクを確認し、好きなことを編集して、準備ができたらジョブを実行してください。
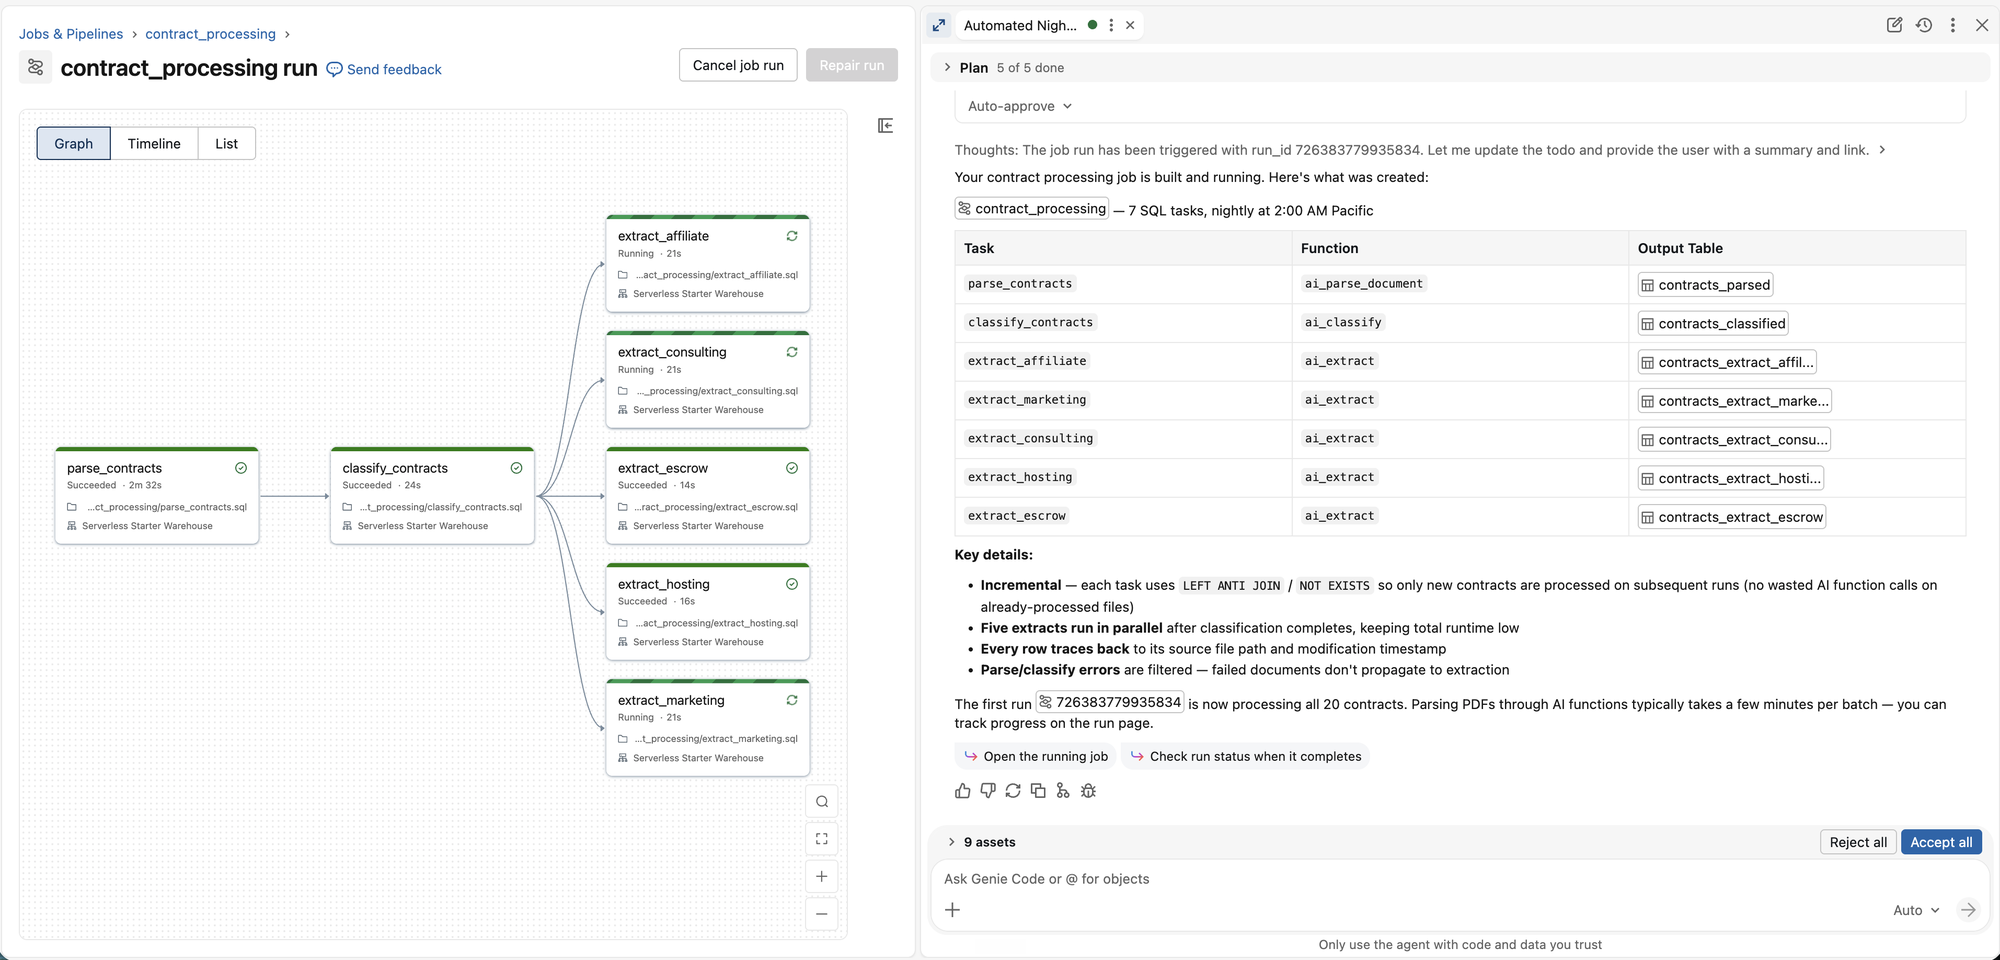
小さく始めて、徐々にスケールアップしましょう。 サンプルを実行し、出力を確認し、品質を評価し、反復してから全データセットを処理します。
Genie Code は何に役立ちますか?
エンドツーエンドのドキュメント処理ジョブを構築しましょう
結果を説明すれば、Genie Codeは目標に必要な段階のみを使って完全なLakeflowジョブを構築します:
- ボリューム内のソースファイルを発見し、その識別や変更を追跡します。
- 文書を構造化されたコンテンツに分割し、テキスト、表、図、ページレイアウトなどの
ai_parse_documentを用いましょう。 -
ai_classify(例えば、アフィリエイト、マーケティング、またはコンサルティング契約など)のようなあなた独自のラベルで分類しましょう。 -
ai_extractします。 - クリーンで構造化された出力をUnity Catalogのテーブルに公開します。
各AI機能は独立したタスクなので、ジョブはモジュール式のままで、後で再実行やバックフィル、編集が可能です。
評価とヒルクライミングで抽出品質を向上させる
Genie Codeは品質を推測ではなく、測定するものとして扱っています。 期待される出力のラベル付きテーブルが与えられ、フィールドレベルの評価を実行し、ループを閉じます。
- 測定。 現在の抽出フィールドごとにスコアリングして、どのフィールドが弱いかを正確に確認できます。
- 改善しましょう。 Genie Code は修正案を提示します。たいていの場合、それはより的確なフィールドの説明であり、適用される前に確認して承認できる差分として表示されます。
- 再評価しろ。 すべての承認された変更は評価セットを再実行し、前後の結果を表示するため、改善と回帰の両方が目に見えます。
このループは、品質が基準を満たすまで繰り返されるため、準備完了かどうかは、もっともらしく見える出力ではなく、スコアと信頼度に基づいて判断します。
結果を検証し、例外を振り分ける
Genie Codeはパイプラインに品質の門を組み込んでいます。 決定論的なチェック(スキーマ、必須フィールド、合計)、モデルの信頼度、ビジネスルールを組み合わせて、何が通るかを判断し、失敗した行は目視化します。
文書を視覚的にデバッグしましょう
Genie Codeは ドキュメント解析UI を開き、解析されたコンテンツや抽出されたフィールドの隣にレンダリングされたページを表示します。 悪い結果を見つけるために使う:解析出力にテキストが欠落したり乱れている場合、問題は解析ファイルかソースファイルにあります。 もしテキスト解析はされていてフィールドが間違っている場合、問題は抽出です。 いずれにせよ、拡大する前に実際のドキュメントで確認してください。
既存のパイプラインを点検しトラブルシューティングしてください
Genie Codeは新しいパイプラインだけでなく、すでに持っているパイプラインでも動作します。 作業の説明、設計やコストのレビューを何も変更せずに行い、失敗や遅い段階の根本原因を見つけ出し、動作部品はそのままにして最小限の修正を行うことができます。
プロンプトの例
エンドツーエンドのパイプラインを構築する
- 契約書が
@my_catalog.raw.contractsに届きます。 それぞれをアフィリエイト、マーケティング、コンサルティング、ホスティング、エスクローに分類する日々の仕事を作り、各契約の種類に重要なフィールドを抽出し、ゴールドテーブルを作成する。」 -
@my_catalog.raw.invoicesにスキャン済みの請求書が大量にあります。 それらを解析し、ベンダー、請求書番号、項目、合計を抽出し、結果をテーブルに書き込むジョブを構築します。」
評価とヒルクライミングで品質を向上させる
- これが何百万行ものデータに対して実行するのに十分な性能を備えていると、どうすればわかりますか? 抽出を私のラベル付けしたテーブル
@my_catalog.default.eval_tableと照らして評価し、どのフィールドが最も弱いか教えてくれ。」 - 「
invoice_totalフィールドでの精度はもっと高くできる。 スキーマと指示を反復的に改善し、評価を再実行し、ビフォー・アフターを見せてくれ。」 - 「評価結果からフィールドごとの信頼度閾値を設定し、低信頼度の行をレビューにルーティングしてください。」
結果を検証し、例外を振り分ける
- 必須項目をチェックし、明細行の合計が請求書合計と一致することを確認する検証を追加し、検証に失敗した行は保持してください。
- 「ビジネスルールに違反した文書(例えば、給与より納税した税金)を別表で人間の確認のために保管する。」
文書を視覚的にデバッグしましょう
- 「これらのPDFの解析済み結果を元のページの隣に見せてくれ。解析結果を確認したいから。」
- 「一部のコンサルティング契約では発効日が間違っている。 解析済みの表示を開いて、パーシングの問題か抽出の問題か見分けられるように。」
既存のパイプラインを点検しトラブルシューティングしてください
- 「この文書処理の仕事で各タスクが何をするのか、そして結果がどこに書かれているのか説明してください。」
- 「この解析作業は失敗し始めた。 最近のラン出力から原因を特定し、最小限の修正を提案します。」
- 「この文書処理パイプライン設計をベストプラクティスと比較してレビューし、全データセットで実行できるかどうか教えてください。」