sdp-meta の プロジェクトには、管理するメタデータからパイプラインを生成するためのツールが用意されています。
Note
オープンソースのsdp-metaプロジェクトは、databrickslabsの GitHub アカウントにあるすべてのプロジェクトと同様に、探索目的のみを目的として存在しています。 Azure Databricks ではサポートされず、サービス レベル アグリーメント (SLA) も提供されません。 このプロジェクトに関連する問題については、Azure Databricks サポート チケットを送信しないでください。 代わりに、GitHubの問題を提出します。この問題は、時間が許す限り確認されます。
SDP-メタとは何ですか?
Lakeflow パイプラインを使用すると、テーブルを宣言によって指定し、パイプラインでフローを生成できます。このパイプラインでは、テーブルが作成され、ソース データが変更されると最新の状態に保たれます。 ただし、組織に何百ものテーブルがある場合、これらのパイプラインの生成と管理には時間がかかり、一貫性のないプラクティスにつながる可能性があります。
sdp-metaプロジェクトは、Lakeflowパイプラインと連携して動作するメタデータ駆動型のメタプログラミングフレームワークです。 このフレームワークでは、JSON ファイルと YAML ファイルのセットに記録されたメタデータを利用して、ブロンズとシルバーのデータ パイプラインを自動化できます。 実行時には、汎用パイプラインがメタデータを読み取り、そこに記述されたフローを動的に構築します。 青銅と銀の加工は別々のパイプラインで行われることも、複合パイプラインで同時に行うことも可能です。 パイプラインのメタデータを生成し、sdp-metaがパイプラインを生成します。
ロジックを 1 か所 (メタデータ) に一元化することで、システムはより高速で再利用可能で、保守が容易になります。
Note
このsdpメタプロジェクトは、Azure Databricks年の古いDelta Live Tables機能にちなんでdlt-metaと呼ばれていました。
Delta Live Tables はLakeflowパイプラインに置き換えられ、sdp-metaはLakeflowパイプラインと連携しています。 既存の dlt-meta インストールをアップグレードする場合は、sdp-metaドキュメント内の 移行ガイド を参照してください。
SDP-メタの利点
sdp-metaには主に2つのユースケースがあります。
- 多数のテーブルを簡単に取り込み、整理できます。
- 複数のパイプラインとユーザーにデータ エンジニアリング標準を適用します。
メタデータドリブン アプローチを使用する利点は次のとおりです。
- メタデータの管理は、Python または SQL コードの知識がなくても行うことができます。
- コードではなくメタデータを維持すると、オーバーヘッドが少なくなり、エラーが減ります。
- コードはsdp-metaで生成されるため、パイプラインや公開テーブルを越えたカスタムコードが少なく、一貫性を持たせています。
- テーブルをメタデータ内のパイプラインに簡単にグループ化し、データを最も効率的に更新するために必要なパイプラインの数を生成できます。
SDP-メタの仕組み
以下の画像はsdpメタシステムの概要を示しています:
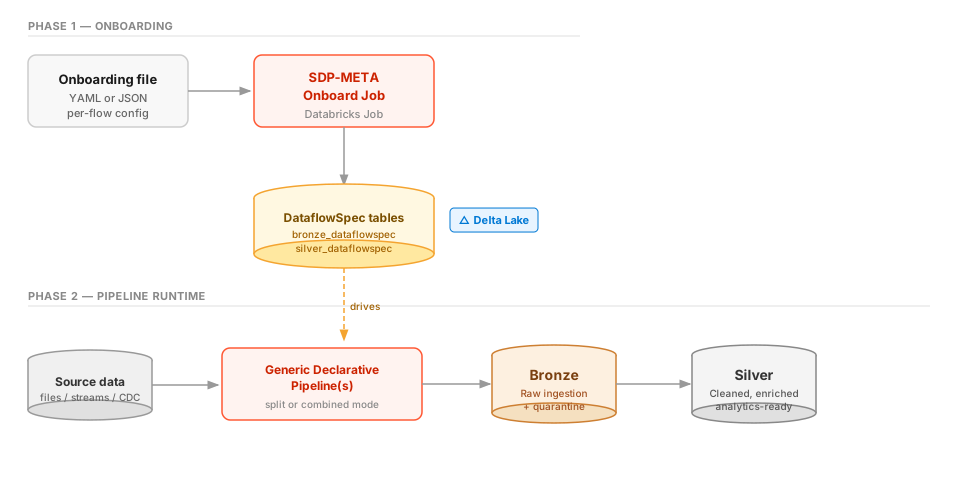
- メタデータファイルをsdp-metaの入力として作成し、ソースファイルと出力、品質ルール、必要な処理を指定します。 これらのオンボーディングファイルはJSONまたはYAMLで書くことができます。
- sdp-meta のオンボーディングジョブを実行します。 エンジンはオンボーディングファイルを DataflowSpecと呼ばれるデータフロー仕様にコンパイルし、後で利用するためにDeltaテーブル(
bronze_dataflowspecおよびsilver_dataflowspec)に保存します。 - 実行時には、汎用パイプラインがDataflowSpecを読み取り、動的にブロンズ処理グラフを構築します。 ソースデータ(ファイル、ストリーム、CDC)を読み取り、品質ルールに合った正しいデータ期待値を適用してブロンズ表を作成し、ルールに合わないレコードを隔離します。
- Silver処理は、宣言的自動化バンドルのデフォルトである別の汎用パイプラインで動作するか、コンバインドモードを使う場合は同じパイプライン内で実行できます。 パイプラインはDataflowSpecを用いて適切な変換やその他の処理を行い、クリーンで強化され分析対応可能なシルバーテーブルを生成します。
sdp-metaで生成されるパイプラインを実行し、ソースデータが更新されるたびに出力を最新に保ちます。
概要
sdp-metaを使うには、以下が必要です:
- SDP-metaソリューションを展開・設定します。
- ブロンズ レイヤー テーブルとシルバー レイヤー テーブルのメタデータを準備します。
- メタデータをオンボードするジョブを作成します。
- メタデータを使用して、テーブルのパイプラインを作成します。
sdpメタプロジェクトは、複数の展開インターフェースをサポートしています:バンドル(推奨)、インタラクティブCLI、ブラウザベースのGUIを備えたDatabricksアプリ、AI支援セットアップ用のMCPサーバー、スキル認識型AIエージェント向けのポータブルエージェントスキルです。
GitHubのsdp-metaドキュメントには、このプロセスを始めるためのチュートリアルがあります。 詳細については、GitHub のsdp-meta の使用開始を参照してください。