データ エンジニアリングでは、 バックフィル とは、現在のデータまたはストリーミング データを処理するように設計されたデータ パイプラインを通じて履歴データをさかのぼって処理するプロセスを指します。
通常、これは既存のテーブルにデータを送信する別のフローです。 次の図は、パイプライン内のブロンズ テーブルに履歴データを送信するバックフィル フローを示しています。
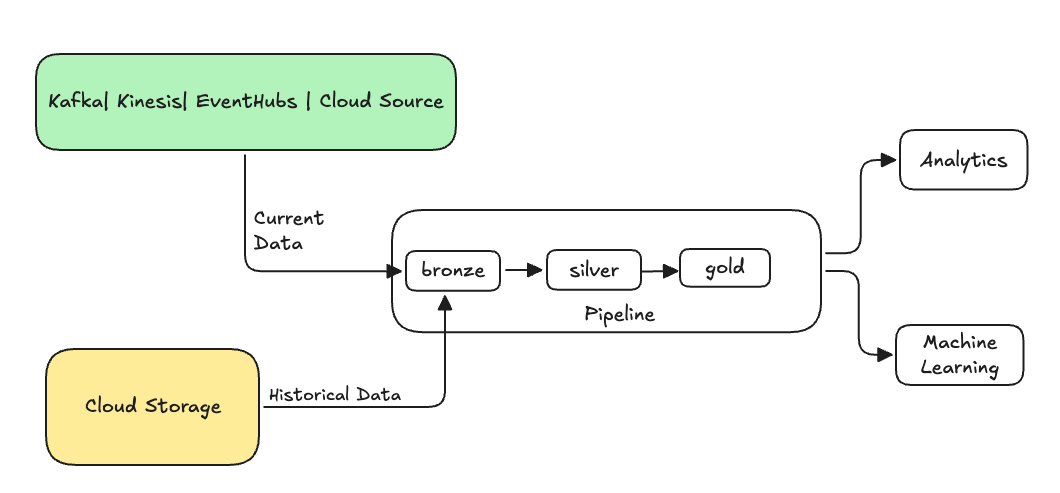
バックフィルが必要なシナリオには、次のような場合があります。
- 従来のシステムからの履歴データを処理して、機械学習 (ML) モデルをトレーニングするか、履歴傾向分析ダッシュボードを作成します。
- アップストリーム データ ソースのデータ品質の問題が原因で、データのサブセットを再処理します。
- ビジネス要件が変更され、最初のパイプラインでカバーされていない別の期間のデータをバックフィルする必要があります。
- ビジネス ロジックが変更され、履歴データと現在のデータの両方を再処理する必要があります。
使用するバックフィルフローは、ターゲットテーブルとソースデータによって異なります。 権威スナップショットを使用する AUTO CDC の緩やかに変化するディメンション (SCD) タイプ 1 ターゲットには、1 回限りの AUTO CDC FROM SNAPSHOT フローを使用します。 過去の変更を再生するSCD移行には、ワンタイム AUTO CDC フローを使いましょう。
追加のみのバックフィルの場合: ONCE オプション付きの専用のアペンドフローを使って、追加のみのストリーミングテーブルをバックフィルします。
オプションの詳細については、append_flowまたは ONCE を参照してください。
履歴データをストリーミング テーブルにバックフィルするときの考慮事項
- 通常は、ブロンズ ストリーミング テーブルにデータを追加します。 後続のシルバー レイヤーとゴールド レイヤーはブロンズ レイヤーから新しいデータを拾います。
- 同じデータが複数回追加された場合に備え、パイプラインで重複データを適切に処理できることを確認します。
- 履歴データ スキーマが現在のデータ スキーマと互換性があることを確認します。
- データボリュームサイズと必要な処理サービスレベルアグリーメント(SLA)を考慮し、クラスタとバッチサイズを適切に設定してください。
例:既存のパイプラインにバックフィルを追加する
この例では、2025 年 1 月 1 日から、クラウド ストレージ ソースから生のイベント登録データを取り込むパイプラインがあるとします。 後になって、下流のレポート作成や分析のユースケースのために、過去3年分の履歴データを後から補完したいと思うようになります。 すべてのデータは、年、月、日ごとに JSON 形式でパーティション分割された 1 つの場所にあります。
初期パイプライン
クラウド ストレージから生イベント登録データを増分的に取り込む開始パイプライン コードを次に示します。
Python
from pyspark import pipelines as dp

source_root_path = spark.conf.get("registration_events_source_root_path")
begin_year = spark.conf.get("begin_year")
incremental_load_path = f"{source_root_path}/*/*/*"

# create a streaming table and the default flow to ingest streaming events
@dp.table(name="registration_events_raw", comment="Raw registration events")
def ingest():
    return (
        spark
        .readStream
        .format("cloudFiles")
        .option("cloudFiles.format", "json")
        .option("cloudFiles.inferColumnTypes", "true")
        .option("cloudFiles.maxFilesPerTrigger", 100)
        .option("cloudFiles.schemaEvolutionMode", "addNewColumns")
        .option("modifiedAfter", "2025-01-01T00:00:00.000+00:00")
        .load(incremental_load_path)
        .where(f"year(timestamp) >= {begin_year}") # safeguard to not process data before begin_year
    )
SQL
-- create a streaming table and the default flow to ingest streaming events
CREATE OR REFRESH STREAMING LIVE TABLE registration_events_raw AS
SELECT * FROM read_files(
  "/Volumes/gc/demo/apps_raw/event_registration/*/*/*",
  format => "json",
  inferColumnTypes => true,
  maxFilesPerTrigger => 100,
  schemaEvolutionMode => "addNewColumns",
  modifiedAfter => "2024-12-31T23:59:59.999+00:00"
)
WHERE year(timestamp) >= '2025'; -- safeguard to not process data before begin_year
ここでは、 modifiedAfter 自動ローダー オプションを使用して、クラウド ストレージ パスのすべてのデータが処理されていないことを確認します。 増分処理は、その境界でカットオフされます。
ヒント
Kafka、Kinesis、Azure Event Hubs などの他のデータ ソースには、同じ動作を実現するための同等のリーダー オプションがあります。
過去 3 年間のデータをバックフィルする
次に、1 つ以上のフローを追加して、前のデータをバックフィルします。 この例では、次の手順を実行します。
-
append onceフローを使用します。 1 回限りのバックフィルが実行され、その後は実行しません。 コードはパイプラインに残り、パイプラインが完全に更新された場合は、バックフィルが再実行されます。 - 年ごとに 1 つずつ、3 つのバックフィル フローを作成します (この場合、データはパス内で年単位で分割されます)。 Python の場合、フローの作成をパラメーター化しますが、SQL では、フローごとに 1 回、コードを 3 回繰り返します。
独自のプロジェクトで作業していて、サーバーレス コンピューティングを使用していない場合は、パイプラインの最大ワーカー数を更新できます。 最大ワーカー数を増やすと、予想される SLA 内で現在のストリーミング データを引き続き処理しながら履歴データを処理するためのリソースが確保されます。
ヒント
自動スケールが強化されたサーバーレス コンピューティング (既定) を使用する場合、負荷が増加すると、クラスターのサイズが自動的に増加します。
Python
from pyspark import pipelines as dp

source_root_path = spark.conf.get("registration_events_source_root_path")
begin_year = spark.conf.get("begin_year")
backfill_years = spark.conf.get("backfill_years") # e.g. "2024,2023,2022"
incremental_load_path = f"{source_root_path}/*/*/*"

# meta programming to create append once flow for a given year (called later)
def setup_backfill_flow(year):
    backfill_path = f"{source_root_path}/year={year}/*/*"
    @dp.append_flow(
        target="registration_events_raw",
        once=True,
        name=f"flow_registration_events_raw_backfill_{year}",
        comment=f"Backfill {year} Raw registration events")
    def backfill():
        return (
            spark
            .read
            .format("json")
            .option("inferSchema", "true")
            .load(backfill_path)
        )

# create the streaming table
dp.create_streaming_table(name="registration_events_raw", comment="Raw registration events")

# append the original incremental, streaming flow
@dp.append_flow(
        target="registration_events_raw",
        name="flow_registration_events_raw_incremental",
        comment="Raw registration events")
def ingest():
    return (
        spark
        .readStream
        .format("cloudFiles")
        .option("cloudFiles.format", "json")
        .option("cloudFiles.inferColumnTypes", "true")
        .option("cloudFiles.maxFilesPerTrigger", 100)
        .option("cloudFiles.schemaEvolutionMode", "addNewColumns")
        .option("modifiedAfter", "2024-12-31T23:59:59.999+00:00")
        .load(incremental_load_path)
        .where(f"year(timestamp) >= {begin_year}")
    )

# parallelize one time multi years backfill for faster processing
# split backfill_years into array
for year in backfill_years.split(","):
    setup_backfill_flow(year) # call the previously defined append_flow for each year
SQL
-- create the streaming table
CREATE OR REFRESH STREAMING TABLE registration_events_raw;

-- append the original incremental, streaming flow
CREATE FLOW
  registration_events_raw_incremental
AS INSERT INTO
  registration_events_raw BY NAME
SELECT * FROM STREAM read_files(
  "/Volumes/gc/demo/apps_raw/event_registration/*/*/*",
  format => "json",
  inferColumnTypes => true,
  maxFilesPerTrigger => 100,
  schemaEvolutionMode => "addNewColumns",
  modifiedAfter => "2024-12-31T23:59:59.999+00:00"
)
WHERE year(timestamp) >= '2025';


-- one time backfill 2024
CREATE FLOW
  registration_events_raw_backfill_2024
AS INSERT INTO ONCE
  registration_events_raw BY NAME
SELECT * FROM read_files(
  "/Volumes/gc/demo/apps_raw/event_registration/year=2024/*/*",
  format => "json",
  inferColumnTypes => true
);

-- one time backfill 2023
CREATE FLOW
  registration_events_raw_backfill_2023
AS INSERT INTO ONCE
  registration_events_raw BY NAME
SELECT * FROM read_files(
  "/Volumes/gc/demo/apps_raw/event_registration/year=2023/*/*",
  format => "json",
  inferColumnTypes => true
);

-- one time backfill 2022
CREATE FLOW
  registration_events_raw_backfill_2022
AS INSERT INTO ONCE
  registration_events_raw BY NAME
SELECT * FROM read_files(
  "/Volumes/gc/demo/apps_raw/event_registration/year=2022/*/*",
  format => "json",
  inferColumnTypes => true
);
この実装では、いくつかの重要なパターンが強調表示されています。
懸念事項の分離
- 増分処理は、バックフィル操作とは無関係です。
- 各フローには、独自の構成と最適化の設定があります。
- 増分操作とバックフィル操作には明確な違いがあります。
制御された実行
-
ONCEオプションを使用すると、各バックフィルが 1 回だけ実行されます。 - バックフィル フローはパイプライン グラフに残りますが、完了するとアイドル状態になります。 完全更新時に自動的に使用する準備が整いました。
- パイプライン定義には、バックフィル操作の明確な監査証跡があります。
処理の最適化
- 処理を高速化したり、処理を制御したりするために、大きなバックフィルを複数の小さなバックフィルに分割できます。
- 拡張自動スケーリングを使用すると、現在のクラスターの負荷に基づいてクラスター サイズが動的にスケーリングされます。
スキーマの進化
-
schemaEvolutionMode="addNewColumns"を使用すると、スキーマの変更が適切に処理されます。 - 履歴データと現在のデータ間で一貫したスキーマ推論が行われます。
- 新しいデータでは、新しい列が安全に処理されます。
AUTO CDC SCD Type 1テーブルにバックフィルを追加
ワンタイムの AUTO CDC FROM SNAPSHOT フローを使って、SCD Type 1 ターゲットに権威あるスナップショットを追加し、そのターゲットは継続的な変更データキャプチャ(CDC)フィードも受け取ります。 スナップショットバージョンとCDCシーケンスカラムは一つの順序ドメインを形成します。 新しいCDCイベントは古いスナップショットより優先され、新しいスナップショットは古いCDCイベントより優先されます。
Requirements
埋め戻しを追加する前に、フローが以下の要件を満たしているか確認してください:
- ターゲットはSCDタイプ1を使用しています。
- ターゲットは正確に1つの
AUTO CDC FROM SNAPSHOTフローと、1つ以上の一意な名前のAUTO CDCフローを持ちます。 - すべてのフローは同じ順序で同じ数のキーを使用します。 スナップショットフローキーネームは
AUTO CDCキーネームと大文字と小文字を区別せずに比較されます。 複数のAUTO CDCフローは同一のキー名とケーシングを使用しなければなりません。 - スナップショットバージョンと各CDCシーケンス列はまったく同じデータ型を持ちます。
-
AUTO CDC FROM SNAPSHOTの流れが想定を定義するわけではありません。 -
AUTO CDCフローはIGNORE NULL UPDATESを使いません。 Pythonでは、ignore_null_updates、ignore_null_updates_column_list、ignore_null_updates_except_column_listを設定しないでください。 - パイプラインはトリガーモードを使用します。 このパターンは連続パイプラインをサポートしません。
両方のフロータイプはSQLまたはPythonパイプラインインターフェースを使用できます。 SQLとPythonのフローを同じターゲット内で混ぜることができます。
スナップショットはソースのバージョンにおける完全な状態を表現しなければなりません。 ターゲットキーがスナップショットに欠けている場合、 AUTO CDC FROM SNAPSHOT はスナップショットバージョンでの削除として扱います。 新しいバージョンを持つ CDC イベントはキーを保持または復元します。
backfill を追加する
ワンタイムスナップショットバックフィルを追加し、CDCイベントの処理を続けるには、以下の手順をご利用ください。
- 既存のターゲットテーブルとその進行中の
AUTO CDCフローをパイプライン定義に保持してください。 - 権威あるスナップショットとそのバージョンを定義してください。 Pythonのコールバックでは、最初の呼び出しでスナップショットとバージョンを返す必要があります。 少なくとも1つのスナップショットが処理された後にのみ
Noneを戻してください。 - Python の
once=Trueまたは SQL のONCEを使用してAUTO CDC FROM SNAPSHOTフローを 1 つ追加します。 既存のターゲットにSQLバックフィルを行う場合は、WITH VERSIONクエリを含めてください。WITH VERSIONなしのSQLスナップショットフローは、空のターゲットへの初期ロードのみをサポートします。 - トリガー付きパイプライン更新を実行し、バックフィルと進行中のCDCイベントを処理します。
以下の例は、既存のPythonパイプラインを前提としており、customers_cdcからの変更を段階的に処理しています。 既にこのパイプラインを実行し、customers ターゲットを入力しているとと仮定します。
from pyspark import pipelines as dp
from pyspark.sql.functions import col, expr

@dp.view
def customers_cdc():
    return (
        spark.readStream.table("main.bronze.customers_cdc")
        .withColumn("change_timestamp", col("change_timestamp").cast("timestamp"))
    )


dp.create_streaming_table("customers")

dp.create_auto_cdc_flow(
    name="customers_incremental_cdc",
    target="customers",
    source="customers_cdc",
    keys=["customer_id"],
    sequence_by=col("change_timestamp"),
    apply_as_deletes=expr("operation = 'DELETE'"),
    except_column_list=["operation", "change_timestamp"],
    stored_as_scd_type=1,
)
2025年1月1日時点の customers_snapshot の状態で既存のターゲットを補填するために、同じパイプライン定義に以下のコードを追加します。 既存のターゲットテーブルと AUTO CDC フローを維持:
from datetime import datetime, timezone
from typing import Optional, Tuple

from pyspark.sql import DataFrame

backfill_version = datetime(2025, 1, 1, tzinfo=timezone.utc)


def backfill_snapshot_and_version(
    latest_snapshot_version: Optional[datetime],
) -> Optional[Tuple[DataFrame, datetime]]:
    if latest_snapshot_version is None:
        return (spark.read.table("main.legacy.customers_snapshot"), backfill_version)
    return None


dp.create_auto_cdc_from_snapshot_flow(
    target="customers",
    source=backfill_snapshot_and_version,
    keys=["customer_id"],
    stored_as_scd_type=1,
    once=True,
)
コールバックは最初の呼び出し時にスナップショットとバージョンを返す必要があります。 スナップショットが処理される前に None を返すと、パイプラインの更新は失敗します。 スナップショットが処理された後、 None を返すことで追加のスナップショットが利用できないことを示します。
スナップショットバージョンはPython datetimeであり、Spark SQLのTIMESTAMP型に対応します。 既存の AUTO CDC フローは change_timestamp を TIMESTAMP にキャストし、2つのシーケンスタイプが完全に一致するようにします。 例では両方のフローにPythonを使っていますが、どちらのフローもSQLで定義し、同じターゲット内でSQLとPythonフローを混ぜることができます。 SQL構文については、空でないターゲットに対する必要な WITH VERSION クエリを含め、「 CREATE FLOW (pipelines)」を参照してください。
スナップショット フローが正常にコミットされた後は、その後の増分更新ではスキップされ、AUTO CDC フローは新しいイベントの処理を続けます。
Important
ターゲットのフルリフレッシュはワンタイムスナップショットフローを再実行します。 スナップショットを常に利用可能にし、完全なリフレッシュを行う前に意図した状態を反映していることを確認しましょう。
この統一バックフィルパターンはSCDタイプ2やバイタイムターゲットをサポートしていません。
例:移行時にSCDターゲットをバックフィルする
一般的な移行シナリオとしては、レガシーシステムにすでに存在し、長年にわたる履歴を持つゆっくり変化する次元(SCD)テーブルが、元の変更フィードがもう利用できなくなっていることです。 元の変更イベントが消えているため、代わりにレガシー テーブルの履歴を新しい AUTO CDC ターゲットに一度再生してから、新しい CDC フィードをアタッチします。
AUTO CDCおよびSCDタイプの詳細については、The AUTO CDC APIS: Streamify Change Data capture with pipelines(自動CDC API:パイプラインによる変更データキャプチャの簡素化)をご覧ください。
このパターンは、進行中のAUTO CDCフローがターゲットとする同じストリーミングテーブルに一度だけAUTO CDCフローを流すものです。
AUTO CDCターゲットはAUTO CDC流れのみを受け入れるため、シードもAUTO CDCフローでなければなりません。 同じテーブルに単純な INSERT INTO ONCE 付加フローは検証に失敗します:
-
AUTO CDCフローが書き込むターゲットストリームテーブルを作成します。 -
レガシー履歴を一度シードします。その際、レガシー SCD テーブルをストリームとして読み取り、レガシー有効開始列で順序付けする
AUTO CDC ONCEフローを使用します。 既存の行を、自分で整形するのではなく、変更イベントとして再生しましょう。AUTO CDCSCDタイプ2ターゲットの__START_ATおよび__END_AT履歴列を作成するため、それらの列を直接書かないでください。 -
最新の変更フィードを読み取る進行中の
AUTO CDCフローをアタッチしてください。AUTO CDCキーごとの順序を解決するため、各ビジネスキーごとにカットオーバーが成り立つ必要があります。各キーの最初のライブ変更は、同じキーの最後にシードされた変更の後にシーケンスされなければなりません。 グローバル・レガシー最大値より単に遅いだけのシーケンス値でも、個々のキーでは古い状態になり得ます。そのキーの最初のライブ変更は無視されたり、順序が誤りになったりします。
以下のコードは上記の手順を用いたストリーミングテーブルを作成します。
CREATE OR REFRESH STREAMING TABLE customers_history;

-- One-time seed: replay the legacy history as change events
CREATE FLOW customers_history_seed
AS AUTO CDC ONCE INTO customers_history
FROM stream(legacy.customers_scd2)
KEYS (customer_id)
SEQUENCE BY valid_from
STORED AS SCD TYPE 2;

-- Ongoing live CDC into the same target
CREATE FLOW customers_history_cdc
AS AUTO CDC INTO customers_history
FROM stream(customers_cdc_bronze)
KEYS (customer_id)
SEQUENCE BY change_timestamp
STORED AS SCD TYPE 2;
両フローはキー、SCDタイプ、シーケンスカラムのデータ型で合意しなければなりません。 前述の例では、両方のフローがタイムスタンプでシーケンスされており、単一のカットオーバー時間でシード履歴とライブフィードを分離しています。 もしレガシーテーブルがライブフィードとは異なるタイプの値でシーケンスされるなら、タイプが一致するようにそのうちの1つをキャストしてください。
同じ形状はSCDタイプ1ターゲットにも適用されます。両方のフローで STORED AS SCD TYPE 2 を STORED AS SCD TYPE 1 に変更し、ターゲットはキーごとに現在の行だけを保持します。 どちらの形状にも依存する前に、シードキーの最初のライブ変更が正確に1つの新しいバージョンを生成し、前のバージョンを正しく閉じることを、キーのサンプルで検証してください。 通常、その段階でキーごとのシーケンスのずれが見られます。