Unity カタログに格納されているフィーチャー ビュー定義を作成したら、機能定義を使用してソース テーブルからフィーチャ データを生成できます。 このプロセスは、特徴の具体化と呼ばれます。 Azure Databricksは、モデルのトレーニングとバッチ スコアリングまたはオンライン サービスのために Unity カタログのテーブルを設定する Lakeflow パイプラインを作成および管理します。
フィーチャ ビューの提供の詳細については、「フィーチャ ビューを 提供する」を参照してください。
過去のソースデータを修正または追加した後にマテリアライズド値を再計算するには、バックフィル フィーチャー ビューを参照してください。
選択したエンティティのマテリアライズされた値を削除するには、エンティティのフィーチャー値の削除を参照してください。
Requirements
- フィーチャーはフィーチャー ビューとして作成し、Unity カタログに格納する必要があります。
- バージョン要件については「要件」を参照してください。
特徴タイプ別のマテリアライゼーションサポート
特徴がどこで具現化できるかは、そのタイプによって異なります。
-
ColumnSelection機能は、オンライン ストアに具体化できます。 ColumnSelection の具体化を参照してください。 -
RollingWindowを使った一括生産Last機能はオンラインストアに具現化可能です。 「 Materialize」の鮮度制限の最新値をご参照ください。 -
RequestSource、FeatureViewSource、およびCustomUDF特徴は物質化できません。 オンデマンド機能とマテリアライズを参照してください。
オンラインストアにのみ現れる機能はオフラインでも使えます。 create_training_set と compute_features はソースから直接時点値を計算するため、オフラインのマテリアル化は不要です。
ColumnSelection の具体化
ColumnSelection 機能は、集計なしでエンティティ キーごとに 1 つの列の最新の値を選択します。 これらは、オンライン ストアにのみ具体化できます。 オフラインユース ケース (トレーニングとバッチ推論) の場合、 ColumnSelection 機能はクエリ時にソース データから直接フェッチされるため、オフライン具体化は必要ありません。
具体化の動作
- パイプラインは、エンティティ キーごとの最新の行を集計ウィンドウなしでオンライン テーブルに書き込みます。
- オンラインマテリアライズにより、オンライン テーブルにエンティティ キーごとの現在の最新の値が設定されます。
例
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import (
    DeltaTableSource, Feature, ColumnSelection, TableTrigger, OnlineStoreConfig,
)

fe = FeatureEngineeringClient()

delta_source = DeltaTableSource(
    catalog_name="catalog",
    schema_name="schema",
    table_name="transactions",
)

amount_feature = Feature(
    source=delta_source,
    function=ColumnSelection("amount"),
    entity=["user_id"],
    timeseries_column="transaction_time",
    name="latest_transaction_amount",
)

# Register before materializing
amount_feature = fe.register_feature(
    feature=amount_feature,
    catalog_name="catalog",
    schema_name="schema",
)

mfs = fe.materialize_features(
    features=[amount_feature],
    online_config=OnlineStoreConfig(
        catalog_name="catalog",
        schema_name="feats_online",
        table_name_prefix="txn_",
        online_store_name="lb_usw2"
    ),
    trigger=TableTrigger(),
)
ColumnSelection 機能は、ソース Delta テーブルが新しいコミットを受信するたびにパイプラインを実行する TableTriggerを使用します。
offline_config機能はオフライン ユース ケース (トレーニングとバッチ推論) のためにソースから直接読み取われるため、ColumnSelectionは必要ありません。
Note
RequestSource 特徴は、推論時に呼び出し元によって提供されたデータ (またはトレーニング時にラベル付けされた DataFrame から抽出される) を表しているため、具体化できません。 読み取り元のソース テーブルがありません。 値は、要求ペイロードまたはトレーニング DataFrame にのみ存在します。
新鮮度に限定された最新値を具現化する
RollingWindowを使ったバッチLast集約は、オンライン機能にタイム・トゥ・ライブ(TTL)を与えます。すなわち、ソース値がウィンドウ内に収まらなければオンラインストアからその価値が切れます。 これは、価値の年齢がその価値の安全性を決定する場合に有用です。 例えば、直近1時間のデバイス状態を処理し、古い状態は無期限に利用可能ではなくnullに解決されます。
RollingWindowは、特徴にTTLに似た挙動を与える明示的な持続時間を定義します。 例えば、ソースが毎日値を公開し、過去7日間の値だけを保持したい場合は、7日間の期間を持つ RollingWindow を使いましょう。 各トリガーで、マテリアライゼーションはオンラインテーブルを完全に置き換え、ウィンドウ外の値は予測可能なスケジュールで削除されます。 これにより、RollingWindowを使ったストリーミングLastと同じ結果が得られますが、計算を連続的に実行しないためコストが低くなります。
この公開パターンは、スナップショットモードで公開されるTTLを持つ特徴テーブルに似ています。 もし特徴テーブルのセットを維持し、他の機能ビューと併用したい場合は、それらを特徴ビュー作成フレームワークに適応させることができます。
RollingWindowとTableTriggerを使ったバッチLastを使いましょう。
この組み合わせには、以下の要件を満たす特別なオンライン専用のママリゼーションモードがあります:
- その源は
DeltaTableSourceに違いない。 - 集約関数は
Lastでなければならず、そのウィンドウはRollingWindowでなければなりません。 - マテリアライゼーションは
OnlineStoreConfigを提供し、OfflineStoreConfigを省略し、TableTriggerを使わなければなりません。
以下の例では、 latest_device_state_1h は以下の要件を満たす登録フィーチャーです。
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import OnlineStoreConfig, TableTrigger

fe = FeatureEngineeringClient()

materialized = fe.materialize_features(
    features=[latest_device_state_1h],
    online_config=OnlineStoreConfig(
        catalog_name="main",
        schema_name="feature_store",
        table_name_prefix="latest_device_state_serving",
        online_store_name="device_state_store",
    ),
    trigger=TableTrigger(),
)
オフライントレーニングやバッチスコアリングの場合、フィーチャーエンジニアリングクライアントはソースから直接時点値を計算します。 この機能のオフラインの物質化は読み取れません。
考慮事項
- 有効期限が更新されるのは、トリガーされた場合のみです。 ソーステーブルのコミットによってマテリアライゼーションのリフレッシュがトリガーされると、オンライン値は更新され、その有効期限は延長されます。 時間の経過だけではリフレッシュは起こりません。 ソースが公開を停止した場合、最後に物質化された値はオンラインストアに残り、後のコミットでリフレッシュが発生します。
- タイムシリーズの列をソースの公開時間に合わせます。 時系列列は、データソースがデータを公開した時期を反映しなければなりません。 そうでない場合、オンラインとオフラインの値は乖離します。これは、オンラインストアではトリガー時刻で結合される一方、オフラインでの読み取り時にはタイムシリーズ時刻で結合されるためです。
- ウィンドウの持続時間を公開のリズムの倍数に設定してください。
RollingWindowの持続時間がソースの公開頻度の倍数でない場合、オフライントレーニング中にオンライン上でまだ表示されている値を有効期限とみなします。
オンデマンド機能とマテリアル化
RequestSource 値はトレーニング中のDataFrameや推論リクエストから来るため、ソーステーブルを生成できません。
FeatureViewSource 特徴量は、トレーニング中またはサービス提供中に、上流の特徴量に CustomUDF を適用します。 事前に計算された結果を保存しません。 Deltaテーブルを基盤とする CustomUDF 機能でもマテリアライゼーションはサポートされていません。
revenue_sum_7dやcost_sum_7dのような依存グラフがmargin特徴に供給する場合:
- オフライン トレーニングの場合は、
create_training_setを使用してmarginを呼び出します。 上流の特徴を解決し、利用可能な場合に互換性のあるオフラインマテリアライゼーションを用いて時点値を計算します。 - オンラインサービスについては、サポートされた収益とコスト機能をオンラインストアに提供してください。 エンドポイントはそれらを検索し、各リクエストごとに
marginを計算します。 -
marginやリクエストバック機能ではなく、サポートされている上流機能のみをmaterialize_featuresに渡してください。 物質化は派生した特徴の依存関係を再帰的に物質化するものではありません。
リクエストバック機能のみを使用するグラフはオンラインストアを必要としません。 FeatureViewSource 特徴量を使ってトレーニングするおよび導出特徴量を提供するを参照してください。
Permissions
マテリアライゼーションには、フィーチャーおよびソースおよびデスティネーションリソースに対する権限が必要です。 Unity Catalogの特権に関する詳細な説明については、 Unity Catalog Privileges referenceを参照してください。
フィーチャーを具体化するには、
MANAGEが必要です。materialize_featuresを呼び出すことで、LakeflowパイプラインやUnity Catalogテーブルが作成され管理されるため、管理操作となります。 機能にはMANAGEが必要です。さらに、具体化される機能定義を読むにはREAD FEATUREも必要です。物質化された特徴の削除は、その作成者に限定されます。 マティビリズド機能を作成したユーザーだけが
delete_materialized_featureで削除できます。 この制限はUnityカタログの権限とは独立しており、機能や親スキーマの上MANAGEは他のユーザーが削除できません。ソースデータを読むには
SELECTが必要です。 Deltaテーブルソースを使用する機能の場合、ソーステーブルにSELECTが必要です。 Stream ソースを使用する機能では、Stream の取り込みテーブルにSELECTが設定されている必要があります。ストリームの認証設定に必要なその他の権限については、 Kafka認証を参照してください。
宛先テーブルの作成には
CREATE TABLEが必要です。OfflineStoreConfigまたはOnlineStoreConfigで指定されたすべてのスキーマにCREATE TABLEが必要です。 オフラインとオンラインの宛先は異なるスキーマやカタログに存在し、マテリアライゼーションにはそれぞれの宛先に権限が必要です。オンラインストアに出店するには、
CAN USEが必要です。 オンラインストアで使われているLakebaseのインスタンスやプロジェクトにCAN USEがある必要があります。 Lakebaseの許可に関する情報は「 助成プロジェクト許可」をご覧ください。具象化された特徴をリストアップするには親の特徴
READ FEATUREが必要です。list_materialized_featuresを使用するには、具体化された機能でREAD FEATUREを使用している必要があります。具体化されたデータを読み取るには、
SELECTが必要です。 アクセスするすべてのオフラインまたはオンライン出力テーブルにSELECTが必要です。READ FEATURE親機能ではこれらのテーブルへのアクセスは許されません。
マテリアライゼーションに関わるUnityカタログリソースごとに、親カタログに USE CATALOG 、親スキーマにも USE SCHEMA が必要です。 この要件は機能、各ソースまたはストリームの取り込みテーブル、そして設定された各宛先に適用されます。
READ FEATURE と MANAGE をスキーマまたはカタログに対して付与すると、その中に現在含まれるすべてのオブジェクトと今後含まれるすべてのオブジェクトに適用されます。
API データ構造
OfflineStoreConfig
具体化された機能が書き込まれるオフライン ストアの構成。
materialize_featuresが呼び出されると、このプレフィックスを使用してフィーチャ ストア バックエンドによってテーブルが作成されます。 各パイプライン実行では、具体化スケジュールに従って、最新の特徴値がテーブルに具体化されます。
OfflineStoreConfig(
    catalog_name: str,        # Catalog name for the offline table where materialized features will be stored
    schema_name: str,         # Schema name for the offline table
    table_name_prefix: str    # Table name prefix for the offline table. The pipeline may create multiple tables with this prefix, each updated at different cadences
)
from databricks.feature_engineering.entities import OfflineStoreConfig

offline_store = OfflineStoreConfig(
    catalog_name="main",
    schema_name="feature_store",
    table_name_prefix="customer_features"
)
OnlineStoreConfig
モデル サービスによって使用される機能を格納するオンライン ストアの構成。 具体化では、 catalog.schema.table_name_prefixを持つ Delta テーブルが作成され、同じ名前のオンライン フィーチャー ストアにテーブルがストリーム配信されます。
from databricks.feature_engineering.entities import OnlineStoreConfig

online_store = OnlineStoreConfig(
    catalog_name="main",
    schema_name="feature_store",
    table_name_prefix="customer_features_serving",
    online_store_name="customer_features_store"
)
MaterializedFeature
具体化されたフィーチャー ビュー、つまり Unity カタログで使用可能な事前計算済みの表現を表します。 オフライン テーブルとオンライン テーブルには、個別の具体化された機能があります。 通常、 MaterializedFeature を直接インスタンス化することはしません。
latest_backfill_operation フィールドには、実体化されたフィーチャーの最新のバックフィル名が格納されます。 詳細は、バックフィル フィーチャー ビューを参照してください。
API 関数呼び出し
materialize_features()
フィーチャ ビューのリストをオフラインの Delta テーブルまたはオンライン フィーチャ ストアに具体化します。 この関数を呼び出す前に、機能を Unity カタログに登録する必要があります (たとえば、 create_feature や register_featureを使用)。 登録されていないローカルで構築された機能は機能しません。
FeatureEngineeringClient.materialize_features(
    *,                                                                     # Arguments are keyword-only
    features: List[Feature],                                               # List of Feature Views to materialize
    offline_config: Optional[OfflineStoreConfig] = None,                   # Offline store config (aggregation features only)
    online_config: Optional[OnlineStoreConfig] = None,                     # Online store config
    trigger: Union[CronSchedule, TableTrigger, StreamingMode],             # Materialization trigger
    tags: Optional[Dict[str, str]] = None,                                 # Custom tags for cost attribution
    budget_policy_id: Optional[str] = None,                                # Serverless usage policy for cost attribution
) -> List[MaterializedFeature]:
このメソッドは、マテリアライズド機能の一覧を返します。このリストには、機能値が更新されるタイミングに関するメタデータと、特徴が具体化される Unity カタログ テーブルが含まれます。
OnlineStoreConfigとOfflineStoreConfigの両方が指定されている場合は、提供された機能ごとに 2 つの具体化された特徴が返されます。1 つはストアの種類ごとに 1 つです。
trigger パラメーターは、具体化パイプラインを実行するタイミングを制御します。
-
CronSchedule: 機能のタイミングに基づいて作成されたスケジュール、または呼び出し元が指定した Quartz の cron スケジュールで実行されます。 バッチ集約機能(AggregationFunctionDeltaTableSource)に対応しています。 -
TableTrigger: アップストリームの Delta テーブルがコミットを受け取ったときに実行されます。ColumnSelection機能および集約機能(AggregationFunction)をサポートし、DeltaTableSourceによって裏付けられています。 アグリゲーション機能では、パイプラインは機能の粒度の半分(スライドウィンドウの場合はスライド時間、タンブリングウィンドウの場合はウィンドウ長)に最大1回しか動作せず、1時間に制限され、5分ごとに1回以上は動作しません。 例えば、1時間の細かさなら最大30分に1回、2時間以上の細かい分量なら最大1時間に1回です。 この間隔は前回の実行から測定されるため、経過後に到達したコミットでもすぐに実行が発生します。 -
StreamingMode: 継続的ストリーミング パイプラインとして実行されます。StreamSourceによってサポートされる機能に必要です。
1 回の materialize_features 呼び出しで異なるトリガーの種類を必要とする機能を混在することはできません。 代わりに個別の呼び出しを発行します。
マテリアライゼーションのコストを算出するには、 tags、 budget_policy_id、または両方をパスしてください。 Azure Databricksは作成したジョブやパイプラインにそれらを適用し、支出が請求可能使用システムテーブルにあなたの帰属を反映させます。 どちらも創造時に適用されるため、既存の物質化を異なる形で帰属させることは新しい物質化を創造することを意味します。
budget_policy_id サーバーレス使用ポリシーのIDを取得します。 作成してIDを取得するには、「 サーバーレス使用ポリシーの作成」をご覧ください。 タグの制限、各値が到達するリソース、そして帰属された支出の照会方法については、 Feature Storeのコスト管理を参照してください。
オフライン ストアに具体化する
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import (
    CronSchedule, OfflineStoreConfig,
)

fe = FeatureEngineeringClient()

materialized = fe.materialize_features(
    features=features,
    offline_config=OfflineStoreConfig(
        catalog_name="main",
        schema_name="feature_store",
        table_name_prefix="customer_features"
    ),
    trigger=CronSchedule(
        quartz_cron_expression="0 0 * * * ?",  # Hourly
        timezone_id="UTC",
    ),
)
オンライン ストアに具体化する
Note
ほとんどの集約機能をオンラインストアに具現化するには、オフラインストアにもマシリングする必要があります。
offline_configとonline_configの両方が必要です。
online_store_nameは、既存のオンライン フィーチャ ストアを参照する必要があります。 作成手順については、「 Databricks Online Feature Stores」を参照してください。
ColumnSelection 機能には OfflineStoreConfigは必要ありません。
ColumnSelection の具体化を参照してください。
特別ケース付きのバッチ・LastRollingWindowもオンラインのみです。 「 Materialize」の鮮度制限の最新値をご参照ください。
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import (
    CronSchedule, OfflineStoreConfig, OnlineStoreConfig,
)

fe = FeatureEngineeringClient()

materialized = fe.materialize_features(
    features=features,
    offline_config=OfflineStoreConfig(
        catalog_name="main",
        schema_name="feature_store",
        table_name_prefix="customer_features"
    ),
    online_config=OnlineStoreConfig(
        catalog_name="main",
        schema_name="feature_store",
        table_name_prefix="customer_features_serving",
        online_store_name="customer_features_store"
    ),
    trigger=CronSchedule(
        quartz_cron_expression="0 0 * * * ?",  # Hourly
        timezone_id="UTC",
    ),
)
ストリーミング機能を具体化する
ストリーミング機能は、オンライン ストアにのみ具体化できます。 offline_config パラメーターはサポートされていません。 ストリーミング機能では、サブ秒の鮮度を確保するためにリアルタイム パイプラインが必要であるため、オフライン具体化はサポートされていません。 オフライントレーニングまたは評価の場合、特徴エンジニアリング クライアントは、評価された各データ ポイントに基づいて特徴の値を再計算します。
ストリーミング機能は、同じ materialize_features 呼び出しのバッチ機能と混在させることはできません。
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import (
    OnlineStoreConfig, StreamingMode,
)

fe = FeatureEngineeringClient()

materialized = fe.materialize_features(
    features=[streaming_feature],
    online_config=OnlineStoreConfig(
        catalog_name="my_catalog",
        schema_name="my_schema",
        table_name_prefix="streaming_features_serving",
        online_store_name="feature_store_online"
    ),
    trigger=StreamingMode(),
)
list_materialized_features()
完全な名前で識別される 1 つの特徴の具体化を返します。
feature_name は必須であり、キーワードのみです。 多くの機能の具体化を確認するには、まずカタログまたはスキーマ内の機能を一覧表示してから、返された各機能に対して list_materialized_features を呼び出します。
既定では、最大 100 個の具体化が返されます。 この制限は、 max_results パラメーターを使用して変更できます。
FeatureEngineeringClient.list_materialized_features(
    *,                                      # Arguments are keyword-only
    feature_name: str,                      # Required: full name of the feature whose materializations to list
    max_results: int = 100,                 # Maximum number of materializations to return
) -> List[MaterializedFeature]:
delete_materialized_feature()
具体化されたフィーチャーを削除する前に、フィーチャーを参照するモデルまたはフィーチャー スペックを削除または更新します。
具体化されたフィーチャーを削除します。 どの機能を渡すかは、機能の種類によって決まります。
-
集計機能: オフラインマテリアライズド機能を渡します。 同じ機能に対してオンラインで具体化された機能がある場合、両方が削除されます。
RollingWindowを持つオンライン専用のバッチLast特徴量については、オンラインのマテリアライズド特徴量を渡します。 -
ColumnSelection機能: オンライン マテリアライズド機能を渡します。ColumnSelection機能はオンライン ストアにのみ具体化されるため ( ColumnSelection の具体化を参照)、ペアのオフライン機能はありません。
具体化の一環として、特徴は効率を高めるデータ ソースと集計ウィンドウごとにグループ化されます。
ColumnSelection 機能には集計ウィンドウがないため、データ ソースによってのみグループ化されます。 具体化パイプライン、オフライン テーブル、およびオンライン テーブルは、グループ化されたすべての機能が削除されるまで削除されません。 グループ内の最後の具体化されたフィーチャーが削除されると、機能ストアは、バックグラウンド プロセスによる自動クリーンアップのために関連するリソースをスケジュールします。
「バックグラウンド リソースのクリーンアップ」を参照してください。
具体化された機能をクリーンアップするには、その具体化された機能に関連付けられたテーブルを確認します。 コンピューティング テーブルリソースと Delta テーブル リソースがクリーンアップされる前に、テーブル内の各機能 (列ごとに 1 つ) を削除する必要があります。
list_materialized_features()を使用して、materialized_feature引数を取得します。
FeatureEngineeringClient.delete_materialized_feature(
    materialized_feature: MaterializedFeature,  # Required: The materialized feature to delete
) -> None
from databricks.feature_engineering import FeatureEngineeringClient

fe = FeatureEngineeringClient()

feature_names = [
    "main.feature_store.amount_sum_sliding_7d_1d",
    "main.feature_store.amount_sum_sliding_30d_1d",
    "main.feature_store.transaction_count_sliding_7d_1d",
    "main.feature_store.latest_transaction_amount",
    "main.feature_store.latest_user_tier",
]

for name in feature_names:
    mfs = fe.list_materialized_features(feature_name=name)   # required, keyword-only
    offline = [mf for mf in mfs if not mf.is_online]
    for mf in (offline or mfs):
        fe.delete_materialized_feature(materialized_feature=mf)
    fe.delete_feature(full_name=name)
バックグラウンド リソースのクリーンアップ
具体化されたフィーチャーを削除すると、Databricks は機能メタデータを直ちに削除します。 関連付けられているインフラストラクチャ (テーブル、パイプライン、ジョブ) は、バックグラウンド プロセスによって非同期的にクリーンアップされます。
複数の具体化されたフィーチャーが同じテーブルとパイプラインを共有できるため、これらの共有リソースは、それらを参照するすべての具体化されたフィーチャーが削除されるまで削除されません。 テーブルのセットを共有する最後の具体化された機能が削除されると、バックグラウンド プロセスによって次のリソースが自動的に削除されます。
- 具体化された特徴データを含むオフラインの Delta テーブル
- オンライン テーブル (機能がオンライン ストアに具体化された場合)
- マテリアライズ パイプライン
- オーケストレーションジョブ
このバックグラウンド プロセスでは、Databricks で管理されるシステム サービス プリンシパルを使用して、ワークスペース内のテーブル、パイプライン、ジョブの削除など、これらのクリーンアップ アクションをユーザーに代わって実行します。 ユーザーからの操作は必要ありません。 クリーンアップは、機能ストアによって完全に管理されます。
Note
グループ内の最後の具体化されたフィーチャーを削除してから、関連付けられているテーブルやその他のリソースを削除するまでに、少し時間がかかる場合があります。
マテリアライズのステータスを表示
Databricks UIでフィーチャービューのマテリアル化状態を確認し、マテリアル化エラーをデバッグするには、 Unity CatalogのExplore Feature Viewをご覧ください。
RollingWindowのエンドツーエンドの最新性を検証する
Note
フレッシュネス検証はパブリックプレビュー中の Lakebase Change Data Feed(CDF)を使用します。 CDF を有効にする前に、ワークスペース管理者が Lakebase Change Data Feed プレビューを有効にしておく必要があります。
このセクションは RollingWindow 集計のみに適用されます。 バッチ機能はここで説明したストリーミングの新鮮度メタデータを公開しません。
Lakebase のオンライン ストアにマテリアライズされたストリーミング RollingWindow 機能には、行ごとの鮮度メタデータが含まれます。 CDFでは、オンラインテーブルのすべての更新をUnityカタログのDelta履歴テーブルに記録し、追加のパイプラインを使わずにエンドツーエンドの新鮮さを測定できます。 エンド ツー エンドの鮮度とは、イベントが発生した時点からその集計値が提供可能になった時点までの遅延を指します。
RollingWindowの機能が行を出力する方法
RollingWindow機能の場合、各エンティティの値は固定された時間枠内のイベント(例:直近1時間の取引件数)を要約します。 ウィンドウは連続的に先へ移動するため、2 つの状況でオンライン ストアに行が書き込まれます:
-
データ駆動型更新 (
is_timer=false):新しいイベントが到着し、集計を更新します。 行はウィンドウ内の最新のイベントを反映しています。 -
ウィンドウの有効期限 (
is_timer=true): 新しいイベントは届きませんが、時間が進み、最も古いイベントがウィンドウの範囲外になるか、期限切れになります。これらのイベントは集計にカウントされなくなり、値が変化 (カウントの減少など) するため、この機能はタイマーで更新行を出力します。 この行は、最も古いイベントが期限切れになった瞬間、つまりそのイベントのウィンドウの終了を反映しています。
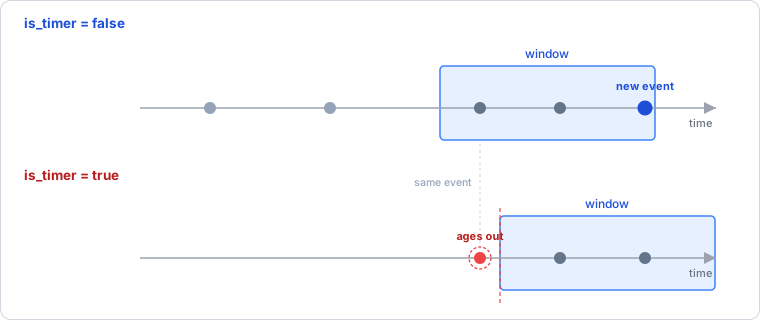
どちらの場合も、event_time は行を生成した変更 (新しいイベントの到着、または最も古いイベントの期限切れ) が起きた時点です。つまり、commit_time - event_time は、行がどのように送信されたかに関係なく、その鮮度を示します。
鮮度メタデータ
オンライン ストリーミングの各行には以下の列が含まれます:
| Column | Description |
|---|---|
event_time |
その行を生成した変更が発生した時です。 データ主導型更新 (is_timer = false) では、ウィンドウ内の最も直近 (最大) のイベント時間。 ウィンドウの終了更新(is_timer = true)では、最も古いイベントがウィンドウ外になった時刻: そのイベントの時刻にウィンドウ期間を加えた時刻です。 オンライン テーブルに異なるウィンドウの期間を持つ機能が存在する場合、期限切れになったウィンドウが使用されます。 |
output_time |
出力時のストリーミングウィンドウフロンティア(ウォーターマーク)。 |
is_timer |
行の発行方法: false = 新たに到着したイベントが集計を進めた(データ駆動); true = タイマーでウィンドウが進み、最も古いデータが時間経過でウィンドウから除外された(ウィンドウの期限切れ)。 |
commit_time |
その行がLakebaseオンラインストアに書き込まれたとき。 |
CDFを有効にすると、各変更はCDFメタデータ列を含む lb_<online_table>_history デルタテーブルに付加されます。
_pg_change_type列(insert、update_preimage、update_postimage、またはdelete)は各変更タイプを識別します。
オンラインテーブルでCDFを有効にする
Warning
CDFは、パイプラインのテストや設定調整の際にエンドツーエンドの鮮度を検証するために使用すべきであり、本番環境のオンラインストアで鮮度を継続的に監視するために使用するものではありません。 CDF と REPLICA IDENTITY FULL は Lakebase インスタンスに負荷を追加します。主に、変更をデコードするための CPU と追加の先書きログのボリュームです。 オーバーヘッドは、同期するテーブルの数に応じて、および配列やマップなどの大きな列値に応じて増加します。 本番トラフィックに対応するオンラインストアでCDFを有効にする場合は、最大計算ユニット(CU)を上げて 自動スケーリング の余裕を確保し、CPUとオンラインサービスのレイテンシを監視してください。
Lakebase CDFは、更新が完全な更新前後の行イメージとともにキャプチャされるように、各ソーステーブルでレプリカ ID が
FULLに設定されている必要があります。 オンライン テーブルにそれを設定する:ALTER TABLE <schema>.<online_table> REPLICA IDENTITY FULL;オンラインストア向けのLakebase CDFを開始し、ソーススキーマと宛先のUnity Catalogカタログおよびスキーマを選択します。 セットアップの詳細は Lakebase Change Data Feedをご覧ください。
CDF は対象スキーマで lb_<online_table>_history を作成します。
変更のキャプチャを停止するには、Lakebase CDFを無効にするを参照してください。 CDFを無効にすると、プロジェクト内のすべてのスキーマのフィードが停止します。 CDFを無効にした後、オンラインテーブルのレプリカ識別をリセットして、追加の書き込みログボリュームを除去できます:
ALTER TABLE <schema>.<online_table> REPLICA IDENTITY DEFAULT;
鮮度を計算する
データ主導の行とウィンドウ有効期限の行の両方で、新鮮度は commit_time - event_time です。
is_timerを含めて2つのエミットタイプを比較し、クエリを測定したい期間に絞り込んでください。
SELECT
  event_time,
  commit_time,
  is_timer,
  (unix_micros(commit_time) - unix_micros(event_time)) / 1000 AS feature_freshness_ms
FROM <dest_catalog>.<dest_schema>.lb_<online_table>_history
WHERE _pg_change_type IN ('insert', 'update_postimage')
  AND commit_time >= (
    SELECT max(commit_time) - INTERVAL 1 DAY
    FROM <dest_catalog>.<dest_schema>.lb_<online_table>_history
  );
feature_freshness_ms はイベント時間からオンラインストア書き込みまでの遅延(ミリ秒単位)です。 これは提供できる値の鮮度です。
Note
すでに行があるオンラインテーブルでCDFを有効にすると、初期スナップショットで既存の各行を履歴テーブルに insertとしてコピーします。 各コピーされた行は、そのエンティティの最後の書き込みの event_time と commit_time を保持するため、新鮮度の値は正確ですが、スナップショットは各エンティティごとにちょうど1つのサンプルを寄与します。 フィードでキャプチャされた書き込みのみを測定するには、Lakebase CDF タブのテーブルの状態が Snapshotting から Streaming に変わるのを待ち、時刻を記録して、max(commit_time) - INTERVAL 1 DAY の代わりにそれを下限として使用します。 オンライン テーブルのスキーマ変更は別の完全なスナップショットをトリガーします。それにより、既にキャプチャされたフィードが再度書き込まれます。 すべての insert 行をフィルタリングしないでください。なぜなら、各新しいエンティティの最初の書き込みもまた一つの insertだからです。
結果を解釈する
-
feature_freshness_msのp50とp99の両方を追跡し、データ駆動(is_timer = false)行とウィンドウ期限切れ(is_timer = true)行を比較します。 - リアルタイムモードのバッチ境界(デフォルトで5分)で、パイプラインがチェックポイントとコミットのために一時停止する際に、小さな周期的なスパイクが発生することが予想されます。 これはデフォルトの間隔では通常無視できる程度です。
- まれなロングテール(最大値、p99以降)に注目してください。 これは定常状態ではなく、パイプラインのキャッチアップを反映したものです。特に、メンテナンス再起動などの再起動後にパイプラインがバッファされたイベントを処理する際に顕著になります。 再起動を除外するウィンドウでの定常状態の新鮮さを測定し、再起動時のスパイクを別々に評価します。
制限事項
バッチ機能
- バッチ具体化パイプラインは、サーバーレスの Lakeflow パイプラインとして実行されます。
- バッチのローリングウィンドウ機能は、鮮度制約付きの最新値をマテリアライズするで説明されている、オンライン専用の
Last特別なケースを除き、マテリアライズできません。 オフライントレーニングやバッチ推論では、各ポイントインタイムルックアップのソースデータからローリングウィンドウ特徴量が計算されます。 -
ColumnSelection機能は、オンライン ストアにのみ具体化できます。 -
RequestSource、FeatureViewSource、およびCustomUDF特徴は物質化できません。 オンデマンド機能とマテリアライズを参照してください。 - 具体化された機能は、作成されたワークスペースでのみ削除できます。
- マテリアライズド フィーチャーを削除できるのは、そのフィーチャーまたはその親スキーマに対する Unity Catalog の権限の有無にかかわらず、それを作成したユーザーのみです。
- 具体化された集計機能の場合、オンラインマテリアライズドフィーチャーを直接削除することはできません。 ペアになったオフラインマテリアライズドフィーチャーを削除すると、変更が両方に反映されます。
- 2026 年 4 月 20 日より前に作成された具体化された集計機能の場合、具体化パイプラインでは、パイプライン内のすべての具体化された特徴が削除されるまで新しい特徴値の生成が続行され、リソースのクリーンアップがトリガーされます。 機能ごとの削除をサポートする更新されたパイプラインを作成するには、機能を削除して再具体化します。
- 具体化された
ColumnSelection機能の場合、具体化パイプラインは、パイプライン内のすべての具体化された特徴が削除されるまで新しい機能値の生成を続け、リソースのクリーンアップをトリガーします。
ストリーミング機能
- ストリーミング機能は、オンライン ストアにのみ具体化できます。 トレーニング時のストリーミング機能は、ミリ秒レベルの精度を提供するために、データ ポイントごとの履歴イベントから再計算されるように設計されているため、オフライン具体化は必要ありません。
- ストリーミング機能は、1 回の
materialize_features呼び出しでバッチ機能と混在させることはできません。 -
compute_featuresはストリーミング機能をサポートしていません。 - ワークスペースは、Lakebase インスタンスをサポートするリージョンに存在する必要があります。
- KafkaのメッセージはJSON、Avro、またはProtobufを使用できます。 スキーマ要件およびスキーマレジストリの制限については、 スキーマレジストリを参照してください。
- ストリーミングアグリゲーション機能には
RollingWindowとSawtoothWindowのみがサポートされています。TumblingWindowとSlidingWindowをバッチ機能と共に使用する必要があります。 ストリーミング機能のタイムウィンドウをご覧ください。 - ストリーミング機能には、
Count、Avg、Sum、StddevPop、Max、Min、First、Last、FirstN、LastN、FirstDistinct、LastDistinctアグリゲーション機能のみがサポートされています。 - ストリーミング ソースからの列選択機能では、順序が異なったメッセージは処理されません。 時系列列の値が以前に受信したイベントよりも前の場合でも、Kafka ストリームの最新のイベントが表示されます。
- ストリーミング パイプラインは週に 2 回再起動されます。 再起動するたびに、処理の遅延と起動時間が最大 1 分発生する可能性があります。 再起動を除き、p99 の鮮度は 200 ミリ秒です。
- ストリーミング機能は、
backfill_featuresでバックフィルできません。 学習用の履歴データを追加するには、ストリーム上で バックフィルソース を設定してください。 - オンライン ストアの
RollingWindowフィーチャーは、実体化の開始後に到着するイベントのみを対象としているため、その値が完全になるのは、そのwindow_durationが完全に経過した後になります。SawtoothWindow特徴は、マテリアライゼーション開始時にStreamのインジェストテーブルから過去の値を計算します。 マテリアル化は、後でインジェスションテーブルのデータ修正をしても、それらの値を再計算しません。 - Databricks Online Feature Store のみがサポートされています。
- ストリーミング具体化パイプラインは、サーバーレスの Lakeflow パイプラインとして実行されます。