Important
この機能は ベータ版です。 これを使用するには、ワークスペース管理者が効率的な列更新をプレビューページから有効にする必要があります。 Manage Azure Databricks プレビューを参照してください。
効率的な列更新 (ECU) を使用すると、変更のない列を再書き込みすることなく、Delta Lake テーブルに列を追加し、バックフィルできます。 既存のデータセットに新しい特徴、埋め込み、その他の派生値を入力するために使用できます。
列を追加すると、既存のデータを書き換えることなくテーブルスキーマが変更されます。 その列に値を入力するには、影響を受ける行を含むデータファイルを、変更されていない列も含めて書き換える必要があります。 Efficient Column Updates は、更新された列値を別々の Parquet ファイルに書き込むことで、変更されない列の書き換えを回避します。
これは、大きなペイロードや埋め込みを含むテーブルに少数の列を追加する場合に特に有用です。 クエリは既存のデータと更新された列の値を組み合わせた1つの論理テーブルを返し続けます。
以下の図は、列の追加とバックフィルの比較を示しています。 灰色ブロックは既存の列データ、緑色ブロックは新しい列データ、赤いアウトラインは書き換えられたデータを示します。
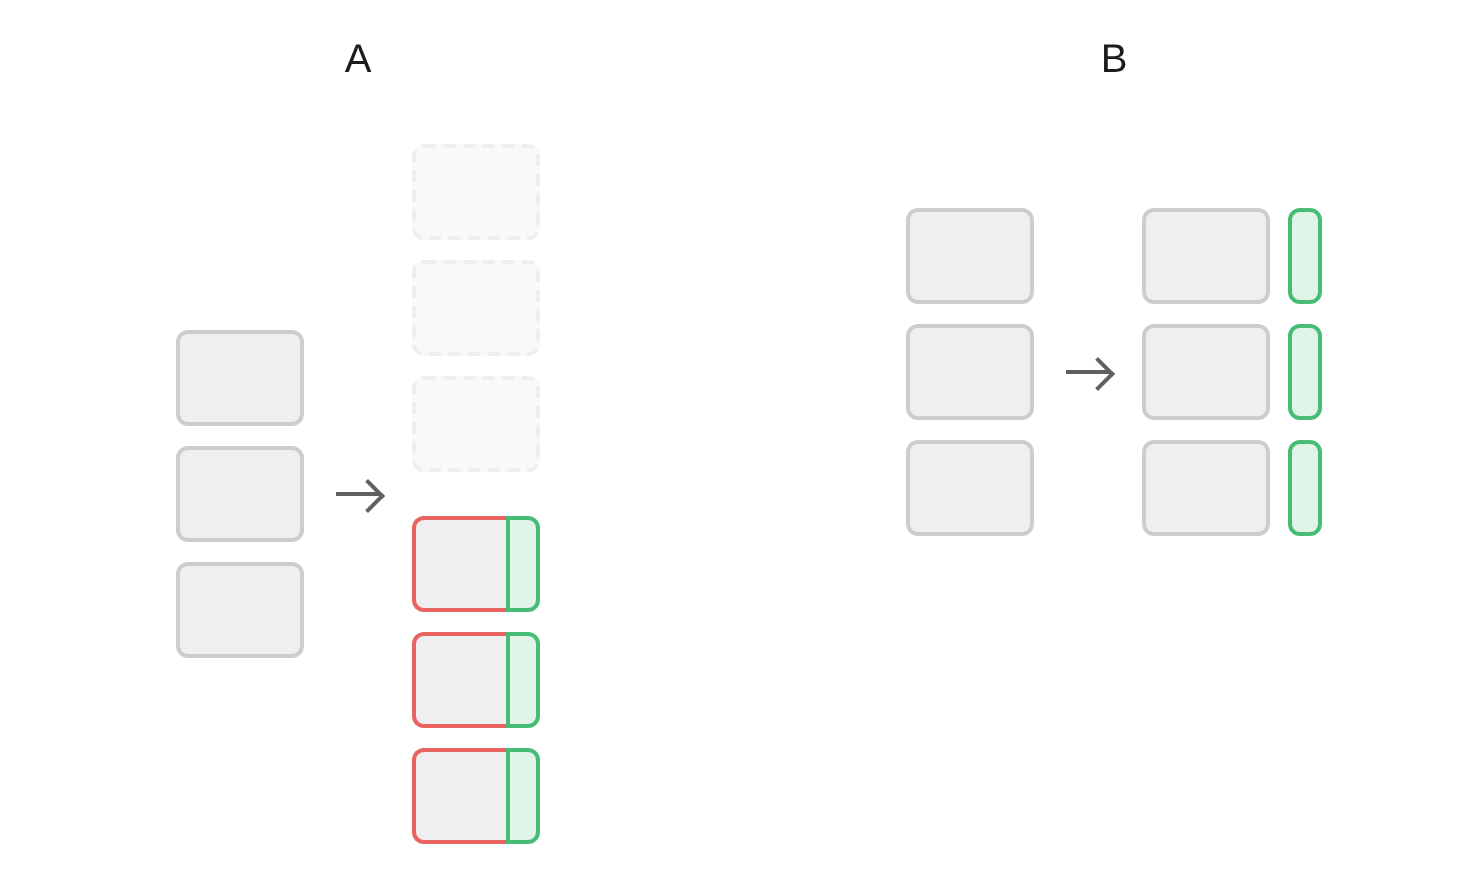
- A: ECUがない場合、バックフィルは元のデータファイル(破線)を、変更されていない列と新しい列の両方を含むファイルに置き換えます。
- B:ECUでは元のファイルが保持され、新しい列値は別ファイルに書き込まれます。
必要条件
- 効率的な列更新が有効化されたテーブルから読み出しまたは書き込みするには、Databricks Runtime 19 以上を使用します。
- カタログコミットが有効化された Unity Catalog 管理の Delta Lake テーブルを使用します。
- テーブル上で 行トラッキング および 削除ベクトル を有効にします。
-
idを'delta.columnMapping.mode' = 'id'モード()で使用します。 このモードはテーブル作成時に設定する必要があります。 - ワークスペースの プレビュー ページからベータを有効にします。
効率的なカラム更新を有効にする
テーブルを作成する場合、または要件を満たす既存のテーブルで効率的な列更新を有効にすることができます。 有効化する前に 制限 を確認してください。
効率的な列更新が有効なテーブルを作成するには、 delta.enableColumnUpdates-preview テーブルプロパティと必要な機能のプロパティを設定します。
CREATE TABLE documents (
  document_id BIGINT,
  description STRING
)
TBLPROPERTIES (
  'delta.feature.catalogManaged' = 'supported',
  'delta.enableRowTracking' = 'true',
  'delta.enableDeletionVectors' = 'true',
  'delta.columnMapping.mode' = 'id',
  'delta.enableColumnUpdates-preview' = 'true'
);
すでに id モードで列マッピングを使用している既存のテーブルについては、カタログコミット、行追跡、削除ベクトルがまだ有効になっていない場合は有効にしてください。
ALTER TABLE documents SET TBLPROPERTIES (
  'delta.feature.catalogManaged' = 'supported',
  'delta.enableRowTracking' = 'true',
  'delta.enableDeletionVectors' = 'true'
);
次に、効率的な列更新を有効にします:
ALTER TABLE documents SET TBLPROPERTIES (
  'delta.enableColumnUpdates-preview' = 'true'
);
問題が発生した場合は、 標準アップデートにロールバックできます。
列を追加してバックフィルする
次の例では、既存の documents テーブルに document_id 列と description 文字列列を使用しています。 各説明の長さを示す列を追加します:
ALTER TABLE documents ADD COLUMN text_length INT;

UPDATE documents
SET text_length = LENGTH(description);
列を追加した後、既存の行にはUPDATEが値を入力するまでtext_lengthNULLが保持されます。 効率的な列更新機能では、バックフィルが未変更の列を書き換えることなく新しい列値を書き込むことができます。
テーブルをクエリして、格納された値を確認します:
SELECT document_id, description, text_length
FROM documents
LIMIT 10;
効率的な列更新では、バックフィル時に書き換えられるデータ量を削減します。 更新は引き続き入力列を読み取り、新しい値を計算します。
効率的な列更新を有効にしても、すべての UPDATE がそれを使用することを保証するわけではありません。 場合によっては、Azure Databricks は影響を受けるデータファイルを書き換える標準更新にフォールバックします。 アップデートは引き続き正常に完了し、同じ結果が得られます。
標準アップデートへのロールバック
効率的な列更新に問題が発生した場合は、新しい列更新を無効にし、既存の列ファイルを統合してください:
新しいカラムファイルの書き込みをやめる:
ALTER TABLE documents SET TBLPROPERTIES (
  'delta.enableColumnUpdates-preview' = 'false'
);
列ファイルを含むデータファイルを REORG TABLE を使用して書き換える:
REORG TABLE documents APPLY (PURGE);
REORG 書き換えたデータファイルに最新の列値を書き込み、列ファイルなしの新しいテーブルバージョンを作成します。 更新された値は保持されます。 以前のテーブルバージョンでも列ファイルを参照できます。
テーブル機能はテーブルプロトコルで有効になっているため、読み書きにはDatabricksランタイム19以上が必要です。
Limitations
- Efficient Column Updates は、書き込み時変更データフィード(CDF)とは互換性がありません。 「 レガシーの変更データフィード」を参照してください。
- Efficient Column Updates は Universal Format (UniForm) と互換性がありません。
- Apache Iceberg 管理テーブルはサポートされていません。
-
MERGE操作では効率的な列更新は使用されません。 -
DROP FEATUREを使用して Efficient Column Updates を削除することはサポートされていません。 Databricksは、重要なテーブルでの有効化を避けることを推奨しています。 列更新の使用をやめるには、「 標準更新へのロールバック」を参照してください。 - レイクフローパイプラインはサポートされていません。