Important
この記事でプレビューとしてマークされているアイテムは、現在プレビュー段階です。 このプレビューはサービス レベル アグリーメント(SLA)なしで提供されており、Microsoft はこれを運用ワークロードでの使用に推奨していません。 特定の機能がサポートされていないか、機能が制限されている可能性があります。 詳細については、「 Microsoft Azure プレビューの追加使用条件」を参照してください。
Important
対話型トレーニングには、明示的なアクセス承認が必要です。 プレビュー サインアップ フォームを使用してアクセス権を申請し、トレーニング セッションを作成する前に承認を待ちます。
対話型トレーニング (プレビュー) は、Microsoft Foundry のオープンウェイト モデルに対して独自のポストトレーニング ループを構築するための API です。 Pythonで実験を制御します。 Foundry は、サーバーレス GPU でモデル サンプリングと低ランク適応 (LoRA) 更新を実行します。
強化学習 (RL) の場合、コードはロールアウトコレクション、報酬、利点、更新スケジュールを制御します。 同じプリミティブは、教師あり学習、嗜好学習、蒸留、およびカスタム損失ワークフローをサポートします。
いつ使用するか
トレーニング ループ自体が研究の一部である場合は、対話型トレーニングを使用します。
- カスタム学習シグナルが必要です。 デモンストレーションを提供したり、報酬とアドバンテージを計算したり、選好学習やその他の目的のためにローカルの損失を作成したりします。
- モデルは環境と対話します。 ドライバーでモデルの応答、ツール呼び出し、観察、報酬を調整します。
- 個々の更新プログラムを制御する必要があります。 バッチ、トークン マスク、損失設定、およびオプティマイザー パラメーターを選択します。 勾配を蓄積し、更新を適用するタイミングを決定します。
- 実験を確認して調整したい。 現在のアダプターからサンプルを取り出し、ホールドアウト用のプロンプトで評価し、観察された結果に基づいて次のプロンプトを選択する。
- 進行状況を保持して続行する必要があります。 アダプターとオプティマイザーの状態を保存し、互換性のあるセッションで再開します。 データセットの位置やその他の実験の状態をドライバに保持します。
マネージド微調整では、強化ファインチューニング用の採点器もサポートされます。 採点者やジョブの設定だけでなく、ループ自体を制御する必要がある場合は、対話型トレーニングを選択してください。 「トレーニングアプローチを選択する」を参照してください。
誰が何をするのか
Python プログラムがトレーニング ドライバーとなります。 このプログラムは入力を準備して、実験を調整します。 Foundry は、モデルとアダプターの状態を維持し、要求された操作を実行します。
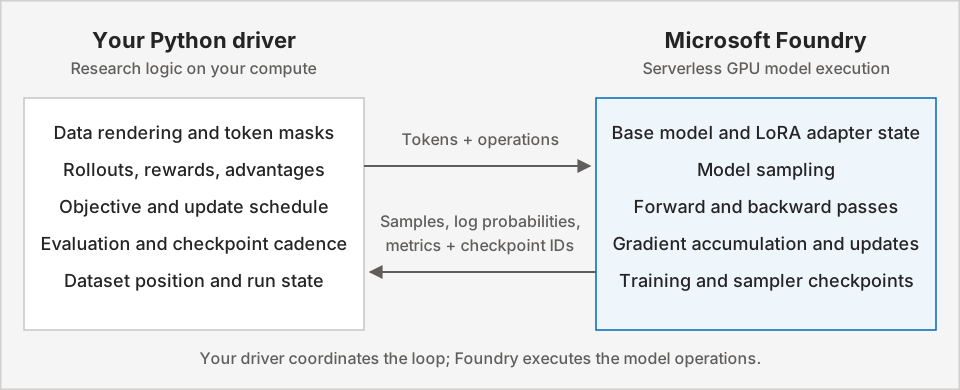
ドライバーは、お使いのマシンやコンピューティング環境を含め、CPU 上で実行できます。 追加する報酬モデルまたは環境には、独自のコンピューティング要件があります。 ドライバーがループを管理している間は、ドライバーを起動したままにします。
コア概念とプリミティブ
セッションはステートフルです。勾配計算、オプティマイザーの更新、サンプリングは、選択したモデルとアダプターに対する個別の操作です。 この分離により、データの収集、勾配の蓄積、更新、評価を行うタイミングを選択できます。
| 構成要素 | それが何をするか |
|---|---|
| トレーニング セッションと LoRA アダプター |
FineTuningSession.create は、サポートされている基本モデルをアダプター構成で初期化します。 セッションは、後続の操作で使用される状態を保持します。 |
| トークン化されたバッチとマスク |
Datum には、モデル入力と損失入力が含まれます。 マスクは、プロンプトやツールの観測結果ではなく、アシスタント トークンなど、学習に寄与するトークンを選択します。 |
| サンプリング |
sample は、選択したサンプラー チェックポイントからの応答を生成します。 RL 入力では、サンプリングされたトークンと、ロールアウトの対数確率および報酬から導出されたアドバンテージがペアになります。 |
| 前方パスと後方パス |
forward は、勾配を累積せずに、例ごとの損失関数の出力を返します。
forward_backward は、選択した目標を計算し、勾配を蓄積します。 オプティマイザーの更新は適用されません。 |
| オプティマイザーの更新 |
optim_step は、Adam パラメーターを使用して累積グラデーションを適用します。 更新するタイミングと使用する学習率を選択します。 |
| サンプラー チェックポイント |
save_weights_for_sampler は、アダプターの重みを生成用に準備します。 更新されたアダプターからサンプリングする前に、更新後にこれらの重みを更新してください。 |
| トレーニングのチェックポイント |
save_weights は、アダプターの重みとオプティマイザーの状態を保持します。
FineTuningSession.create_from_checkpoint は、互換性のあるセッションでトレーニングを再開します。 |
SDK には、教師あり更新のための cross_entropy と、importance_sampling や ppo などの RL 損失が含まれています。 これらの損失は損失プリミティブであり、事前定義されたエンドツーエンドのアルゴリズムではありません。 入力コントラクトとカスタム損失構成については、 主な概念を参照してください。
RL ループのしくみ
数学推論の実験を考えてみましょう。モデルでは、各問題に対して複数の回答が生成され、プログラムによってその正確性が評価されます。 具体例については、「概要」を参照してください。
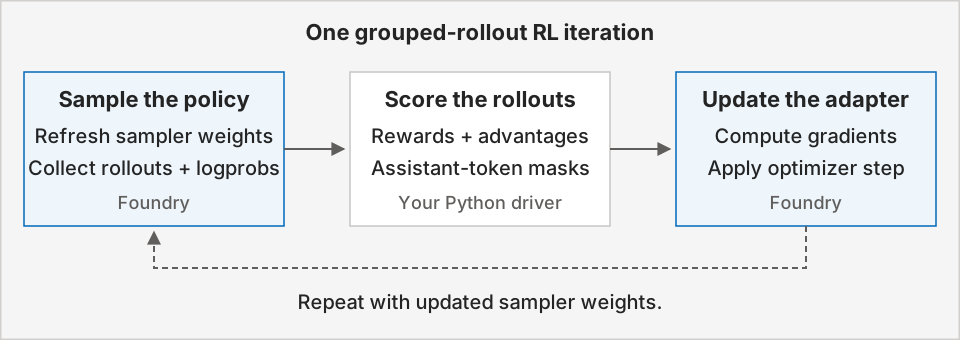
ホールドアウトベースラインを確立し、最初の更新の前に報酬関数をテストします。 その後、以下を繰り返します。
- 現在のポリシーをサンプリング用に準備します。 トレーニング アダプターからサンプラーの重みを保存し、その後、プロンプトごとに複数の応答 (つまり ロールアウト) を収集します。
- 回答をスコア付けして比較します。 報酬関数は、各ロールアウトにスコアを割り当てます。 プロンプト グループの平均報酬を減算して、各ロールアウトの アドバンテージを生み出します。
- 学習信号を準備します。 サンプリングされたアシスタント トークンをロールアウト ログの確率とアドバンテージに合わせます。 学習信号からプロンプトと環境の観察を除外します。
- 勾配を計算します。
forward_backwardを使用してバッチをimportance_samplingに送信します。 それを使用する更新の前に、勾配の計算を完了してください。 - アダプターを更新します。
optim_stepを呼び出し、更新されたポリシーから応答を収集する前にサンプラーの重みを更新します。 - 進行状況を評価して保存します。 保留された正確性をベースラインと比較し、選択した保存間隔でトレーニング チェックポイントを保存します。
概要
タスクに合った開始点を選択します。
- クイック スタート:クイック スタートサンプルに従ってリポジトリを複製し、簡単な強化学習レシピを実行します。
- 他のレシピを試す:微調整サンプル リポジトリで、その他のトレーニング例を確認します。
- 操作を調べる: 関数と主要なパラメーターについては SDK チートシート (プレビュー) を参照してください。
- トレーニング ループを理解する: 報酬、利点、トークン マスク、チェックポイントについては、キー コンセプトを読む。
サポートされているモデルとリージョン
サポートされているモデルとサポートされているリージョンについては、微調整の概要を参照してください。