Flex 処理(プレビュー)では、応答時間の遅延やリソースがときどき利用できない状況を許容できるワークロード向けに、Standard 処理と比べて 50% 割引で推論を提供します。
service_tierをflexに設定して、個々の Responses API または Chat Completions API 要求の Flex 処理を選択します。
Flex 処理は、モデル評価、データ エンリッチメント、ドキュメント分析、非同期アプリケーション ワークフローなど、非インターアクティブで優先順位の低い作業に使用します。 待機時間の影響を受けやすいワークロードまたは容量に依存するワークロードの場合は、代わりに Standard 処理、優先順位処理、またはプロビジョニング済みスループットを使用します。
Important
Flex 処理の導入により、 service_tier を flex に設定した要求は、選択したモデルで Flex 処理がサポートされている場合にのみ処理されます。 サポートされていないモデルは HTTP 400 invalid_request_error を返し、Standard 処理にはフォールバックしません。 Flex 処理には、待機時間の SLA またはサービス SLA はありません。
前提条件
Azure サブスクリプション。 無料で作成できます。
Global Standard デプロイの種類を使用してデプロイされた、サポートされているモデルを持つ Azure OpenAI リソース。
リソース エンドポイントと API キーまたはMicrosoft Entra ID資格情報。 この記事の例では、
AZURE_OPENAI_API_KEY環境変数に格納されている API キーを使用します。可変待機時間と一時的なリソースが使用できない応答を許容できるワークロード。
Pythonの例Python 3.10 以降と OpenAI Python パッケージを次に示します。
pip install --upgrade openai
Flex 要求を送信する
flex 処理を使用する必要がある各要求でflexにservice_tierを設定します。
model値は、Azure モデル デプロイの名前です。
Python
次の例では、Responses API を使用して Flex 要求を送信します。
import os

from openai import OpenAI

AZURE_OPENAI_ENDPOINT = "https://YOUR-RESOURCE-NAME.openai.azure.com"

# Create a client with a longer timeout for Flex requests.
openai = OpenAI(
    base_url=f"{AZURE_OPENAI_ENDPOINT}/openai/v1/",
    api_key=os.environ["AZURE_OPENAI_API_KEY"],
    timeout=900.0,
)

# Send a request for Flex processing.
response = openai.responses.create(
    model="YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    input="Analyze these records and summarize the recurring themes.",
    service_tier="flex",
)

print(response.output_text)
print(f"Processed by service tier: {response.service_tier}")
<generated-analysis>
Processed by service tier: flex
応答には、生成された分析と、要求を処理するサービス レベルが含まれます。
リファレンス:Responses API
REST
次の例では、同じ要求を Responses API に直接送信します。
curl -X POST https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/responses \
  -H "Content-Type: application/json" \
  -H "api-key: $AZURE_OPENAI_API_KEY" \
  -d '{
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
    "service_tier": "flex"
  }'
{
    "service_tier": "flex",
    "status": "completed",
    "output": [<response-output>]
}
要求を処理する層を確認するには、正常な応答で service_tier フィールドを確認します。
リファレンス:Responses API REST リファレンス
処理オプションを選択する
Flex、Standard、Priority の処理は、オンライン API 要求のサービス レベルの選択肢です。 バッチスループットとプロビジョニングスループットは、個別のデプロイと購入のオプションです。
| Option | それを選択する方法 | 待機時間と可用性 | コスト モデル | 最適な用途 |
|---|---|---|---|---|
| Flex処理 | 要求レベルの service_tier を flexに設定します。 |
可変待機時間。 Flex 容量が使用できない場合、要求は HTTP 429 を返すことができます。 | 標準トークンレートと比較して、50% 割引。 キャッシュ トークンの割引も適用されます。 | 評価、データ拡充、オフライン分析、ならびに遅延が許容されるバックグラウンド処理。 |
| 標準処理 | 要求レベルの service_tier を defaultに設定するか、デプロイ用に構成された Standard レベルを使用します。 |
一般的なワークロードのベスト エフォート オンライン処理。 | 標準のトークンごとの支払いレート。 | トラフィックが変動する開発、テスト、運用のワークロード。 |
| 優先度の処理 | デプロイの優先順位を構成するか、要求レベルの service_tier を priorityに設定します。 |
サポートされているモデルのターゲットを定義して、待機時間を短縮し、一貫性を高める。 | トークンあたりの優先順位の支払いレート。 | 予約容量コミットメントのない待機時間の影響を受けやすいオンライン アプリケーション。 |
| バッチ | Batch デプロイに非同期バッチ ジョブを送信します。 | 結果は 24 時間以内に完了を目標とします。 リアルタイム待機時間のターゲットはありません。 | 割引されたバッチ レート。 | 即時応答を必要としない大規模なオフライン ジョブ。 |
| 割り当てられたスループット | プロビジョニングされたデプロイを作成し、プロビジョニング済みスループット ユニット (PTU) を購入または予約します。 | 予測可能なスループットと待機時間を備えた予約容量。 | 時間単位の PTU 課金またはAzure予約。 | 大規模でミッションクリティカルな本番ワークロード。 |
次のすべての条件が適用される場合は、Flex 処理を選択します。
- ワークロードは、より長く、可変の処理時間を許容できます。
- 予測可能な待機時間よりも低コストを優先します。
- アプリケーションは、一時的なエラーを再試行するか、失敗した要求を Standard 処理にルーティングできます。
- 選択したモデルと要求コンテキストがサポートされています。
次のいずれかの条件が適用される場合は、Flex 処理を使用しないでください。
- ユーザーが対話型の応答を待機しています。
- 要求は、厳密な待機時間ターゲット内で完了する必要があります。
- アプリケーションは、一時的な HTTP 429 応答を許容または再試行できません。
- 予約された処理能力または予測可能なスループットが必要です。
Flex 処理には、次の特性があります。
-
要求レベルの選択:flex 処理を使用する必要がある各要求で
flexにservice_tierを設定します。 - 個別のデプロイはありません。 Standard 要求と Flex 要求を同じ Global Standard デプロイに送信し、要求ごとにレベルを選択します。
- サポートされている API: Responses API または Chat Completions API を使用します。
- 同期応答: ワークロードの完了に時間がかかる場合でも、API 呼び出しは同期的なままです。 Flex 処理は Batch API と同じではありません。
- 容量依存の可用性: Flex 容量が使用できない場合、要求は HTTP 429 を返すことができます。
-
自動標準フォールバックなし: 標準処理が許容される場合は、
service_tierをdefaultに設定して、アプリケーションを明示的に再試行する必要があります。 - 共有クォータ: Flex 要求と Standard 要求では、グローバル標準デプロイに割り当てられたクォータが使用されます。
- 同じモデルの出力品質: Flex は、Standard と同じ基になるモデルを使用します。 処理層は、モデルの品質ではなく、待機時間、可用性、および価格を変更します。
Note
Flex 入力トークンと出力トークンは、対応する Standard トークン レートと比較して 50% 割引を受けます。 対象となるキャッシュされた入力トークンは、適用されるキャッシュ トークン割引も受け取ります。 現在の料金については、Azure OpenAI の価格をご覧ください。
サポートされているモデルを確認する
Flex 処理では、起動時のモデルの可用性が制限されています。
gpt-5.6-sol は、サポートされている最初のモデルです。 次の表に、サポートされているモデルを示します。 サポートが利用可能になると、Microsoftにより多くのモデルが追加されます。
| Model | Version | 展開の種類 | リージョンの可用性 |
|---|---|---|---|
gpt-6.1-sol |
2026-09-29 |
グローバル標準 | グローバル標準が利用可能なすべてのAzureリージョン |
gpt-6-sol |
2026-09-22 |
グローバル標準 | グローバル標準が利用可能なすべてのAzureリージョン |
gpt-6-luna |
2026-09-22 |
グローバル標準 | グローバル標準が利用可能なすべてのAzureリージョン |
gpt-6-astra |
2026-09-03 |
グローバル標準 | グローバル標準が利用可能なすべてのAzureリージョン |
gpt-5.6-sol |
2026-07-09 |
グローバル標準 | グローバル標準が利用可能なすべてのAzureリージョン |
gpt-5.6-luna |
2026-07-09 |
グローバル標準 | グローバル標準が利用可能なすべてのAzureリージョン |
gpt-5.6-terra |
2026-07-09 |
グローバル標準 | グローバル標準が利用可能なすべてのAzureリージョン |
Flex 要求を送信する前に、この表を確認してください。 モデルまたは新しいモデル バージョンでは、標準または優先度の処理がサポートされているため、Flex 処理がサポートされているとは想定しないでください。 サポートされていないモデルは HTTP 400 を返します。 アプリケーションの中断を回避するには、Standard の価格とパフォーマンスが許容される場合に、Standard 処理へのアプリケーション レベルのフォールバックを実装します。
標準処理にフォールバックする
Flex 容量が使用できない場合、Flex 処理によって要求が Standard に自動的にルーティングされることはありません。 Flex 価格を保持するよりも要求を完了することが重要な場合は、 service_tier を default に設定して要求を再試行します。
次の例では、完了優先ポリシーを使用します。 最初に Flex 処理を試み、HTTP 429 応答の後に Standard 処理で 1 回再試行します。
import os

from openai import OpenAI, RateLimitError

AZURE_OPENAI_ENDPOINT = "https://YOUR-RESOURCE-NAME.openai.azure.com"

# Create a client with a longer timeout for Flex requests.
openai = OpenAI(
    base_url=f"{AZURE_OPENAI_ENDPOINT}/openai/v1/",
    api_key=os.environ["AZURE_OPENAI_API_KEY"],
    timeout=900.0,
)

request = {
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
}

# Try Flex processing, and fall back to Standard after an HTTP 429 response.
try:
    response = openai.responses.create(**request, service_tier="flex")
except RateLimitError:
    response = openai.responses.create(**request, service_tier="default")

print(response.output_text)
print(f"Processed by service tier: {response.service_tier}")
<generated-analysis>
Processed by service tier: <flex-or-default>
Standard にフォールバックすると、要求の価格とパフォーマンスの特性が変更されます。 このパターンは、ワークロードが Standard 価格を受け入れることができる場合にのみ使用します。
HTTP 429 応答は、利用できない Flex 容量またはクォータ制限を示すことができます。 Flex と Standard の処理ではクォータが共有されるため、クォータによって元の応答が発生した場合、Standard 要求も失敗する可能性があります。 再試行制限を適用し、アプリケーションで 2 つ目の RateLimitError を処理します。 サービスが Flex 固有のエラー識別子を返す場合は、それを使用して、フォールバックを容量関連の応答に制限します。
コストが最も低いワークロードの場合は、フォールバックする前に指数バックオフで Flex 処理を再試行してください。 完了時間を優先するワークロードの場合は、最初の Flex 容量エラーの後に Standard にフォールバックします。
参照: RateLimitError
Flex エラーの処理
永続的な要求エラーと一時的な容量エラーを区別します。
| HTTP 状態 | エラー | 原因 | 推奨される処理 |
|---|---|---|---|
| 400 | invalid_request_error |
選択したモデル、モデルのバージョン、コンテキストの長さ、API、または要求の構成では、Flex 処理はサポートされません。 | 変更せずに同じ要求を再試行しないでください。 サポートされているモデルまたはコンテキストの長さを選択するか、 service_tier を default に設定して明示的に再試行します。 |
| 408 | 要求タイムアウト | 構成されたクライアントまたはサービスのタイムアウト内で要求が完了しません。 Flex 要求には、Standard 要求よりも長い時間がかかる場合があります。 | 長いクライアント タイムアウトを使用します。 有界指数バックオフを使用して再試行します。 Flex の価格よりも完了時間が重要な場合は、Standard で再試行してください。 |
| 429 | リソースが利用できないか、レートが制限されている | Flex 容量が一時的に使用できないか、要求が該当するレート制限を超えました。 Flex 容量は割り込み可能であるため、ピーク時に一時的に使用できなくなる可能性が高くなります。 | 要求がレート制限を超えた場合は、より多くのクォータを割り当てることで、Global Standard デプロイのレート制限を引き上げます。 Flex と Standard は、このクォータを共有します。 サブスクリプションに大きなスループットワークロードに対する十分なクォータがない場合は、クォータの引き上げを要求します。 Flex 容量が一時的に使用できない場合は、指数バックオフとジッターを使用して再試行するか、平日の夜や週末などのオフピーク期間に遅延トレラントな作業を分散するか、 service_tier を default に設定して再試行します。 存在する場合は Retry-After を優先します。 |
| 500、502、503、または 504 | 一時的なサービス エラー | 一時的なサービスまたはゲートウェイの問題が完了できませんでした。 | 有界指数バックオフを使用して再試行します。 無制限の再試行回数を送信しないでください。 |
| 401 または 403 | 認証または承認エラー | 資格情報が見つからないか、無効であるか、期限切れであるか、リソースにアクセスできません。 | 資格情報またはロールの割り当てを修正します。 構成が変更されるまで再試行しないでください。 |
| 404 | デプロイが見つかりません | デプロイ名またはエンドポイントが正しくありません。 |
modelがデプロイ名と一致し、ベース URL が正しい Azure OpenAI リソースを指していることを確認します。 |
Note
処理能力が利用できないために拒否された Flex リクエストには、課金されません。 ただし、Flex 要求と Standard 要求ではグローバル標準デプロイに割り当てられているクォータが共有されるため、利用可能なレート制限容量が少なくなる場合があります。
HTTP 408、429、および一時的な 5xx 応答には、ランダム ジッターで指数バックオフを使用します。 失敗した要求が無制限の再試行ループに残らないように、最大再試行回数と最大遅延を設定します。
- 応答に含まれる
Retry-Afterを優先します。 - それ以外の場合は、ランダムジッターで指数関数的に増加する遅延を待ちます。
- Flex を再試行するのは、遅延がワークロードに対して許容可能なままである場合のみです。
- 再試行バジェットが使い果たされた場合は、アプリケーションがより高い Standard のコストを許容するなら、Standard にフォールバックします。
- 遅延 Flex 処理も Standard フォールバックもアプリケーションの要件を満たしていない場合は、明示的なエラーを返します。
サポートされていない同じ Flex 要求を繰り返し再試行しないでください。 再試行は、モデル、コンテキストの長さ、API 構成、またはサービス レベルを変更した後にのみ成功します。
使用状況とコストの監視
Azure Monitorメトリックを使用して、同じデプロイの Flex トラフィックと Standard トラフィックを比較します。 要求ボリューム、トークン使用量、待機時間、エラー、および Flex 要求がアプリケーションで Standard にフォールバックする速度を監視します。
Azure portal にサインインする
Azure OpenAI リソースに移動し、[メトリック] を選択します。
Azure OpenAI 要求メトリックを追加します。 Azure OpenAI 待機時間、Azure OpenAI Usage、およびエラー メトリックを追加することもできます。
ServiceTierRequest が
flex等しいフィルターを追加します。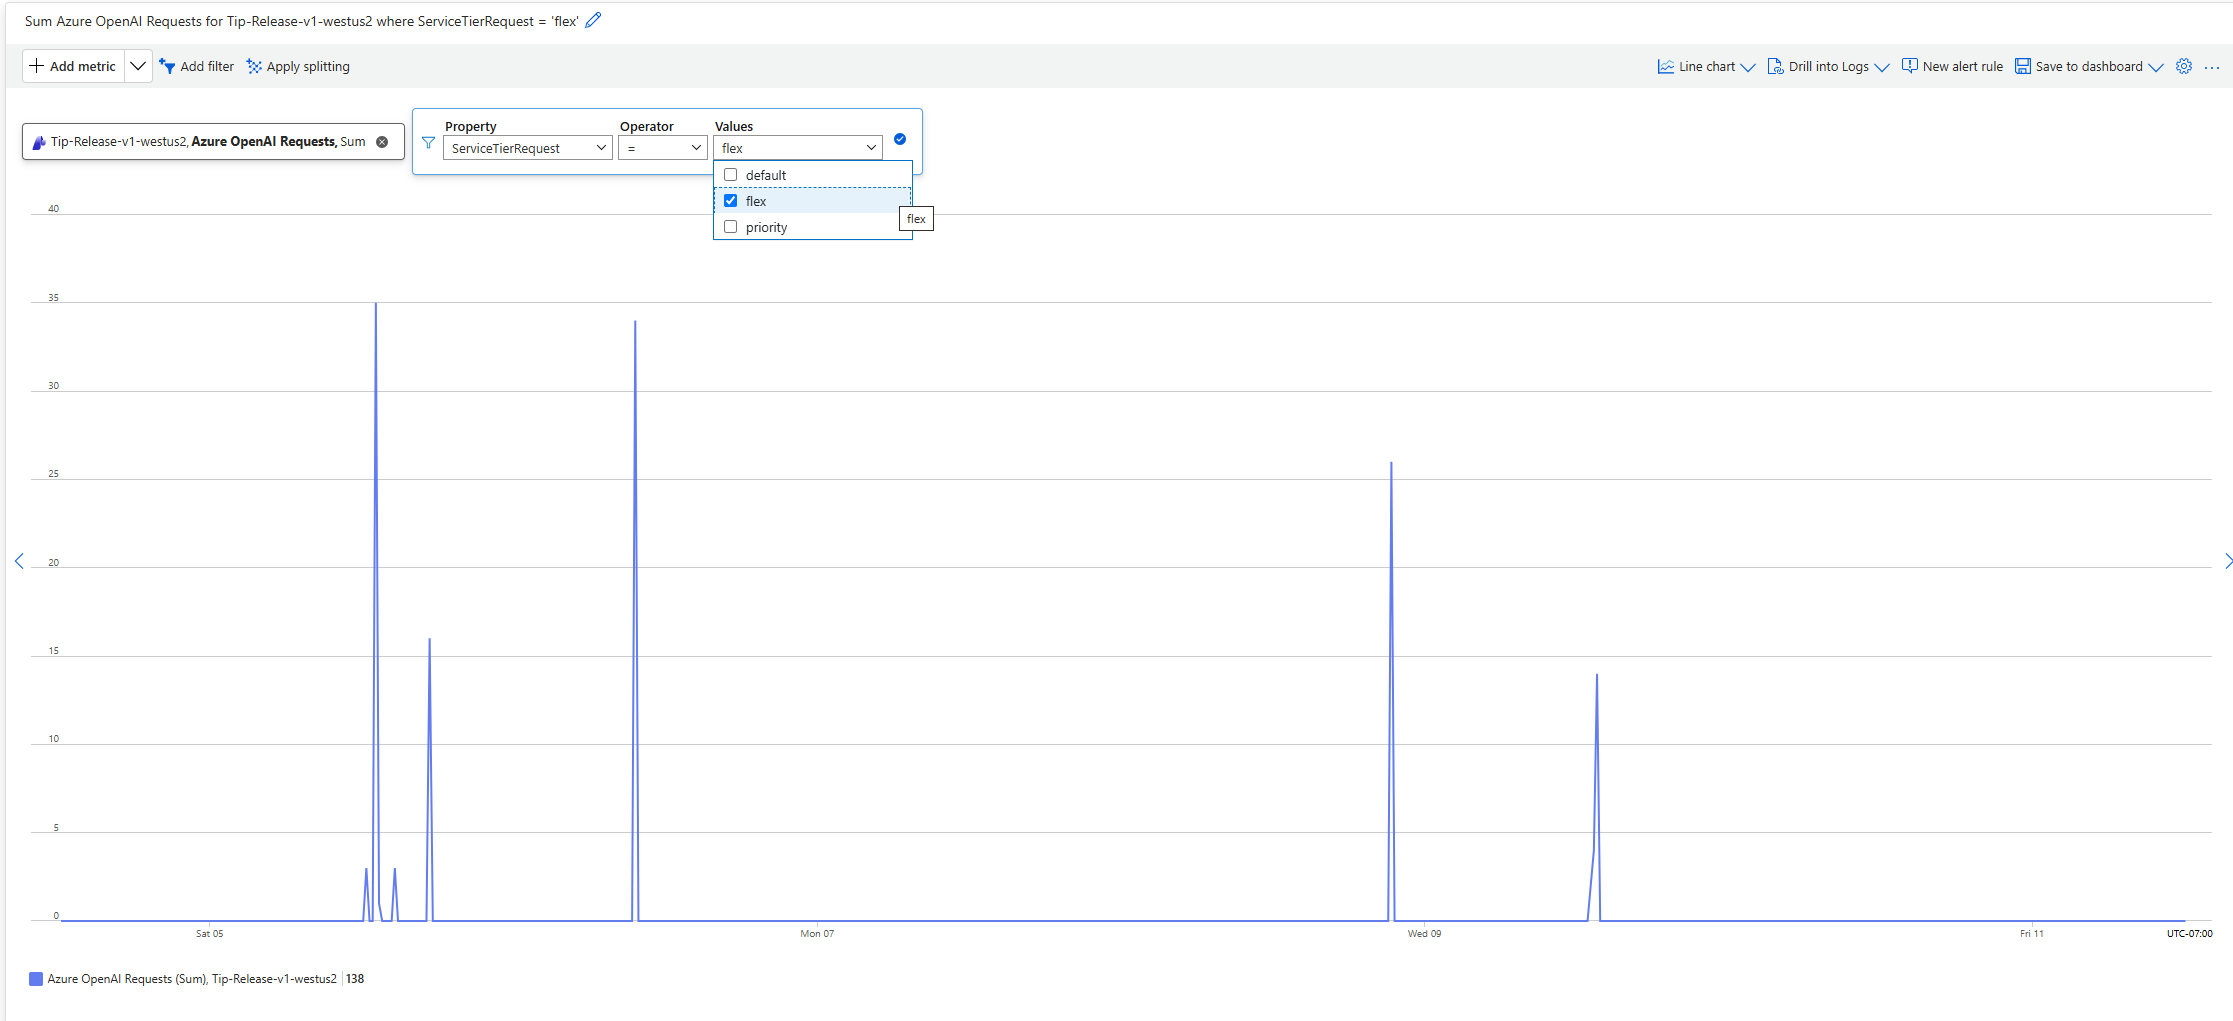
継続的な HTTP 429 応答、エラー率の増加、ワークロードの再試行予算を超える待機時間のアラートを作成します。
ワークロードごとに次のシグナルを追跡します。
| 信号 | 共同作業の重要性 |
|---|---|
| Flex リクエスト数 | 採用状況と、より低コストな処理に振り分けられたトラフィックを示します。 |
| Flex リクエスト成功率 | Flex 容量が要求を受け入れて完了する頻度を示します。 |
| HTTP 429 レート | Flex 容量またはデプロイ クォータが制限されている期間を示します。 |
| 標準フォールバック数とレート | 信頼性の利点と、アプリケーションによって制御されるフォールバックによる追加コストを示します。 |
| 入力、キャッシュされた入力、および出力トークン | コスト属性をサポートし、プロンプト キャッシュの効果を検証します。 |
| エンドツーエンドの待機時間 | ワークロードが Flex に適しているかどうかを判断するのに役立ちます。 |
HTTP 400 invalid_request_error 件数 |
サポートされていないモデル、モデルのバージョン、コンテキストの長さ、または要求の構成を識別します。 |
モデルのデプロイの監視の詳細については、「Azure OpenAI の監視」を参照してください。
Flex の使用量は、標準使用量と区別できるように、専用の Flex メーターで課金されます。 コスト分析を使用して、リソースとデプロイごとの Flex トークンコストを確認します。
- Azure ポータルで、Cost Management + Billing>Cost 分析を開きます。
- デプロイを含むサブスクリプション、リソース グループ、または Azure OpenAI リソースにフィルターを適用します。
- メーターでグループ化またはフィルター処理して、Flex の使用量を Standard の使用量と区別できます。
- 課金 タグ フィルターを追加し、 デプロイを選択して、デプロイ名を選択します。
- Flex のコスト削減と標準フォールバック コストとワークロードの完了要件を比較します。
Flex 入力トークンと出力トークンの価格は、対応する Standard レートの 50% です。 プロンプト キャッシュを使用すると、対象となるキャッシュされた入力トークンのコストをさらに削減できます。 処理能力が利用できないために拒否された Flex リクエストには、課金されません。
運用のベスト プラクティスを適用する
- 長いタイムアウトを設定します。 Flex 要求には、Standard 要求よりも長い時間がかかる場合があります。 ワークロードに適したクライアント タイムアウト (15 分など) から開始し、代表的なプロンプトでテストします。
- 再試行回数を制限します。 再試行回数と経過時間の合計を制限します。
- ジッターを追加します。 バックオフ遅延をランダム化して、同期された再試行の急増を回避します。
- フォールバックを明示的にします。 暗黙的な動作に依存するのではなく、
service_tierをdefaultに設定します。 - 処理されたレベルを追跡します。 待機時間、状態、トークンの使用状況、コスト データを使用して応答
service_tier値を記録します。 - 対話型トラフィックとバックグラウンド トラフィックを分離します。 可変の Flex レイテンシを許容できる場合を除き、ユーザー向けリクエストには Standard、Priority、またはプロビジョニング済みスループットを使用してください。
- 重複する作業を制御します。 クライアント側のタイムアウト後に、アプリケーションが同じ論理ジョブを複数回送信しないようにします。
- テストの失敗パス。 運用環境のワークフローで Flex 処理を使用する前に、HTTP 400、408、429、および一時的な 5xx 応答の処理を検証します。
- アップグレード前にモデルのサポートを確認します。 代替モデルまたはモデル バージョンは、Flex サポートを自動的に継承しません。
要求ヘッダーを使用してサービス レベルをオーバーライドする
x-ms-service-tier要求ヘッダーは、ゲートウェイ、プロキシ、または一元化されたルーティング層が、要求本文を検査または変更せずにサービス レベルを選択する必要がある場合に使用します。 また、要求ヘッダーを使用して OpenAI サービス レベルを既に選択しているアプリケーションの移行の変更を減らすこともできます。
ヘッダーは次の値を受け入れます。
| ヘッダー値 | 要求された処理レベル |
|---|---|
flex |
Flex |
priority |
Priority |
default |
Standard |
auto |
Priority |
ヘッダーが存在し、有効な場合は、要求本文の service_tier 値よりも優先されます。
| ヘッダー入力 | 要求本文の入力 | 動作と出力 |
|---|---|---|
| ヘッダーを省略しました | 有効な service_tier 値 |
要求本文で層が選択されます。 応答が成功すると、 service_tierで処理された層が識別されます。 |
| 有効なヘッダー値 | 任意の値または省略 | ヘッダーは、要求された層を選択します。 応答が成功すると、 service_tierで処理された層が識別されます。 |
| サポートされていないヘッダー値 | 任意の値または省略 | 要求は HTTP 400 を返します。 サービスは要求本文の値にフォールバックしません。 |
この例では、ヘッダーを介して Flex 処理を要求します。 ヘッダーは、要求本文の default 値をオーバーライドします。
curl -X POST https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/responses \
  -H "Content-Type: application/json" \
  -H "api-key: $AZURE_OPENAI_API_KEY" \
  -H "x-ms-service-tier: flex" \
  -d '{
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
    "service_tier": "default"
  }'
{
    "service_tier": "flex",
    "status": "completed",
    "output": [<response-output>]
}
オーバーライド ヘッダーでは、自動フォールバックは行われません。 無効なヘッダー値または選択したデプロイでサポートされていない層は、HTTP 400 を返します。