Azure DocumentDB は、MongoDB との互換性を備えた最新のアプリケーション開発のためのフル マネージド NoSQL データベース サービスです。 Azure DocumentDB では、同期的にレプリケートされたホット スタンバイ レプリカとゾーン冗長性を備えた高可用性 (HA) 構成がサポートされています。 また、別の Azure リージョンにオプションの読み取りレプリカを用意し、不慮のデータ損失から保護するために、特定時点までのデータ保持機能を備えた自動バックアップも提供します。
Azureを使用する場合、信頼性は共有責任です。 Microsoftには、回復性と回復性をサポートするためのさまざまな機能が用意されています。 使用するすべてのサービスでこれらの機能がどのように機能するかを理解し、ビジネス目標とアップタイムの目標を達成するために必要な機能を選択する必要があります。
この記事では、一時的な障害、可用性ゾーンの停止、リージョンの停止、サービス メンテナンスなど、さまざまな潜在的な障害や問題に対して、Azure DocumentDB の回復性を確保する方法について説明します。 また、バックアップ動作について説明し、HA とリージョン間レプリケーションに関する重要な情報も提供します。
信頼性のための運用環境のデプロイに関する推奨事項
クラスターの信頼性を向上させるための推奨事項の一覧については、Azure DocumentDB の高可用性 (HA) とリージョン間レプリケーションのベスト プラクティスに関するページを参照してください。
信頼性アーキテクチャの概要
このセクションでは、信頼性の観点から最も関連性の高いサービスのしくみの重要な側面について説明します。 このセクションでは、デプロイして使用するリソースと機能の一部を含む論理アーキテクチャについて説明します。 また、物理アーキテクチャについても説明します。このアーキテクチャでは、サービスの内部での動作について詳しく説明します。
論理アーキテクチャ
デプロイするプライマリ リソースは、Azure DocumentDB クラスターです。 クラスターごとに、コンピューティング レベルを選択し、ストレージを構成します。 選択したレベルによって、高可用性 (HA) などの信頼性機能に使用できる機能が決まります。また、回復性シナリオの容量を計画する方法にも影響します。
アプリケーションは、 接続文字列 とエンドポイントを使用してクラスターに接続します。 Azure DocumentDB は、読み取り/書き込み操作用の接続エンドポイントと、構成されている場合は読み取りレプリカ クラスター用のエンドポイントを提供します。 これらのエンドポイントを使用すると、サービスがバックグラウンドでフェールオーバー動作を管理しながら、アプリケーションで安定した接続パターンを引き続き使用できます。
各クラスター内では、データは データベース、 コレクション、 ドキュメントとして編成されます。 この MongoDB と互換性のあるデータ モデルは、シャーディング戦略、読み取りと書き込みのパターン、バックアップと復元のスコープなど、ワークロード レベルの設計上の決定の基礎となります。
物理アーキテクチャ
Azure DocumentDB は、サービスを実行するノード (仮想マシン) を表すシャードでクラスターを実行します。 1 つのシャードをデプロイすることも、複数のシャードにスケールアウトすることもできます。 複数のシャードをデプロイすると、スケール容量が向上しますが、単独では HA は提供されません。
HA を有効にすると、Azure DocumentDB によって対応するスタンバイ シャード一式がプロビジョニングされます。 各プライマリシャードにはスタンバイシャードがあります。 サービスは、各プライマリ とスタンバイのペアの間でデータを同期的にレプリケートし、プライマリ シャードが失敗した場合にスタンバイ シャードを昇格させます。 HA の詳細については、「Azure DocumentDB の高可用性」を参照してください。
Azure DocumentDB では、シャードの持続性にAzure Storageが使用されます。 HA が無効になっている場合、各シャードはローカル冗長ストレージ (LRS) を使用します。 LRS はデータのコピーを 3 つ保持しますが、可用性ゾーンの損失に対する回復性はありません。 LRS の持続性の詳細については、「 冗長性オプションの概要」を参照してください。
詳細については、「Azure DocumentDB: バックグラウンドでの可用性とディザスター リカバリー (DR)」を参照してください。
一時的な障害に対する回復性
一時的な障害は、コンポーネントにおける短い断続的な障害です。 これらはクラウドのような分散環境で頻繁に発生し、運用の通常の範囲であり、 一時的な障害は、短時間の経過後に自分自身を修正します。 アプリケーションで一時的な障害を処理できることは重要です。通常は、影響を受ける要求を再試行します。
クラウドでホストされるすべてのアプリケーションは、クラウドでホストされている API、データベース、およびその他のコンポーネントと通信する際に、Azure の一時的な障害処理のガイダンスに従う必要があります。 詳細については、一時的なエラーへの対処に関するレコメンデーションを参照してください。
Azure DocumentDB は MongoDB プロトコルと互換性があるため、アプリケーションは通常、MongoDB ドライバーを使用して接続します。 一時的な障害 、特にフェールオーバー イベント中の接続の中断と短い書き込み中断を処理するように、アプリケーションのドライバーの再試行設定を構成する必要があります。 次のガイドラインに従ってください。
一時的な接続エラーの自動再試行処理をサポートする MongoDB ドライバーを使用します。
指数バックオフを使用して再試行を構成し、再試行回数を制限します。
可能であれば、再試行しても安全になるよう、書き込み操作が冪等になるように設計します。 べき等性に関する一般的な実装ガイダンスについては、べき等コンシューマー パターンを参照してください。
可用性ゾーンの障害に対する回復性
可用性ゾーン は、Azure リージョン内のデータセンターの物理的に分離されたグループです。 1 つのゾーンで障害が発生した際には、サービスを残りのゾーンのいずれかにフェールオーバーできます。
Azure DocumentDB で可用性ゾーンのサポートを使用するには、高可用性 (HA) を有効にします。 可用性ゾーンをサポートするリージョンで HA を有効にすると、Azure DocumentDB によってスタンバイ シャードがプライマリ シャードとは異なる可用性ゾーンに配置されるため、クラスターはゾーン冗長になります。 スタンバイ シャードは、プライマリ シャードが失敗しない限り、クライアント要求を受信しません。
HA を無効にした場合、Azure DocumentDB はスタンバイ シャードを別の可用性ゾーンに配置しないため、可用性ゾーンの障害によってクラスターが使用できなくなる可能性があります。
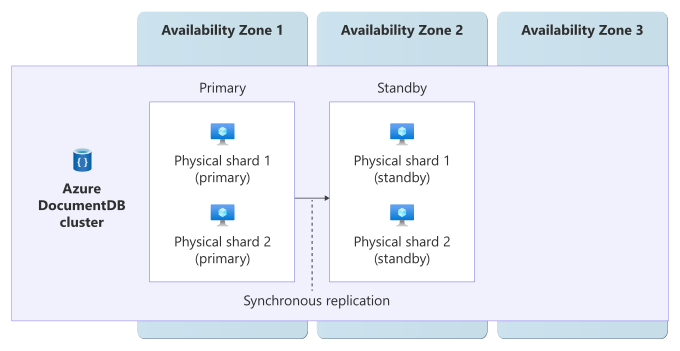
この図は、3 つの可用性ゾーンにまたがる 1 つの Azure DocumentDB クラスターを示しています。 2 つのプライマリ物理シャードが可用性ゾーン 1 にあり、対応するスタンバイ物理シャードが可用性ゾーン 2 にあります。 各プライマリ シャードとスタンバイ シャードの間の矢印は、同期レプリケーションを示します。 この例では、可用性ゾーン 3 にはシャードが含まれていません。
Requirements
リージョンのサポート:Azure DocumentDB で可用性ゾーンを使用するには、Azure DocumentDB と可用性ゾーンの両方をサポートするリージョンを選択します。 リージョン別に利用可能な製品を確認し、可用性ゾーンをサポートするリージョンと比較します。
高可用性: クラスターで HA を有効にする必要があります。 HA では、クラスターで M30 (またはそれ以上) のコンピューティング レベルを使用する必要があります。
Considerations
一部のAzure DocumentDB API には、同じゾーンのデプロイ モードへの参照が含まれていますが、Azure DocumentDB では同じゾーンの HA デプロイはサポートされていません。 このサービスでは、ゾーン冗長 HA デプロイがサポートされています。
ゾーン間でのインスタンスの分散
Microsoftは、クラスターの 2 つの可用性ゾーンを選択します。 ゾーン冗長 HA デプロイでは、Azure DocumentDB は、すべてのプライマリ シャードを 1 つのゾーンに配置し、すべてのスタンバイ シャードを他のゾーンに配置します。
Cost
HA が有効になっている場合、Azure DocumentDB はプライマリ シャードごとにスタンバイ シャードをプロビジョニングします。これによって、クラスターのコンピューティングコストとストレージ コストが増加します。 可用性ゾーンをサポートするリージョンでは、HA によってクラスター ゾーン冗長も行われます。 一部のデプロイ モードでは、DocumentDB Azure既定で HA が有効になります。 運用環境のワークロードの場合は、HA を有効のままにします。 開発ワークロードとテスト ワークロードでは、HA を無効にしてコストを削減できます。 価格の詳細については、Azure DocumentDB の価格をご覧ください。
可用性ゾーンのサポートを設定する
新しいゾーン冗長Azure DocumentDB クラスターを作成する: 可用性ゾーンをサポートするリージョンにクラスターを作成する場合は、HA を有効にしてクラスター ゾーン冗長にします。 詳細な手順については、「クイック スタート: Azure ポータルを使用して Azure DocumentDB クラスターを作成する」を参照してください。
既存の Azure DocumentDB クラスターでゾーン冗長を有効にする: 既存のクラスターで HA を有効にすることができます。 Azure DocumentDB クラスターで高可用性が有効または無効になっている場合、データベースのダウンタイムはありません。 詳細な手順については、「Azure DocumentDB クラスターのスケーリング」を参照してください。
すべてのゾーンが正常な場合の動作
このセクションでは、可用性ゾーンをサポートし、すべてのゾーンが運用可能なリージョンで HA 用に Azure DocumentDB クラスターを構成する場合に想定される内容について説明します。
ゾーン間操作: プライマリ シャードは、すべてのクライアント要求を処理します。 別の可用性ゾーン内のスタンバイ シャードは、プライマリが失敗しない限り、クライアント要求を受信しません。
ゾーン間データ レプリケーション: プライマリ シャードとスタンバイ シャード間のレプリケーションは同期的です。 書き込みは、サービスが応答を返す前に、プライマリ シャードとスタンバイ シャードの両方で保持されます。
ゾーン障害時の動作
このセクションでは、可用性ゾーンをサポートするリージョンで HA 用の Azure DocumentDB クラスターを構成し、いずれかのゾーンで停止が発生した場合に想定される内容について説明します。
検出と応答: Microsoftはシャードの正常性を監視し、検出とフェールオーバーの操作を自動的に処理します。 ゾーンの停止が原因でプライマリ シャードが使用できなくなった場合、Azure DocumentDB はスタンバイ シャードを自動的に昇格させ、新しいスタンバイ シャードを作成して冗長性を再構築します。
通知: ゾーンがダウンしても、Microsoft から自動的に通知されることはありません。 ただし、Azure Service Health を使用して、ゾーン障害を含むサービスの全体的な正常性を把握し、Service Health アラートを設定して問題を通知することができます。
アクティブな要求: フェールオーバーが失敗する前に確認されなかったインフライト要求は、クライアントが再試行する必要があります。 アプリケーションが 一時的な障害を処理する場合、通常、これらの再試行は自動的に完了します。
予期されるデータ損失: Azure DocumentDB はプライマリ シャードとスタンバイ シャードの間でデータを同期的にレプリケートするため、データ損失は予想されません。
予想されるダウンタイム: 読み取り操作でダウンタイムは発生しません。 書き込み操作の場合、フェールオーバーの完了中に短い中断が発生する可能性があります。 アプリケーションが 一時的な障害を 正しく再試行すると、通常、これは短い速度低下として表示されます。
再配布:接続文字列は変更されないため、クライアントは引き続き同じエンドポイントを使用します。 サービスは、昇格されたスタンバイ シャードにトラフィックを自動的にリダイレクトし、新しいスタンバイ シャードを再構築します。
ゾーンの回復
可用性ゾーンが復旧すると、Azure DocumentDB は、クラスターで使用されているすべてのゾーンで通常の操作を自動的に復元します。
ゾーンエラーのテスト
Azure DocumentDB プラットフォームは、ゾーン冗長クラスターのトラフィック ルーティング、フェールオーバー、ゾーン回復を管理します。 可用性ゾーンの障害プロセスを開始または検証する必要はありません。
リージョン全体の障害に対する回復性
各Azure DocumentDB クラスターは、1 つのAzure リージョンにデプロイします。 リージョンの障害に対する回復性をサポートするには、別のリージョンに 1 つのレプリカ クラスターを追加して、リージョン間レプリケーションを構成します。
リージョン間レプリケーション
Azure DocumentDB では、レプリカ クラスターを介したリージョン間レプリケーションがサポートされます。 レプリカ クラスターは、リソース グループ内に別のクラスターとして表示されます。 このレプリカ クラスターは、ディザスター リカバリーと読み取りスケーリングに使用できます。 Azure DocumentDB は、プライマリ クラスターからレプリカ クラスターにデータ変更を自動的かつ非同期的にレプリケートします。
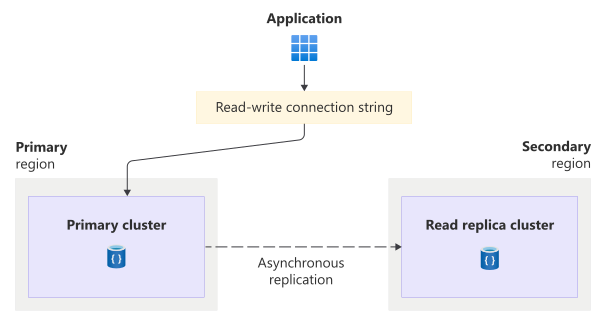
この図は、アプリケーションが読み取り/書き込み用の接続文字列を介して、プライマリリージョンのプライマリクラスターに接続する様子を示しています。 破線の矢印は、プライマリ クラスターからセカンダリ リージョンの読み取りレプリカ クラスターへの非同期レプリケーションを示しています。
プライマリ リージョンで障害が発生した場合は、レプリカ クラスターを昇格して読み取り/書き込みクラスターにすることができます。 グローバルな読み取り/書き込み接続文字列は、昇格後のクラスターを指すように自動的に更新されます。
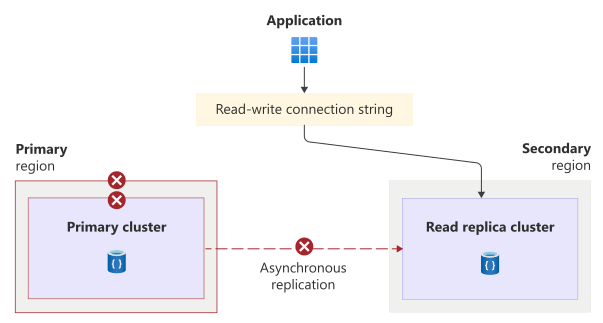
この図は、昇格後に読み取り/書き込み用の接続文字列を介して、セカンダリ リージョンにあるレプリカ クラスターに接続するアプリケーションを示しています。 障害シンボルは、プライマリ クラスター、プライマリ リージョン、および以前の非同期レプリケーション パスをマークします。
このセクションでは、リージョン間レプリケーションの信頼性に関する考慮事項をまとめます。 詳細については、Azure DocumentDB クラスターでのクロスリージョン レプリケーションと同一リージョン レプリケーションの管理およびAzure DocumentDB におけるクロスリージョン レプリケーションと同一リージョン レプリケーションのベスト プラクティスを参照してください。
リージョン間のフェールオーバー
Azure DocumentDB では、次の 3 つの昇格モードがサポートされています。
強制昇格: レプリカ クラスターを直ちに昇格させて書き込み操作を受け入れられるようにし、受信した書き込みトラフィックをグローバルな読み取り/書き込み接続文字列経由でリダイレクトします。 このモードではダウンタイムを最小限に抑えられますが、レプリケートされていない書き込みが失われるため、データ損失が発生する可能性があります。
サービスマネージド フェールオーバー: サービスマネージド フェールオーバーを使用するようにクラスターを構成できます。 Microsoftはプライマリ クラスターを監視し、プライマリ クラスターが異常な場合に強制昇格を自動的にトリガーします。
グレースフル プロモーション: データの損失を防ぎますが、レプリケートされていない書き込みがレプリケートされる間は、ある程度のダウンタイムが必要です。 グレースフル プロモーションでは、両方のクラスターが正常である必要があるため、リージョンの停止中に実行することはできません。
詳細については、「Azure DocumentDB のリージョン間フェールオーバー モード」を参照してください。
Requirements
リージョンのサポート:Azure DocumentDB をサポートするすべてのAzure リージョンでリージョン間レプリケーションを使用できます。
コンピューティング レベル: リージョン間レプリケーションには、M30 以上のコンピューティング レベルが必要です。
Considerations
ネットワーク アクセス: レプリカ クラスターは、プライマリ クラスターからネットワーク設定を継承しません。 レプリカ クラスターでファイアウォール規則またはプライベート エンドポイントを個別に構成し、フェールオーバー前に接続をテストします。 詳細については、「 連続書き込み、クラスター レプリカに対する読み取り操作、接続文字列」を参照してください。
機能のサポート: レプリカ クラスターでは、ポイントインタイム リストア (PITR) またはリージョン内 HA はサポートされていません。
プライマリ クラスターで HA が有効になっている場合は、昇格されたクラスターで HA を再度有効にする必要があります。
詳細については、「Azure DocumentDB サービスの制限とクォータ」を参照してください。
Cost
リージョン間レプリケーションでは、レプリカ クラスターのコンピューティング リソースとストレージ リソースのコストが追加されます。 リージョン間のデータ転送料金も適用されます。 価格の詳細については、「Azure DocumentDB の価格と帯域幅の価格」を参照してください。
マルチリージョンのサポートを構成する
レプリカ クラスターを作成します。 リージョン間レプリケーションを有効にするには、プライマリ クラスターからレプリカ クラスターを作成します。 レプリカ クラスターは、プライマリ クラスターの作成時または後で作成できます。 手順については、Azure DocumentDB クラスターでのリージョン間および同一リージョンのレプリケーションの管理を参照してください。
自動フェールオーバーを構成します。 プライマリ リージョンで障害が発生したときに Azure でレプリカを自動的に昇格させる場合は、サービスマネージド フェールオーバーを有効にします。 詳細については、「 サービス管理フェールオーバーを有効にする」を参照してください。
Note
Microsoftは通常、リージョン全体の停止や多数の影響を受けるお客様など、極端なイベントでのみサービス管理フェールオーバーをトリガーします。 フェールオーバーがトリガーされるまでに遅延が発生する可能性があります。 可用性をすばやく復元する必要がある場合は、顧客が開始した強制昇格を使用してフェールオーバー プロセスを管理することをお勧めします。
すべてのリージョンが正常な場合の動作
このセクションでは、リージョン間レプリケーション用に Azure DocumentDB クラスターを構成し、すべてのリージョンが運用可能な場合に想定される内容について説明します。
リージョン間操作: プライマリ クラスターは、すべての読み取り/書き込みトラフィックを処理します。 レプリカ クラスターは読み取り専用トラフィックを提供します。読み取りワークロードをスケールアウトしたり、読み取りトラフィックを特定のリージョンにローカルに保持したりするために使用できます。 グローバルな読み取り/書き込み接続文字列は、常に現在書き込み可能なクラスターを指すため、クライアントはどのリージョンがプライマリかを追跡する必要はありません。
リージョン間データ レプリケーション: プライマリ クラスターとレプリカ クラスターの間のレプリケーションは非同期です。 書き込みはプライマリ クラスターでコミットされ、レプリカ クラスターにレプリケートされる前にクライアントに確認されます。 この方法により、リージョン間のネットワーク待機時間が書き込みパフォーマンスに影響を与えるのを防ぐことができます。 レプリケーションは非同期であるため、プライマリ クラスターとレプリカ クラスターの間で一部のレプリケーションのラグが予想され、強制フェールオーバー中に書き込みのない書き込みが失われる可能性があります。
リージョン障害時の動作
このセクションでは、リージョン間レプリケーション用に Azure DocumentDB クラスターを構成し、プライマリ クラスターのリージョンで障害が発生した場合に想定される内容について説明します。
検出と応答: 障害を検出して対応する責任は、クラスターで使用されるフェールオーバーの種類によって異なります。
- サービスマネージド フェールオーバーが有効になっている場合、Azure DocumentDB は停止を検出し、レプリカ クラスターの強制昇格を自動的に実行します。
- サービス管理フェールオーバーが有効になっていない場合は、停止を検出し、強制昇格をトリガーする必要があります。
詳細については、「Azure DocumentDB のリージョン間フェールオーバー モード」を参照してください。
Notification: Microsoft は、リージョンがダウンしたときに自動的にあなたに通知しません。 ただし、 Azure Service Health を使用して、リージョンの障害を含むサービスの全体的な正常性を把握し、 Service Health アラート を設定して問題を通知することができます。
アクティブな要求: 失敗したプライマリ リージョンに対するアクティブな要求はすべて失敗する可能性があります。 フェールオーバーが完了したら、アプリケーションは再接続し、昇格されたクラスターに対して再試行する必要があります。
予想されるデータ損失: リージョンの障害時のフェールオーバーは計画外であるため、レプリケーションが非同期であるため、未適用の書き込みが失われる可能性があります。
予想されるダウンタイム: 全体的なダウンタイムは、検出時間、フェールオーバー モード、クライアント再接続の動作によって異なります。
顧客が開始した強制昇格の場合、ダウンタイムの合計には、停止を検出して応答プロセスを開始するのにかかる時間と、プロモーションを完了する時間が含まれます。
昇格が開始されると、通常は数分以内に完了します。
再配布: グローバルな読み取り/書き込み用の接続文字列は、昇格後、自動的に昇格先クラスターを指すようになります。 クラスター固有の接続文字列を使用するアプリケーションでは、正常なクラスターにトラフィックを転送するために構成の更新が必要になる場合があります。
リージョンの復旧
Azure DocumentDB は、復旧後に元のリージョンに自動的にフェールバックされません。 元のリージョンに書き込み操作を返すには、優先トポロジを再確立した後で、別の昇格を実行します。 フェールバック時のデータ損失を回避するには、グレースフルプロモーションを使用してください。 グレースフル プロモーションには少量のダウンタイムが必要であり、メンテナンス期間中など、選択したタイミングで実行できます。 詳細については、「グレースフル プロモーションをトリガーする」を参照してください。
リージョン障害のテスト
制御された環境でレプリカ クラスターを昇格させて、ディザスター リカバリー プロセスを定期的にテストします。
強制昇格を使用して、障害時の動作を再現します。 このテストではデータが失われる可能性があるため、非運用環境でこのテストを実行することを検討してください。 詳細については、「 強制昇格のトリガー」を参照してください。
データ損失を回避する場合は、計画された切り替えドリルに グレースフル プロモーション を使用します。 詳細については、「グレースフル プロモーションをトリガーする」を参照してください。
バックアップと復元
レプリケーションと可用性ゾーンのサポートは、インフラストラクチャの障害時にクラスターを使用できるように保つのに役立ちます。 Azure DocumentDB は、データを誤って削除または変更した後にポイントインタイム リカバリー (PITR) を有効にすることで、別のリスクに対処する継続的バックアップを自動的に実行します。 Azure DocumentDB は、データベース操作のパフォーマンスや可用性に影響を与えずにバックアップを作成します。 レプリケーションとバックアップでさまざまなリスクに対処する方法の詳細については、「 冗長性、レプリケーション、バックアップ」を参照してください。
Azure DocumentDB は、ソース データとは別にバックアップを格納します。 可用性ゾーンをサポートするリージョンでは、サービスはバックアップ スナップショットを 3 つの可用性ゾーンに格納します。 Azure DocumentDB はこれらのバックアップを管理し、エクスポートすることはできません。 このサービスでは、アクティブ クラスターの場合は 35 日間、アクティブなバースト可能層 (M10、M20、M25) クラスターの場合は 7 日間、削除されたクラスターの場合は 7 日間バックアップが保持されます。
バックアップを新しいクラスターに復元できます。 その後、一連の復元後タスクを実行する必要があります。
詳細については、「Azure DocumentDB でのクラスターの復元」を参照してください。
サービス メンテナンスに対する回復性
Microsoft は定期的にサービス更新プログラムを適用し、その他のメンテナンスを実行します。 Azure プラットフォームは、これらのアクティビティを自動的に処理し、メンテナンスがシームレスで透過的であることを保証します。 Azure Service Health の計画メンテナンスを通じて通知されていない限り、メンテナンス イベント中にダウンタイムは想定されていません。
計画メンテナンス イベントでは、引き続きクライアント操作の一時的な障害が発生する可能性があります。 アプリケーションでは、 一時的な障害に対する回復性に関する再試行ガイダンスを使用して、これらのイベントを処理する必要があります。
サービス水準合意書
Azure サービスのサービス レベル アグリーメント (SLA) では、各サービスの予想される可用性と、その可用性の期待を達成するためにソリューションが満たす必要がある条件について説明します。 詳細については、オンラインサービスのSLAを参照してください。
Azure DocumentDB の場合、可用性 SLA は、クラスターで高可用性 (HA) が有効になっている場合にのみ適用されます。 次の構成には、さまざまな可用性 SLA が適用されます。
リージョン間レプリケーションを使用して複数のAzure リージョンにまたがる HA 対応クラスター。
1 つのリージョン内の HA 対応クラスター。