メモ
Azure AI 検索は、Azure ポータル、REST API、およびAzure SDKから使用できます。 また、Foundry IQ は、エンタープライズ コンテンツを、Microsoft Foundry ポータルのエージェントの再利用可能なアクセス許可に対応したナレッジ ベースに変換するマネージド ナレッジ レイヤーです。
Azure AI 検索では、いくつかの方法でインデクサーを実行できます。
- インデクサーの作成時にすぐに実行します。 このオプションは、インデクサーを無効な状態で作成しない限り、既定です。
- スケジュールに従って実行し、 一定の間隔で実行を呼び出します。 スケジュールされたインデクサーがトリガーを停止する場合は、復旧手順の スケジュール動作に関する FAQ を 参照してください。
- リセットの有無にかかわらず、オンデマンドで実行します。
この記事では、インデクサーを必要に応じて、リセットの有無にかかわらず実行する方法について説明します。 また、インデクサーの実行、期間、コンカレンシーについても説明します。
インデクサーが Azure リソースに接続する方法
インデクサーは、他のAzure リソースへの送信呼び出しを行う数少ないサブシステムの 1 つです。 外部データ ソースに応じて、キーまたはロールを使用して接続を認証できます。
Azureロールに関しては、インデクサーには個別の ID がありません。検索エンジンから別のAzure リソースへの接続では、検索サービスのシステムまたはユーザー割り当てマネージド ID と、ターゲット Azure リソースに対するロールの割り当てが使用されます。 インデクサーが仮想ネットワーク上のAzure リソースに接続する場合は、その接続の共有プライベート リンクを作成する必要があります。
メモ
インデクサーは、ユーザーのアクセス許可ではなく、サービス レベルのアクセス許可で動作します。 特定のインデックスへのアクセスを制限するロールを割り当てた場合でも、インデクサーは検索サービス上の任意のインデックスに書き込むことができます。 詳細については、「 インデックスごとのスコープとインデクサーの操作」を参照してください。
インデクサーの実行
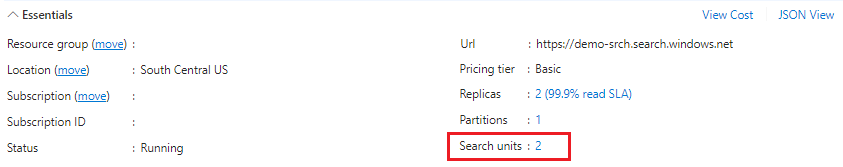
検索サービスは、検索ユニットごとに 1 つのインデクサー ジョブを実行 します。 すべての検索サービスは 1 つの検索単位で始まりますが、新しいパーティションまたはレプリカごとにサービスの検索単位が増加します。 検索ユニット数は、Overview ページの Azure ポータルの [要点] セクションで確認できます。 同時処理が必要な場合は、検索ユニットに十分なレプリカが含まれていることを確認してください。 インデクサーはバックグラウンドで実行されないため、サービスに負荷がかかっている場合は、通常よりも多くのクエリ調整が発生する可能性があります。
次のスクリーンショットは、一度に実行できるインデクサーの数を決定する検索単位の数を示しています。
インデクサーの実行が開始されると、一時停止または停止することはできません。 インデクサーの実行は、読み込みまたは更新するドキュメントがなくなった場合、または 実行時間の上限 に達すると停止します。
十分な容量を想定して一度に複数のインデクサーを実行できますが、各インデクサー自体は単一インスタンスです。 インデクサーが既に実行中に新しいインスタンスを開始すると、次のエラーが発生します。 "Failed to run indexer "<indexer name>" error: "Another indexer invocation is currently in progress; concurrent invocations are not allowed."
インデクサー実行環境
インデクサー ジョブは、マネージド実行環境で実行されます。 現在、次の 2 つの環境があります。
プライベート実行環境は、検索サービスに固有の検索クラスターで実行されます。
マルチテナント環境には、Microsoft が追加費用なしで管理および保護するコンテンツ プロセッサが含まれています。 この環境では、計算負荷の高い処理がオフロードされるため、サービス固有のリソースは日常的な操作に使用できます。 可能な限り、ほとんどのスキルセットはマルチテナント環境で実行されます。 この環境が既定です。
計算負荷の高い処理 とは、大量のドキュメントや大きなサイズのドキュメントを処理するコンテンツ プロセッサおよびインデクサー ジョブで実行されるスキルセットを指します。 ヒューリスティックとシステム情報は、マルチテナント コンテンツ プロセッサでの非スキルセット処理を決定し、顧客の管理下にありません。
インデクサーとスキルセットの処理を検索クラスターのみにピン留めすることで、Standard2 以降のサービスでマルチテナント環境を使用できないようにすることができます。 インデクサー定義の executionEnvironment パラメーターを、プライベート実行環境で常にインデクサーを実行するように設定します。
IP ファイアウォールは マルチテナント環境をブロックするため、ファイアウォールがある場合は、マルチテナント プロセッサ接続を許可する 規則を作成 します。
インデクサーの制限は、環境ごとに異なります。
| ワークロード | 最大期間 | ジョブ数の最大値 | 実行環境 |
|---|---|---|---|
| 個別実行 | 24 時間 | 検索ユニット1 ごとに 1 つのインデクサー ジョブ。 | インデックス作成はバックグラウンドでは実行されません。 代わりに、検索サービスは、すべてのインデックス作成ジョブを、進行中のクエリやオブジェクト管理アクション (インデックスの作成や更新など) とバランスを取ります。 インデクサーを実行する場合、インデックス作成のボリュームが大きい場合は 、クエリの待機時間が 発生することが予想されます。 |
| マルチテナント | 2 時間 2 | 不確定 3 | コンテンツ処理クラスターはマルチテナントであるため、システムは需要に合わせてコンテンツ プロセッサを追加します。 オンデマンドまたはスケジュールされた実行で遅延が発生した場合は、システムがプロセッサを追加しているか、使用可能になるのを待っている可能性があります。 |
検索ユニットはパーティションとレプリカの柔軟な組み合わせが可能ですが、インデックス作成ジョブはどちらか一方に縛られることはありません。 つまり、12 ユニットの場合、検索ユニットのデプロイ方法に関係なく、12 個のインデクサー ジョブをプライベート実行で同時に実行できます。
2 すべてのデータを処理するために 2 時間以上必要な場合は、 変更検出を有効に し、イン デクサー を 5 分間隔で実行するようにスケジュールし、タイムアウトによってインデックスが停止した場合にインデックス作成を迅速に再開します。 その他の戦略については 、大規模なデータ セットのインデックス作成 を参照してください。
3 "不確定" とは、ジョブの数によって制限が定量化されていないことを意味します。 スキルセット処理などの一部のワークロードは並列で実行できるため、インデクサーが 1 つだけ関係していても多くのジョブが発生する可能性があります。 環境には制約はありませんが、検索サービスの インデクサーの制限 は引き続き適用されます。
リセットなしで実行
インデクサーの実行操作では、検索インデックスを基になるデータ ソースの変更と同期するために必要なもののみが検出され、処理されます。 増分インデックス作成は、最後に更新された検索ドキュメントを見つけるために、まず内部のハイウォーターマークを特定することから始まります。 このドキュメントは、データ ソース内の新規および更新されたドキュメントに対するインデクサー実行の開始点になります。
変更検出 は、データ ソースの新機能または更新内容を決定するために不可欠です。 インデクサーは、基になるデータ ソースの変更検出機能を使用して、データ ソースの新機能または更新内容を決定します。
Azure Storageには、LastModified プロパティを使用した変更検出が組み込まれています。
Azure SQLやAzure Cosmos DBなどの他のデータ ソースでは、インデクサーが新しい行と更新された行を読み取る前に、変更検出の構成が必要です。
基になるコンテンツが変更されていない場合、実行操作は無効になります。 この場合、インデクサーの実行履歴は、処理されたドキュメント 0\0 示します。
すべてのドキュメントを再処理するには、インデクサーをリセットする必要があります。
インデクサーのリセット
最初の実行後、インデクサーは、内部のハイ ウォーターマークを使用してどの検索ドキュメントがインデックス付けされたかを追跡します。 マーカーは公開されませんが、内部的にはインデクサーは最後に停止した場所を認識します。
インデックスのすべてまたは一部を再構築するには、オブジェクト階層内のレベルを下げる際に使用できるリセット API を使用します。
- インデクサーをリセット すると、高基準がクリアされ、すべてのドキュメントの完全なインデックス再作成が実行されます。
- インデクサーの再同期 (プレビュー) は、すべてのドキュメントの効率的な部分的なインデックス再作成を実行します。
- ドキュメントのリセット (プレビュー) は、特定のドキュメントまたはドキュメントの一覧のインデックスを再作成します。
- スキルのリセット (プレビュー) は、特定のスキルのスキル処理を呼び出します。
リセット後は、[実行] コマンドに従って、新規および既存のドキュメントを再処理します。 リセットと実行では、データ ソース内に対応するものが存在しない孤立した検索ドキュメントは削除できません。 特定のドキュメントを削除するには、「 検索インデックス内のドキュメントを削除する 」または 「ドキュメント - インデックス」を参照してください。
メモ
テーブルを空にすることはできません。
TRUNCATE TABLEを使用して行をクリアした場合、インデクサーをリセットして再実行しても、対応する検索ドキュメントは削除されません。 孤立した検索ドキュメントを削除するには、 削除アクションでインデックスを作成する必要があります。
インデクサーをリセットして実行する方法
リセットすると、高い基準値がクリアされます。 検索インデックス内のすべてのドキュメントには、インライン更新や既存のコンテンツへのマージを行わずに、完全上書きのフラグが設定されます。 スキルセットと エンリッチメント キャッシュを使用するインデクサーの場合、インデックスをリセットすると、スキルセットも暗黙的にリセットされます。
実際の作業は、Run コマンドを使用してリセットに従うと発生します。
- 基になるソースが見つかったすべての新しいドキュメントが検索インデックスに追加されます。
- データ ソースと検索インデックスの両方に存在するすべてのドキュメントは、検索インデックスで上書きされます。
- スキルセットから作成されたエンリッチメントされたコンテンツはすべて再構築されます。 エンリッチメント キャッシュが有効になっている場合は、更新されます。
前述のように、リセットはパッシブ操作です。インデックスを再構築するには、実行要求に従う必要があります。
リセット/実行操作は、検索インデックスまたはナレッジ ストア、特定のドキュメントまたはプロジェクション、およびキャッシュされたエンリッチメント (明示的または暗黙的にリセットにスキルが含まれる場合) に適用されます。
リセットは、作成操作と更新操作にも適用されます。 検索インデックス内の孤立したドキュメントの削除やクリーンアップはトリガーされません。 ドキュメントの削除の詳細については、「ドキュメント - インデックス」を参照してください。
リセット操作を元に戻すことはできません。
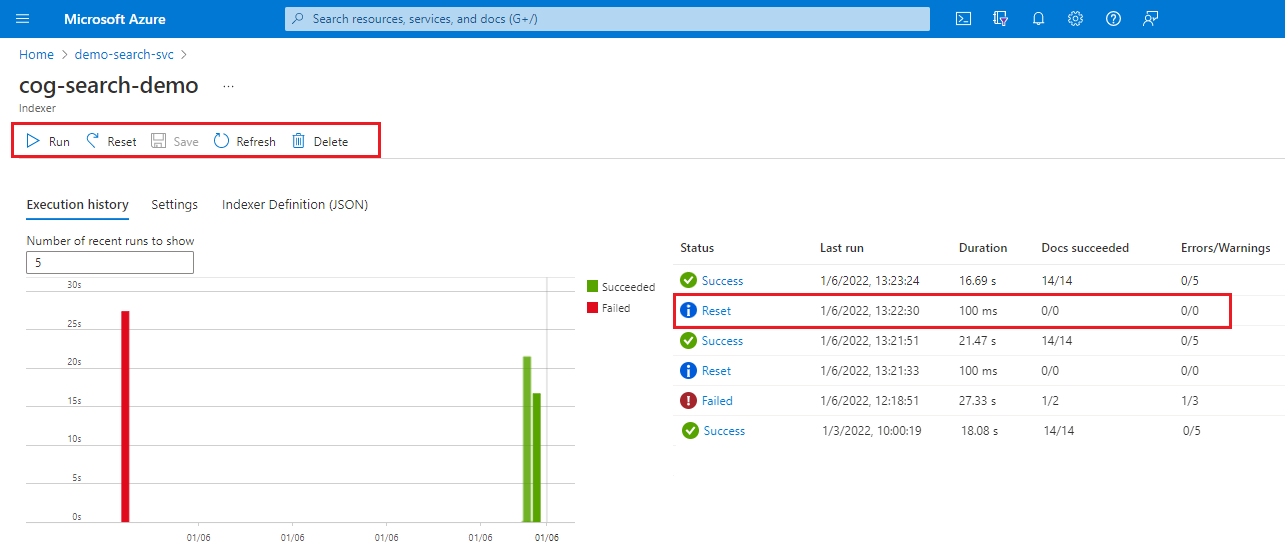
Azure ポータルで検索サービスに移動します。
[ 概要 ] ページで、[ インデクサー ] タブを選択します。
インデクサーを選択します。
[ リセット ] コマンドを選択し、[ はい ] を選択してアクションを確認します。
ページを更新して状態を表示します。 項目を選択すると、その詳細を表示できます。
[ 実行 ] を選択してインデクサーの処理を開始するか、次にスケジュールされた実行を待ちます。
スキルをリセットする方法 (プレビュー)
スキルのリセット要求は、次のインデクサーの実行中に 1 つ以上のスキルを選択的に処理します。 スキルセットを持つインデクサーの場合は、個々のスキルをリセットして、そのスキルとその出力に依存するダウンストリーム スキルのみを強制的に再処理できます。 エンリッチメント キャッシュを有効にした場合、そのリクエストによってそれも更新されます。
キャッシュが有効になっているインデクサーの場合、インデクサーが検出できないスキル更新の処理を明示的に要求できます。 たとえば、カスタム スキルのリビジョンなど、外部の変更を行う場合は、この API を使用してスキルを再実行します。 このプロセスでは、キャッシュからの再利用可能なデータと更新されたスキルごとの新しいコンテンツを使用して、ナレッジ ストアや検索インデックスなどの出力を更新します。
最新の プレビュー API を使用します。
POST /skillsets/[skillset name]/resetskills?api-version=2026-08-01-preview
{
    "skillNames" : [
        "#1",
        "#5",
        "#6"
    ]
}
前の例に示すように個々のスキルを指定できますが、これらのスキルのいずれかが一覧に含まれていないスキル (#2 から #4) からの出力を必要とする場合、キャッシュが必要な情報を提供できない限り、プロセスは一覧に記載されていないスキルを実行します。 この条件を満たすには、スキル #2 から #4 のキャッシュされたエンリッチメントが #1 (リセット用に一覧表示) に依存しないようにする必要があります。
スキルを指定しない場合、プロセスはスキルセット全体を実行し、キャッシュが有効になっている場合はキャッシュも更新します。
実際の処理を呼び出すために、インデクサーを実行することを忘れないでください。
ドキュメントをリセットする方法 (プレビュー)
インデクサー - ドキュメントのリセット (プレビュー) API は、特定のドキュメントを更新できるように、ドキュメント キーの一覧を受け入れます。 リセット パラメーターを指定した場合、基になるデータの他の変更に関係なく、何が処理されるのかを決定します。 たとえば、前回のインデクサー実行以降に 20 個の BLOB が追加または更新されたが、1 つのドキュメントのみをリセットした場合、インデクサーはそのドキュメントのみを処理します。
インデクサーは、ドキュメントごとに、データ ソースの値とメタデータを使用して、検索ドキュメント内のすべてのフィールドを更新します。 更新するフィールドを自由に選べるわけではありません。
データ ソースが Azure Data Lake Storage (ADLS) Gen2 で、BLOB がアクセス許可メタデータに関連付けられている場合、基になるデータのアクセス許可が変更された場合、インデクサーは検索インデックスにそれらのアクセス許可を再取り込みします。 詳細については、 ADLS Gen2 インデクサーを使用した ACL および RBAC スコープのインデックス再作成に関するページを参照してください。
スキルセットを使用してドキュメントを強化し、データをキャッシュした場合、インデクサーは指定されたドキュメントに対してスキルセットを呼び出し、再処理されたドキュメントのキャッシュを更新します。
この API を初めてテストするときは、次の API を使用して動作の検証とテストを行うことができます。 最新のプレビュー API を使用します。
インデクサーの呼び出し - プレビュー API バージョンで状態を取得し、リセットの状態と実行状態を確認します。 リセット要求に関する情報は、状態の応答の最後にあります。
インデクサーの呼び出し - プレビュー API バージョンで Docs をリセットし、処理するドキュメントを指定します。
POST https://[service name].search.windows.net/indexers/[indexer name]/resetdocs?api-version=2026-08-01-preview
{
    "documentKeys" : [
        "1001",
        "4452"
    ]
}
API は、2 種類のドキュメント識別子を入力として受け入れます。検索インデックス内のドキュメントを一意に識別するドキュメント キーと、データ ソース内のドキュメントを一意に識別するデータ ソース ドキュメント識別子です。 本文には、ドキュメント キーの一覧 または インデクサーがデータ ソースで検索するデータ ソース ドキュメント識別子の一覧が含まれている必要があります。 API を呼び出すと、インデクサー メタデータにリセットするドキュメント キーまたはデータ ソース ドキュメント識別子が追加されます。 インデクサーの次回のスケジュールされた実行またはオンデマンド実行では、インデクサーはリセット ドキュメントのみを処理します。
ドキュメント キーを使用してドキュメントをリセットし、ドキュメント キーがインデクサー フィールド マッピングで参照されている場合、インデクサーはフィールド マッピングを使用して基になるデータ ソース内の適切なフィールドを検索します。
要求で指定するドキュメント キーは検索インデックスの値であり、データ ソース内の対応するフィールドとは異なる場合があります。 キー値がわからない場合は、値を返す クエリを送信します 。
selectを使用して、ドキュメント キー フィールドのみを返すことができます。インデクサーが複数の検索ドキュメントに解析する blob (
parsingModeが jsonLines or jsonArrays、あるいは delimitedText に設定されているもの) の場合、インデクサーがドキュメント キーを生成するため、そのキーがユーザーにはわからない可能性があります。 このシナリオでは、正しい値を返すドキュメント キーのクエリ。インデクサーでリセット ドキュメントの処理を停止する場合は、
"documentKeys"または"datasourceDocumentIds"を空のリスト[]に設定します。 このアクションにより、インデクサーは高い基準に基づいて通常のインデックス作成を再開します。 無効なドキュメント キーまたは存在しないドキュメント キーは無視されます。
インデクサーの実行 (任意の API バージョン) を呼び出して、指定したドキュメントを処理します。 インデクサーは、それらの特定のドキュメントにのみインデックスを作成します。
Run Indexer をもう一度呼び出して、前回のハイウォーターマークから処理します。
ドキュメント検索を呼び出して、更新された値を確認し、値がわからない場合はドキュメント キーを返します。 応答に表示するフィールドを制限する場合は、
"select": "<field names>"を使用します。
ドキュメント キーリストを上書きする
異なるキーを使用してドキュメントのリセット API を複数回呼び出すと、新しいキーがドキュメント キーリセットの一覧に追加されます。
overwrite パラメーターを true に設定して API を呼び出すと、現在のリストが新しいものに置き換えられます。
POST https://[service name].search.windows.net/indexers/[indexer name]/resetdocs?api-version=2026-08-01-preview
{
    "documentKeys" : [
        "200",
        "630"
    ],
    "overwrite": true
}
インデクサーを再同期する方法 (プレビュー)
再同期インデクサー は、すべてのドキュメントの部分的なインデックス再作成を実行するプレビュー REST API です。 インデクサーは、ターゲット インデックス内のすべてのドキュメントの特定のフィールドがデータ ソース内のデータと一致している場合、そのデータ ソースと同期されていると見なされます。 通常、インデクサーは最初の実行が成功した後に同期を実行します。 データ ソースからドキュメントを削除した場合、インデクサーはこの定義に従って同期されたままになります。 ただし、次のインデクサーの実行中に、削除の追跡が有効になっている場合、ターゲット インデックス内の対応するドキュメントが削除されます。
データ ソース内のドキュメントを変更すると、インデクサーは同期されません。 一般に、変更追跡メカニズムは、次の実行時にインデクサーを再同期します。 たとえば、Azure Storageでは、BLOB を変更すると最後に変更された時刻が更新されるため、更新された時刻が前回の実行で設定された高基準を超えるため、インデクサーは後続のインデクサー実行でインデックスを再作成できます。
これに対し、ADLS Gen2 などの特定のデータ ソースでは、BLOB のアクセス制御リスト (ACL) を変更しても最終変更時刻は変更されないため、ACL を取り込む場合、変更の追跡は無効になります。 したがって、BLOBが変更されても、インデックスが再作成されることはありません。これは、最後のハイウォーターマーク以降に変更されたドキュメントのみが後続の実行で処理されるためです。
"reset" または "reset docs" を使用するとこの問題に対処できますが、"リセット" は時間がかかり、大規模なデータセットでは非効率的な場合があり、"ドキュメントのリセット" には更新する BLOB のドキュメント キーを識別する必要があります。
インデクサーを再同期すると、効率的で便利な代替手段が提供されます。 インデクサーを再同期モードにし、再同期するコンテンツを指定するには、再同期インデクサー API を呼び出します。 次の実行では、インデクサーはソース内のデータの関連部分のみを検査し、指定されたデータに関連しない不要な処理を回避します。 また、ターゲット インデックス内の既存のドキュメントに対してクエリを実行し、データ ソースとターゲット インデックスの間の不一致を示すドキュメントのみを更新します。 再同期の実行後、インデクサーは同期され、後続の実行では通常のインデクサー実行モードに戻ります。
インデクサーを再同期して実行する方法
インデクサーを呼び出す - プレビュー API バージョンと再同期して、再同期するコンテンツを指定します。
POST https://[service name].search.windows.net/indexers/[indexer name]/resync?api-version=2026-08-01-preview { "options" : [ "permissions" ] }-
optionsフィールドが必要です。 現在、サポートされている唯一のオプションはpermissionsです。 つまり、ターゲット インデックス内のアクセス許可フィルター フィールドのみが更新されます。
-
インデクサーの実行 (任意の API バージョン) を呼び出して、インデクサーを再同期します。
Run Indexer をもう一度呼び出して、前回のハイウォーターマークから処理します。
リセット状態 "currentState" を確認する
リセット状態を確認し、処理のためにキューに登録されているドキュメント キーを確認するには、次の手順に従います。
プレビュー API を使用して インデクサーの状態の取得 を呼び出します。
プレビュー API は、応答の最後にある
currentStateセクションを返します。"currentState": { "mode": "indexingResetDocs", "allDocsInitialTrackingState": "{\"LastFullEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"LastAttemptedEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"NameHighWaterMark\":null}", "allDocsFinalTrackingState": "{\"LastFullEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"LastAttemptedEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"NameHighWaterMark\":null}", "resetDocsInitialTrackingState": null, "resetDocsFinalTrackingState": null, "resyncInitialTrackingState": null, "resyncFinalTrackingState": null, "resetDocumentKeys": [ "200", "630" ] }モードを確認してください。
スキルのリセットでは、AI エンリッチメントが設定するフィールドの観点から、すべてのドキュメントが影響を受ける可能性があるため、"mode" を
indexingAllDocsに設定します。再同期インデクサーの場合は、"mode" を
indexingResyncに設定します。 インデクサーはすべてのドキュメントをチェックし、対象のデータ ソースのデータとターゲット インデックスの対象フィールドに重点を置いています。[ドキュメントのリセット] で、[モード] を
indexingResetDocsに設定します。 インデクサーは、ドキュメントのリセット呼び出しで指定されたすべてのドキュメント キーを処理するまで、この状態を保持します。 この間、操作の進行中に他のインデクサー ジョブは実行されません。 ドキュメント キーリスト内のすべてのドキュメントを見つけるには、各ドキュメントを解読してキーを検索して一致させる必要があります。 データ セットが大きい場合、このプロセスには時間がかかる場合があります。 BLOB コンテナーに何百もの BLOB が含まれており、リセットするドキュメントが最後にある場合、インデクサーは最初に他のすべてをチェックするまで、一致する BLOB を見つけることができません。インデクサーがドキュメントを再処理した後、再びインデクサーの状態の取得を実行します。 インデクサーは
indexingAllDocsモードに戻り、次回の実行時に新規または更新されたドキュメントを処理します。
S3 HD およびサーバーレス検索サービスのインデクサー ランタイム クォータを確認する
このセクションは、Standard 3 High Density (S3 HD) およびサーバーレス検索サービスに適用されます。 クォータの集計動作と計画のガイダンスについては、 サーバーレスおよび S3 HD でのインデクサーの実行に関する記事を参照してください。
各インデクサー実行の最大値は 2 時間です。 個別に、すべてのインデクサーは、各 24 時間 UTC ウィンドウでサービスごとに 24 時間の累積ランタイムを共有します。
24 時間のウィンドウに対するインデクサーの実行時間を監視するために、 サービス統計の取得 と インデクサーの状態の取得 で、応答の詳細情報が返されるようになりました。
累積ランタイム クォータを追跡する
検索サービスの累積インデクサー ランタイムの使用状況を追跡し、現在の 24 時間以内に残っているランタイム クォータの量を決定します。
検索サービス エンドポイントに GET 要求を送信します。 REST クライアントの設定とアクセス トークンの取得に関するヘルプについては、「 検索サービスへの接続」を参照してください。
GET {{search-endpoint}}/servicestats?api-version=2026-08-01-preview
  Content-Type: application/json
  Authorization: Bearer {{accessToken}}
応答には、ウィンドウの開始時刻と終了時刻を示す indexersRuntime プロパティ、すべてのインデクサーで使用される累積秒数、サービスの残りの秒数が含まれます。
インデクサーのランタイムクォータを追跡する
1 つのインデクサーに対して同じ情報を返します。
GET {{search-endpoint}}/indexers/hotels-sample-indexer/search.status?api-version=2026-08-01-preview
  Content-Type: application/json
  Authorization: Bearer {{accessToken}}
応答には、ウィンドウの開始時刻と終了時刻を示す runtime プロパティ、インデクサーで使用される秒数、サービス内のすべてのインデクサーの残り秒数が含まれます。
次の手順
リセット API は、次のインデクサー実行のスコープを通知するために使用されます。 実際の処理では、オンデマンド インデクサーの実行を呼び出すか、スケジュールされたジョブで作業を完了できるようにする必要があります。 実行が完了すると、インデクサーは通常の処理 (スケジュールまたはオンデマンド処理) に戻ります。
インデクサー ジョブをリセットして再実行した後、検索サービスから状態を監視したり、リソース ログを使用して詳細情報を取得したりできます。