Note
Azure AI 検索は、Azure ポータル、REST API、およびAzure SDKから使用できます。 また、Foundry IQ は、エンタープライズ コンテンツを、Microsoft Foundry ポータルのエージェントの再利用可能なアクセス許可に対応したナレッジ ベースに変換するマネージド ナレッジ レイヤーです。
Azure AI 検索では、それぞれ異なるワークロード パターン用に設計された 2 つの価格モデルがサポートされています。
専用: 検索ユニット(SU)に基づく固定料金。 サービス レベルを選択すると、プロビジョニングされたユニットに基づいて 1 時間ごとに課金されます。
サーバーレス (プレビュー): インデックス付きストレージのコンピューティング ユニット/時間 (CU/時間) と GB/月単位で測定される使用量ベースの価格。
Important
サーバーレス開発者レベルは現在プレビュー段階です。 このプレビュー版はサービス レベル アグリーメントなしで提供されています。運用環境のワークロードに使用することはお勧めできません。 特定の機能がサポートされていないか、機能が制限されている可能性があります。 詳細については、「 Microsoft Azure プレビューの追加使用条件」を参照してください。
サーバーレス開発者レベルの課金は、2026 年 9 月 13 日に開始されました。 その日以降の使用量の料金は、Azure請求書に表示されます。 2026 年 9 月 13 日より前の使用には課金されません。
サーバーレス開発者レベルでは、他の価格レベルとの間の移行はサポートされていません。また、他のレベルで使用できる一部の機能は、パブリック プレビュー中はサポートされていません。 サービスの制限、サポートされている機能、および価格の詳細は、一般公開前に変更される可能性があります。
プレビュー期間中、サーバーレス価格モデルは 特定のリージョンでのみサポートされます。
価格モデルとサービス レベルの違いの詳細については、「 価格モデルとサービス レベルの選択」を参照してください。
サーバーレス モデルでのコストの決定方法
専用とサーバーレスの価格モデルでは、検索サービス内での作業が異なります。 専用サービスは、既に購入したプロビジョニング済み容量に対してクエリ、インデックス作成、および結果処理を実行します。 サーバーレス サービスは、これらの操作が消費するコンピューティング、メモリ、ディスク I/O を測定し、その使用量をコンピューティング ユニット (CU) に変換します。 その結果、 パフォーマンスの最適化はサーバーレス コストに直接影響します。
サーバーレス コストは、ワークロードの実行に関連付けられます。
- クエリとインデックス作成では、コンピューティングが消費されます(1 時間あたりのコンピューティング ユニット数 (CU/h) 単位)。
- アクティブインデックスは、リソースの使用状況とアクティブな状態を維持する期間に基づいてコンピューティングを消費します。
- インデックスは、最後のクエリまたはインデックス作成要求の後、非アクティブになる前に 10 分間アクティブなままです。
- 非アクティブなインデックスには、最小または予約済みのコンピューティング料金はありません。 非アクティブなインデックスのコンピューティング使用量は 0 にスケーリングされます。 インデックスが非アクティブな場合、コンピューティングの最小料金は発生しません。
- ストレージ料金は、ディスク上のインデックス サイズに基づいて別途課金され、インデックスが使用中かどうかにかかわらず継続されます。
- エージェント型取得では、検索サービス内で実行される検索クエリとオーケストレーションに対して、コンピューティング リソースが消費されます。
ストレージ料金は、インデックスを削除した場合にのみ停止します。
現在の請求サイクルのコストの内訳と使用率を表示するには、Azure ポータルの [スケール + コスト] タブを表示します。
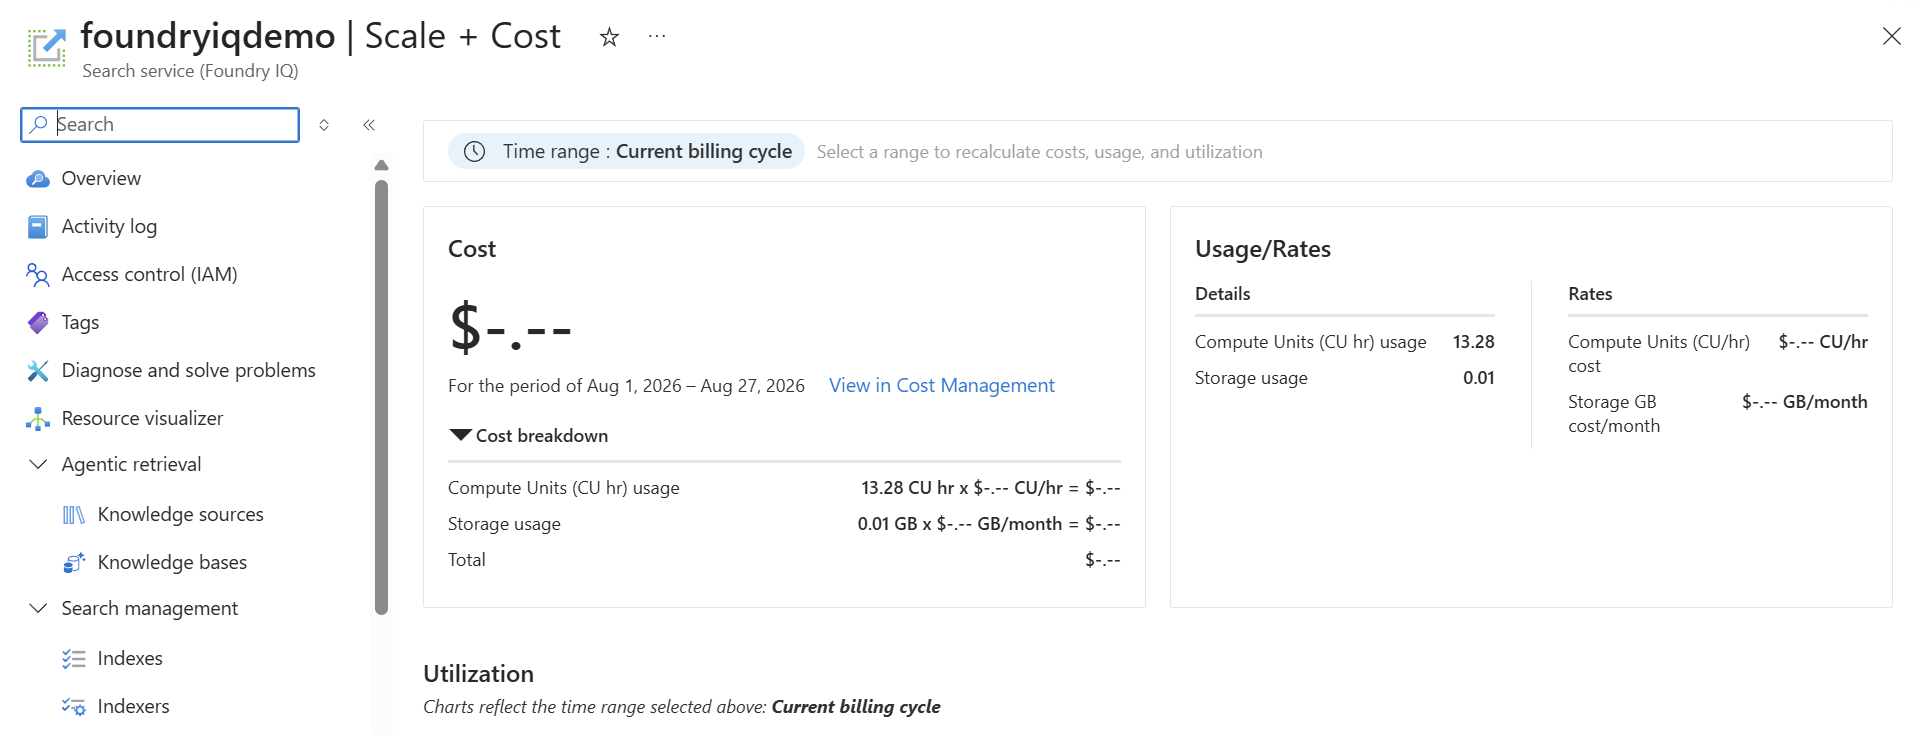
インデックス サイズがコンピューティングの使用状況に与える影響
インデックスがアクティブな間、Azure AI 検索は 2 つの有限リソースを評価して、そのコンピューティング使用量を判断します。
- インデックスの合計サイズ: テキスト、メタデータ、ベクトルを含む、インデックスがディスク上で占有する合計領域。
- ベクター インデックス サイズ: ベクター インデックスによって使用されるメモリ。 メモリはディスクよりもリソースを集中的に消費するため、CU に変換すると、ベクター インデックス サイズの重みが大きくなります。
Azure AI 検索では、結果として得られる 2 つの CU 量は一緒に追加されません。 コンピューティング使用量は、どちらの量が高い方に基づいています。 たとえば、ベクター インデックス サイズは、ディスク上のインデックスの合計サイズが比較的小さい場合でも、コンピューティングの使用量を決定できます。
アクティブ インデックスコンピューティングの使用量を減らすには、どのリソースが高い CU 量を生成するかを特定します。 次に、インデックスの合計サイズ、ベクター インデックス サイズ、またはその両方を減らします。 インデックス付きストレージは、GB/月ごとに個別に課金されます。
サーバーレス価格モデルは、プロビジョニングされた容量が十分に活用されない、可変、断続的、または予測不可能なトラフィックを含むワークロードに対して最もコスト効率が高くなります。
Important
サーバーレス CU の料金には、クエリ、インデックス作成、結果処理、エージェント検索オーケストレーションなど、検索サービス内で実行される作業が含まれます。 検索サービスの外部で実行されたモデル呼び出しやその他の作業では、引き続き既存の課金メーターが使用されます。 たとえば、セマンティック ランク付け、エージェント クエリの書き換え、イメージの抽出、スキルの実行などがあります。
コンピューティング ユニット (CU) について
コンピューティング ユニット (CU) は、サーバーレス モデルで検索操作とインデックス作成操作を実行するために必要な測定されたシステム リソースを表します。 CU コストは、主に CPU、メモリ、IO の使用率によって決まります。また、インデックス サイズとドキュメント ペイロード サイズによって 2 次的に消費されます。使用量は 1 時間あたりのコンピューティング ユニット (CU/h) として課金されます。
コンピューティングのコストは次に応じて増減します:
- クエリの複雑さ
- インデックス サイズ (GB) と構造
- ドキュメント ペイロード サイズ (KB)
- フィールドの数と取得された結果
操作によってコスト プロファイルが異なります。
- 検索: 低コスト。 ID で 1 つのドキュメントを取得することが最も効率的な操作です。
- キーワード検索: 低コスト。 テキスト検索では逆インデックスが使用されます。これは、速度と計算の使用量が少ない場合に最適化されています。
- ベクター検索: コストが高い。 ベクター クエリは、高次元埋め込み全体で類似性の計算を必要とするため、計算コストが高くなります。 キーワード検索と比較して、コンピューティングの消費量が大幅に増加します。
- ハイブリッド検索: キーワード検索とベクター検索の両方のコストがかかります。これは、各クエリで両方のパイプラインが実行されるためであり、さらに、結果を統合するための Reciprocal Rank Fusion(RRF)による小さな追加オーバーヘッドも発生します。
コンピューティングの使用状況を監視する
コンピューティング消費量の監視は、コストの高い操作を特定し、クエリ パターンを最適化し、コストを見積もるのに役立ちます。 すべての要求のコンピューティング ユニット (CU) コストは、 x-ms-azs-compute-units-consumed HTTP 応答ヘッダーで浮動小数点数として返されます。 このヘッダーを使用して、コストの高い操作を特定し、クエリ パターンを最適化します。 Azure Monitorの HTTP 応答ヘッダーと操作イベントを調べることで、すべての要求の CU コストを追跡できます。 使用可能な監視データの種類とそのデータを分析する方法の詳細については、「監視Azure AI 検索」を参照してください。
-
ヘッダー:
x-ms-azs-compute-units-consumed: <value> - 値: 使用された CU を表す浮動小数点数。
Example:
Status: 200 OK
Content-Type: application/json
x-ms-azs-compute-units-consumed: 12.45
この例では、要求は 12.45 コンピューティング ユニットを消費しました。 この値を使用して、高コストの操作を識別し、さまざまなクエリ パターンの相対的なコストを比較できます。
サーバーレス検索サービスのコンピューティング消費量の履歴を確認するには、Azure ポータルでAzure Monitorメトリックを使用します。
- お使いの検索サービスに移動します。
- [メトリック] を選びます。
- [ + メトリックの追加] を選択します。
- メトリックの一覧から、[ コンピューティング ユニットの使用量] を選択します。
- グラフを使用して使用状況の傾向を分析し、コンピューティング消費量の増加期間を特定します。
集計の使用状況を監視すると、全体的なサービス コストを理解し、最も多くのコンピューティング リソースを消費するワークロードを特定するのに役立ちます。 使用可能な監視メトリックの説明については、「 監視データリファレンス」を参照してください。 Azure Monitorログを使用して、時間の経過に伴う CU の使用状況の集計を追跡し、クエリのボリュームとワークロードの変更と関連付けることができます。
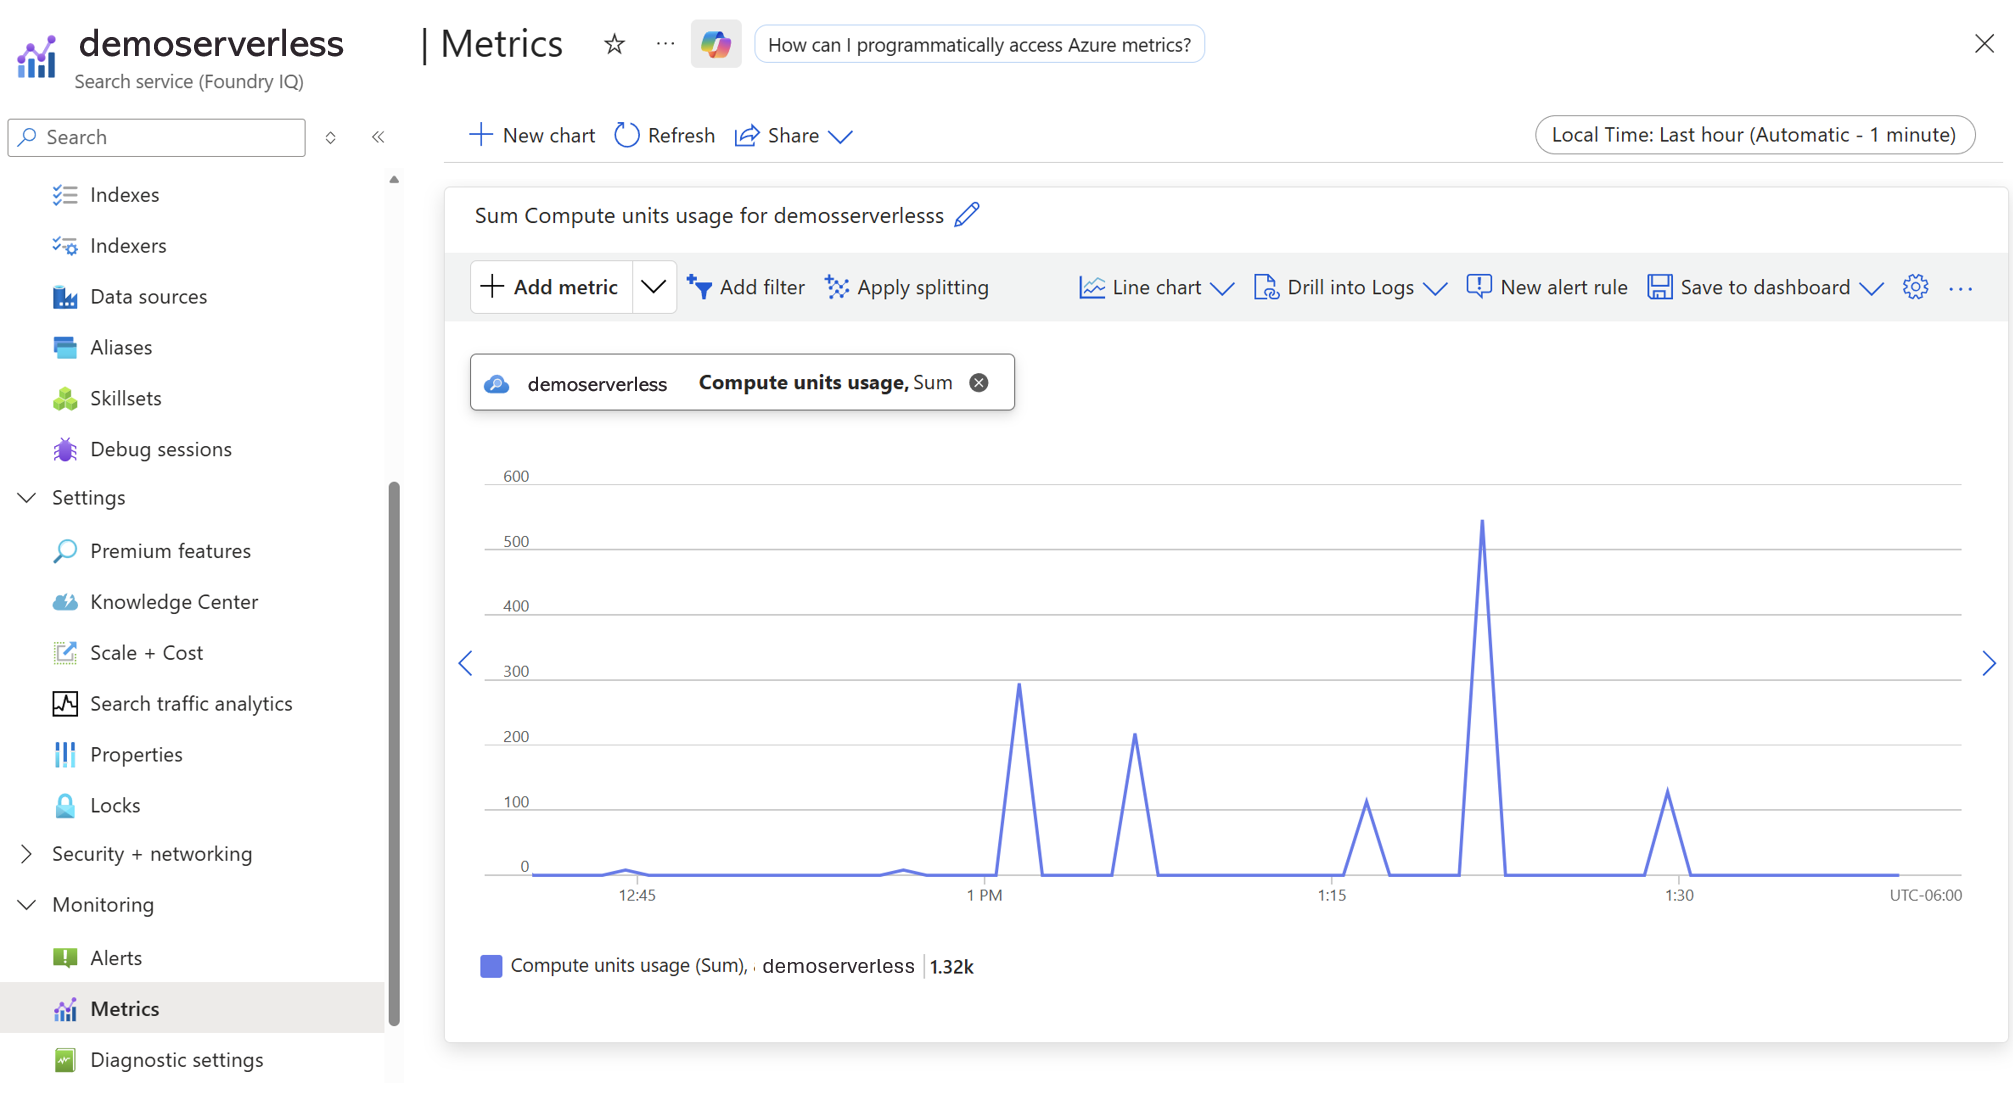
コンピューティング使用量のアラートを構成する
Azure ポータルでコンピューティング使用量が指定したしきい値に達したときに通知を受け取るアラート ルールを作成できます。
- 検索サービス の [アラート] に移動します。
- [+ アラート ルールの作成] を選択します。
- [ 条件] で、シグナルとして [コンピューティング ユニットの使用状況 ] を選択します。
- アラート ロジックを定義します。 たとえば、合計使用量が指定した値より大きい場合にトリガーします。
- 電子メール、SMS、Webhook 通知などの アクションを構成します。
- 残りの手順を完了し、[ 確認と作成] を選択します。
アラートは、予期しない使用量の急増に事前に対応し、コストを管理するのに役立ちます。
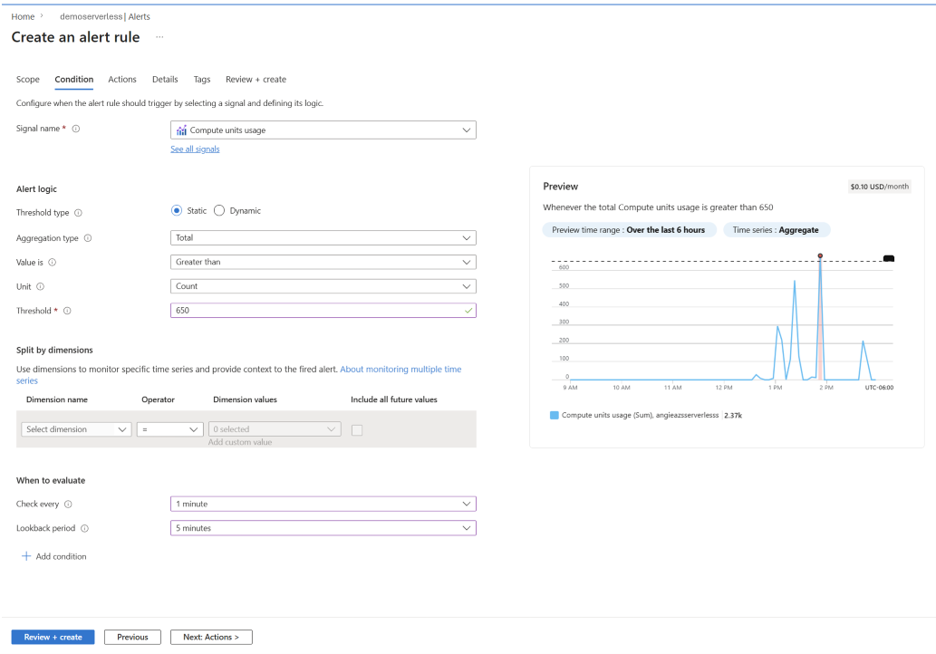
サーバーレスのコストを見積もる
Azure料金計算ツールと検索ユニット (SU) ベースの容量計画ガイダンスは、サーバーレス価格モデルを使用するサービスには適用されません。
サーバーレス コストを見積もる方法:
- 代表的なサンプル データのインデックスを作成します。
- 一般的なインデックス作成とクエリのワークロードを実行します。
- 各操作で返された
x-ms-azs-compute-units-consumed値を記録します。 - Azure Monitorメトリックを使用して、時間の経過に伴う集計の使用状況を測定します。
- 予想される運用トラフィックに基づいてコストを推定します。
Azure ポータルの [スケール + コスト] タブを使用して、現在の使用量を確認し、コストを見積もります。
同じデータに対して同じ要求が実行されると、一般に同様のコンピューティング消費量が生成されるため、代表的なワークロードはコスト見積もりの信頼性の高い基礎を提供できます。
サーバーレス使用量は継続的に測定され、課金対象として集計されます。 コンピューティング使用量は、1 分ごとに追跡され、コンピューティング リソースが使用されている場合にのみ出力されます。
コストを見積もる際は、要求チャージ値を使用して各操作のコストを把握し、Azure Monitor メトリックを使用してサービス全体の使用パターンを把握します。
両方のデータ ソースを一緒に使用してコストを把握します。要求ごとの課金データは個々の操作を評価するのに役立ち、Azure Monitorメトリックは時間の経過に伴うサービス使用量の集計を理解するのに役立ちます。 完全なコスト図では、コンピューティング ユニットとは別に課金される機能についても説明します。
課金は、個々の要求ではなく、コンピューティング使用量の集計に基づいています。 使用量は 1 分間隔で測定され、1 分あたり最も近い 0.25 CU に切り上げられます。 これらの 1 分間の使用間隔は、課金対象の CU/時間の量を決定するために、1 時間の間に累積されます。 内部的には、使用量はミリコンピューティング ユニット (mCU) からコンピューティング ユニット (CU) に集計され、課金のために報告された時間単位の使用量に変換されます。
操作によって消費されるコンピューティング量が異なります。 一般に、以下のことが行われます。
- キーワード検索では、通常、最小コンピューティング リソースが使用されます。
- ベクター検索では、通常、キーワード検索よりも多くのコンピューティング リソースが使用されます。
- ハイブリッド検索ではキーワードとベクター検索の実行が組み合わせられ、通常はどちらの手法よりも多くのコンピューティング リソースが使用されます。
実際のコンピューティング消費量は、クエリの複雑さ、インデックス サイズ、データ ボリューム、ベクター構成、返される結果の数などの要因によって異なります。 要求の料金と使用状況メトリックの集計を監視すると、最適化の機会を特定し、運用コストをより適切に予測するのに役立ちます。
最適化によるコンピューティング コストの削減
効率的なクエリとインデックス設計により、コンピューティングの消費量が削減され、コストが削減されます。
スキーマを最適化する
インデックス スキーマによって、ベースラインコンピューティングとストレージのコストが決まります。
- フィールド属性の制限: 必要に応じて、属性 (検索可能、フィルター可能、ファセット可能、並べ替え可能) のみを有効にします。 各属性は、インデックス サイズとインデックス作成コストを増やします。
- 複合型をフラット化する: 可能な場合は、入れ子になった JSON 構造を単純なフィールドまたはコレクションにマップします。
-
フィルター専用フィールドまたは並べ替え専用フィールドに対して retrievable=false を設定する: フィールドをフィルター処理または並べ替えに使用するが、結果で返す必要がない場合は、インデックスを作成し、
retrievable=false設定して、ディスク上のストレージと GB/月あたりのストレージ コストを削減します。 - 可能な場合は、取得可能なフィールドを使用します。たとえば、表示専用のフィールド (画像 URL など) は検索できません。
- ベクター ディメンションの削減: より高次元のベクターにより、ストレージとクエリのコストが増加します。 必要に応じて、より小さな埋め込みモデルまたは量子化を使用します。
- インデックスを作成する前にドキュメントペイロードのサイズを最小限に抑える: インデックス作成にかかるドキュメントのコストが大きくなります。 インデックスにドキュメントを送信する前に、不要なフィールドを削除し、長いテキストをトリミングし、HTML を削除します。
インデックス作成要求を最適化する
インデックスにデータを送信する方法は、コストとスループットの両方に影響します。
可能な限り大きなバッチを使用する: バッチ インデックス作成では、ネットワークを償却し、より多くのドキュメント間でコストを処理することで、要求ごとのオーバーヘッドが削減されます。 一般に、最大 1,000 個のドキュメントまたは最大 16 MB のバッチは、多数の小さな要求よりも CU 効率が高くなります。 ただし、最適なバッチ サイズはワークロードによって異なります。 スループット、待機時間、信頼性のバランスを取るためにテストします。
新しいデータまたは変更されたデータにのみインデックスを作成する: 可能な場合は、完全なインデックス再作成を避けてください。 追加と更新のみを送信すると、処理されるドキュメントの数が減り、コンピューティング コストが削減され、インジェスト速度が向上します。
必要な場合を除き、画像の抽出をスキップする: 画像抽出は追加の処理作業を追加し、別のコスト ドライバーになる可能性があります。 実際に画像コンテンツが必要なドキュメントまたはワークフローに対してのみ有効にします。
インデックス サイズの増加を考慮する: 可能な場合は、より小さなインデックスを作成します。 インデックスが大きくなると、より多くのデータを格納して維持する必要があり、操作により多くのコンピューティングが必要になるため、インデックス作成のコストが増加します。 非常に大規模なデータセットの場合は、パフォーマンスとコストの管理に役立つ複数のインデックス間でデータをパーティション分割することを検討してください。 コストはインデックス サイズと共に上昇しますが、増加はサブリニアです。 インデックスを大きくすると、操作あたりのコストは高くなりますが、比例的には増加しません。
詳しくは、Azure AI 検索 のパフォーマンス向上のためのヒントを参照してください。
インデクサー操作を最適化する
サーバーレス インデクサーのコンピューティング使用量は、各インデクサーの実行中に実行される作業によって異なります。 行指向ソースの場合は、ワークロード ボリュームのインジケーターとして処理されたドキュメントの数を使用します。 Azure Blob StorageやAzure Data Lake Storage Gen2などのファイル ベースのソースの場合は、処理されるソース データの量を監視します。 実際のコンピューティング使用量は、実行中に実行されるドキュメント ペイロード、インデックス構造、エンリッチメント、およびその他の処理にも依存します。
インデクサーのコンピューティング使用量を減らすには、
変更検出と増分インデックス作成を使用する: 完全なデータ ソースのインデックスを繰り返し作成するのではなく、新しいデータまたは変更されたデータのみを処理します。
適切なサイズのインデクサー スケジュール: データの鮮度要件を満たすスケジュールを選択します。 コンピューティング ユニット テレメトリを使用して、スケジュールの頻度の影響を評価します。
不要なドキュメント コンテンツを減らす: インデックスを作成する必要のないコンテンツを削除し、不要なファイルまたはファイルの種類を除外します。
エンリッチメント スキルのスコープを慎重に設定する: エンリッチメントが必要なフィールドとドキュメントに対してのみスキルを実行し、ダウンストリームで使用されない出力を生成しないようにします。 課金対象のスキルでは、個別のトランザクション料金が発生する可能性があります。
失敗した実行と繰り返し実行を監視する: インデクサーは、失敗する前に完了した作業に対して、コンピューティング リソースを消費することがあります。 実行履歴とコンピューティング ユニットの使用状況を確認して、繰り返し発生するエラーと再試行パターンを特定します。
クエリを最適化する
クエリ設計は、変動コストの主な要因です。
$selectを使用して、返されるフィールドを制限します。これにより、シリアル化に必要なペイロード サイズとコンピューティングが削減されます。GET /docs?search=test&$select=id,title,urlsearchFieldsを使用して、テキストが検索される場所を制限します。クエリ時間の一致をシナリオに関係のあるフィールドに制限します。 検索可能なフィールドが追加されるたびに、クエリ作業が増加し、CU/h が増加する可能性があります。完全一致または単純なキーワード クエリを優先します。あいまい、ワイルドカード、正規表現、プレフィックススタイルのクエリでは、広範なインデックス スキャンが強制され、CU/h が大幅に多く消費される可能性があります。 部分一致動作が必要な場合にのみ使用し、可能な限り完全一致または単純なキーワード クエリを選択します。
可能な場合は、検索ではなくルックアップを使用する: ID によるドキュメントの取得は、検索クエリを実行するよりも効率的です。 ドキュメント ID がわかっている場合は、検索クエリの代わりにルックアップを使用します。 検索はキーによってドキュメントを直接取得し、検索クエリは完全なクエリ パイプライン (解析、インデックス トラバーサル、スコアリング、ランク付け) を呼び出すので、より効率的です。そのため、コンピューティング コストが増加します。
深いページングを回避する (
$skip): 大きな$skip値を指定すると、エンジンは要求されたページの前にある結果を処理、スコア付け、ランク付けする必要があるため、コンピューティングが増加します。 たとえば、$skip=5000では、エンジンが返されない結果を少なくとも 5,000 件処理する必要があります。 この選択により、追加のコンピューティング ユニット (CU) が消費され、コストが増加する可能性があります。 代わりに、フィルターを使用して結果setを絞り込み、$topして返される結果の数を制限します。$topをアプリケーションまたは UI に適したサイズにします。$topでは、一致するドキュメントのスコア付けの数は変更されませんが、値を小さくすると、収集、並べ替え、シリアル化する必要がある結果の数が減ります。 アプリケーションで必要な数だけ結果を要求し、エンジンが大量の未使用の結果を処理する必要があるページング パターンを避けます。ファセット数とファセット スコープを最小限に抑える: UI に表示されるファセットのみを要求し、各ファセット
count値を実用的な値に維持します。 ファセットにはクエリごとの集計が必要であり、カウントが多い場合はコンピューティング コストが増加します。フィルター処理に
search.inを使用する: ID または値の一覧でフィルター処理する場合は、複数のsearch.in条件 (orなど) の代わりにid eq '1' or id eq '2'関数を使用します。 この方法の方が効率的で、コンピューティングのオーバーヘッドが軽減されます。 また、高カーディナリティ フィールド (一意の ID やフリー テキストの説明など、多数の一意の値を持つフィールド) は、必要に応じてフィルター可能またはファセット可能としてマークしないようにする必要があります。これにより、インデックス サイズとクエリ コストが増加するためです。
管理要求を最適化する
クエリ操作とインデックス作成操作に加えて、Azure AI 検索にはオブジェクト レベルおよびサービス レベルの管理操作 (インデックス スキーマやサービス統計の取得など) が含まれます。 これらの要求には、要求あたりのコストが一定です。 各要求は安価ですが、繰り返しまたは不要な呼び出しは時間の経過と同時に蓄積され、全体的なコンピューティング使用量が増加する可能性があります。
- 過剰な管理要求を避ける: インデックス スキーマなどのメタデータを繰り返し取得するのではなく、クライアント側でキャッシュします。 たとえば、すべての書き込み操作の前にインデックス スキーマをフェッチすると、不要なコストが発生します。 サーバーレス モデルでは、このパターンによってコンピューティング料金が直接増加します。一方、専用サービスでは、固定の時間単位の課金によって影響が隠されることがよくあります。
ベクター コストを最適化する
ベクター ワークロードは、コンピューティング ユニット (クエリとインデックス作成) とストレージ (ディスク上のベクター サイズ) の両方に影響するため、通常、サーバーレス価格モデルを検索する際に最もコストの高いコンポーネントです。 コストを削減するには、ベクターの格納方法とクエリ方法の両方を最適化します。
ベクター ストレージとスキーマを最適化する
ベクター フィールドを使用すると、インデックスサイズとインデックス作成コストが大幅に増加する可能性があります。 ストレージのオーバーヘッドを減らすには、次の手法を使用します。
圧縮を使用してベクター サイズを小さくする: 量子化を適用して、関連性への影響を最小限に抑えてストレージ占有領域を削減します。 たとえば、スカラー量子化では、検索品質への影響を最小限に抑えながら、ベクター ストレージを最大 4× 削減できます。
不要な場合はベクターのストレージを無効にする: 検索にベクターのみが必要な場合は、ベクター フィールドに stored=false を設定し、取得は必要ありません。 これにより、元のベクターがインデックスに格納されるのを回避し、クエリの動作に影響を与えずにストレージ コストを削減できます。
可能な場合は、埋め込みディメンションを小さくします。次元の高いベクターを使用すると、ストレージとクエリの両方のコストが増加します。 重要でないワークロードの場合は、コストを削減するために、小さな埋め込みモデル (1536 ではなく 384 または 768 のディメンションなど) を使用します。
ベクター クエリの実行を最適化する
ベクター クエリは、高次元データ構造に対する類似性の計算を必要とするため、コンピューティング集中型です。
ハイブリッド検索を選択的に使用する: ハイブリッド クエリでは、キーワードとベクターの両方の取得が実行されます。 関連性が必要な場合にのみ使用します。
ハイブリッド クエリの maxTextRecallSize を小さくする:
hybridSearch.maxTextRecallSize設定は、Reciprocal Rank Fusion に渡される BM25 で順位付けされた結果の数を制御します。 既定値は 1,000 (範囲 1 ~ 10,000) です。 コンピューティング消費量は、この値にほぼ直線的にスケーリングされるため、この値を下げることは、ハイブリッド ワークロードにとって最も直接的なコスト レバーの 1 つです。多くの場合、約 500 の値では、関連性の損失がほとんどなく、コンピューティングが有意義に削減されます。
さらに下げると、完全一致する用語、ID、頭字語など、ベクター検索が見逃すキーワード一致が失われる可能性があります。
各ベクター クエリで、k を使用してベクター候補を個別に制御します。
値にセトリングする前に、代表的なクエリをテストし、関連性、待機時間、および
x-ms-azs-compute-units-consumedヘッダーを比較します。ベクター クエリの前にフィルターを適用する: ベクター検索の前に候補セットを絞り込み、処理されるデータの量を減らします。 ベクター クエリでのフィルター処理のしくみを参照してください。
使用量を最小限に抑えることでコストを削減
サーバーレス モデルは、消費されたリソースに対してのみ課金されます。 要求がない場合は、それに応じてコンピューティング使用率が低下します。
使用コストを最小限に抑えるには:
- 必要な場合にのみクエリを実行します。
- 冗長な要求や過度に頻繁な要求は避けてください。
- 使用状況を監視し、需要に基づいてワークロードを調整します。
Tip
サービスがウォームかコールドかに応じて、同じクエリの待機時間と CU プロファイルが異なる場合があります。 読み取りまたは書き込みトラフィックがない期間が経過すると、サーバーレス価格モデルのコンピューティング使用量は 0 に低下します。 次の要求では、待機時間が長く、データ パスがウォームアップしている間に消費される CU が増える可能性があります。 一般に、インデックスのサイズが大きいほど、インデックスのサイズが小さいよりもウォーム化に時間がかかるため、コールド スタート効果は、多くの場合、大規模なサービスで顕著になります。
ストレージ コストを最適化する
ストレージは、生データ サイズを超える可能性があるディスク上のインデックス サイズに基づいて GB/月ごとに課金されます。 ストレージ コストを削減するには:
- 未使用のインデックスを削除します。
- 格納されているフィールドを最小限に抑えます。
- ストレージオーバーヘッドを考慮してスキーマを設計します。
- サジェスターはストレージ容量を大幅に増やす可能性があるため、必要な場合にのみ使用してください。
ベクター固有の手法 (圧縮、排除、およびストレージ設定) については、「 ベクターストレージと処理の最適化」を参照してください。
ストレージとクエリのパフォーマンスのトレードオフの詳細については、Tips を参照して、Azure AI 検索 のパフォーマンスを向上させます。