適用対象: Microsoft Fabric のウェアハウス✅
この記事では、Azure Synapse Analytics の専用 SQL プールから Microsoft Fabric Data Warehouse に移行する方法について説明します。
ヒント
戦略や移行計画の詳細については、「移行計画: Azure Synapse Analytics 専用 SQL プールから Fabric Data Warehouse へ」をご覧ください。
Data Warehouse 用 Fabric Migration Assistant を使用して、Azure Synapse Analytics 専用 SQL プールからの移行用の自動化されたエクスペリエンスを利用できます。 この記事の残りの部分では、より手作業が必要な移行手順について説明しています。
以下の表は、データスキーマ(DDL)、データベースコード(DML)、およびデータの移行方法をまとめたものです。 オプション欄には各シナリオの詳細へのリンクがあります。
| オプション番号 | 選択肢 | その機能 | スキルか好みか | シナリオ |
|---|---|---|---|---|
| 1 | データファクトリー | スキーマ (データ定義言語DDL) 変換 データ抽出 データ インジェスト |
ADF またはパイプライン | スキーマ (DDL) とデータ移行をオールインワンに簡略化しました。 ディメンション テーブル に推奨されます。 |
| 2 | Data Factory (パーティションあり) | スキーマ (データ定義言語DDL) 変換 データ抽出 データ インジェスト |
ADF またはパイプライン | パーティション分割オプションを使用して読み取り/書き込みの並列処理を向上させると、スループットがオプション 1 の 10 倍になります。これはファクト テーブルに推奨されます。 |
| 3 | Data Factory で高速コードを使用する | スキーマ (データ定義言語DDL) 変換 | ADF またはパイプライン | スキーマ (DDL) をまず最初に変換して移行してから、CETAS を使用して抽出し、COPY または Data Factory を使用してデータを取り込むことで、全体的なインジェスト パフォーマンスを最適化します。 |
| 4 | ストアド プロシージャの高速コード | スキーマ (データ定義言語DDL) 変換 データ抽出 コード評価 |
T-SQL | IDE を使用する SQL ユーザーは、どのタスクに着手するかをより細かく制御できます。 COPY または Data Factory を使用してデータを取り込みます。 |
| 5 | Visual Studio Code 用の SQL Database プロジェクト拡張機能 | スキーマ (データ定義言語DDL) 変換 データ抽出 コード評価 |
SQL プロジェクト | SQL Database プロジェクトをデプロイに使用し、オプション 4 を統合します。 COPY または Data Factory を使用してデータを取り込みます。 |
| 6 | SELECT として外部テーブルを作成する (CETAS) | データ抽出 | T-SQL | Azure Data Lake Storage (ADLS) Gen2 へのコスト効率とパフォーマンスの高いデータ抽出。 COPY または Data Factory を使用してデータを取り込みます。 |
| 7 | dbt を使用した移行 | スキーマ (データ定義言語DDL) 変換 データベース コード (DML) 変換 |
dbt | dbt を既に使用しているユーザーは、dbt Fabric アダプターを使用して DDL と DML を変換できます。 その後、この表にある他のオプションを使用してデータを移行する必要があります。 |
最初に移行するワークロードを選択する
Synapse専用SQLプールの移行プロジェクトFabric Data Warehouseどこから始めるか決める際は、以下の作業範囲を選んでください:
- 新しい環境の利点を迅速に提供することで、Fabric Data Warehouseへの移行の実現可能性を証明しましょう。 小さくシンプルに始めて、複数の小さな移動に備えましょう。
- 他の領域に移行するときに使用するプロセスとツールについて、社内の技術スタッフがそれに関連する経験を積む時間を確保します。
- ソース Synapse 環境に特化した、今後に使える移行テンプレートと、役立つツールやプロセスを作成します。
ヒント
移行するオブジェクトのインベントリを作成し、移行プロセスを最初から最後まで記録しておき、他の専用SQLプールやワークロードでも同じ手順を繰り返しできるようにしましょう。
初期の移行で移行されたデータの量は、Fabric Data Warehouse環境の機能と利点を示すのに十分な量であるべきですが、価値を迅速に示すには大きすぎてはいけません。 1 から 10 テラバイトの範囲のサイズが一般的です。
Fabric Data Factory を使用した移行
このセクションでは、Azure Data FactoryおよびSynapseパイプラインに慣れたユーザー向けのData Factoryオプションについて説明します。 ドラッグ&ドロップインターフェースは、DDLの変換やデータの移行を簡単に行えます。
Fabric Data Factory では、次のタスクを実行できます。
- スキーマ(DDL)をFabric Data Warehouse構文に変換します。
- Fabric Data Warehouse上でスキーマ(DDL)を作成します。
- データをFabric Data Warehouseに移行してください。
オプション 1。 スキーマとデータ移行 - コピーデータアシスタントとForEach コピーアクティビティ
この方法はData Factory Copy data assistantを用いて、元の専用SQLプールに接続し、専用SQLプールのDDL構文をFabricに変換し、データをFabric Data Warehouseにコピーします。 1 つ以上のターゲット テーブルを選択できます (TPC-DS データセットには 22 個のテーブルがあります)。 UI で選択したテーブルの一覧をループ処理する ForEach を生成し、22 個の並列する Copy アクティビティ スレッドが生成されます。
- 22の
SELECTクエリ(選択したテーブルごとに1つずつ)が生成され、専用のSQLプールで実行されます。 - 生成されたクエリを実行できるように、適切なDWUとリソースクラスを持っていることを確認してください。 今回のケースでは、送信された 22 個のクエリを最大 32 個のクエリで処理できるようにするために、
staticrc10を持つ DWU1000 が少なくとも 32 個必要です。 - 専用 SQL プールから Fabric Data Warehouse に Data Factory を使用してデータを直接コピーするには、ステージングが必要です。 摂取過程には2つの段階があります:
- 第1段階では、専用SQLプールからデータをADLSに抽出します。 この段階はステージングと呼ばれます。
- 第2段階では段階化されたデータをFabric Data Warehouseに取り込みます。 摂取時間の大部分はステージングフェーズに費やされるため、ステージングはパフォーマンスに大きな影響を与えます。
推奨される使用方法
コピーアシスタントを使ってForEachアクティビティを生成することで、DDLを変換し、専用SQLプールから選択したテーブルを一歩で取り込みFabric Data Warehouseに変換するシンプルなインターフェースを提供します。
しかし、この方法は最適な全体のスループットを提供するものではありません。 ステージングやソースからステージへの段階での読み書きの並列化の必要性がレイテンシの主な原因です。 このオプションは寸法表のみに使ってください。
オプション 2。 DDL/データ移行 - パーティションオプションを使用したパイプライン
Fabricパイプラインで大きなファクトテーブルを読み込む際のスループットを向上させるために、各ファクトテーブルにCopy アクティビティを使い、パーティショニングを有効にしてください。 この構成は、最良のCopy アクティビティパフォーマンスを提供します。
利用可能な場合は、ソーステーブルの物理パーティションを活用してください。 テーブルが物理的にパーティション分割されていない場合は、パーティション列と動的パーティショニング用の最小・最大値を指定してください。 以下のスクリーンショットでは、パイプライン のSource オプションが ws_sold_date_sk 列に基づく動的パーティション範囲を指定します。
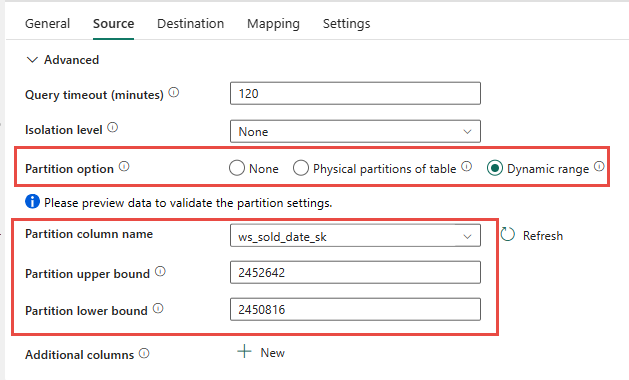
パーティションはステージングスループットを向上させることができます。 設定時には以下のガイダンスを考慮してください。
- パーティション範囲によっては、操作は128以上のクエリを生成し、専用SQLプールのすべての同時実行スロットを使用することがあります。
- すべてのクエリが実行できるように最小限のDWU6000にスケールする必要があります。
- たとえば、TPC-DS
web_salesテーブルの場合、163 個のクエリが専用 SQL プールに送信されています。 DWU6000時点で128件のクエリが実行され、35件のクエリがキューに入りました。 - 動的パーティションを使用すると、範囲パーティションが自動的に選択されます。 今回のケースでは、専用 SQL プールに送信された SELECT クエリごとに 11 日間という範囲です。 例えば:
WHERE [ws_sold_date_sk] > '2451069' AND [ws_sold_date_sk] <= '2451080')
...
WHERE [ws_sold_date_sk] > '2451333' AND [ws_sold_date_sk] <= '2451344')
推奨される使用方法
ファクトテーブルについては、Data Factoryのパーティション設定を使い、スループットを上げます。
しかし、並列読み込みでは、抽出クエリを実行するために専用SQLプールをより高いDWUにスケーリングする必要があります。 分割は分割を使わないよりも速度を10倍に向上させます。 DWUを増やしてスループットを増やすこともできますが、専用のSQLプールでは最大128件のアクティブなクエリまで対応できます。
Synapse DWU と Fabric の対応関係について詳しくは、ブログ: Azure Synapse 専用 SQL プールから Fabric Data Warehouse コンピューティングへのマッピングをご覧ください。
オプション 3。 DDL移行 - コピーデータアシスタント ForEach コピーアクティビティ
前述の2つの方法は 、小規模 なデータベースに適しています。 より高いスループットが必要な場合は、以下の代替案をご利用ください:
- 専用SQLプールからデータをADLSに抽出して、ステージングのオーバーヘッドを減らしましょう。
- Data FactoryまたはCOPYコマンドを使ってデータをウェアハウスに取り込みます。
推奨される使用方法
スキーマ (DDL) の変換には、Data Factory を引き続き使用できます。 コピーデータアシスタントを使えば、特定のテーブルまたは すべてのテーブルを選択できます。 設計上、この方法はスキーマを一段階で移行し、クエリ文の偽条件(false condition)を用いて行なしにスキーマを抽出します TOP 0 。
次のコード サンプルでは、Data Factory を使用したスキーマ (DDL) の移行について説明します。
コード例: Data Factory を使用したスキーマ (DDL) の移行
Fabric Pipelinesを使えば、Azure SQL Databaseや専用SQLプールなど任意のソースからテーブルオブジェクトのDDL(スキーマ)を簡単に移行できます。 このパイプラインは、元の専用SQLプールテーブルのスキーマ(DDL)をFabric Data Warehouseに移行します。
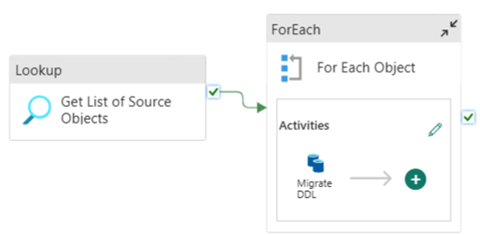
パイプラインの設計: パラメーター
このパイプラインはパラメータ SchemaNameを受け取り、どのスキーマを移行するかを指定します。 デフォルトのスキーマは dboです。
"既定値" フィールドに、移行するスキーマを示すテーブル スキーマの一覧をコンマ区切りで入力します。2 つのスキーマ 'dbo','tpch' と dbo を指定する場合は、tpch のようにします。
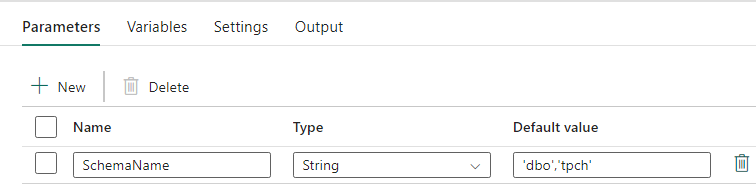
パイプラインの設計: 検索アクティビティ
Lookup アクティビティを作成し、ソース データベースをポイントするように接続を設定します。
[設定] タブで、次のようにします。
"データ ストアの種類" を [外部] に設定します。
接続は、Azure Synapse 専用の SQL プールです。 "接続の種類" は、[Azure Synapse Analytics] です。
[クエリの使用] は、[クエリ] に設定されています。
Queryフィールドは動的式を使って作成し、パラメータ
SchemaNameをターゲットソーステーブルのリストを返すクエリに使えます。 「クエリ」を選択し、次に「動的コンテンツを追加」を選択します。LookUp アクティビティに含まれるこの式により、システム ビューにクエリを実行してスキーマとテーブルの一覧を取得する SQL ステートメントが生成されます。 SQLスキーマでのフィルタリングを可能にするために
SchemaNameパラメータを参照します。 この式の出力は、ForEach Activityが入力として使用するSQLスキーマとテーブルの配列です。次のコードを使用して、すべてのユーザー テーブルとそのスキーマ名を含むリストを返します。
@concat('
SELECT s.name AS SchemaName,
t.name  AS TableName
FROM sys.tables AS t
INNER JOIN sys.schemas AS s
ON t.type = ''U''
AND s.schema_id = t.schema_id
AND s.name in (',coalesce(pipeline().parameters.SchemaName, 'dbo'),')
')

パイプラインの設計: ForEach ループ
ForEach ループについては、[設定] タブで次のオプションを構成します。
- シーケンシャルを無効にすると、複数の反復処理を同時に実行できるようになります。
- "バッチ カウント" を
50に設定して、同時実行するイテレーションの最大数を制限します。 -
Itemsフィールドの動的コンテンツを使ってLookUpアクティビティの出力を参照してください。 次のコード スニペットを追加します:
@activity('Get List of Source Objects').output.value
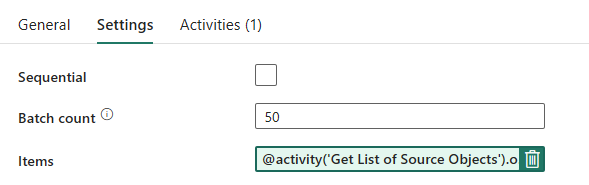
パイプラインの設計: ForEach ループ内の Copy アクティビティ
ForEach アクティビティ内に Copy アクティビティを追加します。 この方法はパイプライン内の動的表現言語を用いて、データなしでスキーマのみをウェアハウスに移行する SELECT TOP 0 * FROM <TABLE> 文を作成します。
[ソース] タブで:
- "データ ストアの種類" を [外部] に設定します。
- 接続は、Azure Synapse 専用の SQL プールです。 "接続の種類" は、[Azure Synapse Analytics] です。
- [クエリの使用] を [クエリ] に設定します。
-
クエリフィールドで動的コンテンツクエリを貼り付け、次の式を使用します。これは行がゼロですが、テーブルスキーマを含むものです。
@concat('SELECT TOP 0 * FROM ',item().SchemaName,'.',item().TableName)

[送信先] タブで、次の手順を実行します。
- "データ ストアの種類" を [ワークスペース] に設定します。
- ワークスペースのデータストアタイプをData Warehouseに設定し、Data Warehouseをウェアハウスに設定します。
- 送信先テーブルのスキーマとテーブル名は、動的コンテンツを使用して定義されます。
- スキーマは現在の反復のフィールドを指し、スニペット
SchemaName以下のようになります。@item().SchemaName - スニペット付き
TableName表参照:@item().TableName
- スキーマは現在の反復のフィールドを指し、スニペット

パイプラインの設計: シンク
シンクについては、ウェアハウスをポイントし、ソース スキーマとテーブル名を参照します。
このパイプラインを実行すると、ウェアハウスにソース内の各テーブルが正しいスキーマで入力されているのが見えます。
Synapse専用SQLプール内のストアドプロシージャを使用した移行
このオプションはストアドプロシージャを使ってFabric Data Warehouseへの移行を行います。
コード サンプルは、microsoft/fabric-migration on GitHub.com で入手できます。 このコードはオープン ソースとして公開されているため、ぜひ貢献してコミュニティを支援してください。
Fabric Migrationのストアドプロシージャができること:
- スキーマ(DDL)をFabric Data Warehouse構文に変換します。
- Fabric Data Warehouse上でスキーマ(DDL)を作成します。
- Synapse 専用 SQL プールから ADLS にデータを抽出します。
- T-SQLコード(ストアドプロシージャ、関数、ビュー)に対してサポートされていないFabric構文にフラグを付ける。
推奨される使用方法
この選択肢は、以下の方に最適です:
- T-SQLに慣れています。
- T-SQL開発に統合開発環境を使いたいです。
- どのタスクに取り組むかをより細かくコントロールしたいです。
スキーマ (DDL) 変換、データ抽出、または T-SQL コード評価用の特定のストアド プロシージャを実行できます。
データ移行には、COPY INTOまたはFabric Data Factoryを使ってデータをウェアハウスに取り込みます。
SQL データベース プロジェクトを使用して移行する
Fabric Data Warehouse Visual Studio Code内で利用可能なSQL Database Projects拡張をサポートしています。
この拡張機能は、Visual Studio Code 内で使用できます。 この機能により、ソース管理、データベース テスト、スキーマ検証の機能が有効になります。
ソース管理の詳細については、「 開発および展開の概要」をご覧ください。
推奨される使用方法
SQL Database Projectを導入したい場合、このオプションをご利用ください。 このオプションは、Fabric MigrationのストアドプロシージャをSQLデータベースプロジェクトに統合し、シームレスな移行体験を提供します。
SQL Database Project を使用すると、以下を行うことができます。
- スキーマ(DDL)をFabric Data Warehouse構文に変換します。
- Fabric Data Warehouse上でスキーマ(DDL)を作成します。
- Synapse 専用 SQL プールから ADLS にデータを抽出します。
- T-SQL コードでサポートされていない構文 (ストアド プロシージャ、関数、ビュー) にフラグを設定します。
データ移行では 、COPY INTO またはData Factoryを使ってデータをウェアハウスに取り込みます。
Microsoft Fabric CATチームは、SQLデータベースプロジェクトを通じてスキーマ(DDL)およびデータベースコード(DML)を抽出、作成、デプロイするためのPowerShellスクリプトを提供しています。 ウォークスルーについては、GitHubのmicrosoft/fabric-migrationをご覧ください。
SQL Database プロジェクトの詳細については、「 SQL Database Projects 拡張機能の概要 」および 「コマンド ラインからデータベース プロジェクトをビルドする」を参照してください。
CETAS を使用してデータを移行する
T-SQL CREATE EXTERNAL TABLE AS SELECT(CETAS)コマンドは、Azure Synapse専用SQLプールからデータをAzure Data Lake Storage(ADLS)Gen2に抽出する最もコスト効率が高く最適な方法を提供します。
CETAS でできることは以下のとおりです。
- ADLS にデータを抽出します。
- このオプションでは、データを取り込む前に倉庫内でスキーマ(DDL)を作成する必要があります。 スキーマ (DDL) を移行するには、この記事のオプションを検討してください。
このオプションの利点は次のとおりです。
- 移行は、元のSynapse専用SQLプールに対して1テーブルごとに1つのクエリのみを送信します。 このクエリはすべての並行スロットを消費せず、同時顧客生産のETLやクエリもブロックしません。
- DWU6000にスケールする必要はなく、各テーブルに1つの並行スロットしか使わないので、より低いDWUを使えます。
- 抽出はすべての計算ノードで並列に実行され、この機能によりパフォーマンスが向上します。
推奨される使用方法
CETAS を使用して、Parquet ファイルとしてデータを ADLS に抽出します。 パーケットファイルは、ネットワーク上で移動する際に消費する帯域幅を抑えるカラム圧縮による効率的なデータストレージの利点を提供します。 FabricはデータをDeltaパーケット形式で保存するため、取り込み時にDelta形式のオーバーヘッドに変換しないため、テキストファイル形式と比べて2.5倍高速です。
CETAS スループットを向上させるには、以下のようにします。
- 並列 CETAS 操作を追加することで、コンカレンシー スロットの使用を増やしつつ、スループットを向上させます。
- Synapse 専用 SQL プールの DWU をスケーリングします。
dbt を使用して移行する
このセクションでは、すでにSynapse専用SQLプール環境でdbtを使用している顧客向けのdbtオプションについて説明します。
dbt でできることは以下のとおりです。
- スキーマ(DDL)をFabric Data Warehouse構文に変換します。
- Fabric Data Warehouse上でスキーマ(DDL)を作成します。
- データベース コード (DML) を Fabric 構文に変換します。
dbt フレームワークを使用することで、実行のたびに DDL と DML (SQL スクリプト) を即座に生成できます。
SELECT文で表現されたモデルファイルを用いることで、dbtはプロファイル(接続文字列)とアダプタータイプを変更することで、DDL/DMLを即座に任意のターゲットプラットフォームに変換します。
推奨される使用方法
DBTフレームワークはコードファーストのアプローチを採用しています。 CETASやCOPY/Data Factoryなどのオプションを使ってデータを移行してください。
dbtアダプターをMicrosoft Fabric Data Warehouseに使うことで、専用SQLプール、Snowflake、Databricks、Google BigQuery、Amazon Redshiftなど異なるAzure Synapseプラットフォームを対象とした既存のdbtプロジェクトを、簡単な設定変更でウェアハウスに移行できます。
Fabric Data WarehouseをターゲットにしたDBTプロジェクトを始めるには、「チュートリアル:Fabric Data Warehouseのためにdbtを設定する」をご覧ください。 また、異なる倉庫やプラットフォーム間での移動オプションも記載されています。
Fabric Data Warehouseへのデータインジェスト
Fabric Data Warehouseへの取り込みには、好みに応じてCOPY INTOかData Factory Fabricを使います。 どちらの方法も推奨され、パフォーマンススループットが同等であり、ファイルがすでにAzure Data Lake Storage(ADLS) Gen2に抽出されていることが前提条件です。
以下の要素を考慮して、最大のパフォーマンスを追求するためにプロセスを設計します。
- Fabricでは、ADLSからFabric Data Warehouseに複数のテーブルを同時に読み込む際にリソース競合が発生しません。 結果として、並列スレッドを読み込んでも、パフォーマンスが低下しません。 最大インジェスメントスループットは、Fabric容量の計算能力のみによって制限されます。
- Fabric のワークロード管理では、負荷とクエリに割り当てるリソースは分離されます。 クエリとデータロードが同時に実行されている間はリソース競合がありません。