適用対象:✅ Microsoft Fabric の SQL 分析エンドポイントおよびウェアハウス
Important
この機能は プレビュー段階です。
Fabric Data Warehouse のデータ クラスタリングでは、クエリのパフォーマンスを向上させ、コンピューティング使用量を削減するためにデータを整理します。 このチュートリアルでは、クラスター化テーブルの作成から有効性の確認まで、データ クラスタリングを使用してテーブルを作成する手順について説明します。
[前提条件]
- アクティブなサブスクリプションを持つ Microsoft Fabric テナント アカウント。
- Microsoft Fabric 対応ワークスペースがあることを確認します: ワークスペースの作成。
- 倉庫が既に作成されていることを確認します。 新しいウェアハウスを作成するには、「 Microsoft Fabric でウェアハウスを作成する」を参照してください。
- T-SQL とデータのクエリの基本的な理解。
サンプル データのインポート
このチュートリアルでは、NY Taxi サンプル データ セットを使用します。 NYタクシーのデータを倉庫にインポートします。 サンプル データを Data Warehouse に読み込むチュートリアルを使用します。
データクラスタリング付きのテーブルを作成します
このチュートリアルでは、NYTaxi テーブルの 2 つのコピー (チュートリアルからインポートされたテーブルの通常のコピーと、データ クラスタリングを使用するコピー) が必要です。 元の NYTaxi テーブルに基づいて、 CREATE TABLE AS SELECT (CTAS) を使用して新しいテーブルを作成するには、次のコマンドを使用します。
CREATE TABLE nyctlc_With_DataClustering
WITH (CLUSTER BY (lpepPickupDatetime))
AS SELECT * FROM nyctlc
注
この例では、Data Warehouse へのサンプル データの読み込みチュートリアルで NY タクシー データセットに指定されたテーブル名を前提としています。 テーブルに別の名前を使用した場合は、コマンドを調整して、 nyctlc をテーブル名に置き換えます。
このコマンドは、元の NYTaxi テーブルの正確なコピーを作成しますが、 lpepPickupDatetime 列にデータ クラスタリングを使用します。 次に、この列をクエリに使用します。
データのクエリを実行する
NYTaxi テーブルに対してクエリを実行し、NYTaxi_With_DataClustering テーブルでまったく同じクエリを繰り返して比較します。
注
この分析では、両方の実行のコールド キャッシュ パフォーマンスを確認すると便利です。つまり、Fabric Data Warehouse のキャッシュ機能を使用せずに確認できます。 そのため、Query Insights で結果を確認する前に、各クエリを 1 回だけ実行します。
多くの場合、倉庫で繰り返されるクエリを使用します。 このクエリでは、 2008-12-31 日と 2014-06-30の間の年ごとの平均運賃額が計算されます。
SELECT
    YEAR(lpepPickupDatetime),
    AVG(fareAmount) as [Average Fare]
FROM
    NYTaxi
WHERE
    lpepPickupDatetime BETWEEN '2008-12-31' AND '2014-06-30'
GROUP BY
    YEAR(lpepPickupDatetime)
ORDER BY
    YEAR(lpepPickupDatetime) DESC
OPTION (LABEL = 'Regular');
注
このクエリで使用される ラベル オプション は、 Regular テーブルのクエリの詳細を、後で Query Insights ビューを使用してデータ クラスタリングを使用するテーブルと比較する場合に便利です。
次に、まったく同じクエリを繰り返しますが、データ クラスタリングを使用するテーブルのバージョンでは次のようになります。
SELECT
    YEAR(lpepPickupDatetime),
    AVG(fareAmount) as [Average Fare]
FROM
    NYTaxi_With_DataClustering
WHERE
    lpepPickupDatetime BETWEEN '2008-12-31' AND '2014-06-30'
GROUP BY
    YEAR(lpepPickupDatetime)
ORDER BY
    YEAR(lpepPickupDatetime) DESC
OPTION (LABEL = 'Clustered');
2 番目のクエリでは、ラベル Clustered を使用して、 後で Query Insights でこのクエリを識別できるようにします。
データ クラスタリングの有効性を確認する
クラスタリングを設定したら、Query Insights を使用してその有効性を評価できます。 Fabric Data Warehouse の Query Insights は、クエリ実行の履歴データをキャプチャし、実行時間の長いクエリや頻繁に実行されるクエリの識別など、実用的な分析情報に集計します。
この場合、Query Insights を使用して、通常のケースとクラスター化されたケースの間でスキャンされたデータの違いを比較します。
次のクエリを使用します。
SELECT
    label,
    submit_time,
    row_count,
    total_elapsed_time_ms,
    allocated_cpu_time_ms,
    result_cache_hit,
    data_scanned_disk_mb,
    data_scanned_memory_mb,
    data_scanned_remote_storage_mb,
    command
FROM
    queryinsights.exec_requests_history
WHERE
    command LIKE '%NYTaxi%'
    AND label IN ('Regular','Clustered')
ORDER BY
    submit_time DESC;
このクエリは exec_requests_history ビューから詳細を取得します。 詳細については、「 queryinsights.exec_requests_history (Transact-SQL)」を参照してください。
クエリでは、次の方法で結果がフィルター処理されます。
- コマンド名に
NYTaxiテキストを含む行のみをフェッチします (テスト クエリで使用された場合) - ラベル値が「標準」または「クラスター化」の行のみを取得します。
注
クエリの詳細が Query Insights で使用できるようになるまで、数分かかる場合があります。 Query Insights クエリで結果が返されない場合は、数分後にもう一度やり直してください。
このクエリを実行すると、次の結果が確認されます。

どちらのクエリも行数が 6 で、同様の送信時間があります。
Clustered クエリでは、total_elapsed_time_ms 1794、allocated_cpu_time_ms 1676、data_scanned_remote_storage_mb 77.519 が表示されます。
Regular クエリでは、total_elapsed_time_ms 2651、allocated_cpu_time_ms 2600、data_scanned_remote_storage_mb 177.700 が表示されます。 これらの数値は、両方のクエリが同じ結果を返したにもかかわらず、 Clustered バージョンでは、 Regular バージョンよりも約 36% 少ない CPU 時間を使用し、ディスク上の約 56% 少ないデータをスキャンしたことを示しています。 どちらのクエリ実行でもキャッシュは使用されませんでした。 これらは、クエリの実行時間と使用量を削減し、 lpepPickupDatetime 列をデータ クラスタリングの強力な候補にするのに役立つ重要な結果です。
注
これは、約 7,600 万行と 2 GB のデータ ボリュームを持つ小さなテーブルです。 このクエリでは集計に対して 6 行しか返されませんが (範囲内の年ごとに 1 行)、結果が集計される前に指定された日付範囲の約 830 万行がスキャンされます。 データ量が多い実際の実稼働データは、より大きな結果を生み出す可能性があります。 結果は、クエリ中の容量サイズ、キャッシュされた結果、またはコンカレンシーによって異なる場合があります。
ワークロードからクラスタリング列を選択します
本番テーブルでは、どの列をクラスタリングするか推測するのではなく、観察されたクエリパターンを活用しましょう。
sqldw-cliスキルの運用機能はQuery Insightsの履歴を分析し、リモートスキャンしたデータによる繰り返しクエリパターンをランク付けし、WHERE述語で使用された列を特定します。
始める前にSkills for Fabricをインストールし、倉庫に最近のクエリ活動があるか確認し、Contributor workspaceの役割以上であることを確認しましょう。 次に、GitHub Copilot CLIを開き、このようなプロンプトを使ってください:
Use the sqldw-cli skill to recommend clustering columns for
<workspace-name>/<warehouse-name> based on the last seven days of workload.
Rank candidates by total remote data scanned, consider columns used in WHERE
predicates, and explain each column's cardinality and data type suitability.
Use read-only diagnostics.
このスキルは、スキャンに最も影響を与えるクエリパターンを特定し、それらのクエリからテーブルやフィルター列を抽出し、クラスタリング候補をランク付けします。 以下のガイドラインで推奨事項を見直してください:
- 日付や識別子などの中~高カーディナリティの値を含み、大規模なテーブルに対して繰り返しフィルタを行う列を優先してください。
- 選択性の高い範囲述語または
WHERE句の等価述語で使用される列を優先してください。 - 列が等しい結合条件に現れるからといって選択しないでください。 これらの条件はデータクラスタリングの恩恵を受けません。
- クラスタリング列は最大4つに制限し、作業量に合う列数以上は追加しないでください。
例えば、 Sales.SalesOrder が15億行、 Sales.OrderLine が60億行を持つeコマース倉庫を考えてみましょう。 繰り返し問い合わせを分析した後、スキルは以下の推奨を返すことがあります。
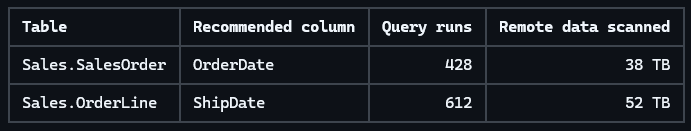
日付列は、最も大きなテーブルのフィルタリングに使われ、一般的な範囲述語をサポートし、OrderStatus や SalesRegion のようなカーディナリティの低い列よりもファイルをスキップできる機会が多いことから、有力な候補です。
sqldw-cli操作機能は読み取り専用です。 列の推奨はしますが、テーブルの作成や置換はしません。 推奨事項を確認した後、CTASを使ってテーブルのクラスタコピーを作成してください:
CREATE TABLE Sales.SalesOrder_clustered
WITH (CLUSTER BY (OrderDate))
AS
SELECT * FROM Sales.SalesOrder;
クラスタ化されたワークロードと非クラスタ化されたワークロードを比較して効果を検証してください。 クラスタテーブルの検証が完了したら、元のテーブルの名前を変更し、さらにクラスタテーブルを元の名前に戻してください:
EXEC sp_rename 'Sales.SalesOrder', 'SalesOrder_old';
EXEC sp_rename 'Sales.SalesOrder_clustered', 'SalesOrder';
元のテーブルはロールバック Sales.SalesOrder_old として引き続き利用可能です。 元のテーブルを削除する前に、依存するワークロードと新しいテーブルを確認してください。 ロールバックコピーが不要になったら、すぐに削除してください:
DROP TABLE Sales.SalesOrder_old;