重複と null を解決する
重複するレコードや null 値などのデータ品質の問題により、分析とダウンストリーム プロセスが損なわれる可能性があります。 データの同時読み込みから重複が発生した場合でも、ソース データが不完全であるために null が表示される場合でも、これらの問題に対処することは、Azure Databricks で作業するデータ エンジニアにとって重要な責任です。
このユニットでは、SQL と PySpark の両方のアプローチを使用して、重複値、欠落値、および null 値を特定して解決する方法について説明します。
重複するレコードを特定する
重複を削除する前に、重複を見つける必要があります。 重複は、通常、データ統合の問題、繰り返しの取り込み、または同時書き込み操作が原因で、同じレコードがテーブルに複数回出現する場合に発生します。
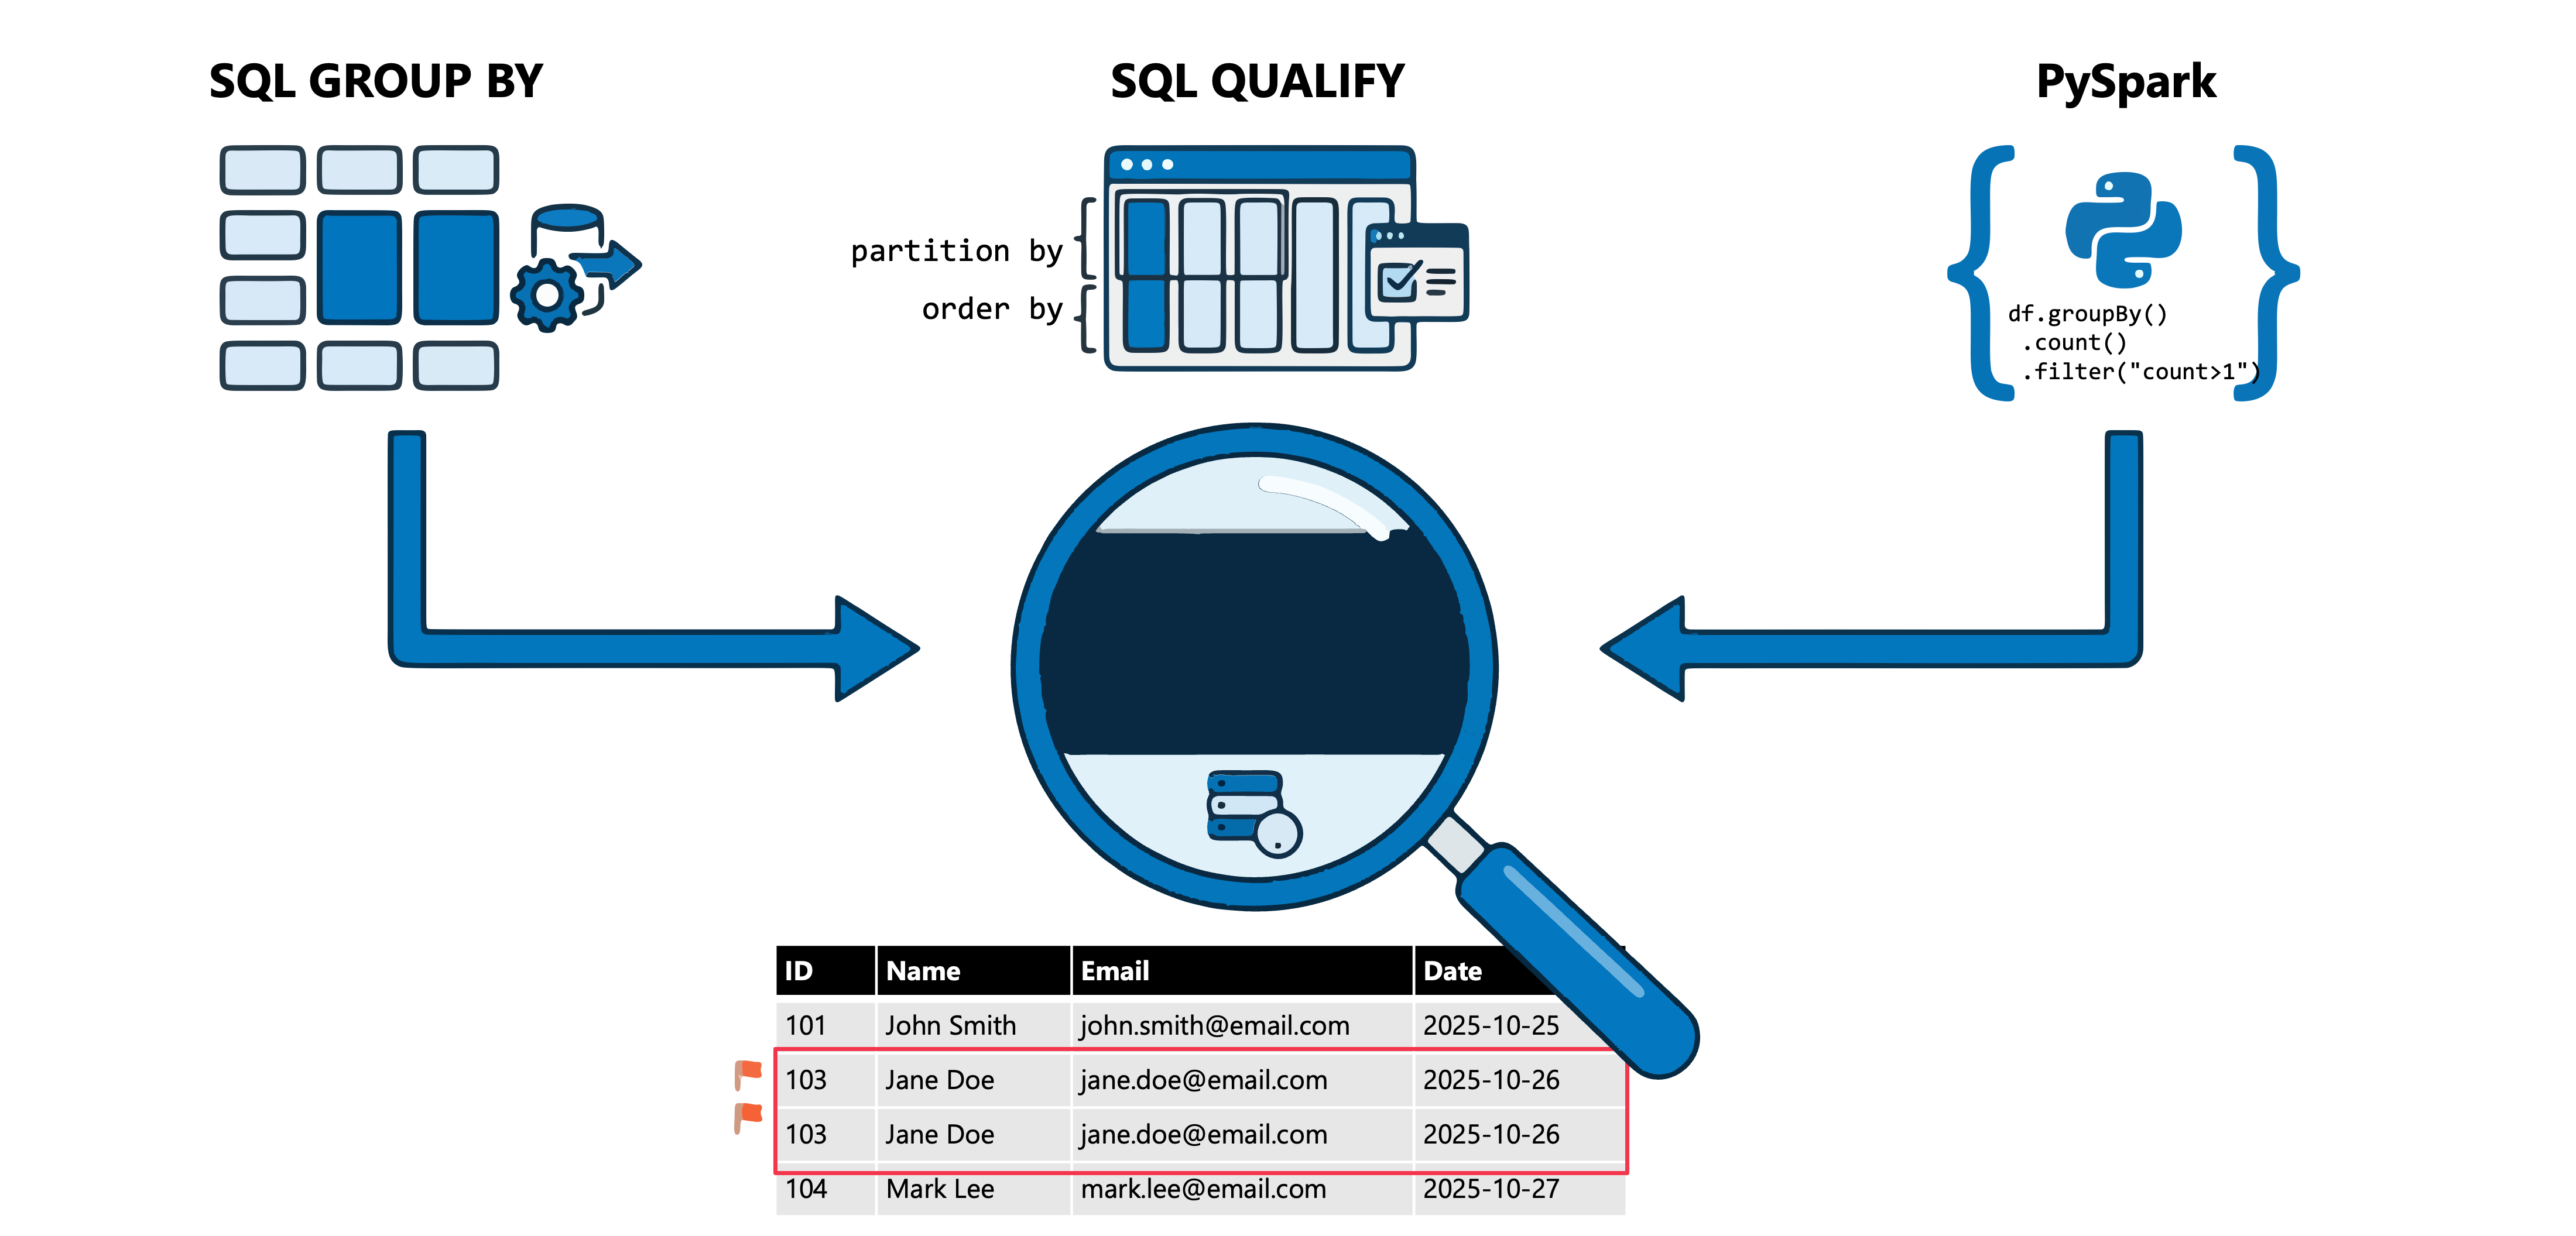
GROUP BY と HAVING を使用して重複を見つける
重複を識別する最も簡単な方法は、レコードをグループ化し、発生回数をカウントする方法です。
HAVING句は、グループ化された結果をフィルター処理して、複数回表示される値のみを表示します。
SELECT
    customer_id,
    email,
    COUNT(*) AS occurrence_count
FROM sales.customers
GROUP BY customer_id, email
HAVING COUNT(*) > 1
ORDER BY occurrence_count DESC;
このクエリは、テーブルに複数回表示される customer_id と email のすべての組み合わせを返し、重複の範囲を理解するのに役立ちます。
ウィンドウ関数で QUALIFY を使用する
QUALIFY句は、サブクエリを必要とせずに、ウィンドウ関数の結果を直接フィルター処理することで、より簡単なアプローチを提供します。 この方法は、カウントだけでなく、実際の重複する行を確認する必要がある場合に特に便利です。
SELECT *
FROM sales.customers
QUALIFY COUNT(*) OVER (PARTITION BY customer_id, email) > 1;
このクエリでは、次のような結果が返される場合があります。
| customer_id | メール | 名前 | 作成日時 | 状態 |
|---|---|---|---|---|
| 1001 | jane@contoso.com | ジェーン・ドウ | 2024-01-15 | Active |
| 1001 | jane@contoso.com | Jane D. | 2024-03-20 | Active |
| 1002 | bob@fabrikam.com | ボブ・スミス | 2024-02-10 | 保留中 |
| 1002 | bob@fabrikam.com | Robert Smith | 2024-02-11 | Active |
このパターンでは、重複する行からすべての列を取得し、重複の原因を簡単に調査できます。
PySpark を使用して重複を検索する
PySpark では、ウィンドウ関数とフィルター処理を組み合わせて使用して、重複するレコードを識別できます。
from pyspark.sql.functions import count
from pyspark.sql.window import Window

window_spec = Window.partitionBy("customer_id", "email")

duplicates_df = (
    df.withColumn("row_count", count("*").over(window_spec))
    .filter("row_count > 1")
    .drop("row_count")
)

display(duplicates_df)
または、 exceptAll() メソッドを使用して、元の DataFrame と重複除去されたバージョンを比較します。
df_duplicates = df.exceptAll(df.dropDuplicates(["customer_id", "email"]))
display(df_duplicates)
exceptAll()メソッドは、重複を保持する一連の違いを実行します。 2 番目の DataFrame に含まれていない最初の DataFrame からすべての行が返され、重複が発生し続けます。 ここでは、そのしくみを示します:
-
df.dropDuplicates(["customer_id", "email"])は、一意の組み合わせごとに 1 行の DataFrame を作成します -
exceptAll()元の DataFrame をこの重複除去されたバージョンと比較します - 一意の組み合わせごとに、1 回の出現が "一致" され、削除され、余分な重複のみが残ります
たとえば、顧客 1001 が元の DataFrame に 3 回出現し、重複除去されたバージョンに 1 回出現した場合、 exceptAll() は 2 行を返します (余分な出現回数)。
注
一致するすべての行を削除し、個別の結果を返す except()とは異なり、 exceptAll() は重複する構造を保持します。 元の行に同じ行が 3 行あり、重複除去セットに 1 行ある場合、 exceptAll() は 2 行を返します。
重複するレコードを削除する
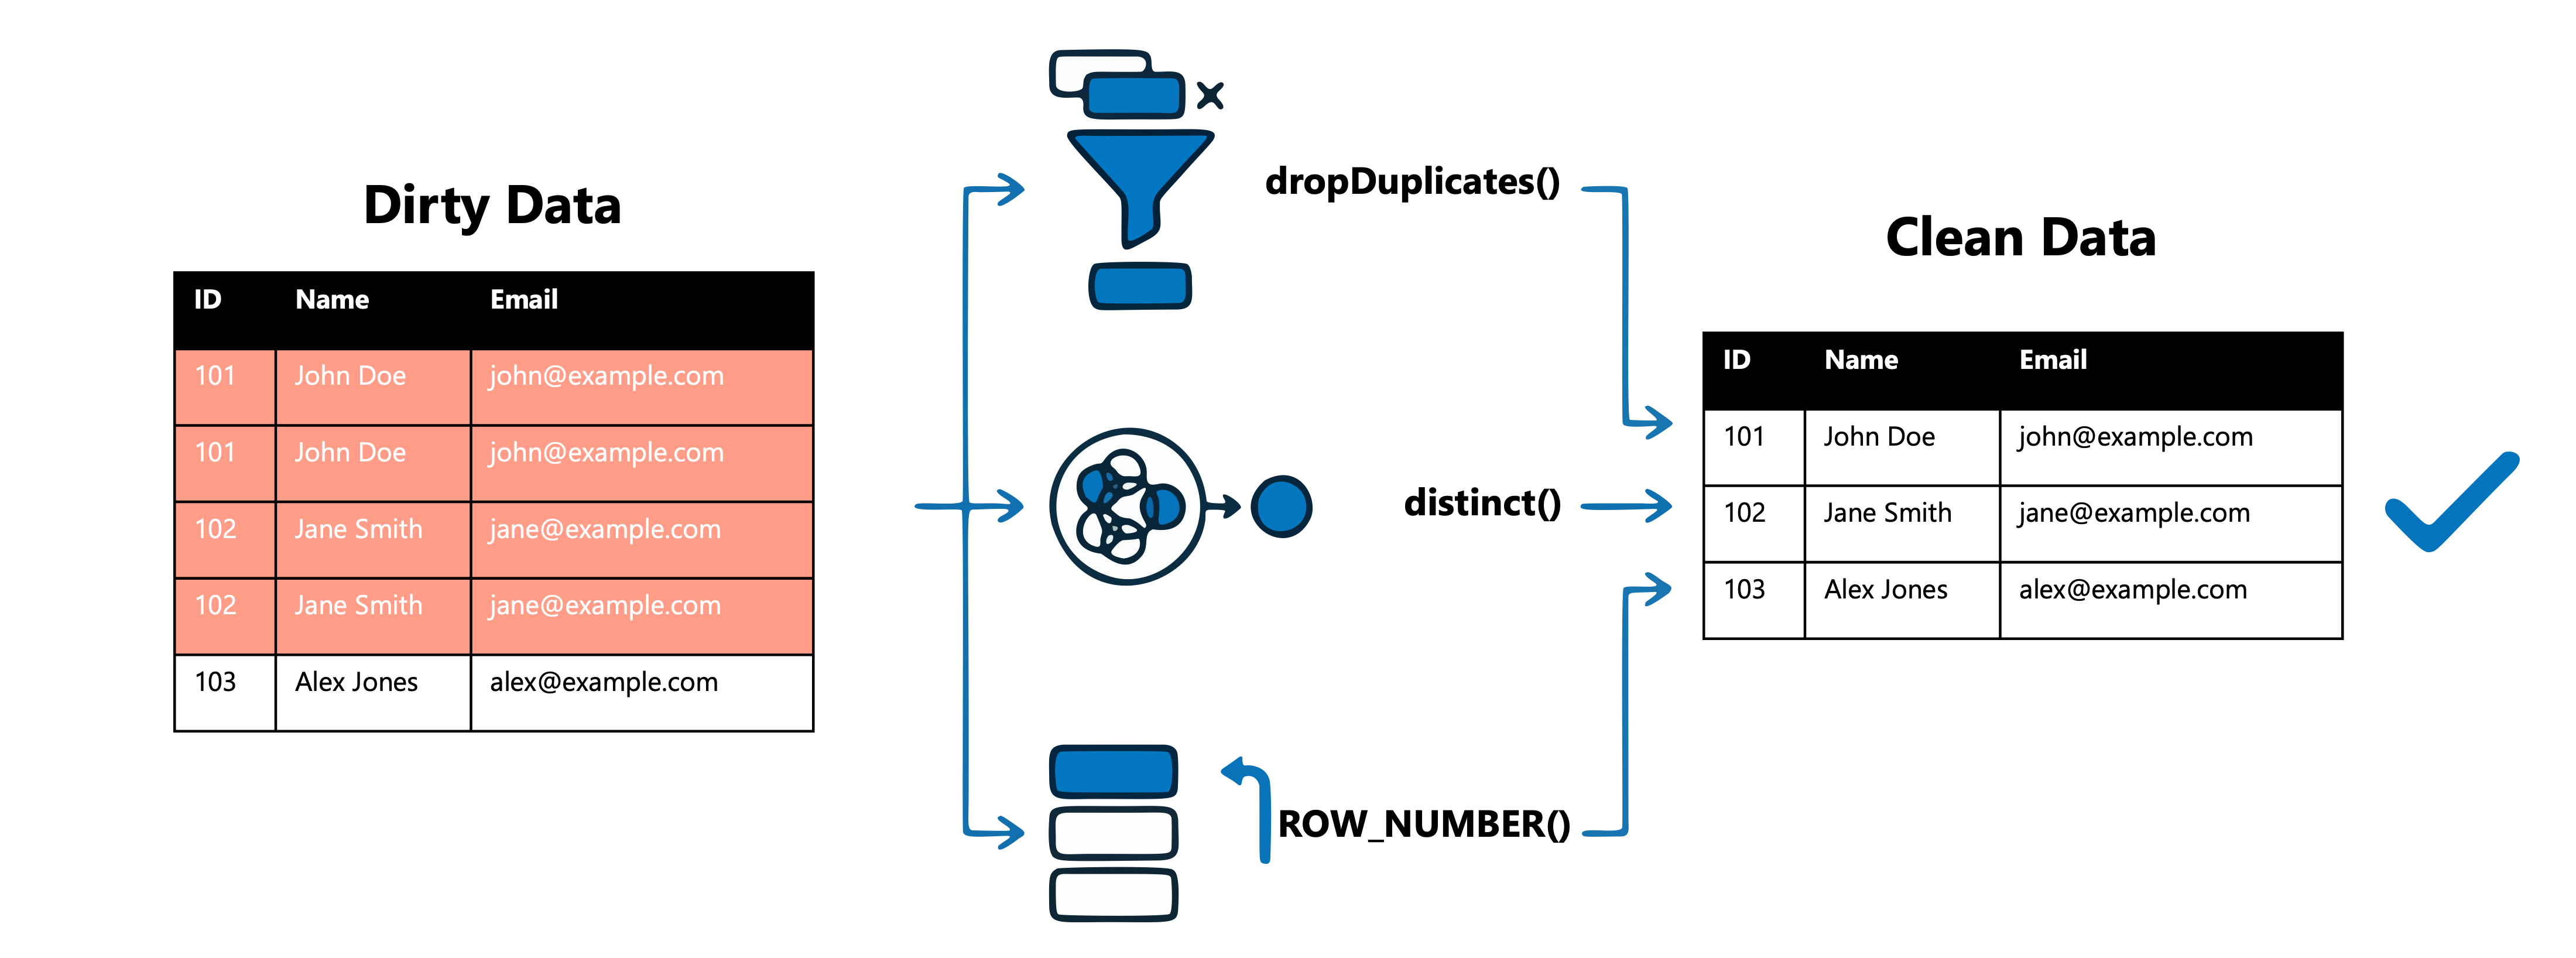
重複を特定したら、データ要件に基づいて解決戦略を選択できます。
PySpark で重複を削除する
dropDuplicates()メソッドは、指定した列に基づいて重複する行を削除し、組み合わせごとに 1 つの行を保持します。 他の列で行が異なる場合、どの行が残るかは保証されません。
df_clean = df.dropDuplicates(["customer_id", "email"])
すべての列で完全な行重複除去を行うには、 distinct()を使用します。
df_unique = df.distinct()
ROW_NUMBERを使用して特定の行を保持する
保持する重複を制御する必要がある場合は、ROW_NUMBER()でQUALIFYを使用して、最新の更新プログラムのような条件に基づいてレコードを選択します。
SELECT *
FROM sales.customers
QUALIFY ROW_NUMBER() OVER (
    PARTITION BY customer_id
    ORDER BY updated_at DESC
) = 1;
このクエリでは、レコードは customer_idでパーティション分割され、降順で updated_at 順に並べ替え、各顧客の最新のレコードのみが保持されます。
null 値と欠損値を処理する
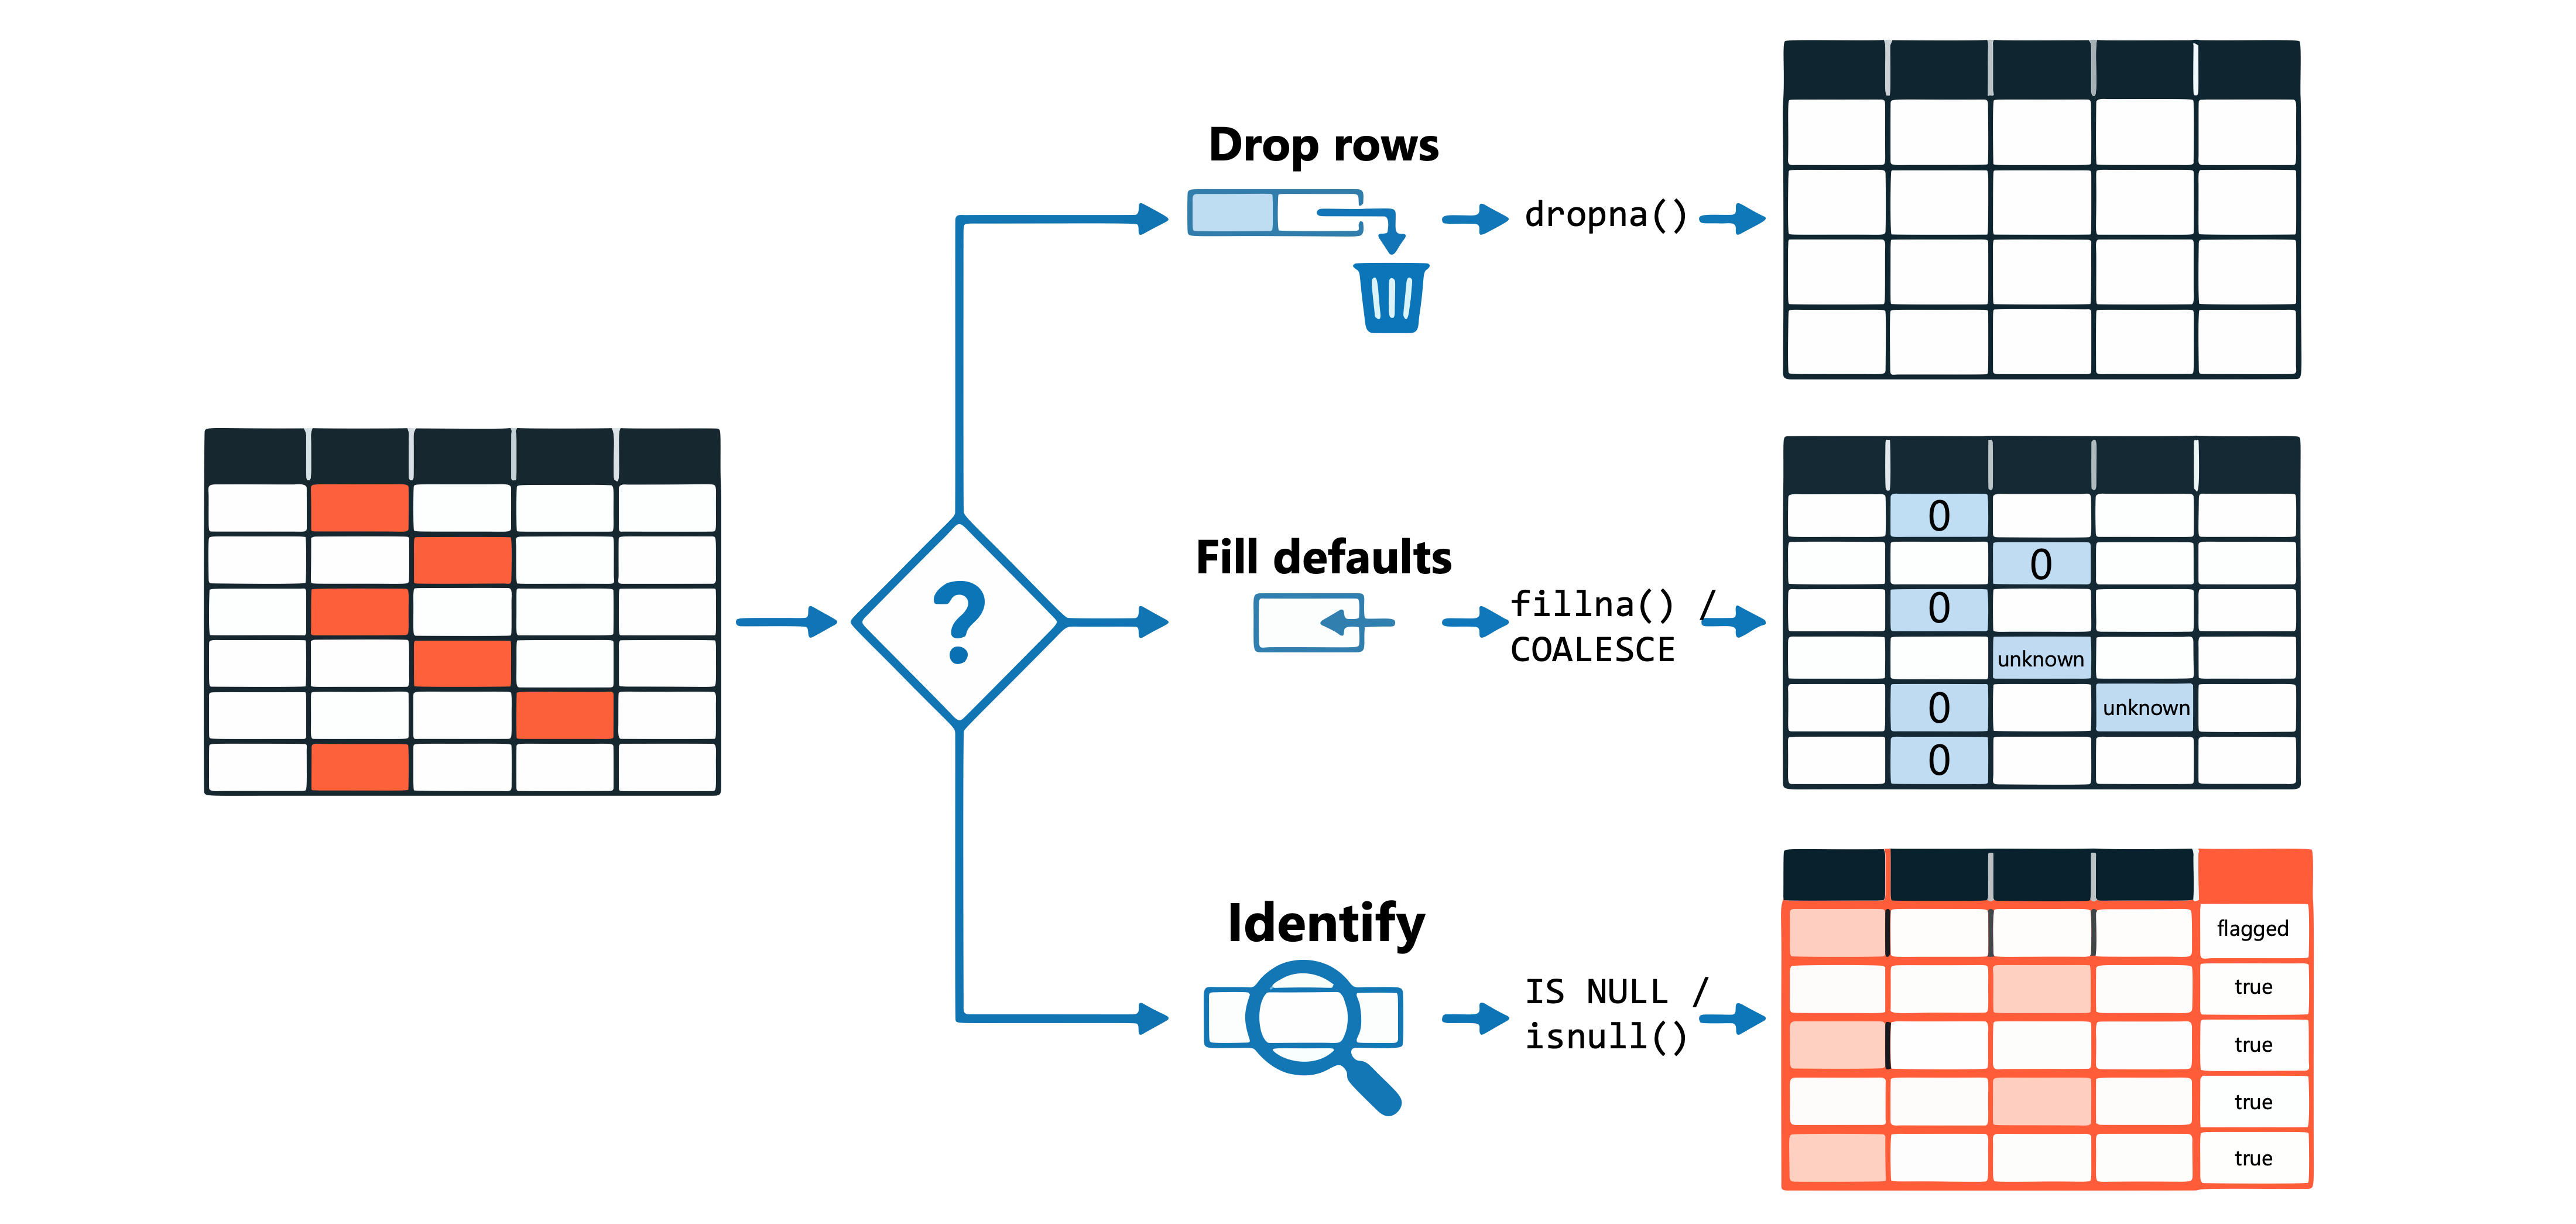
Null 値は、データが見つからないか不明であることを表します。 分析の要件によっては、null を含む行の削除、既定値への置き換え、または統計的補完の使用が必要になる場合があります。
null 値を識別する
isnull()関数またはIS NULL演算子を使用して、欠損値を持つレコードを検索します。
SELECT *
FROM sales.transactions
WHERE amount IS NULL
   OR customer_id IS NULL;
列あたりの null 出現回数をカウントするには:
SELECT
    COUNT(*) AS total_rows,
    COUNT(*) - COUNT(amount) AS null_amount_count,
    COUNT(*) - COUNT(customer_id) AS null_customer_count
FROM sales.transactions;
null 値を持つ行を削除する
PySpark では、 dropna() メソッドは null 値を含む行を削除します。
# Drop rows where any column is null
df_clean = df.dropna()

# Drop rows where all columns are null
df_clean = df.dropna(how="all")

# Drop rows where specific columns are null
df_clean = df.dropna(subset=["customer_id", "amount"])
how パラメーターは動作を制御します。"any"は、少なくとも 1 つの null (既定値) の行を削除しますが、"all"は、指定されたすべての列が null の場合にのみ行を削除します。
既定値を使用して null 値を入力する
fillna() メソッドは、null 値を指定した既定値に置き換えます。
# Fill null values with a single value (applies only to columns whose data type matches)
df_filled = df.fillna(0)

# Fill specific columns with different values
df_filled = df.fillna({
    "amount": 0,
    "status": "Unknown",
    "quantity": 1
})
SQL では、 COALESCE 関数を使用して既定値を指定します。
SELECT
    customer_id,
    COALESCE(amount, 0) AS amount,
    COALESCE(status, 'Unknown') AS status
FROM sales.transactions;
適切な戦略を選択する
適切な null 処理戦略は、データ コンテキストによって異なります。
| Scenario | 推奨される方法 |
|---|---|
| 識別子などの必須フィールドの NULL 値 | 行を削除する |
| 数値フィールドにおける集計用のNULL値 | ゼロまたは平均で補完する |
| 省略可能なカテゴリ フィールドの Null | "Unknown" のようなプレースホルダーを入力します |
| 分析を歪める Null | ドメイン知識に基づいて削除または補完する |
ヒント
null 処理の決定を文書化します。 将来のアナリストは、クエリ結果を正しく解釈するために、特定の値が置き換えられたか削除された理由を理解する必要があります。
これらのデータ品質の問題を特定して解決する方法を理解すると、より信頼性の高いデータ パイプラインを構築する準備が整います。 クリーンなデータを使用すると、ダウンストリームの変換と分析によって信頼できる結果が得られます。